Tumblr 爬虫










Tumblr-Daten mit Thunderbit freischalten
Extrahiere mühelos Tumblr-Daten wie Beitragstexte und Like-Zahlen.
Den vollständigen Tumblr-Kontext erfassen
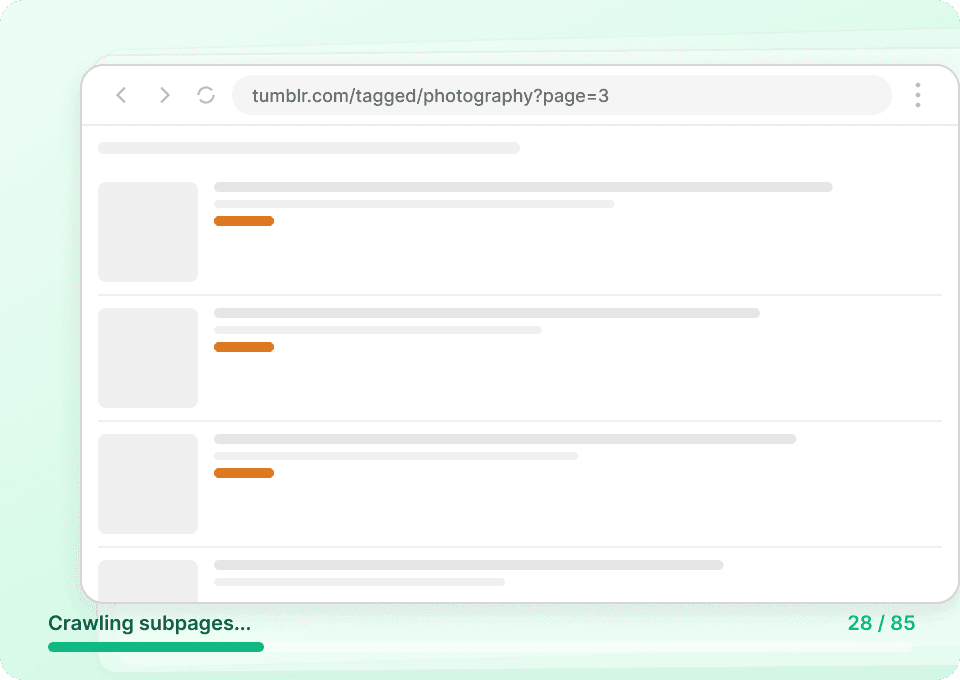
Auf Tumblr zeigen Übersichtsseiten oft nur Ausschnitte an. Für ein vollständiges Bild brauchst du den gesamten Beitragstext, Autorinformationen und alle zugehörigen Metadaten. Thunderbit besucht automatisch jede verlinkte Beitragsseite, extrahiert die vollständigen Details und ergänzt sie als neue Spalten – so kannst du Post-IDs, Veröffentlichungsdaten und mehr erfassen, ganz ohne manuelles Klicken.
Deine Tumblr-Datenerfassung automatisieren
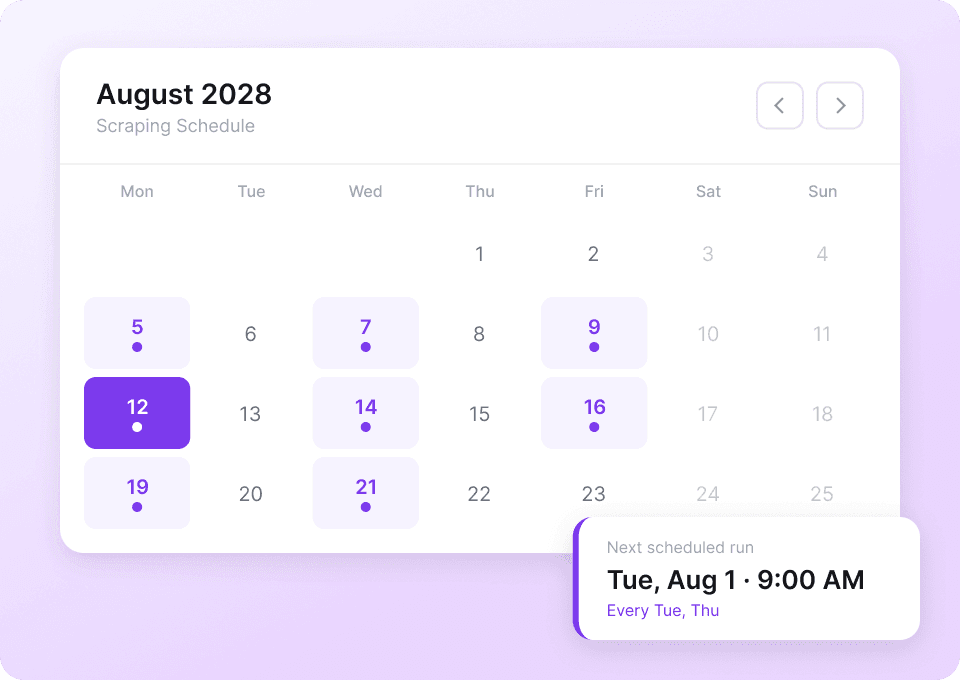
Tumblr-Daten ändern sich laufend. Dieselben Blogs manuell immer wieder aufzurufen und neu zu scrapen ist mühsam und fehleranfällig. Mit dem geplanten Scraping von Thunderbit richtest du wiederkehrende Extraktionen auf Autopilot ein. So erhältst du aktuelle Like-Zahlen und Beitragstexte direkt in Google Sheets – ganz ohne manuelle Arbeit.
Tumblr-Posts in zwei Klicks scrapen
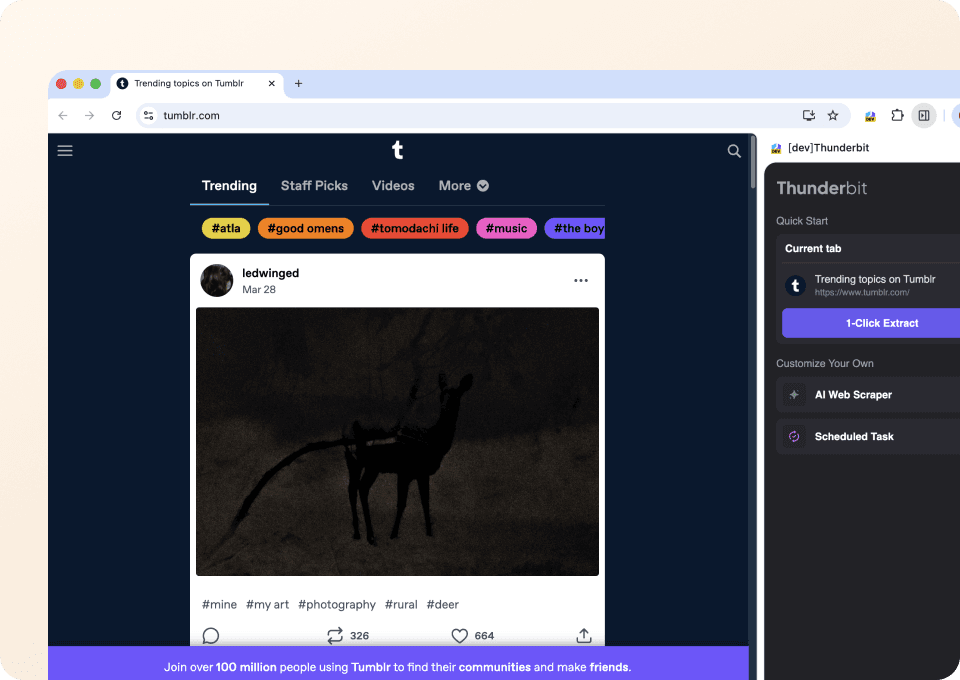
Kein Code und keine CSS-Selektoren nötig. Mit Thunderbit extrahierst du Tumblr-Daten in nur zwei Klicks. Zeige einfach auf das, was du brauchst – Beitragstyp, Autor, Inhalt, Like-Zahl – und die semantische KI von Thunderbit erkennt die relevanten Felder und zieht alles automatisch heraus.
Warum unterscheidet sich Thunderbit von herkömmlichen Tumblr-Scrapern?
Tumblr-Daten ganz ohne Aufwand extrahieren – selbst wenn sich Layouts ändern oder unerwartet verschieben.
Traditionelle Scraper
Der klassische WegThunderbit KI
Der intelligentere AnsatzVerlass dich nicht nur auf unser Wort
Sieh dir an, was unsere Nutzer über Thunderbit sagen.
Häufig gestellte Fragen
Verwandt Anwendungsfälle
Entdecke weitere Anwendungsfälle für Thunderbits Web-Scraper.
Minds-Scraper
Mit dem Thunderbit Minds Web-Scraper können Sie Daten aus Minds-Newsfeeds und Gruppenmitgliedern dank KI-gestützter Feldvorschläge extrahieren. Sammeln Sie Beitragstitel, Autorennamen, Likes, Kommentare und Details zu Gruppenmitgliedern – ideal für Recherche, Marketing oder Community-Analysen. Exportieren Sie strukturierte Minds-Daten schnell und unkompliziert.
Mehr erfahren ->
MeWe-Scraper
Mit dem Thunderbit MeWe-Scraper können Sie Daten aus MeWe-Profilen und Gruppenbeiträgen mühelos extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Profilnamen, Biografien, Beitrittsdaten, Beiträge, Likes und Kommentare für Recherche, Marketing oder Analysen. Perfekt für Marketer, Forscher und Unternehmen, die strukturierte MeWe-Daten benötigen.
Mehr erfahren ->
Parler-Scraper
Mit dem Thunderbit Parler-Scraper können Sie Daten aus Parler-Suchergebnissen und Hashtag-Listen mühelos extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Suchbegriffe, Nutzerbeiträge, Hashtags, Beliebtheitswerte und vieles mehr für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Unternehmen, die strukturierte Parler-Daten benötigen.
Mehr erfahren ->
Element-Scraper
Mit dem Thunderbit Element Web-Scraper können Sie Daten aus dem Element Synapse Admins Room effizient erfassen – unterstützt durch KI-gestützte Feldvorschläge. Sammeln Sie Nachrichten-IDs, Absendernamen, Zeitstempel, Nachrichteninhalte und Anhänge für Analyse- oder Überwachungszwecke. Perfekt geeignet für Entwickler, Community-Manager und Forschende, die strukturierte Element-Daten benötigen.
Mehr erfahren ->
Odnoklassniki-Scraper
Mit dem Thunderbit Odnoklassniki Web-Scraper können Sie Daten aus Odnoklassniki-Gruppen und Spielelisten mühelos extrahieren – unterstützt durch KI-gestützte Feldvorschläge. Sammeln Sie Gruppennamen, Beschreibungen, Mitgliederzahlen, Spieledetails, Bewertungen und vieles mehr für Recherche, Marketing oder Analysen. Perfekt geeignet für Marketer, Analysten und Unternehmen, die strukturierte Odnoklassniki-Daten benötigen.
Mehr erfahren ->
Triller-Scraper
Mit dem Thunderbit Triller Web-Scraper können Sie Daten aus Triller-Blogseiten und Creator-Collective-Profilen extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie Blogtitel, Veröffentlichungsdaten, Autorennamen, Creator-Biografien und Follower-Zahlen im Handumdrehen – ideal für Recherche, Marketing oder Analyse.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



