Einfacher ESPN Scraper










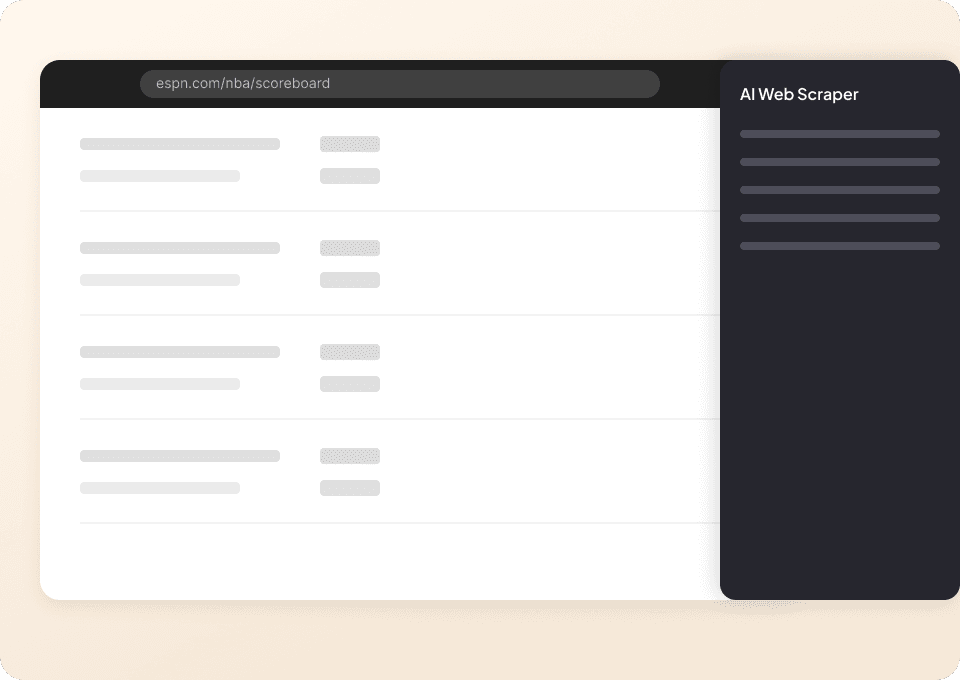
ESPN-Daten ohne Aufwand extrahieren
Mit Thunderbit kannst du Sportdaten von ESPN in nur wenigen Klicks ganz einfach scrapen.
ESPN in zwei Klicks scrapen
Überspringe Code und komplizierte Einrichtung. Mit Thunderbit markierst du einfach die Daten, die du brauchst — Athletenname, Ergebnis, Spieltermin, beliebige Statistiken — und extrahierst sie in zwei Klicks. Keine CSS-Selektoren, keine umständlichen APIs. Einfach zeigen, klicken und die gewünschten ESPN-Daten erhalten.
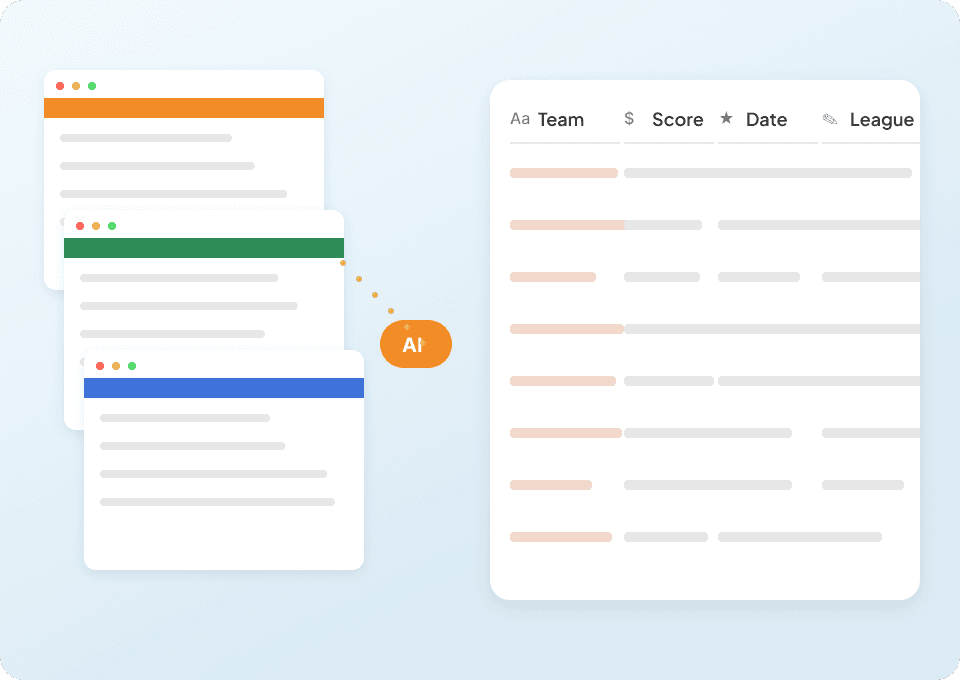
Saubere ESPN-Daten, sofort verfügbar
Rohdaten von ESPN sind oft uneinheitlich und schwer nutzbar. Thunderbit bereinigt und strukturiert alles automatisch während des Scraping-Vorgangs — von Athletenstatistiken über Teamnamen bis hin zu Spielstatus — sodass die Ausgabe direkt nach Abschluss der Extraktion für Analysen oder Berichte bereit ist. Manuelle Nachbearbeitung ist nicht nötig.
Viele ESPN-Seiten auf einmal scrapen
ESPN Seite für Seite zu scrapen kostet unnötig Zeit. Thunderbit besucht und extrahiert automatisch in einem einzigen Durchlauf Daten von Hunderten ESPN-Seiten und folgt dabei Links zu Teamseiten, Spielerprofilen oder einzelnen Spielauswertungen. Du gibst die Start-URLs vor, den Rest übernimmt Thunderbit.
Warum unterscheidet sich Thunderbit von klassischen ESPN Scrapern?
Sportdaten mühelos extrahieren, selbst wenn sich das ESPN-Layout ohne Vorwarnung ändert.
Klassische Scraper
Die alte VorgehensweiseThunderbit KI
Der intelligentere AnsatzVerlass dich nicht nur auf unser Wort
Sieh dir an, was unsere Nutzer über Thunderbit sagen.
Häufig gestellte Fragen
Verwandt Anwendungsfälle
Entdecke weitere Anwendungsfälle für Thunderbits Web-Scraper.

4PDA-Scraper
Mit dem Thunderbit 4PDA Web-Scraper können Sie mithilfe von KI Daten aus 4PDA-Nachrichtenartikeln und Forenbeiträgen extrahieren. Sammeln Sie schnell Überschriften, Veröffentlichungsdaten, Autoren und Beitragsinhalte – ideal für Recherchen, Analysen oder das Monitoring technischer Diskussionen. Perfekt für Technikbegeisterte, Forschende und Marketer, die strukturierte 4PDA-Daten benötigen.
Mehr erfahren ->
Ptt-Scraper
Mit dem Thunderbit Ptt Web-Scraper können Sie mühelos Daten aus Ptt-Foren und Beiträgen extrahieren – dank KI-gestützter Felderkennung. Sammeln Sie Boardnamen, URLs, Beliebtheit, Beitragstitel, Autoren und Kommentare für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Ptt-Daten benötigen.
Mehr erfahren ->
Pizza-Marktplatz-Scraper
Mit dem Thunderbit Pizza Marketplace Scraper können Sie Daten aus den Nachrichtenlisten und Anbieterverzeichnissen von Pizza Marketplace extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Schlagzeilen, Veröffentlichungsdaten, Autoren, Anbieternamen, Standorte und Kontaktdaten – ideal für Recherche, Marketing oder Analysen.
Mehr erfahren ->
Failory Scraper
Mit dem Thunderbit Failory-Scraper können Sie strukturierte Daten aus dem Startup Cemetery und den News-Artikeln von Failory extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie Startup-Namen, Gründungsjahre, Scheitergründe, Artikeltitel, Autoren und vieles mehr – perfekt für Recherche und Analyse. Ideal für Gründer, Investoren und Forschende, die wertvolle Einblicke aus Failory gewinnen möchten.
Mehr erfahren ->
Investing.com Web-Scraper
Extrahiere Börsendaten – Symbole, Kurse, Volumen und Marktkapitalisierung – aus Investing.com mit nur 2 Klicks und exportiere sie direkt nach Google Sheets, Notion oder Excel. Öffne einfach eine beliebige Investing.com-Seite und lass die KI die Felder für dich erkennen.
Mehr erfahren ->
Substack-Webscraper
Extrahieren Sie Substack-Abonnentenzahlen, Artikeltitel und Beschreibungen von Publikationen in nur 2 Klicks — und exportieren Sie die Daten anschließend nach Excel, Google Sheets oder Notion. Ganz ohne Code; Thunderbits KI übernimmt die Strukturierung für Sie.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



