Artikel-Scraper für Texte, Autoren und Daten










Artikeldaten trotz wechselnder Seitenlayouts erfassen
Felder nach Bedeutung lesen, wiederkehrende Läufe planen und denselben Workflow auf öffentlichen Websites einsetzen.
Sich an geänderte Artikellayouts anpassen
Thunderbit liest sichtbare Überschriften, Autorenzeilen, Daten, Zusammenfassungen und Artikeltext nach Bedeutung aus. Dadurch ist der Workflow weniger von festen Seitenpositionen abhängig, wenn eine Nachrichtenseite ihr Layout ändert.
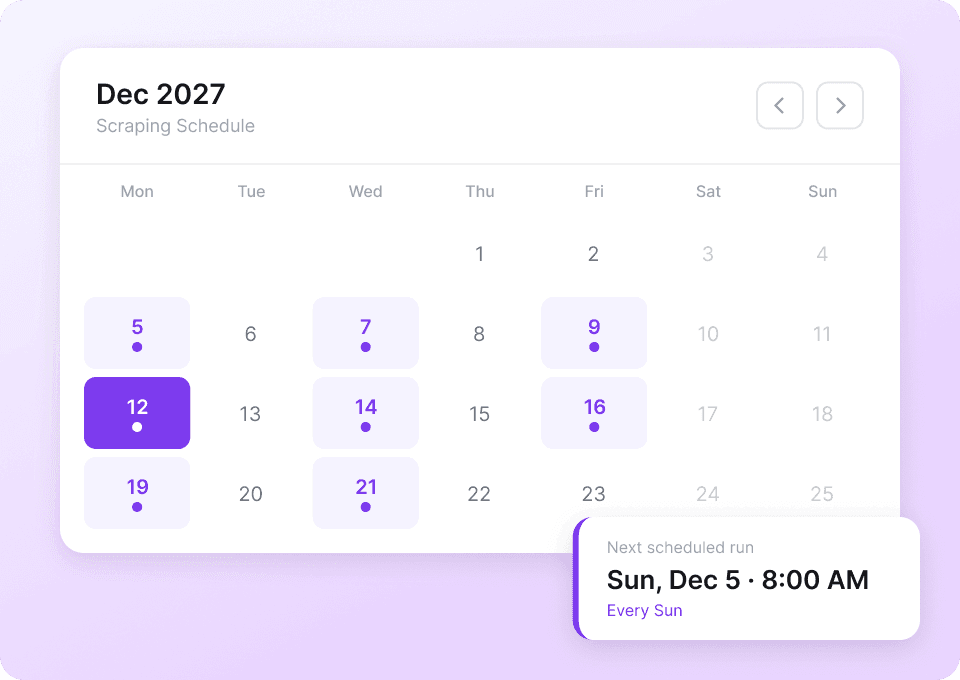
Das Artikel-Scraping nach Zeitplan ausführen
Richten Sie einen wiederkehrenden Lauf für eine öffentliche News-, Blog- oder Kategorienseite ein, die Sie regelmäßig besuchen. Thunderbit kann die aktuell sichtbaren Artikel erfassen und neue Zeilen an Ihre gewünschte Datei oder App senden.
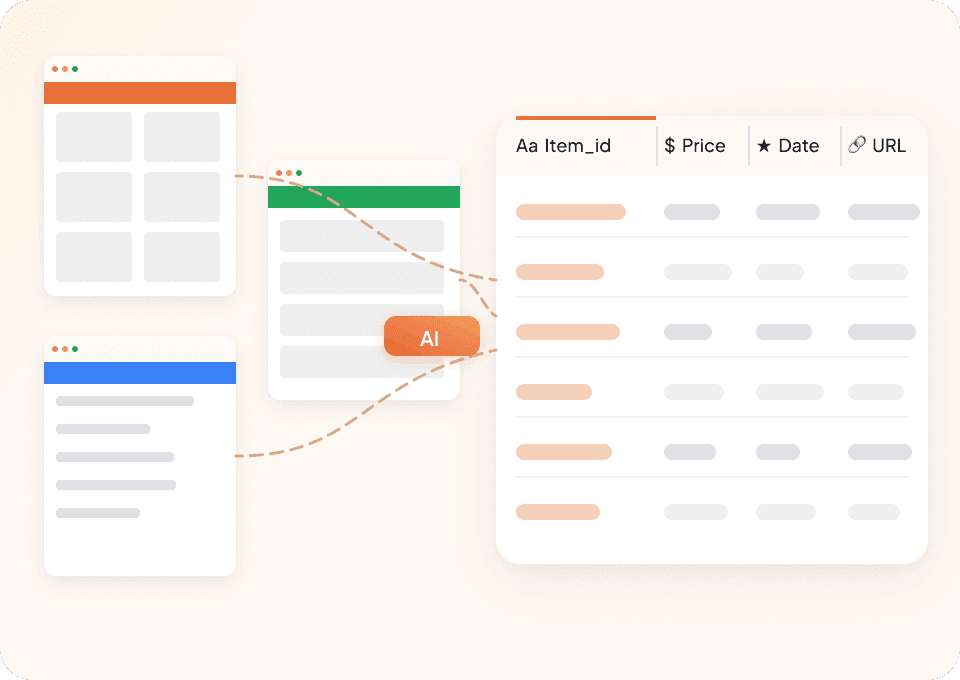
Einen Workflow auf jeder öffentlichen Website nutzen
Verwenden Sie denselben Workflow auf jeder öffentlichen Website mit Artikeln. Benennen Sie die benötigten Felder, und Thunderbit ordnet jede Seite denselben Spalten zu.
Ein Artikel-Workflow für unterschiedliche Seitenlayouts
Feste Selektoren folgen Positionen. Thunderbit AI sucht nach den von Ihnen benannten Artikelfeldern.
Eine Selector-Karte für jeden Herausgeber
Jedes Seitendesign braucht eigene PflegeVon Thunderbit organisierte Artikelfelder
Der gewünschte Datensatz bleibt konsistentWelche Daten können Sie aus einem Artikel extrahieren?
Wählen Sie aus 30 sichtbaren Feldern zu Inhalt, Autor, Herausgeber, Datum, Links, Themen, Medien und Seiten-Metadaten.
- Überschrift
- Alternative Überschrift
- Artikeltext
- Artikelzusammenfassung
- Autorenname
- Autor-URL
- Organisation des Autors
- Name des Herausgebers
- Herausgeber-URL
- Veröffentlichungsdatum
- Änderungsdatum
- Artikelbereich
- Schlüsselwörter
- Wortanzahl
- Sprache
- Canonical-URL
- URL der Hauptentität
- Bild-URL
- Bildunterschrift
- Bildnachweis
- Video-URL
- Audio-URL
- Dateline
- Themen zu diesem Artikel
- Erwähnungen
- Zitat-Links
- Lizenz-URL
- Links zu verwandten Artikeln
- Seitentitel
- Meta-Beschreibung
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.
Fragen zum Scraping öffentlicher Artikel
Nachrichtenseiten verwenden unterschiedliche Layouts und Seitendetails. Welche Felder Sie erhalten, hängt daher von der erfassten Artikelseite ab.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

4PDA-Scraper
Mit dem Thunderbit 4PDA Web-Scraper können Sie mithilfe von KI Daten aus 4PDA-Nachrichtenartikeln und Forenbeiträgen extrahieren. Sammeln Sie schnell Überschriften, Veröffentlichungsdaten, Autoren und Beitragsinhalte – ideal für Recherchen, Analysen oder das Monitoring technischer Diskussionen. Perfekt für Technikbegeisterte, Forschende und Marketer, die strukturierte 4PDA-Daten benötigen.
Mehr erfahren ->
Ptt-Scraper
Mit dem Thunderbit Ptt Web-Scraper können Sie mühelos Daten aus Ptt-Foren und Beiträgen extrahieren – dank KI-gestützter Felderkennung. Sammeln Sie Boardnamen, URLs, Beliebtheit, Beitragstitel, Autoren und Kommentare für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Ptt-Daten benötigen.
Mehr erfahren ->
Pizza-Marktplatz-Scraper
Mit dem Thunderbit Pizza Marketplace Scraper können Sie Daten aus den Nachrichtenlisten und Anbieterverzeichnissen von Pizza Marketplace extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Schlagzeilen, Veröffentlichungsdaten, Autoren, Anbieternamen, Standorte und Kontaktdaten – ideal für Recherche, Marketing oder Analysen.
Mehr erfahren ->
Failory Scraper
Mit dem Thunderbit Failory-Scraper können Sie strukturierte Daten aus dem Startup Cemetery und den News-Artikeln von Failory extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie Startup-Namen, Gründungsjahre, Scheitergründe, Artikeltitel, Autoren und vieles mehr – perfekt für Recherche und Analyse. Ideal für Gründer, Investoren und Forschende, die wertvolle Einblicke aus Failory gewinnen möchten.
Mehr erfahren ->
Investing.com Web-Scraper
Extrahiere Börsendaten – Symbole, Kurse, Volumen und Marktkapitalisierung – aus Investing.com mit nur 2 Klicks und exportiere sie direkt nach Google Sheets, Notion oder Excel. Öffne einfach eine beliebige Investing.com-Seite und lass die KI die Felder für dich erkennen.
Mehr erfahren ->
Substack-Webscraper
Extrahieren Sie Substack-Abonnentenzahlen, Artikeltitel und Beschreibungen von Publikationen in nur 2 Klicks — und exportieren Sie die Daten anschließend nach Excel, Google Sheets oder Notion. Ganz ohne Code; Thunderbits KI übernimmt die Strukturierung für Sie.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



