
Pokud jste někdy hledali nástroj na web scraping a narazili jste na Thunderbit i Bright Data, nejspíš jste si všimli, že to vůbec nepůsobí jako stejné typy produktů. A není to náhoda.
Jeden je AI poháněné rozšíření do prohlížeče pro byznys uživatele, kteří chtějí během pár minut dostat ze stránky strukturovaná data. Druhý je modulární platforma pro webová data s proxy sítí pokrývající více než 195 zemí, několika scraping API, spravovanými prohlížeči a certifikacemi pro enterprise compliance. Objevují se ve stejných výsledcích vyhledávání, ale řeší zásadně odlišné problémy pro zásadně odlišné lidi. Strávil jsem spoustu času tím, že jsem oba prošel do hloubky — jak fungují, kolik stojí, v čem vynikají a kde mají slabiny — a cílem je pomoct vám zjistit, který z nich opravdu sedí vašim potřebám. Ne vašim představám. Vašemu skutečnému workflow.
Thunderbit vs Bright Data v kostce
Než se do toho pustíme naplno, tady je rychlý přehled.
| Oblast | Thunderbit | Bright Data |
|---|---|---|
| Typ produktu | AI rozšíření do prohlížeče + webová aplikace + API | Platforma pro webová data (proxy, API, scrapery, datasety) |
| Hlavní uživatel | Byznys uživatelé, obchodní ops, marketéři, freelanceři | Vývojáři, datoví inženýři, enterprise datové týmy |
| Model nastavení | Nainstalujete rozšíření, otevřete stránku, scrapujete | Vyberete produkt, nastavíte přístup/scraper, spustíte |
| No-code přístup | Hlavní workflow je bez kódu | Má i no-code cesty (Scraper Studio AI Agent, hotové collectory, datasety), ale pokročilé funkce vyžadují technické nastavení |
| Cenový model | Kredity (řádky) pro rozšíření; API jednotky pro API | Cena za požadavek, záznam, GB nebo IP podle produktu |
| Přístup ke škálování | Stránka po stránce nebo plánované běhy; API pro větší úlohy | API s vysokou paralelizací, spravované prohlížeče, proxy sítě |
| Export / doručení | Google Sheets, Excel, Airtable, Notion, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, cloud storage, SFTP, e-mail, datová úložiště |
| Nejvhodnější použití | Ad hoc extrakce, lead listy, rychlý research, monitoring ve středním objemu | Velké datové pipeline, cíle s agresivní anti-bot ochranou, enterprise compliance, průběžné datové feedy |
Pokračujte ve čtení pro kompletní rozbor — funkce, ceny, reálné use casy a rozhodovací matici na konci.
Co je Thunderbit?

Thunderbit je agentní web scraper a automatizační platforma navržená pro byznys uživatele. Hlavní rozhraní tvoří rozšíření pro Chrome/Edge, doplněné o webovou aplikaci, Open API, MCP Server pro AI agent workflow a CLI.
Thunderbit je agentní web scraper: na kompatibilní a oprávněné stránce kliknete na One Click Extract a agent stránku rozpozná, přečte a zanalyzuje, aby se rozhodl, co vytáhnout. Run Now spustí úlohu okamžitě, ale když nic neuděláte, začne automaticky — takže výchozí zkušenost vyžaduje jen jeden záměrný klik, bez kódu, selektorů nebo nastavování schématu.
Základní workflow je jednoduché: otevřete stránku v prohlížeči a kliknete na One Click Extract. Agent stránku detekuje, přečte a analyzuje; Run Now může spustit vše hned, jinak extrakce začne automaticky ještě před exportem do Google Sheets, Excelu, Airtable nebo Notion. Můžete také použít Cloud Mode pro veřejné stránky, nastavit pravidelné plánované běhy a využít šablony pro populární weby. AI nejen navrhuje pole — během extrakce může také transformovat, překládat, kategorizovat, shrnovat nebo formátovat hodnoty pomocí Field AI Prompts.
Thunderbit má také Open API, které podporuje Distill (surový obsah stránky), strukturovaný Extract, asynchronní dávky, render ovládání, cílení podle země a webhooky. Primární zkušenost — tedy to, s čím pracuje většina uživatelů — je ale no-code workflow přímo v prohlížeči.
Co je Bright Data?
Bright Data je široká platforma pro infrastrukturu a doručování veřejných webových dat. Není to jeden nástroj; je to modulární systém, kde si vybíráte produkt nebo produkty podle toho, co zrovna potřebujete sbírat.
Rodina produktů zahrnuje:
- Unlocker API — přístup k odblokovanému HTML/JSON pro chráněné stránky
- SERP API — strukturované výsledky vyhledávání
- Browser API / Agent Browser — spravovaný Chromium přes Puppeteer, Playwright nebo Selenium
- Crawl API — cloud crawling, parsing a doručení dat
- Scraper APIs — hotové strukturované collectory pro populární domény
- Scraper Studio — AI Agent (no-code) nebo JavaScript IDE pro vlastní scrapery
- Datasets a Data Firehose — předpřipravené nebo průběžné datové feedy
- Proxy networks — residential (Bright Data uvádí 400M+ měsíčních residential IP ve více než 195 zemích), datacenter, ISP a mobilní proxy
- MCP Server — pro agentní workflow
Zákaznická základna Bright Data se silně orientuje na enterprise a developerské týmy. Dokumentuje ISO 27001/27017/27018, SOC 2 Type II (pod NDA), veřejné SOC 3, CSA STAR a procesy KYC / review use case. Platforma je navržená pro týmy, které potřebují hlubokou kontrolu nad proxy, prohlížečem, geolokací, session a compliance ve velkém měřítku.
Rozšíření do prohlížeče vs. proxy infrastruktura: dva odlišné přístupy k web scrapingu
Většina srovnávacích článků tenhle architektonický rozdíl úplně přeskočí — přitom právě on rozhoduje, který nástroj skutečně potřebujete.
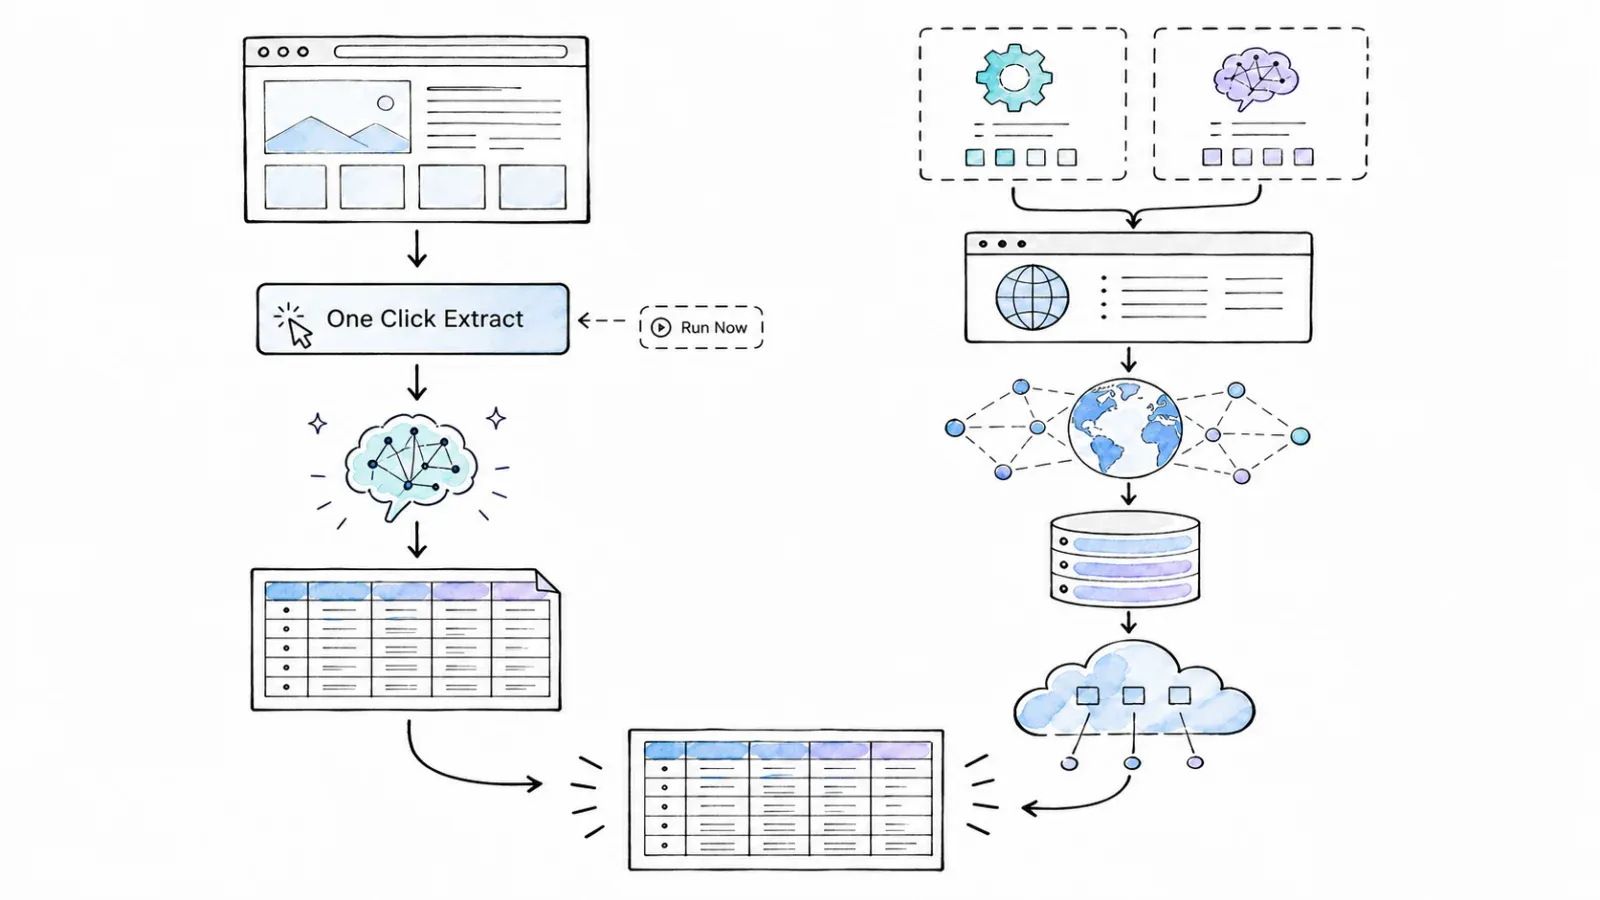
Model Thunderbitu: Nainstalujete rozšíření do prohlížeče, přejdete na stránku, ze které chcete data, a vytáhnete strukturovaná data z toho, co vidíte. AI navrhuje sloupce. Scrapujete aktuální stránku (Browser Mode může na kompatibilních stránkách využít vaši aktuální relaci) nebo přes Cloud Mode pro veřejné stránky. Berte to jako chytrou vrstvu nad copy-paste ve vašem prohlížeči — takovou, která rozumí tabulkám, seznamům i struktuře stránky.
Model Bright Data: Vyberete si produkt z modulární platformy, nastavíte přístupové údaje a logiku scrapingu (nebo ji necháte vygenerovat AI Agentem) a extrakci spustíte přes cloudovou infrastrukturu Bright Data. Požadavky mohou být směrovány přes miliony IP adres, spravované prohlížeče řeší renderování a anti-bot překážky a data se doručují přes API, webhook, cloud storage nebo jiná cílová místa. Představte si to jako infrastrukturu pro sběr dat ve velkém — vy si vybíráte potrubí, tlak i cíl.
Takto tyto architektury vypadají vedle sebe:
| Oblast | Thunderbit | Bright Data |
|---|---|---|
| Prostředí pro běh | Prohlížeč uživatele (Browser Mode) nebo cloud (Cloud Mode) | Cloudová infrastruktura Bright Data |
| Předpoklad nastavení | Nainstalovat rozšíření, otevřít stránku | Vybrat produkt, vytvořit účet, nastavit přístup/scraper |
| Anti-bot přístup | Spravované renderování na podporovaných stránkách | Rotace proxy, Unlocker, Browser API, řešení CAPTCHA, fingerprint management |
| Hlavní způsob práce | Vizuální, přímo v prohlížeči, s pomocí AI | Programově (API/SDK) nebo přes Scraper Studio (AI Agent/IDE); u některých produktů i dashboard |
| Model škálování | Stránka po stránce, plánované běhy nebo API dávky | API požadavky ve vysoké paralelizaci, spravované prohlížeče, proxy sítě |
Ani jeden přístup není univerzálně lepší. Řeší jiné problémy pro jiné lidi. Pokud chcete tabulku ze stránky, kterou právě máte otevřenou, model Thunderbitu vás k výsledku dostane rychleji. Pokud potřebujete posílat 50 000 požadavků přes rotující residential IP s renderováním ve spravovaném prohlížeči, Bright Data je pro to přímo stavěné.
No-code zkušenost: jak oba nástroje vypadají pro byznys uživatele
Jak vlastně vypadá reálný zážitek pro někoho, kdo nikdy nepracoval s API? Protože spousta lidí, kteří tyto nástroje zvažují, nejsou vývojáři — jsou to marketéři, manažeři sales ops, freelance sběrači dat nebo majitelé malých firem.
Thunderbit: postavený pro prohlížeč
Workflow Thunderbitu pro netechnického uživatele vypadá takto:
- Nainstalujete rozšíření z Chrome Web Store.
- Přejdete na stránku, ze které chcete data (adresář, produktový výpis, výsledky vyhledávání atd.).
- Kliknete na rozšíření a spustíte One Click Extract. AI stránku přečte a navrhne sloupce (např. „Company Name“, „Price“, „Rating“).
- Zkontrolujete, přejmenujete, přidáte nebo odstraníte sloupce. Můžete také přidat Field AI Prompts a transformovat data během extrakce — přeložit je do jiného jazyka, kategorizovat, shrnout, formátovat telefonní čísla atd.
- Nastavíte stránkování nebo obohacení přes podstránky, pokud potřebujete data z více stran nebo detailů.
- Run Now je volitelné. Kliknete na něj, pokud chcete okamžitý start; jinak extrakce začne automaticky. Zvolíte Browser Mode (využije vaši aktuální relaci) nebo Cloud Mode (pro veřejné stránky).
- Exportujete přímo do Google Sheets, Excelu, Airtable, Notion, CSV nebo JSON.
Celé to probíhá přímo v prohlížeči. Žádné API klíče, žádná konfigurace proxy, žádný kód. Vidíte stránku, vidíte data a rovnou je exportujete. Pro někoho, kdo potřebuje jen lead list nebo tabulku cen konkurence, je tohle skoro bez tření.
Co už vyžaduje trochu přemýšlení: úprava Field AI Prompts pro složitější formátování, práce se stránkami s neobvyklou strukturou a pochopení, kdy je dostupný Cloud Mode a kdy je potřeba Browser Mode.
Bright Data: infrastruktura s no-code vstupními body
Bright Data není jen pro vývojáře — to je častý omyl. Opravdu nabízí i no-code cesty:
- Scraper Studio AI Agent: Zadáte cílovou URL a popíšete, co chcete, přirozeným jazykem. AI se doptá na upřesnění, navrhne schéma, vygeneruje scraper a umožní vám ho testovat, publikovat a plánovat — to vše z dashboardu. Vlastní dokumentace Bright Data odhaduje vytvoření scraperu zhruba na 10–15 minut.
- Hotové Scraper APIs: Vyberete podporovaný collector pro populární doménu, zadáte vstupy a spustíte jej z ovládacího panelu nebo přes API. Strukturované záznamy se vrátí bez toho, abyste museli cokoliv stavět.
- Datasets: Zvolíte existující dataset, určíte potřeby vzorku/doručení/obnovování a dostanete data bez toho, abyste vůbec vytvářeli scraper.
- Ovládací panel Crawl API: Zadáte domény nebo URL, nastavíte výstup, spustíte crawl a výsledky stáhnete přes download, webhook nebo storage.
Ale tady je fér říct celou pravdu: většina pokročilých funkcí Bright Data — Unlocker, Browser API, raw proxy zones, SERP API, vlastní scrapers v IDE — vyžaduje výběr produktu, správu přístupových údajů a alespoň nějakou technickou konfiguraci. No-code vrstva je reálná, ale stojí na platformě navržené pro inženýry.
| Oblast | Thunderbit | Bright Data |
|---|---|---|
| Kroky k první extrakci | Nainstalovat rozšíření → otevřít stránku → AI Suggest → Scrape → export | Vytvořit účet → vybrat produkt → nastavit nebo použít AI Agent → spustit → stáhnout |
| Potřebné technické znalosti | Pro základní extrakci žádné; pro pokročilé prompty něco málo | Pro AI Agent/datasety žádné; pro API, proxy a IDE střední až vyšší |
| Čas do prvního výsledku | Minuty (dokumentovaný workflow od dodavatele) | Liší se podle produktu; AI Agent je odhadován na 10–15 min; API/proxy cesty jsou delší |
Time-to-first-scrape: jak rychle se dostanete k datům?
„Bright Data je složitější na nastavení“ — to čtete v každém srovnání konkurence, ale málokdo to kvantifikuje. Nedělal jsem kontrolovaný test na stejném cíli, takže nebudu vymýšlet čísla. Můžu ale porovnat dokumentované workflow pro běžný úkol: extrakci produktových výpisů z veřejné e-commerce stránky.
Thunderbit: dokumentovaný postup
| Krok | Co se stane |
|---|---|
| 1. Instalace rozšíření | Jednorázově, cca 1 minuta |
| 2. Otevření stránky | Cílovou URL otevřete v prohlížeči |
| 3. One Click Extract | Kliknete jednou; agent stránku detekuje, přečte a analyzuje |
| 4. Kontrola/úprava polí | Přejmenujete, přidáte, odstraníte nebo doplníte prompty |
| 5. Nastavení stránkování | V případě potřeby zapnete |
| 6. Automatický start | Run Now spustí vše hned; jinak se úloha spustí automaticky |
| 7. Export | Jedním klikem do Sheets, Excelu, Airtable, Notion, CSV nebo JSON |
Předpoklady: prohlížeč Chrome nebo Edge, nainstalované rozšíření Thunderbit, účet Thunderbitu (k dispozici je free verze).
Bright Data: dokumentované workflow (dvě cesty)
Scraper Studio AI Agent (no-code):
| Krok | Co se stane |
|---|---|
| 1. Vytvoření účtu | Registrace, ověření identity |
| 2. Otevření Scraper Studia | Přejdete do dashboardu Studia |
| 3. Zadání URL + popisu | AI popíšete, co chcete, přirozeným jazykem |
| 4. Automatická příprava | Agent určí plán extrakce; volitelné ovládací prvky mohou upřesnit specializovaný výstup |
| 5. Test scraperu | Spustíte test a zkontrolujete výstup |
| 6. Publikace + běh | Naplánujete nebo spustíte ručně |
| 7. Stažení dat | Z dashboardu, přes API, webhook nebo storage |
Scraper API (hotový collector):
| Krok | Co se stane |
|---|---|
| 1. Vytvoření účtu | Registrace, ověření identity |
| 2. Výběr collectoru | Z katalogu vyberete podporovanou doménu |
| 3. Zadání vstupů | URL, vyhledávací výrazy nebo parametry |
| 4. Spuštění | Z dashboardu nebo přes API |
| 5. Stažení dat | Strukturované záznamy v dashboardu, přes API nebo do cílového místa doručení |
Předpoklady: účet Bright Data (u některých produktů zdarma dostupné tarify), výběr produktu a — u API/proxy cest — vytvoření API klíče a konfigurace.
Shrnutí: Thunderbit je stavěný pro rychlou hodnotu u ad hoc úloh — data taháte ze stránky, na které už jste, s minimem rozhodování. Cesta přes AI Agent v Bright Data je reálná, ale platforma vás pořád nutí vybrat produkt, pochopit jednotku účtování a orientovat se ve větším dashboardu. Jednorázová úloha? Thunderbit má kratší cestu. Budujete dlouhodobý plánovaný scraper s doručením do datového skladu? Pak dává větší smysl Bright Data Studio jako investice.
Thunderbit vs Bright Data: srovnání funkcí po jednotlivých bodech
| Funkce | Thunderbit | Bright Data |
|---|---|---|
| agentní analýza stránky | One Click Extract + volitelné Field AI Prompts | Scraper Studio AI Agent (přirozený jazyk → schéma → scraper) |
| Obohacení přes podstránky | Podporováno (data z detailů se sloučí do hlavní tabulky) | Podporováno přes vlastní Studio/Browser/Crawl workflow i některé hotové collectory |
| Práce se stránkováním | Podporuje stránkování i infinite scroll | Podporováno ve Studiu, Crawl API i u hotových collectorů |
| Plánovaná extrakce | Opakované plány (Starter: až 5; Pro: až 25, minimální frekvence 5 minut) | Ve Studiu hodinové/denní/týdenní/vlastní plány; provozní monitoring/alerty |
| Cíle exportu | Google Sheets, Airtable, Notion, Excel, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, cloud storage, SFTP, e-mail, warehouses |
| Běh v prohlížeči vs. v cloudu | Browser Mode (aktuální relace) a Cloud Mode (veřejné stránky, podle tvrzení dodavatele až 50 současně) | Jen cloud; spravované prohlížeče, přes proxy směrované požadavky |
| Proxy/IP infrastruktura | Spravovaná na podporovaných plochách; API má ovládání renderování, země, hlaviček a cookies | Residential (400M+ měsíčně podle dodavatele), datacenter, ISP, mobilní; geo/session/ASN/carrier kontrola |
| Anti-bot handling | Spravované renderování / anti-bot na podporovaných stránkách a v API | Unlocker, Browser API, proxy, CAPTCHA/fingerprint/retry tooling |
| Hotové scrapery / šablony | Site templates + specializované extraktory e-mailů/telefonů/obrázků | Hotové Scraper APIs pro populární domény (počty uváděné na různých stránkách se liší; oficiální materiály zmiňují 100+ až 600+) |
| API přístup | Open API: Distill, Extract, Suggest Fields, async batches, webhooks | Více produktových API: Crawl, Unlocker, Browser, Scraper, SERP, Datasets, Proxies |
| MCP / agent podpora | Oficiální open-source MCP + CLI | Oficiální hosted MCP, Agent Browser, Search & Extract |
| Práce s dokumenty / obrázky | Dokumentované nástroje pro PDF a obrázky | Není to hlavní fokus; část parsování dat je v Crawl/Studio |
| Vícejazyčná podpora | Field AI Prompts mohou během extrakce překládat | Jazyk výstupu závisí na zdroji; vestavěný překlad při extrakci chybí |
| Compliance certifikace | Role GDPR/CCPA, DPA na vyžádání, TLS/AES; veřejně jsme nenašli SOC 2 | ISO 27001/27017/27018, SOC 2 Type II (pod NDA), veřejné SOC 3, CSA STAR, KYC |
V čem Thunderbit vyniká
- One Click Extract a vizuální workflow přímo v prohlížeči. Vidíte stránku, vidíte sloupce navržené agentem, upravíte je a scrapujete. Zpětná vazba je okamžitá.
- Extrakce jedním klikem s pojmenovanými šablonami pro populární weby a specializovanými extraktory e-mailů, telefonů a obrázků.
- Přímý export do byznys nástrojů — Google Sheets, Airtable, Notion, Excel — bez mezikroků.
- Field AI Prompts, které během extrakce data transformují, překládají, kategorizují nebo formátují. To je opravdu užitečné pro byznys uživatele, kteří potřebují čistý a hned použitelný výstup.
- Rychlá hodnota pro ad hoc a občasné scraping úlohy. Pokud potřebujete tabulku ze stránky hned teď, Thunderbit je rychlostně těžko k překonání.
V čem vyniká Bright Data
- Masivní proxy infrastruktura. Bright Data uvádí 400M+ měsíčních residential IP ve více než 195 zemích, plus datacenter, ISP a mobilní sítě. Pokud potřebujete geo-targetované, session-controlled nebo IP-diverzní požadavky, je tohle hlubší nástrojová výbava.
- Anti-bot a unblocking produkty. Unlocker, Browser API, řešení CAPTCHA, fingerprint management a retry logika jsou navržené pro silně chráněné weby (Cloudflare, DataDome, PerimeterX atd.). Skutečná úspěšnost vždy závisí na cíli a čase, ale nástroje jsou rozsáhlejší.
- Extrakce s vysokou paralelizací přes API ve velkém měřítku. FAQ Scraper Studia uvádí až 1 000 paralelních dávkových úloh na jeden scraper, než se zařadí do fronty. Více produktových API podporuje komplexní pipeline architektury.
- Hotové Scraper APIs pro populární domény, plus datasety, Data Firehose a spravovaný sběr dat pro týmy, které chtějí data spíš dostávat než scrapovat.
- Enterprise compliance certifikace. ISO 27001, SOC 2 Type II (pod NDA), SOC 3, CSA STAR a KYC jsou dokumentované a relevantní pro regulovaná odvětví i enterprise procurement.
Thunderbit vs Bright Data Pricing: kolik skutečně zaplatíte
Cenu je tady nejtěžší odpovědět poctivě. Oba nástroje měří používání úplně jinak, takže jednoduché srovnání „za stránku“ nedává smysl.
Cena Thunderbitu (stav k srpnu 2026)
No-code rozšíření Thunderbitu používá kreditový systém. Standardní scraping stojí 1 kredit za výstupní řádek; obohacení přes podstránky stojí 2 kredity za řádek; Personal Data Enrichment stojí 30 kreditů za úspěšný dotaz.
| Plán | Měsíční cena | Kredity / měsíc |
|---|---|---|
| Free | $0 | 6 stránek / měsíc, max. 30 kreditů / stránku |
| Starter | $15/měsíc | 500 / měsíc |
| Pro Tier 1 | $38/měsíc | 3 000 / měsíc |
| Pro Tier 2 | $75/měsíc | 6 000 / měsíc |
| Pro Tier 3 | $125/měsíc | 10 000 / měsíc |
| Pro Tier 4 | $249/měsíc | 20 000 / měsíc |
| Business | Individuální | Individuální |
Roční fakturace je výrazně levnější (např. Starter klesá na $108/rok za 5 000 ročních kreditů).
Open API má samostatné účtování: Distill stojí 1 API jednotku na stránku; Extract stojí 20 jednotek na stránku. API plány začínají na $16/měsíc (při roční fakturaci) za 60 000 jednotek ročně.
Cena Bright Data (stav k srpnu 2026)
Ceny Bright Data se liší podle produktu a metru. Tady jsou vstupní pay-as-you-go sazby pro klíčové produkty:
| Produkt | Free tier | PAYG vstupní sazba | Metr |
|---|---|---|---|
| Unlocker API | 5K požadavků / měsíc | $1.50 / 1K úspěšných požadavků | Úspěšné požadavky |
| SERP API | 5K požadavků / měsíc | $1.50 / 1K úspěšných požadavků | Úspěšné požadavky |
| Scraper APIs | 5K záznamů / měsíc | $1.50 / 1K doručených záznamů | Záznamy |
| Scraper Studio | 5K načtení stránek / měsíc | $1.50 / 1K načtení stránek | Načtení stránek |
| Browser API | Trial se liší | $8 / GB | Přenesená data |
| Residential proxies | PAYG | $8 / GB | Bandwidth |
| Datasets | Vzorky se liší | Od $250 / 100K záznamů | Záznamy + rozsah obnovování |
Globální navigace Bright Data někdy zobrazuje nižší ceny „od“, které odpovídají vysokým objemům nebo promo akcím. Vždy si zkontrolujte živou cenovou stránku pro konkrétní produkt, který hodnotíte.
Proč neexistuje jednoduchý vítěz v ceně
Sto kategorií po 50 řádcích může znamenat 5 000 no-code kreditů Thunderbitu (na úrovni Pro Tier 1 zhruba $38/měsíc). Stejná úloha v Bright Data může být 100 načtení stránek ve Scraper Studiu, 5 000 doručených záznamů přes Scraper API nebo variabilní bandwidth u Browser API — každé s jinou cenou. „Levnější“ nástroj závisí výhradně na:
- tom, který produkt / surface na každé platformě používáte
- kolik výstupních řádků připadá na jednu vstupní URL
- zda potřebujete stránkování, podstránky nebo renderování v prohlížeči
- měsíční vs. roční fakturaci
- retriích, chybějících polích a pravidlech pro přečerpání
Pro lehké až střední použití netechnickými týmy (několik stovek až několik tisíc řádků měsíčně) jsou kreditové plány Thunderbitu obvykle předvídatelnější a dostupnější. Pro objemné, API-driven pipeline se složitým doručením dat mohou být cenové modely Bright Data za záznam nebo za požadavek výhodnější — ale je potřeba modelovat konkrétní produkt a metr.
Před závazkem si vždy ověřte aktuální ceny na cenové stránce Thunderbitu a na příslušné cenové stránce Bright Data.
Reálné use casy: Thunderbit vs Bright Data v praxi
Funkce v tabulce neuzavírají obchody — workflow ano. Tady je pět běžných scénářů a jak je zvládne každý z nástrojů.
Vytvoření lead listu z adresáře
Scénář: Manažer sales ops potřebuje 200 kontaktů z úzce zaměřeného oborového adresáře, exportovaných do Google Sheets.
Fit pro Thunderbit: Tohle je silná stránka Thunderbitu. Otevřete adresář v prohlížeči, spusťte One Click Extract, nechte agenta analyzovat a automaticky začít a exportujte rovnou do Sheets. Žádné API, žádná proxy, žádný kód. Pokud stránka vyžaduje přihlášenou session, Browser Mode může na kompatibilních stránkách využít vaši aktuální relaci.
Fit pro Bright Data: Možné přes hotové Scraper API (pokud je adresář podporován) nebo vlastní scraper ve Scraper Studiu. Ale u 200 kontaktů z jednoho webu je režie kolem nastavení — vytvoření účtu, výběr produktu, konfigurace scraperu — hůř obhajitelná. Bright Data je navržené pro tento typ úlohy v mnohem větším měřítku (tisíce až desítky tisíc záznamů).
Monitoring cen konkurence napříč stovkami SKU
Scénář: E-commerce operations tým sleduje týdně ceny 500+ produktů na několika konkurenčních webech.
Fit pro Thunderbit: Plánovaná extrakce na podporovaných stránkách funguje dobře pro střední objemy. Nastavíte scraper pro každého konkurenta, nakonfigurujete stránkování, naplánujete týdenní běhy a exportujete do Sheets nebo Airtable. Pro 500 SKU budete pravděpodobně potřebovat Pro plán.
Fit pro Bright Data: U silně chráněných e-commerce webů (například storefronty chráněné Cloudflare) je Bright Data Unlocker nebo Browser API v kombinaci se Scraper Studio nebo Scraper API odolnější. Pokud sledujete tisíce SKU napříč desítkami webů se složitými anti-bot opatřeními, infrastruktura Bright Data je pro to přímo stavěná. Nevýhodou je větší režie a strmější křivka učení.
Jednorázový research pro market report
Scénář: Marketingový analytik potřebuje data z 5 webů pro čtvrtletní report — produktové výpisy, počet recenzí, cenové úrovně.
Fit pro Thunderbit: Ideální. Nainstalujete rozšíření, projdete jednotlivé weby, scrapujete, exportujete. Žádná investice do infrastruktury, žádný opakovaný náklad mimo plán, který už máte. To je přesně typ úlohy, kde Thunderbit vyniká svou rychlou návratností hodnoty.
Fit pro Bright Data: Zbytečně složité. Čas na nastavení a výběr produktu neodpovídá jednorázovému úkolu na 5 webech. Pokud nejsou weby silně chráněné a data jinak nezískáte, Bright Data je tady víc nástroj, než potřebujete.
Velkoobjemová datová pipeline pro engineering tým
Scénář: Datový inženýrský tým buduje automatizovanou pipeline pro sběr 100K+ stránek denně z více zdrojů s doručením do cloud datového skladu.
Fit pro Thunderbit: Open API podporuje asynchronní dávky, webhooky a podle tvrzení dodavatele škálu až na miliony stránek s až 50 souběžnými požadavky v Pro API plánu. Pro pipeline ve středním měřítku je to použitelná možnost. Thunderbit je ale primárně navržené kolem rozšíření do prohlížeče a workflow pro byznys uživatele, ne kolem infrastruktury s vysokou paralelizací.
Fit pro Bright Data: To je přesně jeho doména. Více produktových API (Crawl, Unlocker, Browser, Scraper, SERP), spravované prohlížeče, proxy sítě a doručování přes webhooky, cloud storage, SFTP a datové sklady. Scraper Studio dokumentuje až 1 000 paralelních dávkových úloh na jeden scraper. Pokud potřebujete hlubokou kontrolu proxy, geo-targeting, správu session a důkazy o enterprise compliance, je Bright Data přirozenější kandidát na vyhodnocení.
Sběr trénovacích dat pro AI / ML
Scénář: ML inženýr potřebuje strukturovaná trénovací data z stovek domén, pravidelně aktualizovaná každý měsíc.
Fit pro Thunderbit: API zvládne strukturovanou extrakci ve středním objemu a integrace přes MCP/CLI ji zpřístupňuje i pro AI agent workflow. Pro menší, dobře definované datasety to funguje.
Fit pro Bright Data: Datasets, Data Firehose a Scraper APIs jsou navržené přesně pro tohle — velké, vícedoménové, průběžně obnovované strukturované datové zdroje. MCP Server a Agent Browser přidávají agentní přístup. Pro trénovací data ve velkém má Bright Data víc možností i doručovacích cest.
Zvolte Thunderbit, když… / Zvolte Bright Data, když…
Najděte svůj řádek v tabulce níže. Buďte k sobě upřímní, ve které situaci skutečně jste.
| Pokud jste… | A potřebujete… | Zvažte… |
|---|---|---|
| Marketér nebo sales ops (netechnický) | Rychlý lead list nebo data o konkurenci, export do Sheets/Excelu | Thunderbit — rozšíření do prohlížeče, One Click Extract, přímý export |
| Solo founder nebo freelancer | Ad hoc extrakci bez investice do infrastruktury | Thunderbit — free tier, rychlé nastavení, žádné průběžné náklady na infrastrukturu |
| Operations tým se středním objemem | Týdenní monitoring několika stovek až několika tisíc řádků | Thunderbit — plánovaná extrakce, Pro plány, export do byznys nástrojů |
| Vývojář budující datovou pipeline | Vysoce objemnou extrakci přes API s rotací proxy a doručením do datového skladu | Bright Data — Crawl/Unlocker/Browser API, proxy sítě, doručení přes webhook/storage |
| Enterprise datový tým | Sběr ve velkém měřítku s certifikovaným compliance a požadavky procurementu | Bright Data — ISO/SOC certifikace, KYC, enterprise kontrola, managed acquisition |
| AI/ML inženýr | Strukturovaná trénovací data ve velkém, průběžně obnovovaná | Bright Data — Datasets, Firehose, Scraper APIs, MCP; Thunderbit API zvažte pro menší úlohy |
| Kdokoli pracující se silně chráněnými weby | Data z cílů chráněných Cloudflare/DataDome/PerimeterX ve velkém | Bright Data — Unlocker, Browser API, rotace proxy, CAPTCHA/fingerprint tooling |
Rozhodnutí není o tom, který nástroj je „lepší“. Síla Thunderbitu je v no-code jednoduchosti a rychlé návratnosti pro byznys uživatele. Síla Bright Data je v hloubce infrastruktury, odolnosti vůči anti-bot ochraně, enterprise compliance a škálování pro technické týmy. Použít jeden tam, kde se hodí druhý, je jako vzít motorovou pilu na otevření dopisu.
Compliance a ochrana dat: co by byznys uživatelé měli vědět
Žádný bezpečnostní ani compliance program dodavatele vám nedává automatické oprávnění cokoliv scrapovat. Odpovědnost za autorizovaný přístup, platné zákony, povinnosti týkající se osobních údajů a podmínky webu nese vždy uživatel. Oba nástroje vyžadují soulad se zákony o ochraně osobních údajů jako GDPR a CCPA.
Bright Data dokumentuje ISO/IEC 27001:2022, ISO 27017, ISO 27018, SOC 2 Type II (pod NDA), veřejnou zprávu SOC 3, CSA STAR, TLS 1.3, AES-256 v klidu a proces KYC / review use case. To je důležité pro regulovaná odvětví a enterprise nákupní týmy, které vyžadují auditní důkazy.
Thunderbit ve svých podmínkách a zásadách ochrany osobních údajů popisuje role podle GDPR/CCPA/CPRA, DPA na vyžádání, SCCs, TLS 1.2+ a AES-256 v klidu. Veřejně dostupnou SOC 2 attestation jsem k tomuto datu nenašel.
Pokud sbíráte osobní údaje nebo působíte v regulovaném odvětví, konzultujte to s právníkem. Compliance nástroje jsou start, ne cíl.
Thunderbit vs Bright Data: vyberte správný nástroj pro vaše skutečné potřeby
Thunderbit je AI poháněné rozšíření do prohlížeče pro byznys uživatele, kteří chtějí rychle získat strukturovaná data, bez kódu a s minimálním nastavením. Bright Data je modulární platforma pro webová data pro vývojáře a enterprise týmy, které potřebují škálování, odolnost proti anti-bot ochraně, hlubokou kontrolu proxy a důkazy o compliance ve velkém objemu.
- Pokud chcete data ze stránky v prohlížeči exportovat do Sheets během pár minut: vyzkoušejte Thunderbit.
- Pokud stavíte dlouhodobou datovou pipeline s inženýrskými zdroji a enterprise požadavky: vyhodnoťte Bright Data.
- Pokud jste někde mezi tím: začněte jednodušším nástrojem a přejděte na těžší, až vaše potřeby přerostou jeho možnosti. To není vyhýbání se odpovědi — takhle se workflow většiny týmů ve skutečnosti vyvíjejí.
Časté dotazy
Co je levnější, Thunderbit nebo Bright Data?
Pro lehké až střední použití netechnickými týmy (několik stovek až několik tisíc řádků měsíčně) jsou kreditové plány Thunderbitu obecně dostupnější a předvídatelnější. Ceny Bright Data jsou navržené pro vysoké objemy a infrastrukturní použití a liší se podle produktu i metru (za požadavek, za záznam, za GB, za IP). Přímé cenové srovnání vyžaduje shodu konkrétního produktu, objemu a účtovací jednotky. Vždy si zkontrolujte cenovou stránku Thunderbitu a příslušnou cenovou stránku Bright Data pro aktuální sazby.
Můžu používat Thunderbit a Bright Data dohromady?
Ano. Některé týmy používají Thunderbit pro rychlé, ad hoc extrakce (vyhledání leadů, jednorázový research, malé monitoringové úlohy) a Bright Data pro rozsáhlé nebo silně chráněné cíle, které vyžadují proxy infrastrukturu. Tento „hybridní“ přístup vám umožní vybrat nástroj podle úlohy bez zbytečné investice do nastavení u jednoduchých úkolů nebo bez podinvestování do infrastruktury u složitých.
Potřebuji k používání Thunderbit nebo Bright Data programovací dovednosti?
Thunderbit: Pro workflow rozšíření do prohlížeče není kód potřeba. Open API, MCP a CLI už ale technické znalosti vyžadují. Bright Data: Scraper Studio AI Agent, hotové collectory a datasety jsou low-code možnosti, které nevyžadují psaní skriptů. Většina pokročilých funkcí — Unlocker, Browser API, raw proxy zones, vlastní IDE scrapery — ale vyžaduje zapojení vývojářů. Plný potenciál Bright Data znamená technickou konfiguraci.
Je Thunderbit nebo Bright Data lepší pro scraping LinkedIn?
Thunderbit umí vytáhnout data ze stránek, ke kterým máte ve svém prohlížeči oprávněný přístup (např. vaše vlastní relace na LinkedInu na kompatibilních stránkách). Bright Data nabízí hotové Scraper APIs pro LinkedIn přes své API. Oba nástroje vyžadují dodržování podmínek služby LinkedIn i platných zákonů. LinkedIn je v prosazování pravidel velmi tvrdý, takže postupujte opatrně bez ohledu na to, který nástroj zvolíte. Více o přístupech k lead generation najdete v našem průvodci.
Co když Thunderbit přeroste mé potřeby — můžu později přejít na Bright Data?
Rozhodně. Thunderbit exportuje do standardních formátů (CSV, JSON, Excel, Google Sheets), které lze importovat do jakékoli pipeline. Pokud vaše datové potřeby narostou nad to, co zvládne rozšíření nebo API Thunderbitu — nebo pokud budete potřebovat hlubší proxy, anti-bot nebo compliance infrastrukturu — můžete přejít na Bright Data (nebo ho používat paralelně s Thunderbitem), aniž byste přišli o svá data nebo workflow. Tyto dva nástroje vás nespoutávají.
Další čtení




