
Vybrat si mezi Thunderbit a Apify je trochu jako rozhodovat se mezi vrtačkou a celou obráběcí dílnou. Obojí udělá do zdi díru, ale zážitek — i účet — budou úplně jiné. Thunderbit je agentní webový scraper.
Thunderbit je agentní webový scraper: na kompatibilní a povolené stránce kliknete na One Click Extract a agent stránku rozpozná, přečte a zanalyzuje, aby se rozhodl, co vytáhnout. Run Now spustí extrakci okamžitě, ale když neuděláte nic, úloha se spustí sama — takže výchozí zážitek vyžaduje jen jedno vědomé kliknutí, bez kódu, selektorů nebo nastavování schématu.
Web scraping nástroje už roky nejen stavím a testuji (náš tým v Thunderbit vytvořil vlastní řešení, takže mám i pár osobních názorů) a otázka, kterou pořád slyším od sales ops lidí, marketingových analytiků i zakladatelů, je pořád stejná: „Který z nich bych měl vlastně používat?“ Každý srovnávací článek online vypisuje funkce v hezkých tabulkách, ale žádný vám neukáže, jaké to ve skutečnosti je, když oba nástroje použijete na stejný úkol. A právě tuhle praktickou mezeru jsem chtěl zaplnit. Provedu vás reálnými workflow, cenovými modely, vývojářskými možnostmi a — hlavně — upřímným doporučením, kdy je který nástroj lepší volba. Žádné účelové argumenty, žádné lakování na růžovo. Jen fakta, pár tabulek a několik špatných vtipů.
Co jsou Thunderbit a Apify (a pro koho jsou určené)?
Thunderbit je AI web scraper dostupný jako rozšíření pro Chrome a Edge (a také jako webová aplikace), určený pro byznys uživatele, kteří chtějí rychle získat strukturovaná data z webových stránek — bez kódu. Otevřete stránku, kliknete na "One Click Extract" a necháte agenta stránku analyzovat; "Run Now" začne okamžitě, zatímco nic neuděláte, extrakce se spustí automaticky. Výsledek pak můžete exportovat do Excelu, Google Sheets, Airtable nebo Notion. Cílí přímo na sales týmy, operation manažery a výzkumníky, kteří se nechtějí učit CSS selektory ani spouštět cloudový kontejner. Rozšíření má na Chrome Web Storu 100 000+ uživatelů.

Apify je cloudová platforma pro web scraping, automatizaci prohlížeče a extrakci dat — ve skutečnosti je to ale plnohodnotná aplikační platforma. Její hlavní součástí je Actor Store, tržiště s desítkami tisíc předpřipravených nástrojů (tzv. "Actors"), které pokrývají všechno od scraperů produktů z Amazonu po extraktory pro sociální sítě. Můžete spustit Actor ze Store přes grafický formulář bez psaní kódu, nebo si vytvořit vlastní Actor v JavaScriptu či Pythonu pomocí Apify SDK a Crawlee (jejich open-source crawling knihovny s přibližně 25 000 hvězdičkami na GitHubu). Publikum Apify sahá od netechnických uživatelů, kteří spouštějí hotové Actors, až po engineering týmy stavějící komplexní a plánované datové pipeline. Platforma uvádí 74 000 zákazníků a zpracuje přes 1 PB dat měsíčně.
Zásadní rozdíl je jednoduchý. Thunderbit je navržený pro agentní, jedním kliknutím spuštěnou extrakci ze stránky, kterou právě vidíte. Apify je širší platforma, kde si vyberete (nebo vytvoříte) správného Actora pro daný úkol a pak ho orchestrujete pomocí plánování, webhooků, úložiště a proxy.
Úkol: Co jsem se rozhodl scrapovat (a proč je to důležité pro Thunderbit vs Apify)
Aby bylo rozhodování konkrétní, zvolil jsem úkol, který odpovídá tomu, co sales a ops týmy skutečně dělají: extrakci produktových výpisů z veřejné kategorie na e-commerce webu. Představte si název produktu, cenu, hodnocení a URL produktu — zkrátka strukturovaná data, která chcete pro konkurenční analýzu, seznamy leadů nebo produktový průzkum.
Je to záměrně jednoduchý a reprezentativní úkol. Přesně ten typ, kdy chcete přejít z „dívám se na tuhle stránku“ na „mám čistou tabulku“ během minut, ne hodin. Níže ukazuji, jak si s každým krokem poradí oba nástroje — od nastavení přes konfiguraci polí až po spuštění scrapu a dostání dat do Google Sheets.
Krátká poznámka k upřímnosti: nedělal jsem řízený laboratorní benchmark se zmrazenými verzemi, identickým retry nastavením a zlatým referenčním datasetem. (Na to by byl potřeba výzkumný tým a měsíc času.) Místo toho jsem si prošel reálný workflow v obou nástrojích, zdokumentoval jednotlivé kroky a porovnal zkušenost. Kde nemohu tvrdit přímé srovnání „jablka s jablky“ — třeba u ceny na stránku nebo přesnosti — řeknu to rovnou.
Krok za krokem: Thunderbit vs Apify na stejném scrape úkolu
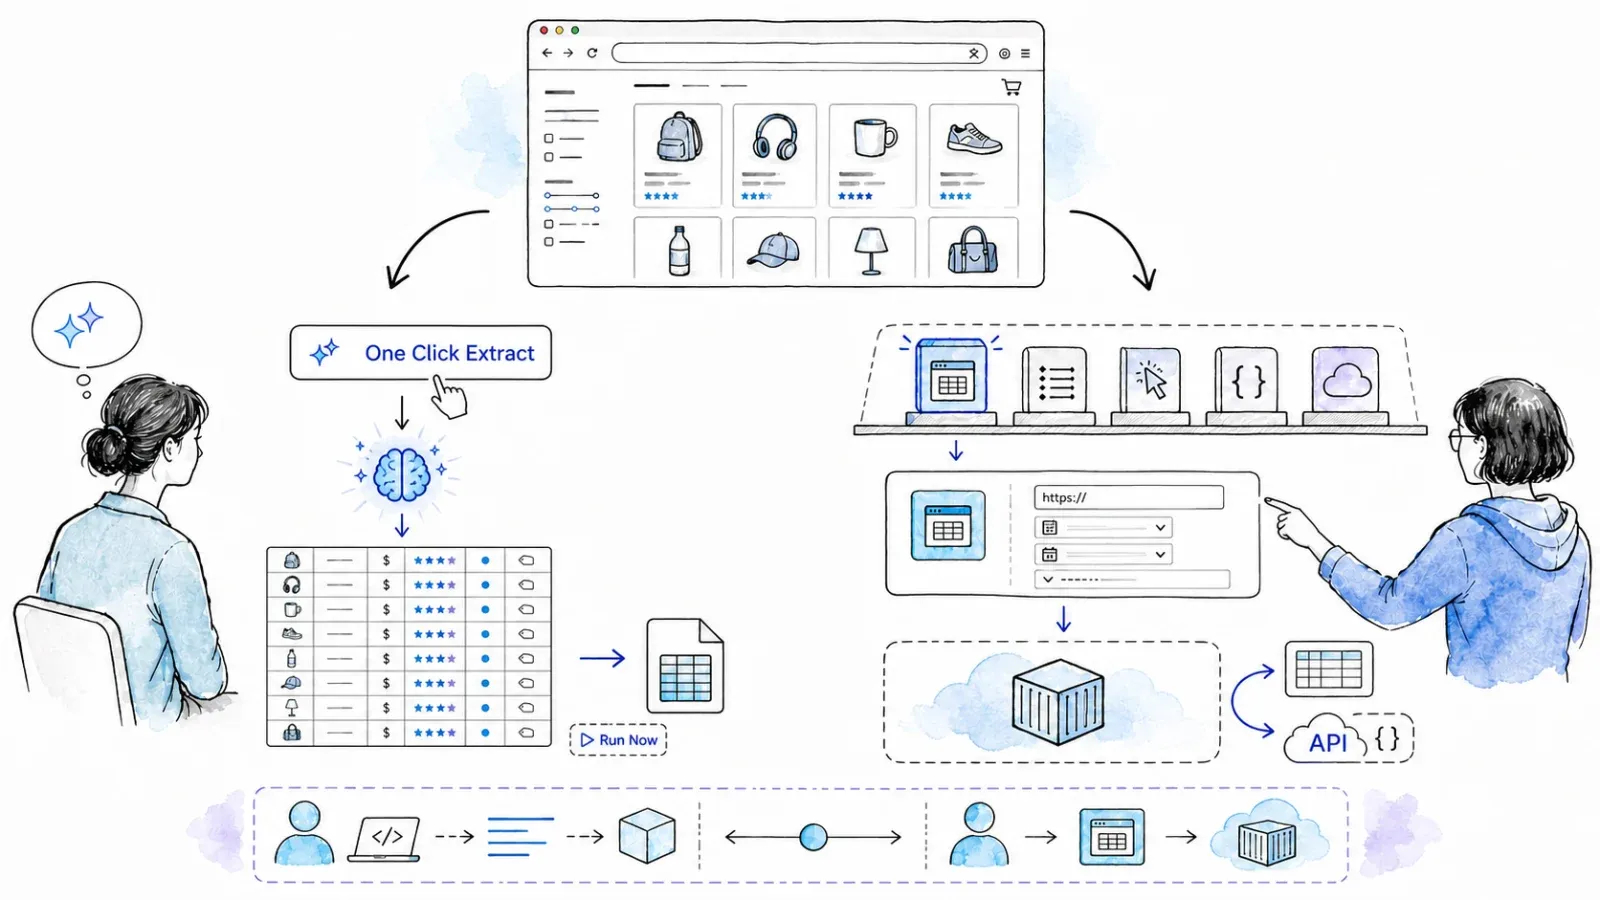
Tohle je část, kterou vám žádný jiný srovnávací článek nedá: skutečný workflow, krok za krokem, v obou nástrojích.
Nastavení: instalace a vytvoření účtu
Thunderbit: Nainstalujete si rozšíření Thunderbit pro Chrome z Chrome Web Storu. Žádný kód, žádný server, žádný Docker kontejner. Zaregistrujete se a můžete začít. Onboarding je zhruba stejně složitý jako instalace blokátoru reklam.
Apify: Zaregistrujete se na apify.com, čímž získáte přístup do Console — webového dashboardu pro správu Actorů, běhů, úložiště, plánování a integrací. Odtud procházíte Actor Store, abyste našli předpřipravený scraper odpovídající cílovému webu. Pokud chcete stavět vlastní řešení, použijete Web IDE, CLI nebo lokální vývojové prostředí.
Nastavení Thunderbit je instalace browser rozšíření. Nastavení Apify je registrace do webové aplikace a následné hledání (nebo tvorba) správného Actora. Obojí lze začít zdarma.
Konfigurace polí: One Click Extract vs výběr Actora v Apify
Thunderbit: Jakmile jste na stránce, kterou chcete scrapovat, kliknete na "One Click Extract." AI přečte stránku a navrhne sadu sloupců — třeba Product Name, Price, Rating, URL. Extrakce se může spustit i automaticky bez dalšího nastavování. Pokud potřebujete specializovaný výstup, můžete přidat vlastní instrukce na úrovni pole (např. „vytáhni jen číselnou cenu, bez symbolu měny“). Žádná kontrola DOM, žádné CSS selektory, žádný kód.
Apify: V Actor Store vyhledáte scraper, který odpovídá vašemu cíli (např. obecný web scraper nebo Actor pro konkrétní web). Každý Actor má vlastní vstupní schéma — některé jsou jednoduché jako „vložit URL a kliknout Start“, jiné vyžadují nastavení selektorů, pravidel pro stránkování, proxy nebo výstupních polí. Pokud neexistuje předpřipravený Actor, který by seděl, možná si budete muset vytvořit nebo upravit vlastní v JavaScriptu či Pythonu.
Thunderbit za vás detekci polí udělá pomocí AI. Předpřipravené Actors v Apify to u podporovaných webů zvládnou také automaticky, ale vlastní nebo generické Actors často vyžadují ruční konfiguraci vstupu.
Spuštění scrapu a práce se stránkováním
Thunderbit: Můžete kliknout na "Run Now" a spustit akci ihned; jinak se rozšíření spustí automaticky a stránku zpracuje. Pokud je na webu stránkování nebo nekonečný scroll, Thunderbit na kompatibilních stránkách zvládá stránkování v rámci vestavěného workflow. Řádky sledujete přímo v prohlížeči, jak se postupně plní.
Apify: Actor spustíte z Console (nebo přes API/CLI). Zpracování stránkování závisí na Actorovi — některé ho řeší automaticky, jiné vyžadují nastavení přímo ve vstupu. Běh probíhá v cloudu a průběh, logy i výsledky sledujete v Console.
Thunderbit běží v prohlížeči (Browser Mode) nebo v cloudu (Cloud Mode). Apify běží vždy v cloudu. Stránkování je v Thunderbit vestavěné; v Apify záleží na konkrétním Actorovi.
Export výsledků: dostat data do Google Sheets, Excelu nebo Airtable
Thunderbit: Jakmile je scrape hotový, exportujete přímo do Excelu, CSV, JSON, Google Sheets, Airtable nebo Notion — všechno z rozšíření nebo webové aplikace. U většiny cílů jde o export jedním kliknutím.
Apify: Výsledky se ukládají do Datasetu v Console, odkud je můžete stáhnout jako JSON, CSV, XML, Excel nebo HTML. Pro Google Sheets můžete použít integraci Apify nebo si nastavit workflow přes webhook / Zapier / Make / n8n. Je to flexibilnější, ale pro netechnického uživatele to znamená více kroků.
Export v Thunderbit je přímý a vestavěný. Export v Apify je výkonný a programovatelný, ale pro byznys nástroje může vyžadovat další konfiguraci.
Přehled vedle sebe
| Krok | Thunderbit (browser extension) | Apify |
|---|---|---|
| Nastavení / účet | Instalace Chrome rozšíření, bez kódu | Registrace, Actor Store nebo SDK |
| Konfigurace polí | One Click Extract → agentní analýza | Výběr předpřipraveného Actora nebo nastavení vstupního schématu |
| Spuštění scrapu | Kliknutí na "Scrape" v prohlížeči | Spuštění Actor běhu v Console nebo přes API |
| Zpracování stránkování | Vestavěné workflow stránkování (na kompatibilních stránkách) | Závisí na Actorovi (liší se podle šablony) |
| Export | Do Excelu, Google Sheets, Airtable, Notion | Stažení CSV/JSON, API webhook, integrace |
| Je potřeba kód? | Ne (pro rozšíření / Web App) | Ne u hotových Actorů; ano u vlastních Actorů |
Agentní analýza stránky vs ruční selektory: kdy který přístup vítězí a kdy selhává
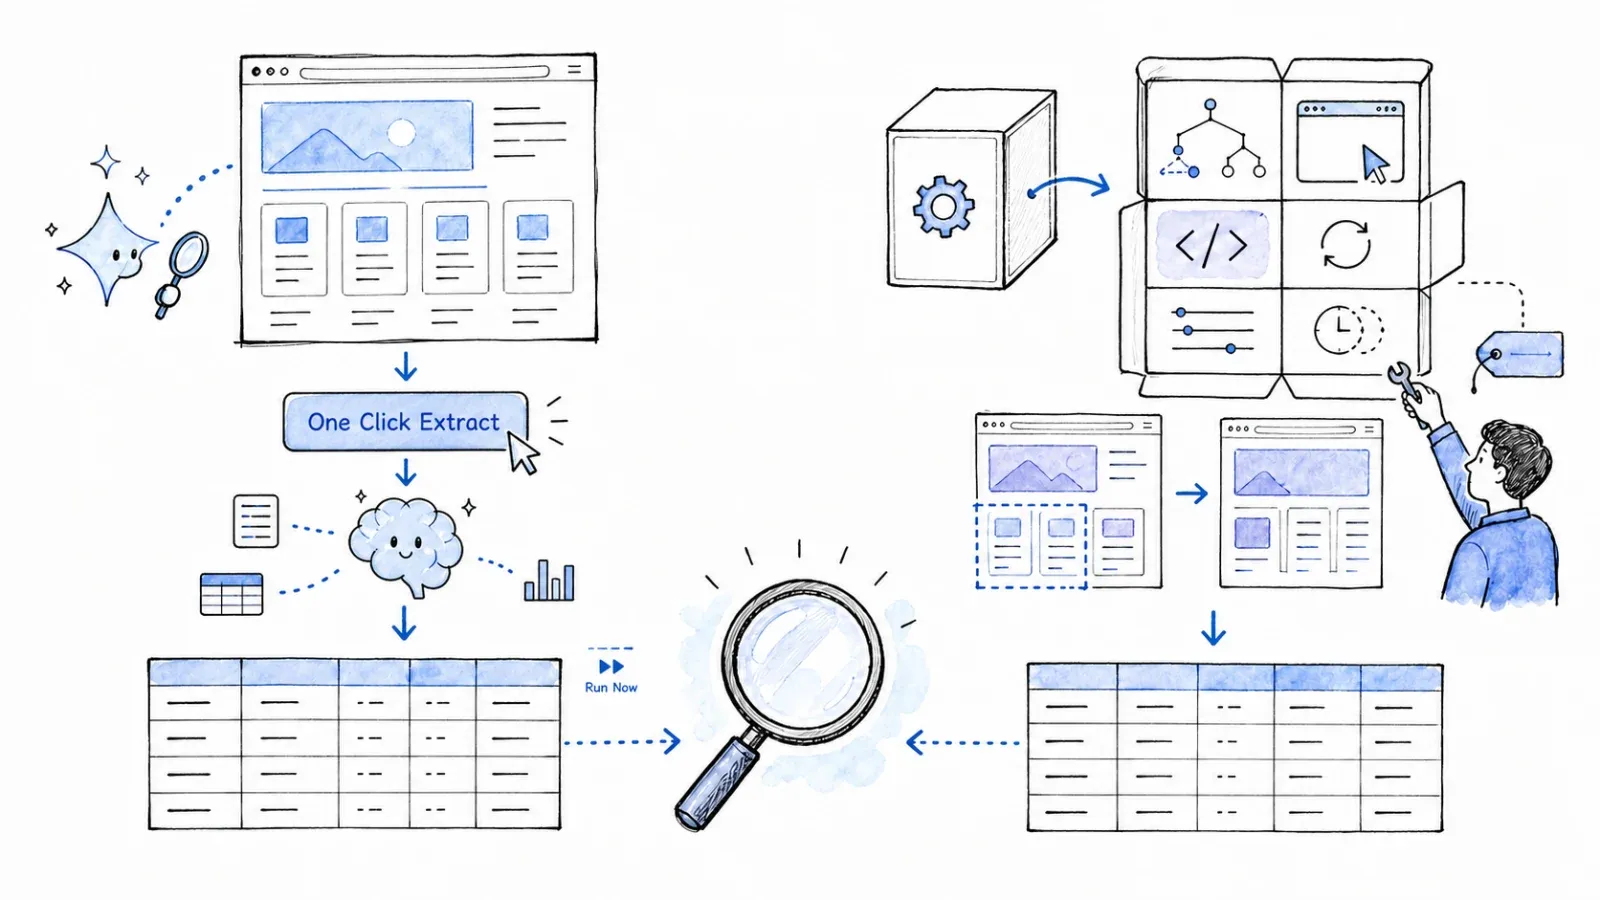
Jedním z největších praktických rozdílů mezi Thunderbit a Apify je jak nástroji řeknete, která data mají vytáhnout. Thunderbit používá agentní analýzu stránky; Apify (podle konkrétního Actora) používá přednastavené selektory, vysokou úroveň vstupních polí nebo vlastní kód. Ani jeden přístup není univerzálně lepší — každý má silné stránky i reálné slabiny.
Kdy agentní analýza stránky září (Thunderbit)
- Neznámé weby, ad hoc extrakce: Přijdete na stránku, kterou jste ještě nikdy nescrapovali. AI v Thunderbit přečte rozložení a navrhne sloupce. Není potřeba zkoumat DOM nebo psát selektory.
- Rychlé nastavení pro netechnické uživatele: Pokud nevíte, co je CSS selektor, One Click Extract je záchrana.
- Změny layoutu webu: Protože AI si stránku při každém spuštění znovu přečte, dokáže na kompatibilních stránkách reagovat i na menší změny rozložení. (I tak ale vlastní Terms upozorňují, že AI výstup může být nepřesný a měl by se nezávisle ověřit — výsledky proto vždy zkontrolujte.)
Kdy mají navrch ruční selektory nebo konfigurace specifická pro Actora (Apify)
- Vysoce strukturovaný, stabilní HTML: Pokud je HTML webu dobře uspořádané a často se nemění, dobře postavený Actor s přesnými selektory může dávat spolehlivý a deterministický výstup.
- Složitý vnořený nebo dynamický obsah: Vlastní Actors vám dávají plnou kontrolu — zvládnete přihlašovací flow, vícekrokovou navigaci, API volání i složité JavaScriptové renderování.
- Niche nebo site-specific Actors: Actor Store může mít nástroj přímo pro váš cíl (např. Amazon, Google Maps, LinkedIn) s poli přizpůsobenými struktuře daného webu.
Upřímné slabiny
- agentní analýza stránky (Thunderbit): Může špatně vyhodnotit nejasné rozložení, seskupit pole nečekaně nebo přehlédnout data na stránkách s netypickou strukturou. Výstupy s vysokou důležitostí po extrakci ověřte.
- Ruční selektory (Apify): Rozbijí se, když web změní HTML. Community Actors nemusí být aktualizované včas. Vlastní Actors vyžadují průběžnou údržbu.
Rychlé srovnání: AI detekce vs ruční selektory
| Scénář | agentní analýza stránky (Thunderbit) | Ruční selektory / konfigurace Actora (Apify) |
|---|---|---|
| Neznámý web, ad hoc extrakce | ✅ Rychlé nastavení, bez zkoumání DOM | ⚠️ Může vyžadovat analýzu struktury stránky nebo hledání vhodného Actora |
| Web s vysoce strukturovaným, stabilním HTML | ✅ Funguje dobře, ale doporučuje se ruční kontrola | ✅ Přesné a spolehlivé, pokud jsou selektory / Actor dobře postavené |
| Složitý vnořený nebo dynamický obsah | ⚠️ Může vyžadovat instrukce na úrovni pole nebo ruční úpravy | ✅ Plná kontrola přes vlastní kód Actora |
| Dojde k redesignu webu | ✅ AI stránku při dalším běhu znovu analyzuje (výsledky je třeba zkontrolovat) | ⚠️ Selektory se mohou rozbít a Actor je potřeba aktualizovat |
Ani jeden přístup není „nastav a zapomeň“. Oba vyžadují dohled a kontrolu. Rozdíl je v tom, kde se ta práce projeví.
Thunderbit vs Apify: vysvětlení cenových modelů (proč jednoduchá tabulka ceny za stránku nefunguje)
Cenotvorba je na tomhle rozhodnutí nejzáludnější část a chci být naprosto upřímný: nepůjde jednoduše vydělit cenu tarifu počtem stránek a dostat smysluplné číslo. Oba nástroje používají zásadně odlišné účtovací jednotky.
Jak funguje cenový model Thunderbit
No-code tarify Thunderbit účtují podle creditů, kde 1 standardní výstupní řádek = 1 credit, 1 řádek na subpage = 2 kredity a enrichments / pokročilé funkce stojí víc. Tady je přehled z Thunderbit pricing page (před opřením se o tato čísla si ověřte aktuální stav):
| Tarif | Měsíčně | Ročně | Credity |
|---|---|---|---|
| Free | $0 | $0 | 6 stránek / měsíc (aktuální limit viz živá tabulka tarifů) |
| Starter | $15 / měsíc | $108 / rok | 500 / měsíc nebo 5 000 / rok |
| Pro 1 | $38 / měsíc | $288 / rok | 3 000 / měsíc nebo 30 000 / rok |
| Pro 2 | $75 / měsíc | $576 / rok | 6 000 / měsíc nebo 60 000 / rok |
| Pro 3 | $125 / měsíc | $1 152 / rok | 10 000 / měsíc nebo 120 000 / rok |
| Pro 4 | $249 / měsíc | $2 304 / rok | 20 000 / měsíc nebo 240 000 / rok |
Důležité: „stránky“ v označení free tarifu a „výstupní řádky“ v pravidlech pro kredity nejsou totéž. Jedna produktová stránka může vytvořit mnoho řádků.
Thunderbit má také samostatný cenový model API pro vývojáře (Distill = 1 jednotka / stránka, Extract = 20 jednotek / stránka, roční jednotky jsou vydávány předem).
Jak funguje cenový model Apify
Apify účtuje podle compute units (CUs) — kde 1 CU = 1 GB RAM alokovaný na 1 hodinu — a k tomu se mohou připočítat náklady na proxy traffic, úložiště, přenos dat a event poplatky specifické pro Actora. Tady je přehled z Apify pricing page (ověřte aktuální stav):
| Tarif | Měsíčně / ročně | Zahrnuté využití platformy | Sazba CU |
|---|---|---|---|
| Free | $0 | $5 / měsíc | $0.20 / CU |
| Starter | $29 / $26 | $29 / měsíc | $0.20 / CU |
| Scale | $199 / $179 | $199 / měsíc | $0.16 / CU |
| Business | $999 / $899 | $999 / měsíc | $0.13 / CU |
Důležité: Skutečná spotřeba CU závisí na přidělené RAM Actora a délce běhu, ne na počtu stránek nebo řádků. Store Actors mohou také účtovat per event (PPE) nebo per usage (PPU), s cenotvorbou definovanou tvůrcem. Náklady na proxy, úložiště a přenos se mohou výrazně nasčítat, hlavně ve větším měřítku.
Proč tady nezveřejňuji tabulku ceny za stránku
Vím, že osnovu měl doplňovat srovnávací tabulkový výpočet pro 100 / 1 000 / 10 000 stránek. Nebudu si ale vymýšlet, a to z těchto důvodů:
- Thunderbit kredity ≠ Apify compute units ≠ stránky ≠ řádky.
- Cena běhu v Apify závisí na Actorovi, jeho RAM, době běhu, proxy / úložišti a na tom, zda se účtuje per event nebo per usage.
- Cena scrape v Thunderbit závisí na počtu výstupních řádků, obohacení subpages a na tom, zda používáte rozšíření nebo API.
- Bez spuštění úplně stejného úkolu na úplně stejném webu v obou nástrojích a bez měření všech proměnných by jakékoli číslo „ceny za stránku“ bylo zavádějící.
Moje doporučení: Pro menší, ad hoc scraping mohou free tarify obou nástrojů úkol pokrýt. S rostoucím objemem je credit model Thunderbit pro jednoduchou extrakci předvídatelnější, zatímco CU model Apify může být nákladově výhodnější u velkých, dlouho běžících nebo složitých pipeline — ale jen pokud rozumíte spotřebě zdrojů vašeho Actora a umíte ji optimalizovat. Vždy si zkontrolujte aktuální ceníky a pokud možno si před závazkem otestujte malý vzorek ve své skutečné škále.
Pro vývojáře: Thunderbit API, MCP a CLI vs Apify Actor SDK
Pokud jste vývojář — nebo polotechnický hodnotitel, který řeší, zda nástroj poroste s týmem — tahle část je pro vás.
Vývojářské možnosti Thunderbit
Thunderbit nabízí tři vývojářské vstupní body, všechny zaměřené na řízenou extrakci webových stránek:
- Open API: HTTP/JSON endpointy pro Distill (vrací Markdown připravený pro LLM) a Extract (vrací strukturovaný JSON podle vašeho schématu), plus asynchronní Batch workflow s podporou webhooků / polling. Render režimy zahrnují
none,basicafull; spravované funkce zahrnují rotaci proxy, geo-routing, retry a anti-bot handling (s omezeními — žádný cíl není zaručený). - MCP Server: Balíček
@thunderbit/mcp-serverzpřístupňuje Distill, Extract, Suggest Fields a batche kompatibilním AI hostům (Claude, Cursor, Windsurf atd.). - CLI: Balíček
@thunderbit/thunderbit-clipodporuje terminálové i coding-agent workflow s výstupem do JSON / Markdown / tabulek.
Co Thunderbit developer nástroje nejsou: Nejde o univerzální runtime pro Actors / kontejnery. Nemůžete v nich stavět a nasazovat libovolné aplikace, publikovat nástroje na marketplace ani orchestrálně řídit vícekrokové workflow s trvalými frontami a úložištěm. Abstrakce je řízená extrakce — pošlete URL a dostanete strukturovaná data zpět.
Vývojářské možnosti Apify
Vývojářský ekosystém Apify je širší a hlubší:
- REST API v2: Plná kontrola nad Actori, běhy, buildy, tasky, plánováním, webhooky a úložištěm. Oficiální JavaScript a Python klienti zvládají retry i limity.
- Actor SDK: Vlastní Actors stavíte v JavaScriptu nebo Pythonu pomocí Apify SDK a / nebo Crawlee (open-source, Apache-2.0, přibližně 25 000 hvězdiček na GitHubu). Crawlee podporuje HTTP / Cheerio / JSDOM / Playwright / Puppeteer a více prohlížečů.
- CLI:
apify-clipro vyhledávání / spouštění Actorů, vytváření / push / pull projektů a konfiguraci MCP. - Actor Store: Desítky tisíc komunitních i Apify spravovaných Actorů. Můžete publikovat i vlastní.
- Scheduling: Vestavěné plánování ve stylu cronu s podporou časových pásem i DST (až 10 Actorů a 10 Tasků na plán).
- Webhooks: Události životního cyklu Actoru / buildu, retry a exponenciální backoff.
- Storage: Datasety, key-value úložiště a request queue.
- Proxy: Datacenter, residential a Google SERP proxy produkty s možností rotace, session a geo nastavení.
- MCP: Hosted i lokální MCP endpointy pro AI-agent integrace (s omezeními danými oprávněními a modely Actorů).
- Integrations: Make, n8n, Zapier, GitHub, Google Sheets, AI frameworky (LangChain, LlamaIndex) a další.
Tabulka srovnání vývojářských možností
| Možnost | Thunderbit | Apify |
|---|---|---|
| API přístup | Open API (Distill, Extract, async Batch) | Full REST API v2 + Actor SDK |
| Podpora jazyků | HTTP/JSON (nezávislé na jazyku) | JavaScript/Python SDK |
| Integrace s AI agenty | MCP Server, plugin pro Claude Code | MCP, komunitní LLM integrace |
| CLI / terminál | @thunderbit/thunderbit-cli | apify-cli |
| Marketplace vlastních scraperů | N/A | Actor Store (desítky tisíc Actorů) |
| Plánování | Závislé na tarifu | Vestavěné, ve stylu cronu |
| Úložiště | Na úrovni účtu (orientace na export) | Datasety, key-value stores, request queues |
| Správa proxy | Řízená (API), bez uživatelského nastavení | Datacenter, residential, SERP, konfigurovatelné |
| Nasazení | SaaS (bez vlastního deploye) | Web IDE, push přes CLI, Git, Docker, Standby |
Pokud potřebujete „dostat strukturovaná data z URL“, je Thunderbit API přímé a spravované. Pokud ale chcete stavět, nasazovat a orchestrálně řídit vlastní scrapingové / automatizační aplikace ve velkém měřítku, Apify vám dává mnohem víc stavebních bloků — ale také strmější křivku učení a více pohyblivých částí.
Kdy zvolit Thunderbit (upřímné doporučení)
Tady jsem zaujatý — jsem spoluzakladatel Thunderbit — ale zkusím být stejně upřímný, jako bych chtěl, aby byli lidé ke mně.
Thunderbit je lepší startovní volba, když:
- Jste netechnický uživatel (sales, ops, marketing, research), který chce strukturovaná data z webové stránky hned teď, bez učení kódu nebo nastavování selektorů.
- Chcete agentní analýzu stránky, která stránku přečte a navrhne sloupce za vás.
- Váš workflow je ad hoc: kontrola konkurenčních cen, extrakce leadů, produktový průzkum nebo rychlé natažení dat do tabulky či Airtable.
- Chcete přímý, vestavěný export do Excelu, Google Sheets, Airtable nebo Notion — bez nastavování webhooků nebo integrací.
- Záleží vám víc na rychlosti prvního výsledku než na hluboké customizaci. (Podle mé zkušenosti většina byznys uživatelů raději dostane čistá data za 5 minut než 47 možností nastavení.)
- Chcete při extrakci používat už přihlášenou session ve vašem prohlížeči u stránek, které vyžadují autentizaci (Browser Mode).
Kdy Thunderbit nemusí být nejlepší volba:
- Velmi rozsáhlé a opakované pipeline s komplexní orchestrací.
- Weby, které vyžadují vícekrokovou navigaci, vlastní přihlašovací flow nebo pokročilé anti-bot řešení nad rámec toho, co spravovaný systém podporuje.
- Týmy, které chtějí vytvářet a distribuovat vlastní scrapingové nástroje nebo aplikace.
Uživatelské recenze na Chrome Web Storu vyzdvihují pohodlí rozšíření a AI nastavení polí jako jeho hlavní přednosti.
Kdy zvolit Apify (upřímné doporučení)
Tahle část není žádná úlitba — je to rada, kterou bych dal kamarádovi. Apify je opravdu silná platforma a pro některé případy použití je to přesně správný nástroj.
Apify je lepší startovní volba, když:
- Potřebujete stavět vlastní Actors pomocí SDK pro složité vícekrokové crawlingy, automatizaci prohlížeče nebo zpracování dat.
- Váš tým provozuje velkoobjemové plánované pipeline s webhook integracemi, trvalým úložištěm a request queue.
- Chcete přístup na marketplace komunitně spravovaných scraperů pro niche weby (v Actor Store je jich desítky tisíc).
- Potřebujete pokročilou správu proxy a orchestraci headless prohlížečů ve velkém — datacenter, residential nebo SERP proxy s rotací a řízením session.
- Váš workflow sahá dál než scraping: vyplňování formulářů, automatizace sociálních sítí, API backendy nebo nástroje pro AI agenty.
- Chcete publikovat a distribuovat vlastní nástroje ostatním uživatelům přes Store.
Kdy Apify nemusí být nejlepší volba:
- Netechnickí uživatelé, kteří chtějí jen rychle, bez kódu získat data z právě otevřené stránky. (Hotové Actors pomáhají, ale hledání a konfigurace může být pořád překážka.)
- Týmy, které chtějí okamžitou agentní analýzu stránky bez nastavování vstupních schémat nebo selektorů.
- Uživatelé, kteří chtějí přímý export do Airtable nebo Notion jedním kliknutím bez nastavování integrací.
Apify získává velmi dobrá hodnocení na recenzních platformách — zhruba 4,7/5 na G2 a 4,8/5 na Capterře — a lidé chválí šíři Actorů, řízenou infrastrukturu a ekosystém plánování / integrací. Mezi časté výtky patří proměnlivá kvalita Actorů (community Actors nemusí být vždy udržované), složitější hledání, strmější křivka učení pro vlastní vývoj, náročnější debugging a horší předvídatelnost nákladů.
Poznámka ke kvalitě Actorů: Ne každý Actor ve Store je udržován nebo kontrolován stejně. Community Actors jsou odpovědností svých autorů a kvalita se liší. Než svěříte Actorovi citlivá data nebo byznysově kritický workflow, vždy si zkontrolujte maintainera, oprávnění, verzi, historii běhů a ukázkový výstup.
Thunderbit vs Apify: kompletní tabulka srovnání funkcí
Tahle tabulka shrnuje všechny hlavní dimenze z předchozích částí:
| Dimenze | Thunderbit | Apify |
|---|---|---|
| Primární publikum | Netechnickí byznys uživatelé, sales/ops/research | Vývojáři, datové týmy, techničtí operátoři (s no-code cestami pro hotové Actors) |
| Jádro produktu | AI web scraper (rozšíření pro Chrome/Edge + Web App) | Cloudová platforma kolem Actorů (scraping, automatizace, aplikace) |
| agentní analýza stránky | One Click Extract (agent analyzuje; Run Now nebo automatický start) | Závislé na Actorovi (některé používají AI; většina používá nakonfigurované selektory / vstupy) |
| No-code cesta | Ano (rozšíření / Web App) | Ano (hotové Actors přes formuláře v Console, Apify AI beta, MCP, Tasks) |
| Vlastní kód | Není potřeba pro rozšíření; API / MCP / CLI pro vývojáře | JavaScript / Python SDK, Crawlee, vlastní Actors |
| Marketplace | N/A | Actor Store (desítky tisíc Actorů) |
| Stránkování | Vestavěné (na kompatibilních stránkách) | Závislé na Actorovi |
| Export | Excel, CSV, JSON, Google Sheets, Airtable, Notion | CSV, JSON, XML, Excel, HTML, RSS, JSONL + integrace (Make, n8n, Zapier, Sheets atd.) |
| Plánování | Závislé na tarifu | Vestavěné, ve stylu cronu |
| Správa proxy | Řízená (API), bez uživatelského nastavení | Datacenter, residential, SERP, konfigurovatelné |
| Úložiště | Na úrovni účtu (orientace na export) | Datasety, key-value stores, request queues |
| Vývojářské API | Open API (Distill, Extract, Batch) | REST API v2 + Actor SDK |
| Integrace s AI agenty | MCP Server, CLI, plugin pro Claude Code | MCP, LangChain, LlamaIndex, komunitní integrace |
| Cenový model | Credity (za výstupní řádek) | Compute units (za GB-hodinu) + proxy / úložiště / přenos + event poplatky specifické pro Actora |
| Free tier | Ano (viz pricing) | Ano ($5 / měsíc využití platformy, viz pricing) |
| Browser mode | Ano (používá vaši přihlášenou session) | Jen cloud (Actors běží v kontejnerech Apify) |
| Open-source komponenty | N/A | Crawlee (Apache-2.0, ~25 000 hvězdiček na GitHubu) |
Konečný verdikt: Který nástroj sedí vašemu workflow?
Tady není žádný univerzální vítěz a byl bych podezřívavý k tomu, kdo by tvrdil opak, aniž by ukázal, na základě čeho.
Pokud jste byznys uživatel a chcete přejít z „dívám se na tuhle stránku“ na „mám čistou tabulku“ během minut, Thunderbit je přímější cesta. Agentní analýza stránky, vestavěný export a workflow nativní pro prohlížeč jsou přesně na tohle stavěné. Nemusíte se učit novou platformu, procházet marketplace ani nastavovat vstupní schémata. Prostě scrapujete a exportujete.
Pokud jste vývojář nebo technický tým a potřebujete vlastní crawlery, plánované pipeline, pokročilou orchestraci proxy / anti-bot, nebo přístup k obřímu marketplace předpřipravených nástrojů, Apify vám dává mnohem širší sadu stavebních bloků. Křivka učení je strmější, ale strop je výš — hlavně u složitých, opakovaných nebo velkoobjemových úloh.
Pokud jste někde mezi tím — třeba polo-technický analytik, který začíná s ad hoc scrapingem, ale chce škálovat do programatických workflow — oba nástroje mají vývojářské rozhraní (Thunderbit API / MCP / CLI; Apify SDK / CLI / API). Otázka je, jestli je vaší hlavní potřebou řízená extrakce (Thunderbit), nebo plná platforma pro tvorbu a orchestraci datových aplikací (Apify).
Moje doporučení: vyzkoušejte oba free tarify na svém skutečném use case. Nejlepší srovnání je vždy to, které si provedete sami, na vlastních datech a se svým týmem. A pokud chcete nejrychlejší cestu ke strukturovaným datům, zkuste Thunderbit — možná vás překvapí, jak rychle uvidíte výsledky.
Často kladené otázky
Je Thunderbit opravdu bez kódu, nebo potřebuju technické znalosti?
Workflow browser rozšíření Thunderbit — One Click Extract → agentní analýza → Run Now nebo automatický start → Export — nevyžaduje vůbec žádné programování. Je navržené pro byznys uživatele, kteří nikdy nesáhli na CSS selektor. Thunderbit ale zároveň nabízí i vývojářské možnosti (Open API, MCP Server, CLI) pro technické uživatele, kteří chtějí extrakci integrovat do aplikací nebo agentních workflow.
Dá se Apify používat bez kódování?
Ano, u předpřipravených Actors. Console vygeneruje formulář ze vstupního schématu Actora, takže mnoho Actorů můžete konfigurovat a spouštět bez psaní kódu. Apify také nabízí Apify AI (beta), MCP, Tasks a integrace (Make, n8n, Zapier) jako no-code / low-code vstupní body. Stavba vlastních Actors nebo řešení pokročilých konfigurací ale pořád vyžaduje JavaScript nebo Python.
Který nástroj je levnější pro menší objem scrapingu?
Oba nástroje mají free tarify, které mohou stačit pro malý, ad hoc scraping. Free plán Thunderbit obsahuje omezený počet stránek za měsíc; free plán Apify obsahuje $5 / měsíc na využití platformy. Při nízkém objemu bývá cena často druhotná. Jakmile škálujete, modely se zásadně rozcházejí — Thunderbit účtuje za výstupní řádek (credit), zatímco Apify účtuje za compute unit (GB-hodinu) plus případné poplatky za proxy, úložiště a eventy specifické pro Actora. Vždy si zkontrolujte aktuální Thunderbit pricing a Apify pricing.
Zvládne Thunderbit velké scrapingové úlohy, nebo je jen pro menší věci?
Rozšíření a webová aplikace Thunderbit jsou optimalizované pro agentní jedním kliknutím spouštěnou extrakci. Pro větší nebo programatické workloady Thunderbit Open API podporuje asynchronní Batch workflow a MCP Server plus CLI umožňují agentní a terminálovou extrakci. Tato vývojářská rozhraní jsou zaměřená na extrakci a nenabízejí stejnou šíři orchestrálních prvků (trvalé fronty, úložiště, vlastní kontejnery) jako platforma Apify, která má delší historii v podpoře komplexních, velkoobjemových pipeline.
Jak Thunderbit a Apify řeší změny webu nebo anti-bot opatření?
AI v Thunderbit při každém scrapu stránku znovu přečte, což může pomoci přizpůsobit se změnám layoutu na kompatibilních stránkách — AI výstup ale vždy kontrolujte a žádný cíl není zaručený. API obsahuje řízené renderování, rotaci proxy a anti-bot handling s uvedenými omezeními. Apify nabízí konfigurovatelnou správu proxy (datacenter, residential, SERP), orchestraci headless prohlížečů a kontrolu session / rotace. Actors — zejména komunitní — se ale mohou rozbít, když cílový web změní HTML, a aktualizace závisí na maintainerovi Actora. Žádný z nástrojů nezaručuje univerzální přístup ani obejití všech anti-bot opatření a oba vyžadují dodržování podmínek webu, soukromí a platných zákonů.
Zjistěte více




