
Redfin aktualizuje 70 % nových amerických MLS nabídek do pěti minut od jejich zveřejnění. Taková rychlost je pro každého, kdo staví realitní datový pipeline, jako magnet — a přesně proto tolik scraperů míří na Redfin a během pár minut skončí zablokovaných.
Na nástrojích pro extrakci dat v Thunderbit pracuji už roky a můžu říct jednu věc: rozdíl mezi „scrapuj Redfin“ a „scrapuj Redfin bez zablokování“ je přesně ten bod, kde se většina návodů rozpadá. Ukážou vám kód v BeautifulSoup, přeskočí část, kde Cloudflare rozdrtí vaše požadavky, a nechají vás civět na stránku 403 a přemýšlet, co se pokazilo. Tenhle průvodce je jiný. Provedu vás třemi reálnými postupy — parsováním HTML, skrytým API Redfinu a bezkódovou cestou přes Thunderbit — a věnuji hodně prostoru ochraně proti botům, která má v praxi skutečně význam. Na konci budete přesně vědět, která metoda sedí vaší úrovni, vašemu objemu i vaší ochotě snášet údržbu.
Vyzkoušet Thunderbit pro scrapování Redfinu
Co je Redfin a proč jsou jeho data důležitá?
Redfin je realitní makléřská platforma založená na technologiích, s placenými agenty, kteří stahují nabídky přímo z MLS feedů. Pokrývá více než 100 metropolitních oblastí v USA a Kanadě napříč 42 státy a měsíčně ji navštíví téměř 50 milionů lidí. Na rozdíl od portálů, které jen agregují nabídky, jsou data na Redfinu ověřená makléři a jeho proprietární odhad ceny Redfin Estimate AVM pokrývá více než 95 milionů nemovitostí s mediánovou chybou jen 1,96 % u nemovitostí na trhu.
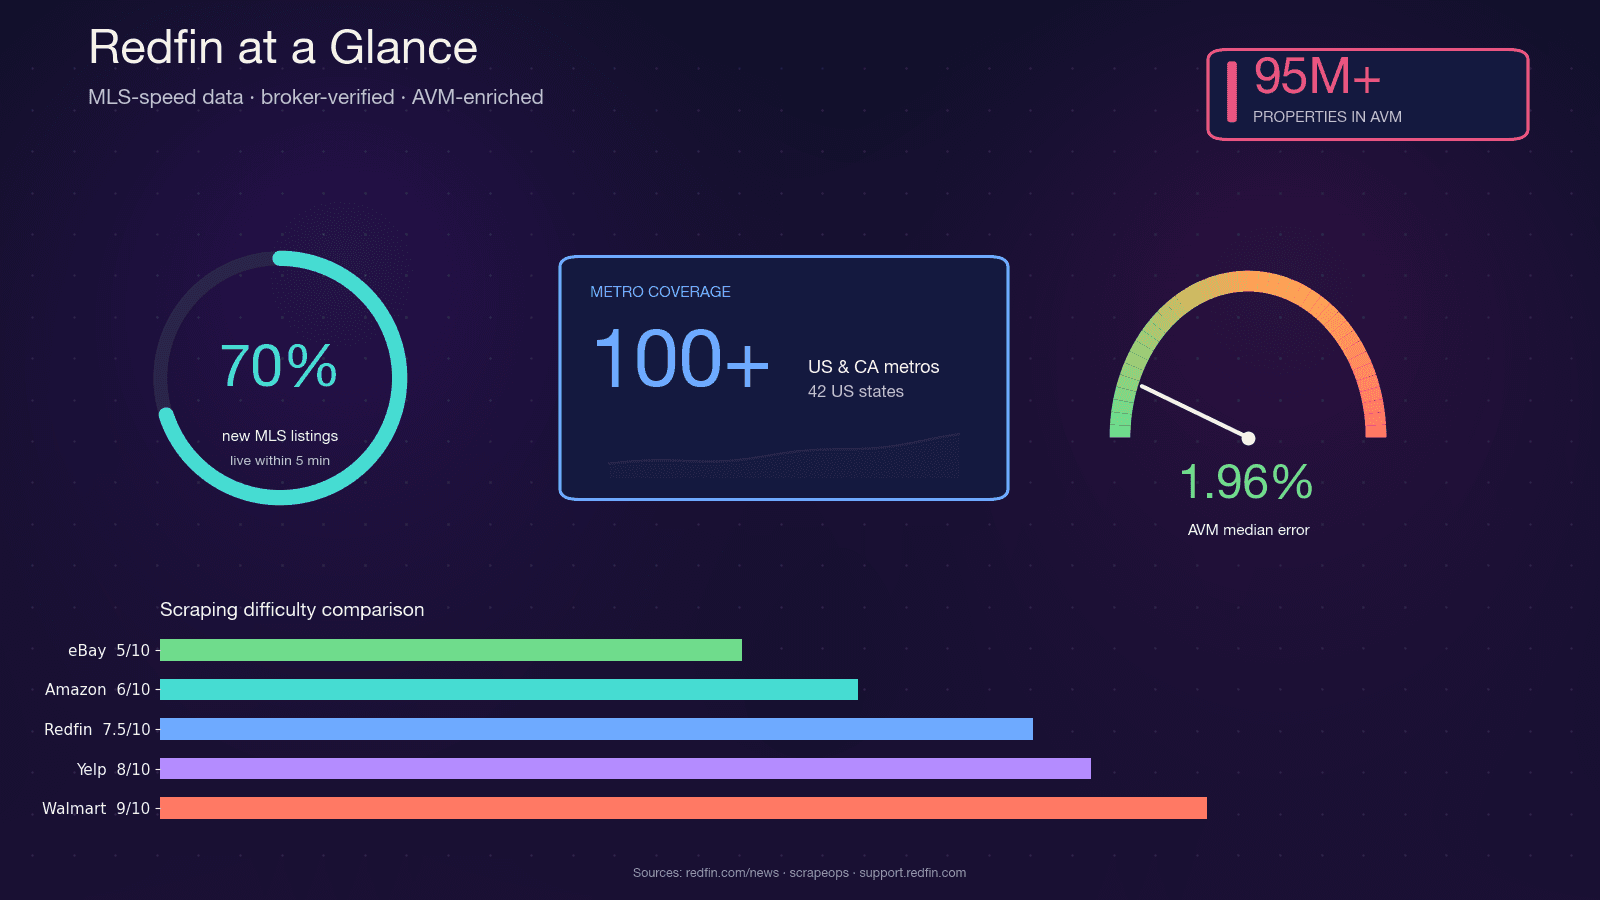
Právě tahle kombinace — čerstvost na úrovni MLS, kvalita ověřená makléřem a přesný AVM model — je důvod, proč investoři do nemovitostí, agenti, proptech startupy i datoví analytici chtějí programový přístup k datům z Redfinu. Python je pro to přirozená volba: jeho scraping ekosystém (requests, BeautifulSoup, Selenium, Playwright) je vyzrálý, komunita obrovská a snadno se napojuje na pandas i Jupyter pro analýzu.
Proč scrapovat Redfin s Pythonem?
Případy použití jsou stejně pestré jako lidé, kteří ta data potřebují. Takhle obvykle různé skupiny používají naskrapovaná data z Redfinu:
| Publikum | Hlavní cíl scrapování | Příklad použití |
|---|---|---|
| Realitní agenti | Generování leadů, přehled o trhu | Nové nabídky a propadlé nabídky v servisní oblasti; adresář agentů pro srovnání s konkurencí |
| Investoři do nemovitostí | Deal flow, analýza cap rate | Filtry na výnos z pronájmu, odhalování podhodnocených nemovitostí, denní upozornění na nové nabídky |
| Proptech startupy | Datové pipeline pro produkt | Trénovací data pro AVM, přehledové dashboardy trhu, akviziční engine pro iBuyer |
| Datoví analytici | Průzkum trhu, BI | Mediánové ceny po ZIP kódech, časové řady dnů na trhu, poměr prodejní a nabídkové ceny |
| Wholesalers / flippery | Sledování problémových nemovitostí | Detekce slev, exekuce, srovnatelné mimo trh |
Širší trend to potvrzuje: více než 72 % realitních firem dnes používá prediktivní analytiku pro hledání příležitostí a řízení rizik. Trh PropTech má podle projekcí dosáhnout $47 miliard v roce 2025 při CAGR 16,4 %. Strukturovaná data o nemovitostech už nejsou „nice to have“ — jsou naprostý základ.
Všechna datová pole Redfinu, která můžete scrapovat (kompletní přehled)
Než napíšete jediný řádek kódu, potřebujete vědět, co je vlastně dostupné. Prošel jsem výsledkové stránky Redfinu, detailní stránky nemovitostí i profily agentů — a porovnal je s open-source Stingray API wrappery jako reteps/redfin a RedfinPlus. Celkem to dává 117 různých polí napříč typy stránek.
Tuhle tabulku je dobré si uložit. Když znáte datové schéma ještě před psaním scraperu, ušetří vám to hodiny hledání selektorů metodou pokus-omyl.
Pole na stránce s výsledky vyhledávání
Jde o lehká pole dostupná na kartách nabídek — často je lze vytáhnout i bez plného JS renderování:
| Pole | Datový typ | Poznámka |
|---|---|---|
| ID nemovitosti | Číslo | Interní int Redfinu, parsovaný z /home/{id} v href |
| Nabídková cena | Číslo | |
| Plná adresa | Text | |
| Ložnice / koupelny / plocha | Číslo | Tři hodnoty v pořadí |
| Typ nemovitosti | Výběr z jedné hodnoty | SFH, Condo, Townhouse, Multi |
| Stav | Text | Active, Pending, Contingent |
| Doba na trhu | Číslo | |
| Indikátor snížení ceny | Číslo | Rozdíl oproti původní ceně |
| Hlavní fotografie | URL obrázku | Jedna fotka na kartu |
| Označení Hot Home | Boolean | |
| Datum/čas open house | Text | |
| Atribuce realitní kanceláře | Text |
Pole na detailní stránce nemovitosti
Detailní stránka obsahuje skutečnou hloubku. Mnohá z těchto polí vyžadují JavaScript renderování nebo Stingray API:
| Pole | Datový typ | Poznámka |
|---|---|---|
| Redfin Estimate (na trhu) | Číslo | Přes /stingray/api/home/details/avm |
| Redfin Estimate (mimo trh) | Číslo | Přes /stingray/api/home/details/owner-estimate; mediánová chyba 7,52 % |
| Rok výstavby / rekonstrukce | Číslo | |
| Velikost pozemku | Číslo | |
| Poplatky HOA | Číslo | Měsíčně, pokud se vztahuje |
| Roční daň z nemovitosti | Číslo | |
| Odhadovaná daňová hodnota | Číslo | |
| Tabulka historie prodejů | Tabulka | Cena, datum, typ události |
| Popis nemovitosti | Text | Marketingový odstavec |
| URL fotografií (karusel) | URL obrázků | 20+ na jednu nabídku |
| Jméno, telefon, e-mail makléře | Text / Telefon / E-mail | Telefon bývá často maskovaný |
| Hodnocení škol (základní/střední/střední škola) | Číslo | Plus název distriktu |
| Walk / Transit / Bike Score | Číslo | |
| Hodnocení klimatických rizik | Číslo | Povodně, požár, horko, vítr |
| Podobné aktivní / prodané / okolní domy | URL | Data z karuselu |
| Parkování, garáž, topení, chlazení | Text | Skupiny vybavení |
Pole v profilu agenta
| Pole | Datový typ | Poznámka |
|---|---|---|
| Jméno agenta, fotka, kancelář, bio | Text / Obrázek | |
| Telefon, kontaktní formulář | Telefon / Text | Zobrazí se po kliknutí |
| Počet aktivních nabídek | Číslo | |
| Prodeje za posledních 12 měsíců / celkový objem | Číslo | |
| Průměrný poměr nabídkové a prodejní ceny | Číslo | |
| Počet hvězdiček / recenzí | Číslo | |
| Roky praxe / číslo licence | Text / Číslo |
Když na stránce Redfinu použijete funkci Thunderbit AI Suggest Fields, automaticky rozpozná většinu těchto sloupců a přiřadí správné datové typy — bez ručního mapování CSS selektorů. K tomu se ještě dostanu.
Jak Redfin brání botům rozebrat do detailu (a není to jen „použij proxy“)
Tady si chci zabodnout vlajku, protože většina návodů ten blokovací problém jen přejde mávnutím ruky a skočí rovnou k „kupte si proxy od našeho sponzora“. To nepomůže. Pokud nevíte, co přesně Redfin dělá pro detekci scraperů, spálíte proxy kredity a stejně skončíte zablokovaní. ScrapeOps hodnotí anti-bot obtížnost Redfinu na 7,5 z 10 a Scraperly ji klasifikuje jako střední (3/5) — „méně agresivní než enterprise WAF u Zillowu, spoléhá na vlastní rate limiting a JavaScript challenge.“
Redfin používá vícevrstvý stack: Cloudflare na edge vrstvě (JS challenge, Turnstile, TLS/JA3 fingerprinting) plus rate limiter na aplikační vrstvě specifický pro Redfin. V jejich robots.txt není žádný Crawl-delay, protože vynucování probíhá na úrovni WAF.
Proč na Redfinu selže obyčejné requests + BeautifulSoup
Když pošlete základní requests.get() na stránku nemovitosti na Redfinu s výchozími hlavičkami, obvykle se stane toto:
- HTTP 403 — JavaScript challenge od Cloudflare se nevyřešila, takže dostanete challenge stránku místo nabídky.
- Mezistránka s výzvou — HTML tělo obsahuje widget Cloudflare Turnstile, ne data o nemovitosti.
- HTTP 200 s částečným HTML — Dostanete obal s velkým vloženým JSON blobem pod
root.__reactServerState.InitialContext, ale žádné předrenderované karty, žádnou historii cen, žádná hodnocení škol.
Redfin používá vlastní React SSR framework (ne Next.js) a hydration klíč je specifický pro Redfin — root.__reactServerState.InitialContext s daty nabídek uvnitř ReactServerAgent.cache.dataCache. Není to __NEXT_DATA__ ani window.__INITIAL_STATE__.
Nejčastější příčina tichých 403? Chybějící hlavičky Sec-Fetch-*. Redfin/Cloudflare explicitně validuje Sec-Fetch-Site, Sec-Fetch-Mode, Sec-Fetch-Dest a Sec-Fetch-User. Když chybí, jste okamžitě označeni.
Hra na obranu: prodlevy, hlavičky, proxy a session
Tady je kompletní rozpad obrany po jednotlivých vrstvách a konkrétní mitigace pro každou z nich:
| Obrana Redfinu | Co dělá | Signál detekce | Strategie mitigace |
|---|---|---|---|
| Cloudflare JS challenge | Mezistránka vydávající cookie cf_clearance | 403 + HTML tělo Cloudflare | curl_cffi s impersonate="chrome120"; zahřát session přes homepage; US residential proxy |
| Cloudflare Turnstile | Interaktivní CAPTCHA u rizikových session | 403 + widget Turnstile | Headless browser se stealth režimem + residential proxy |
| Chyba Cloudflare 1020 (ban ASN) | Blokuje označené IP/ASN na WAF | 403 tělo „Error 1020 Access Denied“ | Přepnout na residential/mobile proxy; nikdy nepoužívat datacentrové ASN |
| TLS/JA3 fingerprinting | Odhaluje TLS stacky mimo prohlížeč | Tiché 403 i s perfektními hlavičkami | Impersonace v curl_cffi nebo skutečný prohlížeč |
| HTTP/2 fingerprinting | Kontroluje HTTP/2 SETTINGS a pořadí HPACK | Tichý blok | curl_cffi mluví HTTP/2 jako Chrome |
| Validace hlaviček (UA, Sec-Fetch-*) | Hlavičky konzistentní s prohlížečem | 403 při prvním požadavku | Plný Chrome header set včetně Sec-Fetch-Site/Mode/Dest/User, realistický Referer |
| Kontinuita cookies/session | Sleduje cf_clearance, RF_BROWSER_ID | Challenge u studených zásahů na deep URL | Trvalá session; nejprve zahřát na homepage |
| Rate limit aplikační vrstvy | Limiter požadavků na IP | 429 | Zpoždění 2–5 s s jitterem; exponenciální backoff |
| Reputace datacentrových IP | Blokuje známé DC ASN | Okamžité 1020/403 | Jen US residential nebo mobile proxy |
| Detekce concurrency | Více paralelních požadavků z jedné IP | Náhlá eskalace na Turnstile | Max. 2 současné požadavky na IP |
Praktické hranice z komunitního testování:
- Bezpečné tempo: 1 požadavek každé 2–3 sekundy na IP
- Trvalé tempo nad 20–30 požadavků/min z jedné datacentrové IP spustí challenge během několika minut
- Mírné rate limity se po 5–15 minutách bez provozu často uvolní
- Zákazy pro datacentrové IP (AWS, GCP, Azure, OVH) mohou trvat hodiny až dny
Běžné Python requests (urllib3 + OpenSSL) vytváří JA3 fingerprint, který neodpovídá žádnému prohlížeči — a dostane tichý blok i při perfektních hlavičkách. Průmyslové řešení je curl_cffi s impersonate="chrome120", které komunikuje TLS i HTTP/2 stejně jako Chrome.
Tři způsoby, jak scrapovat Redfin s Pythonem (a který zvolit)
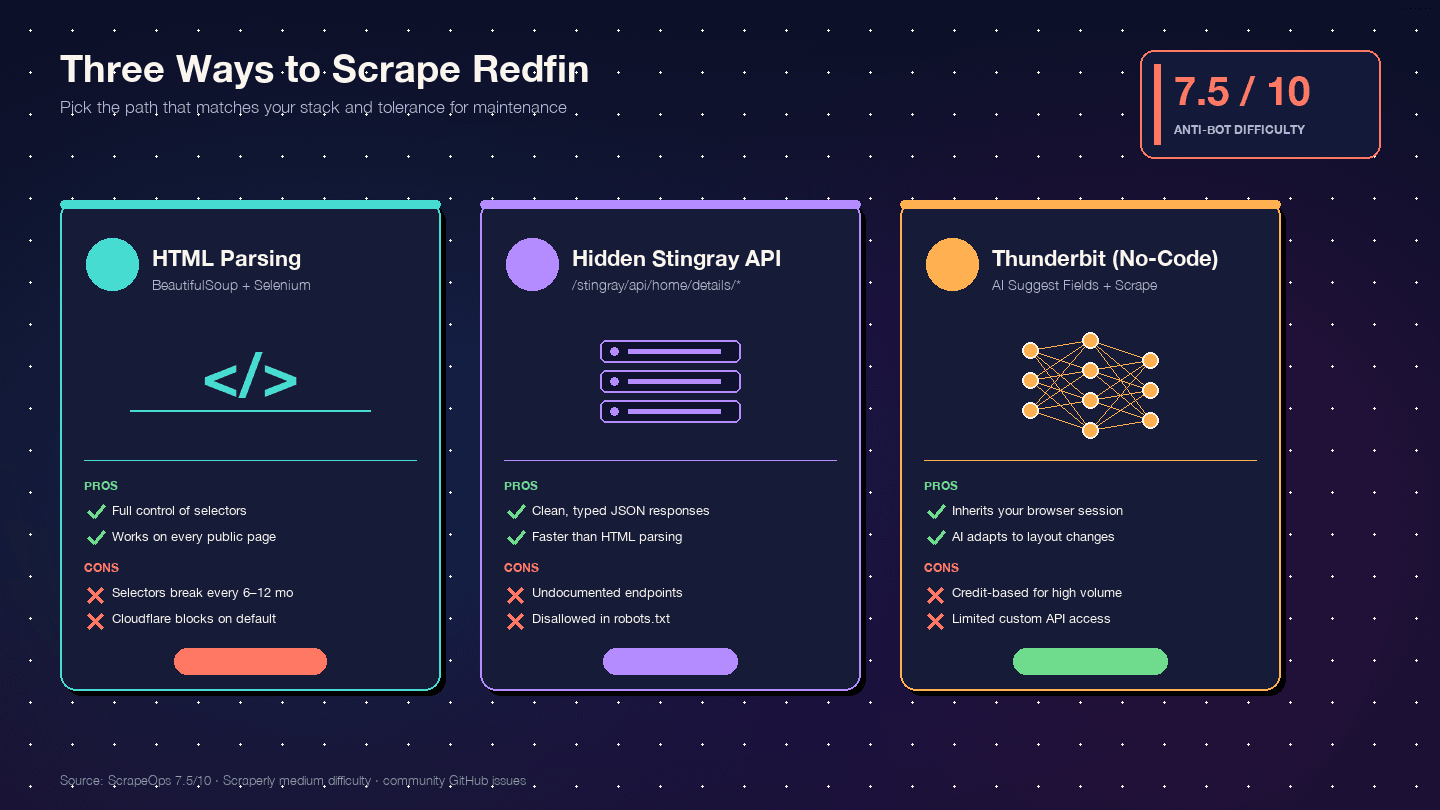
Nenalezl jsem jediný konkurenční návod, který by porovnával všechny tři přístupy vedle sebe. Tady je rozhodovací matice:
| Kritérium | Parsování HTML (BS4 + Selenium) | Skryté Stingray API | Thunderbit (bez kódu) |
|---|---|---|---|
| Obtížnost nastavení | Střední (Python prostředí + driver prohlížeče) | Vysoká (reverse engineering endpointů) | Nízká (instalace rozšíření do Chrome) |
| Riziko anti-bot blokace | Vysoké (požadavky na DOM jsou nejviditelnější) | Střední (API-like požadavky působí čistěji) | Nejnižší (používá vaši skutečnou browser session) |
| Kvalita struktury dat | Střední (nestrukturované HTML → ruční parsování) | Výborná (předstrukturované JSON) | Vysoká (AI auto-detekce polí i typů) |
| Náročnost údržby | Vysoká — změna layoutu rozbije selektory | Střední — endpointy se mohou změnit bez upozornění | Nejnižší — AI se přizpůsobuje změnám layoutu |
| Škálování | Nízké až střední (stovky s proxy) | Střední až vysoké (tisíce, čistší požadavky) | Střední (50 stránek/batch přes cloud scraping) |
| Nejlepší pro | Vývojáře, kteří chtějí plnou kontrolu | Vývojáře, kteří potřebují čisté JSON | Netechnické uživatele, rychlé projekty, průběžná data bez vývojářských kapacit |
Důležitá je hlavně údržba. Redfin nasadil dvě generace DOM karet — starší (homecardV2Price) a aktuální (span.bp-Homecard__Price--value). Historie GitHub issue v komunitě ukazuje, že CSS selektory se rozbíjejí zhruba každých 6–12 měsíců. Když se to stane, scraper v BeautifulSoup přes noc přestane fungovat. AI založená detekce polí se přizpůsobí.
Než začnete
- Obtížnost: Střední (postupy 1 a 2), Začátečník (postup 3)
- Potřebný čas: ~30 minut pro postup 1 nebo 2; ~5 minut pro postup 3
- Co budete potřebovat:
- Python 3.8+ s pipem (postupy 1 a 2)
- Prohlížeč Chrome (všechny postupy)
- Thunderbit Chrome Extension (postup 3)
- US residential proxy pro velkoobjemové scrapování (postupy 1 a 2)
Scrapujte Redfin data s AI Get Started Free
Postup 1: Scraping Redfinu v Pythonu pomocí parsování HTML (BeautifulSoup + Selenium)
Tohle je cesta „mám vše pod kontrolou“. Selektory píšete vy, prohlížeč spravujete vy, chyby řešíte vy.
Je to nejvíc naučné. A zároveň nejkřehčí.
Krok 1: Nastavte Python prostředí
Vytvořte virtuální prostředí a nainstalujte potřebné knihovny:
python -m venv redfin-scraper
source redfin-scraper/bin/activate  # Na Windows: redfin-scraper\Scripts\activate
pip install requests beautifulsoup4 selenium webdriver-manager pandas curl_cffi
curl_cffi je tady klíčové — právě to umožní, aby se vaše HTTP požadavky tvářily jako skutečný Chrome TLS fingerprint, místo standardního Python requests, které Cloudflare odhalí na první pohled.
Krok 2: Nastavte hlavičky prohlížeče a session
Tady většina začátečníků selže. Potřebujete kompletní sadu Chrome hlaviček, včetně Sec-Fetch-*, které Redfin/Cloudflare explicitně validuje:
from curl_cffi import requests as curl_requests

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Fetch-Site": "none",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-User": "?1",
}

session = curl_requests.Session(impersonate="chrome120")
session.headers.update(HEADERS)

# Zahřejte session — získejte cookies cf_clearance a RF_BROWSER_ID
session.get("https://www.redfin.com/")
Zahřátí session je zásadní — přímý zásah na deep URL bez předchozích cookies a bez Referer dostane od Cloudflare horší skóre.
Vždycky začínejte homepage.
Krok 3: Scrapujte výsledky vyhledávání na Redfinu
Jakmile je session zahřátá, můžete stáhnout stránku výsledků pro město a parsovat karty nabídek. Aktuální selektory (2024–2026):
import time
import random
from bs4 import BeautifulSoup

base_url = "https://www.redfin.com/city/17151/CA/San-Francisco"
listings = []

for page_num in range(1, 6):  # Stránky 1–5
    url = f"{base_url}/page-{page_num}" if page_num > 1 else base_url
    resp = session.get(url)

    if resp.status_code != 200:
        print(f"Na stránce {page_num} došlo k blokaci: HTTP {resp.status_code}")
        break

    soup = BeautifulSoup(resp.text, "html.parser")
    cards = soup.select("[data-rf-test-id='property-card'], a.bp-Homecard")

    for card in cards:
        price_el = card.select_one("span.bp-Homecard__Price--value")
        addr_el = card.select_one("a.bp-Homecard__Address")
        stats = card.select("span.bp-Homecard__LockedStat--value")

        listing = {
            "price": price_el.text.strip() if price_el else None,
            "address": addr_el.text.strip() if addr_el else None,
            "beds": stats[0].text.strip() if len(stats) > 0 else None,
            "baths": stats[1].text.strip() if len(stats) > 1 else None,
            "sqft": stats[2].text.strip() if len(stats) > 2 else None,
            "url": "https://www.redfin.com" + addr_el["href"] if addr_el else None,
        }
        listings.append(listing)

    # Náhodná pauza 2–5 sekund
    time.sleep(random.uniform(2, 5))

print(f"Naskrappováno {len(listings)} nabídek")
Měli byste vidět rostoucí seznam slovníků, každý s cenou nabídky v San Francisku, adresou, ložnicemi/koupelnami/plošnou a URL na detail. Pokud dostanete 0 karet, zkontrolujte HTTP status — 403 znamená, že vás zastavil Cloudflare, a pravděpodobně potřebujete residential proxy.
Krok 4: Scrapujte detailní stránky nemovitostí
Výsledky hledání vám dají základy. Detailní stránky přinesou Redfin Estimate, rok výstavby, HOA, historii prodejů, informace o agentovi i fotky. Tyto stránky vyžadují JavaScript rendering, takže přepněte na Selenium:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
from selenium.webdriver.common.by import By
import time

options = webdriver.ChromeOptions()
options.add_argument("--headless=new")
options.add_argument("--disable-blink-features=AutomationControlled")
options.add_argument("user-agent=Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                     "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36")

driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()), options=options)

for listing in listings[:10]:  # Obohate prvních 10
    driver.get(listing["url"])
    time.sleep(random.uniform(3, 6))  # Počkejte na JS renderování

    try:
        estimate_el = driver.find_element(By.CSS_SELECTOR, "[data-rf-test-name='avmLdpPrice']")
        listing["redfin_estimate"] = estimate_el.text.strip()
    except:
        listing["redfin_estimate"] = None

    try:
        year_built = driver.find_element(By.XPATH, "//span[contains(text(),'Year Built')]/following-sibling::span")
        listing["year_built"] = year_built.text.strip()
    except:
        listing["year_built"] = None

driver.quit()
Po tomto kroku by vašich prvních 10 nabídek mělo být obohaceno o Redfin Estimate a rok výstavby. XPath selektory jsou pro tyto vnořené prvky vybavení odolnější než CSS, ale pořád jsou křehké — jakákoli změna DOM je rozbije.
Krok 5: Ošetřete blokace a chyby
Zaveďte retry logiku s exponenciálním backoffem:
import time

def fetch_with_retry(session, url, max_retries=3):
    for attempt in range(max_retries):
        resp = session.get(url)
        if resp.status_code == 200:
            return resp
        elif resp.status_code in (403, 429, 503):
            wait = (2 ** attempt) + random.uniform(1, 3)
            print(f"Blokace ({resp.status_code}). Zkouším znovu za {wait:.1f}s...")
            time.sleep(wait)
        else:
            print(f"Neočekávaný status: {resp.status_code}")
            break
    return None
Známky blokace: HTTP 403 s Cloudflare HTML v těle, HTTP 429 (výslovný rate limit), prázdné tělo odpovědi nebo „Error 1020 Access Denied“ v obsahu stránky. Pokud se to děje pořád, je čas přidat residential proxy nebo přejít na API přístup.
Postup 2: Scrapování Redfinu v Pythonu pomocí skrytého Stingray API
Tohle je můj nejoblíbenější přístup. Frontend Redfinu komunikuje s interním JSON API na /stingray/api/home/details/* a odpovědi vrací jako čisté, typované JSON — bez parsování HTML.
Jak objevit skrytá API endpointy Redfinu
Otevřete Chrome DevTools → záložka Network → filtrujte podle Fetch/XHR → přejděte na libovolnou stránku nemovitosti na Redfinu. Uvidíte požadavky na endpointy jako:
api/home/details/initialInfo— překládá URL → propertyId, listingIdapi/home/details/aboveTheFold— cena, ložnice, koupelny, plocha, fotky, stav, agent, MLS#api/home/details/belowTheFold— vybavení, HOA, daně, parkování, rok výstavby, pozemek, historieapi/home/details/avm— Redfin Estimate pro nemovitosti na trhuapi/home/details/owner-estimate— Redfin Estimate mimo trhapi/home/details/descriptiveParagraph— marketingový popis
U rental stránek se rentalId (36místné UUID) vytahuje z URL v tagu <meta property="og:image">.
Scraping dat o nemovitosti přes Stingray API
Je tu jeden důležitý detail: Stingray JSON odpovědi mají na začátku doslovný prefix {}&& jako anti-CSRF opatření. Před parsováním ho musíte odstranit:
import json
from curl_cffi import requests as curl_requests

session = curl_requests.Session(impersonate="chrome120")
session.headers.update(HEADERS)

# Zahřejte session
session.get("https://www.redfin.com/")

# Načtěte stránku nemovitosti kvůli cookies a property ID
property_url = "https://www.redfin.com/CA/San-Francisco/123-Main-St-94102/home/12345678"
page_resp = session.get(property_url)

# Teď zavolejte Stingray API
api_url = "https://www.redfin.com/stingray/api/home/details/aboveTheFold?propertyId=12345678"
api_resp = session.get(api_url, headers={"Referer": property_url})

# Odstraňte anti-CSRF prefix
payload = json.loads(api_resp.text.replace("{}&&", "", 1))

# Vytáhněte strukturovaná data
listing_data = payload.get("payload", {})
print(json.dumps(listing_data, indent=2))
Odpověď obsahuje typovaná pole: cena jako celé číslo, ložnice/koupelny jako čísla, URL fotek jako pole, informace o agentovi jako vnořené objekty. Žádné parsování BeautifulSoup, žádné CSS selektory, žádné hádání.
Výhody a limity přístupu přes skryté API
Výhody:
- Předstrukturované JSON — výrazně čistší než parsování HTML
- Rychlejší na jeden požadavek (menší payloady, bez render overheadu)
- Nižší riziko blokace (požadavky podobné API při správných hlavičkách působí přirozeněji)
Limity:
- Endpointy se mohou změnit bez upozornění — neexistuje oficiální dokumentace
robots.txtvýslovně zakazuje/stingray/pro wildcard user-agent- K objevení nových endpointů je nutný reverse engineering
- I tak je potřeba zahřát session a mít správné hlavičky, aby vás nezastavil Cloudflare
Bezkódová alternativa: scrapování Redfinu pomocí Thunderbit
Jestli potřebujete data z Redfinu a nechcete udržovat Python skripty — nebo prostě chcete výsledky za pět minut — začněte tady. Přesně pro to jsme postavili Thunderbit: strukturovanou extrakci dat z libovolného webu bez nutnosti kódu.
Krok 1: Nainstalujte Thunderbit a otevřete Redfin
Nainstalujte Thunderbit Chrome Extension z Chrome Web Store. Otevřete Redfin a přejděte na stránku s výsledky vyhledávání — třeba nabídky domů v San Franciscu.
Krok 2: Klikněte na „AI Suggest Fields“
Klikněte na ikonu Thunderbitu v liště prohlížeče a potom na „AI Suggest Fields.“ AI přečte stránku Redfinu a sama navrhne sloupce jako „Adresa“, „Cena“, „Ložnice“, „Koupelny“, „Plocha“, „Typ nemovitosti“ a „Fotka nabídky“ — se správně přiřazenými datovými typy.
Sloupce, které nepotřebujete, můžete odebrat, nebo přidat vlastní kliknutím na „+ Add Column“ a popsat, co chcete, běžnou angličtinou (např. „jméno makléře“ nebo „doba na trhu“).
Měli byste vidět náhled tabulky s nakonfigurovanými sloupci připravenými k naplnění.
Krok 3: Klikněte na „Scrape“ a sledujte, jak data přibývají
Klikněte na tlačítko „Scrape“. Thunderbit zpracuje viditelné nabídky a naplní vaši tabulku. U stránkovaných výsledků zvládne stránkování automaticky — žádná logika smyček není potřeba.
Při mých testech se tabulka se 50 řádky vyplnila zhruba za 45 sekund. Strukturovaná data připravená k exportu.
Jak Thunderbit zvládá ochranu proti botům na Redfinu
Protože Thunderbit běží ve vašem vlastním prohlížeči, dědí vaše existující cookies Redfinu, session i browser fingerprint. Pro Cloudflare to vypadá jako normální uživatel, který si Redfin prohlíží — protože technicky to tak je. Žádný headless browser, žádná datacentrová IP, žádný nesoulad v TLS fingerprintu. U veřejně dostupných stránek může cloud scraping režim Thunderbitu zpracovat 50 stránek najednou.
To je zásadně jiný přístup než posílat requests z Python skriptu na serveru.
Váš browser session je už důvěryhodná.
Scraping podstránek Redfinu s Thunderbit
Po naskrapování výsledků klikněte na „Scrape Subpages“ a nechte AI projít každou URL detailu nemovitosti a obohatit tabulku o další pole — Redfin Estimate, rok výstavby, HOA poplatky, informace o agentovi, fotografie nemovitosti a historii prodejů.
To je ekvivalent 40řádkové Selenium smyčky z Postupu 1 — akorát na jedno kliknutí a bez údržby.
Když Redfin změní DOM z homecardV2Price na span.bp-Homecard__Price--value, AI se přizpůsobí. Vaše Python selektory ne.
Scrapujte podstránky Redfinu s AI Get Started Free
Více než CSV: exportujte data z Redfinu do Google Sheets, Airtable a Notion
Většina návodů končí u df.to_csv(). To stačí na jednorázovou analýzu. Pokud ale pracujete v realitním týmu, potřebujete sdílená živá data — ne statické soubory, které leží na něčím desktopu.
Export pomocí Pythonu (gspread + Airtable API)
Google Sheets přes gspread:
import gspread
import pandas as pd
from gspread_dataframe import set_with_dataframe

df = pd.DataFrame(listings)
gc = gspread.service_account(filename="service_account.json")
sh = gc.open("Redfin Listings")
ws = sh.worksheet("Sheet1")
ws.clear()
set_with_dataframe(ws, df, include_index=False, resize=True)

# Zobrazte fotografie nemovitostí inline přes vzorec IMAGE()
image_col = df.columns.get_loc("image_url") + 1
for row_idx, url in enumerate(df["image_url"], start=2):
    ws.update_cell(row_idx, image_col, f'=IMAGE("{url}")')
Pozor: Sheets má tvrdý limit 10 milionů buněk na jeden spreadsheet a API dovoluje 300 read + 300 write požadavků za minutu na projekt. Pro cokoli nad pár desítek řádků používejte ws.batch_update() místo smyček po jednotlivých buňkách.
Airtable přes pyairtable:
Důležitá změna z roku 2024: Airtable ukončil podporu starých API klíčů 1. února 2024. Teď musíte používat Personal Access Tokens (PAT) — jakýkoli návod, který stále ukazuje api_key=..., je nefunkční.
from pyairtable import Api

api = Api("patXXXXXXXXXXXXXX.yyyyyyyyyyyyyyyyyyyy")
table = api.table("appBaseId123", "Redfin Listings")

records = [
    {
        "Address": row["address"],
        "Price": row["price"],
        "Beds": row["beds"],
        "Photo": [{"url": row["image_url"]}],  # Airtable si obrázek stáhne a znovu hostuje
    }
    for row in listings
]
created = table.batch_create(records, typecast=True)
Rate limit Airtable je 5 požadavků za sekundu na base s 30sekundovým lockoutem při porušení. Příloha obrázku přijímá payload [{"url": ...}] — servery Airtable URL stáhnou, znovu hostují na svém CDN a automaticky vygenerují náhledy.
Export pomocí Thunderbitu (1 klik do Sheets, Airtable, Notion)
Thunderbit má nativní export na 1 klik do Google Sheets, Airtable a Notion — a tady je část, na kterou jsem opravdu hrdý: fotografie nemovitostí se nahrají a zobrazí jako inline obrázky v Notion i Airtable. Žádné hacky s =IMAGE(), žádné rozbité odkazy na CDN. Kliknete na „Export to Airtable“ a váš tým dostane vizuální databázi nemovitostí s náhledy, které si může prohlížet i v telefonu.
Pro realitní týmy, které pracují s vizuálním tříděním nabídek, je to rozdíl mezi užitečným nástrojem a hromadou CSV řádků.
Je scrapování Redfinu legální? Co říkají ToS, robots.txt a judikatura
Nejsem právník a tohle není právní rada. Ale po letech v oblasti extrakce dat vám můžu říct: „je to legální?“ je otázka, kterou si klade každý a většina návodů se jí vyhne.
Redfin robots.txt
Redfin má robots.txt dost detailní. Klíčové body:
- Úplně blokovaní boti:
peer39_crawler/1.0,AmazonAdBot,FireCrawlAgent— Redfin tady přímo jmenuje populární scraping službu z éry LLM - Zákazy pro wildcard
User-agent: *:/stingray/(celý interní API namespace),/myredfin/,/api/v1/rentals/,/api/v1/properties/,/owner-estimate/ - Žádný
Crawl-delay:pro žádného user agenta - 50+ deklarovaných sitemap — sitemap je nejčistší a pro WAF nejšetrnější cesta, jak si vypsat URL
Podmínky používání Redfinu
Oddíl 2.3.5 uvádí: „You may not automatedly crawl or query the Services for any purpose or by any means... unless you have received prior express written permission.“
Jde o browsewrap ujednání — souhlas pokračováním v používání, ne klikací agreement. Americké soudy byly historicky skeptické k vynucování browsewrap proti uživatelům, kteří neměli skutečné upozornění (viz Nguyen v. Barnes & Noble, 9th Cir. 2014).
Relevantní judikatura (stručně)
- Van Buren v. United States (Nejvyšší soud, 2021): U klauzule CFAA „exceeds authorized access“ se používá test „gates-up-or-down“. Použít otevřené dveře k nechtěnému účelu není federální hacking.
- hiQ Labs v. LinkedIn (9th Cir., 2022): Scraping veřejně dostupných dat není porušením CFAA. hiQ ale nakonec zaplatila 500 000 USD v dohodě o narovnání na základě porušení smlouvy — protože si vytvořila účty na LinkedIn a klikla na „I agree.“
- Meta Platforms v. Bright Data (N.D. Cal., leden 2024): Soud vydal summary judgment ve prospěch Bright Data — odhlášené scrapování veřejných dat z Bright Data nedělá „usera“ vázaného ToS Meta.
- X Corp. v. Bright Data (N.D. Cal., květen 2024): Soudce Alsup zamítl nároky X a uvedl, že nároky podle státního práva, které se snaží kontrolovat kopírování veřejného obsahu, jsou vytěsněny Copyright Actem.
Praktické doporučení
- Scrapujte jen veřejně dostupná data — nikdy si nezaložte účet a pak nescrapujte (to vytváří smluvní riziko typu clickwrap)
- Respektujte rate limity — agresivní objemy podporují nároky typu trespass-to-chattels
- Nepublikujte masově surová data ani fotky — žaloba CoStar v. Zillow (podaná v červenci 2025, potenciální škody přes 1 miliardu USD) připomíná, že autorská práva k fotkám jsou vážná věc
- Browser-based přístup Thunderbitu — běží ve vaší vlastní autentizované session — je blíž „ručnímu procházení v rychlosti stroje“ než headless datacentrovému botu, což je právně obhajitelnější postoj, pokud nemáte licencované API
Tipy a časté chyby
Pár tvrdě vydřených lekcí z budování extrakčních nástrojů a sledování tisíců uživatelů při scrapování realitních webů:
- Vždy zahřejte session. Než půjdete na jakoukoli deep URL, otevřete
redfin.com/. Studený zásah na deep URL je nejčastější spouštěč Cloudflare challenge. - Rotujte User-Agent realisticky. Nepoužívejte jen jeden — střídejte 5–10 aktuálních Chrome/Firefox UA. Ale nenechte rotaci být příliš agresivní (jiný UA pro každý požadavek vypadá podezřele).
- Deduplikujte podle ID nemovitosti. Stránkování Redfinu se někdy překrývá. Z URL každé nabídky vytáhněte
/home/{id}a před obohacením deduplikujte. - Když to jde, nescrapujte v době špičky. Pozdní noc / časné ráno v USA bývá podle mých zkušeností méně přísně hlídané WAF.
- Když dostanete 429, zpomalte exponenciálně. Nepokoušejte se hned znovu — právě tak se z mírného rate limitu dostanete k tvrdému IP banu.
- Pro velké projekty (1 000+ stránek) počítejte s residential proxy. Datacentrové IP (AWS, GCP, Azure, OVH) jsou v ASN reputačním systému Cloudflare blacklistované. Na Error 1020 narazíte téměř okamžitě.
Jak si vybrat správný způsob scrapování Redfinu
Tak který přístup si vybrat? Záleží na tom, kdo jste a co potřebujete.
Parsování HTML (BeautifulSoup + Selenium): Nejlepší pro vývojáře, kteří chtějí plnou kontrolu, nevadí jim spravovat CSS selektory a nevadí jim přestavět scraper, když Redfin změní DOM. Počítejte s tím, že kódy budete muset revidovat každých 6–12 měsíců.
Skryté Stingray API: Nejlepší pro vývojáře, kteří potřebují čisté, strukturované JSON a zvládnou reverse engineering nedokumentovaných endpointů. Údržba je nižší než u HTML parsování, ale endpointy se mohou změnit bez upozornění. A pamatujte, že /stingray/ je v robots.txt výslovně zakázané.
Thunderbit (bez kódu): Nejlepší pro netechnické uživatele, rychlé projekty a týmy, které potřebují průběžná data z Redfinu bez vývojářských kapacit. AI se přizpůsobuje změnám layoutu, scrapování podstránek obohatí data na jedno kliknutí a export do Google Sheets, Airtable nebo Notion je zabudovaný. Pokud jste realitní tým, který potřebuje živou databázi nemovitostí — ne jednorázový CSV dump — je to cesta s nejmenším odporem.
Ať už zvolíte jakoukoli cestu: pochopte anti-bot obranu Redfinu ještě před začátkem, vězte, jaká pole potřebujete, zvolte exportní formát, který sedí workflow vašeho týmu, a držte se na správné straně právních pravidel.
Jste připraveni vyzkoušet cestu bez kódu? Free tarif Thunderbitu vám umožní otestovat scrapování Redfinu a vidět výsledky během pár minut. U Python přístupů jsou výše uvedené ukázky funkčním výchozím bodem — stačí přidat proxy a trpělivost.
Vyzkoušet Thunderbit pro průběžná data z Redfinu
Časté dotazy
Má Redfin veřejné API?
Ne. Redfin nenabízí oficiální veřejné API. Skryté Stingray API (/stingray/api/home/details/*) vrací strukturované JSON a používá ho vlastní frontend Redfinu, ale je neoficiální, nedokumentované, může se změnit bez upozornění a je v robots.txt Redfinu výslovně zakázané. Open-source wrappery jako reteps/redfin na PyPI poskytují přístup v Pythonu, ale používejte je s vědomím rizik.
Můžu scrapovat Redfin bez Pythonu?
Ano. Thunderbit je AI rozšíření do Chrome, které dědí vaši browser session kvůli odolnosti proti botům — nainstalujete ho, otevřete Redfin, kliknete na „AI Suggest Fields“ a exportujete do Excelu, Google Sheets, Airtable nebo Notion. Na trhu jsou i další no-code scraping nástroje a poskytovatelé předpřipravených datasetů, pokud chcete zkusit alternativy.
Jak často Redfin mění layout webu?
Historie GitHub issue v komunitě ukazuje, že CSS selektory se rozbíjejí zhruba každých 6–12 měsíců. Redfin nasadil dvě generace DOM karet — starší (homecardV2Price, homeAddressV2) a aktuální (bp-Homecard__Price--value, bp-Homecard__Address). Zralejší scrapery zkoušejí oba přístupy postupně.
Nástroje s AI, jako Thunderbit, se přizpůsobují automaticky, protože pole rozpoznávají podle obsahu, ne podle CSS selektorů.
Jaký typ proxy je nejlepší pro scrapování Redfinu?
Pro velkoobjemové scrapování US residential proxy — komunitní benchmarky uvádějí úspěšnost kolem 80 %. Datacentrové proxy narážejí na Cloudflare Error 1020 téměř okamžitě; rozsahy AWS, GCP, Azure a OVH jsou blacklistované. Mobile proxy mají nejvyšší úspěšnost, ale stojí 5–10× víc.
Pro malé osobní scrapování (<100 stránek) může stačit správná sada hlaviček + impersonace přes curl_cffi + prodleva 2–5 sekund i bez proxy.
Můžu z Redfinu scrapovat prodané nebo mimo-tržní údaje o nemovitostech?
Ano. Data o prodaných nemovitostech a Redfin Estimate mimo trh (mediánová chyba 7,52 %) jsou na detailních stránkách dostupná stejnými scraping přístupy. Pole se liší od aktivních nabídek: stránky mimo trh ukazují prodejní cenu, datum prodeje, historii nemovitosti a endpoint owner-estimate, ale chybí aktuální nabídková cena, dny na trhu a informace o open house. Stingray API endpoint pro odhady mimo trh je api/home/details/owner-estimate místo api/home/details/avm.
Vyzkoušet Thunderbit pro scrapování Redfinu Get Started Free
Zjistit více



