
Pokud ti Glassdoor scraper skvěle fungoval v roce 2022 a dnes vrací už jen 403 chyby, nejsi v tom sám. Na fórech se pořád dokola objevuje stejná otázka: „Ví někdo, proč tenhle scraper už nefunguje?“
Krátká odpověď: Glassdoor změnil úplně všechno. Recruit Holdings začlenil Glassdoor do Indeed v červenci 2025, propustil 1 300 zaměstnanců a utáhl anti-bot ochranu natolik, že běžné scrapery založené na Selenium nebo requests se zablokují ještě před načtením prvního bytu HTML. K únoru 2026 už přihlašování do Glassdooru běží výhradně přes Indeed Login — takže každý návod, který pevně počítá s vlastním přihlašovacím formulářem Glassdooru, je od základu rozbitý. Přitom platforma stále obsahuje více než 180 milionů recenzí, platových údajů a dalších poznatků napříč 2,5 milionu zaměstnavatelů. Tahle data mají obrovskou hodnotu pro HR benchmarking, konkurenční analýzu i sales prospecting — pokud se k nim vůbec dostaneš. Tenhle průvodce je verze, která funguje po všech těchto změnách, a pokrývá všechny tři typy dat z Glassdooru (nabídky práce, recenze i platy) na jednom místě. Ukážu ti přístup v Pythonu s funkčním kódem pro rok 2025, přesně vysvětlím, co tě blokuje a jak to obejít, a přidám i no-code zkratku pro každého, kdo nechce řešit technické věci.
Proč v roce 2025 scrapovat Glassdoor pomocí Pythonu?
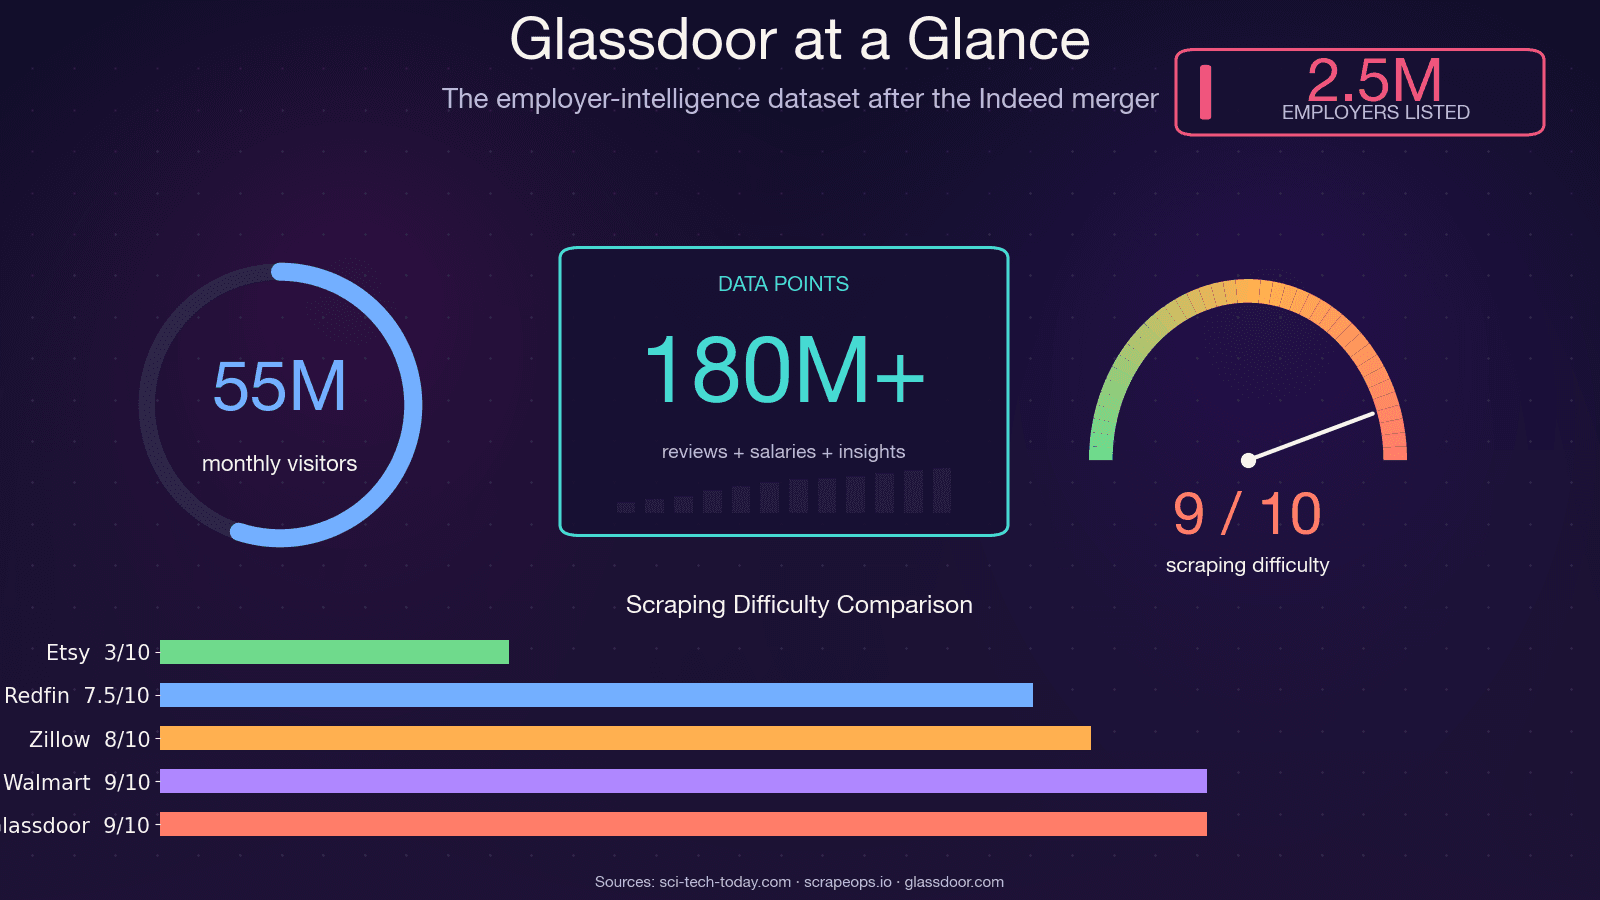
Glassdoor není jen pracovní portál. Je to jedna z nejbohatších databází firemních informací na webu — používá ji zhruba třetina firem z Fortune 500 a každý měsíc ji navštíví asi 55 milionů unikátních uživatelů. Data schovaná za těmi stránkami pohánějí reálná rozhodnutí napříč firmami.
Takto Glassdoor data využívají jednotlivé týmy:
| Případ použití | Potřebný typ dat | Kdo z toho těží |
|---|---|---|
| Benchmarking mezd | Rozložení platů, velikost vzorku | HR, Total Rewards, Operations |
| Sledování náboru konkurence | Nabídky práce, tempo zveřejňování | Sales, strategie, VC/Corp Dev |
| Monitoring employer brandu | Text recenzí, trendy hodnocení, approval CEO | HR, marketing, komunikace |
| Generování leadů (rostoucí firmy) | Nabídky práce + informace o firmě | Sales týmy, SDR |
| Tržní / akademický výzkum | Všechny tři typy | Analytici, konzultanti, výzkumníci |
Když BLS nemohla během říjnového shutdownu vlády v roce 2025 zveřejnit data o pracovním trhu, tým ekonomického výzkumu Glassdooru vydal alternativní report o pracovních místech založený na vlastním datasetu. Tak vážně dnes institucionální analytici ta data berou.
Python zůstává hlavním jazykem, protože jeho ekosystém nemá konkurenci — Playwright pro automatizaci prohlížeče, parsel/lxml pro parsing, curl_cffi pro obcházení TLS fingerprintingu a obrovská komunita, která sdílí funkční postupy. Problém není Python. Problém je, že Glassdoor je dnes mnohem těžší scrapovat.
Scrapujte data z Glassdooru s AI Get Started Free
Pokud chceš no-code alternativu pro extrakci dat z Glassdooru, Thunderbit ti pomůže scrapovat nabídky práce, recenze i platové stránky bez vlastního Python stacku.
Jaká data z Glassdooru vlastně můžete scrapovat?
Většina návodů se věnuje jen nabídkám práce. Ale poptávka uživatelů — podle vláken na fórech, GitHub issue a dotazů na Redditu, které jsem sledoval — je nejvyšší po dvou typech dat, které nikdo pořádně neučí: recenzích a platech. Tady je úplný přehled toho, co lze z těchto tří kategorií získat.
Nabídky práce
Nejlépe dostupný typ dat. Můžeš získat: název pozice, název firmy, lokaci, odhad platu, hodnocení firmy, datum zveřejnění, badge pro snadné přihlášení a odkaz na nabídku. Nabídky práce jsou částečně dostupné i bez přihlášení, i když Glassdoor po několika stránkách může zobrazit přihlašovací popup.
Recenze firem
Tady začíná být analýza employer brandu opravdu zajímavá. Extrahovat lze: celkové hodnocení, dílčí hodnocení (work-life balance, kultura a hodnoty, diverzita a inkluze, kariérní příležitosti, odměny a benefity, top management), text pro, text proti, pracovní pozici recenzenta, datum recenze a zaměstnanecký status. Plný text recenze je ale za loginem — uvidíš jen úryvek, kompletní pro a proti jsou chráněné autentizací.
Platová data
Nejžádanější a zároveň nejvíc frustrující typ dat. Můžeš získat: název pozice, základní platové rozpětí, celkové kompenzační rozpětí, počet hlášení o mzdě a lokaci. Platové stránky jsou ale kompletně za přihlášením a Glassdoor někdy přidává i flow typu „přispěj a odemkni“, kdy musíš zadat vlastní plat, abys viděl údaje ostatních. Žádný srovnatelný návod neposkytuje funkční kód — tohle napravíme.
Co vyžaduje přihlášení a co ne
Tahleta tabulka ti ušetří zjišťování metodou pokus-omyl, které stránky vrátí prázdná data:
| Typ dat | Dostupné bez přihlášení? | Poznámka |
|---|---|---|
| Názvy nabídek práce a základní informace | Ve většině případů ano | Po několika stránkách se může objevit popup |
| Plné popisy práce | Částečně | Často chráněné po 2–3 zobrazeních |
| Recenze firem (celý text) | Ne — vyžaduje login | Zobrazí se úryvek, plný text je uzamčen |
| Platová data | Ne — vyžaduje login | Může navíc vyžadovat „contribute to unlock“ |
Proč je váš starý Glassdoor scraper nejspíš rozbitý
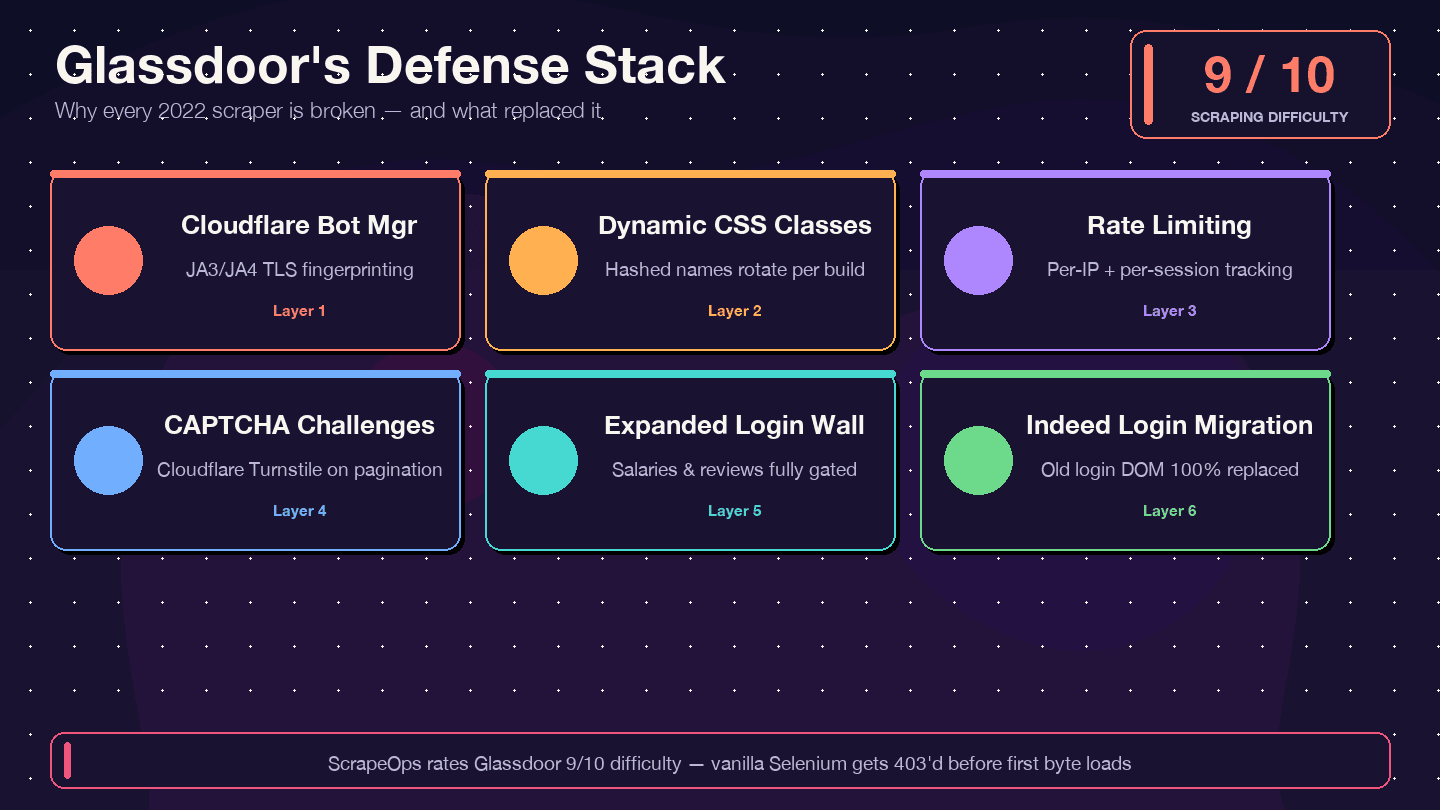
Chci to říct naprosto přímo: pokud kopíruješ kód z návodu z let 2021–2023, nebude fungovat. Nejpopulárnější starší Glassdoor Selenium scraper na GitHubu (MatthewChatham/glassdoor-review-scraper, asi 1,4k hvězdiček) má přes 12 otevřených nevyřešených problémů — včetně „Glassdoor new UI design“, „Cloudflare anti-bot protection“ a „NoSuchElementException“. Repozitář je v praxi opuštěný. Apify actor glassdoor-jobs-scraper je označený jako DEPRECATED. ScrapeOps hodnotí Glassdoor celkově jako 9/10 z hlediska obtížnosti scrapování a 8/10 pro obcházení ochrany.
Tady je, co se změnilo a proč starý kód selhává:
| Vrstva ochrany | Co se změnilo | Dopad na staré scrapery |
|---|---|---|
| Cloudflare Bot Management | Přísnější fingerprinting JA3/JA4 od roku 2024 | Základní requests/Selenium skripty dostanou okamžitě 403 |
| Dynamické názvy CSS tříd | Třídy se generují náhodně při každém buildu | Staré CSS selektory z návodů tiše přestanou fungovat |
| Rate limiting + sledování session | Přísnější limity podle IP a session | Scraper se zablokuje po menším počtu stránek |
| CAPTCHA výzvy (pravděpodobně Cloudflare Turnstile) | Objevují se častěji, hlavně při stránkování | Headless prohlížeče spouští výzvy |
| Rozšířená login stěna | Více typů stránek vyžaduje autentizaci | Stránky s platy a recenzemi vrací prázdná data |
| Migrace na Indeed Login (únor 2026) | Glassdoor login formulář byl kompletně nahrazen | Každý kód mířící na starý login DOM je mrtvý |
Průvodce Scrapfly z roku 2026 obsahuje výslovné upozornění: „Glassdoor je známý vysokou mírou blokování, takže pokud při běhu Python kódu dostáváte None hodnoty, je velmi pravděpodobné, že jste blokováni.“ A článek na DEV.to z března 2026 to říká na rovinu: „Jednoduché HTTP requests přes requests nebo httpx jsou blokovány okamžitě.“
Obranné techniky, které ti ukážu — Patchright (stealth fork Playwrightu), selektory podle atributů data-test, rotující rezidenční proxy a autentizované perzistentní session — jsou navržené přesně tak, aby zvládly každou z těchto vrstev.
Glassdoor API vs. Python scraping: nejdřív zvolte správný přístup
Na fórech se pořád objevuje otázka „Neměl bych prostě použít Glassdoor API?“ — a odpověď zní: nemůžeš.
Staré Glassdoor Partner API je uzavřené pro nové žadatele. Vývojářský portál sice technicky stále existuje, ale vrací HTTP 403. Veřejný endpoint pro recenze nikdy neexistoval — scraper od MatthewChathama vznikl právě „protože Glassdoor nemá API pro recenze“. A pro recenze ani platy neexistuje žádná migrační cesta přes Indeed Publisher API.
Tady je upřímné srovnání:
| Faktor | Glassdoor Partner API v1 | Python scraping | Thunderbit (no-code) |
|---|---|---|---|
| Přístup | Uzavřený pro nové žadatele | Otevřený (musíte ho implementovat) | Chrome extension |
| Nabídky práce | Omezené / v útlumu | Dostupné s úsilím | Dostupné |
| Recenze firem | Veřejně nikdy neexistovaly | Ano (vyžaduje login) | Ano (přes Browser Mode) |
| Platová data | Veřejně nikdy neexistovala | Ano (vyžaduje login) | Ano |
| Rate limity | Neuvedené | Řídíte si tempo sami | Kreditový model |
| Náročnost nastavení | Nelze registrovat nové aplikace | Hodiny až dny | Asi 2 minuty |
| Náklady na údržbu | N/A | Vysoké (změny HTML rozbíjejí kód) | Nízké (AI znovu navrhne pole) |
Pokud potřebuješ recenze nebo platová data — a většina lidí čtoucích tenhle článek je potřebuje — Python scraping nebo no-code nástroj je tvoje jediná realistická možnost.
Než začnete
- Obtížnost: Středně pokročilá (měli byste se vyznat v Pythonu a terminálu)
- Časová náročnost: Zhruba 30–60 minut na celé nastavení; potom asi 10 minut na každý typ dat
- Co budete potřebovat:
- Python 3.10+ (doporučený je 3.11 nebo 3.12)
- Nainstalovaný Chrome
- Účet na Glassdooru (zdarma — potřebný pro platová a recenzní data)
- Rotující rezidenční proxy (pro scraping více než pár stránek)
- Volitelně: Thunderbit Chrome Extension, pokud chcete no-code cestu
Nástroje a knihovny pro scrapování Glassdooru v Pythonu v roce 2025
Krajina nástrojů se zásadně změnila. Tohle jsou věci, které proti současné ochraně Glassdooru opravdu fungují.
Proč je Patchright nejlepší volba pro Glassdoor
Patchright je stealth fork Playwrightu, který opravuje únik Runtime.Enable CDP — přesně ten technický důvod, proč čistý Playwright na stránkách chráněných Cloudflare selhává. Používá stejné API jako Playwright, takže pokud znáš Playwright, zvládneš i Patchright. Aktuální je verze 1.58.2 (březen 2026) a projekt se aktivně udržuje.
Ve srovnání s alternativami:
- Čistý Playwright: Na přihlašovací stránce Glassdooru je detekován kvůli úniku Runtime.Enable
- Selenium + undetected-chromedriver: Poslední vydání undetected-chromedriveru je z února 2024 — dnes už je to prakticky legacy. Benchmark Scrapfly ukázal, že „selhal na každé doméně v našem testu“
- requests + BeautifulSoup: Neumí renderovat JavaScript a Cloudflare je zablokuje okamžitě kvůli TLS fingerprintingu
- curl_cffi: Výborný pro rychlou cestu (10–20× rychlejší než prohlížeč), když stránky posílají
__NEXT_DATA__už v prvním HTML, ale nezvládne přihlášení ani mezistránky s výzvou
Podpůrné knihovny
- parsel (1.11.0) nebo lxml (6.0.4): Rychlý parsing HTML/XPath
- csv nebo pandas: Export dat
- asyncio: Asynchronní scraping pro rychlejší stránkování
Proxy: pouze rezidenční
Cloudflare vrstva na Glassdooru agresivně zpochybňuje datacentrové ASN. Rezidenční proxy údajně snižují míru blokace z 20–30 % na méně než 5 %. Startovací cena je kolem $1.75/GB u IPRoyal (promo) nebo $3.00/GB u Decodo. Pro produkční scraping počítej s $3–8/GB podle objemu.
Náhodné prodlevy mezi požadavky (minimálně 3–8 sekund, u delších běhů 5–15 sekund) jsou nutné bez ohledu na kvalitu proxy.
Krok 1: Nastavení Python prostředí
Vytvořte složku projektu a nainstalujte doporučený stack:
mkdir glassdoor-scraper && cd glassdoor-scraper
python3.11 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip

# Core stack
pip install patchright==1.58.2 parsel==1.11.0

# Install browser binaries
patchright install chromium

# Optional: fast path for __NEXT_DATA__ extraction
pip install "curl_cffi==0.15.0"
Měli byste vidět, že Patchright stahuje binárku Chromium. Pokud patchright install chromium selže, zkontroluj, že máš dost místa na disku (cca 300 MB) a že používáš Python verze 3.10+.
Krok 2: Spusťte Patchright a přejděte na Glassdoor
Tady je základní pattern spuštění, který funguje proti Cloudflare vrstvě Glassdooru:
from patchright.sync_api import sync_playwright
import random, time

with sync_playwright() as p:
    browser = p.chromium.launch(
        headless=False,          # headless je stále snáz detekovatelný
        channel="chrome",        # použije skutečný Chrome, ne přibalený Chromium
    )
    context = browser.new_context(
        viewport={"width": 1440, "height": 900},
        locale="en-US",
        timezone_id="America/New_York",
        user_agent=(
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/134.0.0.0 Safari/537.36"
        ),
    )
    page = context.new_page()
    page.goto(
        "https://www.glassdoor.com/Job/new-york-data-engineer-jobs-"
        "SRCH_IL.0,8_IC1132348_KO9,22.htm"
    )

    # Odstraňte login overlay — obsah je stále v DOM
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)

    page.wait_for_selector("[data-test='jobListing']")
    print("Stránka načtena — nabídky práce jsou viditelné.")
Je důležité si všimnout několika věcí. Přepínač channel="chrome" říká Patchrightu, aby používal váš nainstalovaný Chrome namísto přibaleného Chromia — tím vznikne věrohodnější fingerprint prohlížeče. Trik s add_style_tag skrývá Glassdoor login modal (nazývaný #HardsellOverlay) bez klikání. Scrapfly potvrzuje, že „veškerý obsah tam pořád je, jen je zakrytý overlayem“ — HTML data obsahuje bez ohledu na to, jestli je modal zrovna zobrazený.
Měli byste vidět, jak se otevře okno Chrome, načte vyhledávání pracovních nabídek na Glassdooru a zobrazí karty s nabídkami bez překážejícího login popupu.
Krok 3: Scrapujte nabídky práce z Glassdooru
Najděte stabilní selektory
Glassdoor náhodně mění názvy CSS tříd při každém buildu — takže selector .jobCard_xyz123 z návodu z roku 2023 dnes vrátí potichu nic. Místo toho používej atributy data-test, což je interní QA konvence Glassdooru, která zůstává napříč deployi stabilní.
Tady je přehled selektorů pro pole nabídek práce:
| Pole | Selektor |
|---|---|
| Kontejner karty nabídky | [data-test="jobListing"] |
| Název pozice | [data-test="job-title"] |
| Odkaz na nabídku | a[data-test="job-link"] |
| Název firmy | [data-test="employer-name"] |
| Lokalita | [data-test="emp-location"] |
| Platové rozpětí | [data-test="detailSalary"] |
| Hodnocení firmy | [data-test="rating"] |
| Datum zveřejnění | [data-test="job-age"] |
| Další stránka | [data-test="pagination-next"] |
Extrakce dat o nabídkách práce
from parsel import Selector
import csv, random, time

def scrape_jobs(page, max_pages=5):
    all_jobs = []

    for page_num in range(1, max_pages + 1):
        html = page.content()
        sel = Selector(text=html)
        cards = sel.css('[data-test="jobListing"]')

        if not cards:
            print(f"Stránka {page_num}: Nenalezeny žádné karty — možný blok nebo změna selektoru.")
            break

        for card in cards:
            job = {
                "title": card.css('[data-test="job-title"]::text').get("").strip(),
                "company": card.css('[data-test="employer-name"]::text').get("").strip(),
                "location": card.css('[data-test="emp-location"]::text').get("").strip(),
                "salary": card.css('[data-test="detailSalary"]::text').get("").strip(),
                "rating": card.css('[data-test="rating"]::text').get("").strip(),
                "link": card.css('a[data-test="job-link"]::attr(href)').get(""),
                "posted": card.css('[data-test="job-age"]::text').get("").strip(),
            }
            if job["link"] and not job["link"].startswith("http"):
                job["link"] = "https://www.glassdoor.com" + job["link"]
            all_jobs.append(job)

        print(f"Stránka {page_num}: seškrábáno {len(cards)} nabídek")

        # Stránkování
        next_btn = page.query_selector('[data-test="pagination-next"]')
        if next_btn and page_num < max_pages:
            next_btn.click()
            time.sleep(random.uniform(3, 8))
            page.wait_for_selector("[data-test='jobListing']")
        else:
            break

    return all_jobs
Uložení do CSV
def save_to_csv(jobs, filename="glassdoor_jobs.csv"):
    if not jobs:
        print("Žádné nabídky k uložení.")
        return
    keys = jobs[0].keys()
    with open(filename, "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=keys)
        writer.writeheader()
        writer.writerows(jobs)
    print(f"Uloženo {len(jobs)} nabídek do souboru {filename}")
Poznámka ke stránkování: Glassdoor omezuje výsledky vyhledávání zhruba na 30 stránek bez ohledu na celkový počet výsledků. Pokud potřebuješ větší pokrytí, použij filtry (lokalita, typ práce, platové rozpětí) a rozděl si vyhledávání na menší části místo pokusu o stránkování za limit.
Při mém testování trvalo scrapování 5 stránek nabídek práce (asi 75 pozic) přibližně 45 sekund s náhodnými prodlevami. Ruční kopírování by stejnou práci prodloužilo alespoň na 20 minut.
Krok 4: Scrapujte recenze firem z Glassdooru
Tohle je sekce, pro kterou žádný jiný návod nenabízí funkční kód. Recenze jsou místo, kde leží skutečná firemní inteligence — analýza sentimentu, signály kultury, varovné signály v řízení.
Přejděte na stránku recenzí
URL recenzí mají tento tvar: /Reviews/{Company}-Reviews-E{id}.htm. Employer ID zjistíte vyhledáním firmy na Glassdooru a kontrolou URL.
def navigate_to_reviews(page, company_reviews_url):
    page.goto(company_reviews_url)
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)
    page.wait_for_selector('[data-test="review"]', timeout=15000)
Skrytý BFF endpoint (nejčistší cesta)
Tady je největší zjištění z mého výzkumu: recenze Glassdooru mají funkční interní JSON API, které úplně obchází parsování HTML. Repo se scrapery od Scrapfly tenhle endpoint dokumentuje a je mnohem spolehlivější než scraping DOM.
import json, re, requests

def get_review_ids(page):
    """Z HTML stránky recenzí vytáhne employerId a dynamicProfileId."""
    html = page.content()
    sel = Selector(text=html)
    script_text = sel.xpath(
        "//script[contains(text(), 'profileId')]/text()"
    ).get("")
    employer_match = re.search(r'"employer"\s*:\s*(\{[^}]+\})', script_text)
    if employer_match:
        meta = json.loads(employer_match.group(1))
        return meta.get("id"), meta.get("profileId")
    return None, None

def fetch_reviews_bff(page, employer_id, profile_id, max_pages=5):
    """Volá interní BFF endpoint Glassdooru pro strukturovaná data o recenzích."""
    all_reviews = []
    cookies = {c["name"]: c["value"] for c in page.context.cookies()}

    for pg in range(1, max_pages + 1):
        payload = {
            "applyDefaultCriteria": True,
            "employerId": employer_id,
            "dynamicProfileId": profile_id,
            "employmentStatuses": ["REGULAR", "PART_TIME"],
            "language": "eng",
            "onlyCurrentEmployees": False,
            "page": pg,
            "pageSize": 10,
            "sort": "DATE",
            "textSearch": "",
        }
        resp = requests.post(
            "https://www.glassdoor.com/bff/employer-profile-mono/employer-reviews",
            json=payload,
            cookies=cookies,
            headers={"Content-Type": "application/json"},
        )
        if resp.status_code != 200:
            print(f"BFF vrátil {resp.status_code} na stránce {pg}")
            break

        data = resp.json()
        reviews = data.get("data", {}).get("employerReviews", {}).get("reviews", [])
        total_pages = data.get("data", {}).get("employerReviews", {}).get("numberOfPages", 1)

        for r in reviews:
            all_reviews.append({
                "title": r.get("summary", ""),
                "rating": r.get("ratingOverall"),
                "pros": r.get("pros", ""),
                "cons": r.get("cons", ""),
                "author_role": r.get("jobTitle", {}).get("text", ""),
                "date": r.get("reviewDateTime", ""),
                "recommend": r.get("isRecommend"),
            })

        print(f"Stránka recenzí {pg}/{total_pages}: získáno {len(reviews)} recenzí")
        if pg >= total_pages:
            break
        time.sleep(random.uniform(3, 6))

    return all_reviews
Endpoint BFF ti vrátí čisté JSON s kompletními poli recenzí — žádné parsování HTML, žádné rozbíjení selektorů. Potřebuješ session cookies z autentizovaného kontextu v Playwrightu (popisuji v kroku 6 níže) a nejdřív musíš z HTML stránky recenzí vytáhnout employerId a dynamicProfileId.
HTML fallback selektory pro recenze
Pokud se BFF endpoint změní, nebo dáváš přednost parsování DOM, tady jsou stabilní selektory data-test:
| Pole | Selektor |
|---|---|
| Kontejner recenze | [data-test="review"] |
| Titulek | [data-test="review-title"] |
| Celkové hodnocení | [data-test="overall-rating"] |
| Pro | [data-test="pros"] |
| Proti | [data-test="cons"] |
| Datum | [data-test="review-date"] |
| Role autora | [data-test="author-jobTitle"] |
Krok 5: Scrapujte platová data z Glassdooru
Platové stránky jsou kompletně chráněné přihlášením. Než tento kód vrátí skutečná data, musíte mít autentizovanou session (krok 6).
Přejděte na stránku platů
Platové URL mají tvar: /Salary/{Company}-Salaries-E{id}.htm, stránkování je pak _P{n}.htm.
def scrape_salaries(page, salary_url, max_pages=3):
    all_salaries = []

    for pg in range(1, max_pages + 1):
        url = salary_url if pg == 1 else salary_url.replace(".htm", f"_P{pg}.htm")
        page.goto(url)
        page.add_style_tag(content="""
            #HardsellOverlay { display: none !important; }
            body { overflow: auto !important; position: initial !important; }
        """)
        time.sleep(random.uniform(3, 7))

        html = page.content()
        sel = Selector(text=html)
        items = sel.css('[data-test="salary-item"]')

        if not items:
            print(f"Platová stránka {pg}: Žádné položky — možná login gate nebo blokace.")
            break

        for item in items:
            salary = {
                "job_title": item.css('[class*="SalaryItem_jobTitle__"]::text').get("").strip(),
                "salary_range": item.css('[class*="SalaryItem_salaryRange__"]::text').get("").strip(),
                "count": item.css('[class*="SalaryItem_salaryCount__"]::text').get("").strip(),
            }
            all_salaries.append(salary)

        print(f"Platová stránka {pg}: seškrábáno {len(items)} záznamů")

    return all_salaries
Všimni si patternu [class*="SalaryItem_jobTitle__"]. Stránka s platy Glassdooru používá CSS-module hashované názvy tříd (např. SalaryItem_jobTitle__XWGpT), kde hashovaná přípona se mění při každém deployi. Prefix zůstává stabilní — hash ne. Nikdy napevno nezadávej celý název třídy.
Krok 6: Projděte Glassdoor login stěnu
Tohle je klíčová část, která odemyká platová data a plné texty recenzí. Postup je tento: jednou se ručně přihlásíte ve viditelném prohlížeči, uložíte autentizovaný stav session a pak ho znovu použijete pro všechny další běhy scrapingu.
Uložení autentizované session
Spusťte tenhle skript jednou. Otevře Chrome okno, přejde na Glassdoor login stránku (která dnes přesměruje na Indeed Login) a počká, až se přihlásíte ručně:
import asyncio
from pathlib import Path
from patchright.async_api import async_playwright

STATE_FILE = Path("glassdoor_state.json")

async def login_and_save():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=False, channel="chrome")
        context = await browser.new_context(
            viewport={"width": 1366, "height": 800},
            locale="en-US",
        )
        page = await context.new_page()
        await page.goto("https://www.glassdoor.com/profile/login_input.htm")
        print("Přihlaste se v okně prohlížeče a pak stiskněte Enter zde...")
        input()
        await context.storage_state(path=str(STATE_FILE))
        print(f"Session uložena do {STATE_FILE}")
        await browser.close()

asyncio.run(login_and_save())
Poté, co se přihlásíš a stiskneš Enter, Patchright uloží všechny cookies i local storage do souboru glassdoor_state.json. Ten obsahuje tvoje gdId, GSESSIONID, cf_clearance a autentizační tokeny.
Znovupoužití session pro scraping
Každý další běh scrapingu načte uložený stav — už není třeba ruční přihlášení:
async def scrape_with_auth(target_url):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, channel="chrome")
        context = await browser.new_context(
            storage_state="glassdoor_state.json"
        )
        page = await context.new_page()
        await page.goto(target_url)
        await page.add_style_tag(
            content="#HardsellOverlay{display:none!important}"
        )
        await page.wait_for_load_state("networkidle")
        html = await page.content()
        await browser.close()
        return html
Uložená session obvykle vydrží 20–30 minut aktivního používání, než Glassdoor znovu vyvolá kontrolu. Pro delší scraping běhy si připrav kontrolu: pokud stránka, která by měla obsahovat data, vrátí nula výsledků, spusť znovu login skript a obnov state file.
Jak rozpoznat a zavřít login popup
U částečně chráněných stránek (nabídky práce, které data zobrazují, ale přetíží je modal) funguje injekce CSS z předchozích kroků:
page.add_style_tag(content="""
    #HardsellOverlay, .LoginModal { display: none !important; }
    body { overflow: auto !important; position: initial !important; }
""")
To funguje jen tehdy, když HTML už obsahuje data pod overlayem. U plně serverově chráněných stránek (platy, hlubší recenze) je autentizovaná session z kroku 6 jediná cesta.
Tipy, jak udržet Glassdoor scraper funkční
Glassdoor často aktualizuje frontend. Tady je, jak do scraperu dostat odolnost.
Upřednostňujte atributy data-test před názvy tříd
Glassdoor náhodně mění CSS názvy tříd, ale atributy data-test obvykle zachovává. Vždy dávej přednost [data-test="jobListing"] před .jobCard_abc123. Když data-test není k dispozici (například u platových polí), použij prefix-match pattern: [class*="SalaryItem_jobTitle__"].
Rotujte proxy a náhodně prodlužujte pauzy
Používejte rotující rezidenční proxy — datacentrové IP adresy bývají zpochybněny téměř okamžitě. Přidejte náhodné pauzy 3–8 sekund mezi načítáními stránek (u delších běhů 5–15 sekund). Pokud můžete, vyhněte se scrapingu během pracovní doby v USA, kdy je behaviorální detekce Cloudflare nejpřísnější.
Sledujte, kdy něco přestane fungovat
Do scraperu si přidejte jednoduchou kontrolu: pokud stránka, která by měla obsahovat data, vrátí nula záznamů, ber to jako chybu selektoru, ne jako prázdný výsledek, a pošli si upozornění. Jednou týdně spusť malý testovací scraping, abys zachytil rozbití co nejdřív — Glassdoor nasazuje změny frontendů bez oznámení.
Pokud to jde, použijte rychlou cestu přes NEXT_DATA
Glassdoor je aplikace postavená na Next.js + Apollo GraphQL. Mnoho stránek posílá tag <script id="__NEXT_DATA__">, který obsahuje kompletní GraphQL cache jako JSON. Parsování tohohle je mnohem odolnější než scraping DOM a zcela obchází Hardsell overlay:
import json

def extract_next_data(html):
    sel = Selector(text=html)
    raw = sel.css("script#__NEXT_DATA__::text").get()
    if raw:
        return json.loads(raw)["props"]["pageProps"].get("apolloCache", {})
    return None
Vrátí ti strukturovanou Apollo cache se všemi poli o nabídkách práce, recenzích i platech — bez nutnosti CSS selektorů. Jde o nejodolnější dostupnou strategii extrakce, protože používá stejná data, která pohání React frontend Glassdooru.
Přeskočte kód: scrapujte Glassdoor s Thunderbit (bez Pythonu)
Ne každý, kdo tohle čte, je vývojář. Glassdoor data potřebují i HR týmy, náboráři, sales ops analytici a market research specialisté — a neměli by kvůli tomu spravovat Playwright contexty a rotaci proxy.
Thunderbit je AI Web Scraper Chrome Extension, která dokáže vytáhnout stejná data o nabídkách, recenzích i platech bez jediného řádku kódu. Pracuji v týmu Thunderbit, takže to říkám na rovinu — ale důvod, proč ho tady zmiňuji, je ten, že skutečně řeší dva nejtěžší problémy Glassdoor scrapingu.
Jak Thunderbit na Glassdooru funguje
Postup jsou dva kliky:
- Otevři jakoukoli stránku Glassdooru v Chrome (vyhledávání nabídek, recenze firmy, platová stránka)
- Klikni na AI Suggest Fields v postranním panelu Thunderbitu — AI přečte DOM stránky a navrhne sloupce (název pozice, firma, hodnocení, platové rozpětí, pro, proti atd.)
- Klikni na Scrape — data se vytáhnou do tabulky bez CSS selektorů nebo kódu pro automatizaci prohlížeče
Thunderbit má připravenou šablonu pro Glassdoor company scraper, která v jednom běhu vytáhne přes 23 polí o firmě. Pro nabídky práce, recenze nebo platy funguje obecný workflow AI Suggest Fields na jakoukoli URL z Glassdooru.
Jak obejít login wall bez kódu
Tady je pro Glassdoor konkrétně strukturální výhoda Thunderbitu. Browser Mode běží ve vaší vlastní Chrome relaci — pokud jsi do Glassdooru přihlášený v Chrome, Thunderbit automaticky převezme tvoje cookies. Login stěna, která blokuje server-side scrapery u platů a recenzí, se prostě neuplatní. Žádná správa cookies, žádné perzistentní contexty, žádný session kód.
Scraping podstránek pro obohacení dat
Začni na seznamové stránce (např. 30 firem z vyhledávání), nech Thunderbit projít řádky a potom zapni subpage scraping, aby navštívil stránku recenzí nebo platů každé firmy a obohatil tabulku o plné popisy, text recenzí nebo detailní platové informace.
Export do business nástrojů
Na rozdíl od Python skriptů, které dávají CSV nebo JSON, Thunderbit exportuje přímo do Google Sheets, Airtable, Notion nebo Excelu — zdarma ve všech plánech. To je obzvlášť užitečné pro týmy, které potřebují data sdílet a společně analyzovat.
Python vs. Thunderbit: kdy použít co
| Scénář | Doporučený přístup |
|---|---|
| Budujete opakovaně běžící datový pipeline | Python + Patchright |
| Jednorázový výzkum nebo menší týmový projekt | Thunderbit |
| Potřebujete programově řídit každé pole | Python |
| Nejste vývojář a potřebujete Glassdoor data dnes | Thunderbit |
| Scrapujete 1 000+ stránek v jednom běhu | Python + proxy |
| Scrapujete 30 firem s obohacením dat | Obojí funguje — Thunderbit je rychlejší na nastavení |
Ceny Thunderbitu začínají zdarma (6 stránek měsíčně), přičemž Pro plán stojí $38/měsíc za 3 000 kreditů. Při 1 kreditu na jeden výstupní řádek (2 kredity pro scraping podstránek) to stačí zhruba na 33 běhů po 30 obohacených firmách měsíčně.
Vyzkoušet Thunderbit pro scraping Glassdooru
Je scrapování Glassdooru legální?
Budu stručný a věcný. Podmínky používání Glassdooru Terms of Service výslovně zakazují automatizované scrapování: „You may not use any robot, spider, scraper... to access the Services for any purpose without our express written permission.“
Právní situace je ale složitější než jedna klauzule v podmínkách:
- Meta v. Bright Data (N.D. Cal., leden 2024): Soud rozhodl, že pokud se nikdy nepřihlásíš, nikdy jsi nepřijal ToS, a scrapování veřejně dostupného obsahu bez loginu je neporušuje
- hiQ Labs v. LinkedIn (9. obvod): CFAA se nevztahuje na automatizovaný sběr veřejně dostupných dat — ale falešné účty a scraping po přihlášení jsou jiný příběh
- Van Buren v. United States (Nejvyšší soud, 2021): Zúžil výklad „exceeds authorized access“ v rámci CFAA
Praktický závěr: scrapování veřejných nabídek práce bez přihlášení je právně o něco bezpečnější. Scrapování s přihlášenou session znamená, že jsi při registraci přijala podmínky používání, které to výslovně zakazují. To platí stejně pro Python skripty i pro Browser Mode v Thunderbitu.
Etická pravidla, která má smysl dodržovat vždy:
- Omezte rychlost pod úroveň lidského procházení
- Nescrapujte ani dál neprodávejte osobní údaje recenzentů
- Respektujte pravidla v robots.txt
- Tahajte jen pole, která skutečně potřebujete
Závěr: která metoda je pro vás ta pravá?
Tenhle průvodce pokryl všechny tři typy dat z Glassdooru — nabídky práce, recenze i platy — s funkčním kódem pro rok 2025, který bere v úvahu migraci na Indeed Login, Cloudflare Bot Management i rotaci CSS-module názvů tříd, která rozbila každý starší návod.
Tady je rozhodovací rámec:
| Vaše situace | Nejlepší cesta |
|---|---|
| Vývojář budující datový pipeline | Python + Patchright (postupujte podle kroků výše) |
| Jednorázový výzkum nebo opakované menší extrakce | Thunderbit (bez kódu, v prohlížeči) |
| Potřebujete jen základní nabídky práce v malém měřítku | Nejdřív ověřte, zda je ještě dostupný Glassdoor API přístup (pravděpodobně ne) |
| Potřebujete konkrétně platová nebo recenzní data | Musíte použít Python scraping nebo Thunderbit — API tyto věci nikdy nepokrývalo |
| Tým lidí bez vývojářských znalostí, kteří potřebují sdílená data | Thunderbit → export do Google Sheets |
Obrana Glassdooru se bude dál vyvíjet. Selektory se budou rozbíjet. Budou přibývat nové výzvy. Ulož si tenhle průvodce do záložek — a pokud chceš jít víc do hloubky v nástrojích a technikách web scrapingu, podívej se na naše články o nejlepších automatizovaných nástrojích pro web scraping, jak scrapovat data z webu pomocí Pythonu a nejlepších nástrojích pro scraping pracovních nabídek. Můžeš se také podívat na návody na Thunderbit YouTube kanálu.
Vyzkoušet Thunderbit pro extrakci dat z Glassdooru Get Started Free
Časté dotazy
1. Dá se Glassdoor scrapovat bez přihlášení?
Ano, u většiny dat z nabídek práce a základních firemních hodnocení. Ne, pokud chceš kompletní rozpis platů nebo plný text recenzí za prvními stránkami. #HardsellOverlay je modal jen v CSS — podkladové HTML stále obsahuje data z první stránky — ale hlubší obsah je serverově uzamčený za Glassdoor „give-to-get“ stěnou.
2. Která Python knihovna je v roce 2025 pro scraping Glassdooru nejlepší?
Patchright (stealth fork Playwrightu) je výchozí doporučení. Opravuje Runtime.Enable CDP leak, který má čistý Playwright a na který Cloudflare cíleně kontroluje. Pro stránky s nabídkami, které posílají __NEXT_DATA__ už v prvním HTML, je curl_cffi s impersonate="chrome124" 10–20× rychlejší, ale nezvládne stránky chráněné loginem.
3. Jak se vyhnout blokaci při scrapování Glassdooru?
Používej Patchright nebo rebrowser-playwright (ne čistý Playwright ani Selenium). Rotuj rezidenční proxy — datacentrové IP dostávají výzvy hned. Přidávej náhodné prodlevy 3–8 sekund mezi stránkami. Uchovávej cookies (gdId, cf_clearance, GSESSIONID) mezi požadavky. Počítej s oknem session 20–30 minut, než přijde nová výzva.
4. Existuje Glassdoor API, které můžu použít místo scrapingu?
Prakticky ne. Staré Partner API je uzavřené pro nové žadatele, veřejný endpoint pro recenze nikdy neexistoval a přes Indeed Publisher API není žádná migrační cesta. Pro recenze a platová data je scraping nebo no-code nástroj jako Thunderbit jediná praktická možnost.
5. Jak často se Glassdoor scrapery rozbíjejí?
Často. Glassdoor nasazuje frontendové změny bez oznámení a hash názvů CSS tříd se mění při každém buildu. Nejspolehlivější strategie extrakce jsou: (1) selektory podle atributu data-test, (2) JSON blob __NEXT_DATA__ a (3) interní BFF endpoint pro recenze. Přidej kontrolu na nulový výsledek a spouštěj malý testovací scraping každý týden, abys rozbití zachytil včas.
Více informací



