
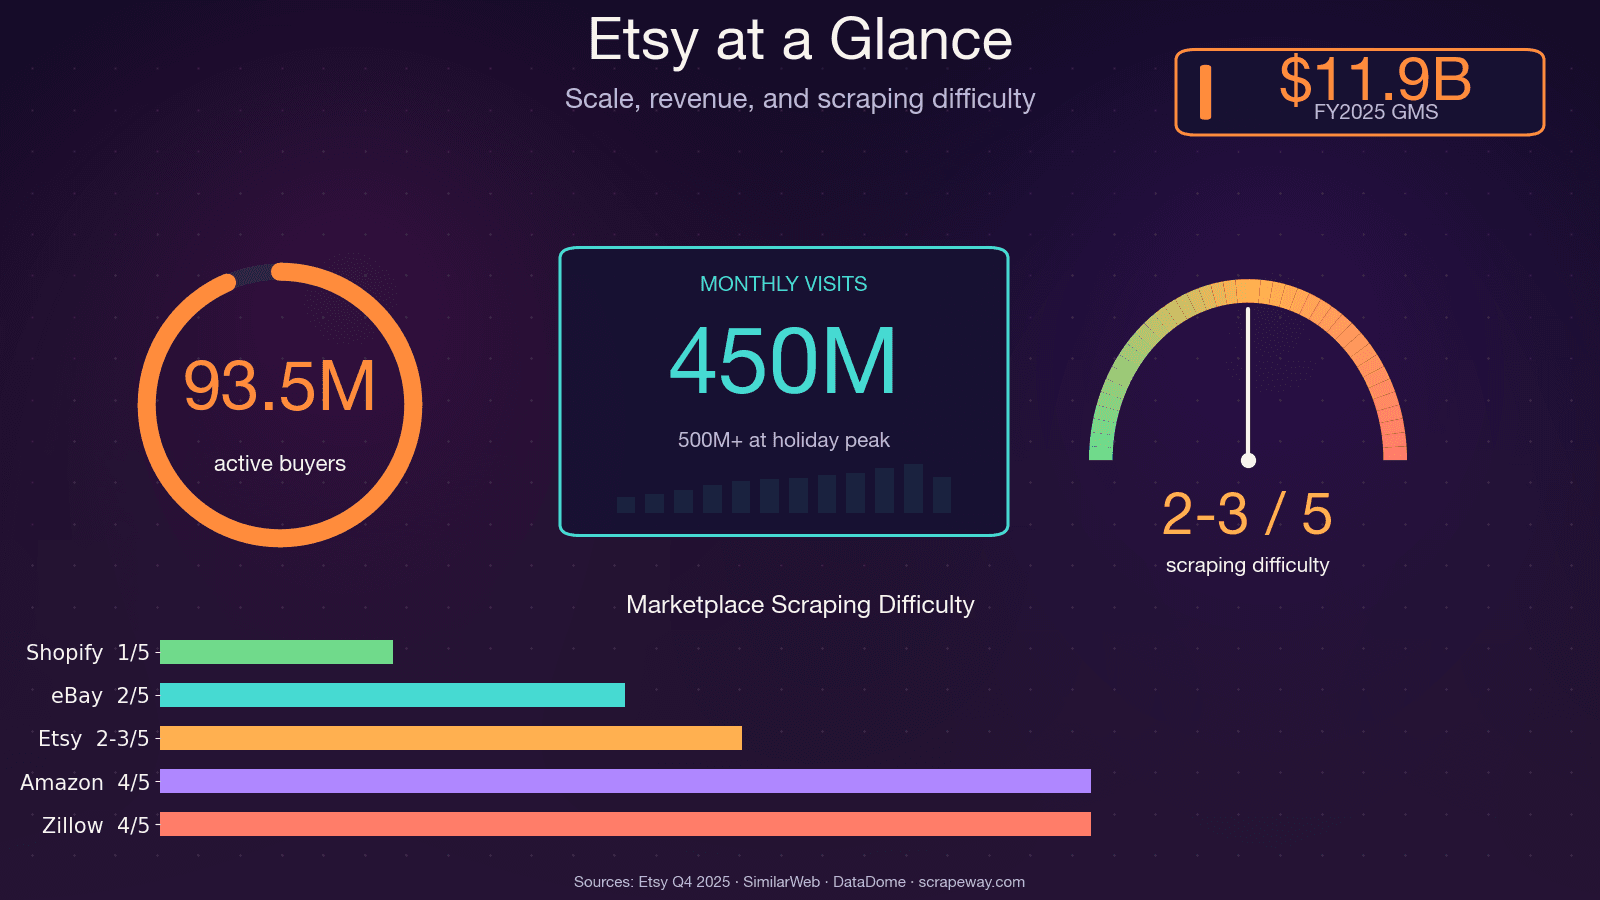
Etsy má přes 100 milionů aktivních nabídek, 5,6 milionu prodejců a zhruba 450 milionů návštěv měsíčně. Je to spousta veřejně dostupných dat o cenách, trendech, recenzích i konkurenci — a pokud jste je někdy zkoušeli sbírat ručně, víte, jaká je to dřina.
Jednou jsem strávil celý víkend ručním katalogizováním konkurenčních produktů pro projekt průzkumu trhu. Když jsem se dostal k produktu číslo 30, začal jsem přehodnocovat každé životní rozhodnutí, které mě dovedlo až k tomu spreadsheetu. Pravdou je, že data z Etsy mají obrovskou hodnotu pro cenovou analýzu, vývoj produktů, hledání nových výklenků i porovnávání prodejců — ale jen pokud je dokážete skutečně získat ve větším měřítku. O tom je tenhle průvodce: jeden návod, který ukazuje, jak z Etsy získávat data pomocí Pythonu napříč všemi čtyřmi hlavními typy stránek (výsledky vyhledávání, produktové stránky, stránky obchodů a recenze), plus otevřené zhodnocení obrany Etsy proti botům a no-code alternativu pro ty, kdo by raději přeskočili skriptování úplně.
Co znamená scrapovat Etsy pomocí Pythonu?
Web scraping v jednoduchosti znamená psaní kódu, který navštěvuje webové stránky a automaticky z nich vytahuje data, která vás zajímají — názvy produktů, ceny, popisy, obrázky, hodnocení, recenze, údaje o obchodě — a ukládá je do strukturované podoby, například do tabulky nebo databáze.
Python je pro tenhle typ práce první volba. Je přívětivý pro začátečníky, má obrovskou komunitu a velmi bohatý ekosystém knihoven určených pro scraping: Requests (pro stahování stránek), BeautifulSoup (pro parsování HTML), Selenium a Playwright (pro automatizaci prohlížeče) a pandas (pro organizaci a export dat). Python se ve výročních průzkumech Stack Overflow stabilně drží mezi třemi nejoblíbenějšími jazyky a jeho scrapingové knihovny patří mezi nejstahovanější na PyPI.
Když scrapujete Etsy, taháte data z HTML (a někdy ze skrytého JSONu), který Etsy doručuje do vašeho prohlížeče. Mezi data, která můžete získat, patří například:
- názvy produktů, ceny, popisy, obrázky a varianty
- informace o prodejci / obchodě (název, počet prodejů, lokalita, hodnocení)
- hodnocení a plný text recenzí
- položky z výsledků vyhledávání, kategorie a signály trendů
Proč scrapovat Etsy? Reálné případy použití, které přinášejí návratnost
Scraping Etsy není jen technické cvičení — je to konkurenční výhoda. Ať už jste prodejce, produktový manažer nebo datový analytik, strukturovaná data z Etsy po ruce mohou přímo ovlivnit vaše výsledky.
| Případ použití | Co scrapujete | Kdo z toho těží | Dopad na byznys |
|---|---|---|---|
| Analýza konkurenčních cen | Výsledky vyhledávání + ceny produktů | E-commerce provoz, prodejci | Dynamické stanovování cen může v průměru zvýšit tržby o 5–22 % |
| Hledání výklenků a trendů | Výsledky vyhledávání, trendující nabídky | Zakladatelé, analytici | Odhalte trendy výklenky včas (např. výraz „preppy pyžama“ zaznamenal růst vyhledávání o +1 112 %) |
| Vývoj a vylepšování produktů | Recenze, údaje o produktu | Produktové týmy | Jedna značka kuchyňského náčiní získala zpět pozici #1 Best Seller během 60 dnů díky analýze sentimentu v recenzích |
| SEO a výzkum klíčových slov | Výsledky vyhledávání, názvy / štítky produktů | Marketingové týmy | Identifikujte klíčová slova s vysokou poptávkou a nízkou konkurencí |
| Porovnávání prodejců | Stránky obchodů, počty prodejů | Obchodní týmy, analytici | Vytvářejte kvalitní leady za 0,01–0,10 USD / záznam místo kupovaných seznamů |
| Sledování zásob a dostupnosti | Dostupnost produktů | E-commerce provoz | Reagujte rychleji na změny skladových zásob konkurence |
Každý z těchto případů použití vyžaduje data z jiného typu stránky Etsy — a právě proto tento návod pokrývá všechny čtyři.
Úspora času: ručně vs. automaticky
- Ruční průzkum Etsy: 30–45 minut na produkt (50–75 hodin pro 100 produktů)
- Automatizovaný scraping: 100 nabídek za 2–5 minut
- Scraping s AI je o 30–40 % rychlejší a dosahuje přesnosti až 99,5 %
Etsy API vs. web scraping: co si vybrat?
Než napíšete jediný řádek kódu, stojí za to se zeptat: mám použít oficiální API Etsy, nebo web scrapovat web přímo? Tuhle otázku vídám ve fórech pořád dokola a odpověď záleží na tom, jaká data potřebujete.
Co Etsy API umí a co ne
Etsy nabízí API v3 s autentizací OAuth 2.0. Funguje pro přístup k datům vašeho vlastního obchodu — nabídky, objednávky, účtenky. Ale má skutečná omezení:
- Data konkurence: API je převážně omezené na váš vlastní obchod. Nepřečtete z něj ceny, prodeje ani nabídky jiného prodejce.
- Recenze: Neexistuje robustní endpoint pro hromadné získání plného textu recenzí.
- Rate limity: Ve výchozím nastavení 10 požadavků za sekundu, 10 000 požadavků za den. Limit offsetu je 12 000 záznamů.
- Použití AI / ML: Při kontrole aplikace je výslovně zamítnuto.
- Dokumentace: Stížnosti komunity jsou běžné — slabé příklady, zastaralé endpointy, pomalá podpora.
Kdy je web scraping lepší cesta
Pokud potřebujete konkurenční informace, sentiment recenzí, analýzu napříč obchody nebo data nad rámec toho, co API zpřístupňuje, je scraping správná volba. Cena za to je jasná: narazíte na ochranu Etsy proti botům (více níže) a budete muset investovat do nastavení.
Srovnávací tabulka: API vs. scraping vs. no-code
| Kritérium | Oficiální API Etsy | Python web scraping | Thunderbit (bez kódu) |
|---|---|---|---|
| Přístup k cenám produktů | ✅ (omezená pole) | ✅ Plné HTML / JSON-LD | ✅ AI vytáhne jakékoli viditelné pole |
| Data o recenzích | ❌ Hromadně nedostupná | ✅ Přes endpoint / HTML recenzí | ✅ Scraping podstránek |
| Data o obchodech konkurence | ❌ Jen vlastní obchod | ✅ Libovolný veřejný obchod | ✅ Libovolný veřejný obchod |
| Vyžadováno přihlášení | ✅ OAuth 2.0 | ⚠️ Cookies pro přihlášená data | ⚠️ Scraping v prohlížeči pro přihlášení |
| Riziko anti-bot blokace | Žádné | VYSOKÉ (DataDome) | Vyřešeno (nativně v prohlížeči) |
| Doba nastavení | Střední (API klíče, OAuth) | Vysoká (kód + proxy) | ~2 minuty |
Pokud potřebujete data o konkurenci, recenze nebo analýzu napříč obchody, API to prostě nepokrývá. To je upřímný stav věci.
Vyberte si Python přístup dřív, než napíšete jediný řádek kódu
Otázka, kterou na Redditu a Stack Overflow vídám pořád: „Mám použít Requests + BeautifulSoup, Selenium, proxy API, nebo něco úplně jiného?“ Správná odpověď záleží na vašich dovednostech, rozpočtu a použití.
| Přístup | Nejlepší pro | Náročnost učení | Zvládá JS? | Anti-bot ochrana | Cena |
|---|---|---|---|---|---|
| Requests + BeautifulSoup | Vývojáře, kteří chtějí plnou kontrolu | Střední | ❌ | Ručně (hlavičky, proxy) | Zdarma + náklady na proxy |
| Selenium / Playwright | Stránky náročné na JS, přihlašovací flow | Vysoká | ✅ | Částečně (browser fingerprint) | Zdarma + náklady na proxy |
| Proxy API služby | Škálování + obcházení anti-bot ochrany | Střední | ✅ (přes API) | ✅ Vestavěné | od 49 USD / měsíc |
| Thunderbit (no-code) | Netechnické uživatele, rychlou extrakci | Velmi nízká | ✅ (nativně v prohlížeči) | ✅ (browser session) | K dispozici free tier |
Pokud chcete plnou kontrolu a s Pythonem si rozumíte, jděte do Requests + BeautifulSoup. Pokud potřebujete renderování JS nebo přihlašovací flow, použijte Selenium. Pokud chcete ve velkém obejít anti-bot ochranu, zvažte proxy službu. A pokud chcete data z Etsy bez psaní nebo údržby kódu, stojí Thunderbit za pozornost — za chvíli se k tomu dostaneme.
Jak Etsy bojuje zpět: porozumění ochraně DataDome proti botům
Většina návodů na scraping vám řekne „prostě použij proxy“ a jde dál. U Etsy to nestačí. Etsy používá DataDome, jeden z nejagresivnějších anti-bot systémů na webu. Vlastní případová studie DataDome uvádí Etsy jako úspěch a zmiňuje, že scrapeři kdysi tvořili asi 1 % výpočetních nákladů Etsy.
Co je DataDome a jak funguje?
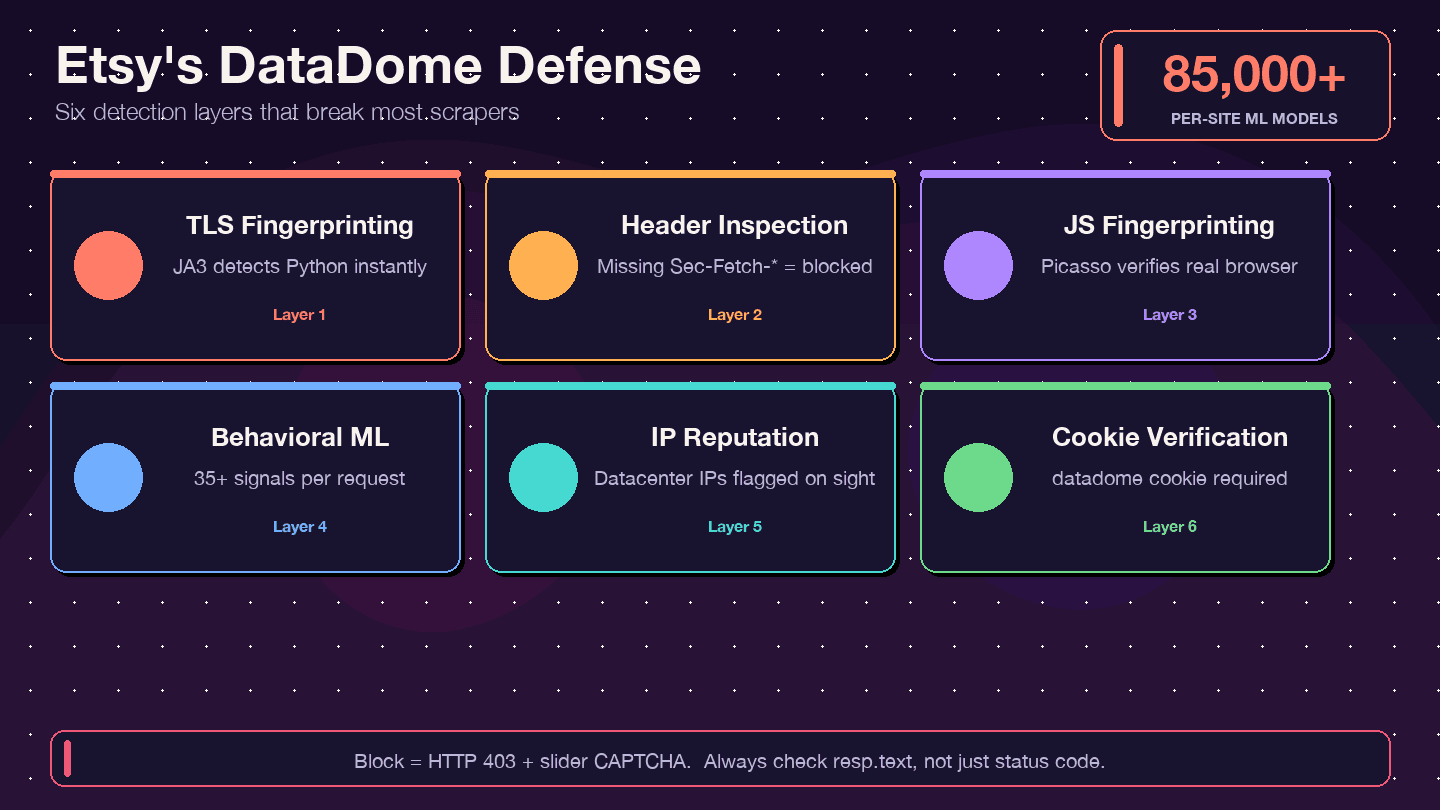
DataDome nekontroluje jen vaši IP adresu. Používá vícevstvený detekční stack:
- TLS fingerprinting (JA3): Knihovna
requestsv Pythonu má výrazný TLS otisk, který DataDome dokáže okamžitě rozpoznat. - Kontrola HTTP hlaviček a protokolu: Prověřuje kompletní a konzistentní browser hlavičky — chybějící nebo nesprávně seřazené hlavičky jsou varovným signálem.
- JavaScript fingerprinting (protokol Picasso): Spouští JS challenge v prohlížeči a ověřuje, že jste skutečný uživatel.
- Behaviorální ML: Analyzuje více než 35 signálů na každý požadavek, s více než 85 000 modely pro jednotlivé weby.
- Hodnocení reputace IP: Datacentrové IP adresy jsou okamžitě označeny.
- Ověřování cookies: Cookie
datadomemusí být přítomná a platná.
Jak poznat, že jste zablokováni (a jak to ověřit)
Jeden z nejčastějších háčků: dostanete odpověď 200 OK, ale HTML ve skutečnosti patří CAPTCHA stránce, ne datům, která jste chtěli. Další signály:
- chyby 403 Forbidden
- smyčky přesměrování
- tělo odpovědi obsahuje JavaScript objekt
ddnebo HTML slider CAPTCHA
Vždy kontrolujte tělo odpovědi, ne jen stavový kód. Rychlá kontrola:
if "captcha" in resp.text.lower() or "datadome" in resp.text.lower():
    print("Blokováno! Místo dat přišla CAPTCHA stránka.")
Hlavičky a cookies, které snižují detekci
Nikdy nezaručíte, že zablokováni nebudete, ale realistické hlavičky a práce s cookies výrazně pomáhají:
session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/133.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="133", "Not-A.Brand";v="99", "Google Chrome";v="133"',
    "Sec-Ch-Ua-Mobile": "?0",
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Upgrade-Insecure-Requests": "1",
})
Důležité je také:
- Udržovat cookies mezi požadavky pomocí
requests.Session(). - Přidávat náhodná zpoždění (2–7 sekund) mezi požadavky.
- Simulovat referrer chain: nejdřív navštívit domovskou stránku, pak vyhledávání, pak produktové stránky.
- Ve větším měřítku je nezbytná rotace residential proxy. Datacentrové IP jsou označeny téměř okamžitě.
Tyto techniky detekci snižují, ale neodstraňují ji. Pro scraping ve vysokém objemu budete pravděpodobně potřebovat proxy službu nebo přístup založený na prohlížeči.
Příprava Python prostředí pro scraping Etsy
Než začnete:
- Náročnost: Střední
- Potřebný čas: ~30–60 minut (nastavení + první scraping)
- Co budete potřebovat: Python 3.8+, pip, editor kódu, prohlížeč Chrome (pro kontrolu v DevTools)
Instalace závislostí
Vytvořte složku projektu, nastavte virtuální prostředí a nainstalujte knihovny, které budete potřebovat:
mkdir etsy-scraper && cd etsy-scraper
python -m venv venv
source venv/bin/activate  # Na Windows: venv\Scripts\activate

pip install requests beautifulsoup4 lxml pandas
- requests — stahuje webové stránky
- beautifulsoup4 — parsuje HTML
- lxml — rychlejší HTML parser (volitelný, ale doporučený)
- pandas — strukturuje data a exportuje je do CSV / Excelu
Pokud později budete potřebovat automatizaci prohlížeče (pro přihlášení nebo stránky náročné na JS), nainstalujte také:
pip install selenium
Než začnete programovat, pochopte strukturu stránky Etsy
Tady je tip, který vám ušetří spoustu času: Etsy na většině stránek vkládá strukturovaná data o produktu do tagů <script type="application/ld+json">. Tato JSON-LD data jsou už uspořádaná — název produktu, cena, hodnocení, obrázky — takže se nemusíte prát s křehkými CSS selektory pro každé pole.
Otevřete libovolnou produktovou stránku Etsy, klikněte pravým tlačítkem, zvolte „Zobrazit zdroj stránky“ a vyhledejte application/ld+json. Najdete blok s @type: Product, který obsahuje většinu dat, která potřebujete. Stránky s výsledky vyhledávání mají @type: ItemList.
CSS selektory jsou pořád užitečné jako záloha (pro data, která nejsou v JSON-LD, jako dopravní informace nebo text recenzí), ale JSON-LD by měl být vaše první zastávka.
Krok 1: Scrapujte výsledky vyhledávání Etsy pomocí Pythonu
Výsledky vyhledávání jsou výchozím bodem pro většinu Etsy scraping projektů — ať už sledujete výklenek, kontrolujete ceny konkurence, nebo budujete databázi produktů.
Sestavte URL pro vyhledávání
URL pro vyhledávání Etsy mají tento tvar:
https://www.etsy.com/search?q={keyword}&ref=pagination&page={page_number}
U víceslovných dotazů zakódujte mezery v URL (např. handmade+jewelry nebo handmade%20jewelry). Parametr ref=pagination způsobí, že požadavek vypadá víc jako skutečná navigace v prohlížeči.
Další užitečné parametry: order (most_relevant, price_asc, price_desc, date_desc), min_price, max_price, ship_to, free_shipping=true. Každá stránka vrací 48 položek.
Odeslání požadavku a parsování HTML
import requests
from bs4 import BeautifulSoup
import json
import time
import random

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
}

def scrape_etsy_search(query, max_pages=3):
    all_products = []
    for page in range(1, max_pages + 1):
        url = f"https://www.etsy.com/search?q={query}&ref=pagination&page={page}"
        resp = requests.get(url, headers=headers, timeout=30)
        if "captcha" in resp.text.lower():
            print(f"Na stránce {page} došlo k blokaci. Zkuste přidat prodlevy nebo proxy.")
            break
        soup = BeautifulSoup(resp.text, "lxml")
        for script in soup.find_all("script", type="application/ld+json"):
            data = json.loads(script.string)
            if data.get("@type") == "ItemList":
                for item in data.get("itemListElement", []):
                    all_products.append({
                        "name": item.get("name"),
                        "url": item.get("url"),
                        "image": item.get("image"),
                        "price": item.get("offers", {}).get("price"),
                        "currency": item.get("offers", {}).get("priceCurrency"),
                        "position": item.get("position"),
                    })
        time.sleep(random.uniform(2, 5))
    return all_products
Extrakce dat o nabídkách z JSON-LD
Pole itemListElement vám dá název položky, URL, obrázek, cenu a měnu. Pokud potřebujete také hvězdičkové hodnocení nebo počet výsledků (ne vždy jsou v JSON-LD), použijte CSS selektory:
- karta nabídky:
.v2-listing-card - název:
h3.v2-listing-card__title - cena:
span.currency-value - odkaz:
a.listing-link(href)
Práce s paginací
Procházejte stránky v cyklu a mezi požadavky přidávejte náhodnou prodlevu. Etsy obvykle vrací až 20–250 stránek podle dotazu.
results = scrape_etsy_search("handmade+jewelry", max_pages=5)
print(f"Scrapováno {len(results)} produktů.")
U scrape na 5 stránek to v mém testu zabralo asi 20 sekund — oproti 30+ minutám ručního kopírování.
Krok 2: Scrapujte produktové stránky Etsy pomocí Pythonu
Jakmile máte seznam URL produktů z vyhledávání, dalším krokem je tahat podrobné údaje z každé produktové stránky.
Načtěte produktovou stránku
def scrape_etsy_product(url):
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "Product":
            offers = data.get("offers", {})
            price = offers.get("price") or offers.get("lowPrice")
            rating_data = data.get("aggregateRating", {})
            return {
                "name": data.get("name"),
                "description": data.get("description", "")[:500],
                "brand": data.get("brand", {}).get("name") if isinstance(data.get("brand"), dict) else data.get("brand"),
                "category": data.get("category"),
                "price": price,
                "currency": offers.get("priceCurrency"),
                "availability": offers.get("availability"),
                "rating": rating_data.get("ratingValue"),
                "review_count": rating_data.get("reviewCount"),
                "images": data.get("image", []),
                "sku": data.get("sku"),
                "material": data.get("material"),
            }
    return None
Práce s cenovými variantami
Některé produkty mají jedinou hodnotu offers.price. Jiné (s variantami jako velikost nebo barva) používají offers.lowPrice a offers.highPrice. Kód výše umí obojí, protože přechází z price na lowPrice.
Parsování dalších polí přes CSS selektory
U dat, která nejsou v JSON-LD — dopravní informace, varianty, plné údaje o prodejci — budete potřebovat CSS selektory:
- název:
h1[data-buy-box-listing-title] - varianty:
select[data-selector-id]nebodiv[data-option-set] - doprava:
div.wt-text-captionpoblíž sekce dopravy
Výhoda: JSON-LD je čistší a stabilnější při změnách rozložení. CSS selektory jsou křehké, ale pokrývají více polí.
Krok 3: Scrapujte stránky obchodů Etsy pomocí Pythonu
Tohle je část, kterou většina konkurenčních průvodců úplně přeskočí — a přitom je možná nejcennější pro obchodní týmy a konkurenční analytiky.
Sestavte URL obchodu a stáhněte stránku
def scrape_etsy_shop(shop_name):
    url = f"https://www.etsy.com/shop/{shop_name}"
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")

    # Metadata obchodu z HTML (ne z JSON-LD)
    sales_el = soup.select_one("div.shop-sales-reviews a")
    rating_el = soup.find("input", {"name": "initial-rating"})
    location_el = soup.select_one("div.shop-location")

    shop_data = {
        "name": shop_name,
        "sales": sales_el.text.strip() if sales_el else None,
        "rating": rating_el["value"] if rating_el else None,
        "location": location_el.text.strip() if location_el else None,
    }

    # Nabídky z JSON-LD
    listings = []
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "ItemList":
            for item in data.get("itemListElement", []):
                listings.append({
                    "name": item.get("name"),
                    "url": item.get("url"),
                    "price": item.get("offers", {}).get("price"),
                })
    shop_data["listings"] = listings
    return shop_data
Co můžete ze stránek obchodů vytáhnout
JSON-LD na stránkách obchodů má @type: ItemList — pokrývá produktové nabídky, ale ne metadata na úrovni obchodu, jako je počet prodejů, lokalita nebo hodnocení. Na to potřebujete CSS selektory:
| Datový bod | Selektor | Poznámka |
|---|---|---|
| Název obchodu | h1 nebo meta title | Obvykle v názvu stránky |
| Celkový počet prodejů | div.shop-sales-reviews a | Text typu „12 345 prodejů“ |
| Hvězdičkové hodnocení | hodnota input[name="initial-rating"] | Číselné 1–5 |
| Lokalita | div.shop-location | Město, země |
| Členem od | div.shop-info | Text s datem |
Data o obchodech jsou mimořádně cenná pro tvorbu seznamů leadů, benchmark konkurence nebo identifikaci nejúspěšnějších prodejců v daném výklenku.
Krok 4: Scrapujte recenze Etsy pomocí Pythonu
Recenze patří mezi nejcennější — a zároveň nejsložitější — datové body na Etsy. Plný text recenzí, hodnocení i data nejsou v úvodním HTML stránky; načítají se přes interní API endpoint.
Přístup 1: Objevení interního API endpointu pro recenze Etsy
Otevřete produktovou stránku v Chromu, spusťte DevTools (F12), přejděte na kartu Network a sjeďte dolů do sekce recenzí. Uvidíte POST požadavek na něco jako:
https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews
Tento endpoint vrací HTML fragmenty obsahující karty recenzí. Abyste jej mohli použít, potřebujete:
- listing_id — číselné ID z URL produktu
- shop_id — vytáhněte z HTML stránky pomocí regulárního výrazu
- csrf_nonce — vytáhněte z
<meta>tagu na stránce
Extrakce ID a CSRF tokenu
import re

def get_review_params(product_url):
    resp = requests.get(product_url, headers=headers)
    html = resp.text
    listing_id = product_url.split("/")[-1].split("?")[0]
    shop_id_match = re.search(r'"shopId"\s*:\s*(\d+)', html)
    shop_id = shop_id_match.group(1) if shop_id_match else None
    soup = BeautifulSoup(html, "lxml")
    csrf_meta = soup.find("meta", {"name": "csrf_nonce"})
    csrf = csrf_meta["content"] if csrf_meta else None
    return listing_id, shop_id, csrf
Scraping recenzí s paginací
def scrape_reviews(listing_id, shop_id, csrf, max_pages=5):
    session = requests.Session()
    session.headers.update(headers)
    all_reviews = []
    for page in range(1, max_pages + 1):
        payload = {
            "specs": {
                "deep_dive_reviews": {
                    "module_path": "neu/specs/deep_dive_reviews",
                    "listing_id": listing_id,
                    "shop_id": shop_id,
                    "page": page,
                }
            }
        }
        resp = session.post(
            "https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews",
            json=payload,
            headers={"x-csrf-token": csrf, "Content-Type": "application/json"},
        )
        data = resp.json()
        html_fragment = data.get("output", {}).get("deep_dive_reviews", "")
        review_soup = BeautifulSoup(html_fragment, "lxml")
        for card in review_soup.select("div.review-card"):
            rating_el = card.find("input", {"name": "rating"})
            text_el = card.select_one("div.wt-text-body")
            user_el = card.select_one("a[data-review-username]")
            date_el = card.select_one("p.wt-text-body-small")
            all_reviews.append({
                "rating": rating_el["value"] if rating_el else None,
                "text": text_el.text.strip() if text_el else None,
                "reviewer": user_el.text.strip() if user_el else None,
                "date": date_el.text.strip() if date_el else None,
            })
        time.sleep(random.uniform(2, 5))
    return all_reviews
Přístup 2: Parsování recenzí z HTML (záloha)
Když API přístup selže (například kvůli problémům s CSRF tokenem), můžete první stránku recenzí parsovat přímo z HTML produktové stránky. Omezení: ve statickém HTML je jen úvodní dávka recenzí. Pro víc jich budete potřebovat API nebo nástroj pro automatizaci prohlížeče, například Selenium.
Práce s daty, která vyžadují přihlášení: scraping vlastního obchodu Etsy
Tohle je mezera, kterou žádný jiný návod běžně nepokrývá, ale je to reálná potřeba — zejména pro prodejce na Etsy, kteří chtějí vytáhnout vlastní objednávky, tržby a statistiky.
Problém je jednoduchý: samotný requests nemá přístup k vašemu dashboardu Etsy, protože nenese cookies vaší přihlašovací relace.
Možnost 1: Selenium s ručním přihlášením a získáním cookies
Použijte Selenium k otevření prohlížeče, přihlaste se ručně (nebo přihlášení automatizujte) a pak pokračujte ve scrapingu již jako přihlášený uživatel:
from selenium import webdriver

driver = webdriver.Chrome()
driver.get("https://www.etsy.com/signin")
# Přihlaste se ručně v okně prohlížeče a pak:
input("Po přihlášení stiskněte Enter...")

cookies = driver.get_cookies()
# Pak použijte driver.get() pro navigaci na stránky dashboardu a scrapování
Cookies ze Selenium relace můžete také uložit a po úvodním přihlášení je znovu použít v requests.Session() pro rychlejší a lehčí scraping.
Možnost 2: Export cookies z prohlížeče pro použití v Requests
Použijte rozšíření prohlížeče (například „EditThisCookie“) k exportu aktivních cookies relace Etsy a načtěte je do Requests session:
import requests

session = requests.Session()
# Přidejte cookies exportované z prohlížeče
session.cookies.set("uaid", "YOUR_UAID_VALUE", domain=".etsy.com")
session.cookies.set("user_prefs", "YOUR_USER_PREFS_VALUE", domain=".etsy.com")
# ... podle potřeby přidejte další session cookies

resp = session.get("https://www.etsy.com/your/orders", headers=headers)
Snadná cesta: browser scraping mód Thunderbit
Protože Thunderbit běží uvnitř vašeho prohlížeče Chrome, automaticky přebírá vaši aktivní přihlášenou relaci Etsy. Žádný autentizační kód, žádný export cookies — prostě otevřete svůj dashboard na Etsy a scrapujte. Je to opravdu užitečné pro získání objednávek, tržeb, statistik a dalších dat dostupných jen pro prodejce, bez jakéhokoli skriptování.
Scrapujte svůj dashboard Etsy pomocí AI
Export a využití nasbíraných dat z Etsy
Uložení do CSV nebo JSON
import pandas as pd

df = pd.DataFrame(results)
df.to_csv("etsy_products.csv", index=False, encoding="utf-8")
df.to_json("etsy_products.json", orient="records", indent=2)
Doporučené postupy: do názvů souborů přidávejte časové razítko, používejte kódování UTF-8 a ošetřete speciální znaky v názvech produktů (prodejci na Etsy milují emoji a diakritiku).
Export do Google Sheets, Airtable nebo Notion
Pro uživatele Pythonu existují knihovny jako gspread (Google Sheets) nebo Airtable API, které umožňují data odesílat programově. Pokud ale používáte Thunderbit, všechny exporty — do Google Sheets, Excelu, Airtable i Notionu — jsou zdarma a na jedno kliknutí. Žádné API klíče, žádné nastavování OAuth.
Přeskočte kód: jak scrapovat Etsy s Thunderbit (no-code alternativa)
Ne každý chce psát Python skripty, spravovat proxy konfigurace nebo ve dvě ráno ladit CSS selektory. Jestli jste to vy, tady je, jak získat data z Etsy pomocí Thunderbit.
Nainstalujte rozšíření Thunderbit do Chromu
Přejděte do Chrome Web Store a nainstalujte Thunderbit. Vytvořte si zdarma účet — free plán vám dá 6 stránek měsíčně a všechny exporty jsou zdarma.
Použijte AI Suggest Fields na libovolné stránce Etsy
Otevřete vyhledávání, produkt nebo stránku obchodu na Etsy. V postranním panelu Thunderbit klikněte na „AI Suggest Fields“. AI prohledá stránku a navrhne sloupce — název produktu, cena, hodnocení, obrázky, název obchodu, tagy, informace o dopravě. Podle potřeby sloupce upravte nebo přidejte.
Klikněte na Scrape a exportujte
Klikněte na „Scrape“ a vytáhněte data z aktuální stránky. U vícestránkových výsledků použijte paginované scrapování v Thunderbit. Pokud chcete obohatit seznam URL produktů o detailní data z každé produktové stránky (popisy, recenze, doprava), použijte scraping podstránek — Thunderbit navštíví každý odkaz a automaticky vytáhne doplňující data.
Exportujte do Excelu, Google Sheets, Airtable nebo Notionu — vše zdarma.
Kdy Thunderbit pro scraping Etsy poráží Python
- Není potřeba nastavovat proxy ani psát anti-bot kód. Thunderbit běží ve vašem skutečném prohlížeči Chrome, takže přebírá vaši relaci a pro DataDome vypadá jako běžný uživatel.
- AI se automaticky přizpůsobuje změnám rozložení. Když Etsy upraví frontend, nemusíte opravovat rozbité selektory.
- Skvělé pro jednorázový průzkum, konkurenční analýzu nebo netechnické členy týmu. Pokud potřebujete jen rychlý dataset, nepotřebujete Python prostředí.
- Scraping podstránek vám umožní obohatit seznam URL produktů o detailní data bez psaní vnořených smyček.
Pro ukázku se podívejte na Thunderbit YouTube kanál.
Srovnání nákladů Python vs. Thunderbit za 6 měsíců
| Faktor | Python svépomocí | Thunderbit |
|---|---|---|
| Doba nastavení | 8–20 hodin | Pod 5 minut |
| Náklady za 6 měsíců (vč. práce, proxy) | 2 720–9 450 USD | 90–228 USD |
| Měsíční údržba | 4–10+ hodin (aktualizace selektorů = přes 80 % režie) | 0–1 hodina |
| Anti-bot ochrana | Residential proxy za 85× běžnou cenu kreditu | Browser-based, nativně obchází DataDome |
| Kvalita dat | Vysoká (s úsilím) | Vysoká (řízená AI) |
Neříkám, že Python je špatná volba — pokud potřebujete plnou kontrolu, vlastní logiku nebo integraci do většího pipeline, kód je král. Ale pro většinu byznysových uživatelů, kteří prostě potřebují data z Etsy, vychází ROI spíš ve prospěch no-code nástroje.
Právní a etické tipy pro scraping Etsy
Na každém článku o scrapingu se mě lidé ptají na legalitu, takže tady je stručná verze:
- Podmínky používání Etsy výslovně zakazují automatizovaný přístup. Etsy nicméně spoléhá spíš na technické vynucení (DataDome) než na soudní spory — nejsou známy žádné žaloby specificky proti scraperům na Etsy.
- Scrapujte jen veřejně dostupná data. Neobcházejte autentizaci ani nepřistupujte do soukromých seller dashboardů, které nevlastníte.
- Používejte rozumné tempo požadavků. Prodlevy 2–7 sekund mezi požadavky a žádné bombardování serverů Etsy.
- Respektujte
robots.txt. Etsy dovoluje vyhledávací stránky, ale některé cesty omezuje. - Zacházejte s osobními údaji zodpovědně podle zákonů o ochraně soukromí, jako je GDPR.
- U komerčních scraping projektů ve větším měřítku se poraďte s právníkem.
Další souvislosti najdete v našem článku o právních dopadech web scrapingu — včetně případu Meta v. Bright Data (2024), kde bylo scrapování veřejných dat potvrzeno.
Závěr: klíčové poznatky
Prošli jsme toho hodně. Tady je to hlavní, co si z toho odnést:
- Strukturovaná JSON-LD data Etsy usnadňují extrakci oproti surovému HTML u většiny polí.
- DataDome je skutečná překážka — pro scraping v Pythonu ve větším měřítku používejte správné hlavičky, prodlevy, správu cookies a residential proxy.
- API Etsy je omezené. Pokud potřebujete recenze, konkurenční obchody nebo analýzu napříč prodejci, scraping je praktická cesta.
- Thunderbit nabízí no-code alternativu s nativním řešením anti-bot ochrany i autentizace — vyplatí se ho zkusit, pokud chcete data z Etsy bez údržby skriptů.
- Scrapujte vždy zodpovědně a respektujte podmínky Etsy.
Pokud chcete začít bez psaní kódu, vyzkoušejte Thunderbit zdarma. Nebo použijte Python kód z tohoto návodu a sestavte si vlastní scraper — a ať se vám selektory nikdy nerozbijí v pátek odpoledne.
Další návody najdete v našem průvodci Etsy scraperem a v přehledu nejlepších AI web scraperů.
Vyzkoušejte Thunderbit a scrapujte data z Etsy rychleji Get Started Free
FAQ
1. Je legální scrapovat Etsy pomocí Pythonu?
Scraping veřejně dostupných dat je obecně přípustný podle nedávné judikatury (např. Meta v. Bright Data, hiQ v. LinkedIn). Podmínky používání Etsy však automatizovaný přístup zakazují, proto si před scrapingem vždy projděte jejich ToS a robots.txt. Pro rozsáhlé nebo komerční využití se poraďte s právníkem.
2. Dá se scrapovat Etsy, aniž by mě zablokovali?
Etsy používá DataDome, jeden z nejtvrdších anti-bot systémů. Realistické hlavičky, prodlevy mezi požadavky, trvalé cookies a rotace residential proxy pomáhají blokace omezit. Přístup Thunderbitu nativně v prohlížeči většinu detekce obchází, protože funguje ve vaší skutečné relaci Chrome.
3. Má Etsy API, které mohu použít místo scrapingu?
Ano — Etsy nabízí API v3, ale je z velké části omezené na data vašeho vlastního obchodu a nemá robustní přístup k recenzím. Většina use case pro konkurenční zpravodajství a analýzu napříč obchody vyžaduje scraping.
4. Jaké Python knihovny potřebuji pro scraping Etsy?
Minimálně: requests, beautifulsoup4, pandas (pro export) a json (vestavěný). Pro stránky náročné na JS nebo vyžadující přihlášení přidejte selenium. Pro rychlejší parsování HTML použijte lxml.
5. Jak přesně scrapovat recenze Etsy?
Recenze Etsy se načítají přes interní API endpoint (/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews). Budete muset z produktové stránky vytáhnout listing ID, shop ID a CSRF token a pak na endpoint posílat POST požadavky s paginací. Jako zálohu můžete z HTML produktové stránky parsovat první várku recenzí — oba postupy jsou v tomto návodu popsány krok za krokem.
Další informace



