

Web scraping se z okrajové dovednosti stal nepostradatelnou superschopností pro každého, kdo pracuje v sales, operations nebo market research. S tím, jak objem webových dat prudce roste — globální tvorba dat vzrostla mezi lety 2019 a 2023 téměř o 193 % — není divu, že 81 % firem dnes považuje data za „srdce“ svého rozhodování. Háček je ale v tom, že 95 % organizací říká, že práce s nestrukturovanými daty (například s neuspořádaným HTML) je velká výzva. Viděl jsem spoustu týmů, které se topí v nekonečném kopírování a vkládání, když se snaží dostat informace z webů do tabulek — věřte mi, nevypadá to hezky.
Získejte data z libovolného webu pomocí AI Get Started Free
A právě tady přichází ke slovu Python a BeautifulSoup. V tomhle praktickém návodu vám ukážu, jak používat BeautifulSoup pro web scraping, a přidám i konkrétní příklad v Pythonu, který si snadno upravíte podle vlastních obchodních potřeb. A protože mi jde o chytřejší práci, ne o tvrdší práci, ukážu vám také, jak BeautifulSoup zkombinovat s Thunderbit, naším AI web scraperem, abyste urychlili svůj workflow a získali čistší, strukturovanější data — bez ohledu na to, jak dobře umíte programovat.
Co je BeautifulSoup a proč ho používat pro web scraping?
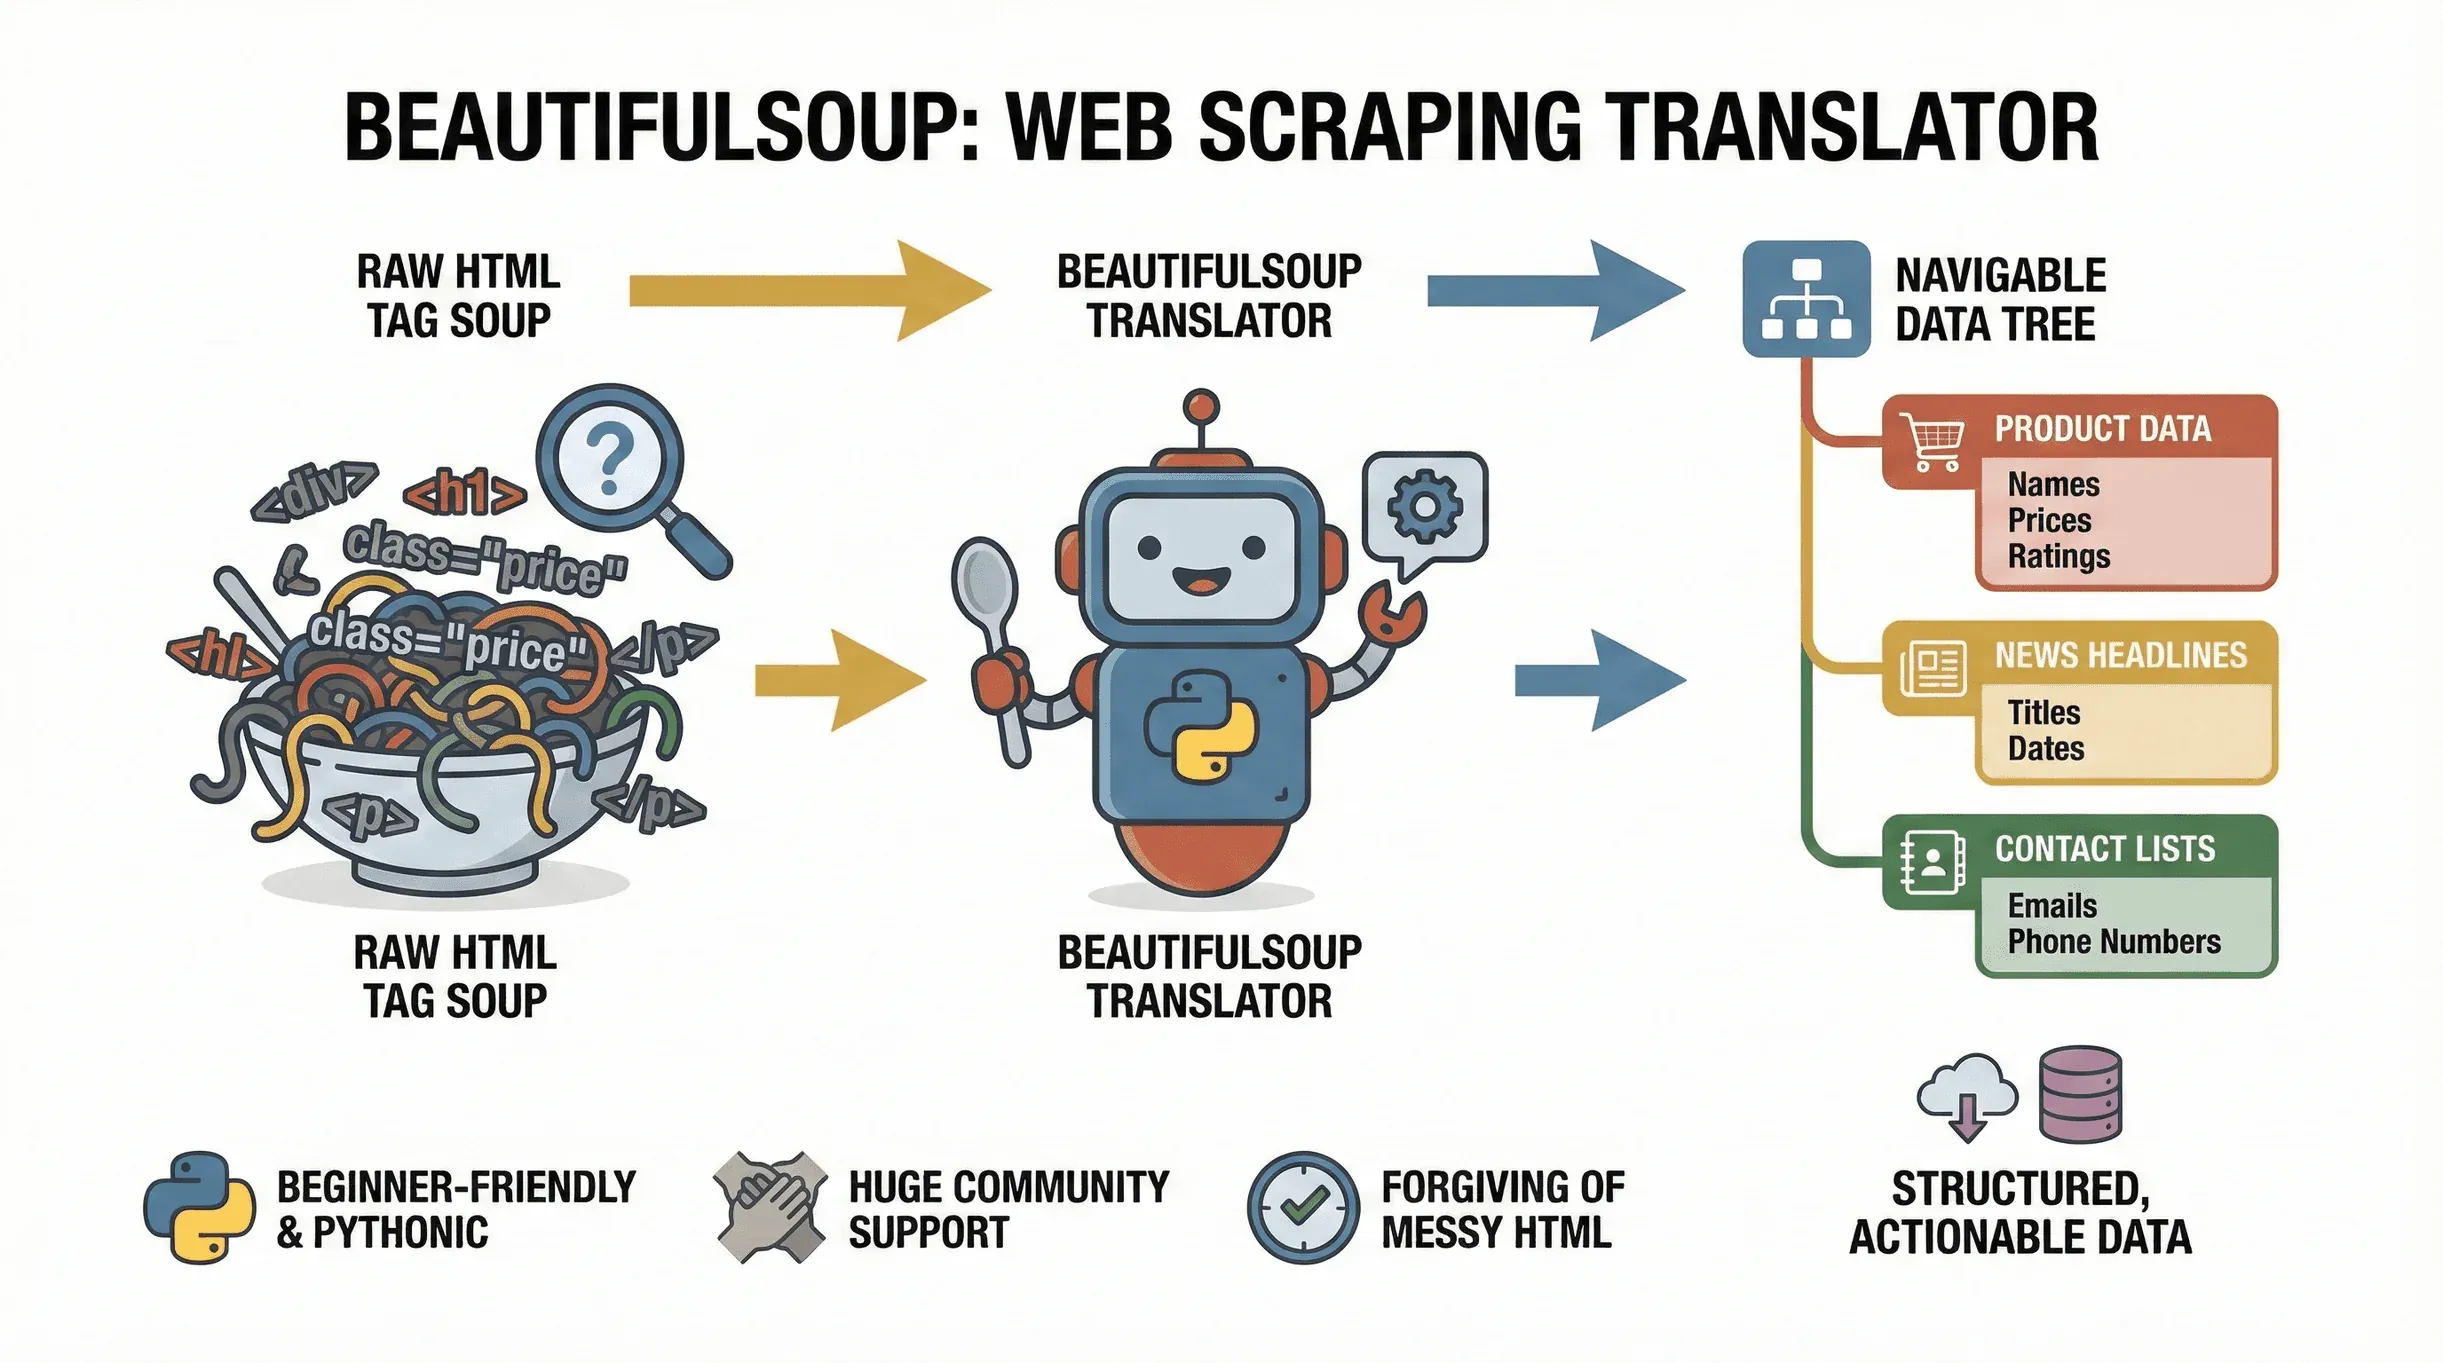 Začněme od základů. BeautifulSoup je knihovna v Pythonu, která usnadňuje parsování dokumentů HTML a XML. Představte si ji jako překladač: vezme „tagovou polévku“ webové stránky a promění ji v procházetelný strom, takže snadno najdete, vytáhnete a upravíte potřebná data. Projekt je pořád aktivně udržovaný —
beautifulsoup4 4.14.3 vyšel na PyPI koncem roku 2025 — takže všechno, co se tu naučíte, je aktuální. Ať už taháte ceny produktů z e‑commerce webu, sbíráte titulky zpráv nebo stahujete kontakty z firemních katalogů, BeautifulSoup je osvědčený nástroj pro proměnu webových stránek ve strukturovaná, použitelná data.
Proč je tak populární? Hlavně proto, že je velmi přívětivý pro začátečníky. BeautifulSoup si poradí i s neuspořádaným HTML (a přiznejme si, web je ho plný) a jeho syntaxe v duchu Pythonu znamená, že se od nuly k prvnímu scrape dostanete během pár řádků kódu. Je také široce podporovaný, má miliony stažení a obrovskou komunitu — takže když se zaseknete, pomoc je jen pár kliknutí ve vyhledávači.
Typické případy použití BeautifulSoup zahrnují:
- Extrakci názvů produktů, cen a hodnocení z e‑commerce stránek
- Tahání titulků, autorů a dat publikace z news webů
- Parsování tabulek nebo adresářů (například seznamů firem či kontaktů)
- Sběr e‑mailů nebo telefonních čísel z katalogových webů
- Sledování aktualizací (změny cen, nové nabídky práce atd.)
Pokud vaše data leží ve statickém HTML, BeautifulSoup je pro web scraping váš nejlepší parťák.
Jedinečné výhody BeautifulSoup pro web scraping
V Pythonu existuje spousta knihoven pro web scraping — proč tedy zvolit právě BeautifulSoup? Takhle si stojí v porovnání s konkurencí:
- Jednoduchost: BeautifulSoup je lehký a snadno se učí. Nemusíte nastavovat celý framework ani psát spoustu boilerplate kódu. Je ideální pro rychlé jednorázové úlohy i pro úplné začátečníky.
- Odolnost: Zvládá rozbité nebo chybně zapsané HTML, což je běžnější, než by člověk čekal.
- Flexibilita: Nejste svázáni přísnou crawlingovou architekturou. Prostě mu předáte HTML a vytáhnete, co potřebujete.
- Integrace: BeautifulSoup si dobře rozumí s dalšími Python knihovnami, jako jsou
requests(pro stahování webových stránek),csv(pro ukládání dat) apandas(pro analýzu dat).
Jak si vede ve srovnání s dalšími nástroji?
| Nástroj | Nejlepší pro | Výhody | Nevýhody |
|---|---|---|---|
| BeautifulSoup | Parsování statického HTML, začátečníci | Jednoduchý, rychlé nastavení, odolný, flexibilní | Není vhodný pro weby s velkým množstvím JavaScriptu |
| Scrapy | Velké, asynchronní úlohy | Výkonný, škálovatelný, vestavěné crawling funkce | Strmější křivka učení, více nastavování |
| Selenium | JavaScript / dynamický obsah | Umí pracovat s JS, vyplňovat formuláře, klikat na tlačítka | Pomalejší, těžší, náročnější na zdroje |
Pokud teprve začínáte nebo potřebujete rychle parsovat statické stránky, je BeautifulSoup „švýcarský nůž“ web scrapingu (medium.com). U složitějších nebo dynamických webů ho můžete zkombinovat se Selenium nebo Scrapy — ale BeautifulSoup je nejlepší způsob, jak se to naučit.
Jak nastavit Python prostředí pro BeautifulSoup
Připraveni začít? Takhle si nastavíte prostředí:
-
Nainstalujte Python: Stáhněte si nejnovější verzi z python.org.
-
Vytvořte virtuální prostředí (volitelné, ale doporučené):
python -m venv venv source venv/bin/activate # Ve Windows: venv\Scripts\activate -
Nainstalujte BeautifulSoup a závislosti:
pip install beautifulsoup4 requests lxml html5libbeautifulsoup4: Hlavní knihovnarequests: Pro stahování webových stráneklxmlnebohtml5lib: Rychlejší / spolehlivější HTML parsovací nástroje
-
Tipy pro řešení problémů:
- Pokud se zobrazí chyba „pip not found“, zkuste
pip3nebopy -m pip. - Na Macu/Linuxu můžete kvůli oprávněním potřebovat
sudo. - Ve Windows se ujistěte, že je Python přidaný do PATH.
- Pokud se zobrazí chyba „pip not found“, zkuste
Pro ověření nastavení spusťte tento rychlý test:
from bs4 import BeautifulSoup
import requests

html = requests.get("http://example.com").text
soup = BeautifulSoup(html, "html.parser")
print(soup.title)
Když uvidíte <title>Example Domain</title>, máte všechno správně nastavené (Thunderbit Blog).
Příklad BeautifulSoup v Pythonu krok za krokem
Pojďme se podívat na reálný příklad v Pythonu s BeautifulSoup. Představte si, že chcete vytáhnout nejnovější titulky zpráv z veřejného zpravodajského webu. Takhle na to:
1. Načtěte webovou stránku
import requests
from bs4 import BeautifulSoup

url = "https://www.bbc.com/news"
response = requests.get(url)
html = response.text
2. Naparsujte HTML
soup = BeautifulSoup(html, "html.parser")
3. Prohlédněte si strukturu HTML
Otevřete si Vývojářské nástroje v prohlížeči (pravé tlačítko → Prozkoumat) a podívejte se na tagy, které obsahují titulky. Na mnoha zpravodajských webech jsou titulky v tagu <h3> s konkrétními třídami.
Například můžete vidět:
<h3 class="gs-c-promo-heading__title">Headline Title</h3>
4. Vytáhněte data
headlines = soup.find_all("h3", class_="gs-c-promo-heading__title")
for h in headlines:
    print(h.get_text(strip=True))
Tímto se vypíšou všechny titulky na stránce.
5. Uložte data do CSV
Uložme si titulky pro pozdější analýzu:
import csv

with open("headlines.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["headline"])
    for h in headlines:
        writer.writerow([h.get_text(strip=True)])
Teď máte CSV soubor připravený pro Excel nebo Google Sheets.
Porozumění struktuře HTML pro efektivní extrakci dat
Než napíšete jediný řádek kódu, vždy si prohlédněte HTML stránky. Takhle na to:
- Otevřete Vývojářské nástroje: Klikněte pravým tlačítkem na stránku a zvolte „Prozkoumat“.
- Najděte data: Najíždějte na prvky a sledujte, které tagy obsahují informace, které potřebujete (např. titulky, ceny, autory).
- Všimněte si tagů a tříd: Hledejte jedinečné identifikátory, jako
class="product-title"neboid="main-content". - Otestujte selektory: Použijte metody BeautifulSoup
.find(),.find_all()nebo.select()a namiřte je na správné prvky.
Tip navíc: Použijte soup.prettify() pro vypsání čitelné verze HTML v Python konzoli.
Extrakce a strukturování dat pomocí BeautifulSoup
Řekněme, že chcete z blogové stránky vytáhnout názvy i autory:
articles = soup.find_all("article")
data = []
for article in articles:
    title = article.find("h2").get_text(strip=True)
    author = article.find("span", class_="author").get_text(strip=True)
    data.append({"title": title, "author": author})
Teď máte seznam slovníků — ideální pro export do CSV nebo pro další analýzu.
Takto můžete vytahovat odkazy, obrázky nebo jakýkoli atribut:
for link in soup.find_all("a"):
    print(link.get("href"))
Nebo obrázky:
for img in soup.find_all("img"):
    print(img.get("src"))
Ukládání extrahovaných dat: z Pythonu do Excelu nebo CSV
Jakmile máte data strukturovaná, export je snadný. Takhle to uděláte pomocí modulu csv:
import csv

with open("articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
A pokud jste fanoušci pandas:
import pandas as pd

df = pd.DataFrame(data)
df.to_csv("articles.csv", index=False)
df.to_excel("articles.xlsx", index=False)
Vždy používejte kódování UTF-8, abyste se vyhnuli problémům se zvláštními znaky, zejména u mezinárodních dat.
Případová studie: scraping dat ze zpravodajského webu pomocí BeautifulSoup
Podívejme se na praktický příklad v Pythonu s BeautifulSoup: scraping názvů článků, autorů a dat publikace ze zpravodajského webu.
Předpokládejme, že chcete získat data z CNN o článcích:
import requests
from bs4 import BeautifulSoup
import csv

url = "https://edition.cnn.com/world"
response = requests.get(url)
soup = BeautifulSoup(response.content, "html.parser")

articles = soup.find_all("article")
data = []

for article in articles:
    title_tag = article.find("h3")
    date_tag = article.find("span", class_="date")
    author_tag = article.find("span", class_="author")
    title = title_tag.get_text(strip=True) if title_tag else ""
    date = date_tag.get_text(strip=True) if date_tag else ""
    author = author_tag.get_text(strip=True) if author_tag else ""
    data.append({"title": title, "date": date, "author": author})

with open("cnn_articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "date", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
Tento skript stáhne nejnovější články, vytáhne název, datum a autora a uloží je do CSV — samozřejmě za předpokladu, že současná struktura CNN stále odpovídá tagům výše. Velké zpravodajské weby často mění názvy tříd i strukturu DOM, takže než to spustíte na produkčních datech, stránku si znovu prohlédněte. Osvědčený vzor je struktura (<article> kontejnery a pak find na potomcích); konkrétní názvy tříd jako "date" a "author" jsou jen zástupné hodnoty, které je potřeba upravit podle toho, co aktuálně web skutečně vrací.
Zlepšení workflow: kombinace BeautifulSoup s Thunderbit
Teď si pojďme říct, jak si scraping workflow ještě víc zjednodušit. Thunderbit je AI web scraper jako rozšíření do Chrome, který vám bere práci s extrakcí dat z rukou. S Thunderbit můžete:
- Použít „AI Suggest Fields“: Thunderbit přečte stránku a automaticky navrhne, která datová pole má vytáhnout — žádné hledání v HTML ani ladění selektorů.
- Scrapovat podstránky: Thunderbit umí následovat odkazy na podstránky (například jednotlivé produktové nebo článkové stránky) a obohatit dataset o další detaily.
- Okamžitě exportovat: Pošlete data jedním kliknutím přímo do Excelu, Google Sheets, Airtable nebo Notion.
- Zvládnout stránkování: Thunderbit umí scrapovat data přes více stránek včetně nekonečného scrollování.
- Naplánovat scrapování: Nastavte opakující se úlohy, aby vaše data zůstala čerstvá.
Tady je hybridní workflow, které mám opravdu rád:
- Začněte v Thunderbit: Otevřete cílový web, klikněte na ikonu Thunderbit a nechte „AI Suggest Fields“, ať určí správné sloupce (například title, author, date).
- Exportujte data: Stáhněte výsledky jako CSV nebo je pošlete do Google Sheets.
- Použijte BeautifulSoup pro vlastní zpracování: Pokud potřebujete hlubší analýzu (například čištění textu, deduplikaci nebo spojení s jinými zdroji), načtěte exportované CSV do Pythonu a použijte BeautifulSoup nebo pandas pro následné zpracování.
Tahle kombinace vám dává to nejlepší z obou světů: rychlost a AI detekci polí v Thunderbitu i flexibilitu BeautifulSoup pro vlastní logiku.
Vyzkoušejte Thunderbit AI Web Scraper zdarma
Rychlost a kvalita dat: proč používat Thunderbit a BeautifulSoup dohromady?
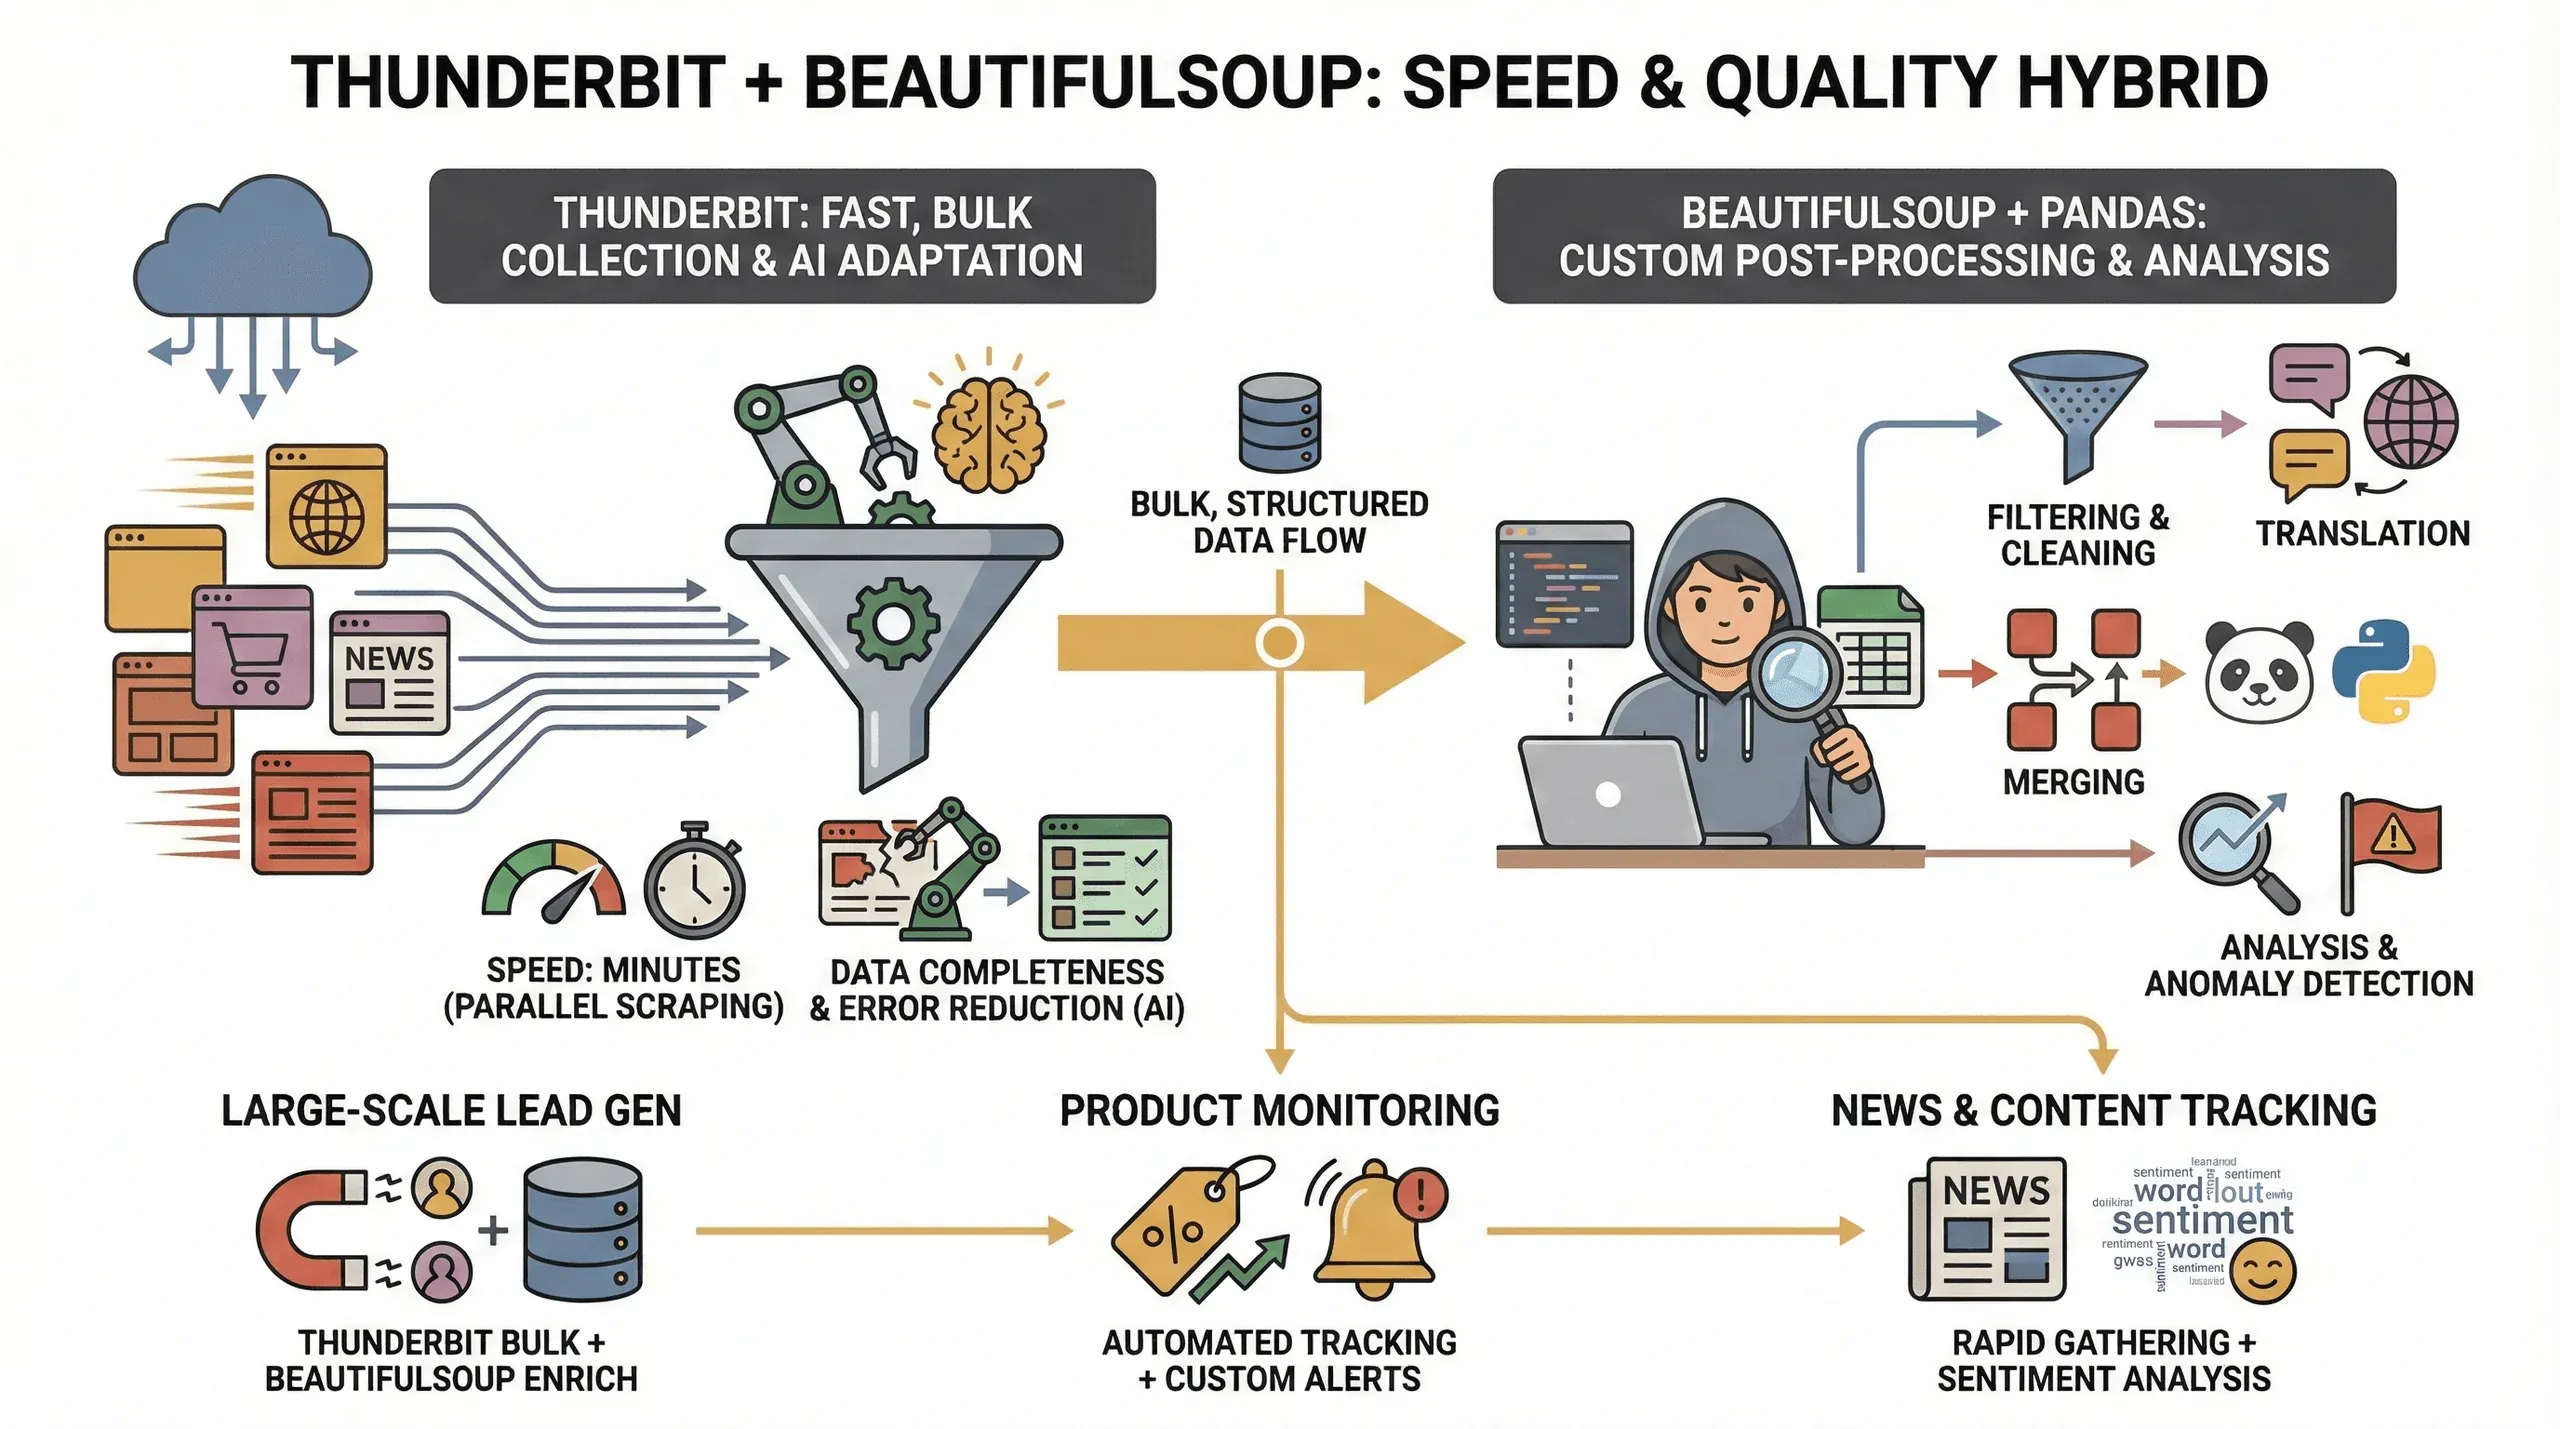 Proč se trápit s obojím? Tohle jsem si ověřil:
- Rychlost: Thunderbit umí scrapovat desítky stránek paralelně (v cloudovém režimu až 50 najednou), takže data máte během minut, ne hodin.
- Úplnost dat: AI v Thunderbitu se přizpůsobuje změnám rozložení a zvládne extrahovat strukturovaná data i z problematických webů, čímž snižuje riziko chybějících polí.
- Méně chyb: Už žádné rozbité skripty, když se změní název třídy — AI v Thunderbitu stránku pokaždé znovu vyhodnotí.
- Vlastní následné zpracování: Pro pokročilé potřeby (například filtrování, překlad nebo slučování datasetů) vám BeautifulSoup a pandas dají plnou kontrolu.
Tento hybridní přístup je obzvlášť užitečný pro:
- Velké lead generation: Thunderbit stáhne objemová data a BeautifulSoup je následně vyčistí a obohatí.
- Sledování produktů: Thunderbit řeší opakující se scraping, zatímco BeautifulSoup vám umožní analyzovat trendy nebo vyznačit odchylky.
- Sledování zpráv a obsahu: Rychle nasbíráte články pomocí Thunderbitu a potom v Pythonu provedete analýzu sentimentu nebo extrakci klíčových slov.
Řešení běžných problémů při web scrapingu s BeautifulSoup
Vyzkoušejte rozšíření Thunderbit pro Chrome Scrapujte jakýkoli web pomocí AI na 2 kliknutí. Get Started Free
Web scraping není vždy bezproblémový — tady jsou časté nástrahy a jak je opravit:
- Dynamický obsah: Pokud web načítá data pomocí JavaScriptu (nekonečný scroll, AJAX), samotný BeautifulSoup je neuvidí. Pro tyto případy použijte Selenium nebo browser mode v Thunderbitu.
- Antibot ochrany: Některé weby blokují automatizované požadavky. Zkuste nastavit vlastní hlavičku User-Agent, přidat pauzy mezi požadavky nebo použít cloud scraping v Thunderbitu, který obejde jednoduché blokace.
- Změny struktury HTML: Když vám skript najednou přestane fungovat, HTML webu se pravděpodobně změnilo. Stránku znovu zkontrolujte a aktualizujte selektory. AI v Thunderbitu může pomoci tím, že se přizpůsobí za běhu.
- Chybějící data: Vždy kontrolujte, zda prvky existují, než zavoláte
.get_text(). U atributů používejte.get()místo[], abyste se vyhnuli KeyErrorům. - Problémy s kódováním: Ukládejte soubory v UTF-8, aby se správně zacházelo se speciálními znaky.
A vždy, vždy respektujte robots.txt a podmínky použití webu. Scrapujte zodpovědně — nikdo nemá rád nezdvořilého robota.
Závěr a hlavní poznatky
Web scraping s BeautifulSoup je jedna z nejpraktičtějších dovedností, kterou se dnes v datově řízeném světě můžete naučit. Tohle jsme v tomhle návodu pro web scraping s beautifulsoup prošli:
- BeautifulSoup je ideální výchozí bod pro parsování statického HTML a extrakci strukturovaných dat v Pythonu.
- Nastavení je hračka — stačí nainstalovat Python, pip a pár knihoven.
- Kontrola HTML je klíčová pro správné zacílení na potřebná data.
- Export do CSV/Excelu udělá z vašich dat okamžitě použitelný podklad pro business analýzu.
- Kombinace s Thunderbit vám dá detekci polí pomocí AI, rychlejší scraping i jednodušší exporty — ideální pro byznys uživatele i neprogramátory.
- Hybridní workflow (Thunderbit pro hromadnou extrakci, BeautifulSoup pro vlastní zpracování) přináší nejlepší rychlost, kvalitu dat i flexibilitu.
Jestli chcete svůj web scraping posunout na vyšší úroveň, vyzkoušejte oba nástroje: nejprve si otestujte jednoduchý skript v BeautifulSoup a pak se podívejte, o kolik rychleji to půjde s Thunderbit AI web scraperem. A pro další praktické návody se podívejte na Thunderbit Blog.
Šťastný scraping — a ať jsou vaše data vždy čistá, strukturovaná a připravená k akci.
Vyzkoušejte Thunderbit AI Web Scraper Get Started Free
Nejčastější dotazy
1. Co je BeautifulSoup a k čemu se používá?
BeautifulSoup je Python knihovna pro parsování dokumentů HTML a XML. Pomáhá vám extrahovat data z webových stránek a převádět je do strukturovaných formátů, jako jsou seznamy nebo tabulky, takže je ideální pro projekty web scrapingu.
2. Jak si BeautifulSoup vede ve srovnání se Selenium a Scrapy?
BeautifulSoup je lehký a snadno použitelný pro statické HTML stránky. Selenium je lepší pro scraping dynamických webů s velkým množstvím JavaScriptu, zatímco Scrapy je plnohodnotný framework pro velké asynchronní scrapingové úlohy. Pro začátečníky a rychlé úkoly je BeautifulSoup nejlepší volba.
3. Můžu používat BeautifulSoup a Thunderbit dohromady?
Rozhodně. Thunderbit umí rychle identifikovat a extrahovat pole z webových stránek pomocí AI a BeautifulSoup můžete použít pro vlastní následné zpracování nebo hlubší analýzu exportovaných dat.
4. Jaké jsou časté problémy při web scrapingu s BeautifulSoup?
Mezi běžné potíže patří práce s dynamickým obsahem, řešení antibot ochrany a přizpůsobení se změnám ve struktuře HTML. Pomoci mohou AI funkce Thunderbitu nebo browser mode.
5. Jak exportuji data získaná pomocí BeautifulSoup do Excelu nebo CSV?
Můžete použít vestavěný modul Pythonu csv nebo knihovnu pandas a uložit extrahovaná data do CSV nebo Excel souborů. Vždy používejte UTF-8, aby se správně zpracovala speciální písmena a byla zajištěna kompatibilita s tabulkovými procesory.
Chcete to vyzkoušet sami? Stáhněte si Chrome Extension Thunderbit a začněte scrapovat chytřeji ještě dnes. Pro další návody a tipy navštivte Thunderbit Blog.
Zjistěte více




