
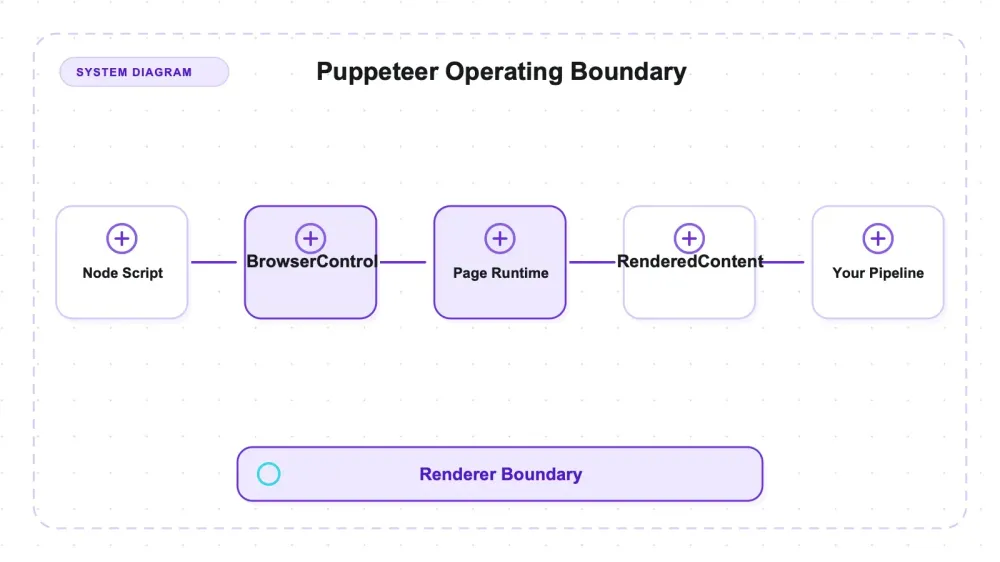
Puppeteer je Node knihovna od Googlu pro ovládání skutečného Chromu přes JavaScript — automatizaci píšete vy, příkazy přenáší Chrome DevTools Protocol a plnohodnotný prohlížeč stránku nejdřív vykreslí, teprve potom z ní čtete data. Na GitHubu ho najdete v repozitáři puppeteer/puppeteer: je pod licencí Apache-2.0, napsaný v TypeScriptu a v době pořízení snímku měl zhruba 95,3 tisíce hvězdiček (95 307). Oficiální popis je záměrně úzký — „JavaScript API pro ovládání Chromu (a experimentálně Firefoxu)” — a přesně tím říká, co Puppeteer je, a stejně užitečně i to, co není.
Puppeteer 24.16.0 jsem otestoval na stejném sadě testovacích fixture a veřejných demo webech, které používáme pro každou knihovnu pro automatizaci prohlížeče: statický katalog s stránkováním, článek, katalog vykreslovaný JavaScriptem, JSON API, route vracející 500, malý crawl graf, a také Books to Scrape a Quotes to Scrape. Vykreslování zvládl čistě a bez zbytečných kudrlinek. Zároveň mi na stole nechal přesně jeden úkol — ten samý, který nechává každá knihovna pro headless browser — a právě poctivost vůči téhle mezeře dělí smysluplnou recenzi od marketingové tiskové zprávy.
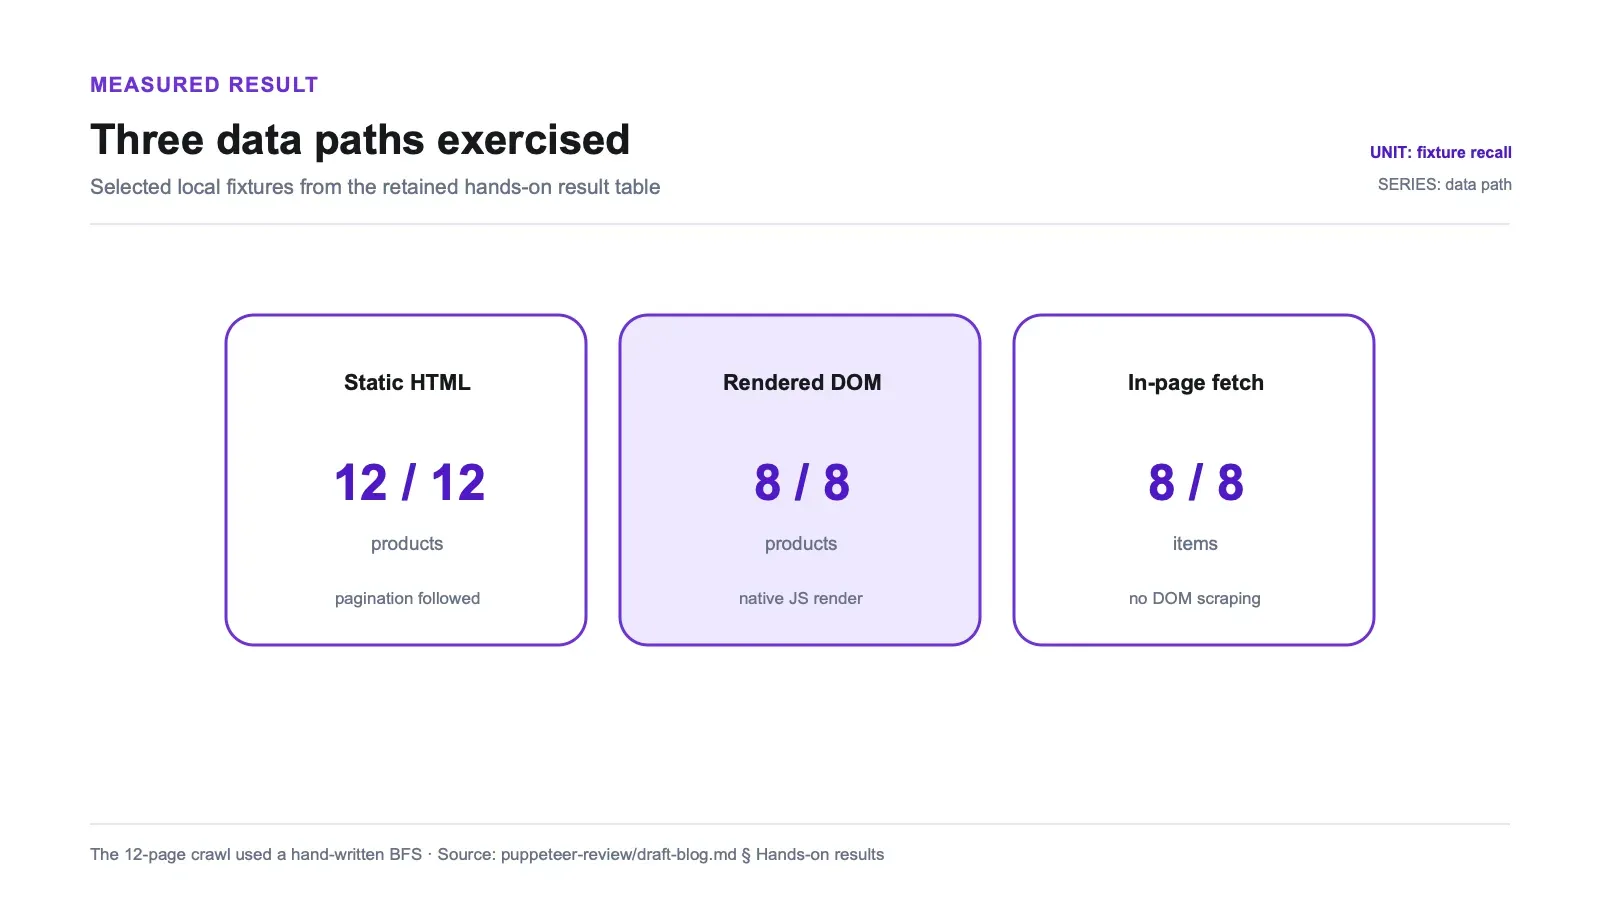
Zaujalo mě víc než samotná čísla zapamatování ještě jedno zjištění. Na stránce, kde data přicházejí z JSON endpointu, Puppeteer vytáhl všech 8 záznamů bez scrapování DOMu — uvnitř stránky spustil fetch a přímo přečetl response objekt. To spolu s nativním renderingem a funkčními screenshoty přesně vystihuje charakter nástroje: zralý renderer pro Chrome, ne crawl framework. A na tomhle rozdílu záleží ještě předtím, než napíšete první řádek.
Co Puppeteer ve skutečnosti je (a s čím soupeří)
Tady dělá kategorické označení skutečnou práci, takže jím začněme. Puppeteer je knihovna pro automatizaci prohlížeče. Spustí Chrome, otevře stránky, nechá proběhnout JavaScript stránky a vrátí vám vykreslený výsledek k přečtení nebo vyfocení. To je celý důvod, proč po něm sáhnete místo HTTP klienta s HTML parserem: chcete stránku po doběhnutí skriptů, ne prázdný skelet, který server pošle jako první.
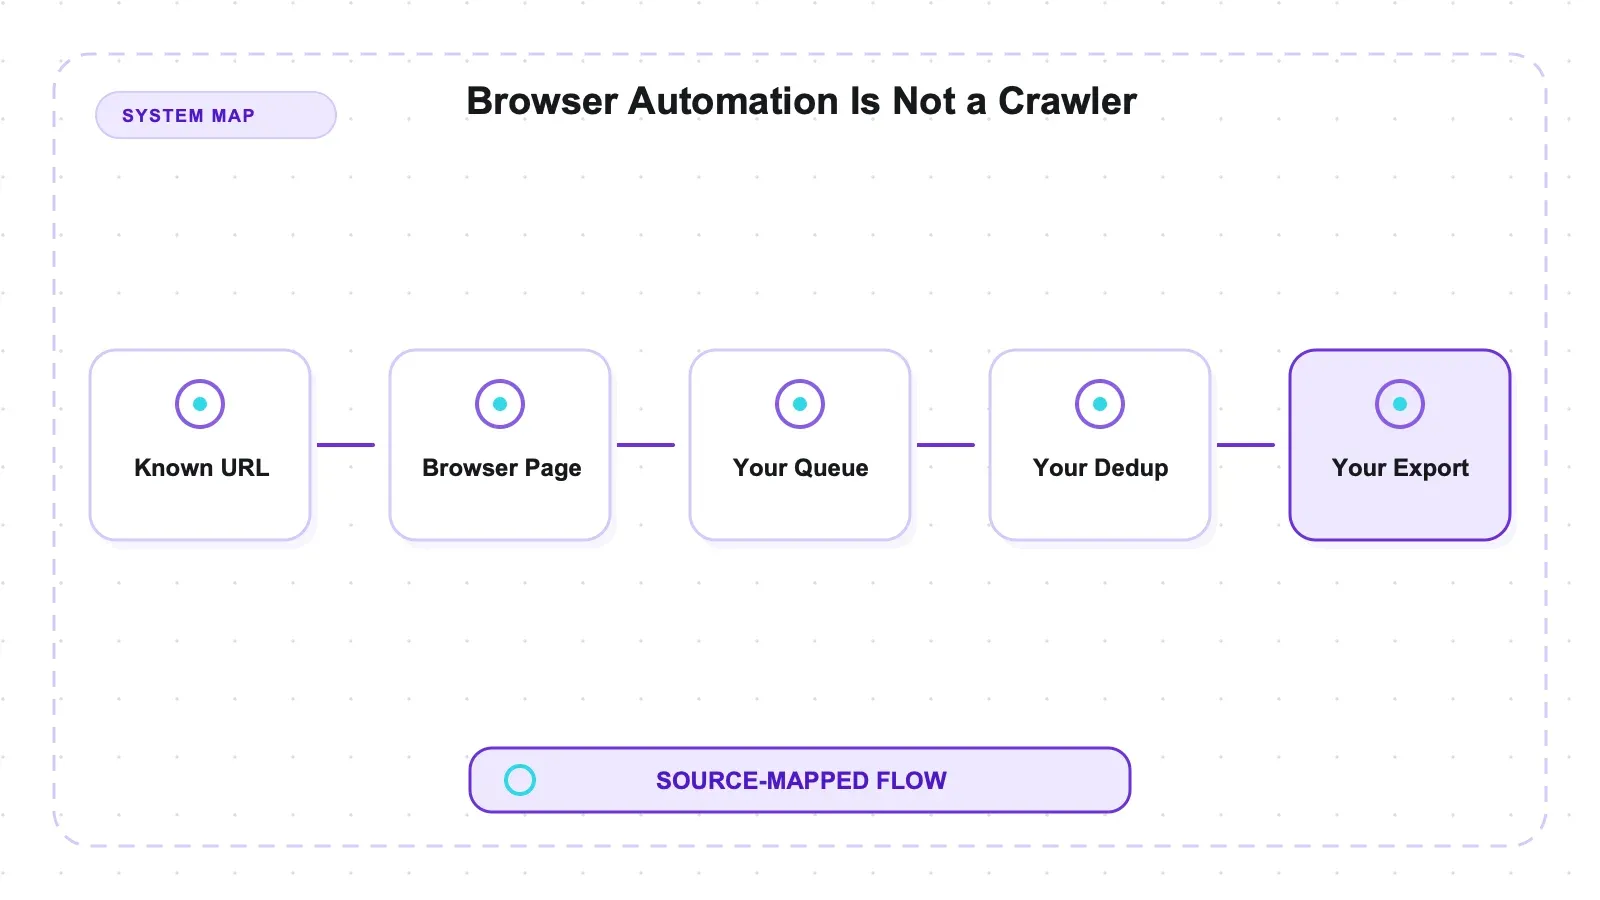
Svou povahou soupeří s ostatními knihovnami pro skutečný browser — tedy s Playwrightem a Selenium — ne s crawl frameworky jako Scrapy ani s nástroji typu LLM-Markdown. Když na Puppeteer pošlete tisíc URL a čekáte, že je zařadí do fronty, odstraní duplicity, bude slušně throttleovat a uloží dataset, přivezli jste renderer na problém s crawlingem. Každou stránku krásně vykreslí, ale žádnou orchestraci nevyřeší. (To je hranice rozsahu, ne chyba — vrátím se k tomu, protože je to nejdůležitější věc, kterou je potřeba si před adopcí nástroje uvědomit.)
Puppeteer vzešel z Chrome týmu Googlu, proto je od základu orientovaný na Chrome a jeho API působí jako tenká, dobře opotřebovaná rukavice přes vlastní ladicí protokol prohlížeče. Je už dost starý na to, aby byl nudný v tom dobrém smyslu: metody, které potřebujete, jsou stabilní už roky, dokumentace je důkladná a ekosystém kolem něj je hluboký.
Nativní rendering a vzor in-page fetch
Dvě chování stojí za to vytáhnout z výsledkové tabulky, protože přesně určují, jak byste ten nástroj v praxi používali.
Zaprvé nativní rendering. Katalog vykreslovaný JavaScriptem — stránka, která po načtení skládá produktovou mřížku na klientovi — skončil na 8/8 a na disk se uložil full-page screenshot. Nastavení bylo minimální, ale zahrnovalo čekání na cílový obsah po goto. Veřejná JS stránka Quotes to Scrape vrátila všech deset citátů stejným způsobem. Jde o výsledky z fixture, ne o obecné skóre vykreslování.
Zadruhé JSON API fixture načítalo produkty z /api/dynamic-products. Když jsem přes page.evaluate spustil fetch ve stejném originu, vrátily se všechny osmi záznamy bez parsování vykreslených řádků. To je obecný vzor práce s browserem, ne nějaký objevený trik specifický pro Puppeteer. Když znáte endpoint i smlouvu requestu, může to výrazně zjednodušit extrakci; hlavičky pro autentizaci, runtime tokeny, credential policy, CORS/CSP, service workers i stránkování ale pořád mohou způsobit, že aplikace request bude jiný.
Třetí věc, kterou je dobré si odnést, není číslo, ale rámec: Puppeteer je zralý renderer pro Chrome a není to crawler. Obojí je pravda — a ta druhá část je ta, kterou se v recenzích často přeskakuje.
Jak Puppeteer komunikuje s Chromem
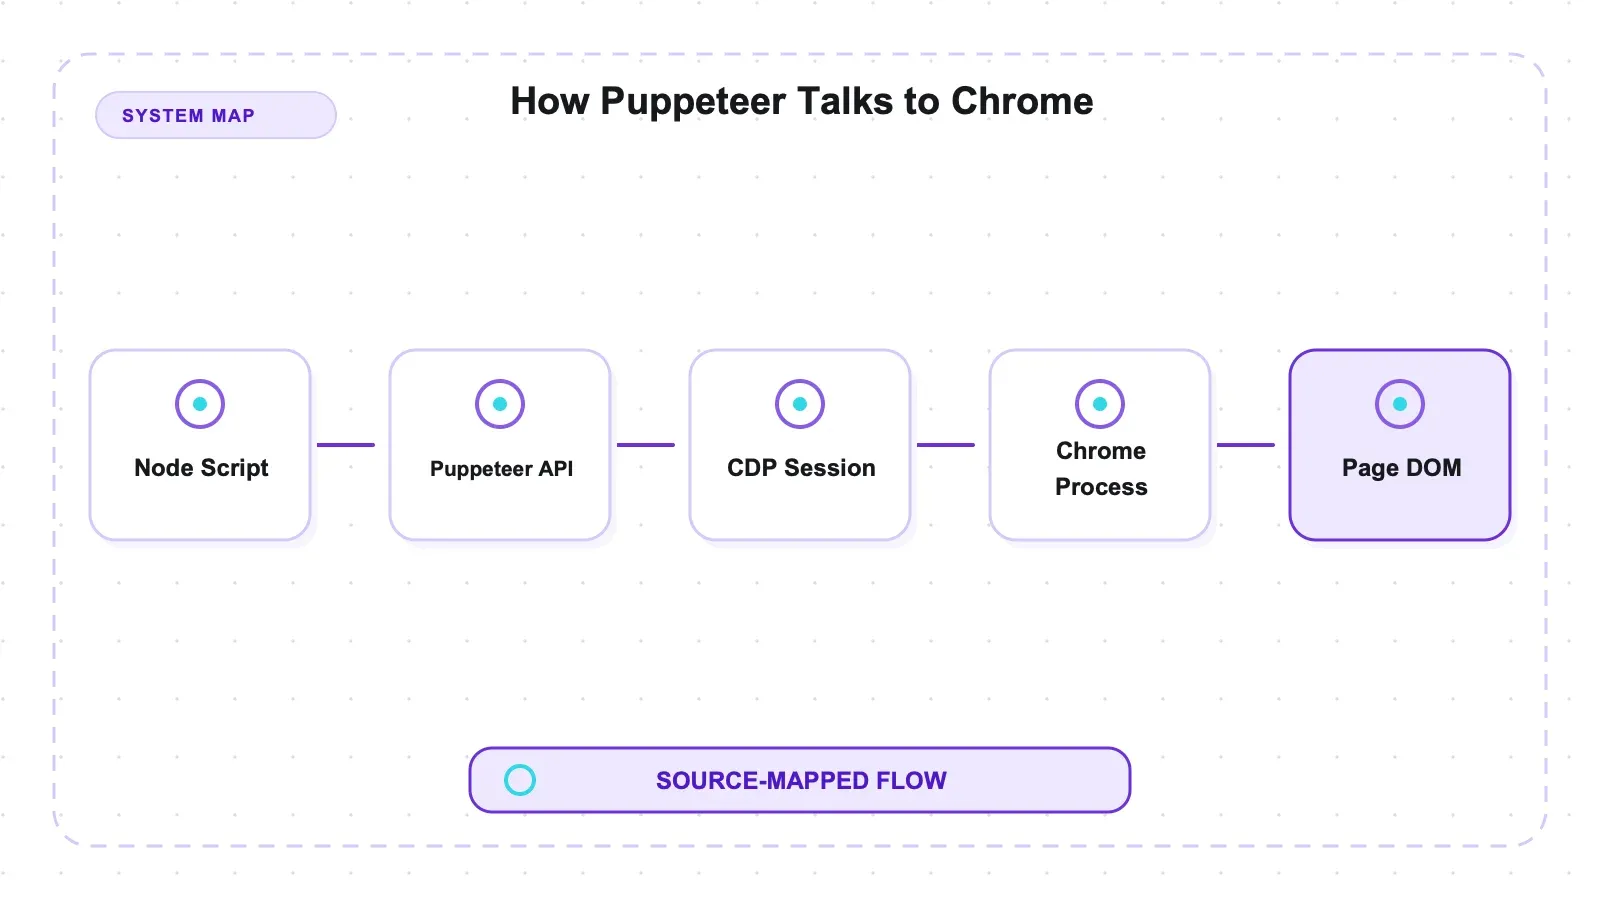
V Chromu Puppeteer používá Chrome DevTools Protocol (CDP), tedy JSON komunikaci přes WebSocket, kterou používají i nástroje DevTools v prohlížeči. puppeteer.launch() spustí Chrome a otevře toto protokolové spojení; volání jako goto, $$eval a screenshot zpřístupňují operace prohlížeče přes vyšší API. Podpora Firefoxu se řídí cestou WebDriver BiDi popsanou níže, takže ne každá operace Puppeteer je univerzálně CDP příkaz.
page.evaluate spouští funkci v kontextu stránky, takže relativní fetch('/api/...') používá origin dané stránky a může znovu využít příslušné cookies a session state. Automaticky ale nereprodukuje autorizační hlavičky, request options, tokeny ani chování service workeru vytvořené aplikací. Na tomto stejném-origin fixture se JSON vrátil přímo; produkční requesty je potřeba posoudit podle jejich skutečné smlouvy.
Je to také důvod, proč je Puppeteer „těžký“. Každá stránka je skutečný záložka prohlížeče se skutečným rendering enginem. To přináší správnost na JavaScriptem nabitých stránkách, ale stojí to paměť a čas startu oproti čistě HTTP fetchi. Nic jako bezplatný rendering neexistuje; CDP jen dělá ten účet čitelný.
Otázka enginu, řečená na rovinu
Často se zjednodušeně říká, že Puppeteer je „jen pro Chrome“. U verze, kterou jsem testoval, to není pravda — a oprava toho tvrzení mění i srovnání.
| Engine | Jak ho Puppeteer 24.16.0 ovládá | Zahrnuto v těchto testech |
|---|---|---|
| Chrome | Chrome-first přes CDP — výchozí chování, takže stávající automatizace dál funguje | ano |
| Firefox | Dokumentovaná podpora přes WebDriver BiDi od v23 | ne |
| WebKit | Není podporován vůbec | — |
Jak Chrome for Developers, tak Mozilla zveřejnily změnu s Firefoxem, když dorazila. Build, který jsem spouštěl, 24.16.0, je výrazně za v23, takže označení „jen Chrome“ podhodnocuje to, co balíček skutečně nabízí. Absence WebKitu plus mladší stav cross-engine podpory oproti Playwrightu je ta skutečná šířková odlišnost — ne „jeden engine versus tři“.
Firefox/BiDi cesta je v dokumentaci a ve verzi, kterou jsem testoval, dostupná, ale moje fixture jsem přes ni nespouštěl, takže reportuji schopnost, ne měření. Pokud je pro vaše cíle podpora Firefoxu klíčová, ověřte ji na vlastních stránkách před nasazením. Pro čtenáře, kteří chtějí plné head-to-head srovnání enginů a jazykového rozsahu, naše srovnání Playwright vs. Puppeteer protahuje obě knihovny stejnými testy a otázku „který z nich“ tam uzavírá; tady je předmětem jen Puppeteer.
Realita instalace: nejtěžší část je prohlížeč
Výchozí cesta npm install puppeteer stáhne kompatibilní build Chrome for Testing. To lze přes konfiguraci přeskočit nebo přesměrovat a uživatelé mohou Puppeteer namířit na jiný executable, takže shoda verzí závisí na volbě nasazení. Největší částí této instalace byl právě download prohlížeče; auditní snapshot balíčkového manažeru ale neberu jako trvalou bezpečnostní vlastnost.
To automatické přibalení je zároveň skutečná ergonomická výhoda i skutečná zátěž pro footprint — a stojí za to pojmenovat obě strany. Výhoda: nemusíte shánět kompatibilní browser ani ručně připínat verze; npm install vám dá funkční dvojici. Nevýhoda: stahujete celý prohlížeč, takže si hlídejte disk i bandwidth, hlavně v CI, kde cold cache zaplatí tu cenu na každém novém runneru.
Je to také reálný kontrast proti Playwrightu, který tyto dva kroky odděluje — nejdřív nainstalujete knihovnu a pak spustíte samostatné npx playwright install, aby se stáhly jeho browser buildy. Ani jeden přístup není bolestivý; jen selhávají jinak. Jediný příkaz v Puppeteeru vás může překvapit velikostí na omezeném připojení, zatímco druhý krok u Playwrightu můžete jednoduše zapomenout. Vědět, který režim používáte, je důležité.
Praktické výsledky
Každý test běžel proti lokálnímu fixture serveru na 127.0.0.1 plus dvěma veřejným cvičným webům, na Node v22.22.3, macOS arm64, s Puppeteer 24.16.0 a přibaleným Chromem. Správný výsledek pro každou fixture jsem si zapsal předem, takže recall se měří proti pevně dané očekávané sadě, ne proti tomu, co Puppeteer náhodou vypsal.
Veřejný research balíček obsahuje fixture server, test runner a ground truth. Dependency lock i syrové shrnutí běhu jsem z publikace záměrně vynechal, protože přísná bezpečnostní kontrola odmítla data z lockfile i materiály závislé na konkrétním prostředí endpointů. Chcete-li si bezpečnou lokální fixture zopakovat, spusťte v tools/puppeteer/tests nejdřív npm install a potom node run_puppeteer_material_tests.mjs a výsledek porovnejte s publikovaným ground truth. Veřejné demo stránky se mohou měnit, proto je lokální fixture stabilním základem pro kontrolu očekávaných počtů.
Pro přesnou historickou rekonstrukci závislostí je lepší vytvořit a lokálně auditovat nový lockfile, než brát nepublikovaný lockfile jako veřejný důkaz.
| Test | Cíl | Výsledek |
|---|---|---|
| Statický katalog + stránkování | lokální fixture | 12/12, recall 1.0 |
| Extrakce článku | lokální fixture | title + 3/3 odstavce, boilerplate oddělený |
| Dynamická JS stránka (nativní rendering) | lokální fixture | 8/8, recall 1.0, uložen full-page screenshot |
Dynamické JSON API (in-page fetch) | lokální fixture | 8/8, recall 1.0, bez parsování DOMu |
| Ošetření HTTP 500 | lokální fixture | status 500 šel zkontrolovat, bez vyhození výjimky |
| Crawl graf (ručně psané BFS) | lokální fixture | 12 stránek, hloubky {0:1, 1:4, 2:7} |
| Books to Scrape | veřejné demo | 20 produktů |
| Quotes JS | veřejné demo | 10 citátů, nativně vykresleno |
Některé z nich si zaslouží pár vět navíc.
Ruční kód pro stránkování získal všech 12 očekávaných položek katalogu. Selektor pro článek vytáhl title a tři očekávané odstavce; okolní boilerplate zůstal v DOM dostupný. Puppeteer dodal vykreslený DOM, ale to, co se počítalo jako obsah článku, určovala selektorová logika — ne Puppeteer sám.
Na testované route s HTTP 500 vrátil goto response objekt s kontrolovatelným statusem 500 a nevyhodil výjimku. To ale nic neříká o timeoutu, selhání DNS, pádu browseru, odpojených framech ani jiných navigačních chybách, které je pořád nutné řešit explicitně.
Crawl graf je ten test, který řekne celý příběh. Procházení interních odkazů fixture až do 12 stránek, se sledováním hloubky, abych se k URL nevracel, vyžadovalo ručně napsané breadth-first search — protože Puppeteer nemá vestavěnou crawl frontu. Našel všech 12 stránek v hloubkách {0:1, 1:4, 2:7}, což znamená, že moje BFS fungovalo. Ale to BFS bylo moje. Puppeteer každou stránku jen vykreslil; logiku procházení webu jsem napsal sám. Pro dvanáct stránek je to pár řádků a žádná drama. Pro tisíce URL s deduplikací, retry a slušnými prodlevami se z těch pár řádků stává projekt.
Jedno upozornění zopakuji, protože se to snadno zneužívá: artefakty obsahují časy jednotlivých testů, ale jde o jednorázová měření na jednom stroji, ne o benchmark. Nehodnotím rychlost Puppeteeru vůči ničemu na základě jednoho notebooku a jednoho běhu. Čísla podporují recall a chování napříč osmi typy stránek — ne stopky.
Co jsem netestoval
Aby výsledky nevyzněly širší, než ve skutečnosti jsou, tady je, co zůstalo mimo testovací běh, a tedy i mimo tato čísla:
| Mimo testovací běh | Stav |
|---|---|
| Firefox přes WebDriver BiDi | Zdokumentováno, ve verzi 24.16.0 dostupné, tady nevyzkoušeno |
| Proxy a intercept requestů | Netestováno; obě funkce jsou podporované, ale nespouštěl jsem je |
| Paralelní škálování stránek | Běžel jsem v malém rozsahu; chování browser fleet při skutečné konkurenci neměřeno |
| Opakovaný běh na nejnovější verzi | Testoval jsem 24.16.0; npm latest je 25.3.0, tedy o celou major verzi dál, k datu 2026-07-09. API, která jsem používal (launch, goto, $$eval, screenshot, in-page fetch), jsou mezi 24→25 stabilní, ale poctivý postup je před spoléháním na přesná čísla spustit test znovu na 25.3.0 |
Nic z toho není výtka. Jsou to hranice toho, co může jeden běh fixture poctivě tvrdit.
Klady a zápory
Klady:
- Nativní vykreslování JavaScriptu s explicitním čekáním na obsah: 8/8 na dynamické fixture a všech deset citátů na veřejném demu, včetně screenshotů.
- Ručně napsané selektory pro stránkování a článek získaly očekávané položky z fixture.
- In-page
fetchvrátil všech osm záznamů ze známého same-origin endpointu bez parsování DOMu. - Testované HTTP 500 se vrátilo jako kontrolovatelná response bez výjimky.
- Výchozí instalace stáhne kompatibilní Chrome for Testing; zároveň je možné nastavit alternativní executable i vypnutí downloadu.
- Zralé API zaměřené na Chrome přes CDP, s hlubokým ekosystémem a důkladnou dokumentací. Apache-2.0.
- Širší než jeho pověst: dokumentovaná podpora Firefoxu přes WebDriver BiDi od v23.
Zápory:
- Bez vestavěné crawl fronty, writeru datasetu nebo throttlingu — pro crawl ve velkém je potřeba vlastní kód nebo wrapper.
- Bez WebKitu a s mladším cross-engine příběhem než má Playwright.
- Váha skutečného browseru: stažení přibaleného Chromu a paměťové náklady na každou stránku oproti HTTP-only nástrojům.
- Na Node; pokud ho chcete používat z jiného jazyka, musíte si vybudovat a udržovat bridge.
- Verze, kterou jsem spustil (24.16.0), je proti aktuálnímu npm latest (25.3.0) pozadu o jednu major verzi — před důvěrou v přesná čísla je potřeba znovu ověřit aktuální release.
Pro koho je a kdo by měl jít dál
Sáhněte po Puppeteeru, pokud pracujete v Node, vaše cíle se v Chromu vykreslují dobře (většinou ano) a chcete zralou, úzce zaměřenou knihovnu, která přetaví „stránku po doběhnutí JavaScriptu“ do něčeho čitelného a screenshotovatelného. Pro scraping sady dynamických stránek, pro zisk JSON API s vlastní session stránky nebo pro ukládání vykreslených screenshotů jako důkaz je to silná a bezproblémová výchozí volba. Varianta přes Firefox/BiDi je připravená, když dorostete, a ekosystém znamená, že většina problémů už byla řešena před vámi.
Zvažte to dvakrát, pokud je váš problém spíš orchestrace crawlů než rendering. Když potřebujete projít stovky nebo tisíce URL s deduplikací, retry a rate limity, samotný Puppeteer vás donutí postavit crawler ručně — a to je pro něj špatná úroveň abstrakce. Headless browser úplně vynechte, pokud vaše stránky k odhalení dat JavaScript vůbec nepotřebují; když content vrátí obyčejný HTTP request a parser, skutečný browser je drahý overkill, který jen pálí paměť a čas na setup. A pokud potřebujete věrnost WebKitu nebo klienta v jiném jazyce než JavaScript, tohle není nástroj pro tuhle osu.
Alternativy a místo Thunderbit
Nejprve poctivé rámování: Puppeteer je zdarma, pod licencí Apache-2.0, self-hosted a vy vlastníte úplně všechno kolem provozu — fleet prohlížečů, crawl kód, který na něj navěsíte, i dlouhodobý boj proti anti-bot ochranám. Pro spoustu projektů je právě tahle kontrola ideální a žádná managed služba nevykreslí autorizovanou stránku levněji než browser, který už máte.
V open source je užitečné srovnávat podle úkolu, ne podle loga. Pro crawl ve větším měřítku je přirozeným parťákem Crawlee: jeho PuppeteerCrawler obaluje Puppeteer o request queue, dataset a throttling, které knihovna záměrně neřeší, takže získáte rendering i orchestrace. Pokud je vaším cílem čistý Markdown pro LLM pipeline místo vykresleného DOMu, Crawl4AI řídí skutečný browser a produkuje přesně to. Pokud browser vůbec nepotřebujete, HTTP-first framework jako Scrapy je jiná a lehčí kategorie. Když zvažujete víc z nich najednou, náš souhrn open-source scraperů je staví vedle sebe.
Managed služba jako Thunderbit přesouvá provoz browseru i extrakci za API. Nebyla součástí těchto Puppeteer fixture, takže tahle recenze netvrdí nic srovnatelného o renderingu, blokování, kvalitě extrakce ani ceně. Rozhodovací hranice je provozní odpovědnost: buď si browser a crawl kód spravujete sami, nebo platíte poskytovateli, aby provozoval tuto část vrstvy.
S Puppeteerem neplatíte žádný vendor usage fee, ale compute, bandwidth, údržba browseru, orchestrace i provoz zůstávají na vás. Managed cesta účtuje za použití a část odpovědnosti přesouvá na poskytovatele. Tento experiment neporovnával výsledky.
Vyzkoušet Thunderbit pro extrakci webových dat
Závěr
Puppeteer 24.16.0 stojí za vyzkoušení, pokud jste v Node a potřebujete automatizaci prohlížeče zaměřenou na Chrome. Kód fixture získal 12 statických položek, 8 dynamických položek a 10 citátů z veřejného demowebu; známé same-origin API vrátilo přes page.evaluate osm záznamů; screenshoty fungovaly; a testované HTTP 500 zůstalo kontrolovatelné. Tyto výsledky patří konkrétním fixture a starší major verzi, ne obecné recall schopnosti extrakce.
Je ale potřeba správně zasadit očekávání. Puppeteer je renderer, ne crawler: můj průchod 12 stránkami vyžadoval ručně napsané BFS, protože vestavěná fronta neexistuje, a ve velkém to je reálná práce — předejte ji Crawlee nebo si mechanismus napište sami. Je Chrome-first, s dokumentovanou podporou Firefoxu přes BiDi, ale bez WebKitu, takže to není nástroj pro široký cross-engine záběr. Nese váhu skutečného browseru. A testoval jsem verzi 24.16.0 proti aktuálnímu 25.3.0, takže před důvěrou v přesná čísla je vhodné běh zopakovat na aktuální verzi. Když znáte tyhle čtyři věci předem, je Puppeteer výborná knihovna pro automatizaci Chromu. Když od něj očekáváte, že vám bude web i crawlvat, budete psát crawler, který jste si mysleli, že stahujete.
Vyzkoušet Thunderbit pro extrakci webových dat Get Started Free
Často kladené otázky
Umí Puppeteer vykreslovat JavaScriptové stránky, nebo potřebuji plugin?
Vykresluje je nativně, bez pluginu. Na mé dynamické fixture vrátil 8 z 8 klientem vykreslených produktů s recall 1.0 a full-page screenshotem a veřejná JS stránka Quotes to Scrape vrátila všech 10 citátů stejným způsobem — prosté goto a pak čtení vykresleného DOMu. Protože Puppeteer ovládá skutečný Chrome přes DevTools Protocol, skripty stránky se před čtením opravdu spustí.
Dokáže Puppeteer scrapovat JSON API bez parsování HTML?
Ano, pokud to dovolí endpoint i request contract. page.evaluate může poslat request z originu stránky a někdy znovu použít příslušné cookies, ale automaticky nereprodukuje aplikační hlavičky, tokeny, options ani chování service workeru. Na same-origin fixture vrátil všech osm záznamů bez parsování DOMu.
Je Puppeteer web crawler? Ne — je to knihovna pro automatizaci prohlížeče, ne crawl framework. Nemá vestavěnou request queue, writer datasetu ani throttle, takže můj crawl 12 stránek (hloubky {0:1, 1:4, 2:7}) potřeboval ručně napsané breadth-first search. To je hranice rozsahu, ne chyba. Pro crawl ve velkém ho spojte s wrapperem jako je Crawlee PuppeteerCrawler, který přidá frontu a datasetovou infrastrukturu, kterou Puppeteer nechává stranou.
Je Puppeteer jen pro Chrome? Už ne. Je Chrome-first přes CDP, ale od v23 má zdokumentovanou podporu Firefoxu přes WebDriver BiDi a verze, kterou jsem testoval (24.16.0), je už dávno za tím. Co ale neovládá, je WebKit, a jeho cross-engine příběh je mladší než u Playwrightu — to je přesné omezení, ne „jen Chrome“. Tady jsem použil jen Chrome, takže Firefox přes BiDi uvádím jako dokumentovanou schopnost, ne jako něco, co jsem měřil.
Co se při instalaci Puppeteeru vlastně stáhne?
Ve výchozím nastavení npm install puppeteer stáhne kompatibilní Chrome for Testing build. Download lze přeskočit nebo přesměrovat a je možné nastavit i jiný executable, takže shoda verzí závisí na způsobu nasazení. Počítejte s diskem a bandwidth pro browser, zejména na CI běžícím z prázdné cache. Tahle recenze testovala 24.16.0; klíčové fixture je vhodné spustit znovu na verzi aktuální v době publikace.




