
Téměř každý přehled typu „nejlepší open-source scraper“ má jeden nenápadný problém: nástroje nikdo netestuje na stejných stránkách. Scrapy se zkouší na zpravodajském článku, Playwright na nějakém e-commerce demu, Colly na tom, co měl autor zrovna po ruce — a pak se srovnávají vedle sebe, jako by ta čísla vůbec mohla znamenat totéž. Takové pořadí vám spíš prozradí něco o stránkách než o nástrojích.
Proto jsem udělal tu nudnou a očividnou věc, kterou seznamy obvykle vynechávají. Připravil jsem jednu sadu testovacích fixture a poslal přes ni všech devět nástrojů: statický katalog, katalog vykreslovaný přes JavaScript, článek schovaný v navigaci a patičkovém balastu, záměrně rozbitý HTTP 500, malý graf interních odkazů a k tomu dva veřejné tréninkové weby. Stejná výchozí data, stejné metriky, každý jediný běh. Skripty i surové výstupy jsou v jednom veřejném benchmark repozitáři, takže si to můžete kdykoli spustit sami. A výsledek není ten uhlazený žebříček, který slibují souhrny — žádný jediný vítěz neexistuje. Jsou tu tři různé úlohy a devět nástrojů se do nich rozpadne téměř samo.
Vyzkoušejte Thunderbit pro extrakci webových dat
Jak benchmark fungoval a jedno omezení, které řeknu nahlas
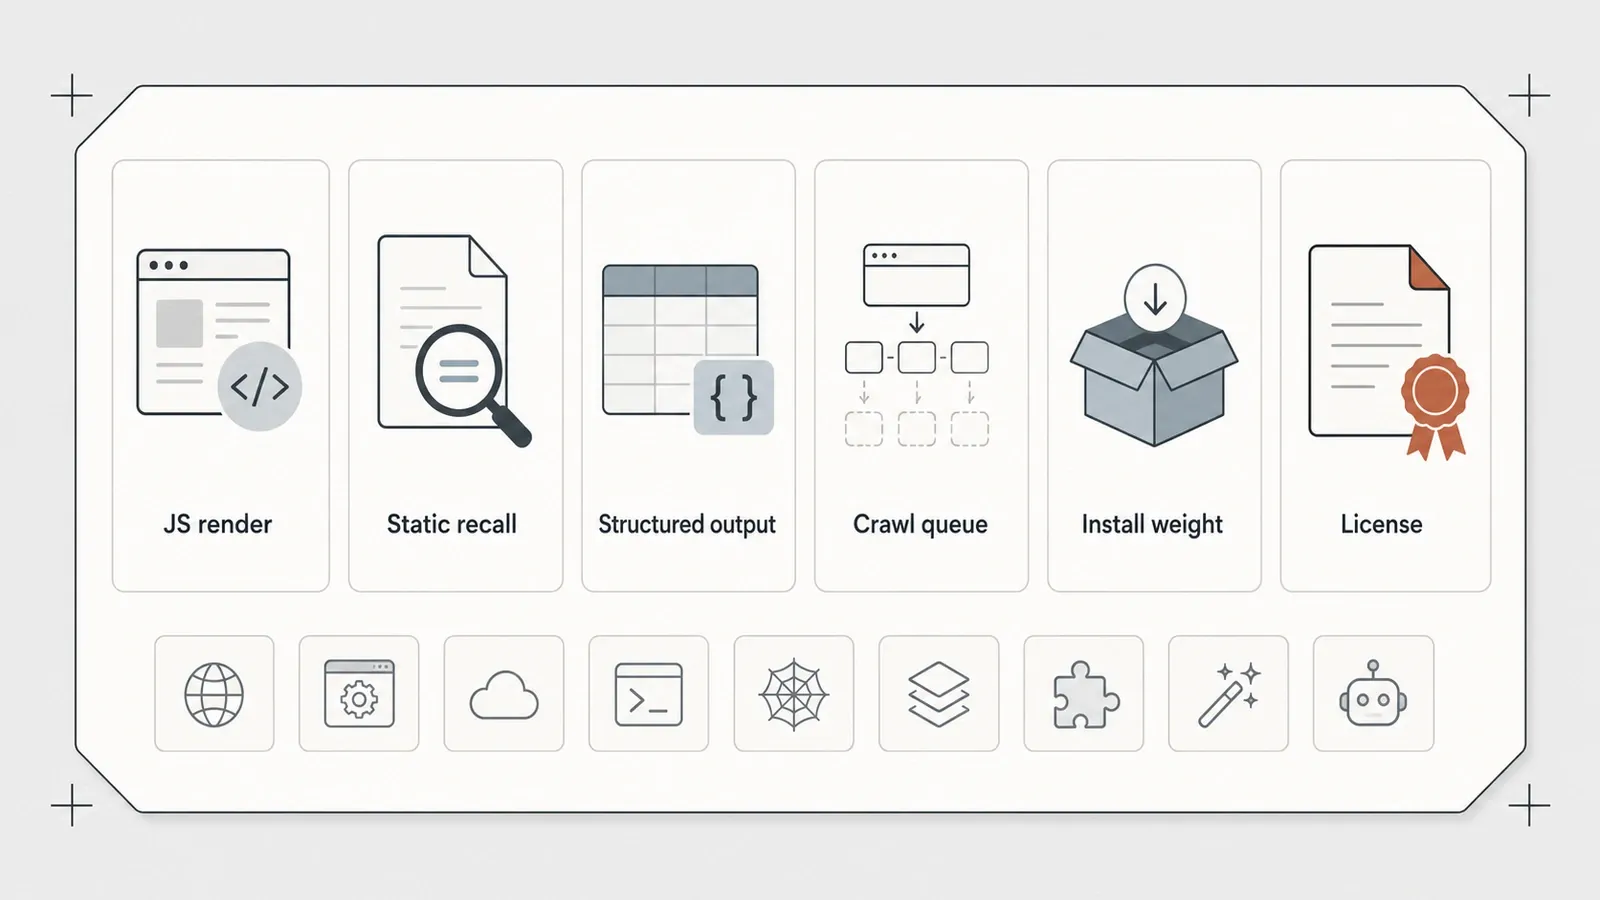
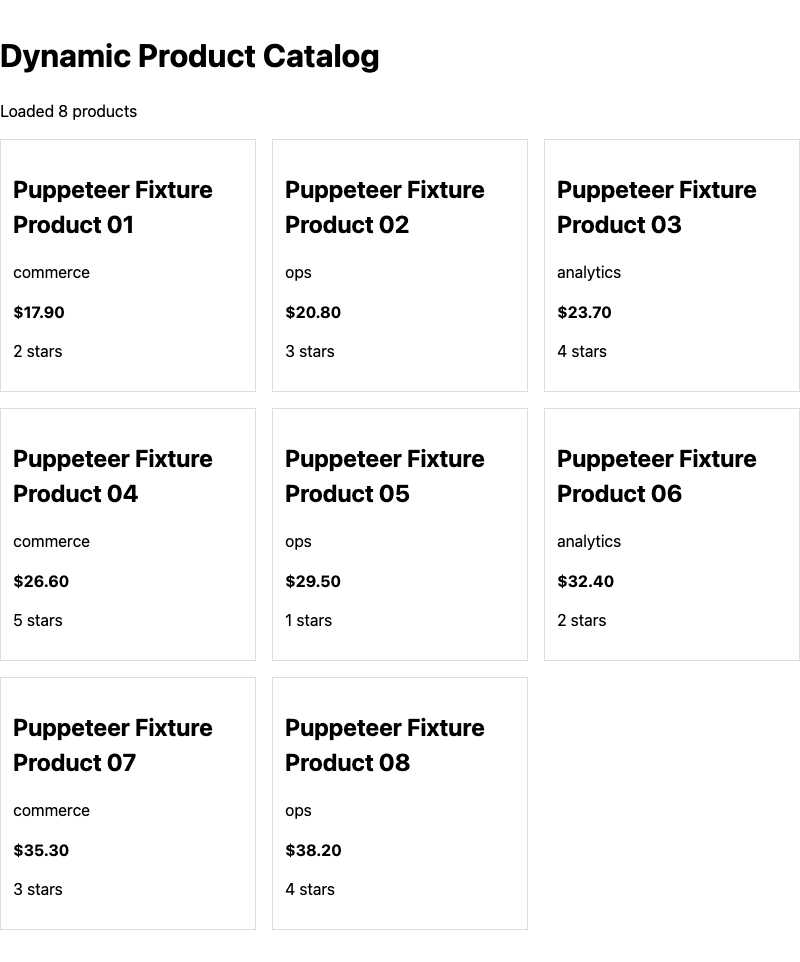
Každý nástroj dostal stejné typy fixture: 12 statických produktů rozprostřených přes dvě stránky, 8 produktů vložených přes JavaScript se zpožděním, článek obalený navigací a patičkou kolem tří skutečných odstavců, záměrný serverový 500 a graf interních odkazů. Právě tahle konstrukce dává výsledkům smysl — „8/8 dynamických produktů“ znamená přesně totéž, ať je vytvořil Puppeteer nebo Crawlee.
Tady je hranice, kterou většina přehledů přeskočí. Balíček každého nástroje zrcadlí vlastní kopii těchto fixture, takže absolutní počty znaků nejsou mezi nástroji striktně porovnatelné — berte je jako signál uvnitř daného nástroje, nikdy ne jako mezistrojové skóre. Srovnatelné jsou tyto věci: recall (berte ho jako poměr), úspěch/neúspěch u JavaScriptu a strukturální chování. A ještě jedna poznámka ve stejném duchu: běh Crawl4AI na statickém katalogu pokrýval jen první stránku, takže jeho 6/6 znamená plný recall na užším výseku, zatímco ostatní nástroje prošly obě stránky pro 12/12 — menší rozsah, ne částečné selhání. Celé zdůvodnění po jednotlivých fixture je v popisu metodiky.
Ještě jedna výhrada před čísly. Každý balíček obsahuje i předběžné výzkumné skóre, ale záměrně je nepublikuji jako tabulku pořadí. Sloužily jen jako interní kontrola, jestli nástroj odpovídá vlastním důkazům, ne jako ligová tabulka — a zveřejnit je tímto způsobem by přesně zopakovalo problém falešné přesnosti, kterému se celý tenhle test snaží vyhnout. Tohle je syntéza toho, co benchmark ukázal, ne výsledková listina.
Celé pole na jednom benchmarku
Podívejte se na dva sloupce v této tabulce — „Rendruje JS?“ a „Vestavěná crawl fronta“ — a tři úlohy se prakticky samy vyjeví.
| Nástroj | Jazyk | Rendruje JS? | Statický recall | Strukturovaný výstup | Vestavěná crawl fronta | Náročnost nastavení | Licence |
|---|---|---|---|---|---|---|---|
| Crawl4AI | Python | Ano (browser) | 6/6 (1. stránka) | CSS schema | Vestavěné BFS/DFS | Vysoká (2 browser stacky) | Apache-2.0 |
| Firecrawl | Self-hosted | Ano (playwright-service) | Plný Markdown | Ano | /v1/crawl | Nejvyšší (6 kontejnerů) | AGPL-3.0 |
| trafilatura | Python | Ne | 3/3 článku | Ne (jen text) | Ne | Nízká | Apache-2.0 |
| Crawlee | Node/TS | Volitelné podle engine | 12/12 | Přes extraction | Ano (RequestQueue) | Střední (+~80 MiB) | Apache-2.0 |
| Playwright | Node/multi | Ano | 12/12 | Ručně | Ne (BFS psané ručně) | Střední (browser) | Apache-2.0 |
| Puppeteer | Node | Ano (Chrome) | 12/12 | Ručně | Ne (BFS psané ručně) | Střední (Chrome) | Apache-2.0 |
| Scrapy | Python | Ne | 12/12 | Feed export (JSON/CSV/XML) | Ano (vestavěná) | Střední (závislosti Twisted) | BSD-3 |
| Colly | Go | Ne | 12/12 | Přes callbacky | Řízení hloubky | Nízká (1 binárka + Go) | Apache-2.0 |
| Scrapling | Python | Ne (HTTP fetcher) | 12/12 | Ano | Ne | Střední ([fetchers]) | BSD-3 |
Ještě poznámka k metadatům v tabulce i všude níže: počty hvězdiček a čísla verzí byla zachycena na začátku července 2026 a obojí se rychle mění. Než je začnete považovat za aktuální, ověřte je znovu na GitHubu a v balíčkovací stránce každého projektu.
Přehled jednotlivých nástrojů
Každý projekt v tomto přehledu má vlastní podrobnou recenzi:
- recenze Crawl4AI
- recenze Firecrawl
- recenze trafilatura
- srovnání Playwright vs Puppeteer
- recenze Crawlee
- recenze Scrapy
- recenze Colly
- recenze Scrapling
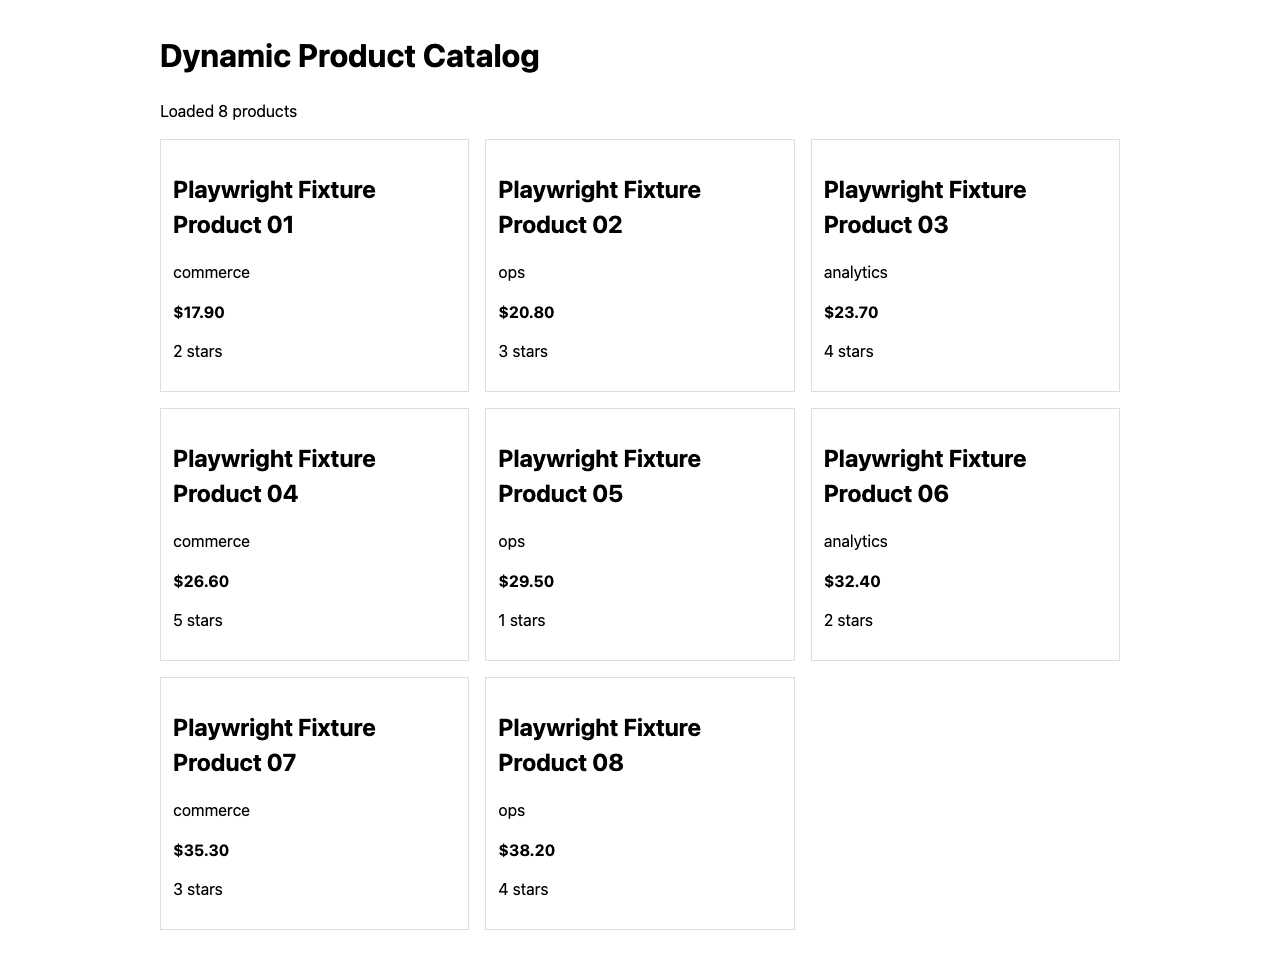
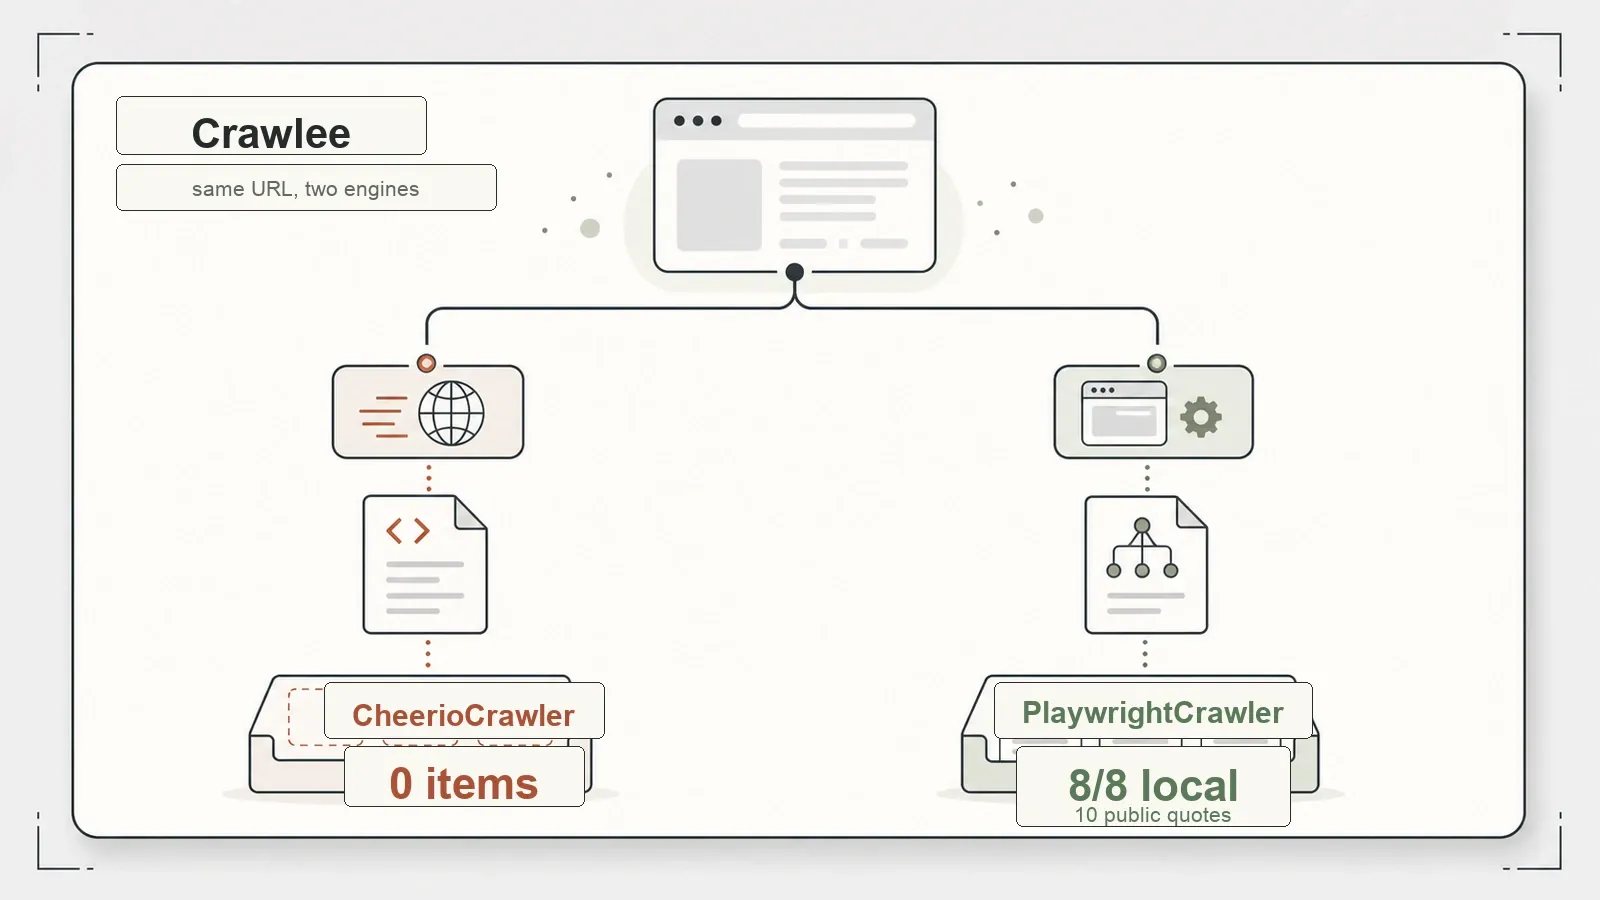
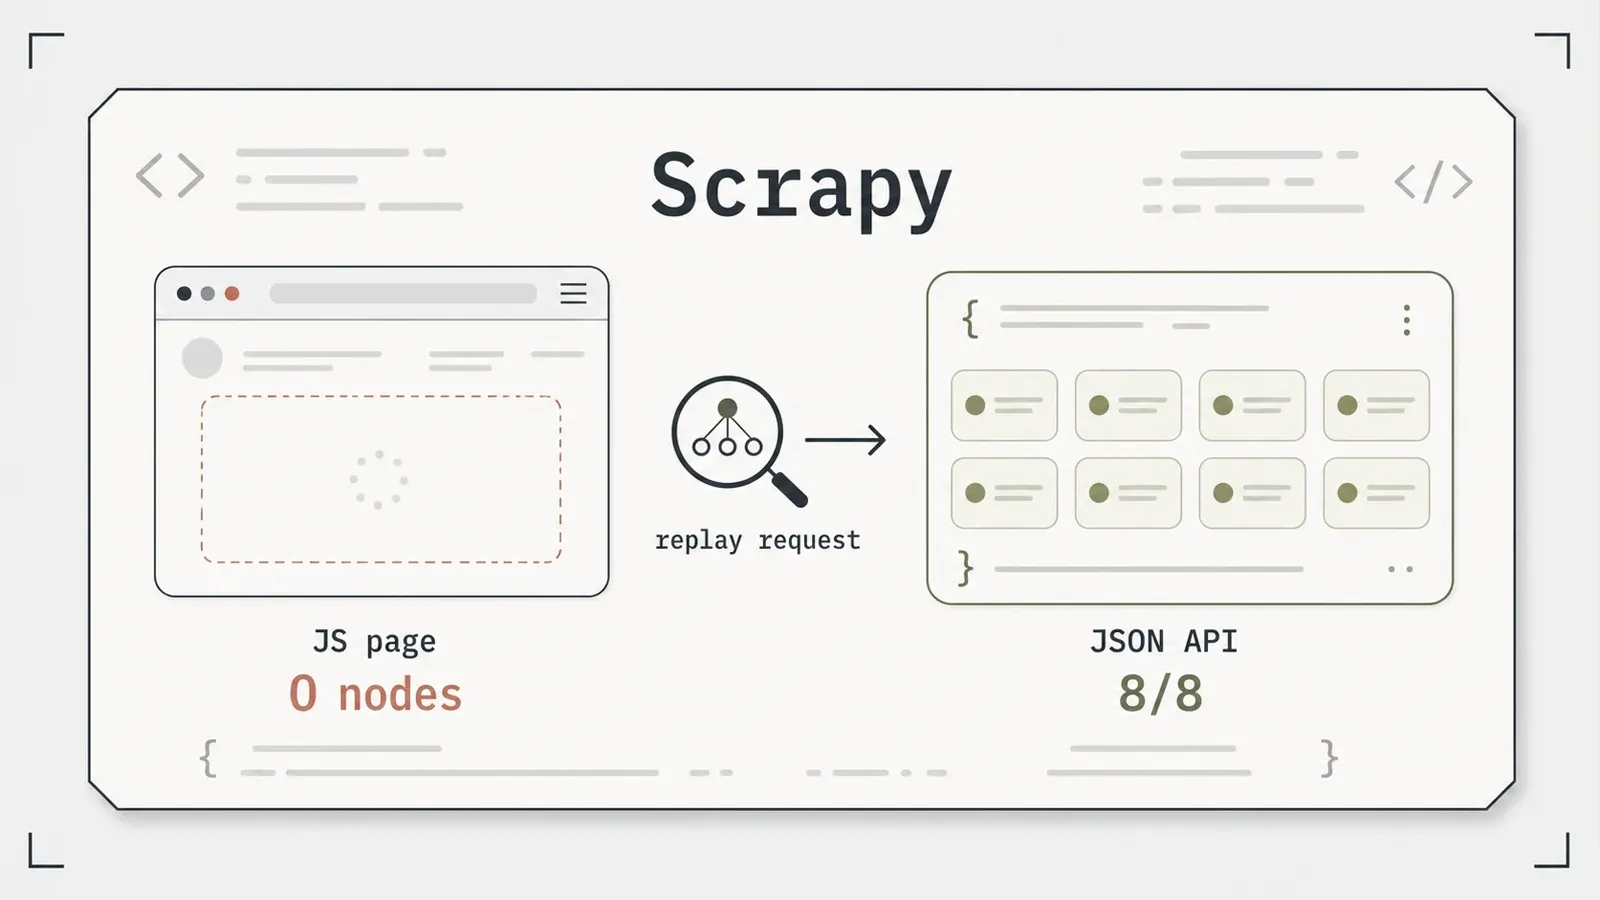
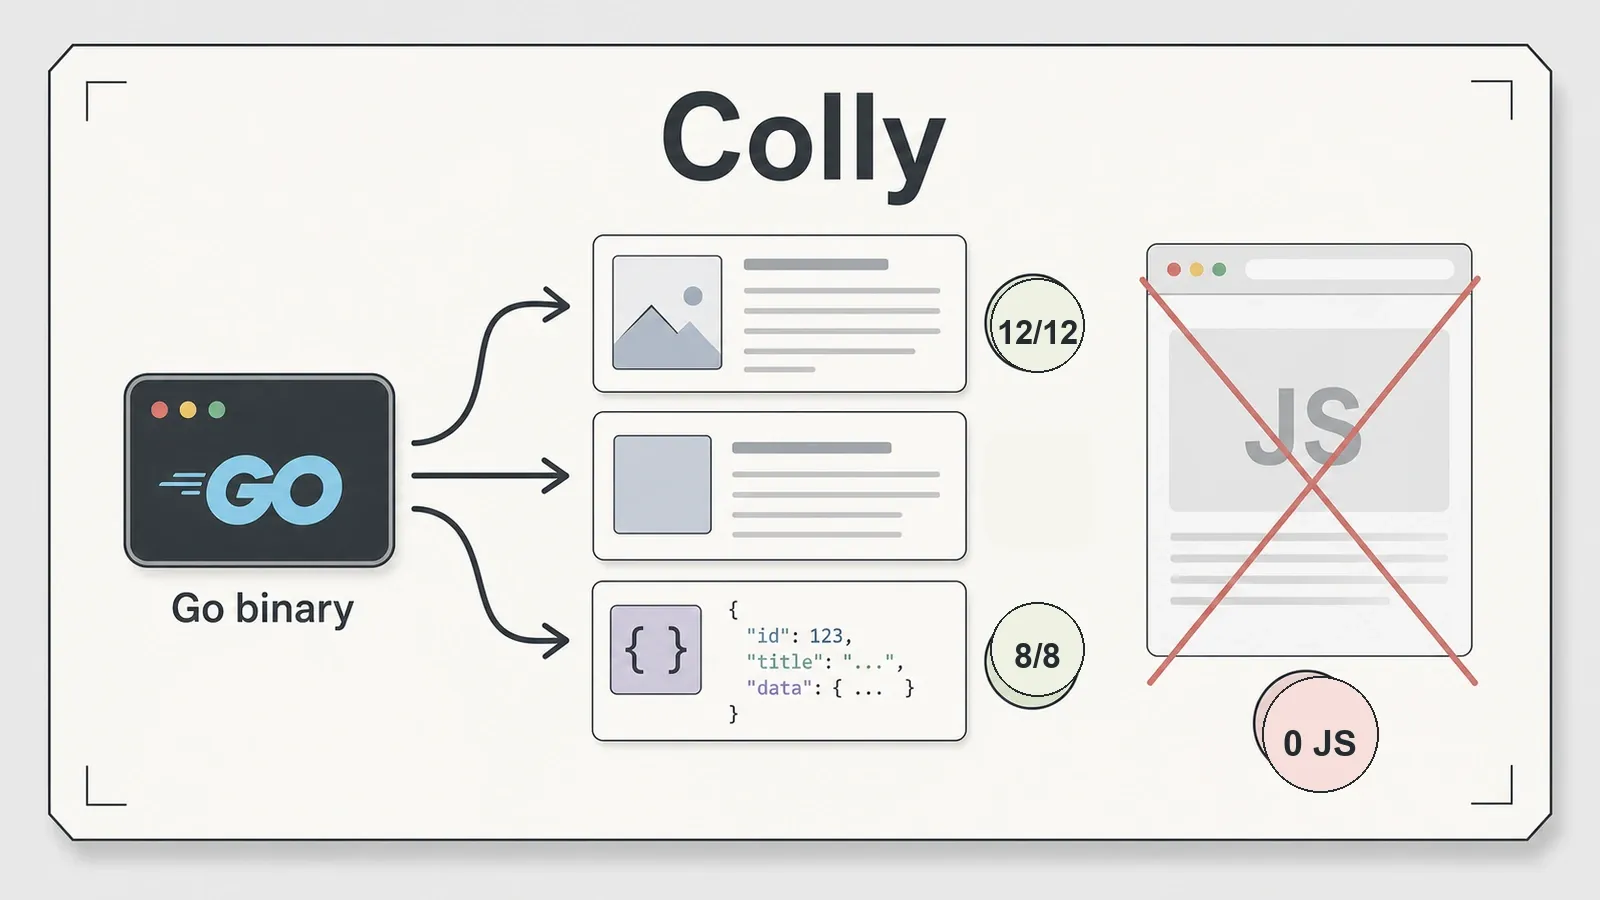
Tady jsou jejich titulky — plus dvě skutečné ukázky z testu JavaScript renderingu, aby tvrzení o „8/8 dynamických“ nebylo jen číslo na stránce.
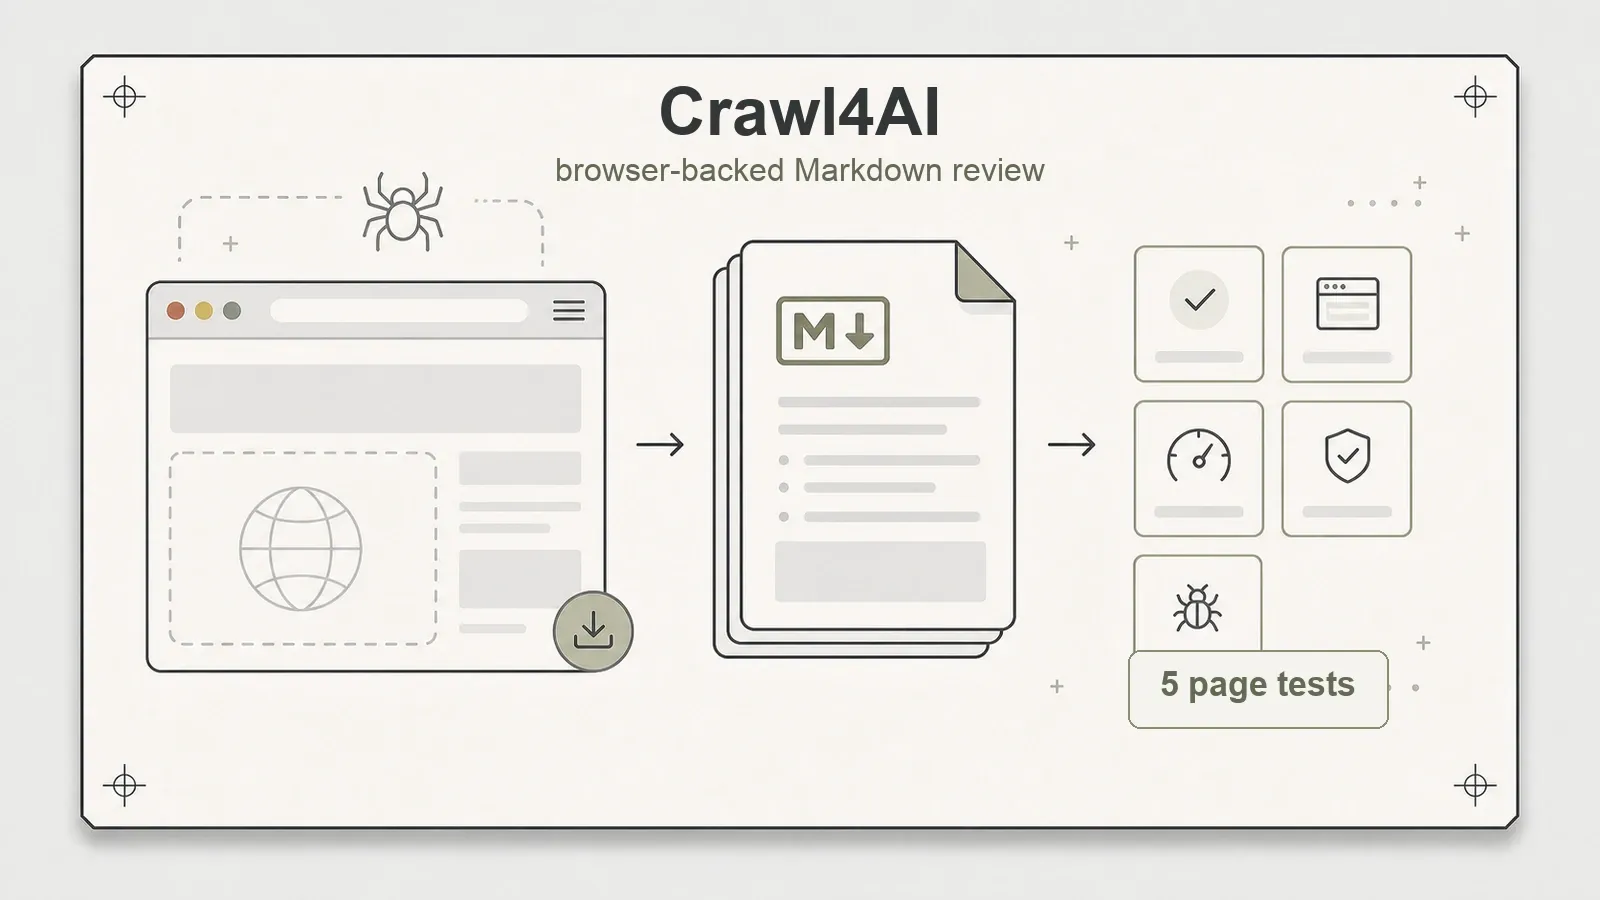
Úloha jedna: přeměnit stránku na text připravený pro LLM
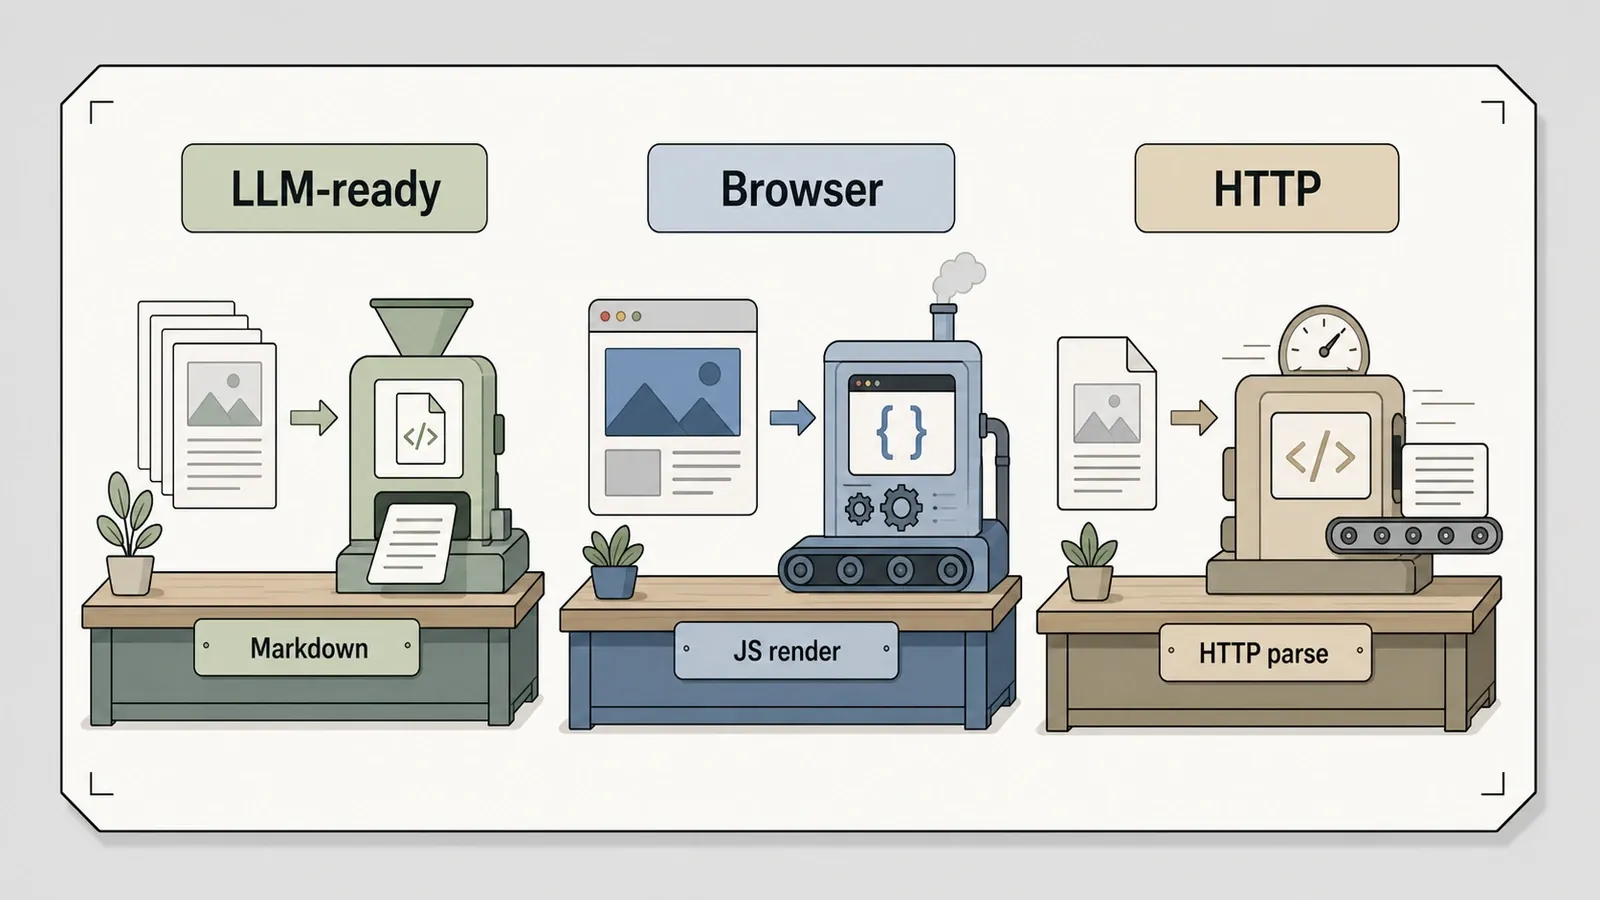
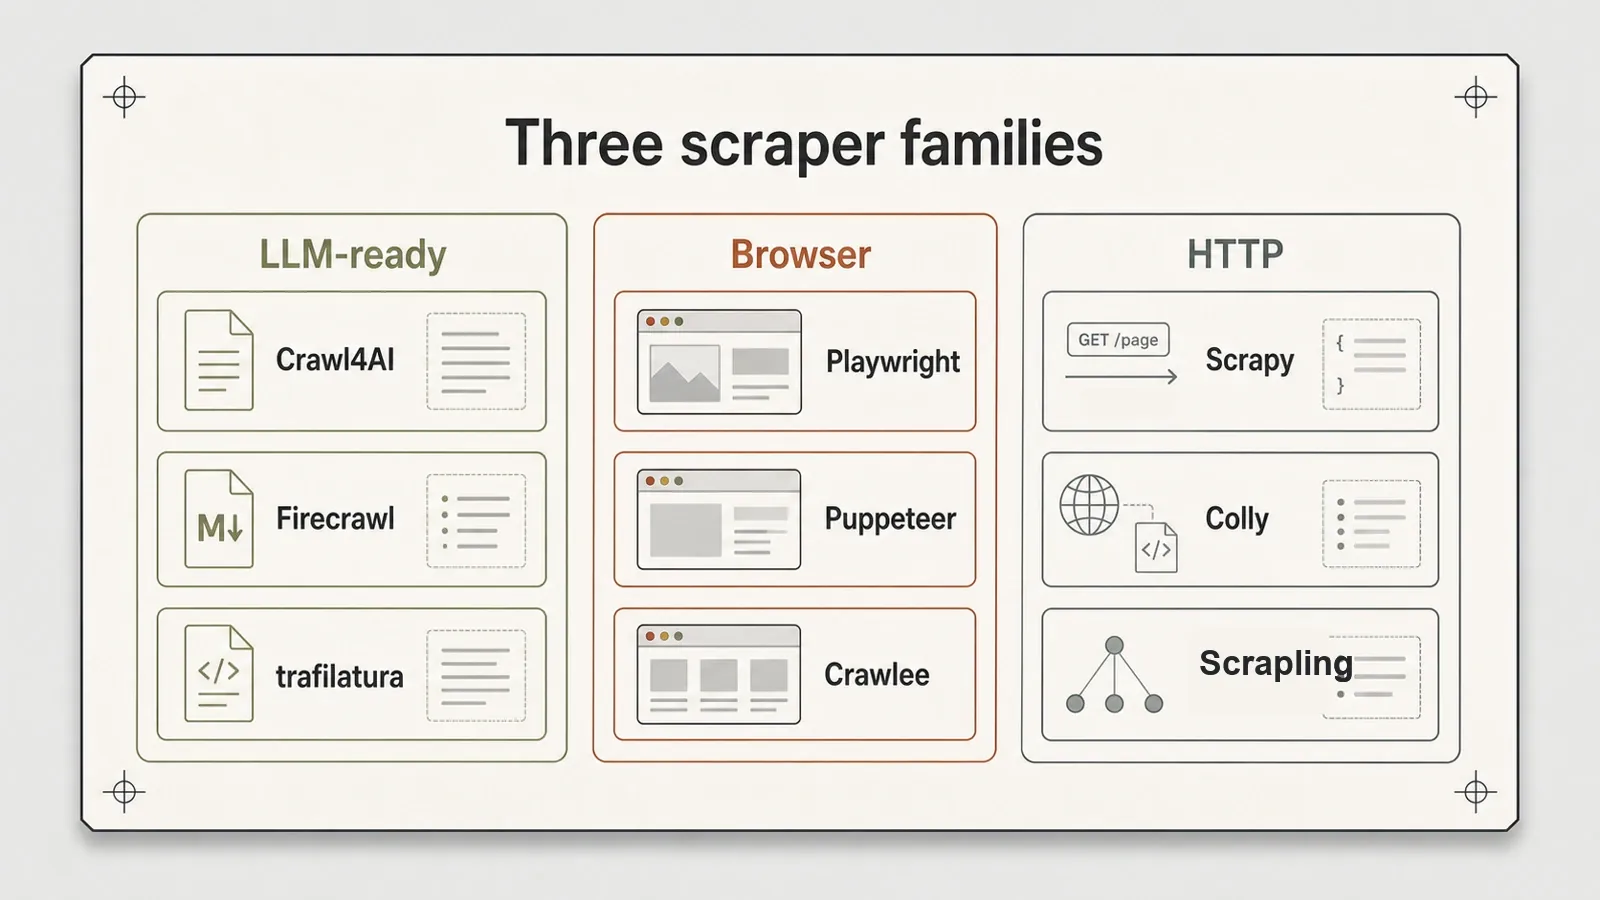
Pokud chcete čistý Markdown pro RAG pipeline, soupeří tři nástroje — a každý z nich je postaven úplně jinak.
Crawl4AI je pod marketingem v podstatě browserem podpořený generátor Markdownu. Stojí za to zrušit příběh o „adaptivní inteligenci se samoučícími selektory“, který se kolem něj motá ve výsledcích vyhledávání: nic takového nemá — to je trik jiné knihovny (víc o tom až u Scrapling). To, co skutečně dělá, dělá dobře. Na testovacím webu Books to Scrape vyprodukoval 13 476 znaků Markdownu, umí CSS-schema extrakci pro strukturované tahy dat a jeho vestavěné BFS deep crawl prošlo na fixture crawl grafu 5 stránek, zatímco zároveň rendrovalo JavaScriptovou stránku a pořídilo screenshot. Dvě skutečné slabiny ale má. Surový Markdown si nese boilerplate stránky, pokud nezapnete filtr obsahu, a záměrný 500 se vrátil jako success=false — ne proto, že by Crawl4AI HTTP chybu elegantně zachytil, ale protože jeho vlastní heuristika obsahu se podívala na krátké chybové tělo a označila ho jako minimal_text ... blocked. A instalace vám na disk přidá dva browser stacky. Verze 0.9.0, Apache-2.0, zhruba 71 tisíc hvězdiček na začátku července.
Firecrawl je těžká váha a self-hosting u něj opravdu funguje — říkám „opravdu“, protože šestikontejnerový stack (api, playwright-service, redis, rabbitmq, nuq-postgres a foundationdb) skutečně naběhl a ze stejné stránky Books to Scrape vyprodukoval 9 222 znaků LLM-ready Markdownu. Stránku s JavaScriptem rendroval přes zabudovaný playwright-service a Einsteinův citát vložený po spuštění skriptu se v výstupu opravdu objevil, což potvrdilo, že render byl skutečný. Dva zádrhele, na které jsem narazil, byly vinou prostředí, ne Firecrawl, a zmiňuji je přesně, aby si nikdo nenechal poradit špatné řešení: build ze zdrojáků narazil na problém snapshotteru v containerd pod colimou (přešel jsem na předpřipravené image) a colimovo DNS rozmezí 198.18.x.x spustilo Firecrawl SSRF ochranu, kterou jsem vyřešil přes ALLOW_LOCAL_WEBHOOKS=true — lokální workaround pro vývoj, ne něco, co byste měli vypínat v reálném nasazení. Self-hosted jádru navíc chybí Fire-engine, cloudová anti-block vrstva, a cloudové API jsem netestoval. Větší varování je ale licence: self-hosted core Firecrawl je AGPL-3.0, takže před komerčním použitím si to skutečně zaslouží právní kontrolu, ne poznámku pod čarou. Na začátku července měl asi 148 tisíc hvězdiček.
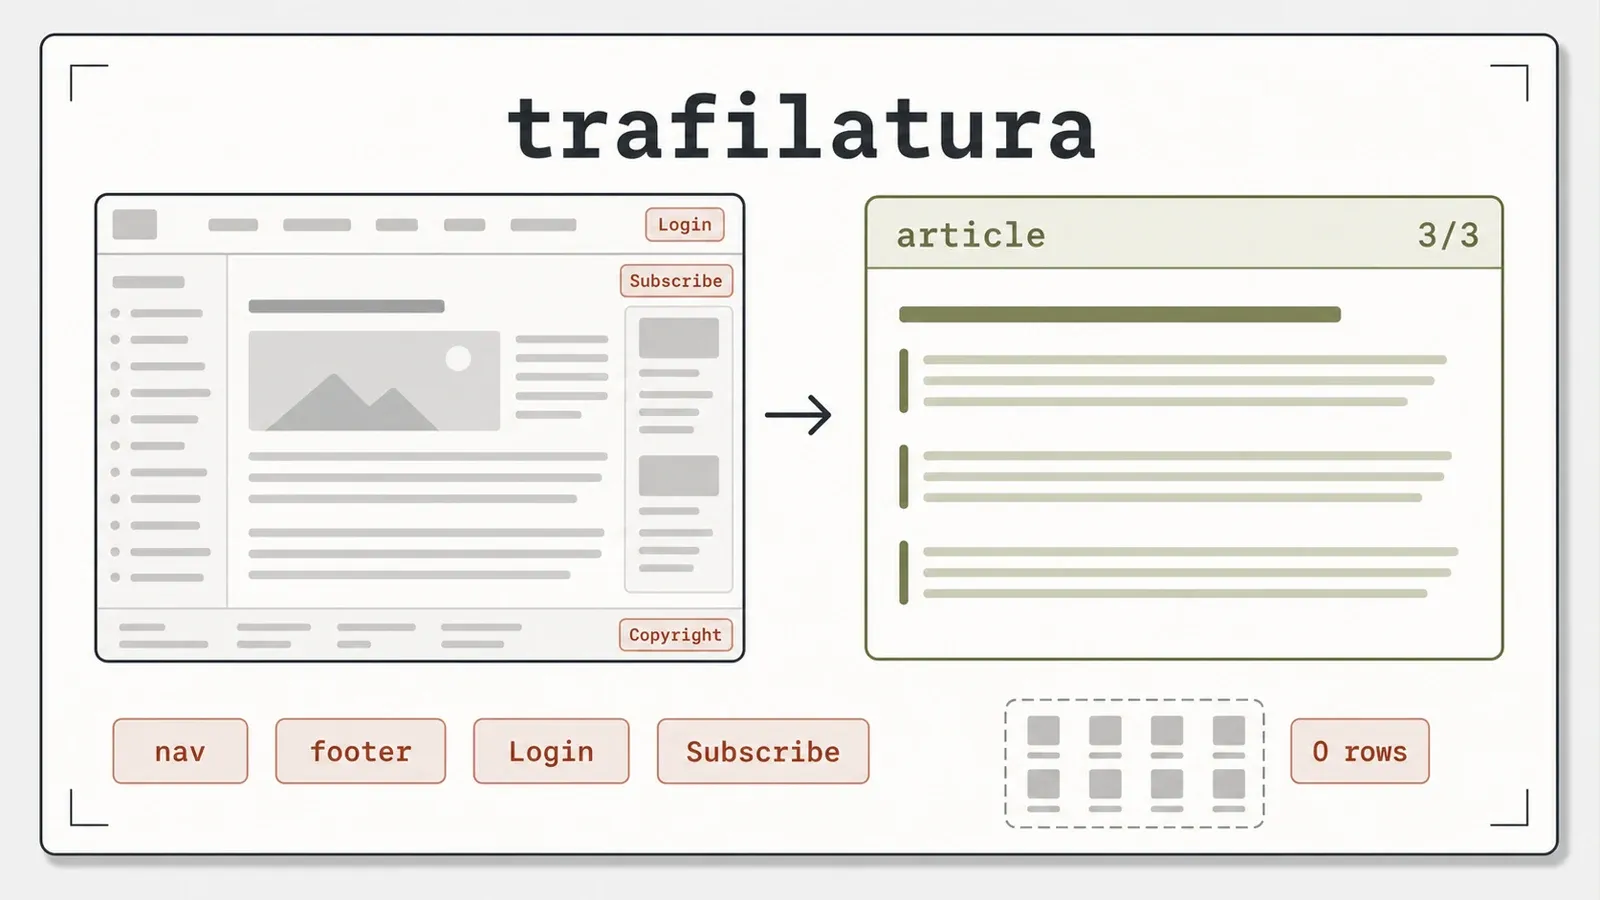
trafilatura je v téhle skupině tak trochu proti proudu a je to nástroj, na který AI-hype seznamy pořád zapomínají. Žádný browser. Žádné strukturované řádky. Jen rychlý a čistý text článku v čistém Pythonu. Na fixture článku vytáhla název a všechny 3 ze 3 skutečných odstavců, kompletně odstranila boilerplate — neprolezly žádné „Login“, „Subscribe“ ani „Copyright“ — a navrch získala i autora a datum. Na veřejné produktové stránce vrátila 1 324 znaků čistého textu. Její limit přesně odpovídá návrhu: když ji nasměrujete na katalog, vrátí 12 názvů produktů jako text, ale 0 strukturovaných řádků — text tam je, struktura ne, a žádný JavaScript nerendruje. Verze 2.1.0 (aktuální vydání), Apache-2.0, asi 6,2 tisíce hvězdiček. Pro čistou extrakci článků je to první volba.
Ta dvě čísla o počtu znaků v Markdownu — 13 476 u Crawl4AI, 9 222 u Firecrawl — pocházejí ze stejné veřejné stránky, ale neberte je jako rozdíl v kvalitě. Odrážejí různé strategie Markdownu (kolik stránkového „chrome“ každý nástroj zachovává), ne verdikt o tom, který výstup je lepší. To je přesně ono pravidlo o signálech uvnitř nástroje, které jsme zmínili dřív.
Úloha dvě: spolehlivě rendrovat JavaScript
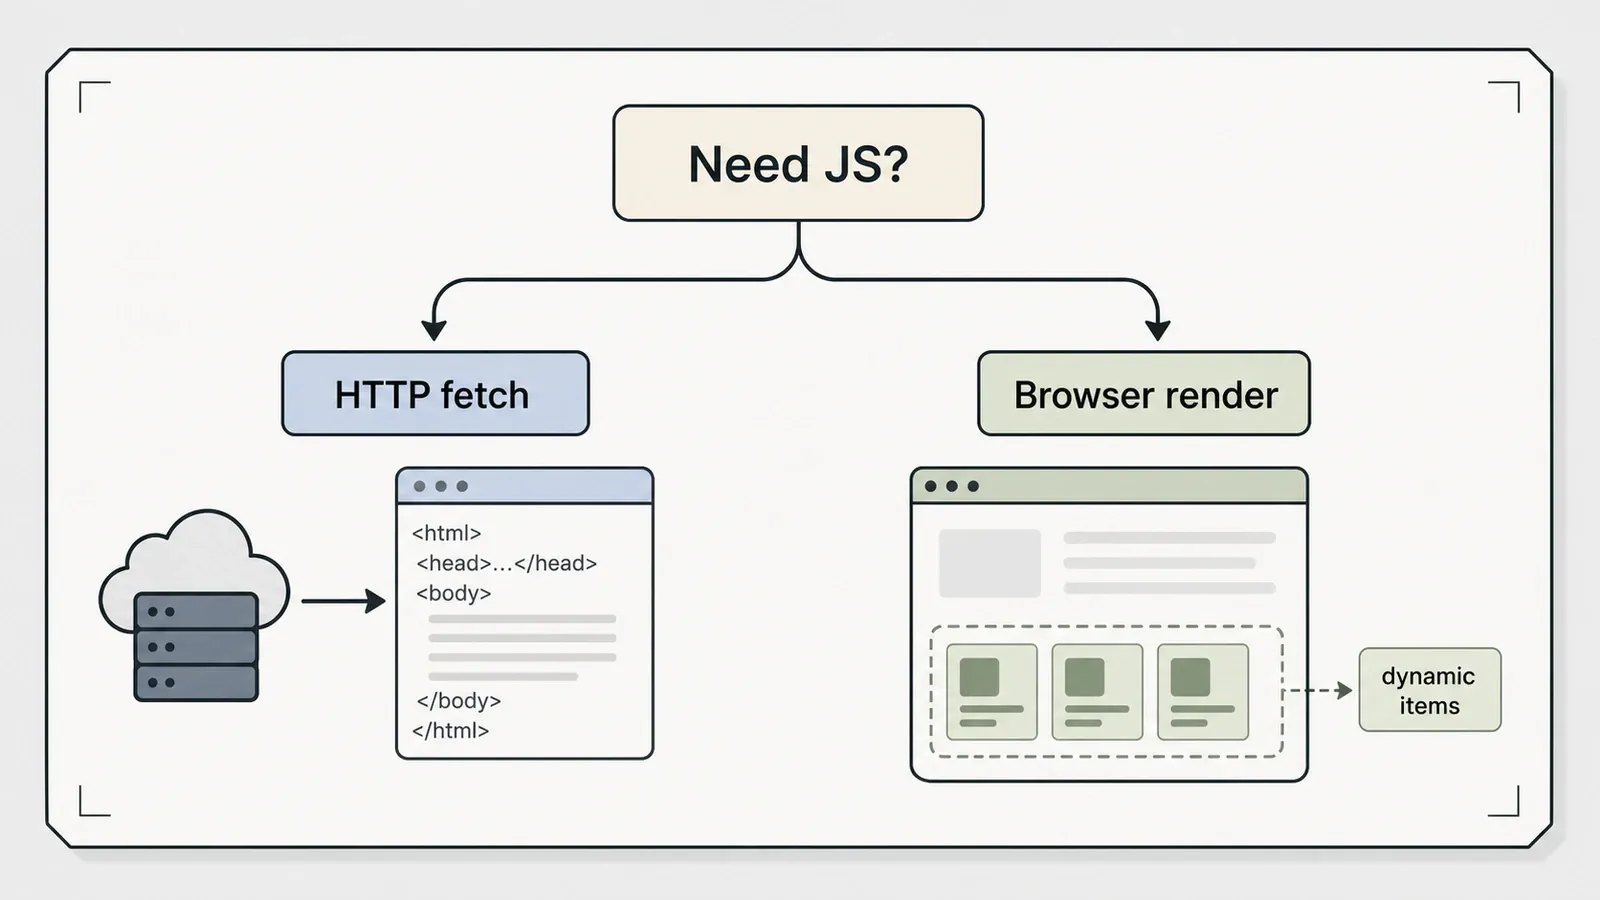
Některá data v HTML prostě nejsou, dokud nespustíte skripty, a právě tehdy přestává být opravdový browser volitelný. Tuhle úlohu pokrývají tři nástroje — a dva z nich se ukázaly být skoro stejný nástroj.
Playwright a Puppeteer dopadly ve všech testech nerozhodně. Oba rendrovaly 8/8 dynamických produktů na lokální fixture a 10 na veřejném Quotes JS webu, oba dosáhly 12/12 u statického recallu a oba zvládly 500 čistě (Puppeteer vrací response objekt místo vyhození výjimky). Ani jeden nedodává crawl frontu, takže oba potřebovaly BFS napsané ručně, které na crawl grafu prošlo 12 stránek v hloubkách 0–2. Jediný skutečný rozdíl je v dosahu: Playwright ovládá Chromium, Firefox i WebKit a mluví Pythonem i .NET, zatímco Puppeteer je primárně pro Chrome a jen pro Node. Dvě upřesnění, protože verze se tu rychle posouvají: testoval jsem Playwright 1.56.0 proti aktuální 1.61.1 a používal jsem jen Chromium; Puppeteer 24.16.0 proti aktuální 25.3.0 — berte to tedy při opakování nebo interpretaci v úvahu. Oba Apache-2.0; zhruba 92 tisíc a 95 tisíc hvězdiček.
Crawlee je ten, který řeší problém s frontou, který ty předchozí dva nechávají otevřený. Schovává engine Cheerio (HTTP) i Playwright (browser) pod jedno API a kontrast na jedné stránce je celý jeho argument: Cheerio engine neviděl 0 položek vložených JavaScriptem, Playwright engine viděl lokálně všech 8/8 (a 10 na veřejném webu) a přepnutí mezi nimi je otázka jedné řádky. Navíc nabízí skutečný RequestQueue, a právě tím si zaslouží místo v této úloze, ne v té třetí. Háček, který nikdo nedává do titulku: browser engine vyžaduje samostatné npx playwright install, což je asi 80 MiB, které vám npm install crawlee nestáhne sám. Verze 3.17.0, TypeScript, Apache-2.0, přibližně 24,6 tisíce hvězdiček.
Úloha tři: rychle crawlout bez browseru
Když na stránce není JavaScript, je browser drahý overkill. Tady soupeří tři HTTP-first nástroje, každý s jinou jazykovou filozofií, a liší se zajímavým způsobem.
Scrapy je z téhle trojice nejvíc „inženýrský“ framework — spiders, feed export do JSON/CSV/XML, AutoThrottle, všechno. U statické stránky dosáhl 12/12 recallu, vytáhl 3/3 odstavce článku, prošel 11 stránek v crawl grafu při hloubce 0–2 a 500 zachytil přes handle_httpstatus_list. Zajímavější je jeho filozofie: nic nerendruje, ale reprodukuje request. Když jsem na něj poslal JavaScriptovou stránku, dostal 0 uzlů — a pak JSON API za tou samou stránkou mu dalo 8/8. To je Scrapy v jedné datové větě: najdi request, který stránka dělá, a přehraj ho, neřiď browser. Cenou za to je výraznější sada závislostí (Twisted, lxml, parsel) a testoval jsem ho jen na malých fixture. Verze 2.17.0, BSD-3-Clause, asi 63 tisíc hvězdiček.
Colly je odpověď světa Go a je příjemně doslovný v tom, čím je: jedna statická binárka, callbacky přes OnHTML, OnResponse a OnError, a řízení hloubky. Zvládl 12/12 statického recallu, vytáhl 8/8 z JSON API přes OnResponse, zachytil 500 přes OnError a došel na 17 stránek v crawl do hloubky 2 — a budu to takhle říkat přesně, protože ten počet stránek je čítač z harnessu, ne záruka úplnosti, kterou by Colly sliboval. Co ale neumí, je JavaScript: dynamická fixture i Quotes JS web skončily 0, záměrně. Ke kompilaci budete potřebovat Go toolchain a verze modulu (v2.3.0) je momentálně napřed před tagovaným vydáním (v2.2.0). Apache-2.0, zhruba 25 tisíc hvězdiček.
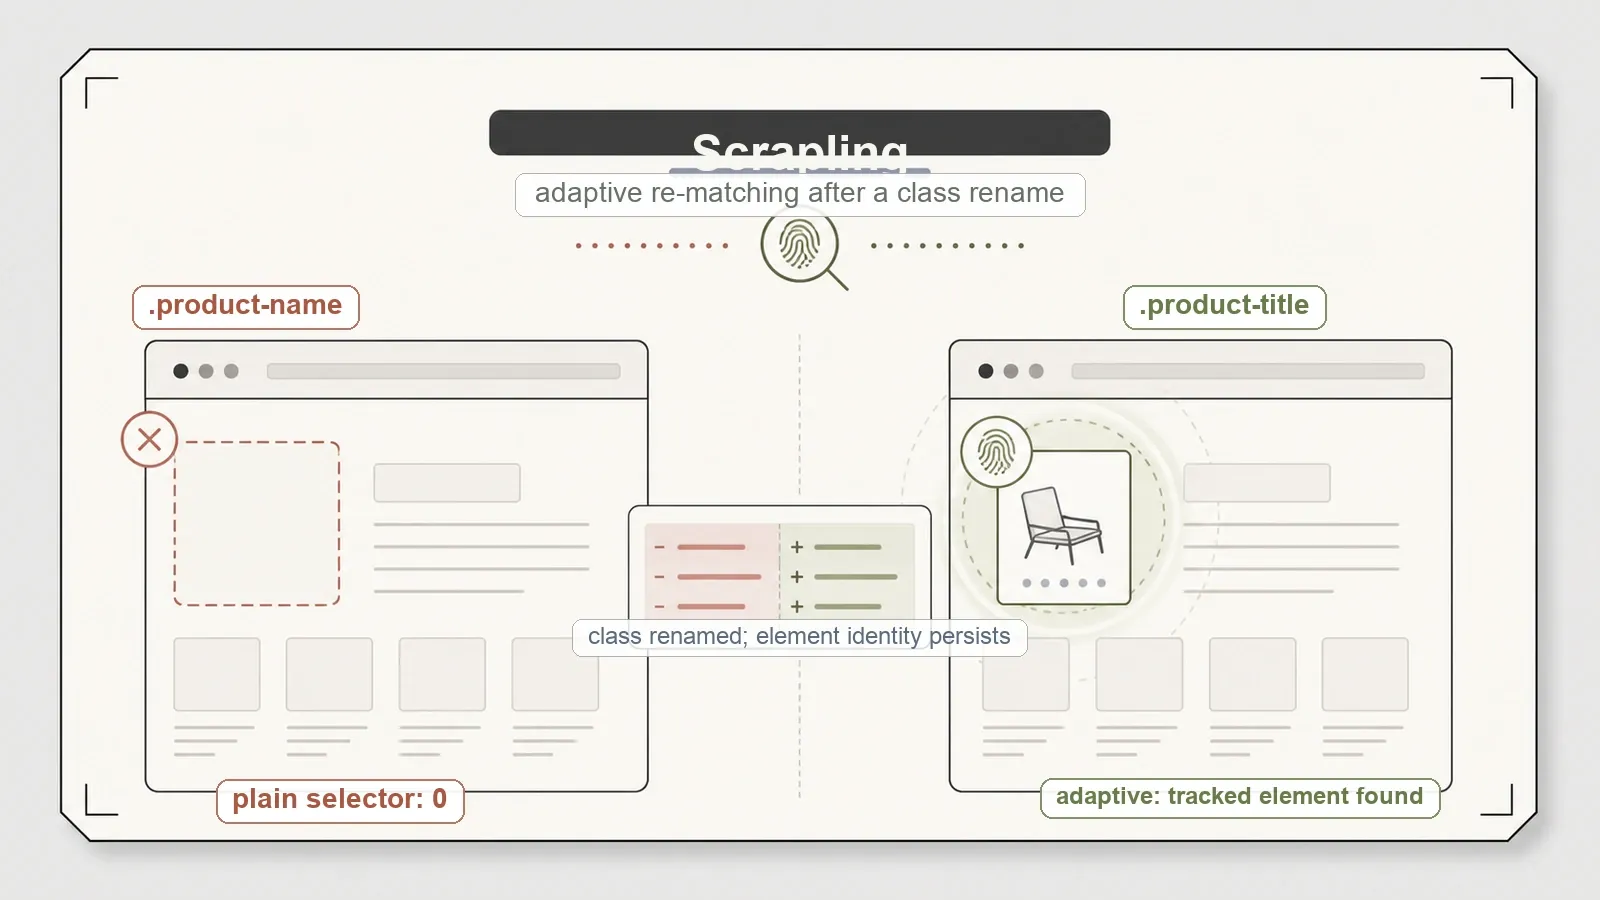
Scrapling je specialista a ten název si opravdu zaslouží. Jeho adaptivní selektory dokážou znovu najít prvek poté, co se změní markup — takže když jsem cílovému prvku přejmenoval HTML třídu z product-name na product-title, obyčejný selektor našel 0 a adaptivní znovu-spárování přesto zachránilo sledovaný prvek. Při čisté HTTP extrakci dosáhl 12/12 na statickém obsahu a 8/8 na JSON API. Co jeho dokumentace neskrývá: v syntetickém testu s více prvky obnovil 1 ze 3 — jde o odolné sledování prvků, ne o univerzální obnovu, takže to v hlavě nepřehánějte. Základní pip install scrapling navíc potřebuje extra balíček [fetchers], aby se vůbec rozběhl, a jeho StealthyFetcher je spíš licenční/opatrnostní otázka než funkce, kterou bych dával na slide. Verze 0.4.10 (aktuální vydání), BSD-3-Clause, asi 68,7 tisíce hvězdiček.
Vzor, který je pod těmi třemi úlohami
Když tyto nástroje postavíte vedle sebe, vyjde z toho něco docela čistého. Plný statický recall — rovné 12/12 — je základ pro každý HTTP-first nástroj; nikdo nepropadl v jednoduchém případě, takže to není rozlišovací znak. Browser nástroje si vyšší váhu obhájí jen tehdy, když je v tom skutečně JavaScript, a za tu cenu platí v nastavení: browser stackem, dalším instalátorem nebo celou flotilou kontejnerů. A sloupec „vestavěná crawl fronta“ je ve skutečnosti hranice mezi frameworkem a enginem — Scrapy a Crawlee přinášejí orchestrace, zatímco Playwright a Puppeteer vás nutí BFS napsat sami. Takhle pole vypadá. Nikdo nevyhrává celkově, protože nikdo nehraje stejnou hru.
Tak který si tedy máte vybrat
Benchmark odmítá vyhlásit jednoho vítěze, protože správná odpověď není nástroj, ale otázka — kterou ze tří úloh vlastně řešíte?
- Potřebujete Markdown připravený pro LLM? Sáhněte po trafilatuře, pokud chcete čistý text článku; po Crawl4AI, pokud chcete zároveň CSS extrakci i JavaScript rendering v jedné knihovně; a po Firecrawl, pokud chcete konkrétně self-hosted službu a zvládnete licenci AGPL-3.0 i váhu šesti kontejnerů.
- Potřebujete renderovat JavaScript? Pro samotný render použijte Playwright nebo Puppeteer — vybírejte podle enginu a jazyka, protože jinak je to remíza — a Crawlee, když chcete i orchestrace crawlů místo ručního psaní.
- Crawlujete statické stránky nebo opakovatelné API ve velkém? Scrapy pro plnohodnotný Python framework, Colly pro syrovou rychlost v jedné binárce a Scrapling, když je vaším konkrétním a opakovaným problémem odolnost vůči změnám markupů.
Slaďte nástroj s úkolem a každý z nich je obhajitelná volba. Vezměte nástroj ze špatné kategorie — browser tool na statické stránky nebo HTTP parser na JavaScriptovou aplikaci — a ani nejlépe hodnocená knihovna na internetu vás nezachrání.
Kde dává smysl spravované AI API místo toho
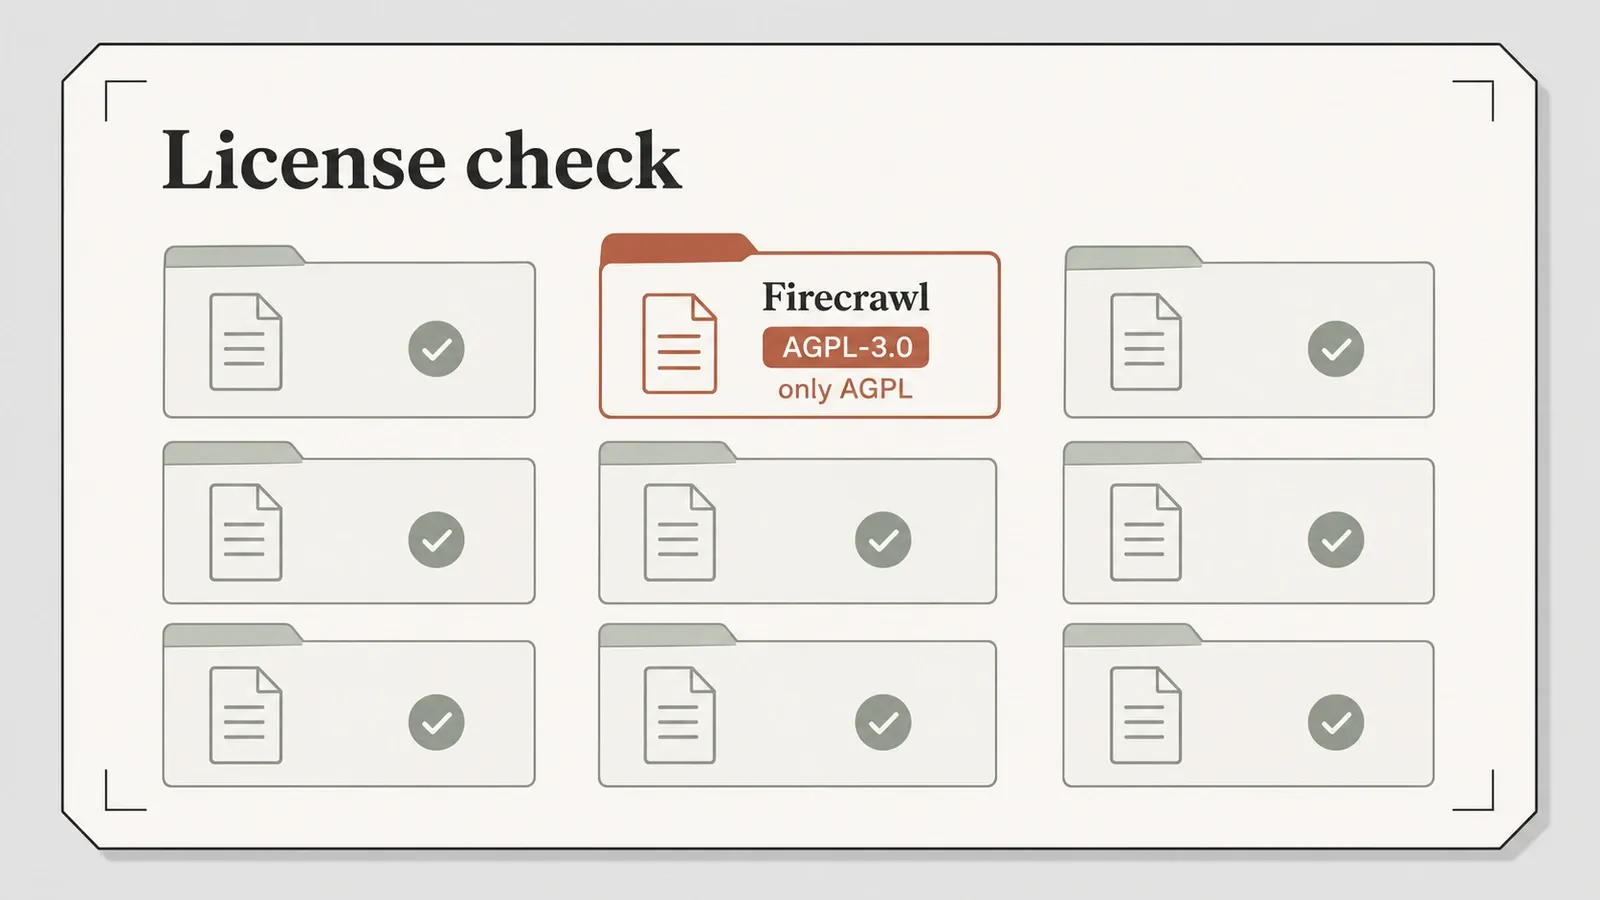
Všechny výše uvedené nástroje jsou zdarma, open-source a můžete je provozovat po svém. Zároveň je to i společný kompromis, který benchmark odhaluje: vlastníte browser prostředí, crawl kód, závod ve zbrojení proti botům i veškerou údržbu. Pro spoustu týmů je přesně tahle kontrola pointa a při rozhodování záleží i na mapě licencí — většina pole je benevolentní (Apache-2.0 u Crawl4AI, Crawlee, Playwright, Puppeteer a Colly; BSD-3 u Scrapy a Scrapling), zatímco self-hosted core Firecrawl s AGPL-3.0 vyžaduje před komerčním použitím skutečnou právní kontrolu.
Ale všimněte si i druhé věci, kterou benchmark ukázal: co tyto nástroje nedělají. Render, crawl, strukturování a obcházení blokací — málokdy všechno najednou a nikdy bez vaší údržby. Spravované AI scraping API tuhle vrstvu zjednoduší na jediný request. Naše vlastní developerská vrstva na Thunderbit je jedna z možností a pro technické publikum jsou podstatné API, MCP server a CLI, ne rozšíření do prohlížeče. POST /distill vrací čistý Markdown a POST /extract vrací JSON definovaný schématem, přičemž JavaScript rendering i anti-bot logiku řeší server, ne váš stroj. Pro agenty a coding asistenty existuje oficiální MCP server — thunderbit_suggest_fields je zdarma pro návrh extrakce, pak thunderbit_distill (1 kredit) a thunderbit_extract (20 kreditů) udělají práci — a k tomu CLI, které můžete spustit přes npx @thunderbit/thunderbit-cli pro terminál a cron joby. Pro netechnické členy týmu je tu také no-code Chrome rozšíření a ceník pokrývá obě roviny.
Kompromis je pořád tentýž, kolem kterého se celý tenhle benchmark točí: provozovat a udržovat až devět knihoven sami bez poplatku za každý request, nebo předat infrastrukturu dál a platit za použití. Ani jedna volba není špatně. Záleží na tom, kolik z toho stacku chcete opravdu vlastnit. Pokud byste raději viděli, jak extrakce vypadá v praxi, Thunderbit YouTube kanál to ukazuje krok za krokem.
Verdikt
Neexistuje jediný nejlepší open-source scraper, a každý seznam, který vám ho sebejistě nabídne, tiše skrývá otázku, která rozhoduje ve skutečnosti: kterou ze tří úloh řešíte? Převést stránku na text, rendrovat JavaScript, nebo crawlovat rychle bez browseru — pole se do těchto kategorií rozpadá čistě a uvnitř každé z nich jde volba hlavně podle jazyka a náročnosti nastavení, ne podle nějakého univerzálního šampiona.
Jestli si z toho máte odnést jeden návyk, tak tenhle: otestujte to na vlastních stránkách, než se pro něco rozhodnete. Každé číslo tady je reprodukovatelné v benchmark repozitáři právě z toho důvodu — protože nástroj, který vede v obecném přehledu, a nástroj, který přežije vaše skutečné cíle, nebývají vždycky ten samý.
Vyzkoušejte Thunderbit pro extrakci webových dat Get Started Free
Často kladené otázky
Jaký je nejlepší open-source web scraper? Neexistuje jeden jediný — záleží na úloze. Pro text připravený pro LLM trafilatura nebo Crawl4AI; pro renderování JavaScriptu Playwright, Puppeteer nebo Crawlee; pro rychlý HTTP crawling Scrapy nebo Colly. Na společném testovacím benchmarku byl každý nástroj nejsilnější ve své kategorii a mimo ni výrazně slabší, což je přesně důvod, proč jednorozměrné žebříčky klamou.
Které open-source scrapery umí renderovat JavaScript? Crawl4AI, Firecrawl, Playwright, Puppeteer a Playwright engine v Crawlee umí JavaScript renderovat. Scrapy, Colly, trafilatura a výchozí HTTP fetcher v Scrapling ne — buď potřebují reprodukovatelné API za stránkou (to je přístup Scrapy, který získal 8/8 z JSON endpointu), nebo samostatný browser režim.
Potřebuji k scrapování webu headless browser? Jen tehdy, když se data objeví až po spuštění JavaScriptu. Pokud se k obsahu dostanete čistým HTTP requestem a parserem, je browser drahý overkill — Scrapy, Colly nebo Scrapling budou v takovém případě mnohem lehčí a rychlejší.
Který z nich má nejpřívětivější licenci pro komerční použití? Většina je benevolentní: Apache-2.0 (Crawl4AI, Crawlee, Playwright, Puppeteer, Colly) nebo BSD-3-Clause (Scrapy, Scrapling). Výjimkou je self-hosted core Firecrawl, který používá AGPL-3.0 a před komerčním produktem si zaslouží skutečnou kontrolu licence.
Jsou tato benchmarková čísla reprodukovatelná? Ano. Každý runner, fixture i surový výsledek jsou ve veřejném repozitáři s MIT licencí. Jediné omezení, které je dobré mít na paměti: recall a strukturální výsledky jsou mezi nástroji srovnatelné, ale absolutní počty znaků platí jen uvnitř daného nástroje, protože každý balíček zrcadlí fixture místo toho, aby sdílel jednu kanonickou kopii — porovnávejte tedy poměry a success/fail, ne surové počty znaků.




