
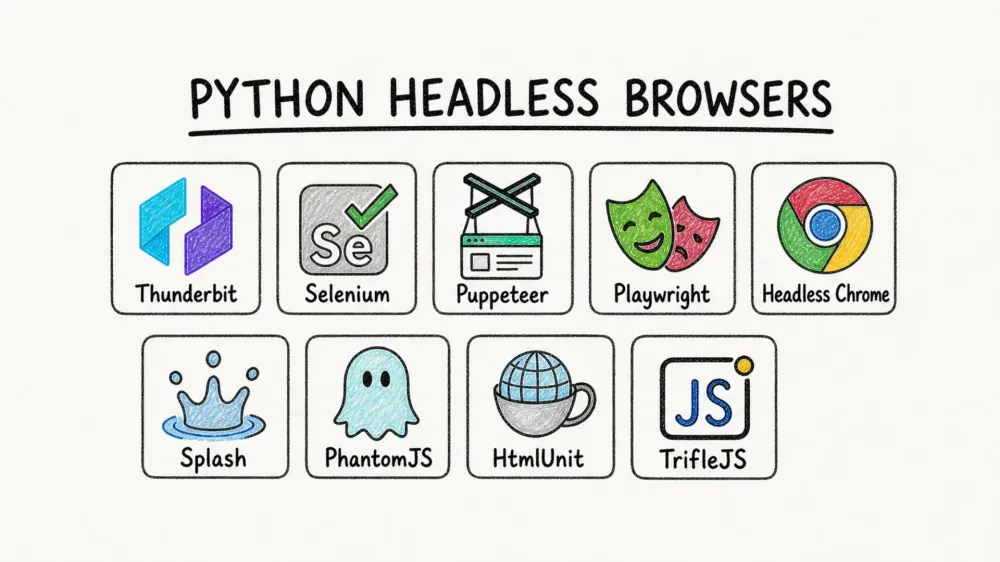
Web se proměnil v divokou, neustále se měnící krajinu — spíš než „digitální knihovnu“ připomíná „datovou džungli“. V roce 2026, pokud se snažíte stahovat data z moderních webů, nestojíte jen proti zdi JavaScriptu — čelíte pevnosti. Na vlastní oči jsem viděl, jak tradiční nástroje pro scraping selhávají pod tlakem dynamického obsahu, nekonečného scrollování a anti-bot ochran. Právě proto není nástup python headless browseru jen trendem — je to plnohodnotná revoluce pro každého, kdo potřebuje spolehlivou a škálovatelnou extrakci webových dat.
A nejde jen o technické nadšence. V roce 2025 73 % firem spoléhá na automatizovanou extrakci webových dat pro business intelligence a více než 94 % webů dnes závisí na vykreslování JavaScriptu na straně klienta. Ať už pracujete v prodeji, ecommerce nebo provozu, správný python headless browser rozhoduje o tom, jestli budete mít „data na dosah ruky“, nebo „data mimo dosah“. Pojďme tedy odříznout hluk kolem — tyto nástroje jsem testoval, porovnával i používal v praxi, a tady rozebírám 10 nejlepších python headless browserů pro moderní scraping (se zvláštním důrazem na to, jak AI mění pravidla hry pro lidi bez programování).
Proč je Python headless browser pro moderní scraping nezbytný?
Získejte data z jakéhokoli webu pomocí AI Get Started Free
Pojďme si vysvětlit terminologii: python headless browser je běžný webový prohlížeč, kterého řídíte pomocí Python kódu, jen bez otravného okna na obrazovce. Načítá stránky, spouští JavaScript, kliká na tlačítka, vyplňuje formuláře — a to všechno neviditelně na pozadí. Představte si ho jako duchovního prohlížeče, který pracuje nonstop, zatímco vy si v klidu pijete kávu.
Proč je to důležité? Protože moderní weby jsou stavěné pro lidi, ne pro boty. Data schovávají za JavaScript, vyžadují přihlášení a čekají, že budete interagovat jako skutečný uživatel. Tradiční scrapery, které jen stáhnou HTML, pak jen bezmocně zírají na prázdnou skořápku. Headless browsery naproti tomu simulují chování reálného uživatele — čekají na AJAX volání, scrollují nekonečné feedy a vytahují obsah přesně tak, jak ho vidíte v Chromu nebo Firefoxu (LiveProxies).
Ale to není všechno:
- Rychlost a efektivita: Headless browsery vynechávají vizuální vykreslování, takže jsou rychlejší a spotřebují méně paměti — ideální pro scraping ve velkém (LiveProxies).
- Podpora dynamického obsahu: Spouštějí JavaScript, takže získáte skutečná vykreslená data, ne jen surové HTML.
- Automatizační superpowers: Potřebujete se přihlásit, procházet stránkování nebo zvládnout pop-upy? Python headless browsery to zvládnou automatizovat.
- Škálovatelnost: Můžete spustit stovky instancí v cloudu, scrapovat tisíce stránek paralelně a vůbec se u toho nezapotit.
Pro firemní uživatele to znamená, že konečně můžete sbírat leady, sledovat konkurenci nebo hlídat ceny — i když je web postavený jako Fort Knox. A s nejnovějšími AI nástroji už k tomu ani nemusíte být programátor.
Jak jsme vybírali nejlepší Python headless browsery
Nevybral jsem je jen tak nahodile z klobouku. Tady je, co jsem sledoval:
- Výkon a rychlost: Zvládne moderní weby náročné na JavaScript rychle a spolehlivě?
- Podpora prohlížečů: Funguje s Chrome, Firefoxem, WebKitem nebo dokonce staršími enginy jako IE?
- Snadnost použití: Je přívětivý pro neprogramátory, nebo potřebujete doktorát z Pythonu?
- AI a no-code funkce: Umí firemní uživatelé využít AI k automatizaci scrapingu bez psaní skriptů?
- Komunita a podpora: Existuje aktivní komunita, dobrá dokumentace a další vývoj?
- Unikátní funkce: Nabízí něco navíc — třeba okamžité šablony, cloud scraping nebo navigaci do podstránek?
Viděl jsem týmy, které týdny zápasily s nastavením, aby nakonec narazily na zeď ve chvíli, kdy se změnilo rozložení webu. Ty nejlepší nástroje nejen fungují — umí se přizpůsobit, škálovat a hlavně vám usnadní život.
Top 10 nejlepších Python headless browserů pro moderní scraping
Tady je můj definitivní seznam, včetně toho, co z každého nástroje dělá hvězdu — nebo naopak slabinu.
1. Thunderbit
 Thunderbit je python headless browser, který jsem si přál mít už před lety. Není to jen nástroj pro automatizaci prohlížeče — je to AI-powered web scraper Chrome Extension vytvořená pro firemní uživatele, kteří chtějí výsledky, ne starosti.
Proč Thunderbit vyniká:
- Nastavení polí pomocí AI: Stačí rozšíření otevřít — jedním kliknutím — a Thunderbit AI pochopí strukturu stránky, vybere pole a scraping spustí za vás (Thunderbit Docs).
- Okamžité datové šablony: Pro populární weby (Amazon, Zillow, LinkedIn aj.) jsou k dispozici šablony na jedno kliknutí — bez nastavování.
- Scraping podstránek a stránkování: Thunderbit umí proklikávat podstránky, zvládá nekonečný scroll a vše sloučí do jedné tabulky.
- Prompty v přirozeném jazyce: Stačí popsat, co chcete, normální angličtinou; zbytek zařídí AI.
- Cloud nebo browser scraping: Scrapy můžete spouštět lokálně nebo v cloudu (až 50 stránek najednou pro vyšší rychlost).
- Bez nutnosti kódování: Vážně — pokud umíte používat prohlížeč, zvládnete i Thunderbit.
- Export dat zdarma: Export do Excelu, Google Sheets, Notion nebo Airtable jedním kliknutím.
Viděl jsem, jak Thunderbit ušetřil hodiny práce sales i ops týmům — při sběru leadů, hlídání cen nebo agregaci produktových dat, a to bez jediného řádku kódu. Na celém světě mu důvěřuje více než 200 000 uživatelů a zpětná vazba je pořád stejná: „Nechápu, jak snadné to je.“
Nejlepší pro: ne-technické uživatele, firemní týmy a každého, kdo chce, aby těžkou práci odvedla AI.
Vyzkoušejte Thunderbit AI Web Scraper zdarma
2. Selenium
 Selenium je klasik mezi automatizací prohlížeče. Pokud jste někdy googlili „python headless browser“, je dost pravděpodobné, že jste narazili na Selenium WebDriver.
Výhody:
- Podpora všech hlavních prohlížečů: Chrome, Firefox, Safari, Edge, a dokonce i Internet Explorer (pro odvážné).
- Obrovská komunita: Spousta tutoriálů, pluginů i odpovědí na Stack Overflow.
- Velká flexibilita: Automatizuje prakticky cokoliv, co by udělal uživatel — kliknutí, formuláře, navigaci.
Nevýhody:
- Nastavení může být opruz: Budete muset řešit ovladače prohlížeče a hlídat synchronizaci verzí.
- Pomalejší než moderní nástroje: WebDriver protokol přidává režii a škálování na stovky prohlížečů je neohrabané.
- Ukecanější API: Napíšete víc kódu než u Playwrightu nebo Puppeteeru.
Nejlepší pro: týmy s existující zkušeností se Selenium, cross-browser testování nebo starší automatizační workflow.
3. Puppeteer
 Puppeteer je vysokou úrovní řízená automatizační knihovna od Googlu pro Chrome/Chromium. Ačkoli je nativně pro Node.js, Python uživatelé se k ní dostanou přes Pyppeteer.
Výhody:
- Optimalizováno pro Chrome: Rychlé, efektivní a pevně propojené s Chrome DevTools.
- Async API: Skvělé pro moderní weby plné JavaScriptu.
- Bohaté funkce: Screenshoty, export do PDF, zachytávání sítového provozu.
Nevýhody:
- Pouze Chromium: Žádná podpora Firefoxu ani Safari.
- Nativně pro Node.js: Python uživatelé musí použít Pyppeteer (který už se ale neudržuje — viz níže).
Nejlepší pro: vývojáře, kteří chtějí rychlou a spolehlivou automatizaci Chromu a nepotřebují podporu více prohlížečů.
4. Playwright
 Playwright je nová hvězda na scéně, vytvořená Microsoftem — a rychle se stal mým oblíbeným nástrojem pro pokročilý scraping.
Výhody:
- Podpora více prohlížečů: Automatizuje Chromium, Firefox i WebKit přes jedno API.
- Automatické čekání: Už žádné hádání, jestli je stránka připravená — Playwright počká za vás.
- Současné běhy: Můžete spouštět více browser contextů paralelně a dosahovat brutální rychlosti.
- Python-first: Nativní Python bindingy, k dispozici async i sync varianta.
Nevýhody:
- Větší instalace: Balí několik prohlížečů, takže setup je o něco těžší.
- Stále je potřeba kódovat: Pro ne-technické uživatele není tak přívětivý jako Thunderbit.
Nejlepší pro: vývojáře, kteří potřebují robustní a moderní automatizaci — zejména pro složité dynamické webové aplikace.
5. Headless Chrome
 Headless Chrome je engine, na kterém stojí mnoho nástrojů výše. Můžete ho ovládat přímo přes Chrome DevTools Protocol (CDP), což dává maximum flexibility.
Výhody:
- Špičková podpora webu: Co funguje v Chromu, funguje i v headless Chromu.
- Detailní kontrola: Přístup ke každému koutku prohlížeče.
Nevýhody:
- Strmá křivka učení: Budete muset mluvit jazykem CDP nebo použít wrapper knihovnu.
- Jen Chrome: Žádná podpora více prohlížečů.
Nejlepší pro: experty, kteří staví vlastní automatizační pipeline nebo integrují Chrome na nízké úrovni.
6. Pyppeteer
 Pyppeteer je neoficiální Python port Puppeteeru. Přinesl do Pythonu async automatizaci Chromu, ale… je tu háček.
Výhody:
- API ve stylu Puppeteeru: Pokud znáte Puppeteer, budete jako doma.
- Rychlá automatizace Chromu: Skvělé pro dynamické weby.
Nevýhody:
- Bez údržby: Původní projekt už se neaktualizuje (vývojáři doporučují přejít na Playwright).
- Pouze Chromium: Žádný Firefox ani Safari.
Nejlepší pro: starší projekty, které už Pyppeteer používají. Pro nové projekty je lepší Playwright.
7. Splash
 Splash je lehký, skriptovatelný headless browser s HTTP API, který vytvořil tým Scrapinghubu (dnes Zyte).
Výhody:
- Lehký: Používá QtWebKit, takže je méně náročný na zdroje než Chrome.
- HTTP API: Můžete ho ovládat z libovolného jazyka, nejen z Pythonu.
- Skvělý pro Scrapy: Plynule se integruje se Scrapy spiderem pro renderování JS.
Nevýhody:
- Starší WebKit engine: Může mít problém s nejnovějším JavaScriptem.
- Nutnost Lua skriptování: Pro pokročilejší interakce se budete muset naučit aspoň trochu Lua.
Nejlepší pro: uživatele Scrapy, kteří potřebují občasné renderování JavaScriptu, nebo lehké server-side rendering úlohy.
8. PhantomJS
 PhantomJS je původní skriptovatelný headless browser postavený na WebKitu. Byl průkopníkem — dnes je ale z velké části zastaralý.
Výhody:
- Jednoduché skriptování: Snadná automatizace pomocí JavaScriptu.
- Podpora starších webů: Stále funguje pro starší statické weby.
Nevýhody:
- Bez údržby: Žádné aktualizace od roku 2016.
- Zastaralý engine: Nezvládá moderní weby s JavaScriptem.
- Bezpečnostní rizika: Žádné nedávné záplaty.
Nejlepší pro: údržbu starých skriptů. Pro nové projekty přejděte na Playwright nebo Puppeteer.
9. HtmlUnit
 HtmlUnit je headless browser v Javě, který simuluje chování prohlížeče. Je rychlý a lehký, ale není to skutečný browser engine.
Výhody:
- Čistě Java: Skvělé do prostředí založených na Javě.
- Rychlý u statických stránek: Není potřeba spouštět plnohodnotný prohlížeč.
Nevýhody:
- Omezená podpora JS: Má problém s moderními dynamickými weby.
- Není nativně pro Python: Vyžaduje integrační vrstvu (např. Selenium HtmlUnitDriver).
Nejlepší pro: Java workflow, testování starších aplikací nebo scraping jednoduchých stránek renderovaných na serveru.
10. TrifleJS
 TrifleJS je headless browser pro Internet Explorer (IE), určený pro automatizaci starších webových aplikací ve Windows.
Výhody:
- Automatizace IE: Zvládá staré intranetové aplikace nebo systémy, které fungují jen v IE.
- API podobné PhantomJS: Pro PhantomJS skripty stačí minimum změn.
Nevýhody:
- Jen pro Windows: Žádná multiplatformní podpora.
- Zastaralý: IE je minulost; TrifleJS je úzce zaměřený a málokdy udržovaný.
Nejlepší pro: specializované legacy workflow, kde je IE automatizace stále nutná.
Srovnávací tabulka funkcí: Python headless browsery v přehledu
| Nástroj | Podpora prohlížečů | Výkon a škálování | Snadnost použití | AI / no-code funkce | Komunita a podpora | Nejlepší pro |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (rozšíření / cloud) | Vysoký (cloud paralelně) | Nejsnazší — bez kódu | Ano (AI, šablony) | Rostoucí, aktivní | Neprogramátory, sales/ops, rychlá extrakce dat |
| Selenium | Všechny hlavní prohlížeče | Střední | Střední (setup) | Ne | Obrovská, vyspělá | Cross-browser, legacy, test automatizace |
| Puppeteer | Chromium / Chrome | Velmi vysoký | Vysoká (pro vývojáře) | Ne | Velká (Node.js) | Jen Chrome, vývojáři, rychlá automatizace |
| Playwright | Chromium, Firefox, WebKit | Velmi vysoký (více kontextů) | Vysoká (pro vývojáře) | Ne | Rychle rostoucí | Pokročilý, více prohlížečů, moderní scraping |
| Headless Chrome | Chrome / Edge | Velmi vysoký | Nízká (ruční CDP) | Ne | N/A (základ) | Vlastní řešení, experti, nízkoúrovňová kontrola |
| Pyppeteer | Chromium / Chrome | Vysoký | Střední (async) | Ne | Malá, bez údržby | Starší Pyppeteer skripty |
| Splash | QtWebKit | Střední | Střední (API / Lua) | Ne | Úzká (Scrapy / Zyte) | Uživatelé Scrapy, lehké renderování JS |
| PhantomJS | WebKit (starý) | Nízký (dnes zastaralý) | Střední (JS) | Ne | Zaniklá | Jen legacy |
| HtmlUnit | Simulované (Java) | Střední / vysoký (statické) | Nízká (Java) | Ne | Malá, zaměřená na Java | Java workflow, jednoduché / statické stránky |
| TrifleJS | Internet Explorer (Trident) | Nízký / střední | Střední (JS, Win) | Ne | Maličká, legacy | Legacy automatizace jen pro IE |
Jak vybrat správný Python headless browser pro vaše podnikání
Co je data scraping a jak na něj v roce 2025 Get Started Free
Tady je můj rychlý tahák, jak vybrat správný nástroj:
- Potřebujete rychlý no-code scraping s pomocí AI? Zvolte Thunderbit. Je to nejjednodušší cesta pro neprogramátory, jak získat spolehlivá data — hlavně pro týmy v sales, ecommerce nebo výzkumu.
- Chcete maximální kontrolu a podporu více prohlížečů? Playwright je nejlepší volba. Je robustní, moderní a připravený na škálování.
- Už jste investovali do Selenium? Zůstaňte u Selenium — pořád je to král pro legacy a multi-browser workflow.
- Budujete Chrome-only automatizaci jako vývojář? Puppeteer (nebo Playwright) je rychlý a výkonný.
- Scrapujete jednoduché statické stránky v Java prostředí? HtmlUnit je lehký a snadno se integruje.
- Udržujete staré skripty nebo aplikace jen pro IE? PhantomJS a TrifleJS jsou vaše poslední záchrana.
A nezapomeňte: nejlepší nástroj je ten, který odpovídá vašemu workflow, dovednostem týmu a obchodním potřebám. Někdy to znamená kombinovat více řešení — Thunderbit pro rychlé úkoly, Playwright pro těžkou práci a Selenium pro starší systémy.
Podívejte se na Thunderbit v akci
Často kladené otázky
1. Co je python headless browser a proč ho potřebuji pro scraping?
Python headless browser je webový prohlížeč, který ovládáte pomocí Python kódu, ale běží neviditelně (bez GUI). Je nezbytný pro scraping moderních webů náročných na JavaScript, protože umí spouštět skripty, pracovat s interakcemi uživatele a extrahovat plně vykreslený obsah — což tradiční HTML scrapery neumí.
2. Který python headless browser je nejlepší pro ne-technické uživatele?
Thunderbit je nejlepší volba pro lidi bez programování. Využívá AI k automatizaci nastavení, nabízí okamžité šablony a umožňuje scrapovat data na jedno kliknutí nebo tím, že AI jednoduše popíšete, jaká data potřebujete — bez psaní kódu.
3. Jak se pro Python uživatele liší Playwright a Puppeteer?
Playwright podporuje více prohlížečů (Chromium, Firefox, WebKit) a má robustní Python bindingy, takže je ideální pro pokročilou automatizaci. Puppeteer je jen pro Chrome a je nativní pro Node.js, ale Python uživatelé mohou použít Pyppeteer (ten je ale už bez údržby). Pro nové Python projekty je lepší Playwright.
4. Je Selenium stále relevantní pro moderní web scraping?
Ano — Selenium se stále hojně používá, zejména pro cross-browser testování a legacy automatizaci. Je ale pomalejší a složitější na nastavení než novější nástroje jako Playwright nebo Thunderbit, a pro scraping ve velkém je méně efektivní.
5. Kdy bych měl používat starší nástroje jako PhantomJS, HtmlUnit nebo TrifleJS?
Jen při údržbě nebo migraci starých workflow. PhantomJS a TrifleJS jsou zastaralé a HtmlUnit je nejlepší pro Java prostředí a jednoduché stránky. Pro nové projekty používejte moderní, aktivně udržované nástroje.
Pokud chcete vidět, jak vypadá moderní scraping poháněný AI, vyzkoušejte Thunderbit. A pokud vás zajímají další hlubší pohledy na webovou automatizaci, podívejte se na Thunderbit Blog. Příjemné scrapování — ať máte data vždy čerstvá a vaše prohlížeče navždy headless.
Vyzkoušejte Thunderbit AI Web Scraper ještě dnes Get Started Free
Zjistěte více



