
Minulý týden mi kolega poslal 47stránkovou smlouvu s dodavatelem a poprosil mě, abych „prostě vytáhl cenové tabulky do spreadsheetu“. Chvíli jsem na to PDF jen zíral, pak jsem ho zavřel a otevřel PDF scraper. Tenhle reflex nevznikl z lenosti — ale z let sledování, jak lidé promarní celé odpoledne bojem s daty z dokumentů, které je zkrátka nechtěly pustit ven.
Čísla tu frustraci jen potvrzují. Průzkum Airbase z roku 2024 mezi 745 finančními profesionály ukázal, že 38 % týmů tráví víc než čtvrtinu celého času ručními úkoly. Zpráva SAP Concur o automatizaci AP navíc uvádí, že 60 % položek faktur do ERP nebo účetních systémů se pořád zadává ručně.
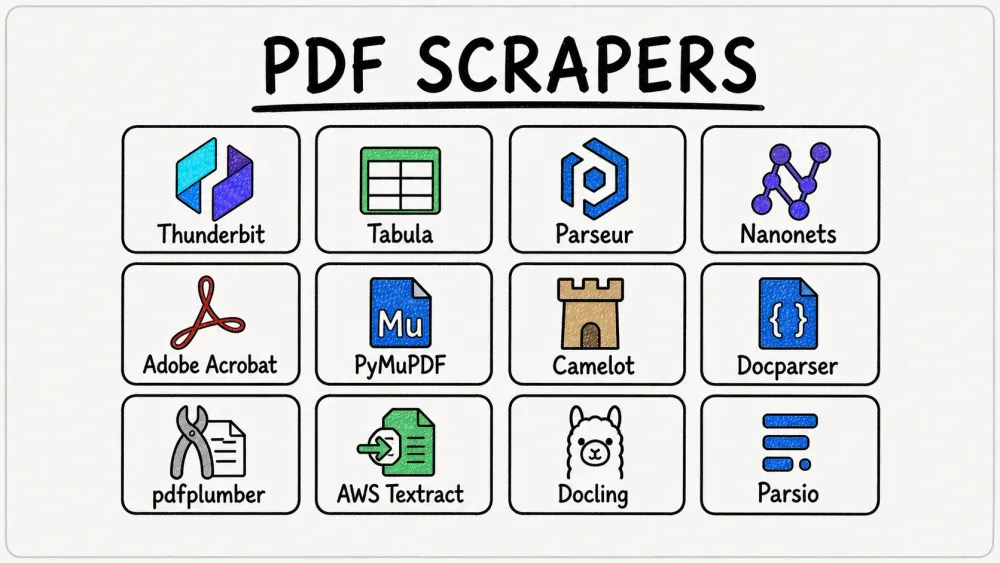
PDF jsou všude — faktury, smlouvy, finanční výkazy, naskenované účtenky — a pořád příliš velká část práce končí u copy-paste. V roce 2026 sahá nabídka PDF scraperů od bezplatných Python knihoven až po AI nástroje bez nutnosti kódování, a špatná volba vás může stát dny místo toho, aby vám je ušetřila. Otestoval jsem 12 nejlepších PDF scraperů podle extrakce tabulek, OCR, ceny a snadnosti použití, abyste si ideální nástroj našli během pár minut.
Co je PDF scraper a proč by vás měl zajímat?
PDF scraper je software, který automaticky extrahuje text, tabulky, pole a strukturovaná data ze souborů PDF. Pokud jste se někdy pokusili zkopírovat tabulku z PDF do Excelu a sloupce se vám slily do jednoho nepřehledného řádku, ten problém už dobře znáte.
PDF scrapery a web scrapery se často pletou, takže rychlé rozlišení je na místě. Web scraper čte HTML, které má aspoň nějakou strukturu — nadpisy, tabulky, divy. PDF scraper vychází z formátu popisu vizuální stránky. Vlastní dokumentace Adobe to říká jasně: PDF je navržený tak, aby zachoval vzhled stránky napříč zařízeními, ne aby poskytoval čistou tabulkovou nebo sémantickou strukturu. Proto copy-paste rozbíjí řádky, sloupce i pořadí čtení.
Kde PDF scraping opravdu šetří čas?
- Zpracování faktur: vytahování názvů dodavatelů, ID faktur, celkových částek, daní a položek
- Finanční reporty: extrakce tabulek z výročních zpráv, výkazů a povinných zveřejnění
- Skenované záznamy: získání kontaktních údajů nebo transakčních dat z PDF, která jsou jen jako obrázky
- Migrace starých archivů: převod starých dokumentů do prohledávatelných, strukturovaných záznamů
Dopad na byznys je mnohem širší než jeden workflow. Gartner pořád uvádí, že nekvalitní data stojí organizace v průměru alespoň 12,9 milionu dolarů ročně. A v únoru 2025 Gartner uvedl, že 63 % organizací buď nemá, nebo si není jistých, že má správné postupy správy dat pro AI. Do roku 2026 podle Gartneru organizace opustí 60 % AI projektů, které nejsou podložené daty připravenými pro AI. Pokud jsou PDF pořád místem, kde žije velká část surových dat, kvalita extrakce dokumentů je přímo propojená s připraveností na AI.
Průzkum Adobe z roku 2025 mezi finančními profesionály zjistil, že 61 % pravidelně upravuje dokumenty založené na PDF a 64 % je pravidelně podepisuje. PDF Association navíc uvádí, že PDF bylo v datech CommonCrawl vyhodnoceno jako 3. nejpopulárnější formát souborů na webu. PDF nikam nemizí.
Jak jsme hodnotili nejlepší PDF scrapery
Než se ponoříme do nástrojů, tady je rámec, který jsem použil. Osm kritérií níže přímo odpovídá problémům, které nejčastěji vídám ve fórech, issue na GitHubu i v recenzích produktů:
| Kritérium | Co měří | Proč je to důležité |
|---|---|---|
| Podporované typy PDF | nativní text, naskenované/jen obrázek, kombinované | Mnoho nástrojů selže ještě před samotnou extrakcí |
| Přesnost extrakce tabulek | jednoduché, bez okrajů, vícestránkové, sloučené buňky | Nejčastější stížnost na PDF extrakci |
| OCR schopnosti | vestavěné, doplněk, nebo žádné | Naskenovaná PDF jsou bez OCR nepoužitelná |
| Výstupní/exportní formáty | Excel, CSV, JSON, Sheets, Notion, API | Data jsou zbytečná, pokud je nelze z nástroje čistě dostat |
| Náročnost nastavení | bez kódu, low-code, nebo code-first | Týmy potřebují velmi rozdílnou úroveň kontroly |
| Cena / free tier | veřejná cena, trial, realistická vstupní úroveň | Cenové modely se výrazně liší |
| Automatizace / integrace | Zapier, API, plánování, webhooks | Ruční exporty se nedají škálovat |
| Nejvhodnější použití | k čemu je nástroj skutečně dobrý | Většina nástrojů není univerzální — jsou vázané na konkrétní workflow |
Aby to bylo přehledné, dělí se 12 nástrojů do tří kategorií: AI scrapery bez kódu, SaaS parsery založené na šablonách a knihovny pro vývojáře / API / open-source nástroje.
12 nejlepších PDF scraperů na první pohled
Tady je hlavní srovnání, abyste si rychle našli svůj profil a mohli přeskočit rovnou na odpovídající část:
| Nástroj | Typ | Extrakce tabulek | Vestavěné OCR | Bez kódu | Free tier | Nejlepší pro |
|---|---|---|---|---|---|---|
| Thunderbit | AI no-code scraper | ✅ AI-powered | ✅ Ano | ✅ Ano | ✅ Free kredity | Business uživatele, různorodé rozvržení |
| Tabula | Open-source desktop | ✅ Dobrá (textové PDF) | ❌ Ne | ✅ GUI | ✅ Plně zdarma | Jednoduché textové PDF s hodně tabulkami |
| Parseur | Hybridní SaaS | ⚠️ Šablona + AI | ✅ Ano | ✅ Ano | ⚠️ Omezený | Opakované zpracování faktur / e-mailů |
| Nanonets | AI IDP SaaS | ✅ Silná | ✅ Ano | ✅ Low-code | ⚠️ Zkušební kredity | Automatizace dokumentů ve velkém |
| Adobe Acrobat | Sada pro práci s PDF | ⚠️ Základní | ✅ Ano | ✅ Ano | ❌ Export je placený | Občasný převod PDF do Excelu |
| PyMuPDF | Python knihovna | ⚠️ Ruční parsování | ❌ Ne (Tesseract volitelně) | ❌ Vyžaduje kód | ✅ Plně zdarma | Vývojáři, textově bohatá PDF |
| Camelot | Python knihovna pro tabulky | ✅ Silná (lattice + stream) | ❌ Ne | ❌ Vyžaduje kód | ✅ Plně zdarma | Vývojáři, složité tabulky |
| Docparser | Template SaaS | ⚠️ Na šablonách | ✅ Ano | ✅ Ano | ⚠️ Trial | Opakované dokumenty + Zapier workflow |
| pdfplumber | Python knihovna | ✅ Dobrá (jemná kontrola) | ❌ Ne | ❌ Vyžaduje kód | ✅ Plně zdarma | Vývojáři, detailní kontrola |
| AWS Textract | Cloud API | ✅ Silná | ✅ Ano | ❌ Vyžaduje API | ⚠️ Omezený free tier | Enterprise pipeline |
| Docling | Open-source Python | ✅ Dobrá | ✅ Přes integraci | ❌ Vyžaduje kód | ✅ Plně zdarma | LLM/RAG pipeline |
| Parsio | Hybridní SaaS | ⚠️ S podporou AI | ✅ Ano | ✅ Ano | ⚠️ Omezený | Opakované typy dokumentů |
Chcete co nejmenší nastavení? Začněte u no-code nebo SaaS řádků. Potřebujete maximální kontrolu? Podívejte se na řádky pro vývojáře. Pracujete se skenovanými PDF? Vyřaďte vše, co má OCR = Ne.
1. Thunderbit
 Thunderbit je PDF scraper, který bych dal komukoli, kdo řekne „jen z toho PDF potřebuji dostat data“ a nechce poslouchat nic o Pythonu, šablonách nebo API klíčích. Je to AI agent na webová data — rozšíření do Chromu — který čte PDF, obrázky i weby a vrací strukturovaná data. Žádné šablony, žádné programování.
Thunderbit jsme postavili pro situaci, která potrápí většinu nástrojů: dostanete PDF od pěti různých dodavatelů, každé má trochu jiné rozvržení, a vy z nich potřebujete stejná pole. AI si každý dokument přečte znovu od začátku, přes funkci „AI Suggest Fields“ navrhne názvy sloupců i datové typy a data vytáhne do strukturované tabulky. Vestavěné OCR si poradí se skenovanými PDF i obrázky nativně a podporuje 34 jazyků.
Klíčové funkce:
- One Click Extract rozpozná sloupce a datové typy z jakéhokoli rozvržení PDF — bez ruční konfigurace
- Vestavěné OCR pro skenovaná PDF a obrázky
- Exporty do Excelu, Google Sheets, Airtable, Notion, CSV a JSON — vše zdarma
- AI označování a přeformátování: AI umí při extrakci data překládat, kategorizovat nebo přestavět, ne až dodatečně
- Extrakce tabulek čte rozložení vizuálně (jako člověk), takže si poradí i s tabulkami bez okrajů, nepravidelnými i multi-vendor formáty
Jak scrapovat PDF pomocí Thunderbit:
- Nainstalujte Thunderbit Chrome Extension
- Otevřete nebo nahrajte PDF v prohlížeči
- Klikněte na „One Click Extract“ — AI dokument přečte a určí názvy sloupců i typy
- Klikněte na „Scrape“ — data se vytáhnou do strukturované tabulky
- Exportujte do Google Sheets, Excelu, Airtable, Notion, CSV nebo JSON
Cena: Free tier s kredity (cca 6 stránek zdarma, 10 se zkušební verzí). Starter plán zhruba od 15 USD měsíčně nebo asi 9 USD měsíčně při roční fakturaci. Kredity jsou účtované podle řádků (1 kredit = 1 výstupní řádek). Podrobnosti najdete na Thunderbit Pricing.
Nejlepší pro: Neteknické uživatele, kteří pracují s různým rozvržením PDF (faktury od více dodavatelů, reporty v různých formátech) a chtějí výsledky jedním kliknutím.
Výhody: Nejjednodušší nastavení v tomto seznamu; vestavěné OCR; přímý export do Sheets, Notion, Airtable a Excelu; funguje na různých rozvrženích bez šablon.
Nevýhody: Účtování podle kreditů chvíli trvá, než si ho člověk přepočítá na cenu za stránku; méně recenzí třetích stran než u větších SaaS vendorů.
Vyzkoušejte Thunderbit pro PDF scraping Nahrajte faktury od pěti různých dodavatelů a nechte AI, ať si pro každé rozvržení sama určí sloupce — bez nastavování šablon po jednom. Get Started Free
2. Tabula
 Tabula je klasická bezplatná odpověď na extrakci tabulek z textových PDF a zároveň je na ní jasně vidět, že jde o starší projekt. V repozitáři se píše, že běží jako dobrovolnický projekt, a desktopová aplikace pravděpodobně už neuvidí aktualizace v dohledné době. Nejnovější desktop verze je pořád 1.2.1 z roku 2018, zatímco tabula-java naposledy vydala 1.0.5 v roce 2021.
Klíčové funkce:
- GUI typu point-and-click pro výběr oblastí tabulky
- Běží lokálně — data nikdy neopustí váš počítač
- Žádný účet, předplatné ani registrace
Cena: Úplně zdarma navždy. Open source.
Nejlepší pro: Uživatelé s jednoduchými textovými PDF a jasně ohraničenými tabulkami, kteří chtějí bezplatné lokální řešení.
Výhody: Zdarma; lokální; velmi jednoduché pro základní tabulky.
Nevýhody: Žádné OCR (skenované PDF jsou nepoužitelná); slabší u tabulek bez okrajů; žádná automatizace ani API; žádná cloudová varianta; v praxi už bez aktivního rozvoje.
3. Parseur
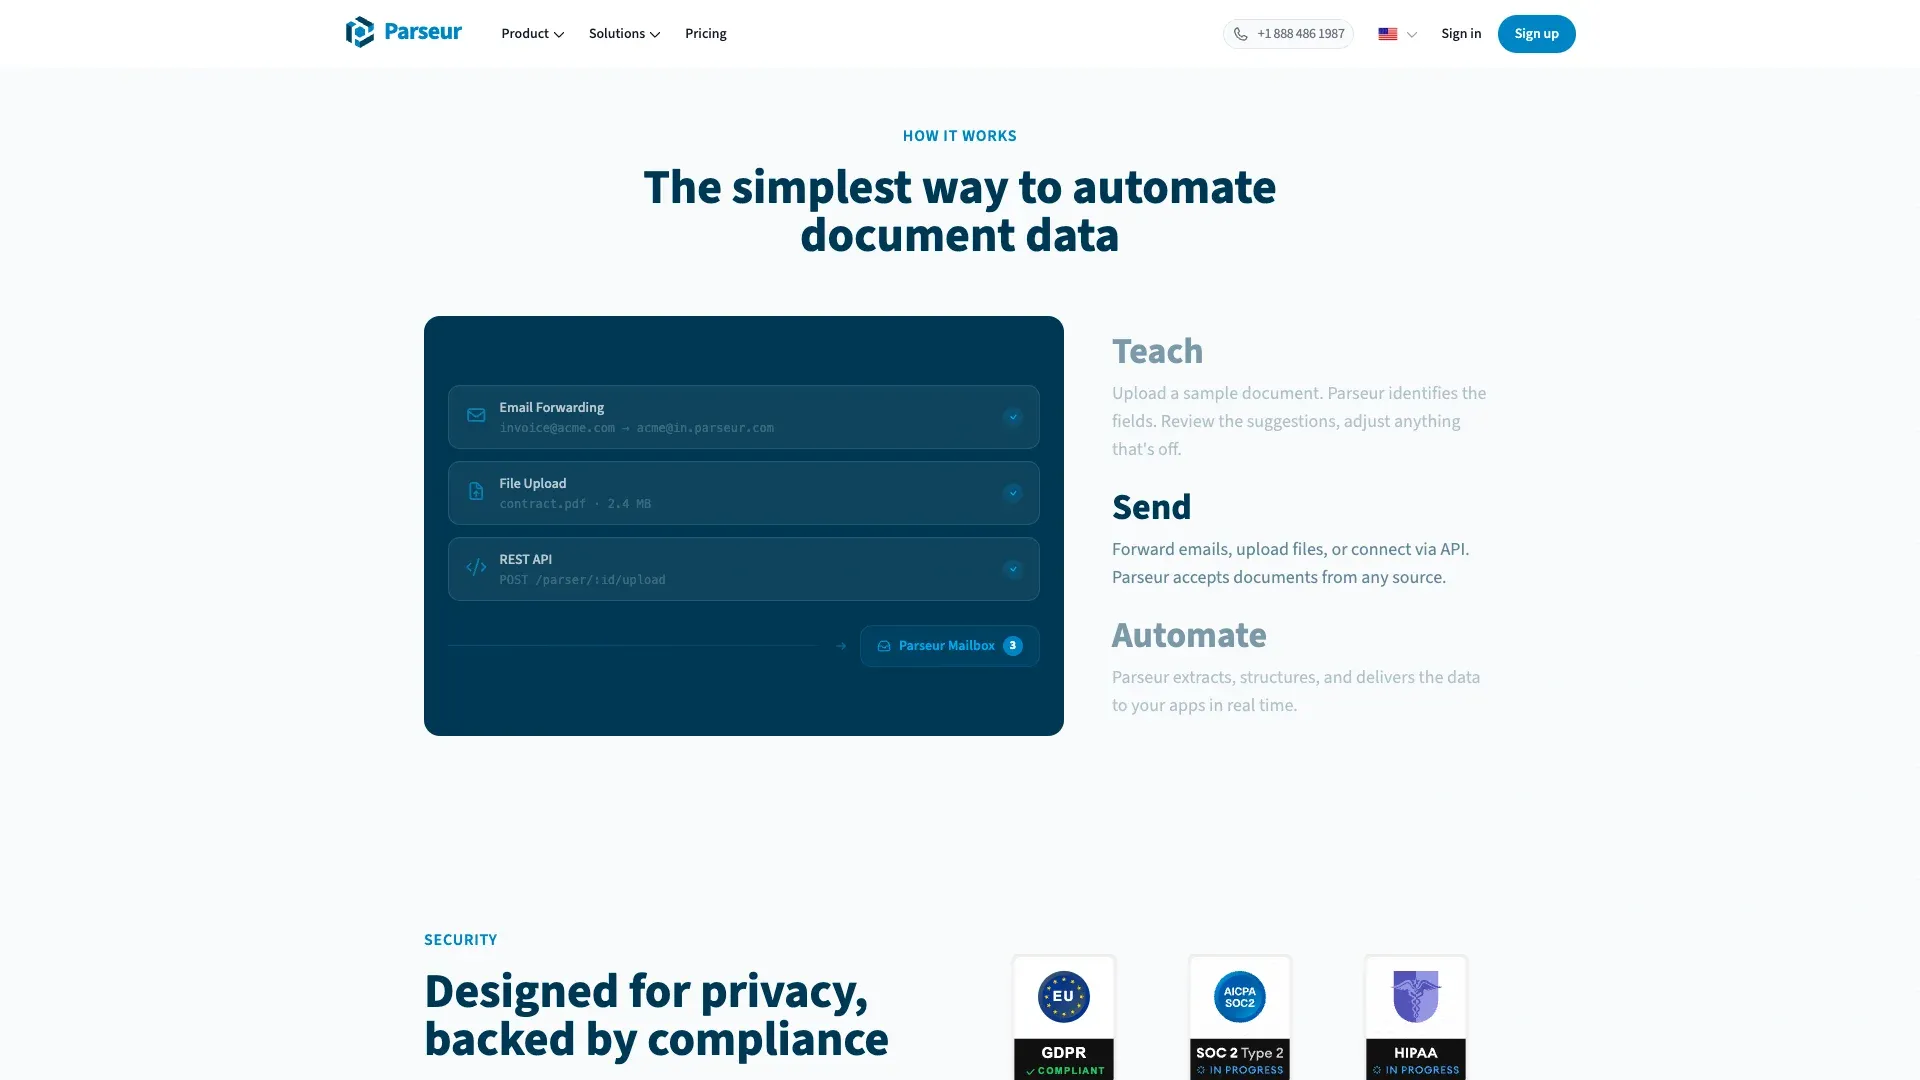 Parseur je nejsilnější hybrid v kategorii SaaS, protože kombinuje AI parsing, šablonový parsing a dynamické OCR. Díky tomu je flexibilnější než čistě zónový parser, ale pořád strukturovanější než plně obecný AI scraper.
Klíčové funkce:
- Vestavěné OCR s podporou 60+ jazyků (160+ experimentálně)
- Integrace se Zapier, Make, Power Automate, API, webhooks, Google Sheets
- Dobře sedí na faktury, dodací listy, potvrzení objednávek a opakující se typy dokumentů
Cena: Free tier přibližně 20 stránek měsíčně. Nejnižší samoservisní placená úroveň kolem ~39 USD/měsíc. Normalizovaná cena na nejmenším plánu vychází zhruba na 390 USD za 1 000 stránek, ale při vyšším objemu klesá efektivní sazba.
Nejlepší pro: Týmy, které dostávají opakovaně stejné typy dokumentů a chtějí automatizaci bez programování.
Výhody: Vestavěné OCR; silný automatizační stack; dobře zvládá opakující se rozvržení.
Nevýhody: Každé nové nebo měnící se rozvržení může vyžadovat práci se šablonou nebo fallback na AI; složité tabulky zůstávají náročnější.
4. Nanonets
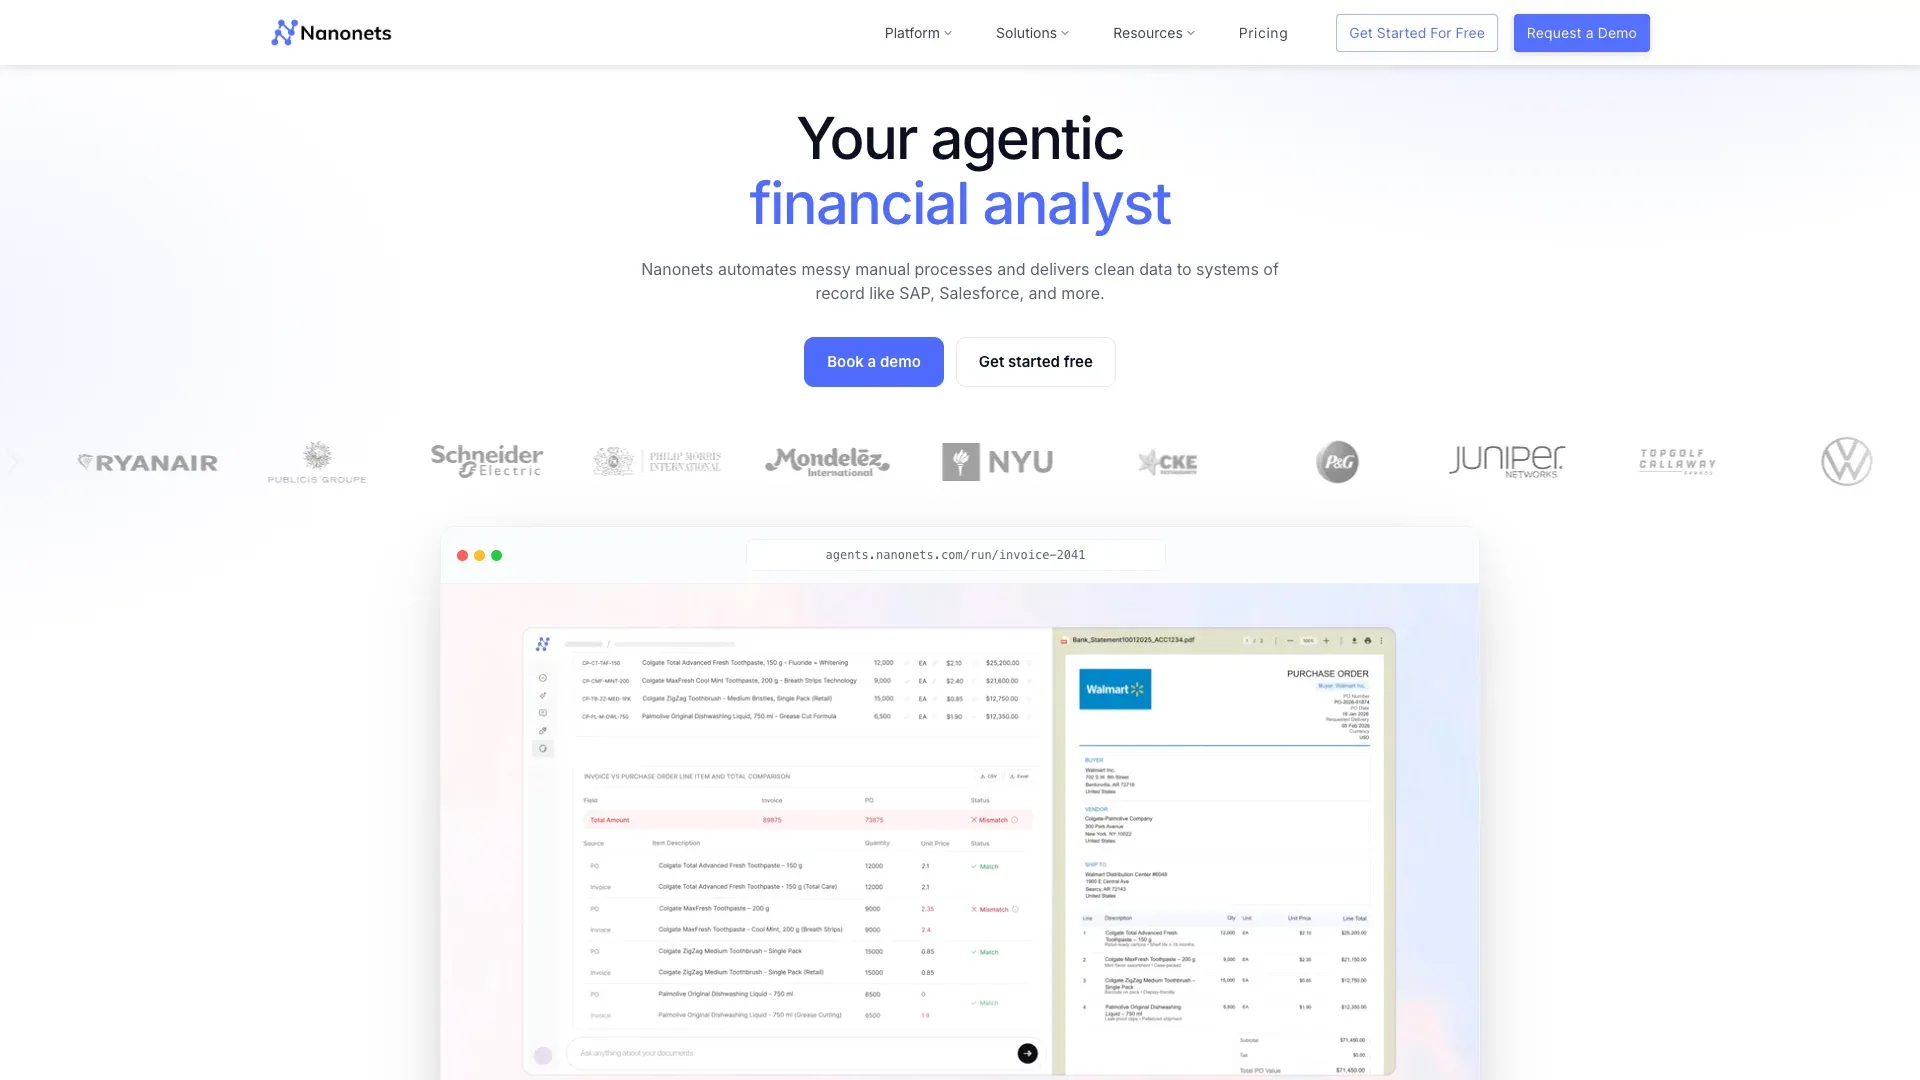 Nanonets je spíš platforma pro inteligentní zpracování dokumentů (IDP) než jednoduchý PDF scraper — a to je zároveň jeho síla i složitost. Společnost změnila ceny 31. ledna 2025 a přešla na předplacené usage kredity místo jednoduchého modelu podle stran.
Klíčové funkce:
- Extrakce tabulek a detekce polí pomocí AI
- Vestavěné OCR s podporou 40+ jazyků
- Automatizace workflow s kroky schvalování
- Široký enterprise integrační stack
Cena: Kredity při registraci. Účtování podle spotřeby. Hrubý odhad podle veřejných dokumentů s blokovou cenou je zhruba 300–380 USD za 1 000 stránek u jednoduchého workflow extrakce.
Nejlepší pro: Středně velké až velké týmy zpracovávající tisíce dokumentů měsíčně (automatizace AP, logistika, pojistné události).
Výhody: Silná AI extrakce; enterprise integrace; automatizace workflow.
Nevýhody: Cena se hůř předvídá; vyšší křivka učení pro pokročilé workflow; omezený free tier.
5. Adobe Acrobat
 Adobe Acrobat je základní PDF nástroj, který zná skoro každý. Je silný v OCR a konverzi, ale v tomhle seznamu není úplně scraper v tom samém smyslu jako ostatní nástroje.
Klíčové funkce:
- Vestavěné OCR v Pro
- Export do Wordu, Excelu, PowerPointu, HTML, TXT a obrazových formátů
- Široká vícejazyčná podpora OCR
Cena: Acrobat Standard za 14,99 USD/měsíc; Acrobat Pro za 19,99 USD/měsíc. Reader je zdarma, ale exportní funkce vyžadují placený plán.
Nejlepší pro: Uživatelé, kteří jen občas potřebují převést PDF do Wordu nebo Excelu a už mají předplatné Adobe.
Výhody: Široce důvěryhodný; vestavěné OCR; mnoho lidí ho už má.
Nevýhody: Extrakce tabulek je u složitých rozvržení základní; žádná automatizace ani API pro dávkové zpracování; není navržený jako „scraper“.
6. PyMuPDF
 PyMuPDF (známý také jako „fitz“) zůstává v tomhle přehledu nejrychlejší univerzální Python knihovnou pro extrakci PDF. Aktuální verze je 1.27.2.2 z března 2026 a benchmarky dál ukazují, že je výrazně rychlejší než mnoho jiných Python PDF knihoven.
Klíčové funkce:
- Extrémně rychlá extrakce surového textu
- Extrakce obrázků a přístup k metadatům
- Volitelné OCR přes Tesseract (dokumentace ale uvádí, že OCR je asi 1 000× pomalejší než standardní extrakce)
- Detekce tabulek přes
find_tables()
Cena: Úplně zdarma, open source.
Nejlepší pro: Vývojáře stavějící pipeline, kteří hlavně pracují s textově bohatými nativními PDF.
Výhody: Velmi rychlý; lehký; aktivní komunita; silná extrakce textu.
Nevýhody: Žádné vestavěné OCR; extrakce tabulek vyžaduje ruční parsovací logiku; nutný kód.
7. Camelot
 Camelot je pořád jeden z nejznámějších Python nástrojů pro extrakci tabulek, protože je primárně zaměřený na tabulky, ne na dokumenty obecně. Současný repozitář je udržovaný a verze 1.0.9 vyšla v srpnu 2025.
Klíčové funkce:
- Dva režimy extrakce:
latticepro tabulky s okraji,streampro tabulky bez okrajů / založené na mezerách - Metrix přesnosti v parsing reportu — jedna z nejužitečnějších funkcí Camelotu pro automatizační workflow
- Výstup do pandas DataFrames, CSV, JSON a Excelu
Cena: Úplně zdarma, open source.
Nejlepší pro: Vývojáře, kteří potřebují přesnou extrakci tabulek ze strukturovaných textových PDF.
Výhody: Výborná přesnost tabulek; dva režimy extrakce; hodnocení přesnosti.
Nevýhody: Žádné OCR; jen textová PDF; nutný kód; u velkých dokumentů může být pomalý.
8. Docparser
 Docparser je ze všech nástrojů v tomhle seznamu nejvíc řízený pravidly. Používá zónové OCR, kotvící klíčová slova a parsovací pravidla pro pevné rozvržení místo toho, aby se snažil chovat jako obecný AI čteč dokumentů.
Klíčové funkce:
- Vestavěné OCR
- Integrace se Zapier, Workato, Power Automate, Google Sheets, Salesforce a REST API
- Dobře funguje pro předávání extrahovaných dat do firemních workflow
Cena: Starter za 39 USD/měsíc; Professional za 74 USD/měsíc; Business za 159 USD/měsíc. 14denní trial zdarma. Účtuje se podle dokumentu, takže normalizovaná cena za 1 000 stran závisí na délce dokumentu — zhruba 78–390 USD v nejnižší úrovni.
Nejlepší pro: Týmy, které chtějí automatizovat opakované dokumentové workflow s pevným napojením na nástroje jako Zapier nebo Salesforce.
Výhody: Vestavěné OCR; silné workflow integrace; vhodné pro stabilní rozvržení.
Nevýhody: Založené na šablonách — každé nové rozvržení vyžaduje nastavení; extrakce tabulek závisí na definici zón; nejsilnější na první stránce.
9. pdfplumber
 pdfplumber zůstává v této skupině nejdetailnější vývojářskou knihovnou. Aktuální verze je 0.11.9 z ledna 2026 a repozitář uvádí, že je aktivně vyvíjen.
Klíčové funkce:
- Jemná kontrola nad znakových objektech, čarami, obdélníky a strategiemi hledání tabulek
- Filtrování podle ořezu a vizuální debugging
- Výstup dat jako Python listy/dict pro snadnou manipulaci
Cena: Úplně zdarma, open source.
Nejlepší pro: Python vývojáře, kteří potřebují jemně nastavitelnou logiku extrakce tabulek.
Výhody: Výborná nízkoúrovňová kontrola; dobrá přesnost u složitých tabulek; aktivní vývoj.
Nevýhody: Žádné OCR; strmější křivka učení než Camelot; nutný kód.
10. AWS Textract
 AWS Textract je v tomhle seznamu nejvíc enterprise API. Je stavěný na škálování, různorodé dokumenty a programové použití, ne na pohodlí GUI.
Klíčové funkce:
- Extrakce tabulek a formulářů poháněná AI
- Vestavěné OCR s podporou rukopisu (v tomhle seznamu nejblíž, ale pořád ne dokonalé)
- Škálovatelnost na enterprise úrovni
- Čistá integrace do ekosystému AWS
Cena: Účtování podle stránek. Free tier: 1 000 stran měsíčně po dobu 3 měsíců. Poté: OCR jen pro text za 1,50 USD / 1 000 stránek; tabulky za 15 USD / 1 000 stránek; formuláře + tabulky za 65 USD / 1 000 stránek; expense dokumenty za 10 USD / 1 000 stránek.
Nejlepší pro: Enterprise týmy zpracovávající 10 000+ dokumentů měsíčně přes API pipeline.
Výhody: Přesná extrakce formulářů a tabulek; vestavěné OCR; enterprise škálování.
Nevýhody: Jen API; žádné vizuální rozhraní; náklady u pokročilých režimů rychle rostou; vendor lock-in v ekosystému AWS.
11. Docling
 Docling je tady nejvíc budoucí open-source nástroj, protože je přímo zaměřený na pipeline z dokumentů do LLM. Aktuální verze je 2.90.0 z 17. dubna 2026 a projekt se pohybuje hodně rychle.
Klíčové funkce:
- Výstup do Markdownu, HTML, WebVTT, DocTags a bezztrátového JSON
- Podpora OCR přes více integrovaných enginů
- Navržený pro LangChain, LlamaIndex, CrewAI, Haystack a podobné ekosystémy
- Silný růst komunity
Cena: Úplně zdarma, open source.
Nejlepší pro: Vývojáře stavějící LLM/RAG aplikace, kteří potřebují převést PDF do strukturovaného Markdownu připraveného pro AI.
Výhody: Čistý výstup v Markdownu; OCR přes integraci; stavěný pro moderní AI workflow; aktivní vývoj.
Nevýhody: Nutný kód; primárně zaměřený na vývojáře; méně vyladěné GUI nebo exporty než u SaaS nástrojů.
12. Parsio
 Parsio je hybridní SaaS parser, který kombinuje šablony, OCR, AI parsing a parsing s GPT. Pocitově stojí někde mezi Parseurem a Docparserem: je flexibilnější než čistě zónové řešení, ale pořád optimalizovaný pro opakované příchozí dokumenty.
Klíčové funkce:
- Vestavěné OCR
- AI asistovaná detekce polí
- Integrace s Google Sheets, webhooks, API, Zapier, Make, n8n a Pabbly
Cena: Sandbox s 30 kredity. Starter za 41 USD/měsíc pro 1 000 kreditů; Growth za 124 USD/měsíc; Business za 249 USD/měsíc. Jeden zpracovaný dokument nebo stránka PDF může stát 1, 2 nebo 5 kreditů podle režimu parseru, takže normalizovaný odhad na Starter plánu vychází zhruba na 41–205 USD za 1 000 stránek.
Nejlepší pro: Malé až střední týmy, které zpracovávají opakující se typy dokumentů (faktury, účtenky) a chtějí no-code SaaS řešení s lehkou AI podporou.
Výhody: Vestavěné OCR; široké pokrytí typů dokumentů; široký automatizační stack.
Nevýhody: Málo nezávislých recenzí; ceny jsou v různých režimech méně transparentní; není tak jasně vymezený jako Parseur nebo Nanonets.
Souboj extrakce tabulek: jak si nejlepší PDF scrapery poradí s reálnými tabulkami
Extrakce tabulek je zdaleka nejdiskutovanější bolestivé místo u PDF scraperů — a právem. Nedávné benchmarky jako OmniDocBench (1 651 stran přes 10 typů dokumentů) a akademická práce o exktrakci heterogenních tabulek potvrzují, že „extrace tabulek“ není jedna jediná úloha. Je to celé spektrum.
Jednoduché tabulky (jasné okraje, jedna stránka)
Tady většina nástrojů funguje dobře. Tabula, Camelot, pdfplumber, Thunderbit i AWS Textract si vedou solidně. Pokud vaše PDF obsahují jen jednoduché tabulky s okraji, bude fungovat skoro kterýkoli nástroj z tohoto seznamu.
Tabulky bez okrajů a založené na mezerách
Tady se rozdíl začne ukazovat výrazněji. Bez čar parsování založené na pravidlech hůř rozpoznává hranice sloupců. Režim stream v Camelotu a vlastní ladění parametrů v pdfplumber jsou silné pro vývojáře, kteří si mohou nastavení doladit. AI nástroje jako Thunderbit, Nanonets a AWS Textract interpretují rozvržení vizuálně, což většinou funguje lépe pro netechnické uživatele s nekonzistentními formáty.
Tabulky roztažené přes více stran
Častý bod selhání. Nástroje založené na šablonách a jednoduché extraktory často berou každou stránku jako samostatnou tabulku, pokud workflow výslovně nepropojí pokračování. AI-first nástroje mají výhodu, protože dokážou kontinuitu interpretovat sémanticky, ne jen geometricky — i když žádného vendora není radno považovat za dokonalého v této kategorii problému.
Sloučené buňky a vnořené hlavičky
Nejtěžší scénář. Studie EMNLP 2024 o extrakci heterogenních tabulek uvádí F1 v rozmezí 74,2 až 96,1 podle metody a scénáře. AI nástroje (Thunderbit, Nanonets, AWS Textract) zde obvykle překonávají parsery založené na pravidlech, protože interpretují rozvržení sémanticky místo spoléhání na čáry a hranice.
Porovnání OCR: které PDF scrapery zvládají skenované dokumenty?
OCR je hranice mezi nástroji, které zvládnou skutečná firemní PDF, a nástroji, které zvládnou jen ideální strojově generované dokumenty. Tady je matice:
| Nástroj | Nativní OCR | Podpora skenovaných PDF | Vícejazyčné OCR | Podpora rukopisu |
|---|---|---|---|---|
| Thunderbit | ✅ Vestavěné | ✅ Ano | ✅ 34 jazyků | ⚠️ Omezená |
| Adobe Acrobat | ✅ Vestavěné | ✅ Ano | ✅ Silná | ⚠️ Omezená |
| AWS Textract | ✅ Vestavěné | ✅ Ano | ✅ Více hlavních jazyků | ✅ Nejblíž, ale ne dokonalé |
| Nanonets | ✅ Vestavěné | ✅ Ano | ✅ 40+ jazyků | ⚠️ Omezená |
| Parseur | ✅ Vestavěné | ✅ Ano | ✅ 60+ jazyků | ❌ Ne |
| Parsio | ✅ Vestavěné | ✅ Ano | ✅ Vícejazyčné | ⚠️ Omezená |
| Docparser | ✅ Vestavěné | ✅ Ano | ✅ Ano | ⚠️ Omezená |
| Docling | ✅ Přes integraci | ✅ Ano | Záleží na enginu | ⚠️ Omezená |
| Tabula | ❌ Žádné | ❌ Ne | N/A | N/A |
| PyMuPDF | ❌ Ne (Tesseract volitelně) | ❌ Vyžaduje doplněk | Záleží na enginu | Záleží na enginu |
| Camelot | ❌ Žádné | ❌ Ne | N/A | N/A |
| pdfplumber | ❌ Žádné | ❌ Ne | N/A | N/A |
Žádný nástroj v roce 2026 spolehlivě nezvládá rukopis ve všech případech. AWS Textract je k tomu nejblíž mezi enterprise API, ale rukopis pořád zůstává funkcí typu „používat opatrně“. Pokud jsou vaše PDF naskenovaná, ale strojově psaná, dobře vám poslouží jakýkoli nástroj s vestavěným OCR. Pokud jsou ručně psaná, nastavte si realistická očekávání.
AI-powered vs. rule-based vs. template-based: tři generace PDF scrapingu
Nejjednodušší způsob, jak pochopit trh s PDF scrapery v roce 2026, je rozdělit ho do tří generací:
Generace 1: Rule-based (Tabula, Camelot, pdfplumber)
Fungují nejlépe na strukturovaných textových PDF s konzistentním rozvržením. Pro vývojáře jsou silné, ale když se rozvržení mění, snadno se rozbijí. Pokud jsou vaše dokumenty předvídatelné, jsou pořád výborné — a zdarma.
Generace 2: Template-based (Parseur, Docparser, Parsio)
Uživatelé definují zóny nebo pole pro každý typ dokumentu. Skvělé pro opakující se formáty, třeba faktury od stejného dodavatele. Háček je jasný: každé nové rozvržení nebo změna rozvržení vyžaduje nastavení nebo údržbu.
Generace 3: AI/LLM-powered (Thunderbit, Nanonets, AWS Textract, Docling pro LLM pipeline)
AI čte dokument sémanticky, přizpůsobí se novým rozvržením bez šablon a zároveň umí data označit i transformovat. Tímhle směrem trh míří. Everest Group 2025 IDP assessment i ACL 2025 výzkum multimodálních tabulek ukazují na extrakci založenou na LLM a agentech jako na další standard.
Pro netechnické uživatele je to prakticky zásadní: pokud PDF přicházejí z mnoha různých zdrojů (dodavatelé, partneři, klienti), nástroje založené na šablonách se rychle promění v údržbovou zátěž. AI nástroje zvládají rozmanitost hned od začátku. To je přesně prostor, pro který byl Thunderbit postaven — business uživatele s různorodými PDF a nulovým zájmem psát Python nebo udržovat extrakční šablony.
AI PDF scraping pro různá rozvržení Jedno schéma nemusí sedět na každého dodavatele — AI si každý dokument přečte a sama určí jeho strukturu. Get Started Free
Rozpad cen: kolik nejlepší PDF scrapery ve skutečnosti stojí
Tohle je srovnání, které nikdo jiný běžně nezveřejňuje, a přitom je to přesně to, na co se uživatelé ptají nejčastěji. Tady je upřímný pohled:
| Nástroj | Free tier | Startovací placená cena | Odhad ceny za 1 000 stran | Open source? |
|---|---|---|---|---|
| Thunderbit | ✅ Free kredity | ~$15/měs. ($9/měs. ročně) | ~$18–$30 | Ne |
| Tabula | ✅ Neomezeně | Navždy zdarma | $0 | Ano |
| Camelot | ✅ Neomezeně | Navždy zdarma | $0 | Ano |
| PyMuPDF | ✅ Neomezeně | Navždy zdarma | $0 | Ano |
| pdfplumber | ✅ Neomezeně | Navždy zdarma | $0 | Ano |
| Docling | ✅ Neomezeně | Navždy zdarma | $0 | Ano |
| Parseur | ⚠️ ~20 stran/měs. | ~$39/měs. | ~$390 (nejnižší úroveň) | Ne |
| Nanonets | ⚠️ Kredity při registraci | Účtování podle spotřeby | ~$300–$380 | Ne |
| Docparser | ⚠️ 14denní trial | $39/měs. | ~$78–$390 | Ne |
| Parsio | ⚠️ 30 kreditů | $41/měs. | ~$41–$205 | Ne |
| Adobe Acrobat | ❌ (export je placený) | $19,99/měs. Pro | Neúčtuje se podle stran | Ne |
| AWS Textract | ⚠️ 1 000 stran/měs. (3 měsíce) | Platba podle použití | $1,50–$65 | Ne |
Skrytý trade-off je důležitější než cenovka. Open-source Python nástroje jsou zdarma v dolarech, ale stojí čas vývojářů na nastavení, údržbu a ladění. SaaS nástroje založené na šablonách jsou jednoduché při nízké variabilitě, ale drahé, když se rozvržení mění. AI no-code nástroje jako Thunderbit stojí kredity za řádek, ale dramaticky zkracují čas nastavení. Cloud API jako AWS Textract jsou při velkém objemu nejlevnější — ale jen když už máte připravené engineeringové zázemí.
Když přemýšlím o „skutečné ceně“, počítám do toho i mzdu člověka, který na tom pracuje. Hodina práce datového analytika strávená nastavováním šablon nebo psaním Pythonu není zadarmo, i když je software zdarma.
Který PDF scraper si vybrat?
Tady je rychlý rozhodovací přehled:
| Vaše situace | Doporučený nástroj / nástroje |
|---|---|
| Netechnický uživatel, různá rozvržení PDF, potřebujete rychlé výsledky | Thunderbit, Nanonets |
| Opakující se faktury/účtenky ve stejném formátu | Parseur, Docparser, Parsio |
| Vývojář budující datovou pipeline | PyMuPDF, Camelot, pdfplumber |
| Enterprise, 10 000+ dokumentů měsíčně, potřebujete API | AWS Textract, Nanonets |
| Stavíte LLM/RAG aplikaci | Docling |
| Občasný převod PDF do Excelu, už máte Adobe | Adobe Acrobat |
| Zdarma, lokálně, zaměřené na tabulky, bez programování | Tabula |
Pokud jste business uživatel a chcete jen dostat data z PDF bez programování nebo nastavování šablon, začněte s Thunderbit. Každé PDF čte AI znovu od začátku a exportuje data do nástrojů, které už používáte. Pokud máte dokumenty s opakujícím se rozvržením, lepší volbou bývá Parseur nebo Docparser. A pokud chcete maximální kontrolu, open-source stack je pořád cenové minimum.
Závěr
PDF scraping v roce 2026 už není jeden problém s jednou odpovědí. Správný nástroj závisí na tom, jestli jste vývojář, business analytik nebo enterprise tým — a také na tom, jestli jsou vaše PDF čisté textové soubory, nebo chaotické naskenované obrázky od deseti dodavatelů.
Pokud chcete vidět, jak v praxi vypadá AI extrakce z PDF, vyzkoušejte free tier Thunderbit. Myslím, že vás překvapí, kolik dat z PDF dostanete během pár kliknutí. A pokud Thunderbit není ideální, zkuste některé další nástroje z tohoto seznamu. Nikdy nebyla lepší doba přestat kopírovat a vkládat z PDF a začít skutečně využívat data, která v nich jsou.
Další tipy k extrakci dat a automatizaci najdete v našich průvodcích na extrakci dat z webových stránek do Excelu, nejlepších nástrojích pro extrakci dat, AI extrakci dat pro firmy a jak převést obrázky do Excelu. Můžete se také podívat na podrobné návody na Thunderbit YouTube kanálu.
Vyzkoušejte Thunderbit zdarma Tabulky, OCR i smíšené reporty v jednom kroku. Free plán stačí na to, abyste zjistili, jestli si poradí s vašimi dokumenty. Get Started Free
Časté dotazy
1. Jaký je nejlepší bezplatný PDF scraper?
Pro netechnické uživatele je Tabula nejjednodušší plně bezplatný GUI nástroj pro textové PDF tabulky. Pro vývojáře jsou silné volby Camelot, pdfplumber, PyMuPDF a Docling. Pokud chcete no-code variantu s free tierem, Thunderbit je nejlepší start.
2. Umí PDF scrapery pracovat se skenovanými dokumenty?
Jen nástroje s vestavěným OCR zvládnou skenovaná PDF přímo. Patří sem Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio a Docling (s integrovanými OCR enginy). Tabula, Camelot a pdfplumber samy o sobě skenovaná PDF nezvládnou — potřebují externí OCR, například Tesseract.
3. Jak přesná je extrakce tabulek z PDF?
Hodně záleží na složitosti tabulek. Většina nástrojů si dobře poradí s jednoduchými tabulkami s okraji. Tabulky bez okrajů, sloučené buňky a vícestránkové tabulky jsou mnohem těžší. AI nástroje jako Thunderbit, Nanonets a AWS Textract obvykle překonávají parsery založené na pravidlech u různorodých rozvržení, zatímco rule-based nástroje mohou být pořád výborné u stabilních textových PDF.
4. Potřebuji k scrapování PDF programovací dovednosti?
Ne. Nástroje jako Thunderbit, Parseur, Docparser, Parsio, Nanonets a Adobe Acrobat lze používat bez kódování. GUI má i Tabula. Python knihovny jako PyMuPDF, Camelot, pdfplumber a Docling vyžadují kód.
5. Můžu exportovat data z PDF přímo do Excelu nebo Google Sheets?
Většina nástrojů umí aspoň export do CSV nebo Excelu. Thunderbit navíc zdarma exportuje přímo do Google Sheets, Airtable a Notion. Parseur, Docparser a Parsio podporují export do firemních workflow přes integrace jako Zapier, webhooks a API.
Vyzkoušejte AI PDF scraping s Thunderbit Get Started Free
Zjistěte více



