
Původní otázka byla jednoduchá: „Který scraper umí zkopírovat data z téhle webové stránky?“
Lepší otázka pro rok 2026 zní přesněji: „Který workflow dokáže proměnit nepřehlednou webovou stránku v důvěryhodná strukturovaná data, a to s dostatečnou kontrolou, abych je mohl příští týden znovu použít?“
Tohle rozlišení je důležité, protože pojem „AI web scraper“ dnes zahrnuje několik velmi odlišných produktů. Některé nástroje používají AI k návrhu polí a extrakci dat bez selektorů. Jiné jsou vizuální scrapery s několika chytrými detekčními funkcemi. Další jsou vývojářské platformy, kde AI pomáhá psát nebo udržovat kód. A některé starší nástroje se ve výsledcích vyhledávání stále objevují, i když už nejsou skutečně AI-native.
Tento průvodce drží porovnání při zemi a prakticky. Pokud pracuješ v prodeji, marketingu, ecommerce, výzkumu, provozu nebo datovém týmu, cílem není scraper obdivovat. Cílem je dostat čisté řádky z veřejných webů do tabulky, CRM, databáze nebo automatizačního workflow, aniž bys zbytek měsíce strávil opravováním selektorů.
Scrapeuj weby s AI Použij Thunderbit k převodu webových stránek do strukturovaných tabulek a pak je exportuj do Sheets, Airtable, Notion, CSV nebo JSON. Get Started Free
Co se v roce 2026 počítá jako free AI web scraper?
Užitečný AI web scraper by měl pomoct aspoň s jedním z těchto úkolů:
- přečíst stránku a navrhnout pole k extrakci
- zvládnout seznamy, stránkování, nekonečný scroll nebo podstránky
- převést neuspořádaný obsah stránky do strukturovaných řádků
- exportovat data do nástrojů, které už váš tým používá
- snížit množství údržby selektorů po změně stránky
- udělat workflow opakovatelný pro tým, ne jen pro jednu browser session
„Free“ si taky zaslouží střízlivý pohled. Některé nástroje mají skutečně bezplatný plán. Jiné nabízejí bezplatnou zkušební verzi. Další jsou open source, ale vyžadují čas vývojářů. Některé enterprise nástroje jsou skvělé, ale bezplatná cesta je spíš demo nebo trial. To z nich nedělá špatné nástroje — jen to mění, pro koho dávají smysl.
Praktické rozhodovací pravidlo je toto:
- Pokud potřebuješ data dnes a nechceš programovat, začni s no-code AI scraperem.
- Pokud potřebuješ vlastní pipeline a máš vývojáře, použij vývojářský framework nebo cloudovou automatizační platformu.
- Pokud potřebuješ řízené, velkoobjemové datové feedy, podívej se na enterprise datové platformy.
- Pokud je nástroj zastaralý nebo nepodporovaný, ber ho jako referenci, ne jako výchozí volbu.
Jak jsme tyto nástroje vybírali
Prošel jsem současný seznam 10 nástrojů z původního článku a zachoval stejný praktický hodnoticí pohled. Důležitá otázka už není „Umí ten produkt scrapovat?“ ale „Jaký typ scrapingového workflow ten produkt usnadňuje?“
Kritéria byla:
- AI asistence: návrh polí, chytrá extrakce, nastavení v přirozeném jazyce nebo AI podpora parsování.
- Bezplatný přístup: free plán, free trial, open-source dostupnost nebo vývojářské kredity.
- Snadnost použití: zda to zvládne byznys uživatel bez pomoci vývojářů.
- Podpora moderního webu: stránkování, podstránky, JavaScriptové stránky, obrázky a exporty.
- Provozní vhodnost: zda se výsledek dá proměnit v opakovatelný proces.
- Riziko a údržba: kolik nastavení, oprav selektorů, compliance kontroly a QA si uživatel pořád musí řešit sám.
Ještě jedna poznámka: před scrapováním si vždy zkontroluj podmínky cílového webu, robots.txt, požadavky na přihlášení a povinnosti v oblasti ochrany soukromí. AI usnadňuje extrakci; nezbavuje tě odpovědnosti používat webová data zodpovědně.
Rychlý výběr: nejlepší free AI web scrapery podle použití
| Použití | Začni zde | Proč |
|---|---|---|
| Rychlé no-code scrapování pro byznys týmy | Thunderbit | Návrh polí pomocí AI, scrapování podstránek, exporty, Chrome workflow |
| Vizuální desktopové scrapování | ParseHub nebo Octoparse | Dobré pro uživatele, kteří preferují klikací workflow |
| Scrapování pomocí browser receptů | Data Miner | Silné pro běžné tabulky a opakovatelnou práci s recepty |
| Scrapování pod kontrolou vývojářů | Scrapy nebo Apify | Nejlepší, když záleží na kódu, API a vlastní infrastruktuře |
| AI datová API a extrakce entit | Diffbot | Vhodnější pro API-led enrichment a strukturovaná data entit |
| Open-source crawling připravený pro AI | Crawl4AI nebo Scrapling | Vývojářské frameworky pro LLM pipeline a udržovatelný custom scraping |
1. Thunderbit
Thunderbit je nejlepší volba pro firemní uživatele, kteří chtějí scrapovat veřejné webové stránky bez psaní scraper kódu. Jde o rozšíření pro Chrome postavené na jednoduchém postupu: otevřeš stránku, necháš AI navrhnout pole, případně upravíš tabulku, vyextrahuješ seznam nebo podstránky a pak výsledek exportuješ.
Na tom workflow záleží, protože spousta týmů ve skutečnosti nechce „scraper“. Chtějí leady z adresářů, produktová data z marketplace, ceny od konkurence, realitní nabídky, recenze, pracovní nabídky nebo výzkumná data v tabulce.
Thunderbit je obzvlášť silný, když:
- zdroj je webová stránka, ne PDF nebo interní databáze
- uživatel ví, jaká data potřebuje, ale nezná CSS selektory
- stránka má detailní stránky, stránkování nebo opakující se karty
- výstup má jít do Google Sheets, Airtable, Notion, CSV nebo JSON
- workflow může opakovaně spouštět i netechnický kolega
AI přístup je praktický, ne jen ozdobný. AI pomáhá odhadnout pole, psát extrakční prompty a udělat nastavení méně křehké než u čistě klikacího selektorového workflow. I tak bys měl před exportem větší dávky zkontrolovat vzorové řádky, zvlášť když zdrojová stránka míchá reklamy, doporučení nebo sponzorované záznamy mezi hlavní výsledky.
Free přístup: Thunderbit má bezplatnou cestu pro menší úlohy, s placenými plány pro vyšší objem scrapování. Před zveřejněním přesných limitů kreditů si zkontroluj aktuální pricing page, protože balíčky kreditů se mohou měnit.
Nejlepší pro: prodej, marketing, ecommerce, real estate, operations a výzkumné týmy, které potřebují rychle strukturovaná webová data.

2. ParseHub
ParseHub je vizuální web scraper pro uživatele, kteří raději klikají přímo po stránce a naučí nástroj, co má extrahovat. Umí pracovat s mnoha dynamickými stránkami a pořád zůstává známou volbou pro týmy, které chtějí desktopový nebo cloudový vizuální scraper.
ParseHub je užitečný, když je uživatel ochotný vytvářet projekt krok za krokem: vybrat prvek, rozšířit výběr, přidat stránkování, otestovat běh a pak exportovat. Není tak „prompt-first“ jako novější AI-native nástroje, ale pořád může fungovat dobře pro strukturované seznamy, článkové stránky a produktové kolekce.
Free přístup: ParseHub historicky nabízel free tier s omezeným počtem projektů a běhů stránek. Před uváděním čísel do produkčního textu si ověř aktuální limity projektů a stránek na oficiálním webu.
Nejlepší pro: menší vizuální scraping projekty, kde uživateli nevadí věnovat trochu času konfiguraci workflow.
3. Octoparse
Octoparse je vyspělá no-code web scraping platforma s šablonami, tvorbou workflow, cloudovými běhy, plánováním a podporou mnoha dynamických webů. Je funkčně bohatší než lehké Chrome rozšíření, což může být výhoda i zátěž podle typu uživatele.
Octoparse je dobrá volba, když je scraping opakovaný, cílový web je složitý nebo tým chce vizuální nástroj pro tvorbu workflow s plánováním a cloudovým spuštěním. Nastavení může zabrat víc času než rychlý AI-assisted scraping, ale pokročilým uživatelům dává větší kontrolu.
Free přístup: Octoparse nabízí free plán, ale limity funkcí a záznamů se mění. Než uvedeš přesná čísla, ověř si aktuální limity free plánu na Octoparse pricing page.
Nejlepší pro: pokročilé uživatele a týmy, které potřebují vizuální kontrolu workflow, šablony, plánování nebo opakované úlohy.

4. Scrapy
Scrapy není no-code AI scraper. Je to open-source Python framework pro tvorbu crawlerů a extrakčních pipeline. To rozlišení je důležité.
Pro vývojáře je Scrapy pořád jeden z nejflexibilnějších způsobů, jak postavit vlastní scraper. Můžeš řídit requesty, parsování, retry, pipeline, úložiště i nasazení. Kolem Scrapy můžeš také používat LLM: pro návrh selektorů, kontrolu parsovací logiky, generování testů nebo vysvětlování chyb. Ale samotné Scrapy neeliminuje vývojářskou práci.
Free přístup: Scrapy je open source. Software je zdarma, ale hosting, proxy, údržba, monitoring a čas vývojářů zdarma nejsou.
Nejlepší pro: inženýry, kteří staví vlastní, udržitelné scraping systémy, kde je vlastnictví kódu v pořádku.
5. Data Miner
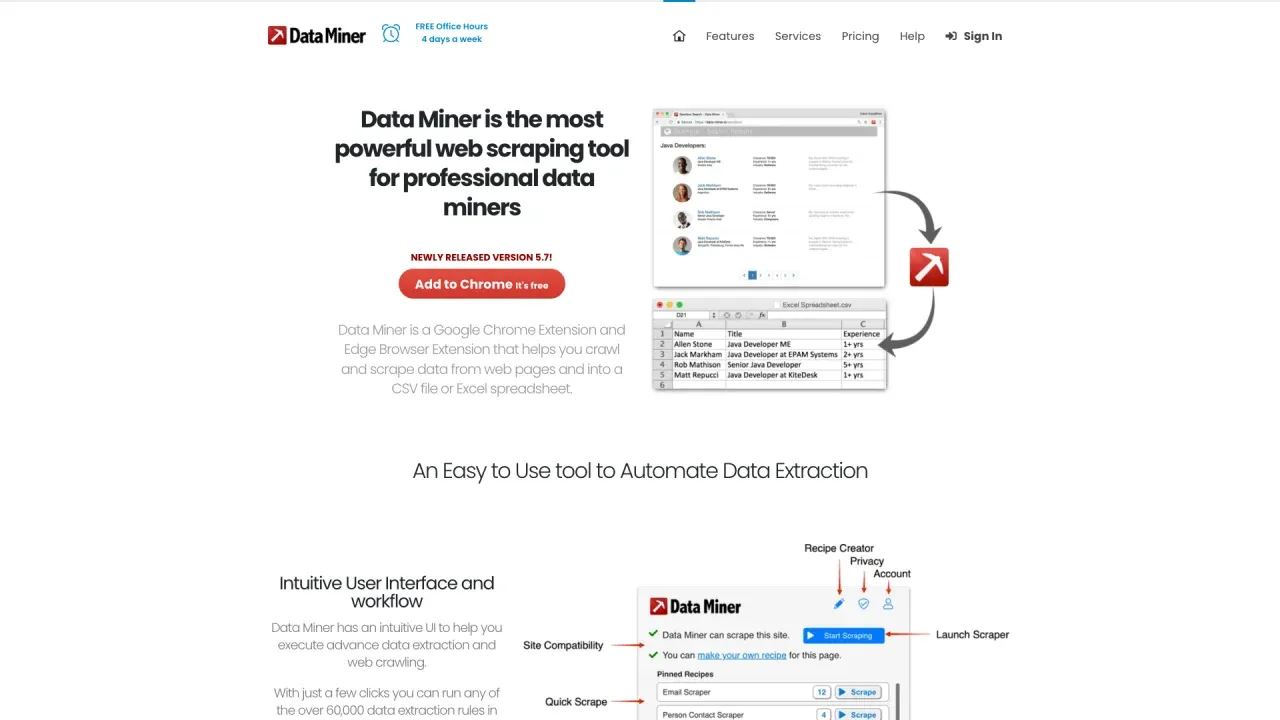
Data Miner je browser extension zaměřená na scrapování tabulek, seznamů a běžných vzorů na stránkách. Její hlavní výhodou je knihovna receptů: pokud už pro tvůj zdroj existuje recept, nastavení může být rychlé.
Je to dobrá volba pro uživatele, kteří opakovaně scrapují známé typy stránek a nepotřebují plnohodnotnou extrakční platformu. Méně se hodí pro chaotické, vysoce dynamické stránky nebo tam, kde je potřeba AI, aby odhadla pole z nejednoznačného obsahu.
Free přístup: Data Miner nabízí omezené bezplatné použití s placenými plány pro vyšší objem. Před citováním si ověř aktuální limity stránek nebo kreditů.
Nejlepší pro: rychlou tabulkovou extrakci, běžné adresáře a uživatele, kteří mají rádi workflow v browser extension.
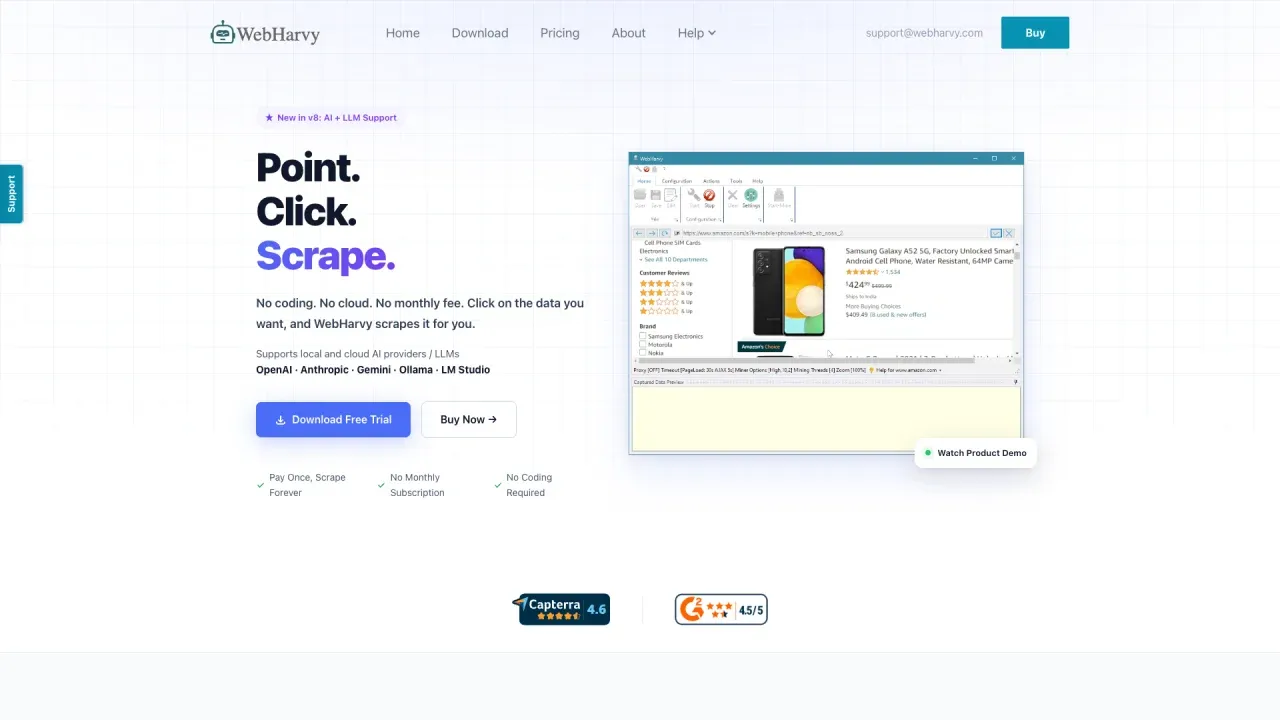
6. WebHarvy
WebHarvy je desktopový scraper pro Windows s vizuálním rozhraním a funkcemi pro detekci vzorů. Hodí se pro uživatele, kteří chtějí na stránce označit příklady a nechat nástroj odvodit podobné položky.
WebHarvy je nejsilnější u produktových stránek, stránek bohatých na obrázky a desktopového workflow. Není to nejmodernější AI-native varianta, ale pořád může dobře fungovat pro uživatele, kteří preferují jednorázovou licenci a lokální desktopový software.
Free přístup: WebHarvy je obecně postavený spíš na free trial a placené licenci než na průběžném free plánu. Než ho budeš označovat za bezplatný nástroj, zkontroluj aktuální web WebHarvy.
Nejlepší pro: uživatele Windows, kteří scrapují produktové seznamy, obrázky a opakující se vzory na stránkách.
7. Apify
Apify je vývojářsky přívětivá cloudová platforma pro web scraping, browser automation a datovou extrakci. Její hlavní přednost je Actor marketplace: místo začínání na prázdném skriptu mohou týmy použít nebo upravit existující actory pro běžné weby a workflow.
Apify je jedna z nejsilnějších voleb ve chvíli, kdy se scraping má stát softwarem. Podporuje API, plánování, úložiště, webhooky a vývojářské workflow. AI tu taky může pomoci, ale spíš jako asistent pro tvorbu, ladění a validaci actorů než jako jednorázové rozhraní pro byznys uživatele.
Free přístup: Apify má model s free kredity/plánem. Před uváděním přesných limitů compute si ověř aktuální Apify pricing a platform dokumentaci.
Nejlepší pro: vývojáře, automatizační týmy a technické operátory, kteří chtějí cloudovou scraping infrastrukturu.

8. Diffbot
Diffbot je AI datová platforma známá extrakcí strukturovaných entit z webových stránek a správou rozsáhlého knowledge graphu. Má blíž k API a platformě pro datovou inteligenci než k vizuálnímu scraperu.
Diffbot může být velmi silný, když je úkolem extrakce entit, parsování článků nebo produktů, enrichment nebo porozumění webovým datům ve velkém měřítku. Obvykle to ale není první volba pro netechnického uživatele, který chce kliknout na stránku a exportovat tabulku.
Free přístup: Diffbot má free plán a modely přístupu pro vývojáře; nejnovější podmínky kreditů a trialu si ověř na aktuální Diffbot pricing.
Nejlepší pro: technické týmy, které potřebují API-based strukturovanou extrakci, data knowledge graphu nebo entity intelligence.
9. Crawl4AI
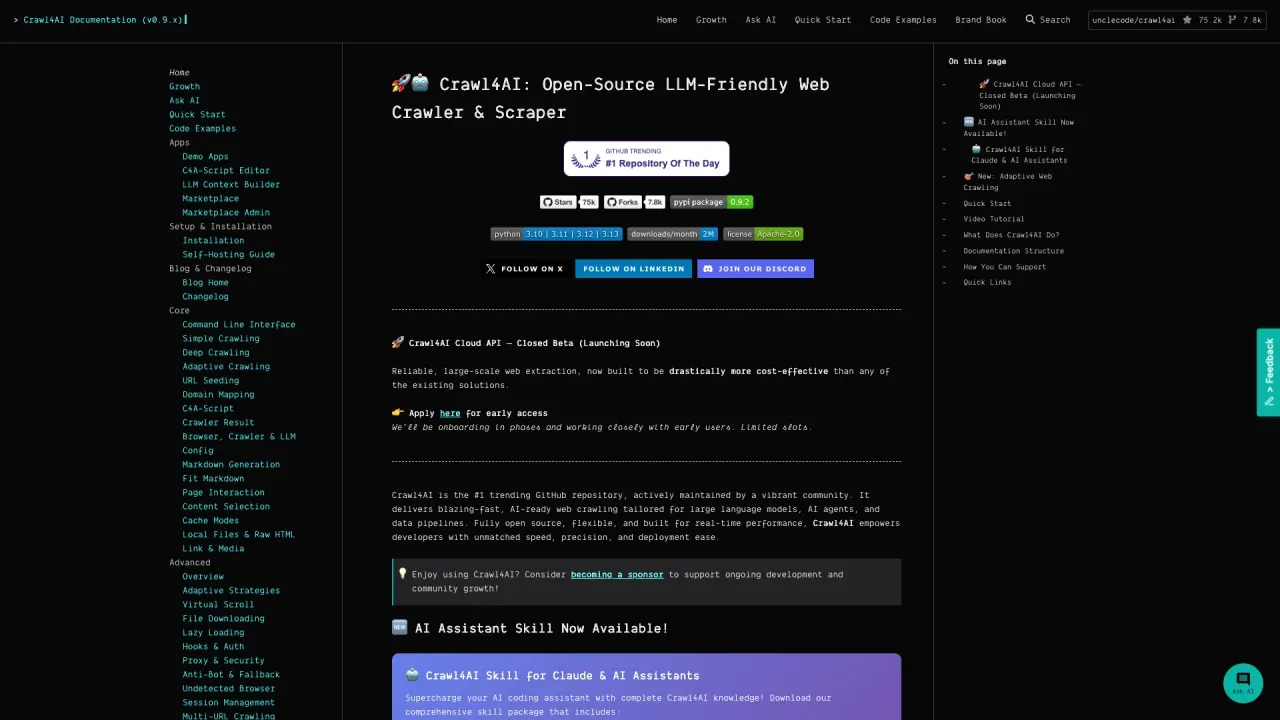
Crawl4AI je open-source crawler a scraper přátelský k LLM, určený pro vývojáře, kteří staví AI agenty, RAG pipeline a vlastní datové workflow. Umí vytvořit čistý Markdown, extrahovat strukturované JSON pomocí CSS nebo XPath a použít LLM k vytvoření znovupoužitelného extrakčního schématu, když se to pro daný úkol hodí.
Crawl4AI je silná volba ve chvíli, kdy se výsledek má stát součástí inženýrského workflow, ne jen jednorázového exportu do tabulky. Podporuje řízení prohlížeče, asynchronní crawling, session a detailní možnosti extrakce, ale pořád počítá s Pythonem a technickým vlastnictvím.
Free přístup: Open source bez povinného API key nebo paywallu platformy. Extrakce pomocí LLM ale může stále vyžadovat LLM providera nebo lokální model.
Nejlepší pro: vývojáře, kteří staví AI-ready crawlery, RAG ingestion nebo opakovatelná strukturovaná datová pipeline.
10. Scrapling
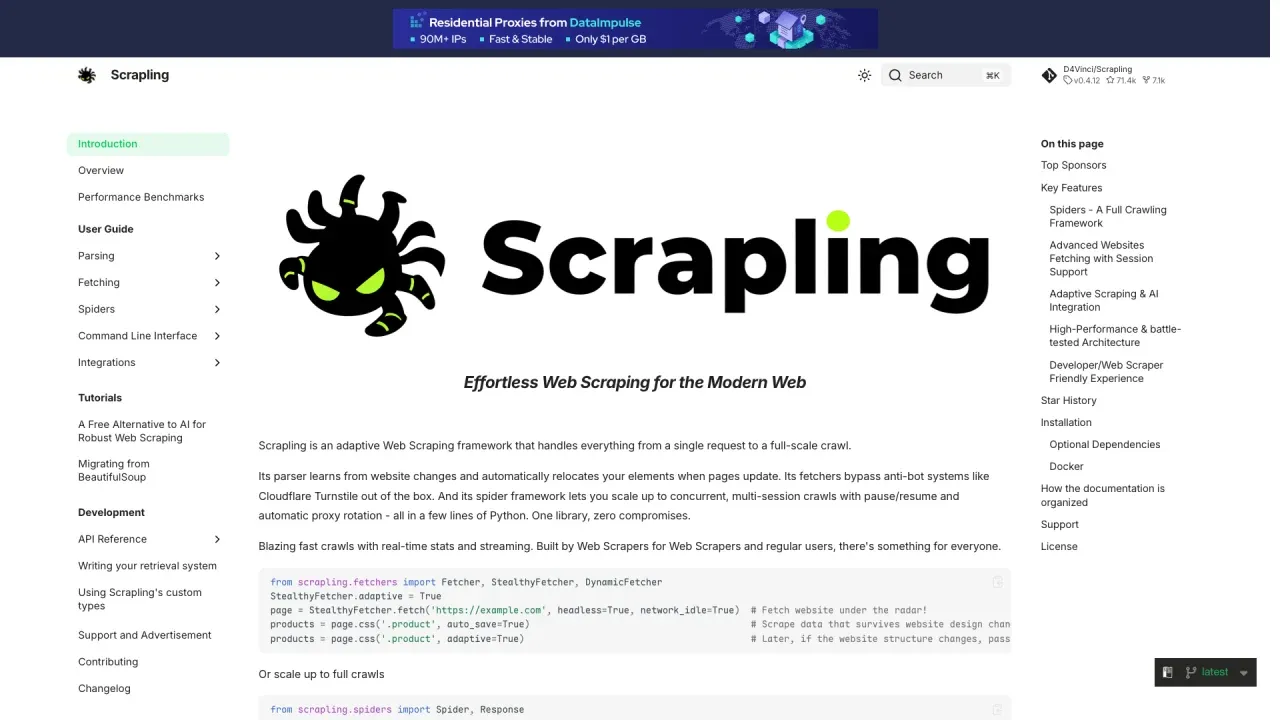
Scrapling je adaptivní Python scraping framework, který pokrývá jednoduché requesty, fetchování přes browser i plnohodnotné crawly. Jeho adaptivní parsování je navržené tak, aby pomohlo znovu najít prvky na stránce, když se web změní, což může snížit zátěž s opravou selektorů v code-owned scraping projektu.
Není to no-code AI nástroj: týmy si pořád musí definovat extrakční logiku, testovat ji a vlastnit runtime. Je to ale moderní náhrada za starší vizuální scraping vstupy, protože je aktivně dokumentovaný a lépe odpovídá dnešnímu Python-based scraping stacku.
Free přístup: Open source. Infrastruktura, proxy služby, browser běhy a čas vývojářů jsou samostatné náklady.
Nejlepší pro: Python vývojáře, kteří chtějí adaptivní scraping a cestu od jednoho fetchu až po concurrent crawl.
Srovnávací tabulka: free AI web scraping nástroje
| Nástroj | Typ | Free cesta | AI-native? | Nejlepší použití |
|---|---|---|---|---|
| Thunderbit | AI Chrome scraper | Bezplatné starter použití | Ano | Firemní uživatelé, kteří potřebují rychlá strukturovaná webová data |
| ParseHub | Vizuální scraper | Omezený free tier | Částečně | Menší vizuální projekty |
| Octoparse | No-code scraping platforma | Free plán/trial | Částečně až silně | Pokročilí uživatelé a opakované no-code úlohy |
| Scrapy | Python framework | Open source | Ne, ale AI-assisted coding funguje | Vývojáři stavějící vlastní scrapery |
| Data Miner | Browser extension | Omezené bezplatné použití | Omezeně | Tabulky, seznamy, scraping na bázi receptů |
| WebHarvy | Windows vizuální scraper | Free trial | Omezeně | Product/image scraping na desktopu |
| Apify | Cloud automation platforma | Free kredity/plán | Vedle AI pro vývojáře | Technické scraping pipeline |
| Diffbot | AI extraction API | Free kredity/plán | Ano | Extrakce entit a workflow s knowledge graphem |
| Crawl4AI | Open-source AI-ready crawler | Open source | Ano / přátelské k LLM | RAG, AI agenti a vývojářské pipeline |
| Scrapling | Adaptivní Python scraping framework | Open source | Vedle AI / adaptivní | Kódem vlastněný scraping, který potřebuje odolnost selektorů |
Jak vybrat správný nástroj
Začni u zdroje a uživatele, ne u značky.
Pokud jsou data na veřejných webových stránkách a uživatel je netechnický, začni s Thunderbit, ParseHub, Octoparse nebo Data Miner. Tyto nástroje jsou blíž skutečnému byznys workflow: otevřít zdroj, definovat pole, spustit test, zkontrolovat řádky, exportovat.
Pokud úloha vyžaduje vlastní logiku, práci s autentizací, orchestrace, API nebo nasazení, podívej se na Scrapy nebo Apify. Tady dává vlastnictví vývojářů smysl. AI použij ke zrychlení kontroly selektorů a generování testů, ale lidskou kontrolu si nech pro compliance, řešení chyb a kvalitu dat.
Pokud firma potřebuje API-led extrakci entit, enrichment nebo strukturovaný knowledge graph, vyhodnoť Diffbot a porovnej jeho trial podmínky, pokrytí dat a vhodnost API s vašimi požadavky. U širších spravovaných datových feedů používej dedikovaný procurement proces, ne je jen brát jako free scraper volbu.
Pokud web nebo dokumentace nástroje vypadají zastarale, nepoužívej ho na citlivou práci. Otestuj ho na neškodné veřejné stránce, ověř exporty a zkontroluj, že je produkt pořád udržovaný.
Jednoduchý checklist validace před exportem
Než spustíš velký scraping, otestuj malý vzorek:
- Odpovídá každý řádek správné entitě?
- Nemíchají se do dat sponzorované, duplicitní nebo doporučené položky?
- Nezastavilo se stránkování nebo nekonečný scroll příliš brzy?
- Parsují se ceny, data, e-maily a telefonní čísla konzistentně?
- Jsou pole z podstránek přiřazená ke správnému nadřazenému řádku?
- Zachovává export formát schéma, které potřebuješ?
- Smíš tato data pro svůj účel sbírat a používat?
AI může nastavení zrychlit, ale taky může způsobit, že špatná extrakce vypadá čistě. QA kontrola na 20 řádcích je pořád jeden z nejlevnějších způsobů, jak se vyhnout špatnému datasetu.
Konečné doporučení
Pro většinu firemních uživatelů začni nejrychlejším bezpečným workflow: použij no-code AI scraper, otestuj malý vzorek, validuj schéma a pak exportuj do systému, kde práce pokračuje.
Thunderbit je nejlepší volba, když jde o veřejná webová data a uživatel chce praktické AI-assisted workflow v prohlížeči. ParseHub, Octoparse a Data Miner stojí za vyzkoušení, pokud preferuješ vizuální buildery projektů nebo scraping na základě receptů. Scrapy, Crawl4AI, Scrapling a Apify jsou lepší ve chvíli, kdy se scraper má stát kódem nebo infrastrukturou. Diffbot je specializovaná volba tam, kde je důležitější extrakce entit nebo data knowledge graphu než browser-based workflow.
Nejlepší nástroj není ten s nejdelším seznamem funkcí. Je to ten, který tvému týmu dodá spolehlivá strukturovaná data s co nejmenší dlouhodobou údržbou.
Často kladené otázky
Co je AI web scraper?
AI web scraper používá strojové učení, LLM, počítačové vidění nebo chytré porozumění stránce k identifikaci polí, extrakci strukturovaných dat nebo adaptaci na nepřehledné weby. Nejlepší nástroje ale pořád umožní výstup zkontrolovat a opravit.
Jsou free AI web scrapery opravdu zdarma?
Některé mají bezplatné starter použití, jiné free trial a další jsou open source. Free neznamená vždy free ve velkém měřítku. Zkontroluj limity stránek, kreditů, omezení exportu a to, zda jsou zahrnuté cloudové běhy.
Který free AI web scraper je nejlepší pro netechnické uživatele?
Thunderbit je nejlepší výchozí volba pro netechnické týmy, které chtějí scrapovat veřejné weby do strukturovaných tabulek. Podle toho, jestli preferuješ vizuální projekty, šablony nebo browser recepty, mohou být užitečné i ParseHub, Octoparse a Data Miner.
Kdy bych měl použít Scrapy nebo Apify místo no-code scraperu?
Použij Scrapy nebo Apify, když potřebuješ vlastní logiku, kontrolu vývojáře, API, plánování, monitoring nebo integraci do širšího softwarového workflow. Jsou výkonné, ale vyžadují větší vlastnickou odpovědnost.
Umí AI web scrapery pracovat se stránkováním a podstránkami?
Mnoho moderních nástrojů ano, ale je potřeba je pečlivě otestovat. Stránkování, nekonečné scrollování a podstránky jsou častá místa, kde scrapery skončí příliš brzy nebo přiřadí data z detailních stránek ke špatnému řádku.
Je legální scrapovat webové stránky?
Záleží na webu, typu dat, jurisdikci a použití. Před sběrem nebo použitím scrapovaných dat si projdi podmínky webu, robots.txt, omezení přihlášení, povinnosti v oblasti soukromí a interní compliance požadavky.
Zjistit více
- Jak scrapovat libovolný web pomocí AI
- Top 5 nejlepších softwarů pro scrapování webových dat v roce 2026
- 7 nejpopulárnějších nástrojů pro web scraping, které používat v roce 2026
- Top 10 AI web scraper nástrojů pro zvýšení produktivity v roce 2025
- Top 8 nejlepších AI web scraperů pro chytřejší extrakci dat
Vyzkoušet AI web scraper Get Started Free




