
Firecrawl هي منصّة تعتمد على واجهات API بالدرجة الأولى لاستخراج بيانات الويب وزحفها والبحث فيها واستخلاصها ضمن سير عمل المطوّرين. تركّز هذه المراجعة على النموذج الحالي للمنتج: الخطط والأرصدة (credits)، والفروق العملية بين النسخة السحابية والنسخة مفتوحة المصدر، والحالات التي يكون فيها واجهة API للمطوّرين أو بديل بدون كود هو الخيار الأنسب.
إذا كنت قد أجريت بعض عمليات الاستخراج التجريبية وتحاول تحديد ما إذا كان Firecrawl مناسبًا لفريقك، فهذه المراجعة موجّهة إليك. فهي تفصل الحقائق الحالية والقابلة للتحقّق بشأن الخطط والمنتج عن الادّعاءات التي تعتمد على موقع مستهدف بعينه أو حِمل عمل معيّن أو تاريخ محدّد، وتوضّح أين قد يكون خيار بدون كود مثل Thunderbit هو الأنسب مباشرة.
ما هو Firecrawl ولمن صُمّم؟
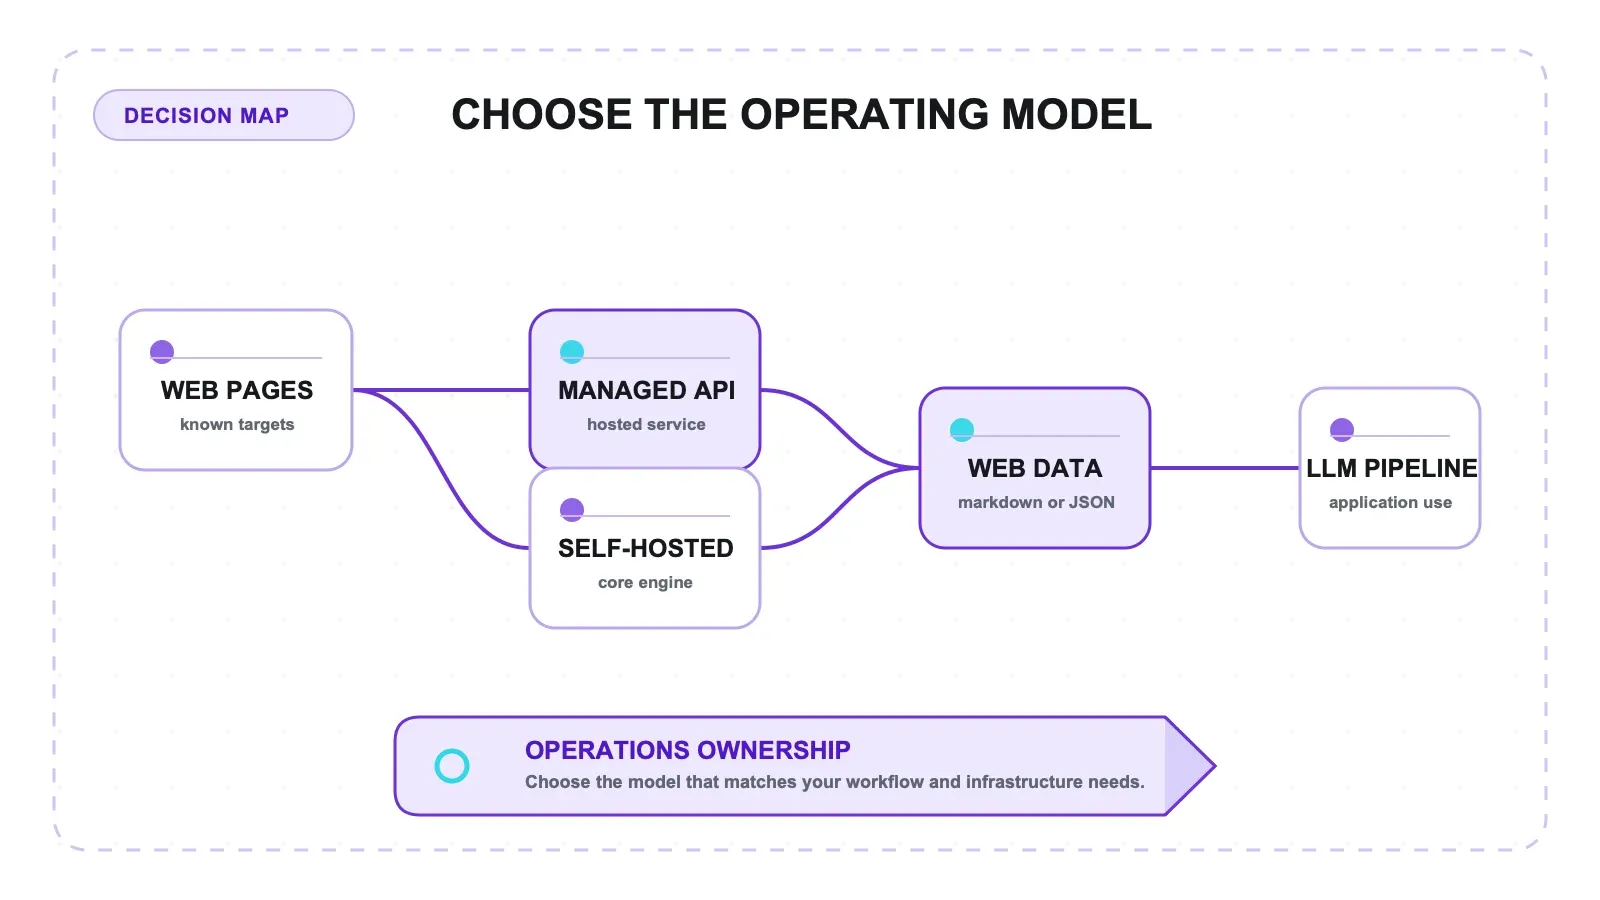
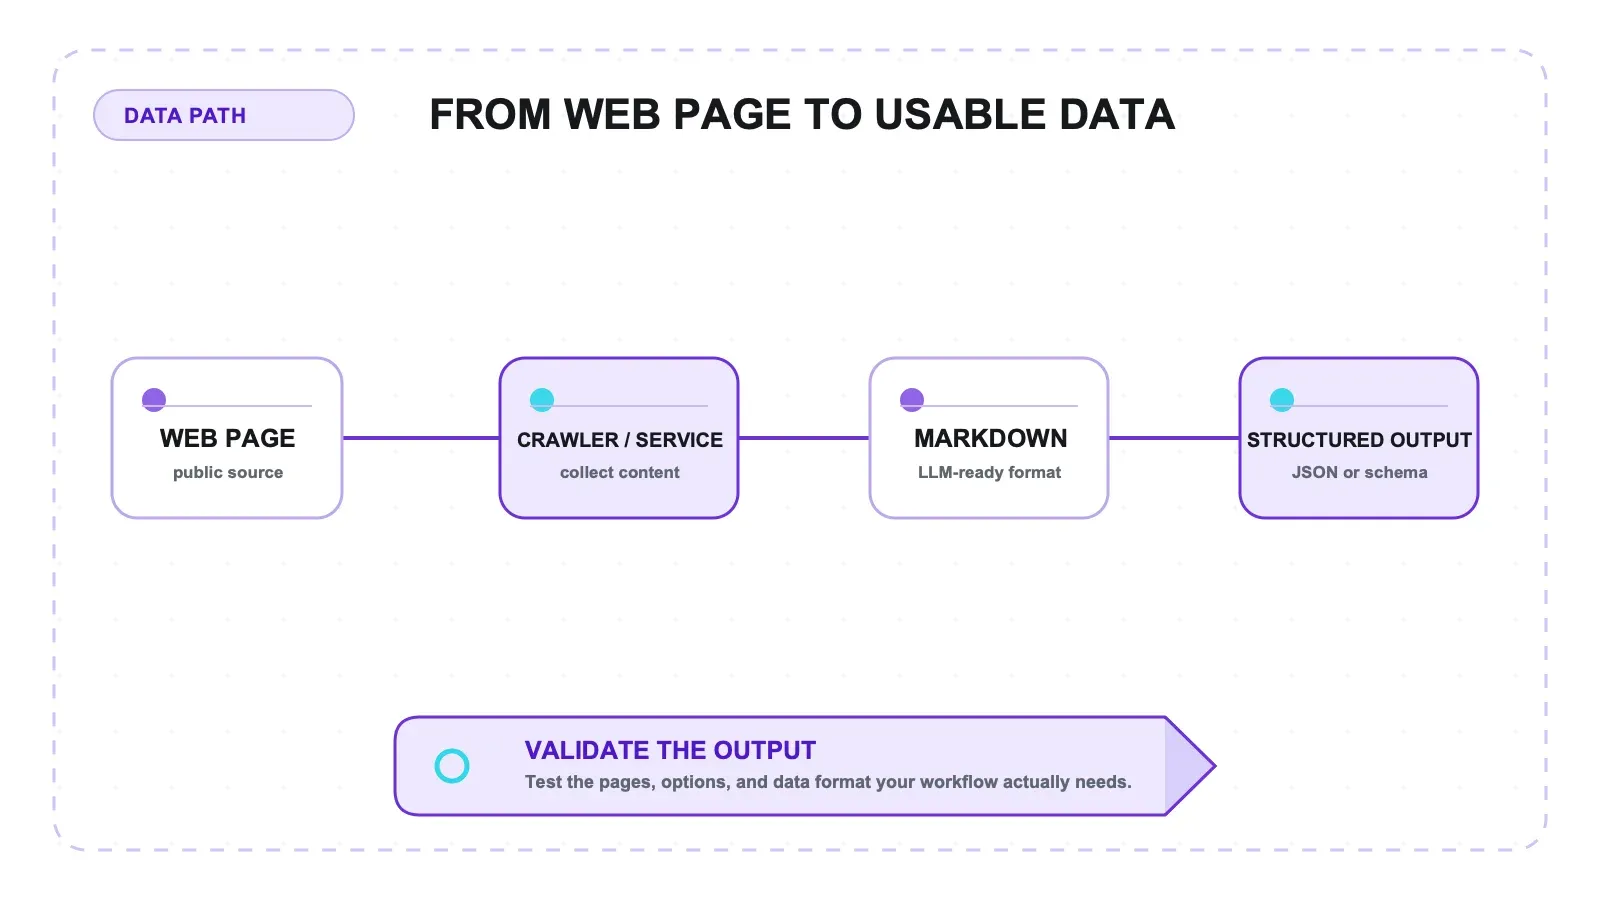
Firecrawl هي منصّة لاستخراج بيانات الويب وزحفها تعتمد على واجهات API بالدرجة الأولى، وتحوّل المواقع إلى markdown نظيف أو JSON منظّم. وهي مصمّمة أساسًا للمطوّرين الذين يبنون تطبيقات ذكاء اصطناعي وتطبيقات LLM — أي خطوط أنابيب RAG وقواعد معرفة روبوتات الدردشة وسير عمل وكلاء الذكاء الاصطناعي. أسّس Firecrawl كلٌّ من Caleb Peffer وEric Ciarla وNicolas Silberstein Camara كمشروع منبثق عن Mendable.ai، وشاركت الشركة في دفعة S22 من Y Combinator. ويتجنّب هذا المقال عمدًا تقديم أرقام التمويل أو عدد الموظفين أو العملاء أو معدّلات التبنّي — وهي بيانات سريعة التقادم — على أنها حقائق حالية عن المنتج.
تشمل نقاط النهاية الأساسية لجمع البيانات في Firecrawl ما يلي:
| الوضع | ما الذي يقوم به |
|---|---|
| Scrape | تحويل رابط واحد إلى markdown أو JSON أو لقطة شاشة |
| Crawl | زحف رابط وجميع صفحاته الفرعية |
| Map | اكتشاف الروابط داخل موقع ما |
| Search | بحث على الويب مع جلب محتوى الصفحة كاملًا |
| Extract | استخلاص منظّم مدعوم بالذكاء الاصطناعي عبر الأوامر أو المخطّطات (schemas) |
| Agent (معاينة بحثية) | بحث ذاتي على الويب دون تحديد روابط |
أريد أن أكون صريحًا: Firecrawl أداة للمطوّرين. فهي تتطلّب استدعاءات API ومعرفة برمجية وإعدادًا تقنيًا. وإذا كنت مستخدمًا في مجال الأعمال تريد جلب بيانات من موقع دون كتابة كود، فإن Firecrawl لم يُصمَّم لك (سنتحدّث عن البدائل لاحقًا). لكن بالنسبة لفرق التطوير التي تبني تطبيقات ذكاء اصطناعي، فالوعد مغرٍ — بيانات ويب نظيفة وجاهزة لنماذج اللغة بأقل قدر من أوجاع الرأس المتعلقة بالبنية التحتية.
مراجعة Firecrawl: نظرة سريعة على الأسعار والأرصدة
تُدرج صفحة الأسعار الحالية لـ Firecrawl أرصدة شهرية متكرّرة في كل خطة ذاتية الاشتراك. وتعرض الصفحة العامة الفوترة السنوية افتراضيًا، لذا يُعرض السعر السنوي إلى جانب السعر الشهري حيثما ذكرت Firecrawl سعرًا شهريًا.
| الخطة | السعر الشهري | الأرصدة/الشهر | التزامن | السعر السنوي |
|---|---|---|---|---|
| Free | 0 دولار | 1,000 شهريًا | 2 | — |
| Hobby | 19 دولارًا/شهر | 5,000 | 5 | 16 دولارًا/شهر بفوترة سنوية |
| Standard | 99 دولارًا/شهر | 100,000 | 50 | 83 دولارًا/شهر بفوترة سنوية |
| Growth | 399 دولارًا/شهر | 500,000 | 100 | 333 دولارًا/شهر بفوترة سنوية |
| Scale | 749 دولارًا/شهر | 1,000,000 | 150 | 599 دولارًا/شهر بفوترة سنوية |
كيف يعمل نموذج الأرصدة الحالي
السعر المعلن ليس سوى جزء من القرار، لأن استهلاك الأرصدة يعتمد على نقطة النهاية والخيارات المحدّدة. وتُدرج Firecrawl حاليًا هذه المعدّلات الأساسية:
| نقطة النهاية أو الميزة | الاستهلاك الأساسي الحالي للأرصدة |
|---|---|
| Scrape أو Crawl أو Map أو Monitor | رصيد واحد لكل صفحة |
| Search | رصيدان لكل 10 نتائج |
| Interact | رصيدان لكل دقيقة متصفّح |
| Agent (معاينة) | 5 تشغيلات مجانية يوميًا، ثم تسعير ديناميكي |
| الخيارات المتقدّمة | وضع JSON ووضع Enhanced وما شابههما تستهلك أرصدة إضافية |
لم يعد هناك اشتراك عام منفصل بالرموز (tokens) لخدمة Extract في نموذج التسعير الحالي. وبالنسبة لرابط معروف، توصي Firecrawl باستخدام وضع JSON على /scrape باعتباره الخيار المتزامن الأقل تكلفة؛ أما /agent فمخصّص للبحث الذاتي عندما تكون الروابط مجهولة أو عندما يكون التنقّل مطلوبًا. وفي الخطط ذاتية الاشتراك، لا تُرحَّل الأرصدة غير المستخدمة. كما تقول Firecrawl إنها لا تحاسبك على الأعطال من جانبها، لكنها قد تحاسبك على صفحة جُلبت بنجاح حتى لو استجاب الموقع المستهدف بخطأ 4xx أو 5xx. لذا احسب استهلاكك على روابطك التمثيلية قبل اختيار خطة.
استضافة Firecrawl ذاتيًا: ما المتضمَّن وما هو حصري للسحابة
النسخة مفتوحة المصدر من Firecrawl متاحة بموجب رخصة AGPL-3.0. وتشير وثائقها الحالية إلى أن المشروع مفتوح المصدر يتضمّن محرّك الاستخراج والزحف الأساسي، إضافة إلى Map وSearch والاستخراج الدفعي وExtract ووضع JSON وتتبّع التغييرات وحِزم SDK. أما النسخة السحابية فتضيف بنية تحتية مُدارة وعدّة قدرات ليست جزءًا من العرض مفتوح المصدر.
| القدرة | مفتوح المصدر | السحابة |
|---|---|---|
| Scrape وCrawl وMap وSearch والاستخراج الدفعي وExtract ووضع JSON | ✅ | ✅ |
| تتبّع التغييرات وحِزم SDK | ✅ | ✅ |
| Agent وBrowser Sandbox وActions | ❌ | ✅ |
| البروكسيات المحسّنة وتدويرها | ❌ | ✅ |
| لوحة التحكم وميزات المؤسسات | ❌ | ✅ |
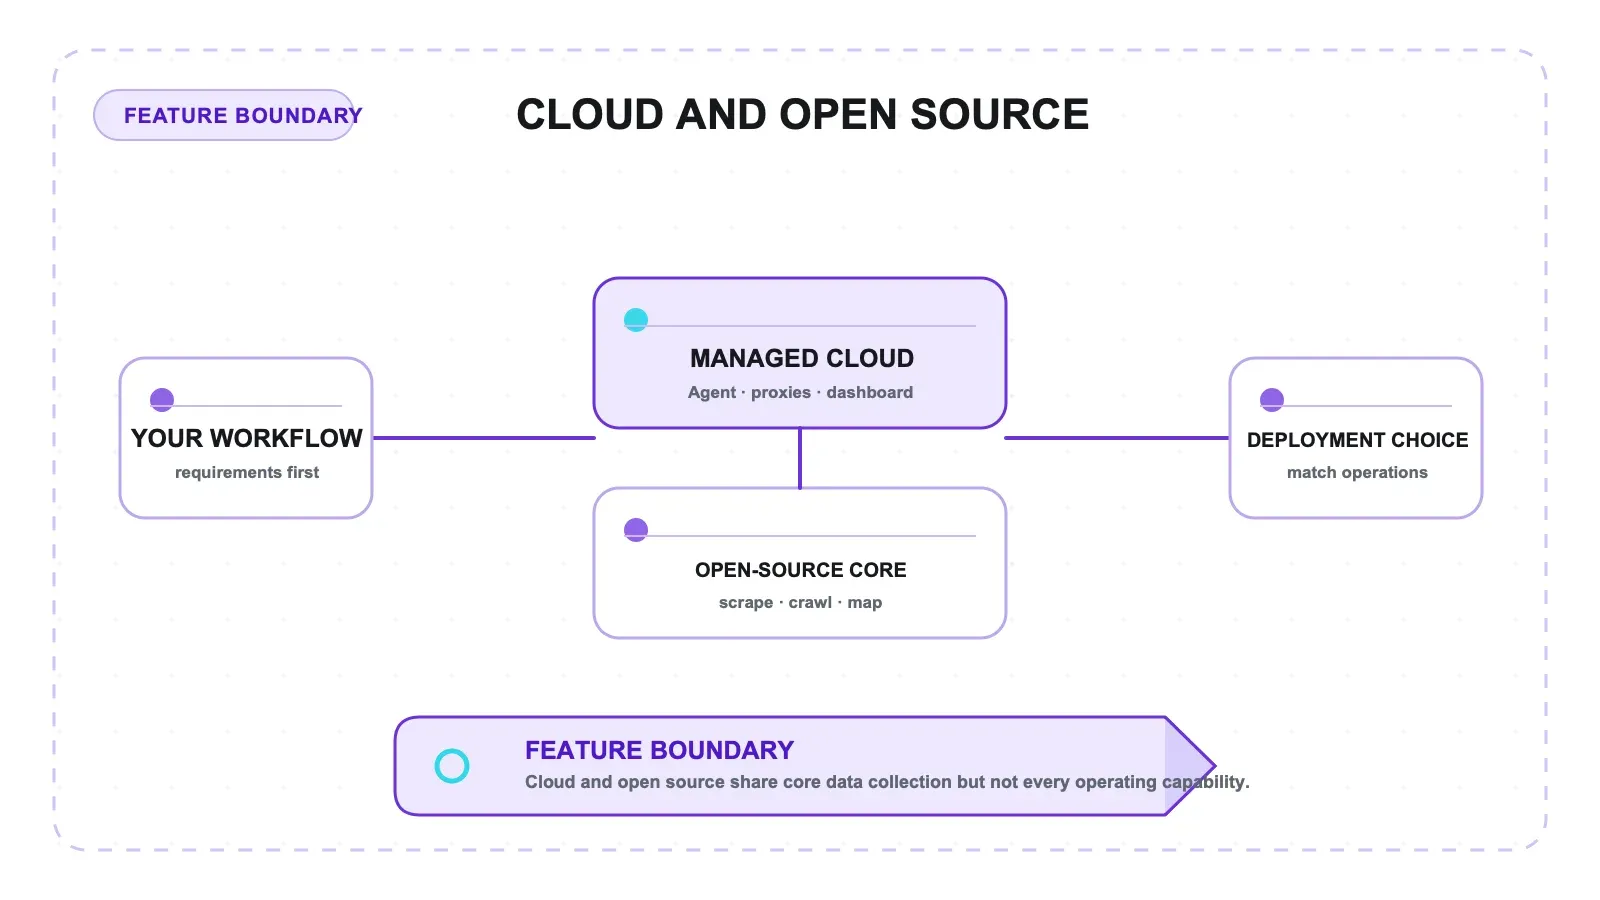
قد تكون الاستضافة الذاتية خيارًا جيدًا عندما تريد التحكّم بالمحرّك الأساسي وتستطيع تشغيل البنية التحتية المطلوبة. لكنها ليست بديلًا مكافئًا للنسخة السحابية إذا كان سير عملك يعتمد على البروكسيات المُدارة أو قدرات المتصفّح أو Agent أو لوحة التحكم. راجع وثائق Firecrawl الحالية حول المقارنة بين مفتوح المصدر والسحابة قبل اتخاذ قرار معماري، لأن هذه الحدود بين الميزات تتغيّر باستمرار.
Firecrawl على المواقع المحمية: اختبر أهدافك الفعلية
تعتمد نتائج تجاوز أنظمة مكافحة الروبوتات على الموقع المستهدف والموقع الجغرافي وسلوك الجلسة والخيارات المفعّلة، لذا لا يتعامل هذا المقال مع أي اختبار قياس أداء قديم من طرف ثالث على أنه معدّل نجاح عالمي حالي. توفّر النسخة السحابية من Firecrawl بروكسيات محسّنة وتدويرًا للبروكسيات، وهي ميزات غير مضمّنة في النسخة مفتوحة المصدر.
بالنسبة للوثائق العامة والمدوّنات والمواقع ذات الحماية الخفيفة، ابدأ بعيّنة تمثيلية وتحقّق من جودة المخرجات ونطاق التغطية وزمن الاستجابة واستهلاك الأرصدة. أما المواقع ذات دفاعات صارمة ضد الروبوتات، فأجرِ إثبات مفهوم منضبطًا بروابطك الخاصة ومتطلبات الامتثال لديك قبل الالتزام بأي مزوّد. فالنتيجة المستخلصة من موقع آخر أو من تاريخ آخر ليست ضمانة شرائية موثوقة.
مزايا Firecrawl وعيوبه: خلاصة صريحة
ما يجيده Firecrawl
- سير عمل بيانات الويب المعتمد على API أولًا — تدعم نقاط النهاية Scrape وCrawl وMap وSearch وExtract وما يرتبط بها خطوط أنابيب البيانات التي يبنيها المطوّرون.
- صيغ جاهزة لنماذج اللغة ووضع JSON — مفيدة عندما يحتاج خط الأنابيب إلى محتوى ويب بصيغ قابلة للقراءة آليًا.
- نواة مفتوحة المصدر إضافة إلى خدمة سحابية مُدارة — تستطيع الفرق اختيار التحكّم بالبنية التحتية أو الاعتماد على خدمة مستضافة.
- Agent في معاينة بحثية — مفيد للمهام التي تكون فيها الروابط مجهولة أو التي تتطلّب تنقّلًا ذاتيًا.
- دعم MCP وحِزم SDK — عملي للفرق التي تدمج Firecrawl في سير عمل الوكلاء أو التطبيقات.
ما ينبغي التحقّق منه بعناية
- استهلاك الأرصدة يتفاوت حسب نقطة النهاية والخيارات المتقدّمة — قدّر استهلاكك بالخيارات نفسها التي ستشغّلها فعليًا.
- Agent معاينة بحثية بتسعير ديناميكي — اضبط حدًّا عبر
maxCreditsواختبره بأوامر تمثيلية. - الاستضافة الذاتية والسحابة ليستا متكافئتين في الميزات — البروكسيات المُدارة وأدوات المتصفّح وAgent ولوحة التحكم كلها قدرات سحابية.
- الموثوقية على المواقع المحمية مرتبطة بالهدف تحديدًا — تحقّق منها عبر إثبات مفهوم منضبط لا عبر اختبار قياس عام.
- يظلّ المنتج موجّهًا للمطوّرين — سير عمل الـ API أنسب للفرق المرتاحة في دمجه وتشغيله.
أبعد من أدوات المطوّرين: بدائل بدون كود لا تذكرها مراجعات Firecrawl أبدًا
كل مراجعة لـ Firecrawl قرأتها تقارنه حصرًا بأدوات مطوّرين أخرى — Crawl4AI وScrapy وPlaywright وApify. وهذا منطقي إن كنت مطوّرًا. لكن شريحة كبيرة من الباحثين عن حلول استخراج بيانات الويب ليسوا مطوّرين: فرق مبيعات تبني قوائم عملاء محتملين، وفرق عمليات في التجارة الإلكترونية تراقب أسعار المنافسين، ومسوّقون يجمعون بيانات المحتوى، ووكلاء عقارات يتابعون الإعلانات.
وهذه فجوة تستحق أن تُسدّ.
جدول مقارنة بدائل Firecrawl
| الأداة | الأنسب لـ | هل يتطلّب كودًا؟ | مخرجات جاهزة لنماذج اللغة | سعر البداية |
|---|---|---|---|---|
| Firecrawl | مطوّرو تطبيقات الذكاء الاصطناعي | نعم (API) | ✅ Markdown/JSON | خطة مجانية؛ الخطط المدفوعة تبدأ من 19 دولارًا/شهر |
| Crawl4AI | مطوّرون يريدون حلًّا مجانيًا/مفتوح المصدر | نعم (Python) | ✅ Markdown | مجاني |
| Apify | مطوّرون يحتاجون التوسّع + سوق الأدوات | نعم (SDK) | ⚠️ مع إعداد إضافي | 39 دولارًا/شهر |
| Thunderbit | مستخدمو الأعمال (بدون كود) | لا (إضافة Chrome) | ✅ بيانات منظّمة | تتوفّر خطة مجانية |
| ScrapingBee | مطوّرون يحتاجون بروكسيات | نعم (API) | ❌ HTML خام | 49 دولارًا/شهر |
| Bright Data | فرق بيانات المؤسسات | نعم (API/SDK) | ⚠️ مع إعداد إضافي | +500 دولار/شهر |
لماذا يُعدّ Thunderbit الخيار الأول للفرق غير التقنية
أنا أعمل ضمن فريق Thunderbit، ولذلك سأكون شفافًا بهذا الشأن. يستحق Thunderbit مكانًا في هذه المقارنة لأنه يحلّ مشكلة مختلفة عن تلك التي يحلّها Firecrawl، ولجمهور مختلف، ودون الحاجة إلى أي كود.
سير عمل Thunderbit يتلخّص في نقرتين: افتح إضافة Chrome، وانقر على "AI Suggest Fields"، ثم انقر على "Scrape". يقرأ الذكاء الاصطناعي الصفحة، ويقترح الأعمدة المناسبة، ويستخرج البيانات المنظّمة في جدول. بلا مفاتيح API، وبلا محدِّدات، وبلا برمجة. ويمكنك التصدير مجانًا إلى Excel أو Google Sheets أو Airtable أو Notion.
أبرز عوامل التمييز لمستخدمي الأعمال:
- إثراء الصفحات الفرعية — الدخول إلى صفحات التفاصيل وسحب حقول إضافية تلقائيًا
- ذكاء اصطناعي يتكيّف مع تغيّرات التصميم — لا صيانة عند إعادة تصميم الموقع
- تصنيف البيانات وترجمتها بشكل مدمج — مفيد لمجموعات البيانات متعدّدة اللغات
- قوالب جاهزة فورية للمواقع الشهيرة (Amazon وZillow وLinkedIn وغيرها)
وللمطوّرين الذين يريدون بديلًا عبر API، يوفّر Thunderbit أيضًا نقطتَي النهاية Distill وExtract بتسعير أبسط من نظام الأرصدة والرموز المزدوج في Firecrawl. وهو لن يحلّ محلّ Firecrawl بالنسبة لمطوّري خطوط أنابيب نماذج اللغة. لكنه بالنسبة لفرق المبيعات والتجارة الإلكترونية والتسويق والعمليات التي تحتاج بيانات منظّمة دون كتابة كود، يمثّل المسار الأسرع والأرخص.
البناء أم الشراء: كيف تختار المسار الصحيح
القرار الصحيح يعتمد على مواقعك المستهدفة وصيغة البيانات وقدراتك الهندسية ومتطلبات الامتثال لديك، أكثر من اعتماده على نقطة تقاطع تكلفة عالمية مفترضة.
| العامل | بناء حل مخصّص | Firecrawl Cloud | Thunderbit (بدون كود) |
|---|---|---|---|
| الإعداد والصيانة | أنت تملك الكود والتشغيل | خدمة مُدارة مع دمج عبر API | سير عمل داخل المتصفّح لمستخدمي الأعمال |
| صيغة البيانات | قابلة للتخصيص بالكامل | Markdown وJSON واستجابات API | جداول منظّمة وعمليات تصدير |
| المواقع المحمية | أنت تصمّم النهج | تحقّق من النتائج حسب كل هدف | تحقّق من النتائج حسب كل هدف |
| الأنسب لـ | الفرق التي تحتاج أقصى درجات التحكّم | المطوّرون الذين يبنون سير عمل لبيانات الويب أو الذكاء الاصطناعي | الفرق التي تحتاج بيانات منظّمة بلا كود |
قبل الالتزام، شغّل حِمل العمل التمثيلي الصغير نفسه عبر الخيارات الواقعية: أدرِج الصفحات التي تحتاجها فعلًا، ومخطّط المخرجات، وإعادة المحاولات، وأي تفاعل مع المتصفّح. وقارن إجمالي الجهد الهندسي وجودة البيانات، لا سعر الخطة المعروض فحسب.
مراجعة Firecrawl: جدول مقارنة جنبًا إلى جنب
إليك كل شيء جنبًا إلى جنب:
| الأداة | النوع | الأنسب لـ | يتطلّب كودًا | التعامل مع أنظمة مكافحة الروبوتات | مخرجات جاهزة لنماذج اللغة | خيار الاستضافة الذاتية | سعر البداية |
|---|---|---|---|---|---|---|---|
| Firecrawl | API | مطوّرو الذكاء الاصطناعي/نماذج اللغة | نعم | تحقّق حسب الهدف | ✅ Markdown/JSON | ✅ (المحرّك الأساسي) | خطة مجانية؛ الخطط المدفوعة تبدأ من 19 دولارًا/شهر |
| Crawl4AI | مكتبة Python | مطوّرون يفضّلون مفتوح المصدر | نعم | لا يوجد (بجهدك) | ✅ Markdown | ✅ | مجاني |
| Apify | منصّة سحابية | التوسّع + سوق الأدوات | نعم | متوسط | ⚠️ مع إعداد إضافي | ✅ | 39 دولارًا/شهر |
| Thunderbit | إضافة Chrome + API | مستخدمو الأعمال، بدون كود | لا | مدمج | ✅ بيانات منظّمة | ❌ | خطة مجانية |
| ScrapingBee | API | مطوّرون يركّزون على البروكسيات | نعم | قوي | ❌ HTML خام | ❌ | 49 دولارًا/شهر |
| Bright Data | API + شبكة بروكسيات | فرق بيانات المؤسسات | نعم | الأفضل (~99.9%) | ⚠️ مع إعداد إضافي | ❌ | +500 دولار/شهر |
الحكم النهائي: هل يستحق Firecrawl العناء؟
Firecrawl خيار قوي لفرق التطوير التي تحتاج طريقة تعتمد على API أولًا لجمع بيانات الويب لتطبيقاتها أو خطوط أنابيب RAG أو سير عمل الوكلاء. فخططه الحالية ذاتية الاشتراك توفّر أرصدة متكرّرة، وتغطي نقاط نهايته الأساسية عمليات الاستخراج والزحف ورسم الخرائط والبحث والمراقبة والتفاعل والاستخلاص المنظّم.
أما القرار العملي فيتوقّف على أهدافك وسير عملك. اختبر المواقع الفعلية ومتطلبات المخرجات التي تهمّك، واحسب الأرصدة اعتمادًا على صفحة الأسعار الحالية، وميّز القدرات المُدارة الحصرية بالسحابة عن النواة مفتوحة المصدر. وإذا كنت تحتاج بيانات أعمال منظّمة دون دمج API أو كتابة كود، فقد تكون أداة بدون كود مثل Thunderbit خيارًا أنسب مباشرة.
ابدأ بأرصدة Firecrawl المجانية البالغة 1,000 شهريًا لإجراء إثبات مفهوم تمثيلي، ثم راجع صفحة الأسعار الحالية قبل اختيار خطة مدفوعة. وللاستخراج بدون كود، يمكنك تجربة إضافة Thunderbit لمتصفّح Chrome أو الاطّلاع على أسعار Thunderbit.
الأسئلة الشائعة
كم تبلغ تكلفة Firecrawl لكل صفحة مستخرَجة؟
تستهلك عمليات Scrape وCrawl وMap وMonitor رصيدًا واحدًا لكل صفحة. ويستهلك Search رصيدين لكل 10 نتائج، بينما يستهلك Interact رصيدين لكل دقيقة متصفّح. أما Agent فهو في مرحلة المعاينة مع 5 تشغيلات مجانية يوميًا وتسعير ديناميكي. ووضع JSON ووضع Enhanced وما شابههما من الخيارات المتقدّمة تضيف أرصدة، لذا راجع صفحة الأسعار الحالية قبل تقدير حِمل عمل إنتاجي.
هل يمكن استضافة Firecrawl ذاتيًا مجانًا؟
نعم. فالنواة مفتوحة المصدر من Firecrawl متاحة بموجب رخصة AGPL-3.0. ويشمل العرض الحالي مفتوح المصدر Scrape وCrawl وMap وSearch والاستخراج الدفعي وExtract ووضع JSON وتتبّع التغييرات وحِزم SDK. أما Agent وBrowser Sandbox وActions والبروكسيات المحسّنة وتدوير البروكسيات ولوحة التحكم وميزات المؤسسات فهي حصرية للسحابة. راجع مقارنة الميزات الحالية لدى Firecrawl قبل اتخاذ قرارك.
هل Firecrawl مناسب لاستخراج بيانات Amazon أو LinkedIn أو غيرها من المواقع المحمية؟
لا تعتمد على ادّعاء عام بمعدّل نجاح تاريخي. فالنتائج على المواقع المحمية تتفاوت حسب الهدف والإعدادات والموقع الجغرافي والدفاعات المتغيّرة. اختبر عيّنة تمثيلية ومتوافقة مع الشروط من المواقع التي تحتاجها تحديدًا. وتتضمّن النسخة السحابية من Firecrawl بروكسيات محسّنة وتدويرًا للبروكسيات، وهي ميزات غير متاحة في النسخة مفتوحة المصدر.
ما أفضل بديل لـ Firecrawl للمستخدمين غير التقنيين؟
Thunderbit خيار بدون كود لمستخدمي الأعمال الذين يحتاجون بيانات منظّمة من المواقع. وتستطيع إضافته لمتصفّح Chrome اقتراح الحقول واستخراج البيانات في جدول دون استدعاءات API أو كتابة محدِّدات؛ كما تدعم التصدير إلى Excel وGoogle Sheets وAirtable وNotion.
هل يوفّر Firecrawl نسخة تجريبية مجانية؟
توفّر خطة Firecrawl المجانية الحالية 1,000 رصيد شهريًا، إضافة إلى 1,000 رصيد بحث، دون الحاجة إلى بطاقة. وهي مخصّصات شهرية متكرّرة وليست منحة لمرة واحدة قدرها 500 رصيد. وتتيح الخطة طلبين متزامنين وحدود معدّل منخفضة؛ راجع تفاصيل الخطة الحالية لأن هذه الحدود قابلة للتغيير.
اعرف المزيد




