
كان السؤال القديم بسيطًا: «أي أداة Scraper يمكنها نسخ البيانات من هذا الموقع؟»
أما سؤال 2026 الأفضل فهو أدق: «أي سير عمل يمكنه تحويل صفحة ويب فوضوية إلى بيانات منظمة وموثوقة، مع مستوى كافٍ من التحقق يسمح لي بإعادة استخدامها الأسبوع المقبل؟»
هذا التحول مهم لأن مصطلح «AI web scraper» أصبح يصف عدة أنواع مختلفة جدًا من المنتجات. فبعض الأدوات تستخدم الذكاء الاصطناعي لاقتراح الحقول واستخراج البيانات من دون محددات. وبعضها أدوات مرئية مع ميزات ذكية بسيطة للتعرّف. وبعضها منصات للمطورين يساعد فيها الذكاء الاصطناعي على بناء الكود أو صيانته. وهناك أدوات أقدم ما زالت تظهر في نتائج البحث رغم أنها لم تعد مبنية أصلًا على الذكاء الاصطناعي.
هذا الدليل يحافظ على الطابع العملي للمقارنة. إذا كنت تعمل في المبيعات أو التسويق أو التجارة الإلكترونية أو البحث أو العمليات أو فرق البيانات، فالهدف ليس الإعجاب بأداة Scraper بحد ذاتها. الهدف هو الحصول على صفوف نظيفة من المواقع العامة إلى جدول بيانات أو CRM أو قاعدة بيانات أو سير عمل آلي، من دون قضاء بقية الشهر في إصلاح المحددات.
استخرج بيانات المواقع باستخدام الذكاء الاصطناعي استخدم Thunderbit لتحويل صفحات الويب إلى جداول منظمة، ثم صدّرها إلى Sheets أو Airtable أو Notion أو CSV أو JSON. Get Started Free
ما الذي يُعد AI Web Scraper مجانيًا في 2026؟
يجب أن يساعدك AI web scraper المفيد في تنفيذ واحدة على الأقل من المهام التالية:
- قراءة الصفحة واقتراح الحقول المطلوب استخراجها
- التعامل مع القوائم أو ترقيم الصفحات أو التمرير اللانهائي أو الصفحات الفرعية
- تحويل محتوى الصفحة غير المنظم إلى صفوف مرتبة
- تصدير البيانات إلى الأدوات التي يستخدمها فريقك أصلًا
- تقليل مقدار الصيانة المطلوبة للمحددات عندما تتغير الصفحة
- جعل سير العمل قابلًا للتكرار لفريق كامل، وليس فقط لجلسة متصفح شخص واحد
أما كلمة «مجاني» فتحتاج أيضًا إلى نظرة واقعية. فبعض الأدوات لديها خطة مجانية فعلية. وبعضها يقدم نسخة تجريبية مجانية. وبعضها مفتوح المصدر لكنه يتطلب وقتًا من المهندسين. وهناك أدوات مؤسسية ممتازة، لكن المسار المجاني فيها لا يتجاوز غالبًا العرض التوضيحي أو فترة التجربة. هذا لا يجعلها أدوات سيئة، لكنه يغير من ينبغي أن يختارها.
إليك قاعدة القرار العملية:
- إذا كنت تحتاج البيانات اليوم ولا تريد البرمجة، فابدأ بأداة AI Scraper بدون كود.
- إذا كنت تحتاج مسارًا مخصصًا ولديك مهندسون، فاختر إطار عمل للمطورين أو منصة أتمتة سحابية.
- إذا كنت تحتاج تدفقات بيانات كبيرة ومنضبطة، فابحث في منصات البيانات المؤسسية.
- إذا كانت الأداة قديمة أو غير مدعومة، فتعامل معها كنقطة مرجعية لا كخيار افتراضي.
كيف اخترنا هذه الأدوات
راجعت القائمة المختصرة المكوّنة من 10 أدوات في المقال الحالي وحافظت على نفس المنهج العملي للتقييم. فالسؤال المهم لم يعد: «هل هذه الأداة تقوم بالسكرابينغ؟» بل أصبح: «أي نوع من سير عمل السكرابينغ تجعل هذه الأداة أسهل؟»
معايير التقييم:
- مساعدة الذكاء الاصطناعي: اقتراح الحقول، الاستخراج الذكي، الإعداد باللغة الطبيعية، أو التحليل المدعوم بالذكاء الاصطناعي.
- الوصول المجاني: خطة مجانية، نسخة تجريبية، توفر مفتوح المصدر، أو رصيد للمطورين.
- سهولة الاستخدام: هل يستطيع مستخدم أعمال تشغيلها من دون مساعدة هندسية؟
- دعم الويب الحديث: ترقيم الصفحات، الصفحات الفرعية، الصفحات المعتمدة على JavaScript، الصور، والتصدير.
- الملاءمة التشغيلية: هل يمكن أن يتحول الناتج إلى عملية قابلة للتكرار؟
- المخاطر والصيانة: مقدار الإعداد، وإصلاح المحددات، ومراجعة الالتزام، وضمان الجودة التي لا يزال المستخدم مسؤولًا عنها.
ملاحظة أخيرة: تحقّق دائمًا من شروط الموقع المستهدف وملف robots.txt ومتطلبات تسجيل الدخول والالتزامات المتعلقة بالخصوصية قبل البدء بالسكرابينغ. الذكاء الاصطناعي يجعل الاستخراج أسهل، لكنه لا يزيل مسؤوليتك عن استخدام بيانات الويب بشكل مسؤول.
أفضل اختيارات سريعة: أفضل AI Web Scrapers مجانية حسب حالة الاستخدام
| حالة الاستخدام | ابدأ هنا | لماذا |
|---|---|---|
| استخراج سريع بدون كود لفرق الأعمال | Thunderbit | اقتراحات حقول بالذكاء الاصطناعي، استخراج الصفحات الفرعية، التصدير، وسير عمل Chrome |
| استخراج مرئي بأسلوب سطح المكتب | ParseHub أو Octoparse | مناسب لمن يفضلون سير العمل القائم على النقر |
| استخراج قائم على وصفات المتصفح | Data Miner | قوي للجداول الشائعة والمهام المتكررة المبنية على الوصفات |
| استخراج تحت تحكم المطور | Scrapy أو Apify | الأفضل عندما يكون الكود وواجهات API والبنية المخصصة هي الأساس |
| واجهات API للبيانات واستخراج الكيانات | Diffbot | مناسب أكثر للإثراء القائم على API وبيانات الكيانات المنظمة |
| زحف مفتوح المصدر وجاهز للذكاء الاصطناعي | Crawl4AI أو Scrapling | أطر عمل للمطورين لخطوط أنابيب LLM وسكرابينغ مخصص قابل للصيانة |
1. Thunderbit
Thunderbit هو الخيار الأفضل لمستخدمي الأعمال الذين يريدون استخراج صفحات ويب عامة من دون كتابة أي كود. إنه إضافة Chrome مبنية حول سير عمل بسيط: افتح الصفحة، دع الذكاء الاصطناعي يقترح الحقول، عدّل الجدول إذا لزم الأمر، استخرج القائمة أو الصفحات الفرعية، ثم صدّر النتيجة.
هذه العملية مهمة لأن كثيرًا من الفرق لا تريد في الحقيقة «أداة Scraper» بحد ذاتها. ما تريده هو بيانات العملاء المحتملين من الأدلة، أو بيانات المنتجات من الأسواق، أو الأسعار من صفحات المنافسين، أو إعلانات العقارات، أو المراجعات، أو الوظائف، أو بيانات الأبحاث داخل جدول.
يتألق Thunderbit بشكل خاص عندما:
- يكون المصدر موقع ويب لا ملف PDF ولا قاعدة بيانات داخلية
- يعرف المستخدم ما البيانات التي يحتاجها لكنه لا يعرف CSS selectors
- تحتوي الصفحة على صفحات تفاصيل أو ترقيم صفحات أو بطاقات متكررة
- يجب أن يذهب الناتج إلى Google Sheets أو Airtable أو Notion أو CSV أو JSON
- قد يحتاج زميل غير تقني إلى تكرار سير العمل لاحقًا
زاوية الذكاء الاصطناعي هنا عملية وليست استعراضية. فالذكاء الاصطناعي يساعد على استنتاج الحقول، وكتابة تعليمات الاستخراج، وجعل الإعداد أقل هشاشة من سير العمل الذي يعتمد فقط على النقرات والمحددات. ومع ذلك، يجب أن تراجع الصفوف النموذجية قبل تصدير مهمة كبيرة، خاصةً عندما تختلط الإعلانات أو التوصيات أو القوائم الممولة مع النتائج الأساسية في الصفحة.
الوصول المجاني: لدى Thunderbit مسار مجاني للمهام الصغيرة، مع خطط مدفوعة للأحجام الأعلى. راجع صفحة التسعير الحالية قبل نشر حدود الرصيد الدقيقة، لأن حزم الأرصدة قد تتغير.
الأفضل لـ: فرق المبيعات والتسويق والتجارة الإلكترونية والعقارات والعمليات والبحث التي تحتاج بيانات ويب منظمة بسرعة.

2. ParseHub
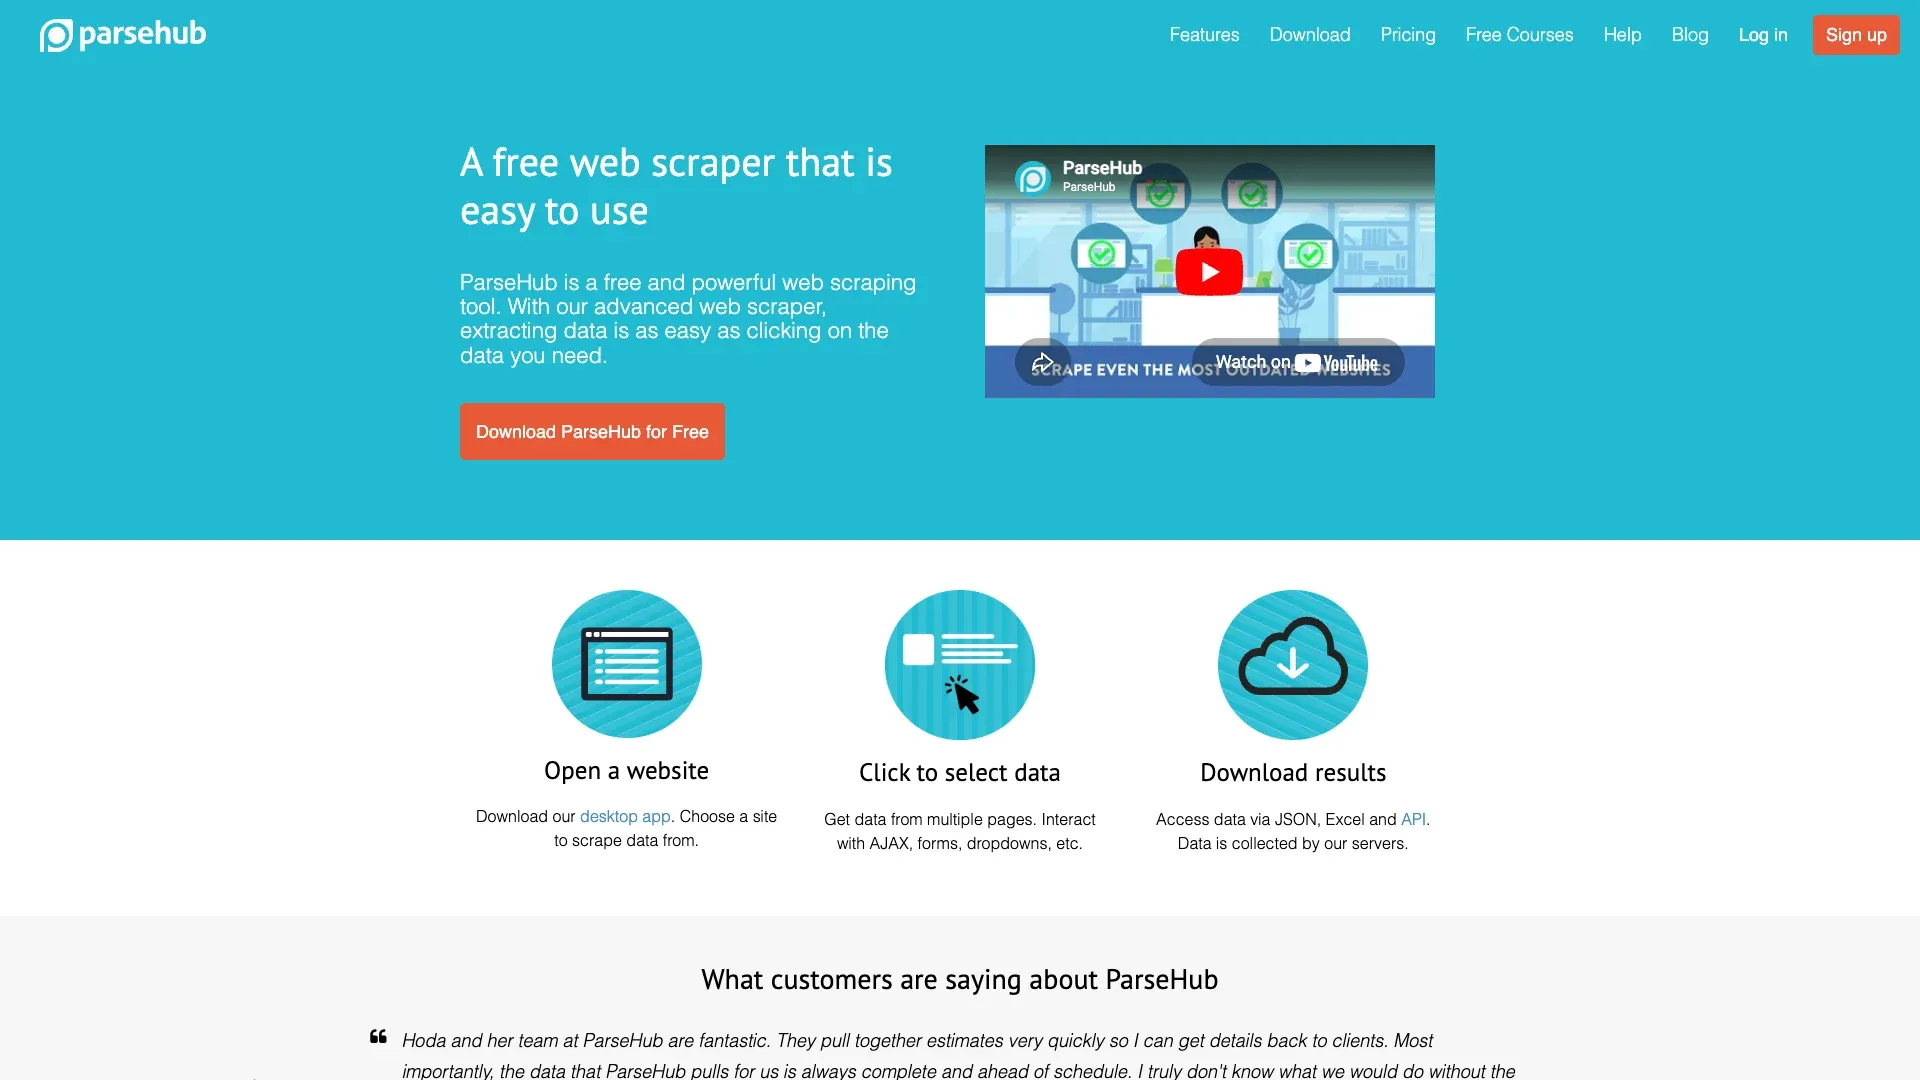
ParseHub هو Web Scraper مرئي للمستخدمين الذين يفضلون النقر داخل الصفحة وتعليم الأداة ما الذي يجب استخراجه. يمكنه التعامل مع كثير من الصفحات الديناميكية، ولا يزال خيارًا مألوفًا للفرق التي تريد أداة استخراج مرئية لسطح المكتب أو السحابة.
يكون ParseHub مفيدًا عندما يكون المستخدم مرتاحًا لبناء مشروع خطوة بخطوة: اختر عنصرًا، وسّع التحديد، أضف ترقيم الصفحات، اختبر التشغيل، ثم صدّر البيانات. وهو ليس «موجهًا بالمطالبات» مثل أدوات الذكاء الاصطناعي الأحدث، لكنه لا يزال فعالًا مع القوائم المنظمة، وصفحات المقالات، ومجموعات المنتجات.
الوصول المجاني: تاريخيًا، قدّم ParseHub مستوى مجانيًا لمشاريع محدودة وتشغيلات صفحات محدودة. تأكد من حدود المشاريع والصفحات الحالية على الموقع الرسمي قبل ذكر أي أرقام في نصوص الإنتاج.
الأفضل لـ: مشاريع استخراج مرئية صغيرة يكون المستخدم مستعدًا لقضاء بعض الوقت في إعدادها.
3. Octoparse
Octoparse منصة Web Scraping ناضجة بدون كود، مع قوالب، وبناء سير العمل، وتشغيل سحابي، وجدولة، ودعم للكثير من المواقع الديناميكية. وهي أغنى بالميزات من إضافة Chrome خفيفة، وقد يكون ذلك ميزة أو عبئًا بحسب المستخدم.
يُعد Octoparse خيارًا جيدًا عندما تكون مهمة الاستخراج متكررة، أو يكون الموقع المستهدف معقدًا، أو يريد الفريق منشئ سير عمل مرئيًا مع الجدولة والتنفيذ السحابي. قد يستغرق الإعداد وقتًا أطول من استخراج سريع مدعوم بالذكاء الاصطناعي، لكنه يمنح المستخدمين المتقدمين تحكمًا أكبر.
الوصول المجاني: يقدم Octoparse خطة مجانية، لكن حدود الميزات والسجلات قد تتغير. تحقّق من الحدود الحالية في صفحة تسعير Octoparse قبل نشر أرقام دقيقة.
الأفضل لـ: المستخدمين المتقدمين والفرق التي تحتاج تحكمًا مرئيًا في سير العمل، أو قوالب، أو جدولة، أو مهام متكررة.

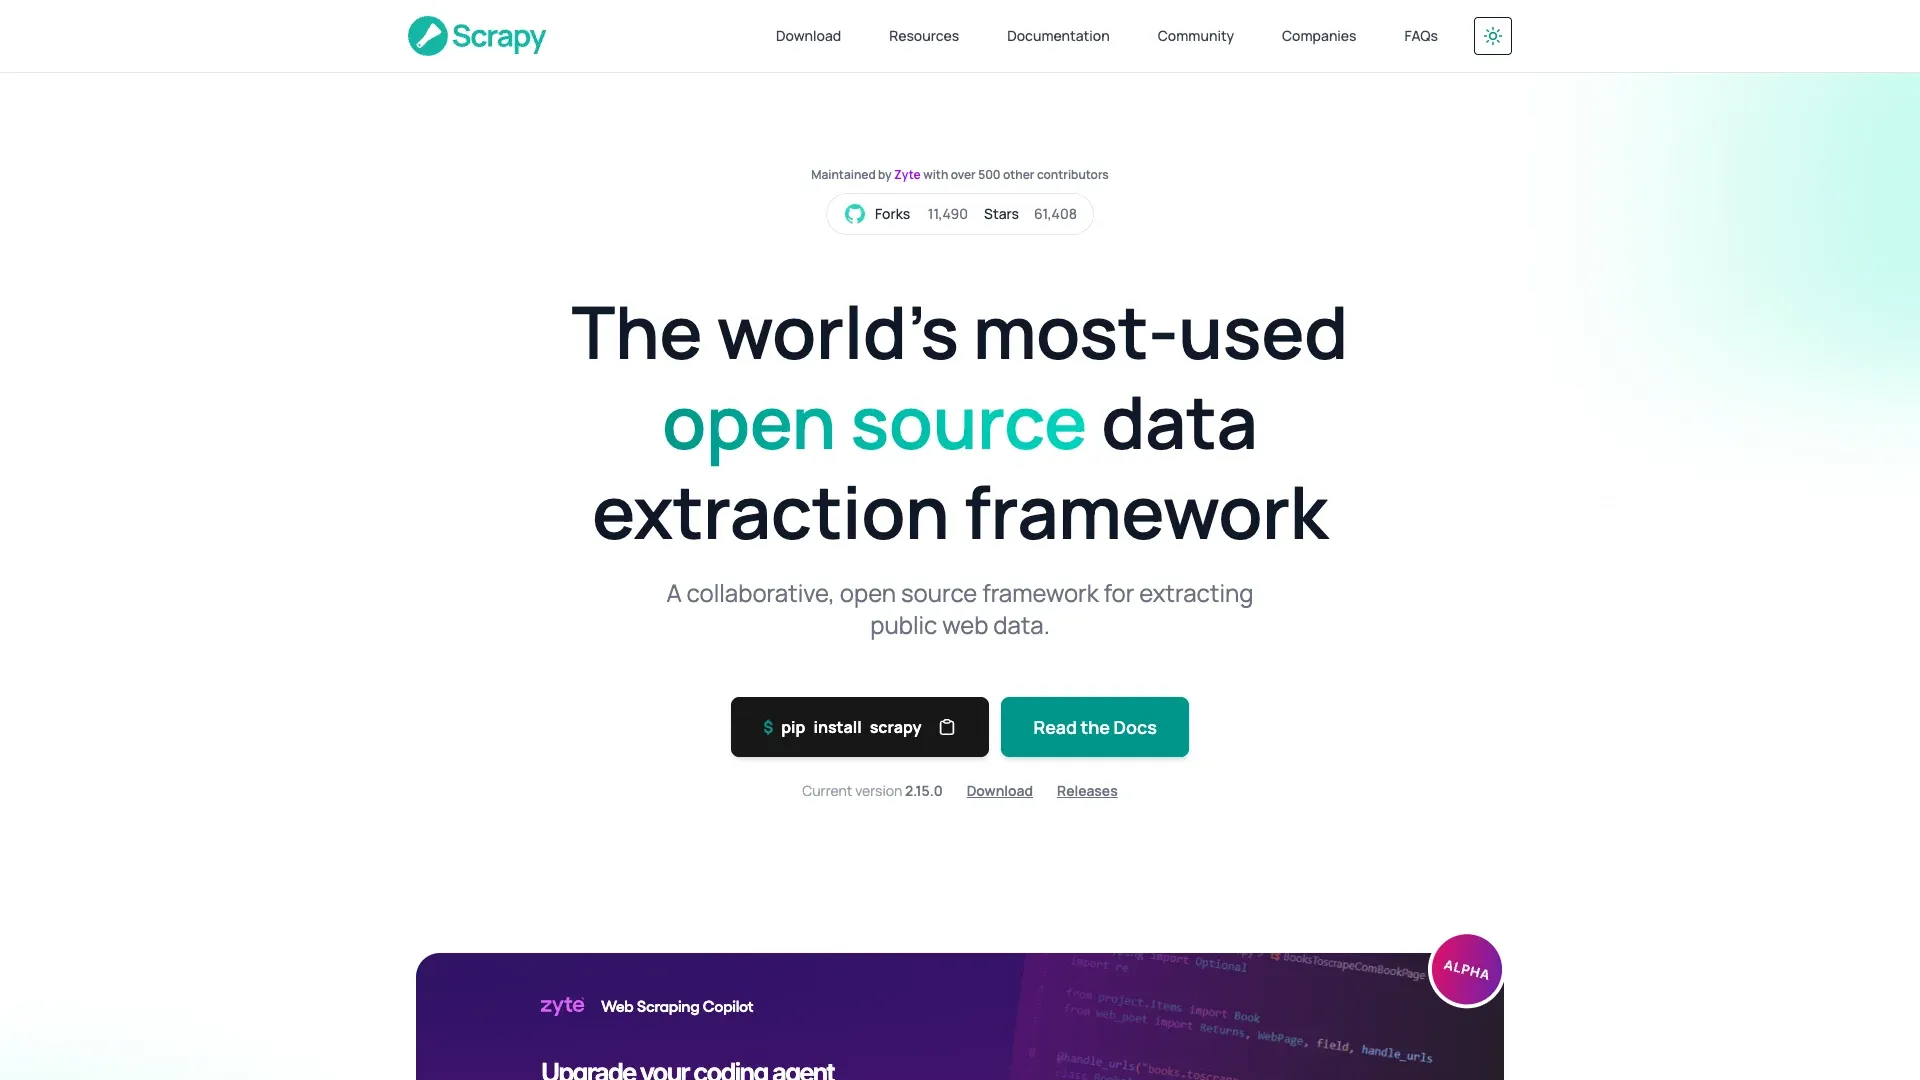
4. Scrapy
Scrapy ليس AI Scraper بدون كود. إنه إطار عمل Python مفتوح المصدر لبناء الزواحف وخطوط الاستخراج. وهذا الفرق مهم.
بالنسبة للمطورين، لا يزال Scrapy من أكثر الطرق مرونة لبناء أداة Scraper مخصصة. يمكنك التحكم في الطلبات والتحليل وإعادة المحاولة وخطوط المعالجة والتخزين والنشر. كما يمكن استخدام LLMs حول Scrapy: لصياغة المحددات، أو مراجعة منطق التحليل، أو توليد الاختبارات، أو شرح الأعطال. لكن Scrapy نفسه لا يزيل الجهد الهندسي.
الوصول المجاني: Scrapy مفتوح المصدر. البرنامج مجاني، لكن الاستضافة والبروكسيات والصيانة والمراقبة ووقت المطور ليست مجانية.
الأفضل لـ: المهندسين الذين يبنون أنظمة سكرابينغ مخصصة وقابلة للصيانة حيث تكون ملكية الكود مقبولة.
5. Data Miner
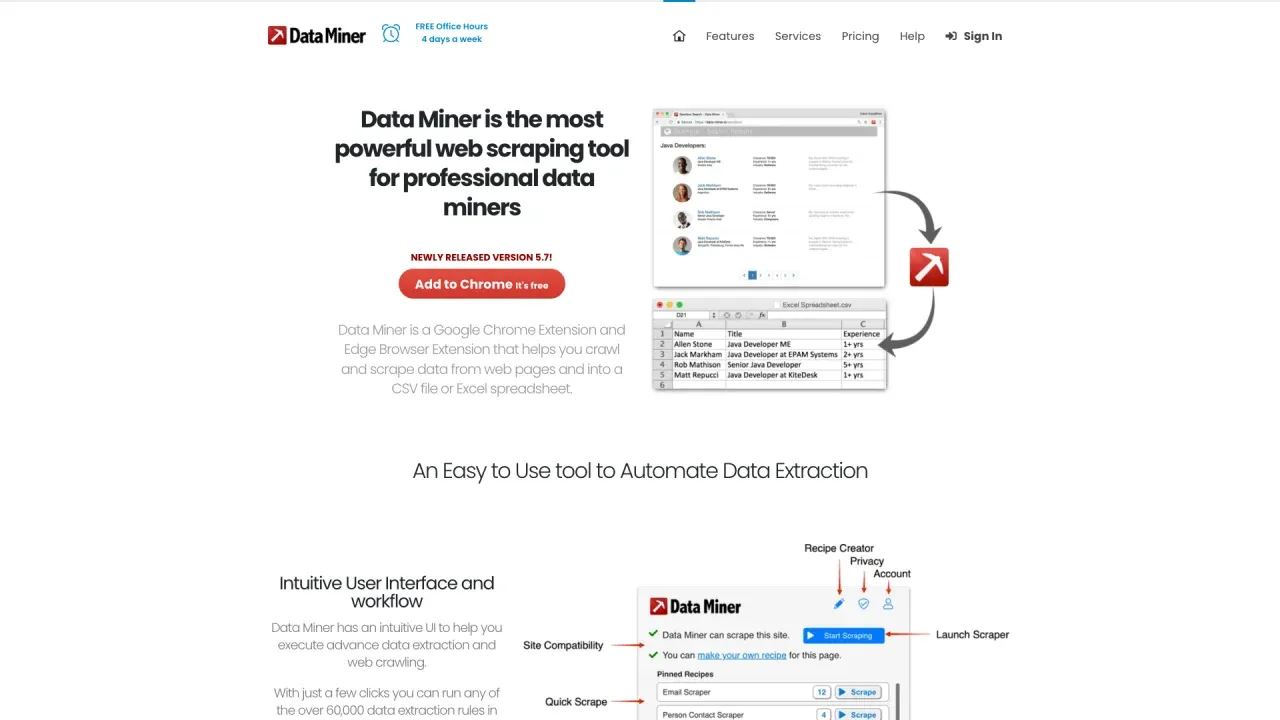
Data Miner إضافة متصفح تركز على استخراج الجداول والقوائم وأنماط الصفحات الشائعة. وتكمن ميزتها الأساسية في مكتبة الوصفات: إذا كانت هناك وصفة جاهزة لمصدرك، فقد يكون الإعداد سريعًا.
هذا مناسب للمستخدمين الذين يستخرجون مرارًا صفحات مألوفة ولا يحتاجون إلى منصة استخراج كاملة. وهو أقل مثالية عندما تكون الصفحة فوضوية أو شديدة الديناميكية أو تحتاج إلى ذكاء اصطناعي لاستنتاج الحقول من محتوى غامض.
الوصول المجاني: يقدم Data Miner استخدامًا مجانيًا محدودًا مع خطط مدفوعة للأحجام الأعلى. تحقّق من حدود الصفحات أو الأرصدة الحالية قبل ذكرها.
الأفضل لـ: الاستخراج السريع للبيانات الجدولية، والأدلة الشائعة، والمستخدمين الذين يفضلون سير العمل عبر إضافات المتصفح.
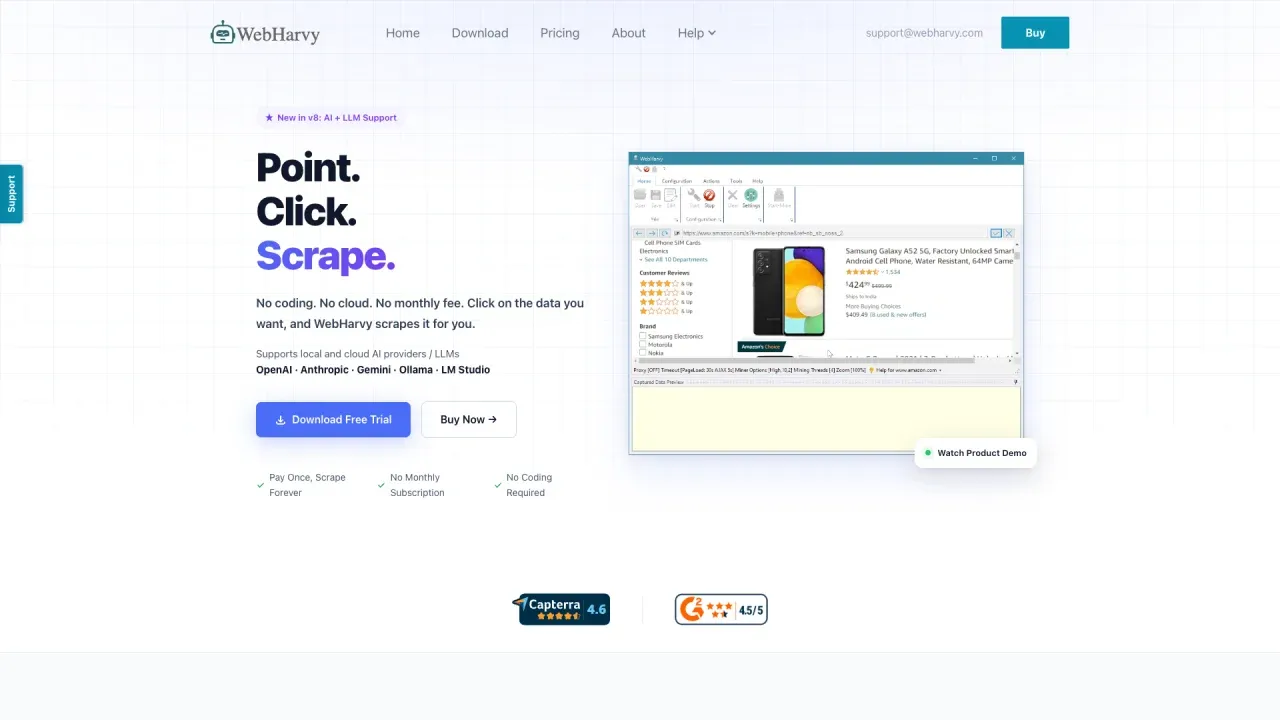
6. WebHarvy
WebHarvy هو أداة Scraper لسطح المكتب على Windows بواجهة مرئية وميزات لاكتشاف الأنماط. وهو مفيد للمستخدمين الذين يريدون النقر على أمثلة داخل الصفحة وترك الأداة تستنتج العناصر المشابهة.
يتفوق WebHarvy في صفحات المنتجات، والصفحات الغنية بالصور، وسير العمل المكتبي. وهو ليس أحدث خيار مبني على الذكاء الاصطناعي، لكنه قد ينجح جيدًا مع المستخدمين الذين يفضلون ترخيصًا لمرة واحدة وبرنامجًا محليًا على سطح المكتب.
الوصول المجاني: يتموضع WebHarvy عادةً حول نسخة تجريبية مدفوعة لاحقًا، وليس خطة مجانية مستمرة. تحقّق من الموقع الحالي قبل اعتباره أداة مجانية.
الأفضل لـ: مستخدمي Windows الذين يجرون استخراجًا لقوائم المنتجات والصور وأنماط الصفحات المتكررة.
7. Apify
Apify منصة سحابية صديقة للمطورين مخصصة للسكرابينغ وأتمتة المتصفح واستخراج البيانات. وأكبر عناصر الجذب فيها هو سوق الـ Actors: فبدلًا من البدء من سكربت فارغ، يمكن للفرق استخدام أو تعديل Actors موجودة لمواقع وسيناريوهات شائعة.
يُعد Apify من أقوى الخيارات عندما يحتاج السكرابينغ إلى أن يتحول إلى برمجية. فهو يدعم واجهات API والجدولة والتخزين وwebhooks وسير عمل المطورين. يمكن للذكاء الاصطناعي أن يساعد هنا أيضًا، لكن غالبًا كمساعد في بناء الـ Actors وتصحيحها والتحقق منها، لا كواجهة بنقرة واحدة لمستخدم الأعمال.
الوصول المجاني: لدى Apify نموذج قائم على خطة/أرصدة مجانية. راجع تسعير Apify والوثائق الحالية قبل ذكر حدود الحوسبة الدقيقة.
الأفضل لـ: المطورين وفرق الأتمتة والمشغلين التقنيين الذين يريدون بنية تحتية سحابية للسكرابينغ.

8. Diffbot
Diffbot منصة بيانات تعتمد على الذكاء الاصطناعي، معروفة باستخراج الكيانات المنظمة من صفحات الويب وبناء رسم معرفة ضخم. وهي أقرب إلى منصة API وذكاء بيانات منها إلى أداة Scraper مرئية.
يمكن أن يكون Diffbot قويًا عندما تكون المهمة هي استخراج الكيانات، أو تحليل المقالات والمنتجات، أو الإثراء، أو الفهم المنظم للويب على نطاق واسع. لكنه عادةً ليس أول أداة يلجأ إليها المستخدم غير التقني الذي يريد فقط النقر على صفحة ثم تصدير جدول.
الوصول المجاني: لدى Diffbot خطة مجانية ونماذج وصول للمطورين؛ راجع تسعير Diffbot الحالي للاطلاع على أحدث شروط الرصيد والتجربة.
الأفضل لـ: الفرق التقنية التي تحتاج استخراجًا منظّمًا عبر API، أو بيانات رسم معرفة، أو ذكاء الكيانات.
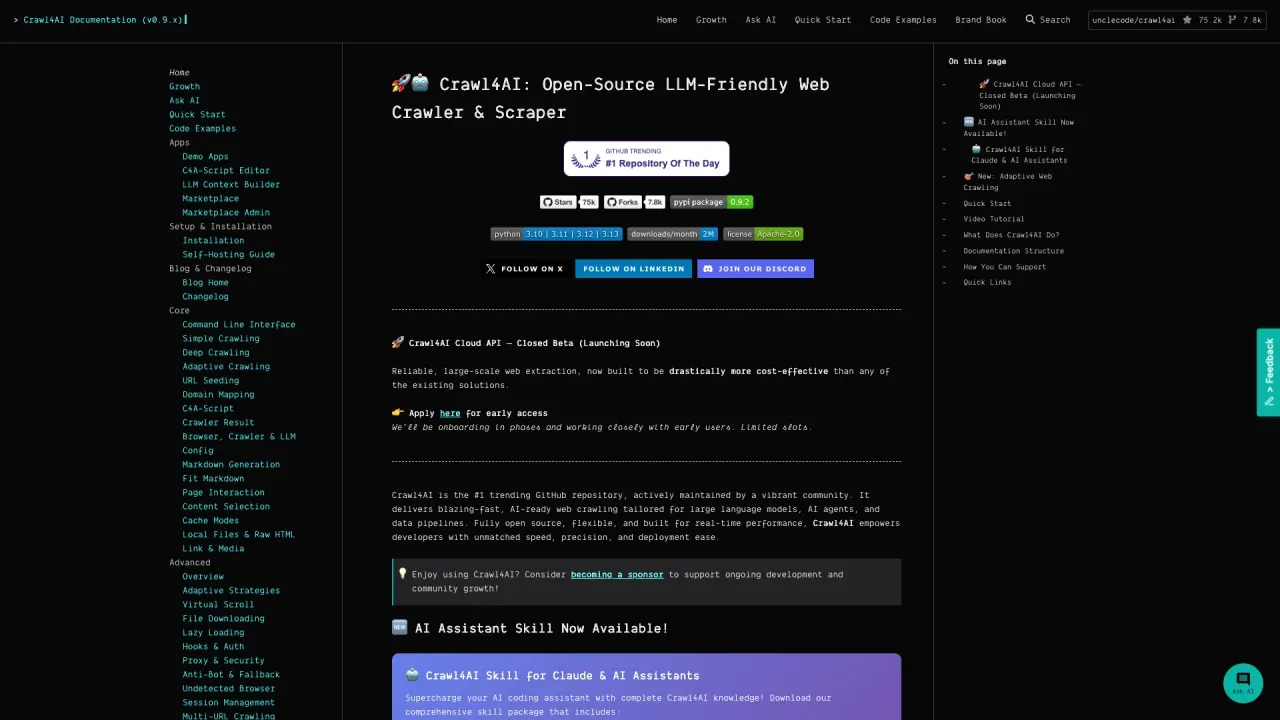
9. Crawl4AI
Crawl4AI هو زاحف ومُستخرج مفتوح المصدر ومناسب لـ LLMs، موجه للمطورين الذين يبنون وكلاء ذكاء اصطناعي، وخطوط RAG، وسير عمل بيانات مخصص. يمكنه إنتاج Markdown نظيف، واستخراج JSON منظم باستخدام CSS أو XPath، واستخدام LLM لتوليد مخطط استخراج قابل لإعادة الاستخدام عندما يناسب ذلك المهمة.
يُعد Crawl4AI خيارًا قويًا عندما يجب أن تصبح النتيجة جزءًا من سير عمل هندسي بدلًا من تصدير جدول لمرة واحدة. وهو يدعم التحكم في المتصفح، والزحف غير المتزامن، والجلسات، وخيارات الاستخراج الدقيقة، لكنه لا يزال يتطلب Python وملكية تقنية.
الوصول المجاني: مفتوح المصدر من دون مفتاح API إلزامي أو حاجز دفع للمنصة. لكن قد يتطلب الاستخراج المعتمد على LLM مزود LLM أو نموذجًا محليًا.
الأفضل لـ: المطورين الذين يبنون زواحف جاهزة للذكاء الاصطناعي، أو إدخال RAG، أو خطوط بيانات منظمة قابلة للتكرار.
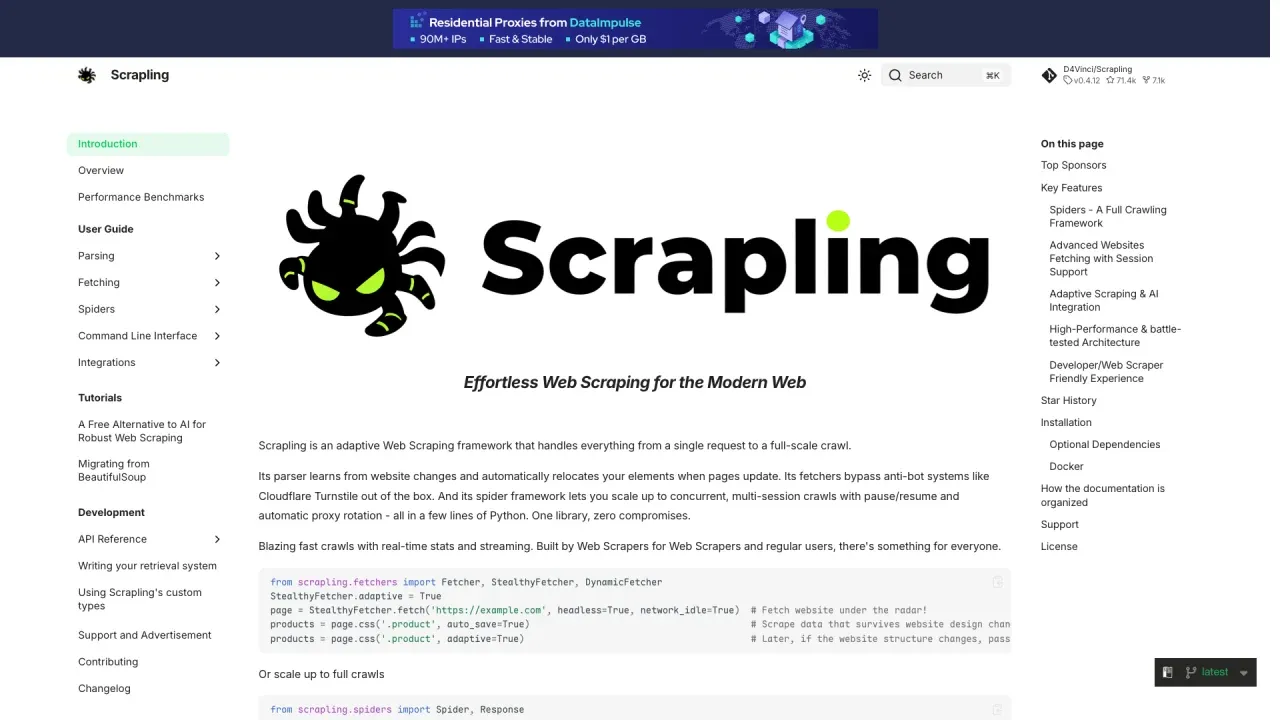
10. Scrapling
Scrapling إطار عمل Python تكيفي للسكرابينغ يغطي الطلبات المفردة، والجلب المعتمد على المتصفح، والزحف الكامل. صُمم التحليل التكيفي فيه لمساعدة الأداة على إعادة تحديد مواقع العناصر عندما يتغير الموقع، ما قد يقلل عبء إصلاح المحددات في مشروع سكرابينغ مملوك للكود.
هو ليس أداة ذكاء اصطناعي بدون كود: فما زالت الفرق بحاجة إلى تعريف منطق الاستخراج واختباره وامتلاك بيئة التشغيل. لكنه بديل حديث لمدخل الأدوات المرئية القديمة لأنه موثّق بشكل نشط وأكثر ملاءمة لمكدسات السكرابينغ الحالية المعتمدة على Python.
الوصول المجاني: مفتوح المصدر. أما البنية التحتية وخدمات البروكسي وتشغيل المتصفح ووقت الهندسة فتبقى تكاليف منفصلة.
الأفضل لـ: مطوري Python الذين يريدون سكرابينغ تكيفيًا ومسارًا من جلب واحد إلى زحف متزامن.
جدول المقارنة: أدوات AI Web Scraping المجانية
| الأداة | النوع | المسار المجاني | هل هي مبنية على الذكاء الاصطناعي؟ | أفضل استخدام |
|---|---|---|---|---|
| Thunderbit | AI Chrome scraper | استخدام ابتدائي مجاني | نعم | مستخدمو الأعمال الذين يحتاجون بيانات ويب منظمة بسرعة |
| ParseHub | أداة استخراج مرئية | خطة مجانية محدودة | جزئي | المشاريع المرئية الصغيرة |
| Octoparse | منصة سكرابينغ بدون كود | خطة/نسخة تجريبية مجانية | جزئي إلى قوي | المستخدمون المتقدمون والمهام المتكررة بدون كود |
| Scrapy | إطار عمل Python | مفتوح المصدر | لا، لكن البرمجة المدعومة بالذكاء الاصطناعي تعمل | المطورون الذين يبنون أدوات Scraper مخصصة |
| Data Miner | إضافة متصفح | استخدام مجاني محدود | محدود | الجداول والقوائم والاستخراج المبني على الوصفات |
| WebHarvy | أداة استخراج مرئية لويندوز | نسخة تجريبية مجانية | محدود | استخراج المنتجات/الصور على سطح المكتب |
| Apify | منصة أتمتة سحابية | رصيد/خطة مجانية | مرتبط بالمطورين والذكاء الاصطناعي | خطوط سكرابينغ تقنية |
| Diffbot | واجهة API لاستخراج البيانات بالذكاء الاصطناعي | رصيد/خطة مجانية | نعم | استخراج الكيانات وسير عمل الرسم المعرفي |
| Crawl4AI | زاحف مفتوح المصدر جاهز للذكاء الاصطناعي | مفتوح المصدر | نعم/صديق لـ LLM | RAG، ووكلاء الذكاء الاصطناعي، وخطوط المطورين |
| Scrapling | إطار عمل Python تكيفي للسكرابينغ | مفتوح المصدر | مرتبط بالذكاء الاصطناعي/تكيفي | سكرابينغ مملوك للكود يحتاج إلى مرونة في المحددات |
كيف تختار الأداة المناسبة
ابدأ بالمصدر والمستخدم، لا باسم العلامة التجارية.
إذا كانت البيانات على صفحات ويب عامة والمستخدم غير تقني، فابدأ بـ Thunderbit أو ParseHub أو Octoparse أو Data Miner. هذه الأدوات أقرب إلى سير العمل الفعلي للأعمال: افتح المصدر، حدّد الحقول، شغّل اختبارًا، راجع الصفوف، ثم صدّر.
إذا كانت المهمة تحتاج منطقًا مخصصًا أو معالجة للمصادقة أو تنسيقًا بين المهام أو واجهات API أو نشرًا، فانظر إلى Scrapy أو Apify. هنا تكون الملكية الهندسية منطقية. استخدم الذكاء الاصطناعي لتسريع مراجعة المحددات وتوليد الاختبارات، لكن أبقِ المراجعة البشرية على الالتزام ومعالجة الأعطال وجودة البيانات.
إذا كانت الشركة تحتاج إلى استخراج كيانات عبر API أو إثراء البيانات أو رسم معرفة منظم، فقارن Diffbot مع متطلباتك من حيث شروط التجربة وتغطية البيانات وملاءمة الـ API. أما تدفقات البيانات المُدارة الأوسع، فتعامل معها عبر عملية شراء مخصصة بدلًا من اعتبارها مجرد خيار مجاني للسكرابينغ.
إذا بدا موقع أداة ما أو وثائقها قديمة، فلا تستخدمها في الأعمال الحساسة. اختبرها أولًا على صفحة عامة غير ضارة، وتحقق من التصدير، وتأكد من أن المنتج ما زال مدعومًا.
قائمة تحقق بسيطة للتحقق قبل التصدير
قبل تشغيل عملية استخراج كبيرة، اختبر عينة صغيرة:
- هل تمثل كل صف الكيان الصحيح؟
- هل اختلطت العناصر الممولة أو المكررة أو الموصى بها مع البيانات؟
- هل توقفت صفحات الترقيم أو التمرير اللانهائي مبكرًا؟
- هل تم تحليل الأسعار والتواريخ ورسائل البريد والأرقام بشكل متسق؟
- هل تمت مطابقة حقول الصفحات الفرعية مع الصف الأب الصحيح؟
- هل يحافظ شكل التصدير على المخطط الذي تحتاجه؟
- هل يُسمح لك بجمع هذه البيانات واستخدامها لغرضك؟
يمكن للذكاء الاصطناعي أن يسرّع الإعداد، لكنه قد يجعل الاستخراج الخاطئ يبدو نظيفًا. وما زالت مراجعة 20 صفًا من أفضل وأقل الطرق تكلفة لتجنب مجموعة بيانات سيئة.
التوصية النهائية
بالنسبة لمعظم مستخدمي الأعمال، ابدأ بأسرع سير عمل آمن: استخدم AI Scraper بدون كود، اختبر على عينة صغيرة، تحقّق من المخطط، ثم صدّر إلى النظام الذي سيستكمل فيه العمل.
Thunderbit هو الأنسب عندما تكون المهمة بيانات ويب عامة ويريد المستخدم سير عمل عمليًا مدعومًا بالذكاء الاصطناعي داخل المتصفح. أما ParseHub وOctoparse وData Miner فجديرة بالاختبار إذا كنت تفضّل منشئي المشاريع المرئية أو الاستخراج المبني على الوصفات. ويكون Scrapy وCrawl4AI وScrapling وApify أفضل عندما يحتاج الـ Scraper إلى أن يصبح كودًا أو بنية تحتية. أما Diffbot فهو خيار متخصص عندما يكون استخراج الكيانات أو بيانات الرسم المعرفي أهم من سير العمل القائم على المتصفح.
أفضل أداة ليست صاحبة أطول قائمة ميزات. بل هي التي تمنحك بيانات منظمة وموثوقة مع أقل قدر من الصيانة المستمرة لفريقك.
الأسئلة الشائعة
ما هو AI web scraper؟
AI web scraper يستخدم التعلم الآلي أو LLMs أو الرؤية الحاسوبية أو فهم الصفحات الذكي للمساعدة في تحديد الحقول واستخراج البيانات المنظمة أو التكيف مع الصفحات الفوضوية. ومع ذلك، أفضل الأدوات ما زالت تتيح لك مراجعة الناتج وتصحيحه.
هل أدوات AI web scraper المجانية مجانية فعلًا؟
بعضها يقدم استخدامًا مجانيًا ابتدائيًا، وبعضها نسخة تجريبية، وبعضها مفتوح المصدر. و«مجاني» لا يعني دائمًا مجانيًا على نطاق واسع. تحقّق من حدود الصفحات، وحدود الأرصدة، وقيود التصدير، وما إذا كانت التشغيلات السحابية مشمولة.
ما أفضل AI web scraper مجاني لغير التقنيين؟
Thunderbit هو أفضل نقطة بداية للفرق غير التقنية التي تريد استخراج المواقع العامة إلى جداول منظمة. كما أن ParseHub وOctoparse وData Miner مفيدة أيضًا، بحسب ما إذا كنت تفضل المشاريع المرئية أو القوالب أو وصفات المتصفح.
متى أستخدم Scrapy أو Apify بدل أداة بدون كود؟
استخدم Scrapy أو Apify عندما تحتاج إلى منطق مخصص أو تحكمًا للمطورين أو واجهات API أو جدولة أو مراقبة أو دمجًا داخل سير عمل برمجي أكبر. فهي قوية، لكنها تتطلب ملكية أكبر.
هل يمكن لأدوات AI web scraper التعامل مع ترقيم الصفحات والصفحات الفرعية؟
تستطيع كثير من الأدوات الحديثة ذلك، لكن يجب اختبارها بعناية. فترقيم الصفحات والتمرير اللانهائي والصفحات الفرعية من أكثر الأماكن التي تتوقف فيها الأدوات مبكرًا أو تخلط بيانات صفحة التفاصيل مع الصف الخاطئ.
هل من القانوني سكرابينغ المواقع؟
يعتمد ذلك على الموقع ونوع البيانات والولاية القضائية وحالة الاستخدام. راجع شروط الموقع وملف robots.txt وقيود تسجيل الدخول والالتزامات المتعلقة بالخصوصية ومتطلبات الامتثال الداخلية قبل جمع أو استخدام البيانات المستخرجة.
اعرف المزيد
- كيفية استخراج أي موقع باستخدام الذكاء الاصطناعي
- أفضل 5 برامج Web Data Scraping في 2026
- 7 من أشهر أدوات Web Scraping لاستخدامها في 2026
- أفضل 10 أدوات AI Web Scraper لتعزيز الإنتاجية في 2025
- أفضل 8 AI Web Scrapers لاستخدامها لاستخراج بيانات أذكى
جرّب AI Web Scraper Get Started Free




