Twitter 帖子爬虫:让推文与线程上下文保持在一起








让 Twitter 帖子与对话上下文保持完整
同时查看帖子、附近上下文,以及你能够访问的互动数据。
将每条帖子整理成一行清晰数据
Thunderbit 会读取推文中可见的内容和附近上下文——作者、正文、数据统计、引用或回复对象,以及媒体内容——并在抓取时写入各个字段。无需编写规则。
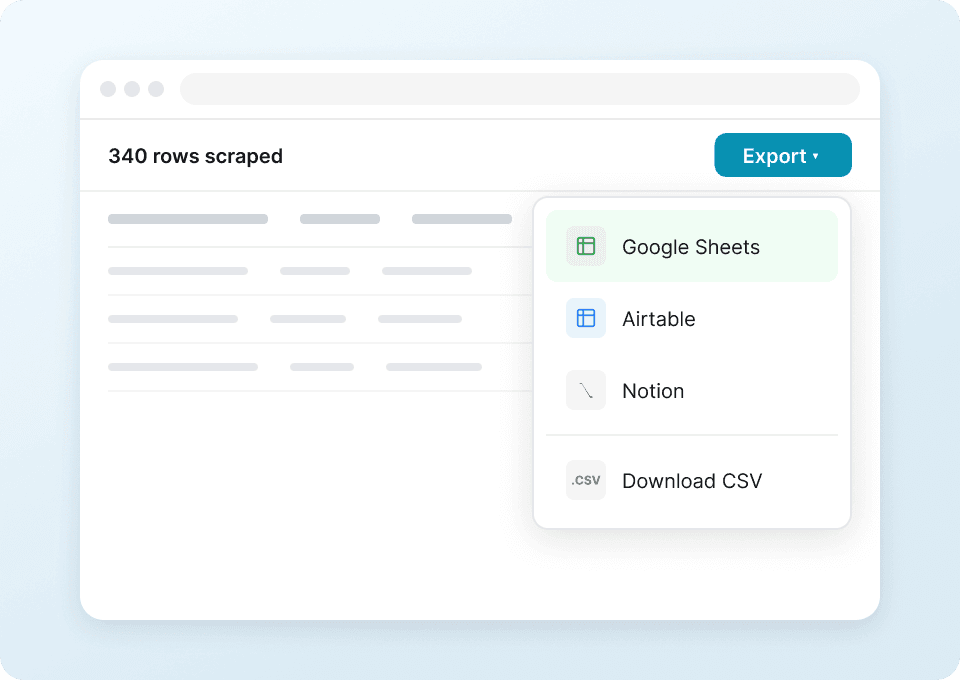
直接导出 Twitter 帖子数据
你可以将抓取到的字段导出到 Google Sheets、Excel、Airtable 或 Notion,也可以保留为 CSV 文件。
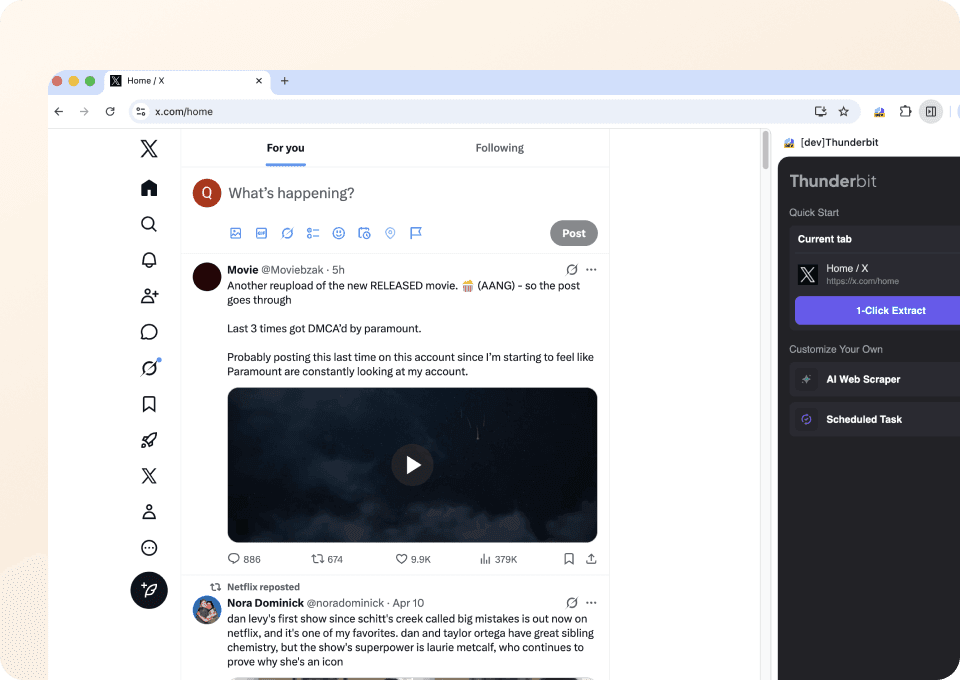
一键抓取 Twitter 帖子
在 Agent Mode 下,系统会自动建议字段并一并完成抓取。在开始前,你只需用简单语言告诉代理要包含什么或跳过什么。
复制下来的 Twitter 线程,往往会丢失上下文
手动记录会把帖子、作者、媒体、引用和回复拆散。Thunderbit 会把可见上下文保留在一起。
来自实时线程的零散记录
链接和数据统计彼此脱节由 Thunderbit 生成的帖子数据行
可见上下文始终与帖子绑定帖子、引用和回复的字段
仅在你可访问的页面中显示时才会包含。
- post_url
- post_text
- posted_datetime
- author_display_name
- author_username
- author_profile_url
- author_profile_image_url
- verified_badge
- pinned_label
- reply_count
- repost_count
- like_count
- quote_count
- view_count
- hashtags
- mentions
- cashtags
- media_type
- media_urls
- attached_media_count
- external_link_url
- link_domain
- card_title
- card_description
- card_thumbnail_url
- in_reply_to_username
- in_reply_to_post_url
- sensitive_content_warning
- poll_question
- location_name
See conversation research move into rows
In user videos, people show how Thunderbit turns posts, authors, links, and public response counts into clear rows.
帖子级研究常见问题
帮助你研究可见的公开 Twitter 帖子。
Study more of a Twitter conversation
Use ready‑made agents for profile bios, search results, thread steps, and media cards.
Minds 爬虫
Thunderbit Minds 爬虫借助 AI 智能字段推荐,帮助你高效提取 Minds 动态和群组成员数据。无论是研究、营销还是社群分析,都能快速获取帖子标题、作者、点赞数、评论数及群成员信息,并导出为结构化数据。
了解更多 ->
MeWe 爬虫
Thunderbit MeWe 爬虫可帮助你通过 AI 智能字段推荐,批量提取 MeWe 用户资料和群组帖子数据。支持采集用户名、简介、加入时间、帖子内容、点赞数和评论数,适用于调研、营销或数据分析。非常适合需要结构化 MeWe 数据的市场人员、研究者和企业。
了解更多 ->
Parler 爬虫
Thunderbit Parler 爬虫可帮助你通过 AI 智能字段推荐,从 Parler 搜索结果和话题标签列表中提取数据。无论是搜索词、用户帖子、标签还是热度分数等信息,都能一键获取,助力研究、营销或内容分析。非常适合需要结构化 Parler 数据的市场人员、研究者和企业。
了解更多 ->
Element 爬虫
Thunderbit Element 爬虫可帮助你从 Element Synapse 管理员房间中提取数据,AI 智能识别字段。你可以收集消息 ID、发送者名称、时间戳、消息内容和附件,便于后续分析或监控。非常适合开发者、社区管理者和研究人员获取结构化的 Element 数据。
了解更多 ->
Odnoklassniki 爬虫
Thunderbit Odnoklassniki 爬虫可帮助你通过 AI 智能字段推荐,快速提取 Odnoklassniki 群组和游戏列表的数据。支持采集群组名称、简介、成员数、游戏详情、评分等信息,适用于调研、营销或数据分析。非常适合需要结构化 Odnoklassniki 数据的市场人员、研究者和企业。
了解更多 ->
Triller 爬虫
Thunderbit Triller 爬虫可帮助你从 Triller 博客页面和创作者集体资料中提取数据。借助 AI 智能字段推荐,快速收集博客标题、发布时间、作者姓名、创作者简介和粉丝数量,助力调研、营销或数据分析。
了解更多 ->准备好大幅提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 200,000+ 专业人士。
免费试用可为 8 个网页提供无限额度。



