Tumblr 爬虫








使用 Thunderbit 解锁 Tumblr 数据
轻松提取 Tumblr 数据,例如帖子内容和点赞数。
还原完整的 Tumblr 内容
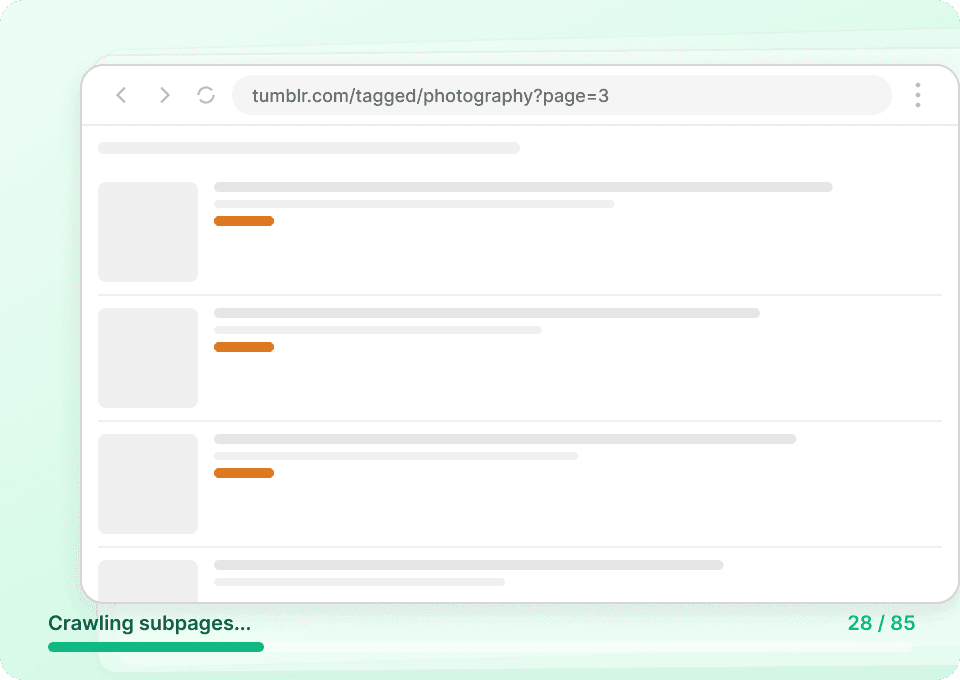
Tumblr 的列表页通常只显示摘要。想看到完整信息,就需要帖子全文、作者详情以及所有相关元数据。Thunderbit 会自动访问每个关联的帖子页面,提取完整内容,并将其追加为新列——这样你无需手动逐个点击,也能抓到帖子 ID、发布时间等更多信息。
自动化你的 Tumblr 数据采集
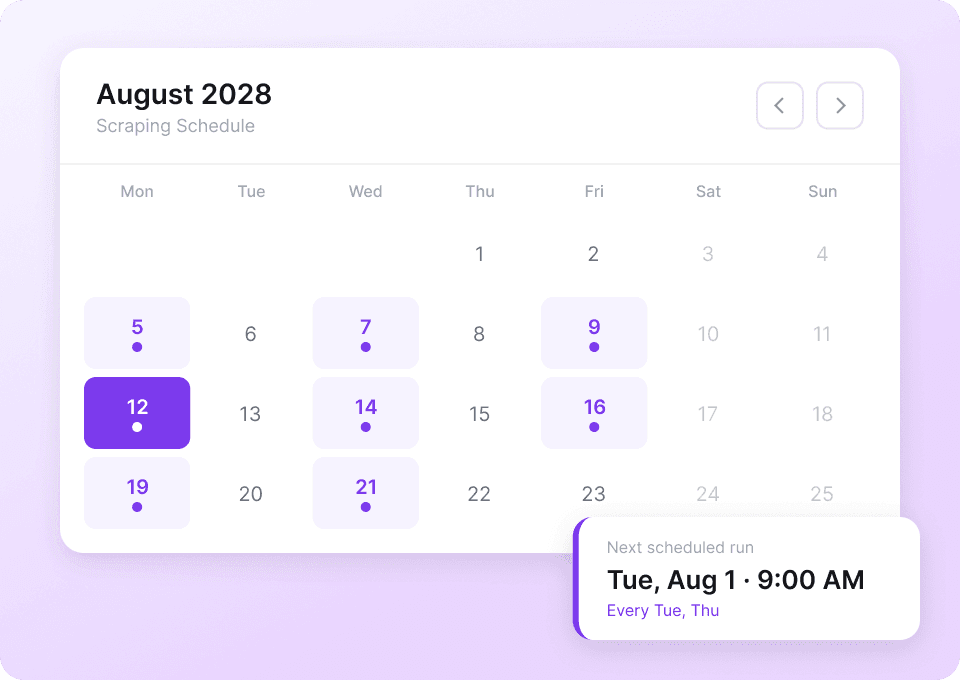
Tumblr 数据变化非常快。每次手动回到同样的博客重新抓取,既耗时又容易出错。借助 Thunderbit 的定时爬取功能,你可以设置周期性自动提取,完全自动运行。最新的点赞数和帖子内容会直接送到 Google Sheets,无需任何手动操作。
两次点击抓取 Tumblr 帖子
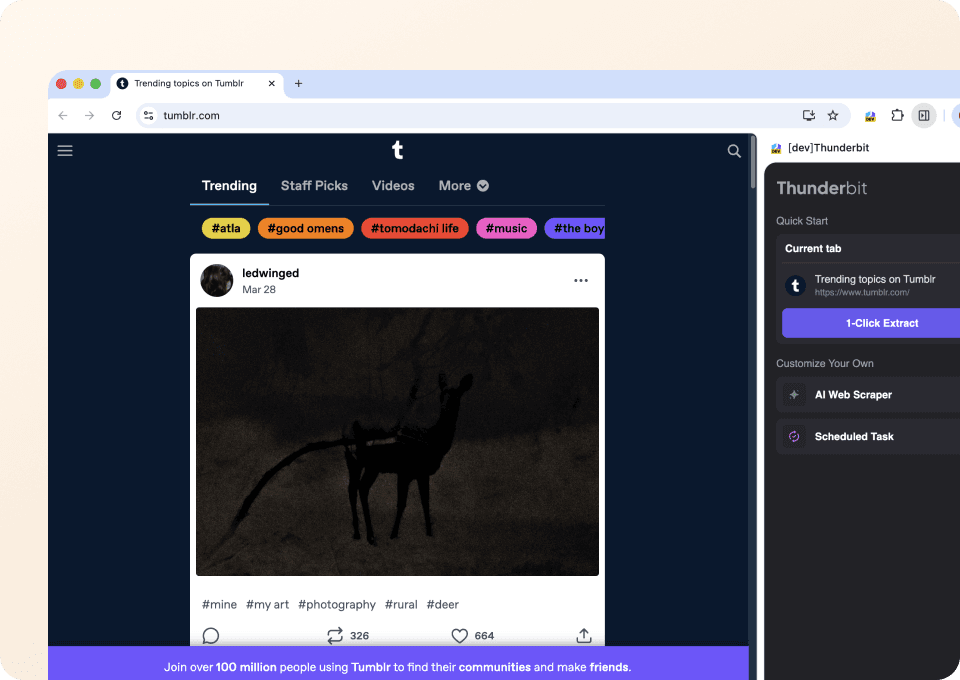
无需代码,也不需要 CSS 选择器。Thunderbit 只要两次点击就能帮你提取 Tumblr 数据。你只需指向想要的内容——帖子类型、作者、正文、点赞数——Thunderbit 的语义 AI 就会识别相关字段并自动提取所有信息。
Thunderbit 为什么不同于传统 Tumblr 爬虫?
即使布局发生变化,或者意外调整,也能轻松提取 Tumblr 数据。
传统爬虫
老派的做法Thunderbit AI
更聪明的方案
常见问题
相关 应用场景
探索 Thunderbit 网页爬虫的更多应用场景。
Minds 爬虫
Thunderbit Minds 爬虫借助 AI 智能字段推荐,帮助你高效提取 Minds 动态和群组成员数据。无论是研究、营销还是社群分析,都能快速获取帖子标题、作者、点赞数、评论数及群成员信息,并导出为结构化数据。
了解更多 ->
MeWe 爬虫
Thunderbit MeWe 爬虫可帮助你通过 AI 智能字段推荐,批量提取 MeWe 用户资料和群组帖子数据。支持采集用户名、简介、加入时间、帖子内容、点赞数和评论数,适用于调研、营销或数据分析。非常适合需要结构化 MeWe 数据的市场人员、研究者和企业。
了解更多 ->
Parler 爬虫
Thunderbit Parler 爬虫可帮助你通过 AI 智能字段推荐,从 Parler 搜索结果和话题标签列表中提取数据。无论是搜索词、用户帖子、标签还是热度分数等信息,都能一键获取,助力研究、营销或内容分析。非常适合需要结构化 Parler 数据的市场人员、研究者和企业。
了解更多 ->
Element 爬虫
Thunderbit Element 爬虫可帮助你从 Element Synapse 管理员房间中提取数据,AI 智能识别字段。你可以收集消息 ID、发送者名称、时间戳、消息内容和附件,便于后续分析或监控。非常适合开发者、社区管理者和研究人员获取结构化的 Element 数据。
了解更多 ->
Odnoklassniki 爬虫
Thunderbit Odnoklassniki 爬虫可帮助你通过 AI 智能字段推荐,快速提取 Odnoklassniki 群组和游戏列表的数据。支持采集群组名称、简介、成员数、游戏详情、评分等信息,适用于调研、营销或数据分析。非常适合需要结构化 Odnoklassniki 数据的市场人员、研究者和企业。
了解更多 ->
Triller 爬虫
Thunderbit Triller 爬虫可帮助你从 Triller 博客页面和创作者集体资料中提取数据。借助 AI 智能字段推荐,快速收集博客标题、发布时间、作者姓名、创作者简介和粉丝数量,助力调研、营销或数据分析。
了解更多 ->准备好大幅提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 200,000+ 专业人士。
免费试用可为 8 个网页提供无限额度。



