跨平台公开数据社交媒体爬虫








无需重做流程,也能采集公开社交数据
让 AI 处理不断变化的页面布局,批量处理 URL 列表,并在需要更深层字段时打开关联页面。
页面布局变了,也能继续采集
Thunderbit 会读取页面中可见的标签和内容,而不只是依赖固定选择器。即使公开主页或帖子页面结构发生变化,工作流也不需要频繁手动修补。
批量处理资料和帖子 URL
把你想研究的公开页面贴进去,一次性批量处理。用户名、说明文字、日期和可见互动数据都可以直接整理成可审核、可导出的表格行。
把关联详情带进同一张表
当列表页只是起点时,子页面抓取可以打开可访问的资料页或帖子页,并把你需要的可见信息追加为新列。
别再按平台一个个重建社交爬虫了
传统工具会把每种布局分别编码。Thunderbit 则保留一套 AI 工作流,并识别各平台可见的字段标签。
一堆按平台拆分的爬虫
每接一个来源都要重新配置一次一个智能代理,处理你选定的公开页面
Thunderbit 会自动适配你要求的字段30 个适用于公开社交研究的实用字段
不同平台可获取的内容和指标名称各不相同。请始终把来源平台和页面类型放在每个抓取值旁边。
- 平台名称
- 来源页面类型
- 来源 URL
- 资料 ID
- 资料用户名
- 资料显示名称
- 资料 URL
- 资料头像 URL
- 资料简介
- 资料网站 URL
- 资料认证状态
- 粉丝数
- 关注数
- 订阅数
- 帖子 ID
- 帖子 URL
- 帖子正文或说明
- 帖子发布时间
- 帖子类型
- 媒体类型
- 主要媒体 URL
- 话题标签列表
- 提及账号
- 帖子点赞数
- 帖子评论数
- 帖子分享数
- 帖子观看数
- 评论 ID
- 评论内容
- 评论作者用户名
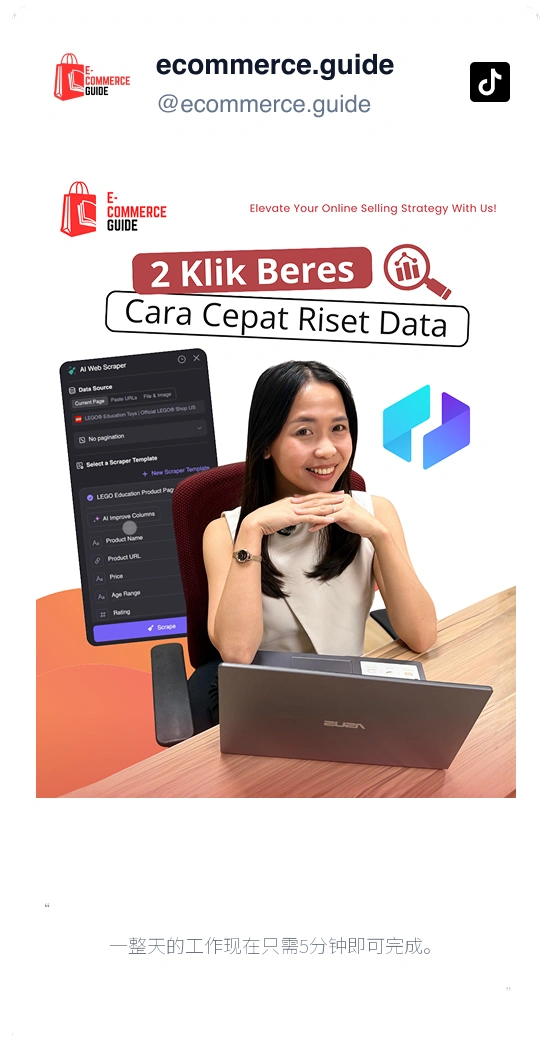
Hear how teams use one scraper across the web
Thunderbit users share how they collect public data from changing pages without maintaining a separate tool for every source.
构建可自证合理的社交媒体数据集时会遇到的问题
跨平台范围、指标含义、公开访问权限与字段结构选择。
Switch to a platform-specific scraper when precision matters
Use dedicated TikTok comments, Telegram channel, Patreon membership, YouTube, Instagram, or X pages when the task depends on platform-only entities, fields, or interaction patterns.
Minds 爬虫
Thunderbit Minds 爬虫借助 AI 智能字段推荐,帮助你高效提取 Minds 动态和群组成员数据。无论是研究、营销还是社群分析,都能快速获取帖子标题、作者、点赞数、评论数及群成员信息,并导出为结构化数据。
了解更多 ->
MeWe 爬虫
Thunderbit MeWe 爬虫可帮助你通过 AI 智能字段推荐,批量提取 MeWe 用户资料和群组帖子数据。支持采集用户名、简介、加入时间、帖子内容、点赞数和评论数,适用于调研、营销或数据分析。非常适合需要结构化 MeWe 数据的市场人员、研究者和企业。
了解更多 ->
Parler 爬虫
Thunderbit Parler 爬虫可帮助你通过 AI 智能字段推荐,从 Parler 搜索结果和话题标签列表中提取数据。无论是搜索词、用户帖子、标签还是热度分数等信息,都能一键获取,助力研究、营销或内容分析。非常适合需要结构化 Parler 数据的市场人员、研究者和企业。
了解更多 ->
Element 爬虫
Thunderbit Element 爬虫可帮助你从 Element Synapse 管理员房间中提取数据,AI 智能识别字段。你可以收集消息 ID、发送者名称、时间戳、消息内容和附件,便于后续分析或监控。非常适合开发者、社区管理者和研究人员获取结构化的 Element 数据。
了解更多 ->
Odnoklassniki 爬虫
Thunderbit Odnoklassniki 爬虫可帮助你通过 AI 智能字段推荐,快速提取 Odnoklassniki 群组和游戏列表的数据。支持采集群组名称、简介、成员数、游戏详情、评分等信息,适用于调研、营销或数据分析。非常适合需要结构化 Odnoklassniki 数据的市场人员、研究者和企业。
了解更多 ->
Triller 爬虫
Thunderbit Triller 爬虫可帮助你从 Triller 博客页面和创作者集体资料中提取数据。借助 AI 智能字段推荐,快速收集博客标题、发布时间、作者姓名、创作者简介和粉丝数量,助力调研、营销或数据分析。
了解更多 ->准备好大幅提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 200,000+ 专业人士。
免费试用可为 8 个网页提供无限额度。


