房地产爬虫:跨房产网站对比房源列表





跨房产网站对比房源列表
适配不同页面布局,重新查看目标市场,并为每套房源保留一行干净数据。
无需逐站配置选择器
Thunderbit 会识别价格、状态、卧室数、浴室数和面积的可见含义,因此你无需为每种页面布局单独编写 CSS 规则,也能跨房产网站工作。
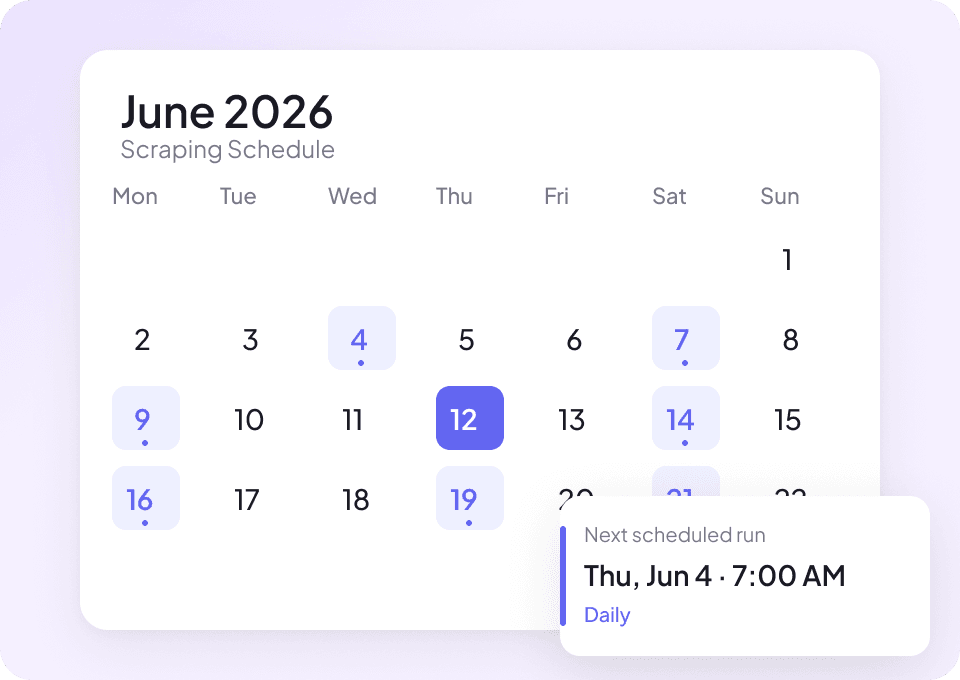
按计划刷新房源数据
可对同一个搜索页或房源页重新运行任务,获取价格、状态或可售情况的最新视图。
每套房源都保留为一行整洁数据
来源、地址、价格、房屋信息、经纪人和状态会分别存放在不同列中。网页未展示的字段会保持空白。
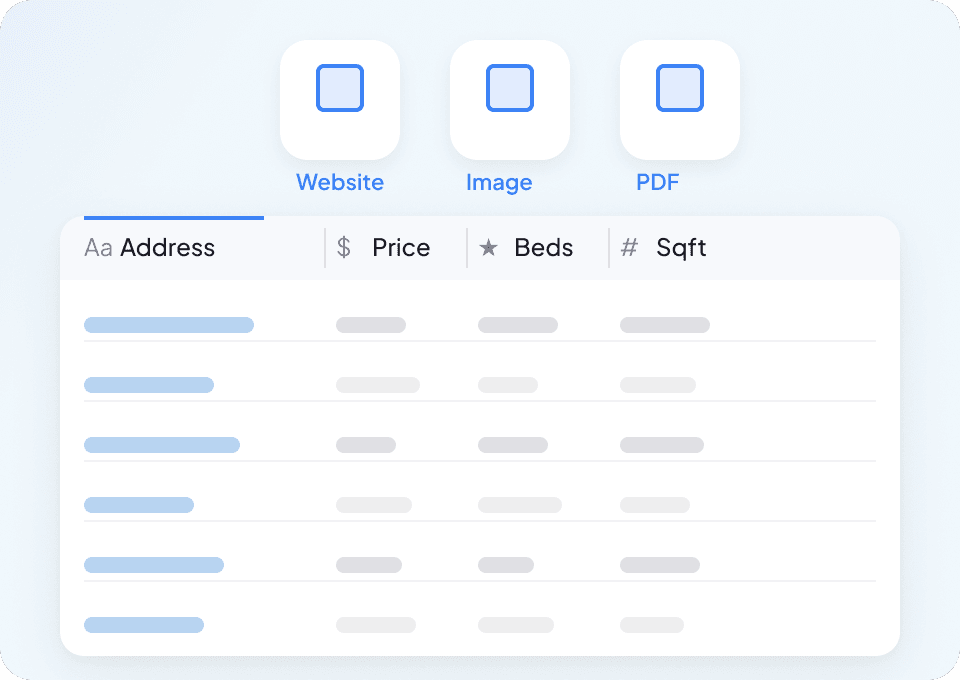
无需搭建爬虫也能对比房源列表
把搜索页和房源详情页的信息保留在同一套房源记录中。
手动复制或选择器工具
上下文信息容易被拆散Thunderbit AI 代理
打开房源页面即可开始适用于混合房源信息的统一字段结构
每个房源来源只填充它实际展示的房屋信息和列表上下文。
- listing_url
- address
- city
- state
- postal_code
- neighborhood
- price
- price_change
- beds
- baths
- half_baths
- square_feet
- lot_size
- property_type
- listing_status
- days_on_market
- year_built
- hoa_fee
- price_per_sqft
- open_house_date
- open_house_start_time
- open_house_end_time
- agent_name
- brokerage
- agent_phone
- mls_id
- listing_id
- photo_url
- virtual_tour_url
- description_snippet
Watch analysts organize listings with Thunderbit
Customer videos show people turning listing facts into rows and changing the fields for their own comparison.
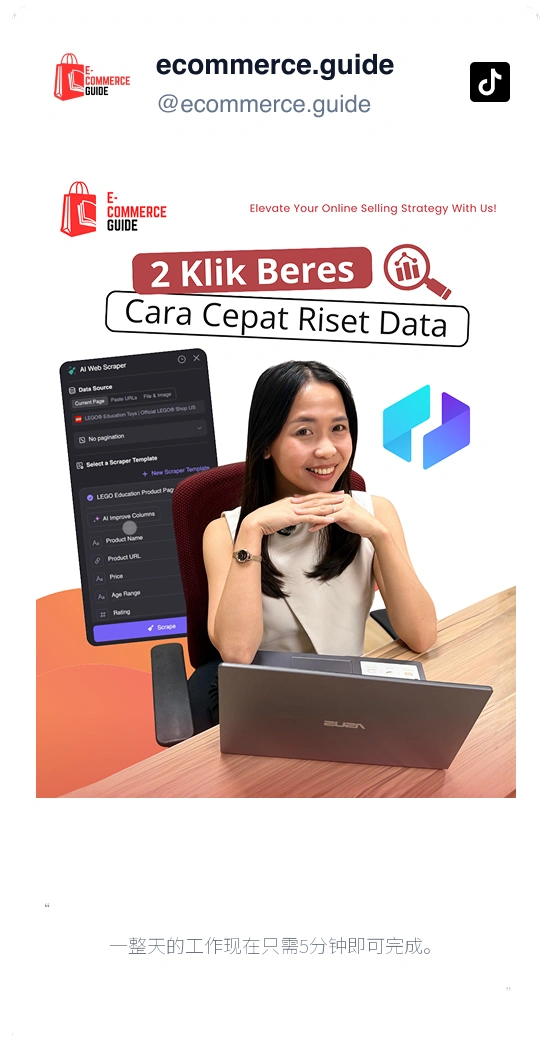
为不同房源来源设计一张表
只有当来源特有的缺失信息仍然可见时,共享字段结构才真正有用。
Move from collected listings to market questions
Separate rentals from homes for sale, compare local areas, or review agents across the sites you choose.
Tradera 爬虫
Thunderbit Tradera 爬虫让你轻松提取 Tradera 商品列表和产品页面的数据。借助 AI 智能字段推荐,快速收集商品名称、价格、分类、图片和描述,便于分析或库存管理。无论你是电商卖家、收藏爱好者还是研究人员,都能高效获取结构化的 Tradera 数据。
了解更多 ->
UpCity 爬虫
Thunderbit UpCity 爬虫可帮助你从 UpCity 的广告代理机构列表和服务商评论中提取数据。借助 AI 智能字段推荐,快速收集机构名称、所在地、评分、联系方式及详细评论内容,便于分析与研究。非常适合需要结构化 UpCity 数据的市场营销人员、研究者和企业主。
了解更多 ->
Substack 爬虫
只需 2 次点击,即可抓取 Substack 的订阅人数、文章标题和发布简介,并导出到 Excel、Google Sheets 或 Notion。无需编写代码,Thunderbit 的 AI 会自动帮你整理好数据结构。
了解更多 ->
白页爬虫
Thunderbit White Pages 爬虫借助 AI 智能字段识别,帮助你高效提取 White Pages 上的电话和商家信息。只需几次点击,即可批量获取姓名、电话号码、地址和网址,助力线索收集、市场营销或数据调研。
了解更多 ->
Herold 爬虫
Thunderbit Herold 爬虫可帮助你仅用两步从 Herold 的企业和个人搜索结果中提取数据。借助 AI 智能字段推荐,快速收集企业名称、地址、电话、邮箱等信息,无论是用于获客、调研还是市场营销都非常高效。非常适合销售、市场和研究团队获取结构化 Herold 数据。
了解更多 ->
HKTVmall 爬虫
只需 2 次点击,即可从 HKTVmall 商品列表中提取商品名称、价格、评分等信息,无需编写代码。数据可直接导出到 Excel、Google Sheets 或 Notion,把 HKTVmall 数据快速转化为可执行的洞察。
了解更多 ->准备好提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 20 万+ 专业人士。
免费试用可获得 8 个网页的无限额度。


