Boots 商品、成分与评价爬虫





无需手工搭建数据集,也能研究 Boots 商品
覆盖不同品类,打开商品页读取标签细节,并在价格或库存变化时重新抓取。
一个工作流覆盖 Boots 多个品类
Thunderbit 可用于 Boots 的公开护肤、彩妆、香氛、健康护理等页面。AI 会根据当前页面可见内容推荐字段,而不是要求你为每个品类单独配置。
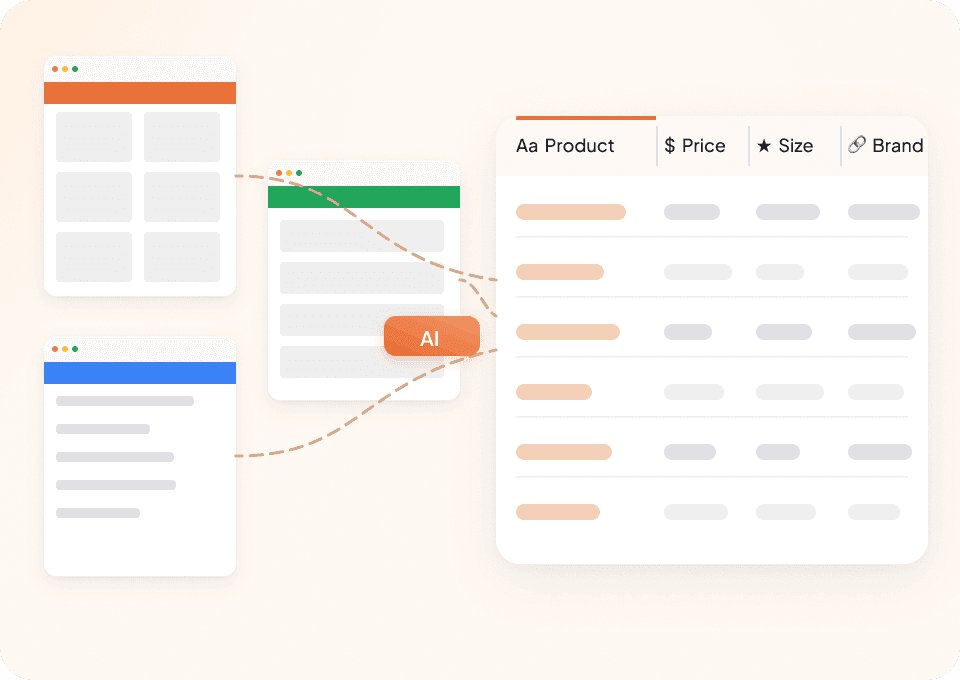
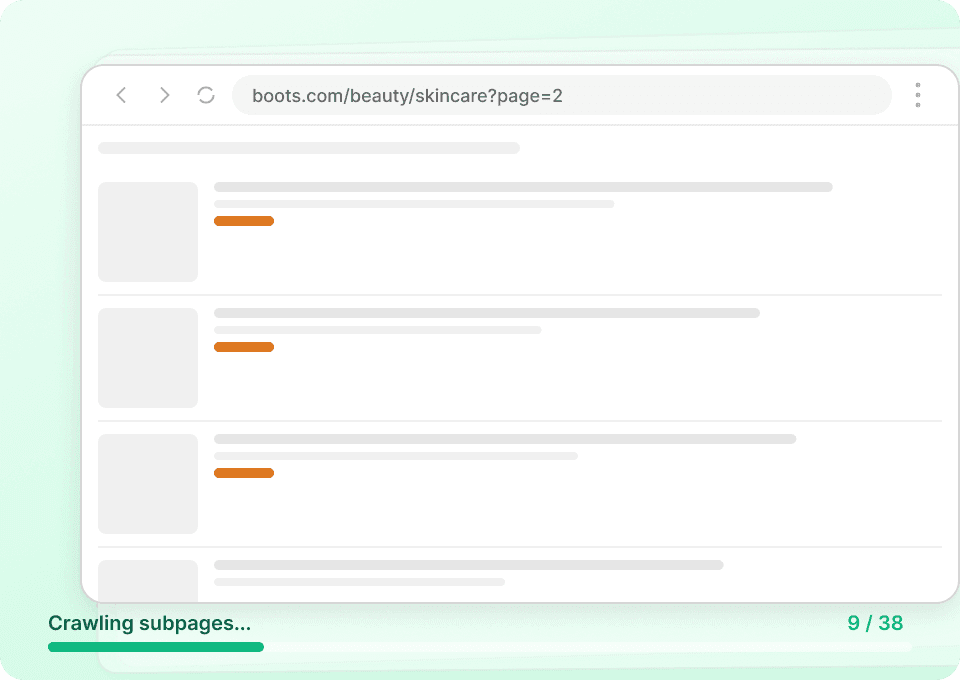
打开商品详情页,读取标签级信息
通过子页面抓取功能,可以跟随可访问的商品链接,把成分、功效、注意事项、包装规格、色号、声明或使用说明等可见信息补充到同一张表里。
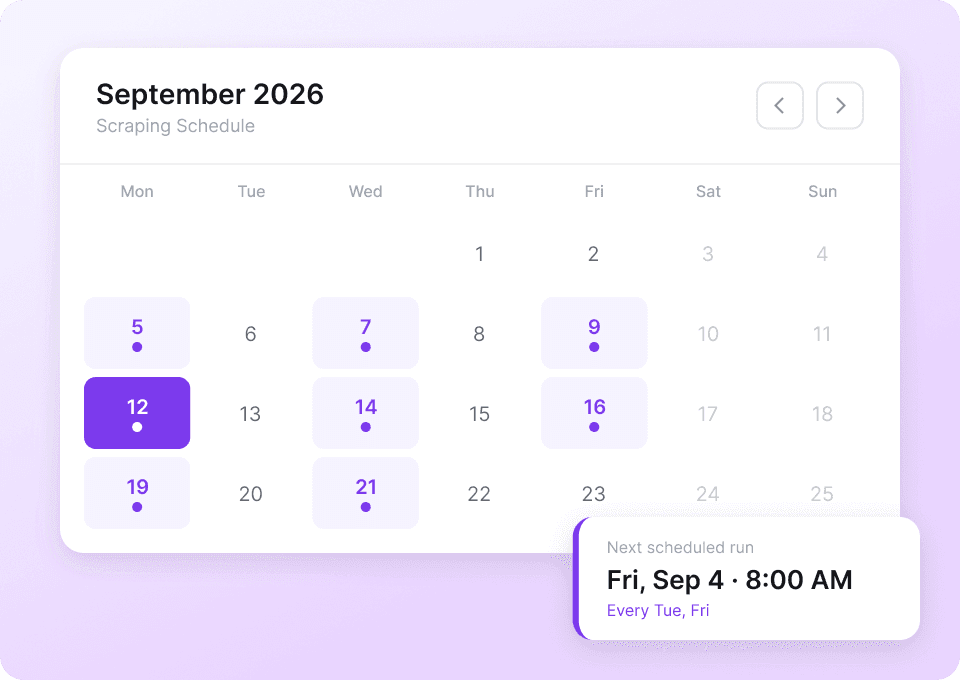
定时刷新价格与库存
选择想要监控的 Boots 页面并设置定期运行。新的公开价格、优惠、评分或库存变化都可以按时间生成电子表格快照。
Boots 不同品类的标签不一样,爬虫也必须灵活适配
传统提取规则通常只适合一种页面结构;Thunderbit AI 则直接读取页面上可见的商品语言。
围绕单一商品类型构建的选择器
不同标签意味着更多配置工作Thunderbit 采集的 Boots 详情
AI 会根据当前页面自动适配30 个实用的 Boots 商品字段
仅当 Boots 页面展示这些字段时才会出现;不同品类和商品的配方、声明、色号与评价会有所不同。
- 商品名称
- 当前价格
- 商品编码
- 包装规格
- 单价
- 总体评分
- 评价数量
- 优惠标签
- 商品描述
- 主要功效
- 产品质地
- 适用肤质
- 使用频率
- 使用说明
- 危险提示与注意事项
- 原产国
- 制造商/责任方地址
- 成分
- 活性成分
- 不含成分声明
- 保湿时长声明
- 可见效果时间
- 色号变体
- 色系
- 纯素声明
- 敏感肌适用性
- 无动物实验认证
- 库存情况
- 品牌名称
- 商品图片
See Thunderbit users simplify detailed web research
Their videos show how an AI scraper helps organize product information that would otherwise require repeated page-by-page work.
处理 Boots 健康与美妆字段
这里整理了关于品类相关字段、声明证据以及 Boots 页面履约信息的常见问题。
Next workflow: UK multi-retailer range check
After building your Boots dataset, consider scraping comparable UK health-and-beauty retailers with the same schema to compare product codes, unit prices, claims text, and stock availability across matching SKUs.
DialIndia 爬虫
Thunderbit 的 DialIndia 爬虫可帮助你从 DialIndia 的企业资料和旅游目录中提取数据,AI 智能字段推荐让操作更高效。只需几步,即可批量获取企业名称、联系方式、地址和简介,助力调研、营销或获客。
了解更多 ->
贴吧爬虫
Thunderbit 贴吧爬虫可帮助你从百度贴吧提取数据,包括热门话题和论坛分类。借助 AI 智能字段推荐,快速获取话题名称、链接、帖子数和用户活跃度,无论是做调研、营销还是内容创作都非常高效。非常适合分析贴吧上的社交趋势与讨论动态。
了解更多 ->
People-Search 爬虫
Thunderbit People-Search 爬虫可帮助您从 People-Search 个人资料和电话反查页面提取结构化数据。借助 AI 智能字段推荐,快速收集姓名、地址、电话号码、邮箱等信息,适用于调研、营销或获客。非常适合需要获取公开记录和联系方式的市场人员、研究者及企业。
了解更多 ->
Amarillas.com 爬虫
Thunderbit 的 Amarillas.com 爬虫可帮助你从 Amarillas.com 提取结构化数据,包括汽车旅馆和餐厅等商家信息。借助 AI 智能字段推荐,快速收集商家名称、地址、联系电话、评分和评论,助力市场调研、营销推广或销售线索获取。
了解更多 ->
ReverseAustralia 爬虫
Thunderbit ReverseAustralia 爬虫可帮助您从 ReverseAustralia 的投诉和评论页面提取数据。借助 AI 智能字段推荐,快速收集电话号码、投诉内容、评论文本、用户名等信息,便于分析与研究。非常适合市场营销人员、研究者及企业获取结构化反馈数据。
了解更多 ->
白页爬虫
Thunderbit White Pages 爬虫借助 AI 智能字段识别,帮助你高效提取 White Pages 上的电话和商家信息。只需几次点击,即可批量获取姓名、电话号码、地址和网址,助力线索收集、市场营销或数据调研。
了解更多 ->准备好提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 20 万+ 专业人士。
免费试用可获得 8 个网页的无限额度。


