Bilibili 视频、评论和弹幕爬虫








让 Bilibili 视频研究随着数据变化持续推进
一套工作流覆盖多个公开页面,批量处理视频列表,并按计划刷新表现快照。
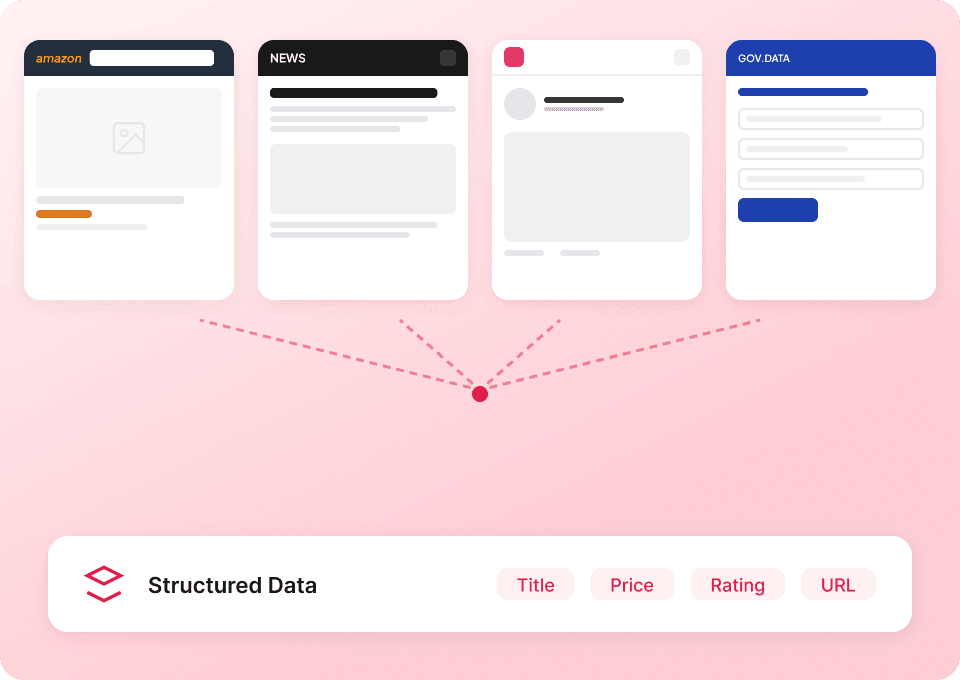
从 Bilibili 或任意公开页面开始
Thunderbit 不局限于某一个视频网站。打开你需要的页面,让 AI 自动识别可见字段,并用自然语言自定义输出结果。
批量处理 Bilibili 视频列表
粘贴一组公开视频 URL,一次性采集标题、BV ID、上传日期、可见播放量、点赞、投币、收藏、评论或弹幕等信息。
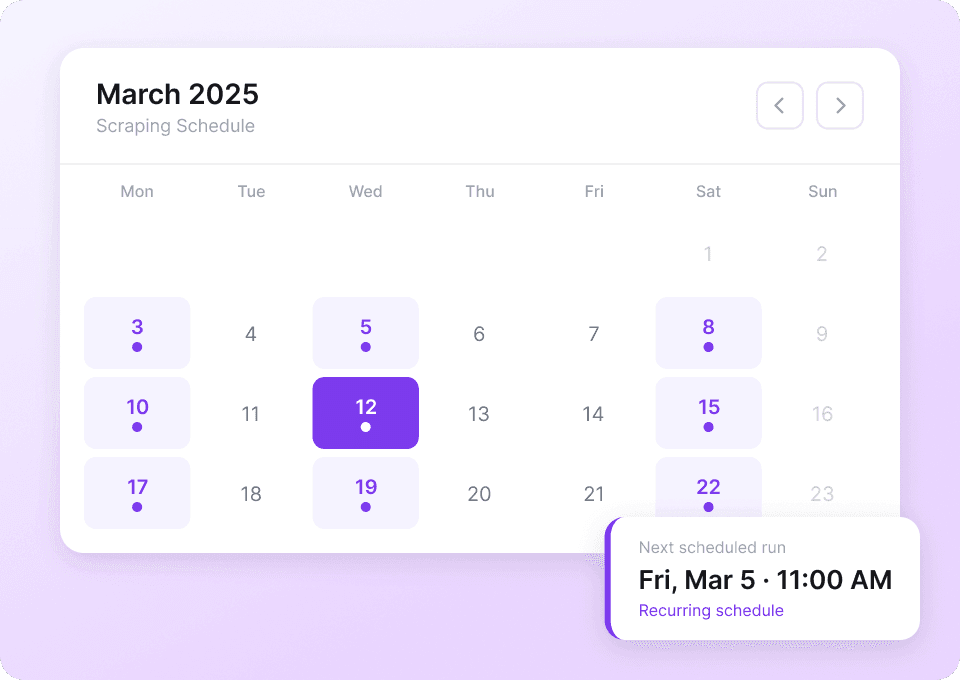
按计划刷新变化中的视频指标
按照你设定的间隔重新访问所选视频。最新的公开数据可以自动写入表格,让每次监测都形成新的快照。
无需维护选择器,也能持续追踪 Bilibili 视频
传统爬虫依赖固定位置和加载规则。Thunderbit AI 会直接读取页面上可见的视频信息。
只适配某一种 Bilibili 页面布局的爬虫
页面稍有变化就得返工修复由 Thunderbit 处理的 Bilibili 页面
AI 负责更多前期配置Bilibili 视频与弹幕导出字段
根据你抓取的是播放页、UP 主视频列表,还是多分集播放器,下面某些字段可能不会出现;导出结果会如实保留你运行时页面上公开可见的内容。
- 视频标题
- BV 视频 ID
- 视频 URL
- 视频分类
- 视频描述
- 封面图片 URL
- 上传日期
- 视频时长
- UP 主名称
- UP 主主页 URL
- UP 主粉丝数
- 播放量
- 弹幕数
- 点赞数
- 投币数
- 收藏数
- 评论数
- 分享数
- 视频标签
- 版权或转载说明
- AI 生成内容说明
- 合集或系列名称
- 集数或分集编号
- 评论内容
- 评论作者
- 评论点赞数
- 评论回复数
- 评论日期
- 弹幕内容
- 弹幕视频时间戳
See how users monitor changing web data with Thunderbit
Their videos show practical ways to turn repeated page checks into organized, exportable records.
使用 Bilibili 视频与弹幕数据
面向公开页面研究采集的常见问题解答。
Need seeds? Gather BV IDs from Bilibili search or tag pages
First collect Video URL and BV Video ID from public search or tag listings to build a crawl queue, then return here to capture comments, danmaku, and recommendation context for each target video.
RUTUBE 爬虫
Thunderbit RUTUBE 爬虫可帮助你高效提取 RUTUBE 热门频道和趋势视频的数据。借助 AI 智能字段推荐,快速收集频道名称、订阅人数、视频标题、播放量、点赞数等信息,适用于调研、营销或内容分析。非常适合需要结构化 RUTUBE 数据的市场人员、研究者和内容创作者。
了解更多 ->
Rumble 爬虫
Thunderbit Rumble 爬虫可帮助你几步内提取 Rumble 排行榜和在线商店的数据。借助 AI 智能字段推荐,快速收集排名、用户名、分数、商品名称、价格及库存信息,便于分析和研究。非常适合需要结构化 Rumble 数据的市场营销人员、研究者和内容创作者。
了解更多 ->
eFind 爬虫
Thunderbit eFind 爬虫可帮助你从 eFind 的视频和新闻搜索结果页面提取数据。借助 AI 智能字段推荐,快速获取视频标题、链接、时长、上传时间、新闻详情等信息,无论是做调研、营销还是数据分析都非常高效。非常适合需要结构化 eFind 数据的市场人员、研究者和内容创作者。
了解更多 ->
Vimeo 爬虫
只需 2 次点击,即可提取 Vimeo 视频标题、观看次数、上传日期等信息,并立即导出到 Excel、Google Sheets 或 Notion。无需编程。
了解更多 ->
FC2 爬虫
Thunderbit FC2 爬虫让你几步内即可从 FC2 视频列表和排行榜页面提取数据。借助 AI 智能字段推荐,快速收集视频标题、链接、上传者、播放量、点赞数及排名等信息,便于分析和研究。非常适合市场营销人员、研究者和内容创作者获取结构化 FC2 数据。
了解更多 ->准备好大幅提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 200,000+ 专业人士。
免费试用可为 8 个网页提供无限额度。



