Air Canada 航班、票价与规则爬虫





无需逐个打开行程,也能批量收集 Air Canada 航班选项
批量处理航线结果,从关联页面补充票价详情,并可在下一次旅行来源中继续复用 Thunderbit。
批量运行 Air Canada 航班
把你想对比的公开结果页或行程 URL 交给 Thunderbit。航班号、机场、时间、经停、舱位和页面上显示的票价都会在一次运行中转成结构化数据行。
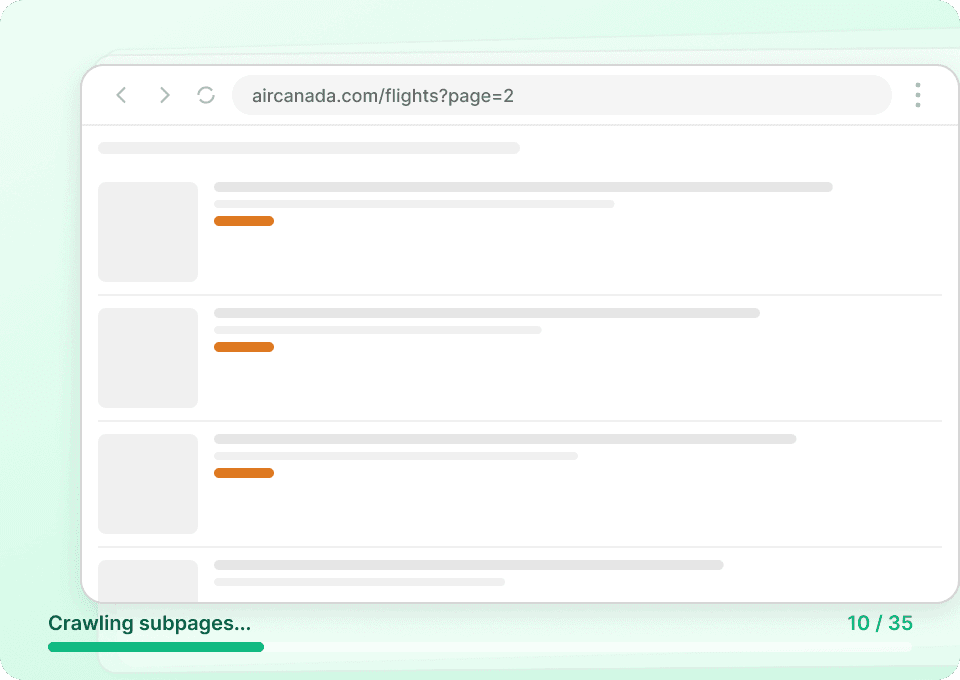
从子页面补充票价和行李信息
关联的票价页或航班页可以把可见的订座舱等、可退款性、改签条款、手提行李、托运行李以及实际承运航司信息补充到对应行程中。
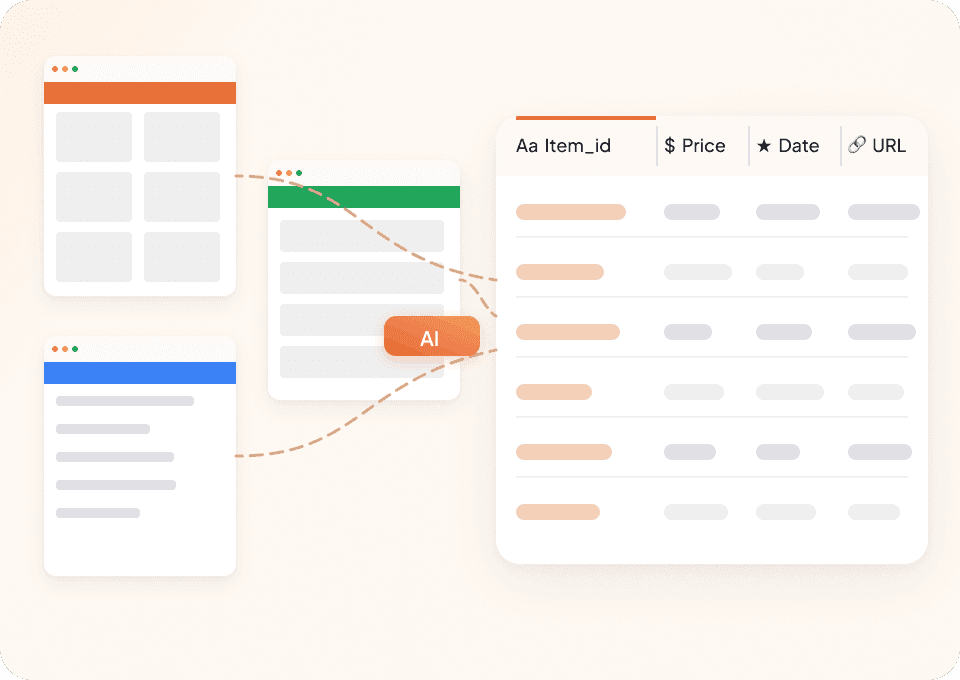
不只适用于 Air Canada
打开另一家航司或旅行页面,继续使用同一套 Thunderbit 工作流。AI 会根据当前页面自动推荐字段,必要时也能用自然语言进行调整。
航班信息随时变化;Air Canada 爬虫必须跟得上
静态规则很难追上动态结果。Thunderbit AI 会读取当前页面可见的行程与票价信息。
基于页面规则的航班提取
动态结果让流程很脆弱由 Thunderbit 处理的 Air Canada 数据行
智能代理会跟随页面上可见的航班详情Air Canada 行程、舱位与票价规则字段
当公开搜索页、票价详情页、航班状态页或行李页面显示这些字段时即可抓取;具体可用性会因航线、舱位、日期和页面视图而异。
- 出发机场
- 到达机场
- 出发日期
- 返程日期
- 行程类型
- 航班号
- 销售航司
- 实际承运航司
- 起飞时间
- 到达时间
- 出发机场
- 到达机场
- 飞行时长
- 经停次数
- 中转机场
- 中转时长
- 机型
- 舱位
- 票价家族
- 订座舱等
- 基础票价
- 税费
- 航司附加费
- 总票价
- 币种
- 票价可售性
- 可退款性
- 手提行李额度
- 首件托运行李额度
- 托运行李费用
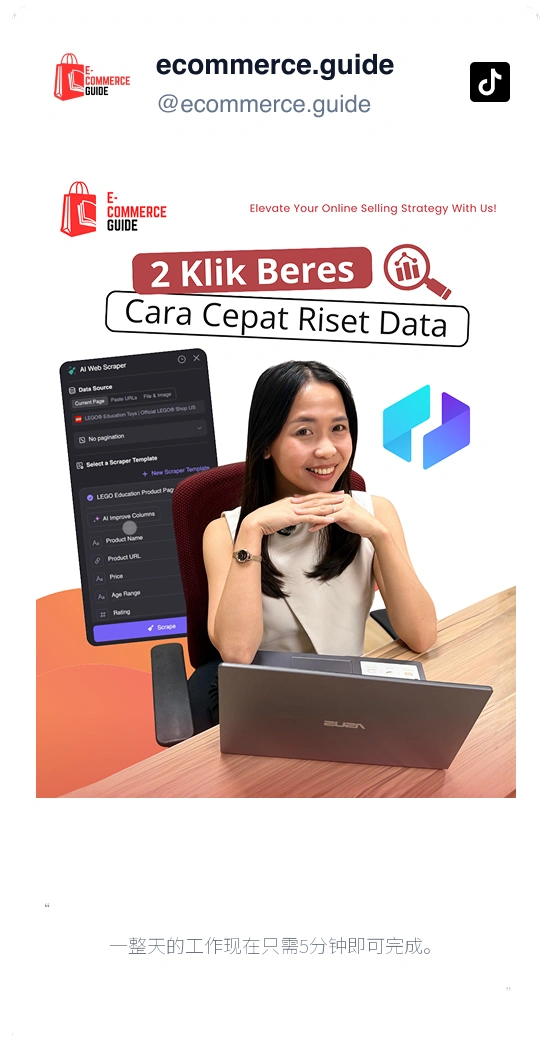
Hear how analysts reduce repetitive travel research
In these videos, Thunderbit users show how changing schedules and fares become records they can review outside the browser.
Air Canada 行程与票价规则常见问题
在按舱位逐一对比之前,先读一下这些说明。
Cross‑carrier fare‑rule parity after your Air Canada matrix
Next, consider a WestJet scrape for domestic comparisons or a United scrape to review operating details on AC‑marketed transborder codeshares before finalizing route and cabin recommendations.

United Airlines 爬虫
只需 2 次点击,即可从 United Airlines 提取航班号、起飞时间、到达机场和价格,并立即导出到 Excel、Google Sheets 或 Notion。剩下的工作交给 Thunderbit AI 即可。
了解更多 ->
On the Beach 爬虫
Thunderbit 的 On the Beach 爬虫可帮助你一键提取 On the Beach 网站上的度假和酒店列表、价格、评分等信息。借助 AI 智能字段推荐,快速收集并整理旅行数据,便于分析、对比或行程规划。非常适合旅游从业者、数据分析师和度假计划者使用。
了解更多 ->
白页爬虫
Thunderbit White Pages 爬虫借助 AI 智能字段识别,帮助你高效提取 White Pages 上的电话和商家信息。只需几次点击,即可批量获取姓名、电话号码、地址和网址,助力线索收集、市场营销或数据调研。
了解更多 ->
DialIndia 爬虫
Thunderbit 的 DialIndia 爬虫可帮助你从 DialIndia 的企业资料和旅游目录中提取数据,AI 智能字段推荐让操作更高效。只需几步,即可批量获取企业名称、联系方式、地址和简介,助力调研、营销或获客。
了解更多 ->
TripAdvisor 商业列表爬虫
Thunderbit TripAdvisor 商家列表爬虫可帮助你从 TripAdvisor 的商家列表、资源中心和业主论坛中提取数据。借助 AI 智能字段推荐,快速收集资源名称、网址、描述、论坛话题、作者及帖子内容,助力调研、营销或数据分析。
了解更多 ->
Substack 爬虫
只需 2 次点击,即可抓取 Substack 的订阅人数、文章标题和发布简介,并导出到 Excel、Google Sheets 或 Notion。无需编写代码,Thunderbit 的 AI 会自动帮你整理好数据结构。
了解更多 ->准备好提升你的数据提取效率了吗?
加入已在使用 Thunderbit 自动化网页抓取流程的 20 万+ 专业人士。
免费试用可获得 8 个网页的无限额度。


