
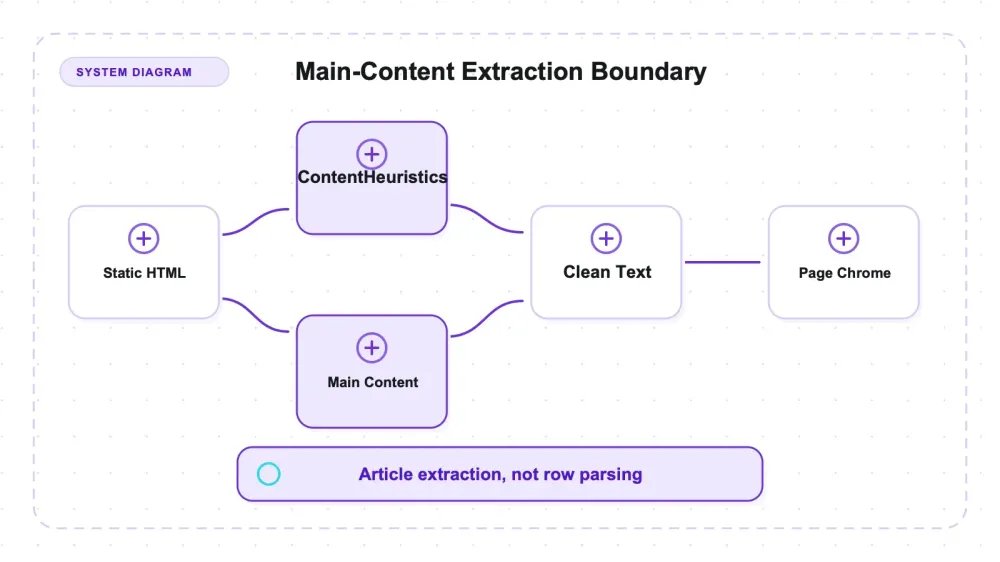
trafilatura là một bộ trích xuất nội dung Python không cần trình duyệt. Trên bộ fixture gắn nhãn trong bài viết này, đối thủ duy nhất có chất lượng trích xuất HTML tương đương là Mozilla Readability: trafilatura để lọt 1 trong 17 đơn vị boilerplate đã chú thích, trong khi Readability để lọt 5. Các công cụ dựa trên trình duyệt chỉ xuất hiện trong phần nói về mức độ triển khai và không được kiểm thử chất lượng trên các trang này.
Nhiệm vụ cốt lõi của nó là trích xuất phần nội dung chính: đầu vào là HTML, đầu ra là văn bản và metadata theo hướng bài viết, đồng thời loại bỏ các thành phần thừa của trang bằng heuristic. Công cụ có thể xuất ra JSON và một số định dạng khác, nhưng không tạo được schema dòng do người dùng định nghĩa hay các bản ghi danh mục có kiểu dữ liệu lặp lại. Phiên bản được kiểm thử là 2.1.0. Nó không thực thi JavaScript, và phép so sánh với Readability cho thấy đây là một đánh đổi giữa độ chính xác và khả năng giữ lại nội dung, chứ không phải một chiến thắng tuyệt đối ở mọi hạng mục.
trafilatura phù hợp ở đâu, và nó từ chối làm gì
trafilatura tự mô tả là một công cụ Python và dòng lệnh để thu thập văn bản và metadata trên web — crawling, scraping, extraction — với đầu ra là CSV, JSON, HTML, Markdown, TXT hoặc XML. Nghe thì rất rộng. Nhưng trên thực tế, phần làm nên giá trị của công cụ lại hẹp và sắc hơn nhiều: nó nhận một tài liệu HTML rồi trả về nội dung chính, đã loại bỏ phần khung và chi tiết phụ của trang.
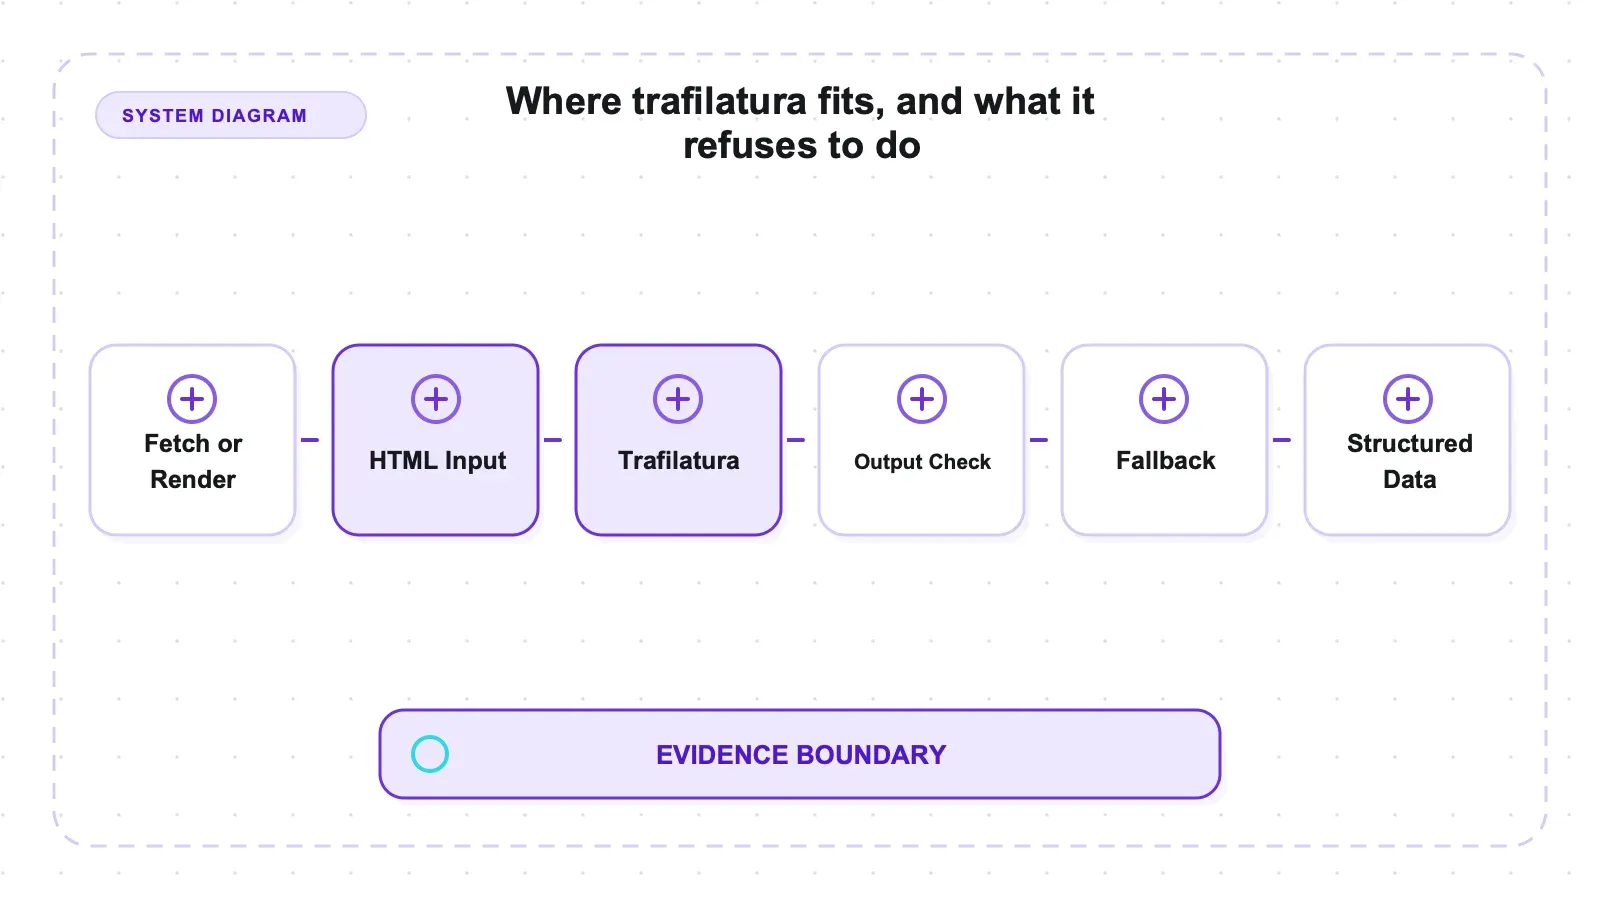
Hãy hình dung thế này, vì nó giải thích cả điểm mạnh lẫn giới hạn của công cụ. Phần lớn scraper bạn chỉ vào một trang đều dựa trên selector — bạn bảo chúng “lấy phần tử có class product-price”, và chúng trả về đúng thứ nằm ở địa chỉ đó. trafilatura làm theo hướng ngược lại. Nó đọc toàn bộ tài liệu rồi tự quyết định khối nào là bài viết thật, khối nào chỉ là boilerplate, dựa trên heuristic nội dung thay vì selector do bạn viết. Vì vậy, nó không cần rule riêng cho từng website để làm sạch trang. Và cũng chính vì thế, nó không thể đưa bạn một catalog có cấu trúc: không có schema, không có dòng dữ liệu có kiểu, chỉ có “đây là phần văn bản có ý nghĩa”. Nó là extractor, không phải parser để bạn chỉ điểm.
Công cụ này cũng không cần tải riêng một browser runtime. Cây phụ thuộc có các gói wheel theo nền tảng như lxml, nên “không cần cài browser” không đồng nghĩa với “chỉ có mã nguồn” hay “không dùng native code”.
Cài đặt: nhẹ, không cần browser
Chạy pip install trafilatura trong một virtualenv mới trên Python 3.14 đã cài 17 gói; wheel lớn nhất được ghi nhận là lxml với dung lượng 8.6 MB, theo pip-install-trafilatura.log. Không cần cài browser riêng hay chạy lệnh hậu cài nào cho browser.
Nếu xét về quy mô, bộ Scrapling trong cùng nền tảng nghiên cứu này cần bốn lần gọi pip riêng biệt mới chạy được fetcher và kết thúc ở 26 gói, trong đó có hai wheel driver Playwright nặng 42.2 MB (tools/scrapling/artifacts/logs/pip-install-scrapling.log) — đó là chưa tính đến việc tải binary browser. Bộ Crawlee ghi nhận riêng phần tải Chromium khoảng ~81.7 MiB (tools/crawlee/research-materials.md). Những công cụ đó làm việc lớn hơn, nên đây không phải một cuộc so kè công bằng về năng lực; chỉ là những gì đĩa và CI cache của bạn phải gánh. Và phiên bản pip cài cho tôi (2.1.0) đúng bằng bản phát hành hiện tại, nên các con số bên dưới không bị gắn dấu sao kiểu “bạn kiểm thử bản cũ”.
Thực chiến: extractor thực sự trả về gì
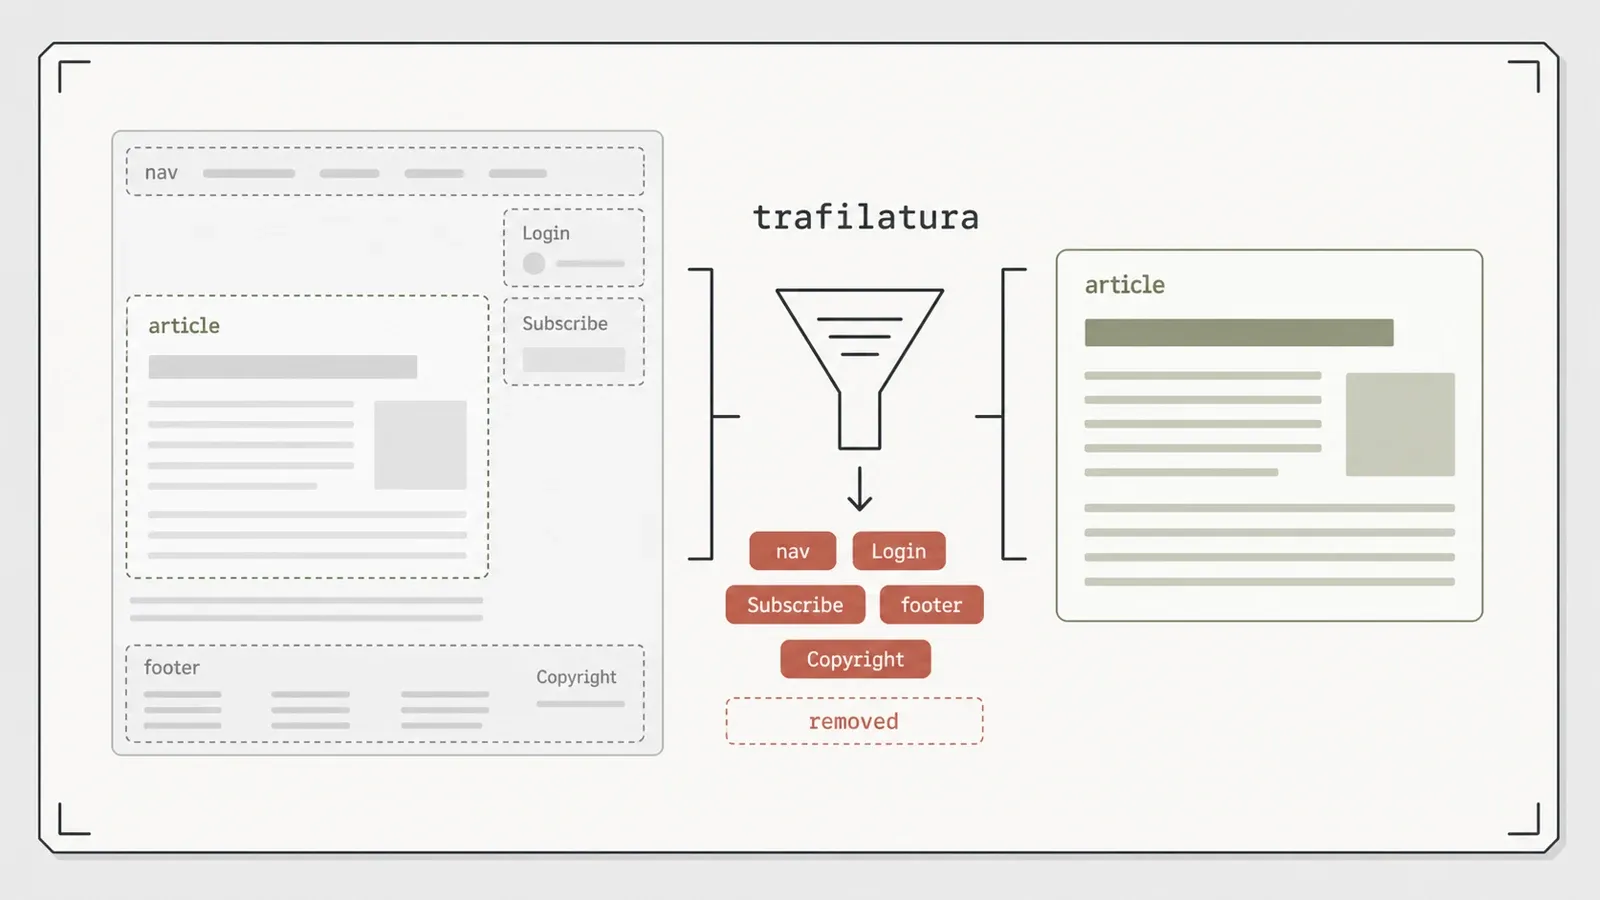
Tôi đã chạy nó trên các fixture được thiết kế để chạm cả điểm mạnh lẫn điểm yếu, và lưu đầu ra thô trong benchmark repo. Bài test bài viết là phần thuyết phục tôi nhất.
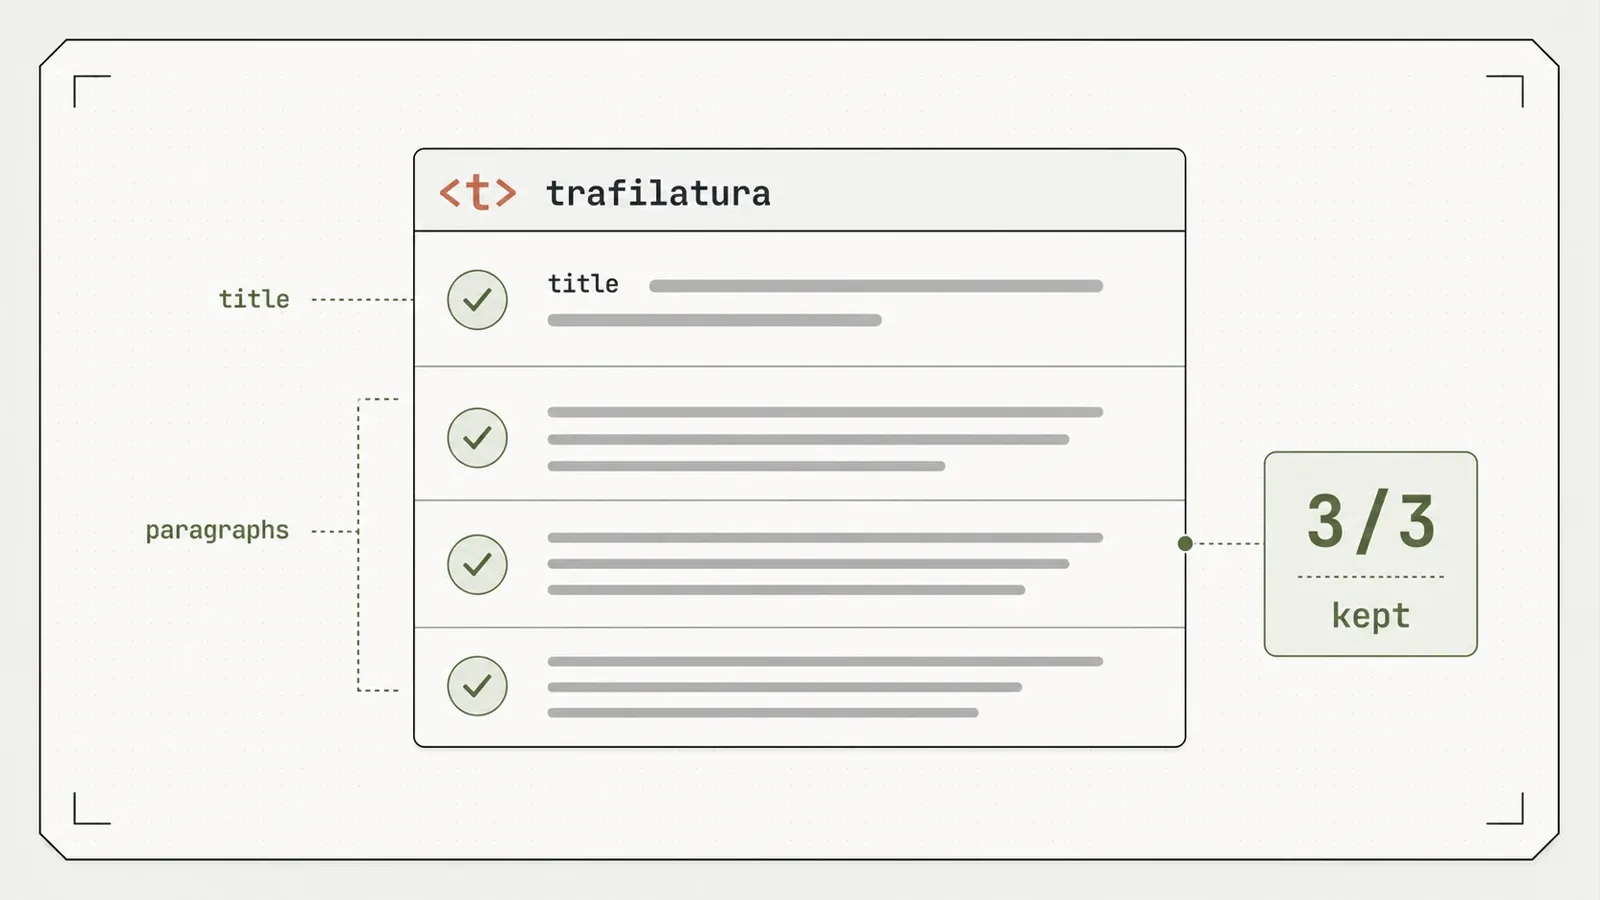
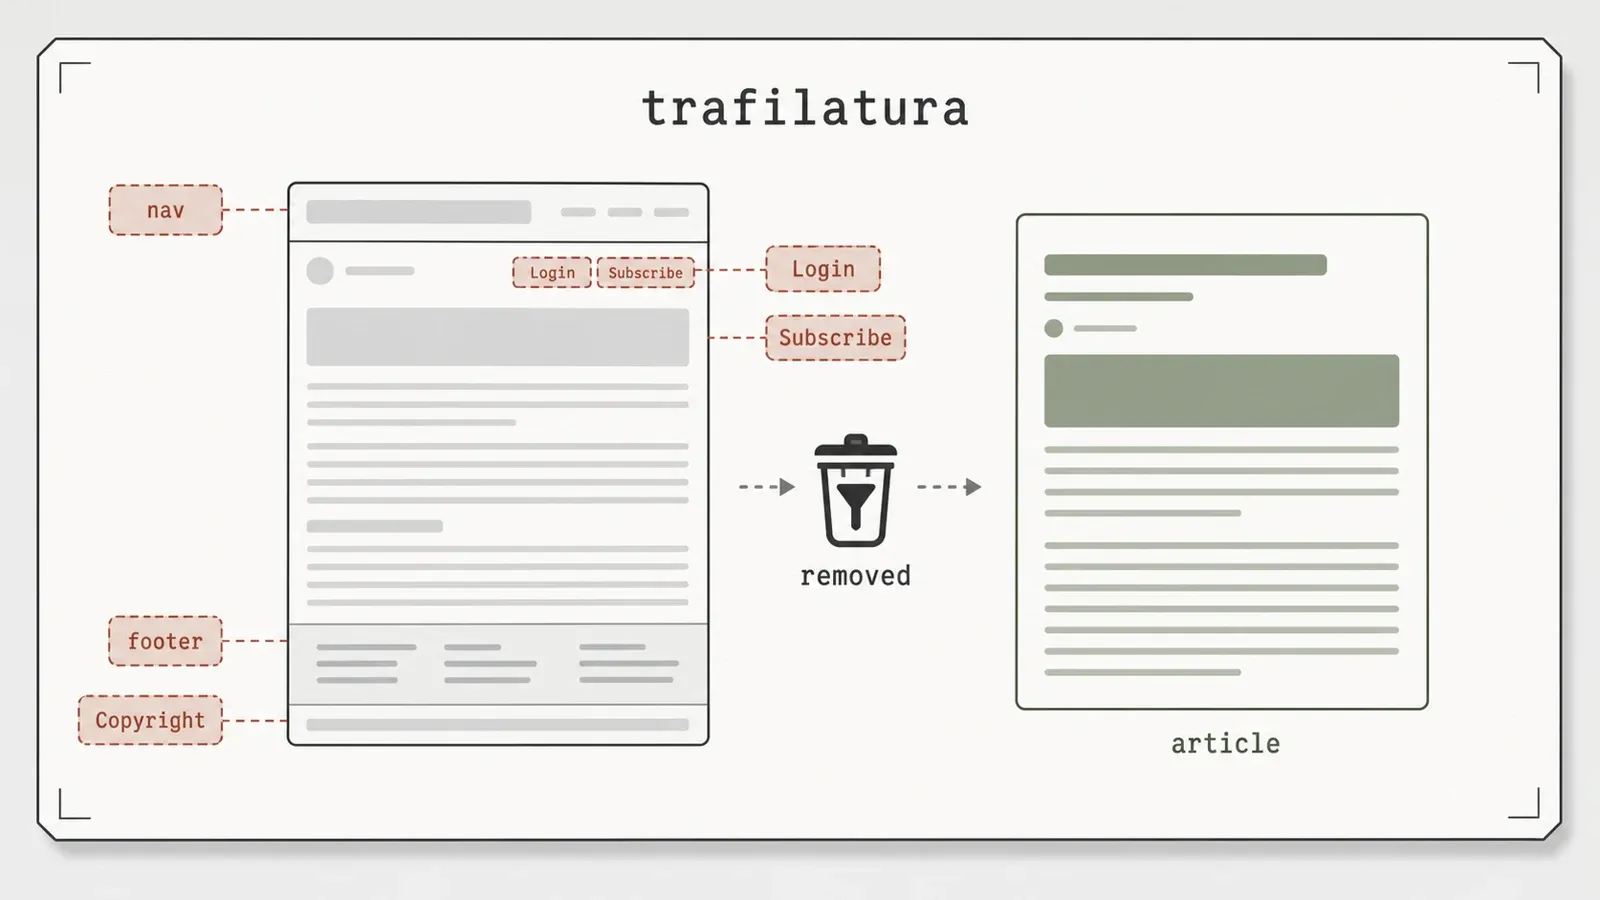
Tôi lấy một fixture bài viết cục bộ rồi bọc nội dung thật bằng nhiễu: nhắc đăng nhập, lời kêu gọi “Subscribe”, các link điều hướng, footer bản quyền — kiểu boilerplate tiêu chuẩn mà một scraper ngây thơ thường kéo luôn vào cùng nội dung chính. trafilatura trả về tiêu đề cộng với đủ 3/3 đoạn thân bài, và toàn bộ các dấu hiệu boilerplate đó — Login, Subscribe, Copyright — đều biến mất khỏi đầu ra. Bên cạnh phần văn bản, nó còn lấy đúng tác giả và ngày tháng từ metadata của trang. Kết quả đầy đủ ở các định dạng .txt, .md và .json nằm trong results/local_article.json.
Cùng một HTML đã được lưu này được xuất ra dạng text thuần, Markdown và JSON. Bài viết không cho thấy cả ba định dạng đó đến từ một lời gọi duy nhất cùng lúc; chúng là các cách tuần tự khác nhau của cùng đường trích xuất. JSON ở đây chứa văn bản và metadata đã trích xuất, chứ không phải các bản ghi lặp có cấu trúc do người dùng định nghĩa.
Đây là toàn bộ lần chạy đầu tiên đặt chung một chỗ, để bạn có thể tự đối chiếu thay vì chỉ nghe mô tả:
| Fixture | Kết quả trả về | Thời gian chạy | Bằng chứng |
|---|---|---|---|
| Bài viết cục bộ, bọc nav / login / subscribe / copyright | tiêu đề + 3/3 đoạn, không lọt phần boilerplate nào, tác giả Thunderbit Research Lab, ngày 2026-07-09 | 0.007 s | local_article.json |
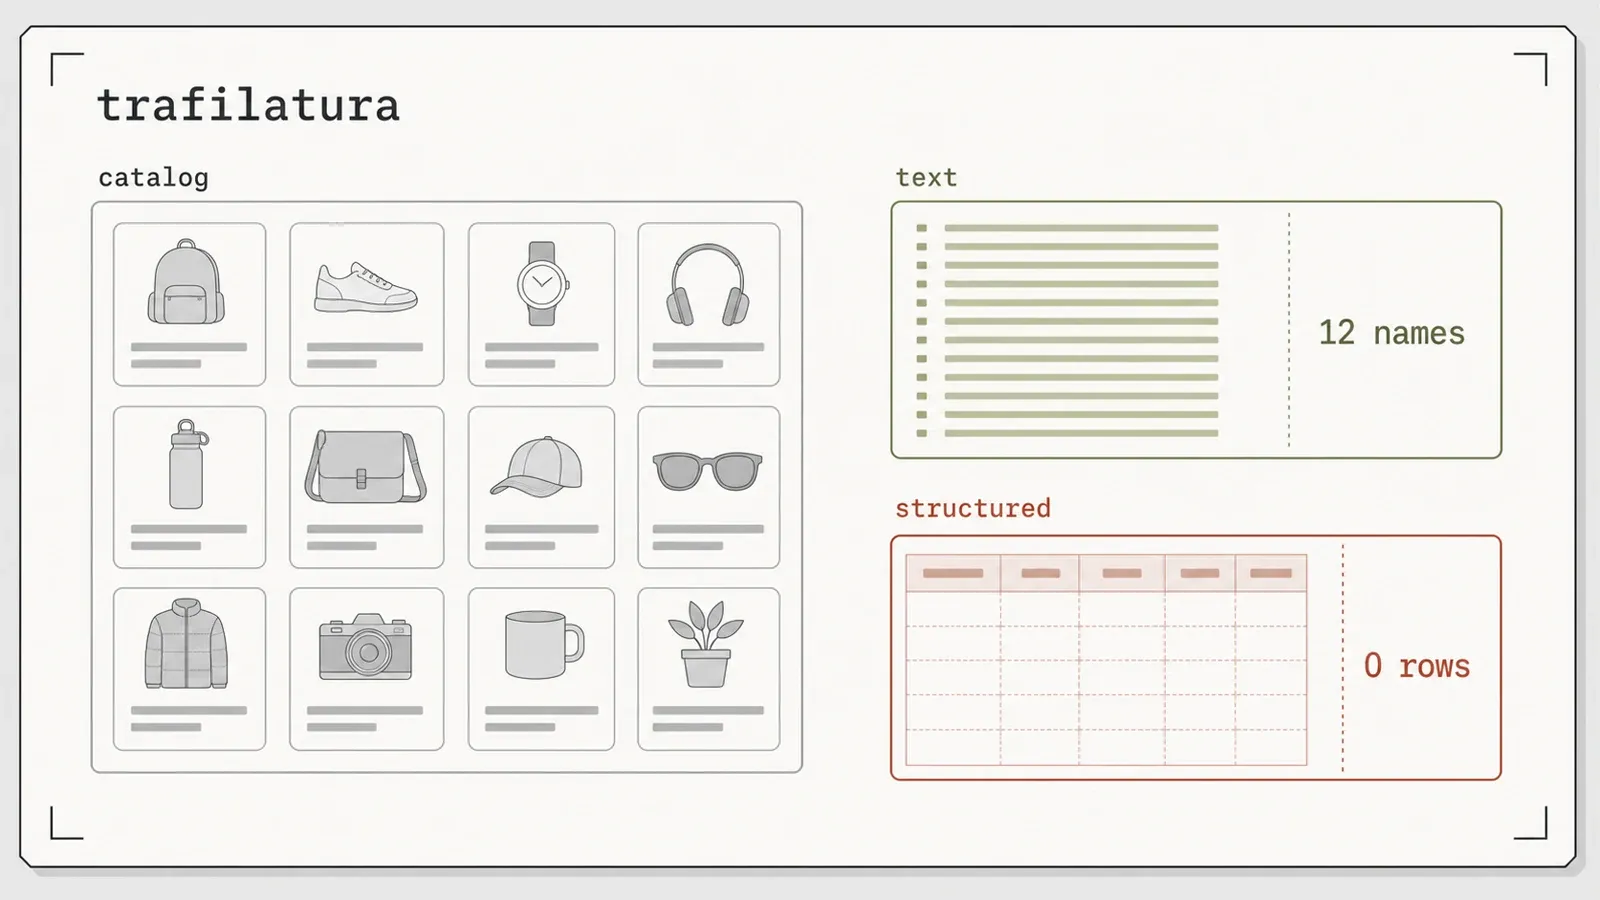
| Catalog sản phẩm cục bộ | 12 tên sản phẩm và 12 mức giá dưới dạng văn bản phẳng, 0 dòng có cấu trúc, 478 ký tự | 0.064 s | local_catalog_extraction.txt |
| Trang trả về HTTP 500 | fetch_url trả về None, không ném exception | 30.012 s | local_failure_500.json |
| Trang sản phẩm Books to Scrape (công khai) | 1,324 ký tự văn bản sạch, kèm bản Markdown tương ứng | 0.753 s | public_books_product.txt / .md |
Mỗi dòng đều được đọc từ artifacts/raw/trafilatura-test-summary.json trong bộ trafilatura — trafilatura 2.1.0, Python 3.14, macOS arm64, một lần chạy trên một máy. Hãy xem các mốc thời gian này như quan sát thực tế, không phải benchmark chính thức.
Ở fixture 500, fetch_url trả về None sau khoảng 30 giây trong khi các endpoint cục bộ lân cận lại nhanh. Lần chạy chỉ cho thấy độ trễ, chứ không chứng minh được đó là retry/backoff, timeout cố định hay một nhánh nội bộ khác. Bài viết này không xác minh được tham số timeout theo từng lần gọi cho fetch_url; cách điều khiển đã được chứng minh là dùng một HTTP client do bên gọi kiểm soát rồi đưa HTML nhận được vào trafilatura.
Các test này cũng cho thấy ba giới hạn.
Thứ nhất, và cũng là lớn nhất: trafilatura là content extractor, không phải structured scraper. Tôi chạy nó trên một fixture catalog sản phẩm. Nó trả về đủ 12 tên sản phẩm — dưới dạng text — và đúng 0 dòng có cấu trúc (478 ký tự văn bản phẳng, theo results/local_catalog_extraction.txt). Giá cũng đi ra, từ $18.00 đến $51.00, nằm trên các dòng riêng dưới mỗi tên. Tất cả những gì bạn cần đều có trong đầu ra; nhưng không có thứ gì là field cả. Nếu bạn cần [{name, price, rating}, …] thì đây là sai công cụ, và không có cấu hình nào đổi được điều đó — đó là lựa chọn thiết kế, không phải lỗi.
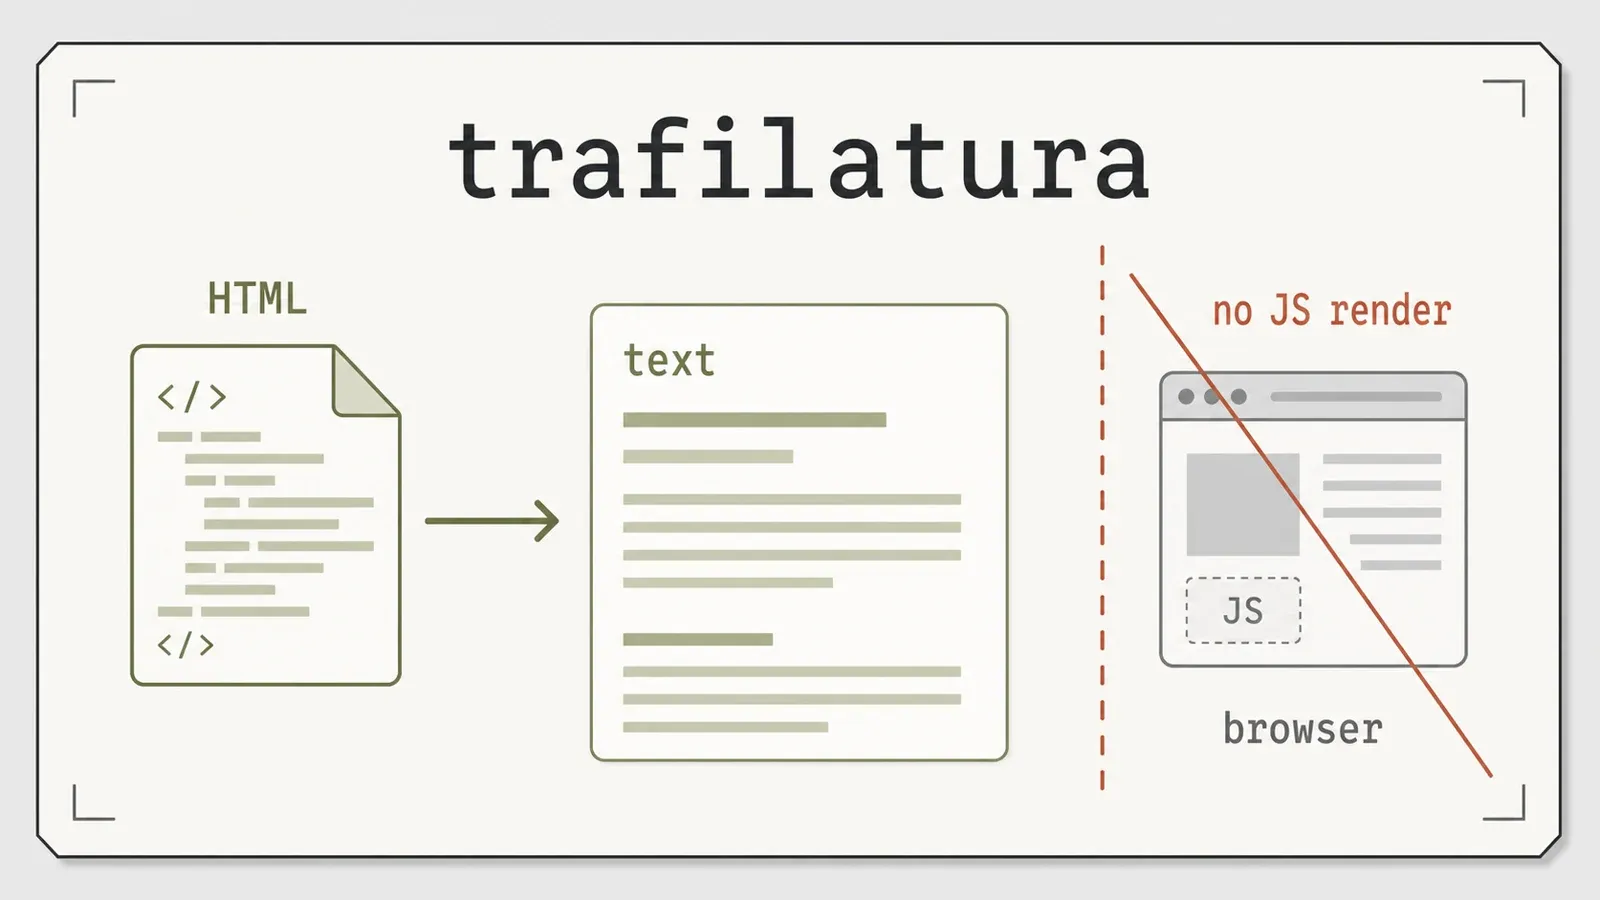
Thứ hai: nó không render JavaScript. Nó chỉ đọc HTML tĩnh. Nếu bạn đưa cho nó một trang render phía client, bạn sẽ nhận đúng phần server đã gửi trước khi JS chạy, mà thường không phải nội dung bạn cần. Nếu mục tiêu của bạn nặng JS, hãy ghép thêm một renderer; trafilatura không làm hộ phần đó.
Thứ ba, một lưu ý về chính bộ bằng chứng của tôi: bài test trích xuất công khai đầu tiên đó dùng một khối mô tả sản phẩm, không phải bài báo tin tức thật, vì sandbox công khai không có trang tin. Kết quả làm sạch bài viết ở trên đến từ fixture cục bộ có kiểm soát. Tôi tin kết quả đó — việc loại boilerplate là rất rõ ràng — nhưng tôi không muốn lấy một trang sản phẩm rồi giả làm bằng chứng cho năng lực trích xuất kiểu newsroom, nên bộ này giữ nó như một khoảng trống mở. Một lần chạy bổ sung vào 2026-07-14 đã lấp được khoảng trống đó, và kết quả nằm ở phần tiếp theo.
Kiểm tra độ sạch boilerplate trên trang thật
Hai trang thật đã được fetch một lần, lưu thành fixture offline kèm hash SHA-256, rồi chạy lại khi không có mạng. Không ghi nhận thời gian hay ground truth đã gắn nhãn. Đây là kiểm tra độ sạch boilerplate trên trang thật, không phải điểm fidelity.
| Fixture bài viết thật | HTML thô | Nội dung body được trích xuất | Body/raw | Dấu hiệu khung trang bị loại bỏ | title | date | hostname | author | sitename |
|---|---|---|---|---|---|---|---|---|---|
| Wikipedia, "Web scraping" | 230,049 bytes | 26,673 bytes | 0.116 | 4/4 | có | 2005-09-17 | wikipedia.org | null | null |
| Wikinews, "7th Heaven" (đã lưu trữ) | 79,716 bytes | 2,200 bytes | 0.028 | 5/5 | có | 2005-11-29 | wikinews.org | null | null |
Cả hai dòng đều lấy từ artifacts/results/trafilatura-fidelity-summary.json. Các dấu hiệu được kiểm tra gồm "Jump to content", "Privacy policy", "Powered by MediaWiki", "This page was last edited", và thêm "free news source" trên trang Wikinews — tất cả đều bị loại, không thứ gì lọt ra, trên cả hai trang.
Tỷ lệ body/raw đo mức độ giảm dung lượng, không đo độ chính xác; phần nội dung bài viết bị bỏ sót không được chấm điểm. author và sitename đều là null trên hai template MediaWiki này, trong khi fixture cục bộ có kiểm soát thì cung cấp tác giả. Đây là một trường hợp miss liên quan đến MediaWiki được quan sát trong bài test, không phải bằng chứng về độ tin cậy chung của việc trích byline. Ngày được trích ra chỉ được báo cáo đúng như công cụ trả về và không được đối chiếu ground truth.
Hai extractor, cùng bytes HTML, một script chấm điểm
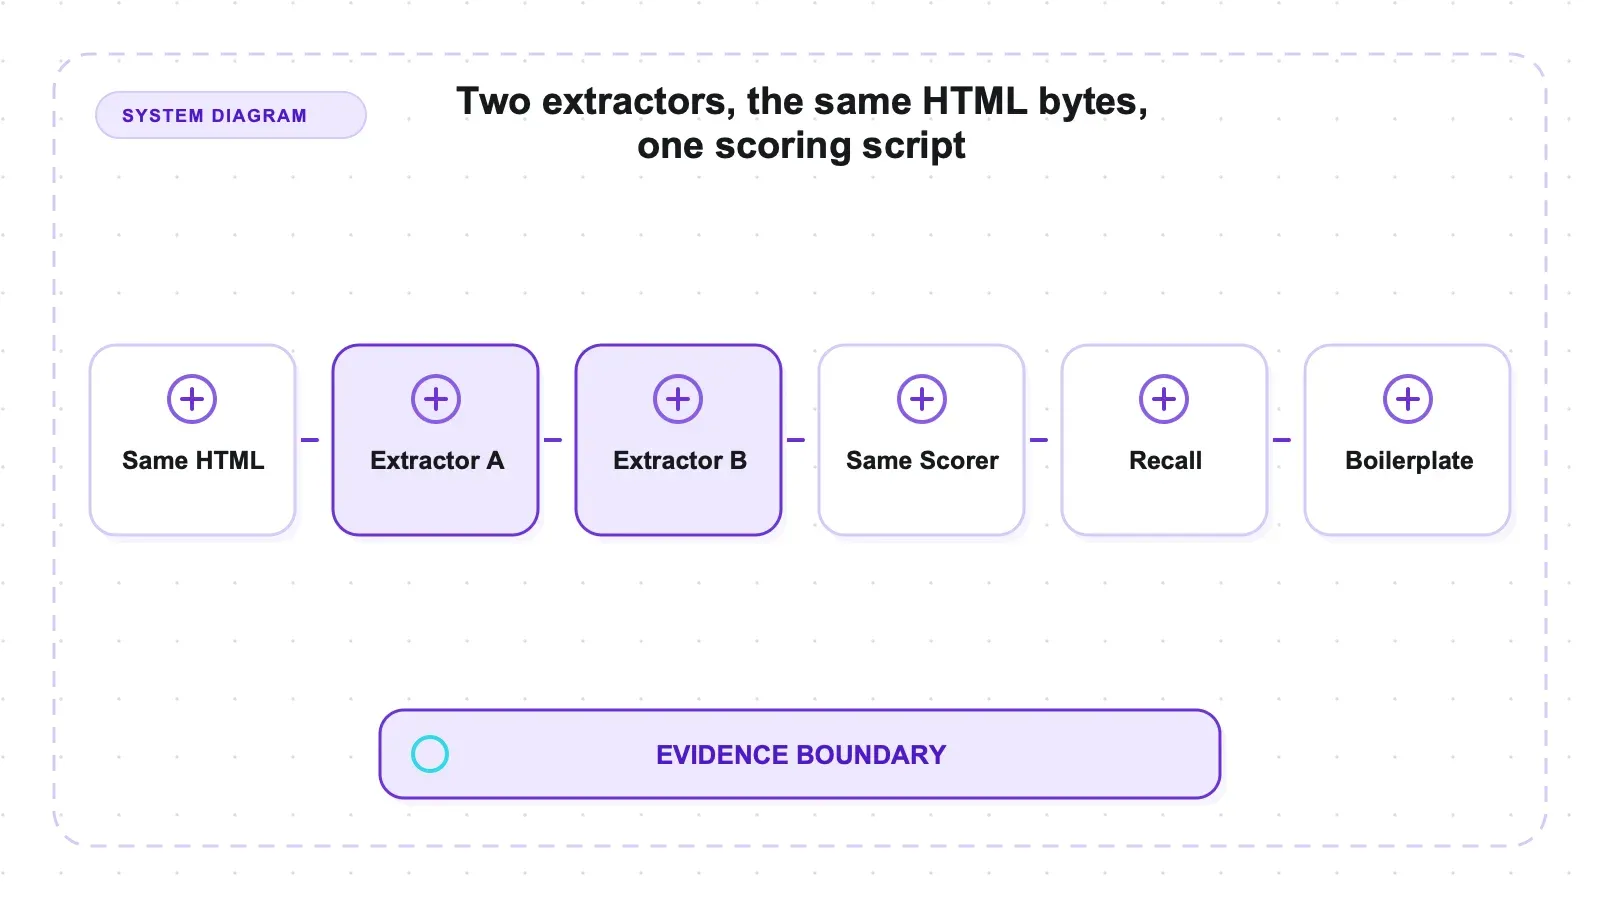
Trong bộ nghiên cứu này chỉ có đúng một phép so sánh trên cùng bộ test dành cho trafilatura, và chính pack của trafilatura không tạo nó. Pack mozilla-readability đã làm điều đó, như một nhánh đối chứng: 22 fixture gắn nhãn thủ công, trong đó mọi khối văn bản đều được đánh dấu ARTICLE hoặc BOILERPLATE và mỗi từ mang một token sentinel duy nhất, để một từ trích xuất có thể truy ngược về đúng một khối đã gắn nhãn. Cả hai công cụ nhận cùng một bytes HTML. Readability chạy dưới jsdom 29.1.1 trên Node v22.22.3; trafilatura chạy parser riêng của nó.
| Chỉ số (micro-averaged, bộ content-fidelity) | trafilatura 2.1.0 | @mozilla/readability 0.6.0 | Bằng chứng |
|---|---|---|---|
| Số đơn vị bài viết thu hồi được | 40/40 | 40/40 | comparison.json |
| Số đơn vị boilerplate bị lọt | 1/17 | 5/17 | comparison.json |
| Số token boilerplate làm bẩn đầu ra | 3 | 41 | comparison.json |
| Độ chính xác token | 0.939 | 0.902 | comparison.json |
| Token F1 | 0.969 | 0.948 | comparison.json |
Recall phần không phải văn xuôi, fixture f6_nonprose | 7/8 | 8/8 | comparison.json |
Bài viết rất ngắn, F1 của f3_short_120 | 0.571 | 0.800 | comparison.json |
Nguồn: tools/mozilla-readability/artifacts/raw/comparison.json trong bộ nghiên cứu này — 11 fixture trong tập content-fidelity, 40 đơn vị bài viết và 17 đơn vị boilerplate. Đây là các fixture tổng hợp, cố tình thiên về những trường hợp đối kháng, nên hãy đọc chúng như cơ chế hoạt động chứ không phải bảng xếp hạng trên corpus thật.
Không công cụ nào quét sạch hoàn toàn, và phần chia tách mới là điều đáng chú ý. trafilatura giữ phần khung tốt hơn — chỉ 1 block lọt so với 5 của Readability, 3 token nhiễu so với 41. Đó là nửa “độ sạch” của nội dung bài viết, và cũng là nửa quyết định việc cửa sổ ngữ cảnh của LLM có bị lấp bởi link sidebar hay không. Nhưng Readability lại thu hồi được những phần mà trafilatura bỏ đi: trên fixture không phải văn xuôi, trafilatura bỏ mất <figcaption> mà Readability giữ lại, và trên một bài rất ngắn nó chỉ đạt 0.571 so với 0.800 của Readability. Làm sạch mạnh tay là một sự đánh đổi, không phải món hời miễn phí. Nếu corpus của bạn đầy bài ngắn, caption và trang nặng bảng biểu, sự đánh đổi đó sẽ bất lợi.
Biến phép so sánh thành một bài test chọn công cụ
Hãy bắt đầu bằng việc xác định lỗi nào tốn kém hơn cho pipeline của bạn. Nếu phần khung trang làm hao token downstream hoặc làm bẩn kết quả tìm kiếm, hãy ưu tiên chỉ số leakage của boilerplate và số token nhiễm bẩn. Nếu việc bỏ mất caption, bài ngắn hoặc khối không phải văn xuôi là không chấp nhận được, hãy ưu tiên recall theo dạng trang. Bộ fixture chung làm cho sự đánh đổi này trở nên hữu hình, nhưng nó không tự chọn trọng số cho một kho tin tức, corpus tài liệu hay pipeline truy hồi.
Bối cảnh stress-test rộng hơn nằm ở so sánh bộ nhớ và HTML lỗi của 10 thư viện.
Hãy xây bài so kè từ HTML đã lưu thay vì URL trực tiếp, để cả hai extractor nhận cùng một bytes. Bao gồm bài dài thông thường, thông báo ngắn, bài nhiều caption, tài liệu nặng bảng hoặc code, và các template từ từng nhà xuất bản mà bạn thực sự ingest. Gắn nhãn trước một số đơn vị nội dung bắt buộc và các khối khung trang đã biết trước khi chạy bất kỳ công cụ nào. Sau đó chấm riêng đầu ra trống, mức thu hồi đơn vị bắt buộc, mức rò rỉ đơn vị không mong muốn và từng field metadata. Một điểm chất lượng tổng hợp duy nhất có thể che mất đúng kiểu lỗi mà vận hành thực sự quan tâm.
Cũng cần kiểm tra hợp đồng đầu ra ở tầng downstream. JSON của trafilatura có thể chứa nội dung và metadata đã trích xuất, nhưng JSON serialization không đồng nghĩa với schema dòng có kiểu dữ liệu. Với văn bản bài viết, hãy kiểm tra độ dài body tối thiểu và các dấu hiệu bắt buộc thay vì chấp nhận bất kỳ đầu ra không rỗng nào. Với metadata, hãy phân biệt giữa thiếu giá trị và giá trị sai, đồng thời giữ lại source URL cùng phiên bản extractor để có thể chạy lại các miss.
Tầng fetch cũng nên được kiểm thử riêng. Quan sát lỗi cục bộ 30 giây thuộc về fetch_url, không phải phần trích xuất từ HTML đã có sẵn, và cơ chế nội bộ của nó không được xác định. Nếu deadline, retry, xác thực hay policy proxy quan trọng, hãy dùng client mà bạn kiểm soát hành vi, lưu lại bytes phản hồi cuối cùng, rồi đưa bytes đó vào extractor. Làm vậy sẽ tách lỗi ở khâu lấy dữ liệu khỏi lỗi ở khâu chọn nội dung, đồng thời giúp so sánh lặp lại được.
Cuối cùng, hãy đo các đặc tính triển khai trên nền tảng mục tiêu. Việc cài Python 3.14 với 17 gói mà không cần browser riêng là một điểm tốt, nhưng nó không nói lên throughput, mức tăng bộ nhớ, độ sẵn có của wheel trên mọi kiến trúc, hay hành vi dưới nhiều worker đồng thời. Bài viết này chứng minh một cơ chế precision/retention hữu ích khi so với Readability; còn phù hợp production hay không vẫn phụ thuộc vào corpus và các bài test runtime.
Nếu muốn một đối chiếu bên ngoài không phải do chính bộ này thực hiện, trang đánh giá của trafilatura và ScrapingHub article-extraction-benchmark công khai đều đặt nó cao hơn readability-lxml về word-F1 trên khoảng ~181 trang thật — cùng xu hướng với bảng ở trên. Một lưu ý mà nhiều bài viết trích benchmark này thường bỏ qua: con số F1 của trafilatura được trích dẫn rộng rãi (~0.945) gắn với dòng 0.5.1 cũ hơn, không phải 2.1.0 được kiểm thử ở đây.
Ưu và nhược điểm
Ưu điểm:
- Rò rỉ boilerplate đã gắn nhãn thấp hơn Readability trên bộ fixture chung: 1 block trong 17 so với 5.
- Lấy đúng tác giả và ngày trên fixture cục bộ, và title/ngày/hostname trên cả hai trang bài viết thật.
- Cùng một HTML có thể được xuất thành text, Markdown hoặc JSON.
- Cài đặt chỉ 17 gói, không cần browser runtime riêng.
- Lỗi được xử lý yên lặng:
fetch_urltrả vềNonetrên HTTP 500 thay vì ném lỗi. - Phiên bản được kiểm thử trùng với bản mới nhất (2.1.0) — không có lệch phiên bản.
- Giấy phép Apache-2.0 — thoáng và thân thiện với thương mại.
Nhược điểm:
- Không phải structured scraper: test catalog trả về 12 tên và 12 giá dưới dạng text và 0 dòng có kiểu. Không schema, không field.
- Không render JavaScript — chỉ HTML tĩnh; cần renderer riêng cho trang phía client.
authorvàsitenameđều null trên cả hai trang MediaWiki thật, nên trích byline không phải lúc nào cũng có.- Làm sạch mạnh tay có cái giá của nó: nó bỏ một
<figcaption>mà Readability giữ lại, và chỉ đạt 0.571 so với 0.800 của Readability trên một bài rất ngắn. - Lỗi 500 yên lặng đó mất 30.012 giây mới trả về
None; hãy dùng fetcher do bên gọi kiểm soát nếu cần quản lý deadline. - Các chế độ crawl/sitemap tích hợp và định dạng CSV/XML chưa được thử trong đợt này, nên tôi không đưa ra khẳng định nào về chúng.
Dành cho ai — và ai nên bỏ qua
trafilatura hướng đến trích xuất nội dung chính theo kiểu bài viết. Nó phù hợp để xây corpora văn bản, kho lưu trữ dễ đọc, hoặc đầu vào NLP từ HTML tĩnh khi việc làm sạch bằng heuristic là chấp nhận được. So sánh fixture chung cho thấy nó lọt ít boilerplate hơn Readability, trong khi Readability giữ lại nhiều hơn ở các trường hợp ngắn và không phải văn xuôi.
Hãy bỏ qua nếu thứ bạn thực sự cần là trích xuất có cấu trúc — các dòng sản phẩm có giá, bản ghi có kiểu, field key: value — vì công cụ này đưa cho bạn văn bản chứ không phải bảng (test catalog phục hồi đủ 12 tên và đủ 12 giá, nhưng 0 dòng). Cũng nên bỏ qua nếu mục tiêu của bạn render nội dung trong browser và bạn không muốn gắn thêm renderer riêng, vì trafilatura chỉ đọc HTML tĩnh rồi dừng ở đó. Và hãy cân nhắc kỹ nếu corpus của bạn chủ yếu là đoạn ngắn, caption hình ảnh, và trang nặng bảng biểu: trên các fixture gắn nhãn, đó chính là nơi việc làm sạch của nó bắt đầu cắt vào nội dung thật (F1 0.571 trên bài rất ngắn, bỏ mất một <figcaption>). Hãy chọn đúng công cụ cho đúng việc: toàn văn bài viết thì được; JSON có cấu trúc, trang JS, hoặc các đoạn 100 từ thì nên tìm lựa chọn khác.
Các lựa chọn thay thế, bao gồm vị trí của Thunderbit
trafilatura là một thư viện tự host theo giấy phép Apache-2.0, không có phí per-call từ nhà cung cấp; chi phí compute, băng thông, fetching, giám sát và bảo trì vẫn do người vận hành chịu. Nó xử lý trích xuất theo hướng bài viết từ HTML được đưa vào, nhưng không đảm nhiệm thực thi browser hay schema cho các dòng lặp do người dùng định nghĩa.
Để xem cùng bộ fixture trên cả sáu extractor, hãy tham khảo so sánh trích xuất của sáu thư viện.
Một dịch vụ quản lý có thể đặt acquisition, rendering và định hình schema sau ranh giới của nhà cung cấp. Chúng tôi xây dựng Thunderbit, nhưng không chạy nó trên các fixture này, nên bài viết này không đưa ra so sánh chất lượng, rendering, độ trễ, chống bot hay chi phí. Sự lựa chọn là giữa kiểm soát HTML-to-content tự host và một ranh giới hosted cho acquisition và structured-extraction.
Các bài đánh giá benchmark liên quan: so sánh toàn bộ scraper mã nguồn mở, đánh giá Crawl4AI có browser-backed Markdown, và đánh giá Firecrawl tự host Markdown.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Hãy cân nhắc trafilatura khi công việc là trích xuất theo hướng bài viết từ HTML tĩnh và ưu tiên của bạn là loại bỏ boilerplate đã gắn nhãn. Trên bộ fixture chung, nó để lọt 1 đơn vị boilerplate đã chú thích so với 5 của Readability. Lợi thế đó đi kèm khả năng giữ lại thấp hơn ở các fixture rất ngắn và không phải văn xuôi, nên hình dạng corpus sẽ là yếu tố quyết định.
Nó không thực thi JavaScript và không xuất các dòng lặp do người dùng tự định nghĩa. Trên hai trang MediaWiki, author và sitename đều là null — đây là quan sát giới hạn theo template. Readability giữ lại caption mà trafilatura bỏ qua và đạt điểm cao hơn trên fixture có nhãn f3_short_120; bằng chứng nhìn thấy chỉ ủng hộ kết luận “F1 thấp hơn trên fixture rất ngắn”, chứ không phải đếm ký tự hay nói đầu ra bị hỏng.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
trafilatura trả về cấu trúc gì? Nó có thể xuất nội dung và metadata đã trích xuất dưới dạng JSON, Markdown, text, HTML, XML hoặc CSV. Đó là serialization có cấu trúc, nhưng không phải schema dòng lặp do người dùng định nghĩa như tên sản phẩm, giá và đánh giá. Fixture catalog trả về các giá trị dưới dạng nội dung phẳng chứ không phải dòng có kiểu.
trafilatura có thể scrape catalog sản phẩm thành các dòng có cấu trúc không? Không. Nó là content extractor, không phải structured scraper. Trên một fixture catalog, nó trả về đủ 12 tên sản phẩm dưới dạng text phẳng và 0 dòng có cấu trúc — tên có trong đầu ra nhưng không phải field. Nếu bạn cần bản ghi có kiểu như tên/giá/đánh giá, hãy dùng parser dựa trên selector hoặc một API trích xuất theo schema.
trafilatura có render JavaScript không? Không. Nó chỉ tiêu thụ HTML tĩnh. Nếu bạn đưa cho nó một trang render phía client, bạn sẽ nhận đúng phần server đã gửi trước khi JavaScript chạy, và thường đó không phải nội dung bạn muốn. Hãy ghép với một renderer riêng nếu mục tiêu của bạn nặng JS.
Cài trafilatura có khó không?
Trong virtualenv Python 3.14 đã kiểm thử, việc cài đặt kéo theo 17 gói và không cần browser runtime riêng. Wheel lớn nhất được ghi nhận là lxml với 8.6 MB. Ngoài ra, một lần gọi local 500 mất 30.012 giây mới trả về None; hãy dùng HTTP client do bên gọi kiểm soát nếu bạn cần deadline đã được xác minh.
trafilatura có miễn phí cho mục đích thương mại không? Nó dùng giấy phép Apache-2.0, khá thoáng và thân thiện với thương mại. Như mọi khi, hãy kiểm tra giấy phép hiện tại trên repo trước khi xây dựng sản phẩm dựa trên nó.




