
Web đang phát triển với tốc độ thật sự khó mà theo kịp—đến năm 2026, gần một nửa lưu lượng internet là do bot tạo ra, và một phần rất lớn trong đó đến từ các doanh nghiệp dùng scraping để phục vụ bán hàng, vận hành và nghiên cứu đối thủ. Tôi đã tận mắt thấy web scraping chuyển từ một “món hay ho” dành cho dân kỹ thuật thành công cụ gần như bắt buộc với đủ mọi đối tượng, từ đội sales đến môi giới bất động sản. Nhưng có một điểm cần lưu ý: không phải công ty web scraping nào cũng giống nhau, và chọn đúng đơn vị có thể tạo ra khác biệt giữa một quy trình tự động mượt mà với cả tuần vật lộn copy-paste.
Vì vậy, tôi đã xắn tay áo và đào sâu vào danh sách những công ty web scraping tốt nhất cho năm 2026. Dù bạn là người không rành kỹ thuật, chỉ muốn lấy dữ liệu trong vài cú nhấp chuột, hay là lập trình viên cần toàn quyền kiểm soát, danh sách này sẽ tổng hợp những lựa chọn đáng chú ý nhất—kèm theo đánh giá thẳng thắn về điểm mạnh và điểm hạn chế của từng bên. Cùng bắt đầu nhé.
Vì sao doanh nghiệp cần đến các công ty web scraping hàng đầu
Trích xuất dữ liệu từ bất kỳ website nào bằng AI Get Started Free
Nếu bạn từng phải tự xây danh sách khách hàng tiềm năng, theo dõi giá của đối thủ, hoặc lấy dữ liệu sản phẩm từ hàng chục (thậm chí hàng nghìn) trang, chắc hẳn bạn hiểu rõ nỗi khổ của việc thu thập dữ liệu thủ công. Nó chậm, dễ sai sót, và nói thật là chẳng ai thấy vui cả. Đó là lý do web scraping đã phát triển thành một ngành công nghiệp thực thụ, với doanh nghiệp ứng dụng cho đủ mọi nhu cầu từ tạo lead và theo dõi giá đến nghiên cứu thị trường và phân tích cảm xúc.
Điều tuyệt nhất là gì? Chính là tự động hóa. Các công ty web scraping hiện đại cho phép bạn:
- Tự động hóa những việc nghiên cứu lặp đi lặp lại (không còn những “cuộc marathon” copy-paste)
- Mở rộng quy mô lên hàng nghìn trang mà không tốn thêm nhiều công sức
- Kết nối dữ liệu trực tiếp với các công cụ bạn hay dùng nhất (Excel, Google Sheets, Notion, CRM)
- Đi trước đối thủ nhờ dữ liệu mới hơn, giàu hơn và nhanh hơn
Nhưng có quá nhiều lựa chọn, làm sao để chọn đúng? Đó chính là lý do bài hướng dẫn này ra đời.
Chúng tôi đánh giá các công ty web scraping hàng đầu như thế nào
Không phải scraper nào cũng sinh ra để phục vụ cùng một nhóm người dùng hay cùng một nhu cầu. Đây là cách tôi đánh giá từng bên:
- Dễ sử dụng: Người không biết code có dùng nhanh được không? Giao diện có trực quan không?
- Tự động hóa & tính năng: Có xử lý được phân trang, trang con, lịch chạy và nội dung động không?
- Khả năng mở rộng: Có phù hợp với dự án lớn hay chỉ hợp việc nhỏ?
- Tích hợp: Xuất dữ liệu hoặc kết nối với công cụ khác có dễ không?
- Giá cả: Có gói miễn phí không? Có hợp túi tiền của SMB và đủ linh hoạt cho doanh nghiệp lớn không?
- Hỗ trợ & cộng đồng: Có tài liệu hướng dẫn, template và hỗ trợ thực sự khi cần không?
Tôi cũng xem xét điểm riêng khiến mỗi công ty nổi bật—vì đôi khi, công cụ “tốt nhất” không phải là công cụ nhiều tính năng nhất, mà là công cụ khớp nhất với quy trình làm việc của bạn.
Được rồi, cùng vào danh sách nhé.
1. Thunderbit
 Thunderbit là công cụ AI web scraper mà tôi hào hứng nhất cho năm 2026—và không chỉ vì tôi có tham gia xây dựng nó! Thunderbit được thiết kế cho người dùng doanh nghiệp muốn có dữ liệu, không muốn đau đầu. Tiện ích Chrome extension của Thunderbit cho phép bạn scrape bất kỳ website nào bằng prompt ngôn ngữ tự nhiên và gợi ý trường dữ liệu bằng AI. Không cần code, không cần template, không căng thẳng.
Điểm khiến Thunderbit nổi bật:
- Scraping một cú nhấp: Chỉ cần bấm “One-Click Extract”—phần còn lại để AI lo.
- Hỗ trợ trang con & phân trang: Dễ dàng lấy danh sách trước, rồi để AI đi qua từng trang con để lấy thêm chi tiết.
- Template tức thì: Với các website phổ biến (Amazon, Zillow, Shopify, v.v.), dùng template dựng sẵn để scrape chỉ với 1 cú nhấp.
- Xuất dữ liệu miễn phí: Xuất sang Excel, Google Sheets, Notion hoặc Airtable—không chặn dữ liệu của chính bạn sau tường phí.
- AI làm giàu dữ liệu: Gắn nhãn, phân loại và dịch dữ liệu ngay trong lúc scrape.
- Scheduled & Cloud Scraping: Thiết lập tác vụ định kỳ hoặc chạy trên cloud để tăng tốc.
- Gói miễn phí thật sự: Scrape tối đa 6 trang miễn phí, hoặc 10 trang với trial boost. Gói trả phí bắt đầu từ $15/tháng.
Thunderbit hiện được hơn 200.000 người dùng trên toàn thế giới tin dùng, từ đội sales đến người vận hành thương mại điện tử. Nếu bạn đang tìm trải nghiệm web scraping dễ nhất và thân thiện nhất năm 2026, Thunderbit rất khó bị vượt qua.
Muốn xem nó hoạt động thế nào? Tải Chrome extension và tự mình trải nghiệm.
2. Scrapy
 Scrapy là framework Python mã nguồn mở quen thuộc dành cho lập trình viên muốn kiểm soát toàn diện. Nó mạnh, linh hoạt và đã được kiểm chứng qua rất nhiều bài toán, từ crawl website nhỏ đến scrape hàng triệu trang.
Phù hợp nhất cho: đội kỹ thuật, data engineer và bất kỳ ai dùng Python thành thạo.
Tính năng chính:
- Tạo quy tắc tùy chỉnh: Xây spider để xử lý bất kỳ cấu trúc website nào.
- Mạnh và nhanh: Xử lý dự án scrape quy mô lớn với khả năng chống lỗi tốt.
- Tích hợp với hệ sinh thái Python: Kết nối với Pandas, Jupyter và nhiều công cụ khác.
- Miễn phí & mã nguồn mở: Không tốn phí bản quyền, cộng đồng hỗ trợ rất lớn.
Lưu ý: Scrapy có độ khó học nhất định. Nếu bạn không biết code, có lẽ nên cân nhắc công cụ khác. Nhưng với lập trình viên, đây là một cỗ máy cực mạnh (ScraperAPI).
3. ParseHub
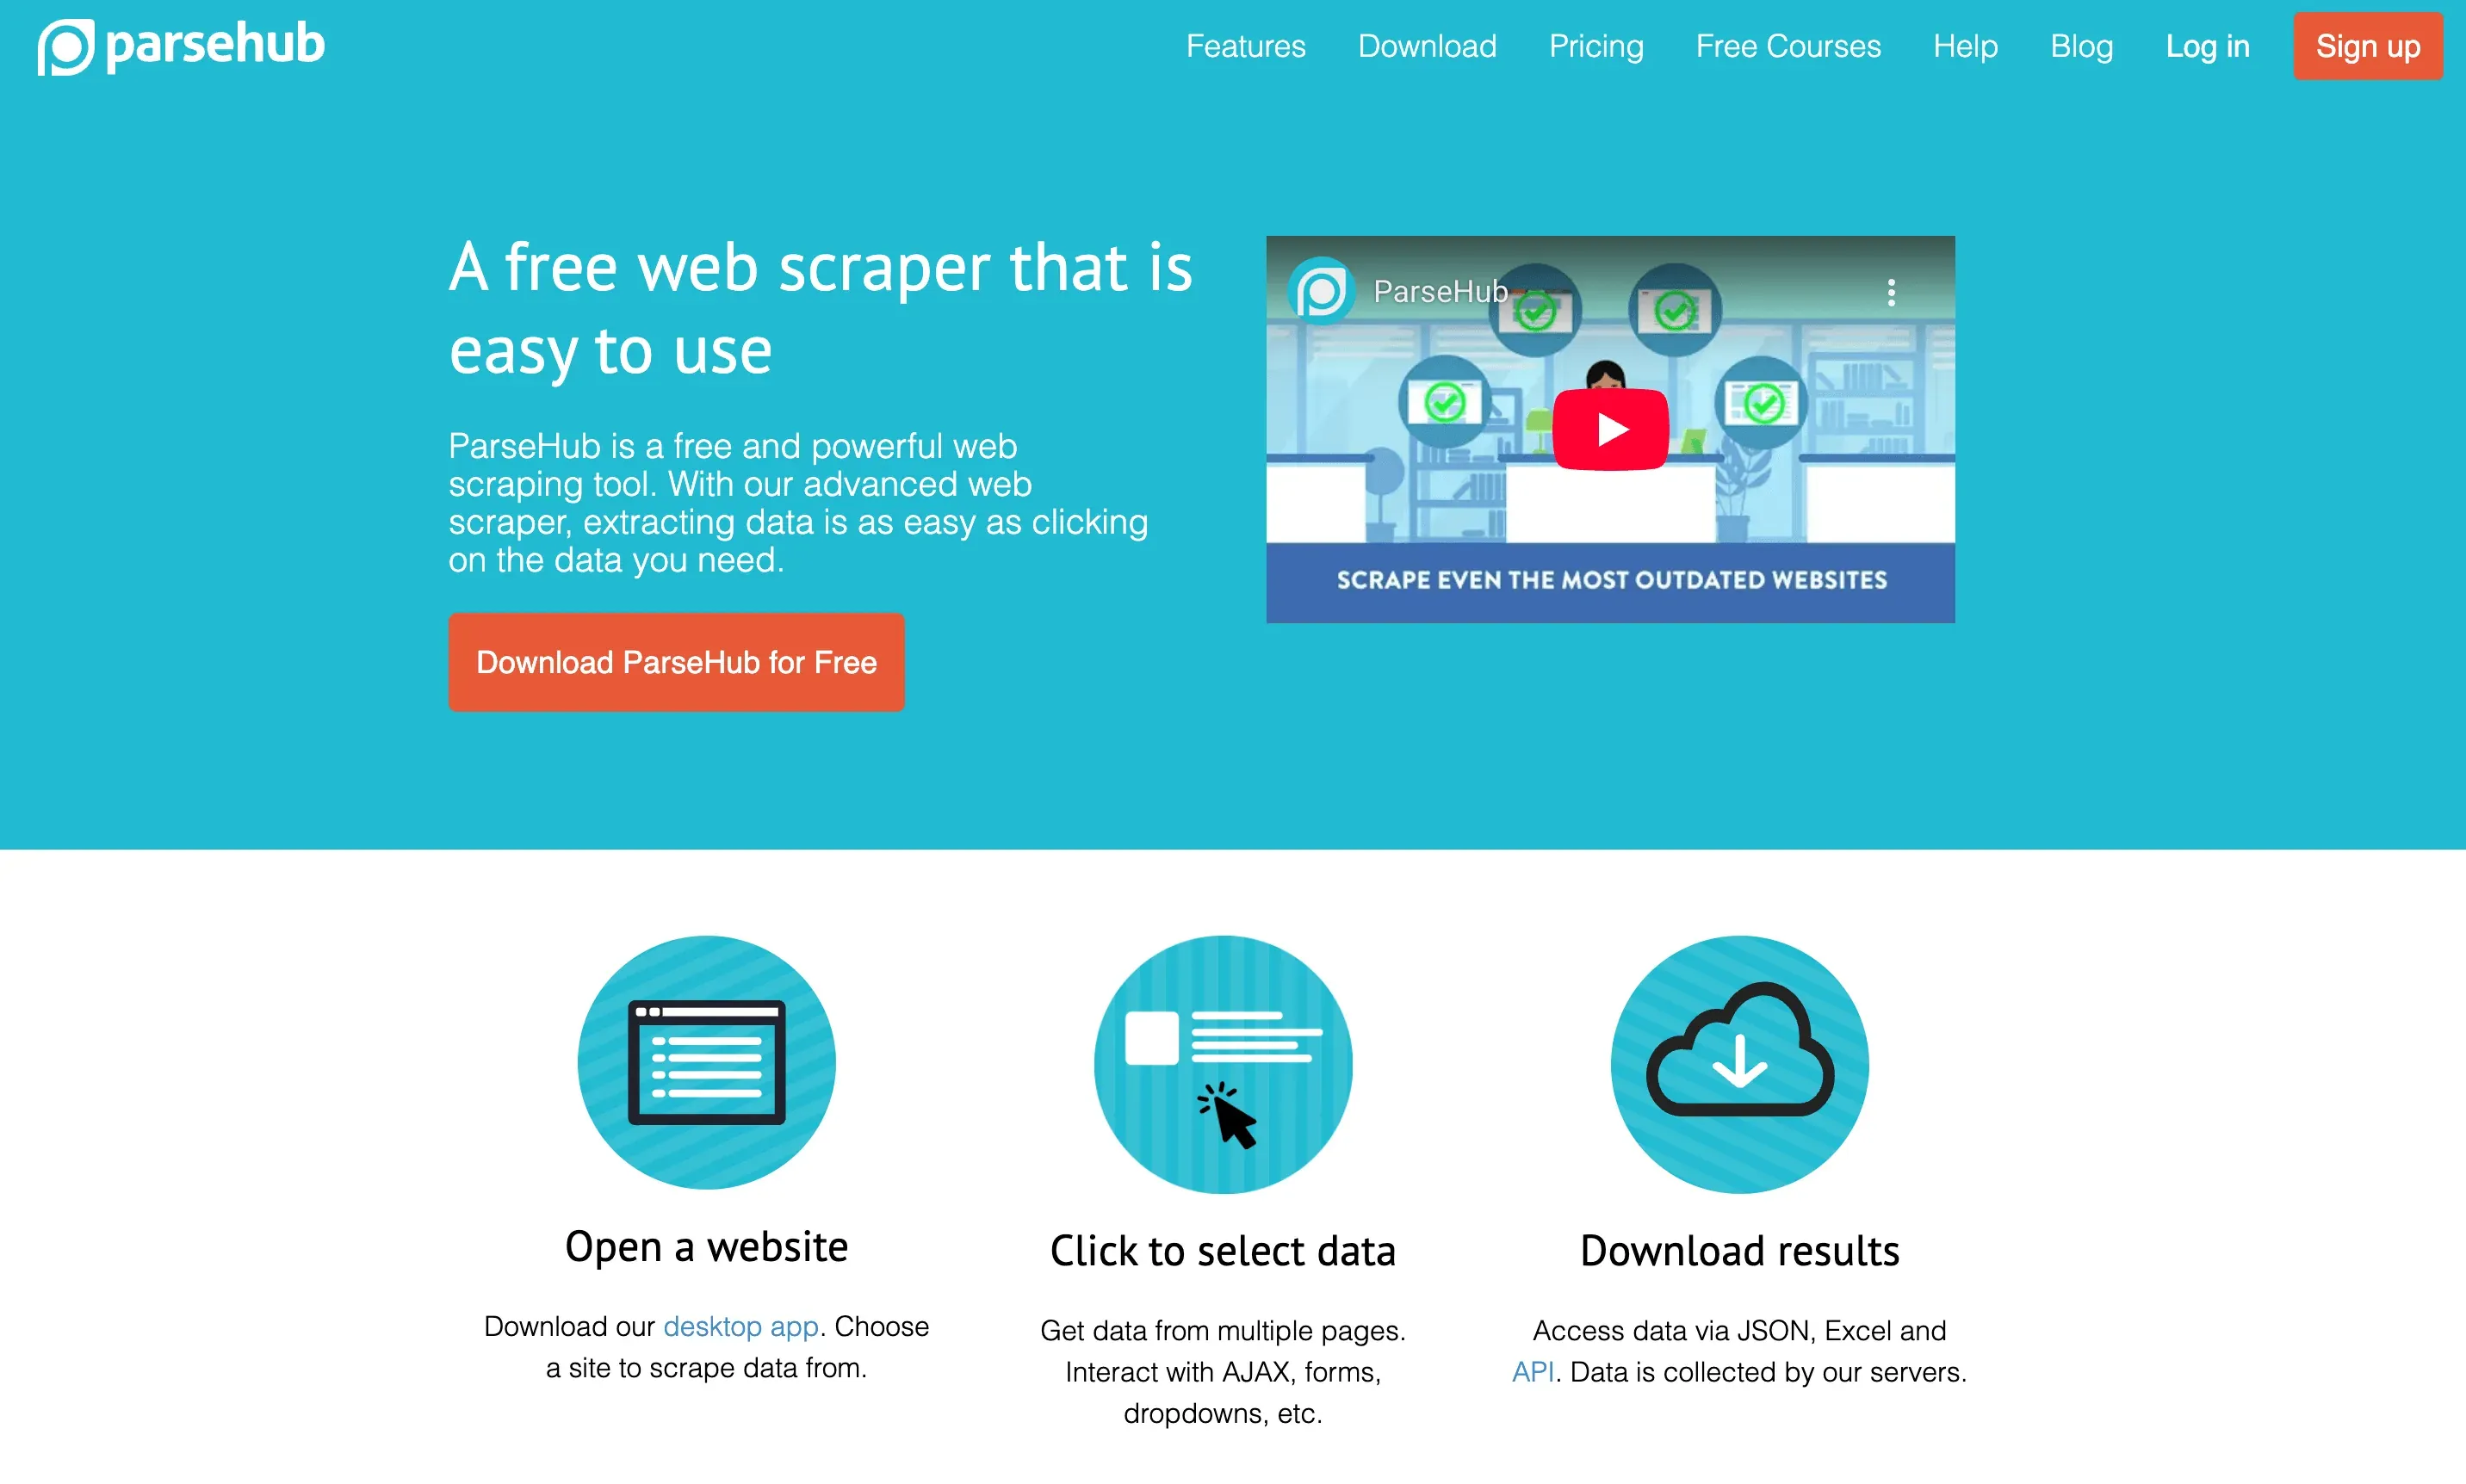 ParseHub là ứng dụng desktop giúp web scraping trở nên trực quan và dễ tiếp cận hơn. Giao diện point-and-click cho phép bạn xây scraper mà không cần viết code.
Phù hợp nhất cho: SMB, nhà nghiên cứu và người không biết code nhưng muốn sự linh hoạt.
Tính năng chính:
- Quy trình trực quan: Nhấp để chọn dữ liệu, xây logic cho phân trang và trang con.
- Lên lịch trên cloud: Chạy tác vụ theo lịch ngay cả khi máy tính của bạn đang tắt.
- Tuỳ chọn xuất dữ liệu: Tải xuống CSV, Excel hoặc JSON.
- Gói miễn phí: 5 dự án, tối đa 200 trang/lần chạy; gói trả phí từ $189/tháng.
ParseHub đặc biệt phổ biến trong việc scrape danh sách, đánh giá và dữ liệu thương mại điện tử (ScraperAPI).
4. Octoparse
 Octoparse là nền tảng web scraping no-code kéo-thả, tập trung vào tự động hóa ở quy mô lớn. Đây là lựa chọn tuyệt vời cho các team muốn thiết lập tác vụ phức tạp mà không cần viết script.
Phù hợp nhất cho: đội marketing, nghiên cứu và vận hành.
Tính năng chính:
- Workflow kéo-thả: Xây scraper bằng giao diện trực quan, xử lý nội dung động và infinite scroll.
- Cloud scraping & scheduling: Chạy tác vụ trên cloud, lên lịch lặp lại.
- Xoay IP & chống chặn: Có sẵn tính năng hỗ trợ scrape những website khó.
- Xuất sang Excel, Sheets, cơ sở dữ liệu: Tích hợp dễ dàng với quy trình làm việc của bạn.
- Gói miễn phí: Tối đa 10.000 bản ghi/tháng; gói trả phí từ $83/tháng, hoặc $69/tháng nếu thanh toán theo năm.
Octoparse đặc biệt được đánh giá cao nhờ tốc độ và khả năng xử lý các dự án quy mô lớn (ScraperAPI).
5. DataMiner
 DataMiner là một Chrome extension mang web scraping ngay vào trình duyệt của bạn. Công cụ này rất phù hợp để scrape nhanh theo template cho bảng, danh sách và các website đơn giản.
Phù hợp nhất cho: người dùng phổ thông, sales ops và bất kỳ ai làm việc chủ yếu trên Chrome.
Tính năng chính:
- Kho template: Hơn 60.000 công thức dựng sẵn cho các website phổ biến.
- Trích xuất point-and-click: Chọn dữ liệu bằng thao tác trực quan, không cần code.
- Xuất sang Excel/Google Sheets: Chỉ một cú nhấp để export.
- Gói miễn phí: 500 trang/tháng; gói trả phí từ $19/tháng.
DataMiner là lựa chọn quen thuộc cho các tác vụ nhanh và người không chuyên về kỹ thuật (DataMiner).
6. Import.io
 Import.io là nền tảng cấp doanh nghiệp, tập trung biến nội dung web thành dữ liệu có cấu trúc phục vụ phân tích và business intelligence.
Phù hợp nhất cho: doanh nghiệp lớn có nhu cầu dữ liệu và yêu cầu tích hợp cao.
Tính năng chính:
- Mô hình dịch vụ quản lý: Đội ngũ Import.io có thể xây và duy trì scraper thay cho bạn.
- Giao diện trực quan: Tạo workflow trích xuất mà không cần code.
- Truy cập API: Đưa dữ liệu scrape trực tiếp vào ứng dụng và dashboard.
- Tuân thủ & bảo mật: Kiểm soát ở cấp doanh nghiệp, che giấu PII và nhiều hơn nữa.
Giá: báo giá theo yêu cầu, thường bắt đầu khoảng $199/tháng (PromptCloud).
7. Apify
 Apify là nền tảng tự động hóa thân thiện với lập trình viên, sở hữu marketplace rất lớn gồm các “Actor” dựng sẵn (scraping bot) cùng khả năng xây workflow tùy chỉnh.
Phù hợp nhất cho: lập trình viên, agency và các đội cần sự linh hoạt.
Tính năng chính:
- Actor marketplace: Scraper dựng sẵn cho các website phổ biến, hoặc tự xây cái riêng.
- Hạ tầng cloud: Chạy scrape ở quy mô lớn, đặt lịch và tích hợp API.
- Tích hợp GitHub: Tự động hóa workflow và CI/CD.
- Trả theo mức dùng: Có credit miễn phí, sau đó tính theo sử dụng; gói trả phí từ $29/tháng.
Apify phù hợp cho cả dự án đơn giản lẫn phức tạp (Black Bear Media).
8. Diffbot
 Diffbot dùng AI và knowledge graph để biến nội dung web phi cấu trúc thành dữ liệu có cấu trúc, có thể đọc bằng máy. Có thể hiểu đây là “bộ não” của web scraping.
Phù hợp nhất cho: doanh nghiệp lớn, nhà nghiên cứu và bất kỳ ai cần trích xuất tự động ở quy mô lớn.
Tính năng chính:
- Trích xuất bằng AI: Tự động nhận diện bài viết, sản phẩm, tổ chức và nhiều loại nội dung khác.
- Knowledge graph: Truy cập đồ thị dữ liệu web lớn nhất thế giới qua API.
- Làm giàu dữ liệu: Kéo thêm thực thể liên quan, tin tức và ngữ cảnh.
- API-first: Tích hợp với công cụ BI và data pipeline.
Giá: từ $299/tháng (Diffbot Pricing).
9. WebHarvy
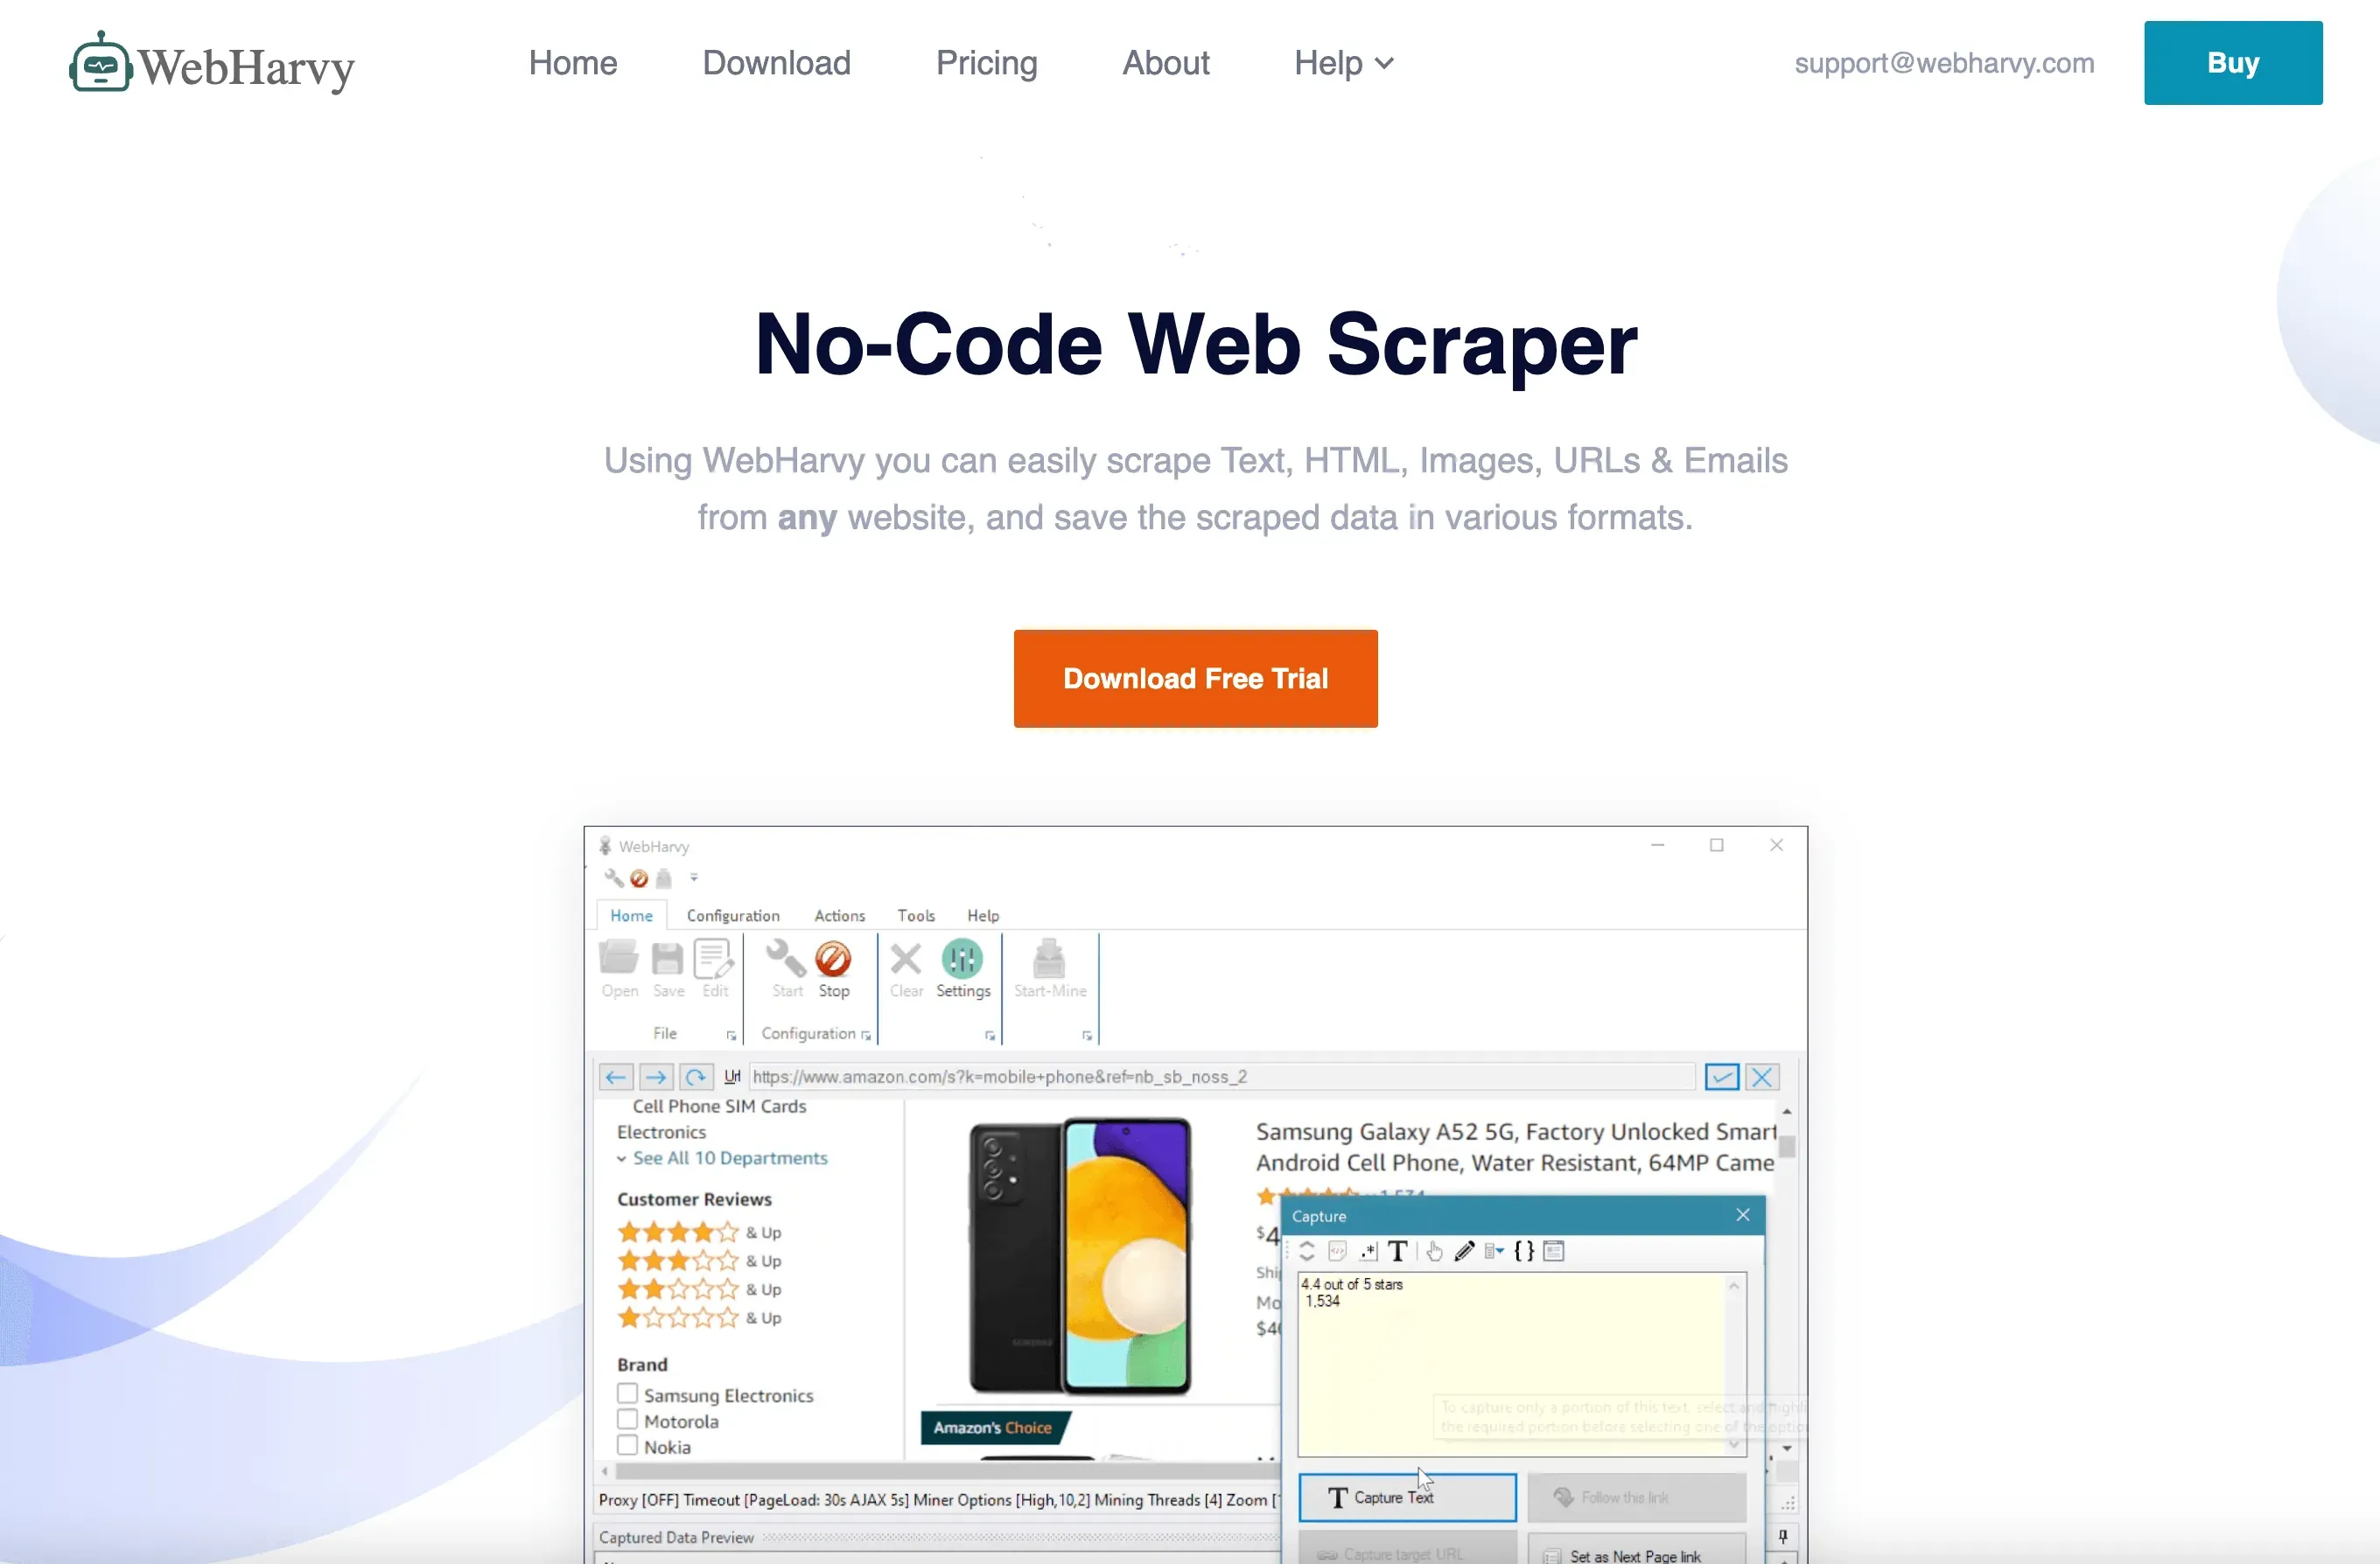 WebHarvy là công cụ desktop trên Windows với giao diện trực quan point-and-click. Nó phù hợp với người muốn tránh code và thích ứng dụng cài trên máy.
Phù hợp nhất cho: người dùng Windows, nhà nghiên cứu và SMB.
Tính năng chính:
- Chọn dữ liệu trực quan: Nhấp vào dữ liệu để xác định field—không cần code.
- Xử lý hình ảnh & điều hướng nhiều trang: Scrape văn bản, hình ảnh và theo dõi phân trang.
- Xuất sang Excel, XML, cơ sở dữ liệu: Nhiều tùy chọn đầu ra linh hoạt.
- Giấy phép một lần: Trả một lần, dùng mãi mãi (WebHarvy).
WebHarvy đặc biệt phổ biến với các website thương mại điện tử và trang tin rao vặt (Thunderbit Blog).
10. Mozenda
 Mozenda là nền tảng cloud được xây dựng cho việc trích xuất dữ liệu và tự động hóa ở cấp doanh nghiệp.
Phù hợp nhất cho: tổ chức lớn, các ngành có yêu cầu tuân thủ nghiêm ngặt.
Tính năng chính:
- Tự động hóa trên cloud: Lên lịch, giám sát và quản lý tác vụ scrape tập trung.
- Biến đổi dữ liệu: Làm sạch, làm giàu và xuất dữ liệu ở nhiều định dạng.
- Cộng tác nhóm: Hỗ trợ nhiều người dùng và quản lý workflow.
- Hỗ trợ doanh nghiệp: Tuân thủ, độ tin cậy và hỗ trợ riêng (Appvizer).
Giá: khoảng $99/tháng; có báo giá doanh nghiệp.
11. Sequentum (trước đây là Content Grabber)
 Sequentum là công cụ desktop/web scraper nâng cao dành cho chuyên gia dữ liệu và agency. Nếu bạn từng biết đến nó với tên Content Grabber thì giờ tên đó đã không còn nữa — Sequentum đã đổi tên sản phẩm và contentgrabber.com hiện không còn hoạt động (Sequentum FAQ).
Phù hợp nhất cho: chuyên gia dữ liệu, agency và bất kỳ ai cần tự động hóa chuyên sâu.
Tính năng chính:
- Script nâng cao: Tự động hóa logic trích xuất phức tạp.
- Báo cáo & giám sát: Theo dõi tác vụ, nhận cảnh báo và quản lý dự án lớn.
- Tích hợp: Xuất sang cơ sở dữ liệu, API hoặc cloud storage.
- Không có gói miễn phí: Chỉ có license trả phí (DataOX).
Sequentum được xây cho các nhu cầu trích xuất khối lượng lớn, tùy biến cao.
12. Helium Scraper
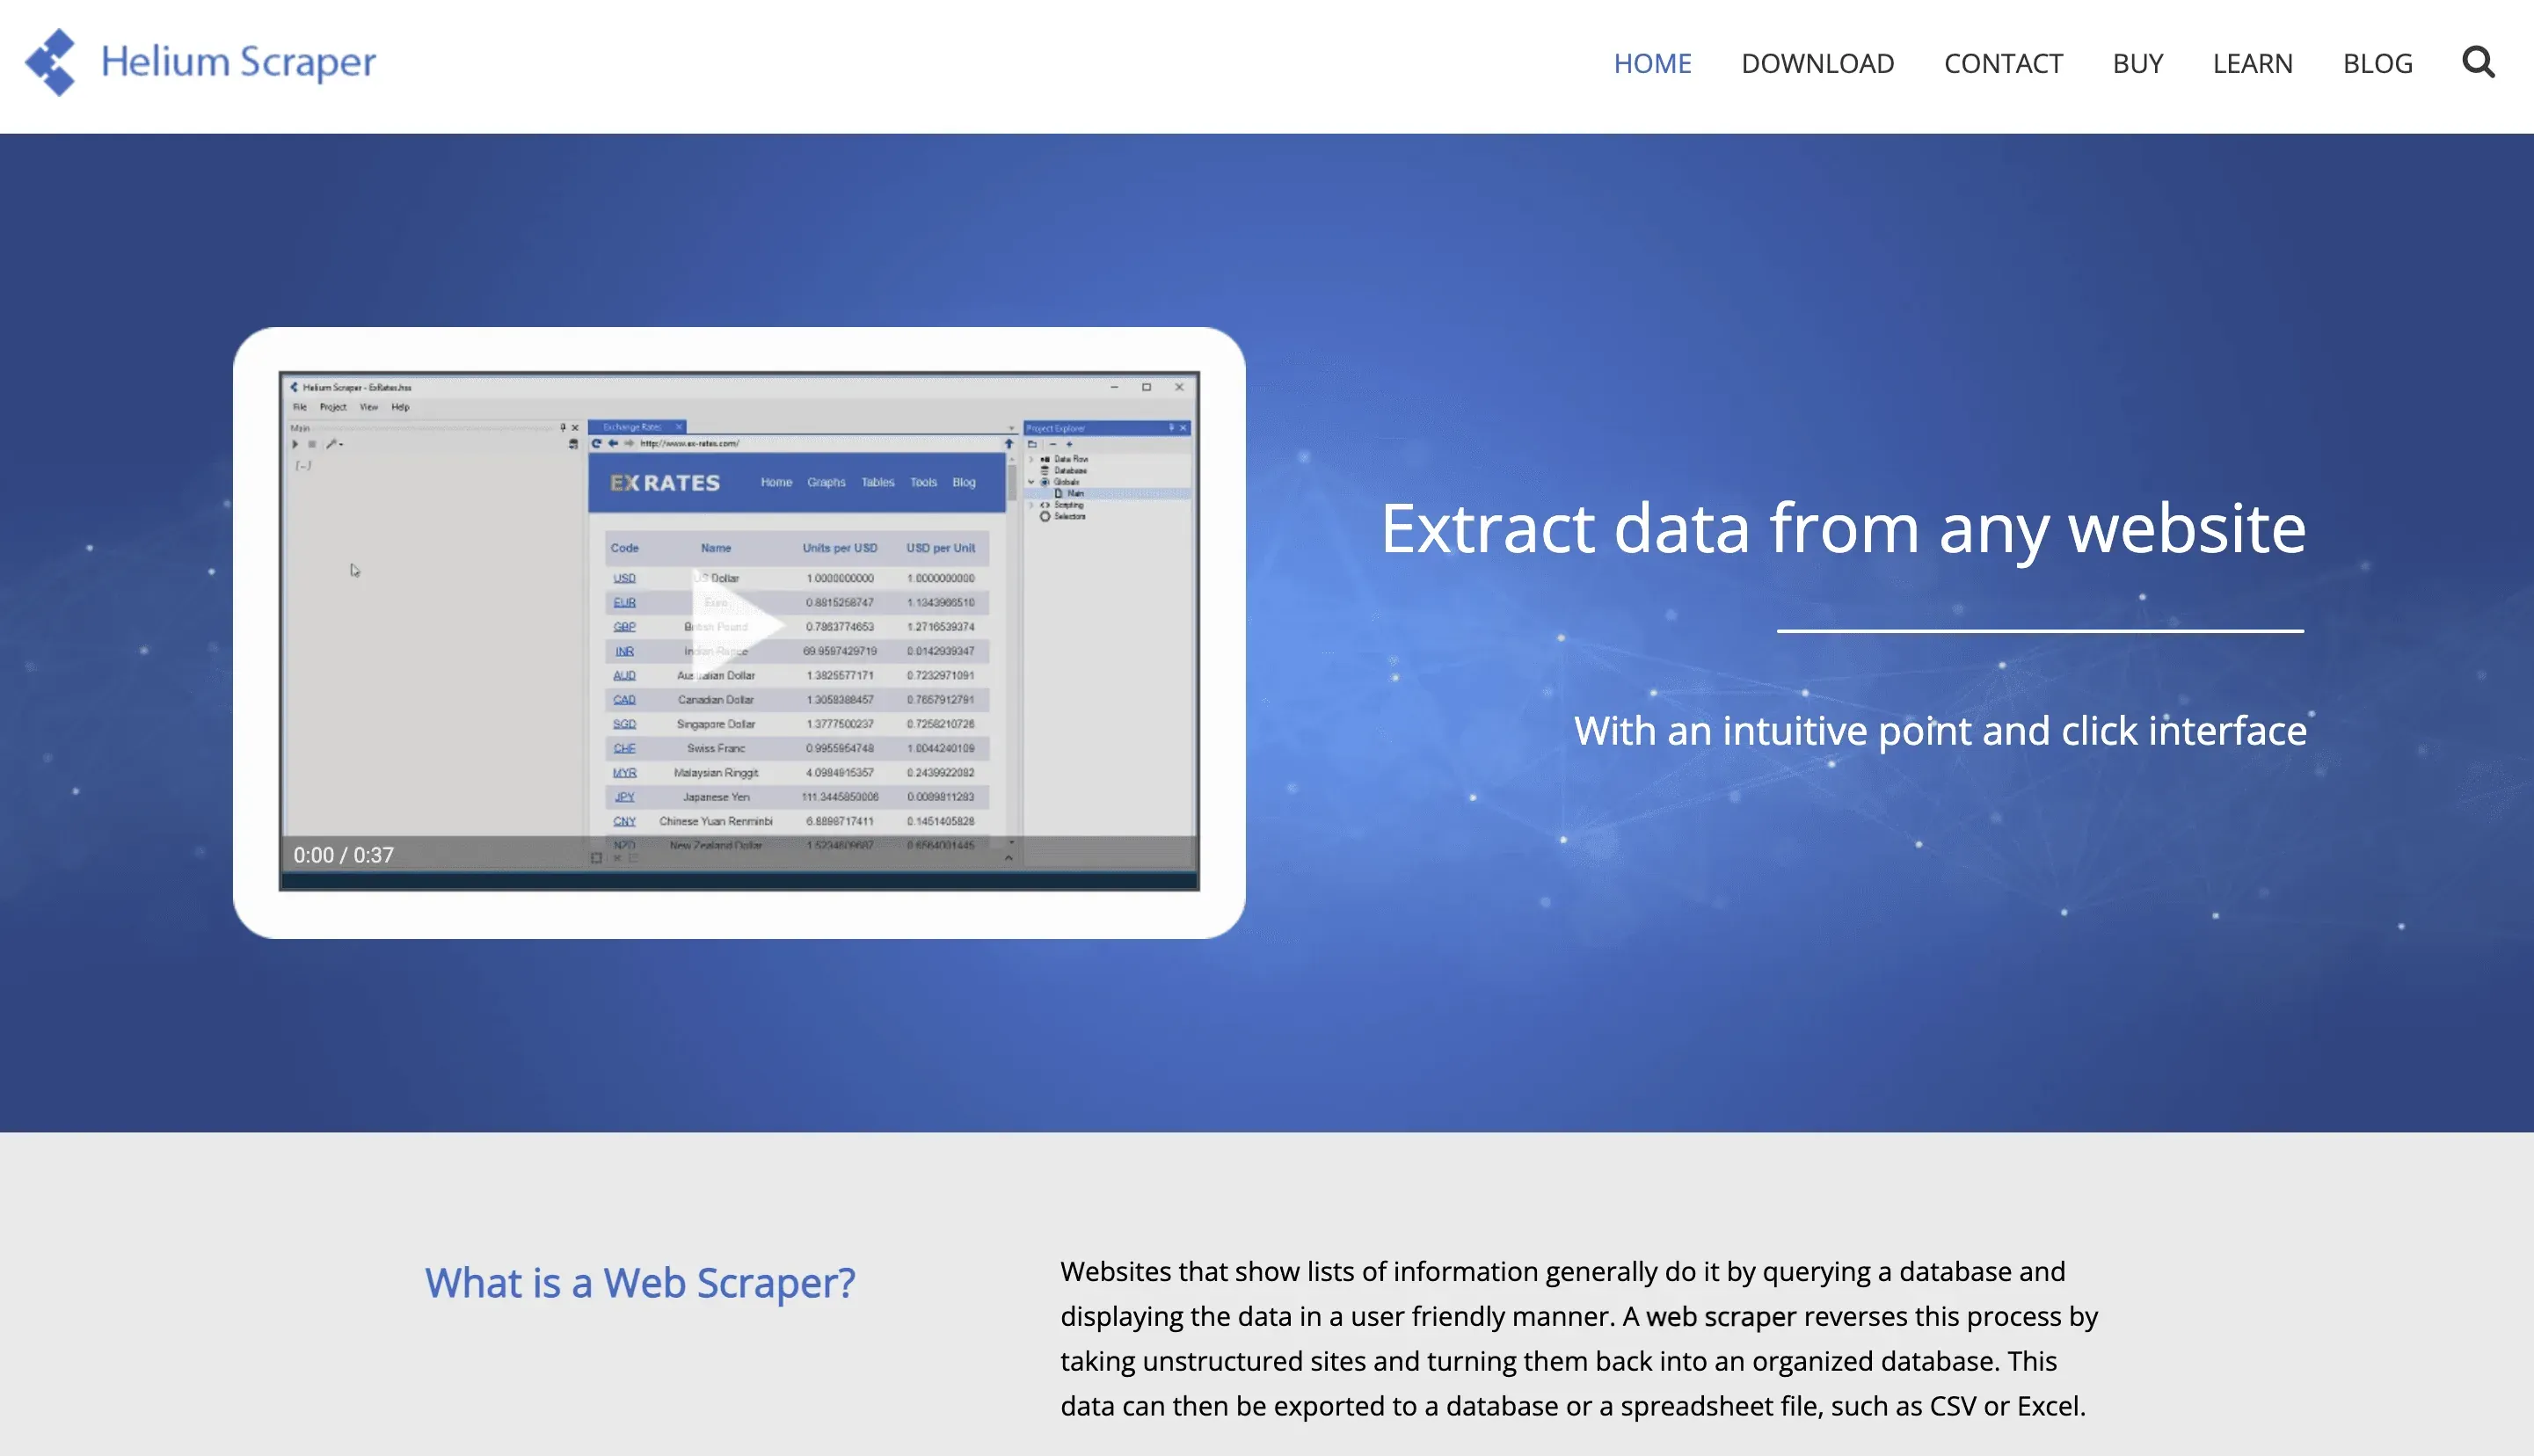 Helium Scraper là công cụ desktop có trình dựng workflow trực quan, rất phù hợp để trích xuất dữ liệu từ các website phức tạp và động.
Phù hợp nhất cho: power user, analyst và bất kỳ ai muốn linh hoạt mà không phải code.
Tính năng chính:
- Workflow trực quan: Giao diện kéo-thả để xây logic trích xuất.
- Xử lý nội dung động: Hoạt động tốt với các website dùng nhiều JavaScript.
- Biến đổi dữ liệu: Làm sạch và sắp xếp dữ liệu trước khi xuất.
- Tuỳ chọn xuất: Excel, CSV, cơ sở dữ liệu và nhiều hơn nữa.
- Phí một lần: License vĩnh viễn từ $99 (Basic, 1 user) đến $699 (Enterprise, 10 users)—không thu phí thuê bao (Helium Scraper).
Helium Scraper đặc biệt phù hợp với các website không theo mẫu thông thường và workflow tùy chỉnh.
So sánh các công ty web scraping hàng đầu: tổng quan tính năng
Dưới đây là bảng so sánh nhanh để bạn dễ chọn công cụ phù hợp:
Gợi ý nhanh:
- Cho người không biết code: Thunderbit, DataMiner, ParseHub, WebHarvy
- Cho lập trình viên: Scrapy, Apify, Sequentum
- Cho doanh nghiệp lớn: Import.io, Diffbot, Mozenda
- Cho workflow trực quan, linh hoạt: Thunderbit, Octoparse, Helium Scraper
Kết luận: Chọn đúng đối tác web scraping cho doanh nghiệp của bạn
Khám phá thêm các hướng dẫn web scraping Get Started Free
Web scraping năm 2026 không còn là chuyện riêng của dân kỹ thuật—đó là năng lực cốt lõi cho bất kỳ doanh nghiệp nào cần dữ liệu để ra quyết định thông minh hơn và nhanh hơn. Một công ty web scraping phù hợp có thể giúp bạn tiết kiệm hàng giờ, tăng ROI và mở ra những insight mà đối thủ có thể bỏ lỡ.
Lời khuyên của tôi:
- Chọn công cụ theo đội ngũ của bạn: Người không rành kỹ thuật sẽ thích Thunderbit hoặc DataMiner. Lập trình viên nên xem Scrapy hoặc Apify. Doanh nghiệp lớn có thể cân nhắc Import.io hoặc Diffbot.
- Nghĩ về quy mô và tích hợp: Bạn có cần scrape hàng nghìn trang không? Bạn muốn dữ liệu đi vào Sheets, Notion hay CRM?
- Bắt đầu bằng bản dùng thử miễn phí: Hầu hết công cụ đều có gói miễn phí—hãy test trên một dự án thật trước khi quyết định.
- Đừng ngại kết hợp nhiều công cụ: Đôi khi workflow tốt nhất là sự phối hợp của vài công cụ khác nhau.
Và nếu bạn muốn thấy web scraping có thể dễ đến mức nào, hãy thử Thunderbit. Bảng tính của bạn (và cả sự bình tĩnh của bạn) sẽ biết ơn đấy.
Để xem thêm phân tích chuyên sâu, mẹo và hướng dẫn, hãy ghé Thunderbit Blog.
Bắt đầu scraping với Thunderbit
Câu hỏi thường gặp
1. Web scraping là gì và vì sao quan trọng với doanh nghiệp năm 2026?
Web scraping là quá trình tự động trích xuất dữ liệu từ website. Nó rất quan trọng với doanh nghiệp vì cho phép thu thập dữ liệu nhanh, ở quy mô lớn cho tạo lead, theo dõi giá, nghiên cứu thị trường và nhiều mục đích khác—giúp tiết kiệm thời gian và ra quyết định tốt hơn.
2. Công ty web scraping nào phù hợp nhất cho người không rành kỹ thuật?
Thunderbit và DataMiner là những lựa chọn hàng đầu cho người không biết code, nhờ giao diện AI và giao diện trực quan. Cả hai đều cho phép bạn trích xuất dữ liệu chỉ trong vài cú nhấp, không cần lập trình.
3. Tôi nên tìm những tính năng nào ở một công ty web scraping?
Hãy ưu tiên sự dễ dùng, tự động hóa (phân trang, trang con, lên lịch), khả năng mở rộng, tuỳ chọn xuất dữ liệu (Excel, Sheets, API) và hỗ trợ khách hàng tốt. Chọn công cụ phù hợp với kỹ năng kỹ thuật và nhu cầu kinh doanh của bạn.
4. Có giải pháp web scraping miễn phí không?
Có! Thunderbit, DataMiner, ParseHub và Octoparse đều có gói miễn phí. Scrapy là mã nguồn mở nên miễn phí cho lập trình viên. Các gói miễn phí rất phù hợp cho dự án nhỏ hoặc dùng thử trước khi mở rộng.
5. Làm sao để scraping dữ liệu một cách tuân thủ và có đạo đức?
Luôn tôn trọng điều khoản sử dụng và chính sách quyền riêng tư của website. Chỉ scrape dữ liệu công khai, tránh gây quá tải cho trang web, và lưu ý các quy định về bảo mật dữ liệu như GDPR. Nhiều công ty web scraping hàng đầu có sẵn tính năng hỗ trợ tuân thủ và hướng dẫn thực hành tốt nhất.
Sẵn sàng scraping thông minh hơn chưa? Dùng thử Thunderbit miễn phí hoặc khám phá thêm hướng dẫn trên Thunderbit Blog.
Thử AI Web Scraper Get Started Free
Tìm hiểu thêm
- Top 5 phần mềm web data scraping tốt nhất năm 2026
- 7 công cụ web scraping phổ biến nhất nên dùng năm 2026



