
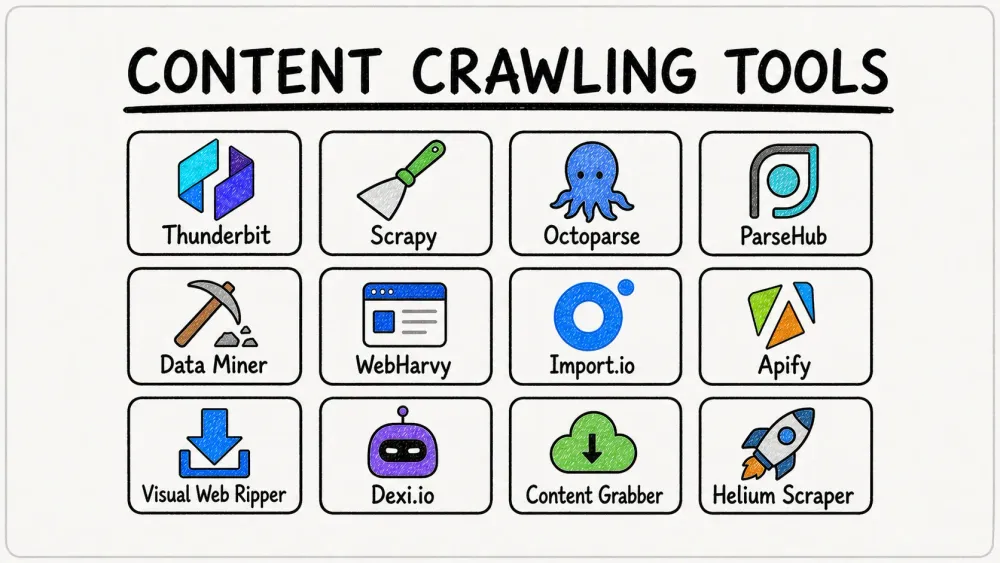
Web thì ngập tràn dữ liệu, nhưng có một vấn đề: thu thập thủ công thì chán chẳng khác gì ngồi nhìn sơn khô—mà hiệu suất cũng chẳng khá hơn bao nhiêu. Đến năm 2026, doanh nghiệp đang “bơi” trong lượng nội dung web nhiều hơn bao giờ hết, khi mức tiêu thụ dữ liệu web hằng ngày trung bình của một công ty tăng từ 1,2 TB năm 2020 lên 8 TB năm 2025 (Actowiz Solutions). Dù bạn làm sales, marketing, ecommerce hay vận hành, nhu cầu về dữ liệu web nhanh, có cấu trúc và chính xác không còn là “có thì tốt” nữa — mà là yêu cầu sống còn của vận hành. Và nói thẳng ra: chẳng ai có thời gian cho những cuộc marathon copy-paste vô tận.
Trích xuất dữ liệu từ bất kỳ website nào bằng AI Chỉ cần click một lần, AI sẽ đọc trang, hiểu cấu trúc và trả về bảng dữ liệu sạch. Gói miễn phí hỗ trợ 6 trang mỗi tháng. Get Started Free
Đó là lý do các công cụ crawling nội dung bùng nổ mạnh mẽ. Từ tiện ích Chrome dùng AI đến các nền tảng cấp doanh nghiệp, những công cụ này giúp bạn tự động hóa toàn bộ quy trình, biến các trang web rối rắm thành spreadsheet gọn gàng, cơ sở dữ liệu hoặc dashboard thời gian thực. Tôi đã làm trong SaaS và automation nhiều năm, và có thể khẳng định: công cụ phù hợp không chỉ tiết kiệm thời gian, mà còn có thể thay đổi cách cả team vận hành. Vì vậy, hãy cùng khám phá top 16 công cụ crawling nội dung cho web scraping hiệu quả trong năm 2026, tập trung vào điểm mạnh riêng của từng công cụ, mức độ phù hợp với nhu cầu doanh nghiệp khác nhau và cách chọn công cụ tốt nhất cho workflow của bạn.
Vì sao doanh nghiệp cần những công cụ crawling nội dung hàng đầu
Nếu bạn từng tự tay xây danh sách lead, theo dõi giá đối thủ hay đo lường cảm xúc thị trường, hẳn bạn hiểu việc thu thập dữ liệu thủ công nhanh chóng biến thành ác mộng như thế nào. Nó chậm, dễ sai, và đến lúc làm xong thì dữ liệu có khi đã lỗi thời. Đó là lý do hơn 70% doanh nghiệp đã áp dụng web extraction tự động vào năm 2025, cắt giảm khoảng 60% công sức thủ công (Actowiz Solutions).
Công cụ crawling nội dung tự động trích xuất dữ liệu có cấu trúc từ website, giúp bạn:
- Đẩy lead mới vào CRM (không còn copy-paste từ các thư mục danh bạ)
- Theo dõi giá và tồn kho của đối thủ theo thời gian thực
- Tổng hợp review, tin tức và lượt nhắc trên mạng xã hội để phục vụ insight marketing
- Tạo bộ dữ liệu tùy chỉnh cho nghiên cứu hoặc phân tích
- Lên lịch lấy dữ liệu định kỳ cho báo cáo liên tục
Và ROI là có thật: các doanh nghiệp dùng web scraping báo cáo đã tiết kiệm tổng cộng hơn 500 triệu USD trong giai đoạn 2020–2025, đồng thời tăng hiệu suất vận hành thêm 20–40% (Actowiz Solutions). Nói ngắn gọn: công cụ crawling nội dung giúp team của bạn tập trung vào chiến lược thay vì công việc nhàm chán.
Chúng tôi chọn các công cụ crawling nội dung hàng đầu như thế nào
Không phải web scraper nào cũng giống nhau. Khi xây danh sách này, tôi đánh giá công cụ dưới góc nhìn của người dùng doanh nghiệp thực thụ — các team sales, marketing, vận hành và nghiên cứu cần kết quả, không cần phiền toái. Những tiêu chí quan trọng nhất gồm:
- Dễ sử dụng: Người không biết kỹ thuật có thể bắt đầu nhanh không? Có giao diện click là dùng hay hỗ trợ AI không?
- Tự động hóa & tính năng: Công cụ có xử lý được phân trang, subpage, lịch chạy và nội dung động không? Có thể chạy trên cloud để tăng tốc và mở rộng không?
- Đầu ra dữ liệu & tích hợp: Có xuất được sang Excel, CSV, Google Sheets, Airtable, Notion hoặc kết nối qua API không?
- Khả năng mở rộng: Phù hợp cho tác vụ một lần hay các dự án lớn, liên tục?
- Tùy biến: Có chỉnh logic trích xuất, thêm trường tùy chỉnh hoặc xử lý website khó không?
- Tuân thủ & quyền riêng tư: Công cụ có giúp bạn an toàn với GDPR, CCPA và điều khoản website không?
- Hỗ trợ & cộng đồng: Có tài liệu, hỗ trợ hoặc cộng đồng người dùng để giải quyết sự cố không?
- Chi phí: Có gói miễn phí hoặc bản dùng thử không? Mức giá có phù hợp quy mô và ngân sách không?
Và tất nhiên, tôi dành spotlight đặc biệt cho Thunderbit — công cụ mà team tôi và tôi đã xây dựng — vì tôi thật sự tin đây là cách dễ nhất để người dùng doanh nghiệp bắt đầu với web scraping bằng AI.
18 công cụ crawling nội dung hàng đầu cho web scraping hiệu quả
Hãy cùng đi qua những công cụ tốt nhất, từ sự đơn giản nhờ AI đến các “cỗ máy” dành cho developer, và mọi thứ ở giữa.
1. Thunderbit
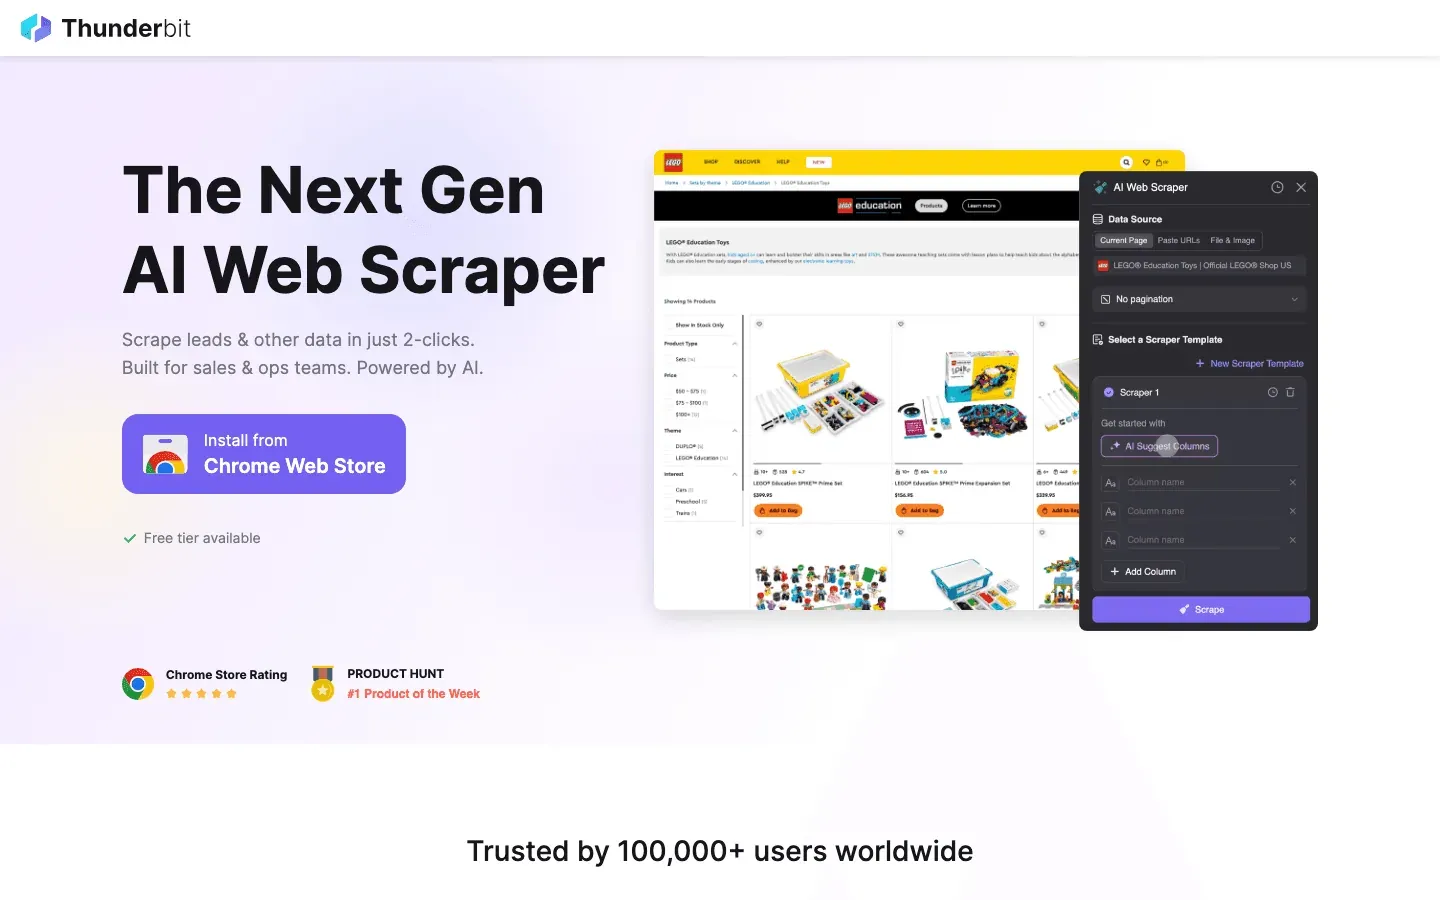 Thunderbit là tiện ích Chrome AI web scraper dành cho người dùng doanh nghiệp muốn có kết quả nhanh. Tính năng nổi bật nhất là One Click Extract: chỉ cần mở một trang web, click một lần, AI của Thunderbit sẽ đọc trang, nhận diện các trường dữ liệu và tự thiết lập scraper cho bạn. Không cần code, không phải lo selector — chỉ cần click, scrape và xuất dữ liệu.
- Scrape subpage: Thunderbit có thể tự động truy cập từng subpage (như trang chi tiết sản phẩm hoặc hồ sơ) để làm giàu dữ liệu, rất lý tưởng cho lead generation hoặc nghiên cứu ecommerce.
- Phân trang & template: Xử lý danh sách nhiều trang và có sẵn template cho các trang như Amazon, Zillow và Instagram.
- Xuất dữ liệu miễn phí: Xuất sang Excel, Google Sheets, Airtable, Notion, CSV hoặc JSON — không bị khóa trả phí.
- AI Autofill: Tự động điền form online bằng AI, mở rộng từ scraping sang tự động hóa workflow.
- Cloud & browser scraping: Chọn cloud scraping tốc độ cao cho website công khai hoặc chế độ trình duyệt cho phiên đăng nhập.
- Giá: Miễn phí tối đa 6 trang (hoặc 10 trang với bản dùng thử), gói trả phí chỉ từ $15/tháng.
Thunderbit phù hợp nhất cho các team sales, marketing và vận hành muốn tự động hóa thu thập dữ liệu mà không đau đầu vì kỹ thuật. Đây là công cụ mà tôi ước mình có từ nhiều năm trước — giờ thì bất kỳ ai cũng có thể tạo danh sách lead hoặc theo dõi đối thủ chỉ trong vài phút.
Dùng thử Thunderbit AI Web Scraper miễn phí Không cần cấu hình crawler, không phải bảo trì selector. Xuất sang Excel, Google Sheets, Airtable hoặc Notion mà không mất thêm phí. Get Started Free
2. Scrapy
 Scrapy là “đầu tàu” mã nguồn mở dành cho developer. Đây là framework dựa trên Python, cho phép bạn viết spider tùy chỉnh để crawl và trích xuất dữ liệu ở quy mô lớn. Scrapy được xây dựng để chạy nhanh và linh hoạt, hỗ trợ crawling bất đồng bộ, pipeline tùy chỉnh, xoay proxy và tích hợp với cơ sở dữ liệu hoặc API.
- Phù hợp nhất cho: Developer và data engineer xây dựng dự án scraping lớn, phức tạp hoặc chạy định kỳ.
- Điểm mạnh: Kiểm soát toàn diện, mở rộng tốt, cộng đồng lớn và độ tin cậy đã được kiểm chứng.
- Hạn chế: Khó học với người không biết code; không có giao diện trực quan.
Nếu bạn rành Python và muốn xây crawler mạnh, ổn định, có thể mở rộng, Scrapy là tiêu chuẩn vàng.
3. Octoparse
 Octoparse là web scraper no-code, chạy trên cloud với giao diện kéo-thả trực quan. Bạn có thể click để chọn dữ liệu, thiết lập phân trang và thậm chí dùng AI để nhận diện pattern nhằm rút ngắn thời gian cài đặt.
- Template có sẵn: Trích xuất dữ liệu từ các trang phổ biến như Amazon, Twitter và Google Maps chỉ trong vài phút.
- Cloud scraping & scheduling: Chạy job trên máy chủ của Octoparse, lên lịch tác vụ định kỳ và xử lý dự án quy mô lớn.
- Tùy chọn xuất dữ liệu: CSV, Excel, JSON, tích hợp API.
- Giá: Có gói miễn phí với giới hạn; gói trả phí từ khoảng $75/tháng.
Octoparse rất phù hợp cho business analyst và người không lập trình nhưng vẫn muốn scraping mạnh mẽ mà không cần viết code.
4. ParseHub
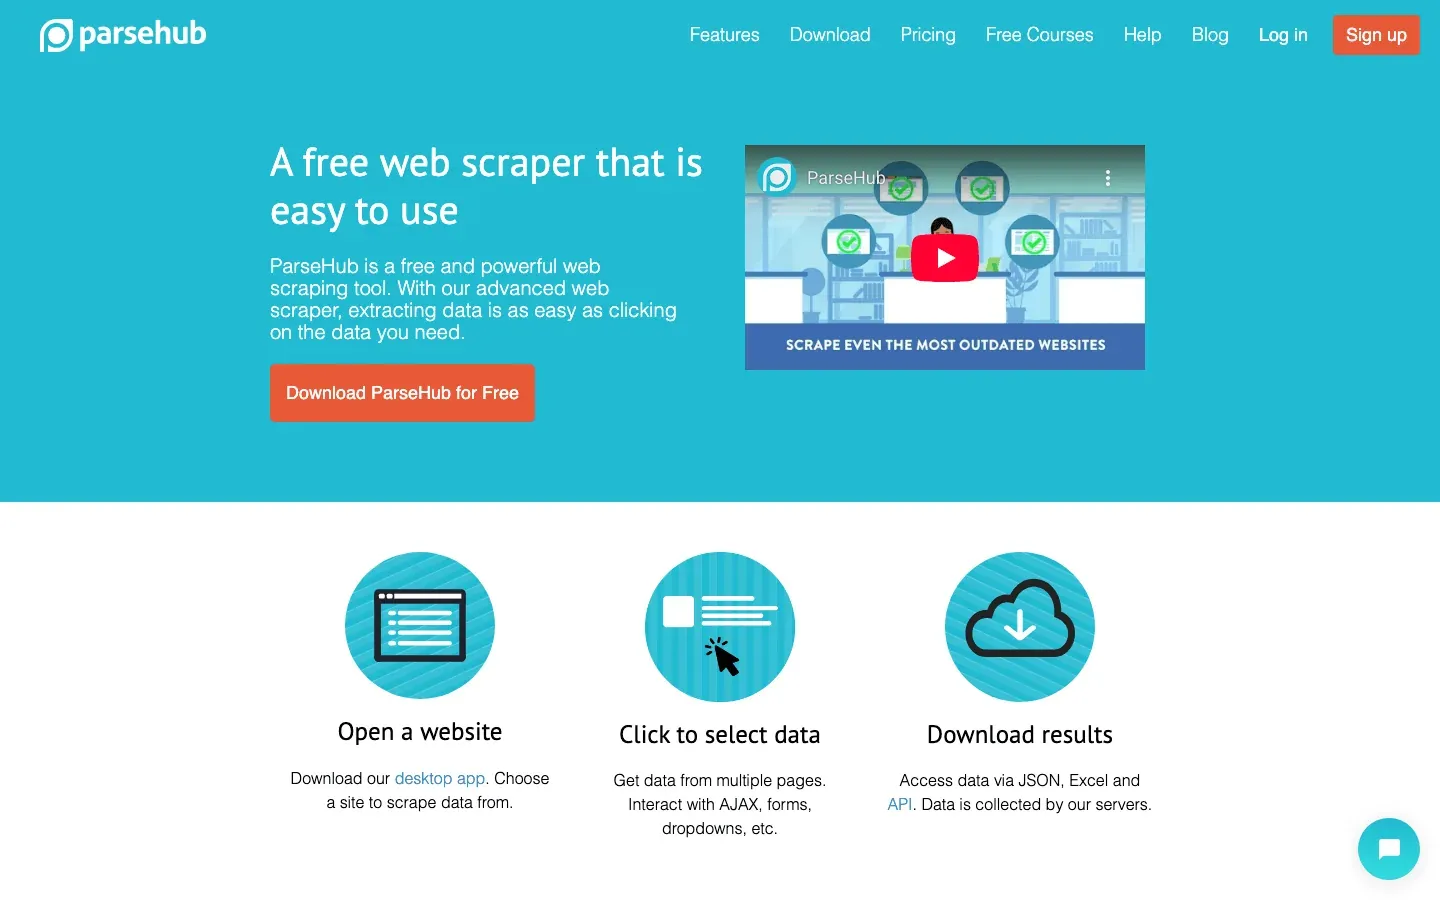 ParseHub là công cụ web scraper trực quan, nổi bật khi xử lý nội dung động và cấu trúc website phức tạp. Giao diện click để chọn cho phép bạn xây workflow với logic điều kiện, vòng lặp và điều hướng nhiều cấp.
- Nội dung động: Xử lý được dropdown, infinite scroll và các phần tử tương tác.
- Chạy cloud & local: Chạy dự án trên cloud (bản trả phí) hoặc chạy cục bộ cho tác vụ nhỏ.
- Xuất dữ liệu: CSV, Excel, JSON, API.
- Giá: Gói miễn phí khá hào phóng; gói trả phí từ $49/tháng.
ParseHub rất hợp cho người không biết code nhưng cần sự linh hoạt và sức mạnh để xử lý các website khó.
5. Data Miner
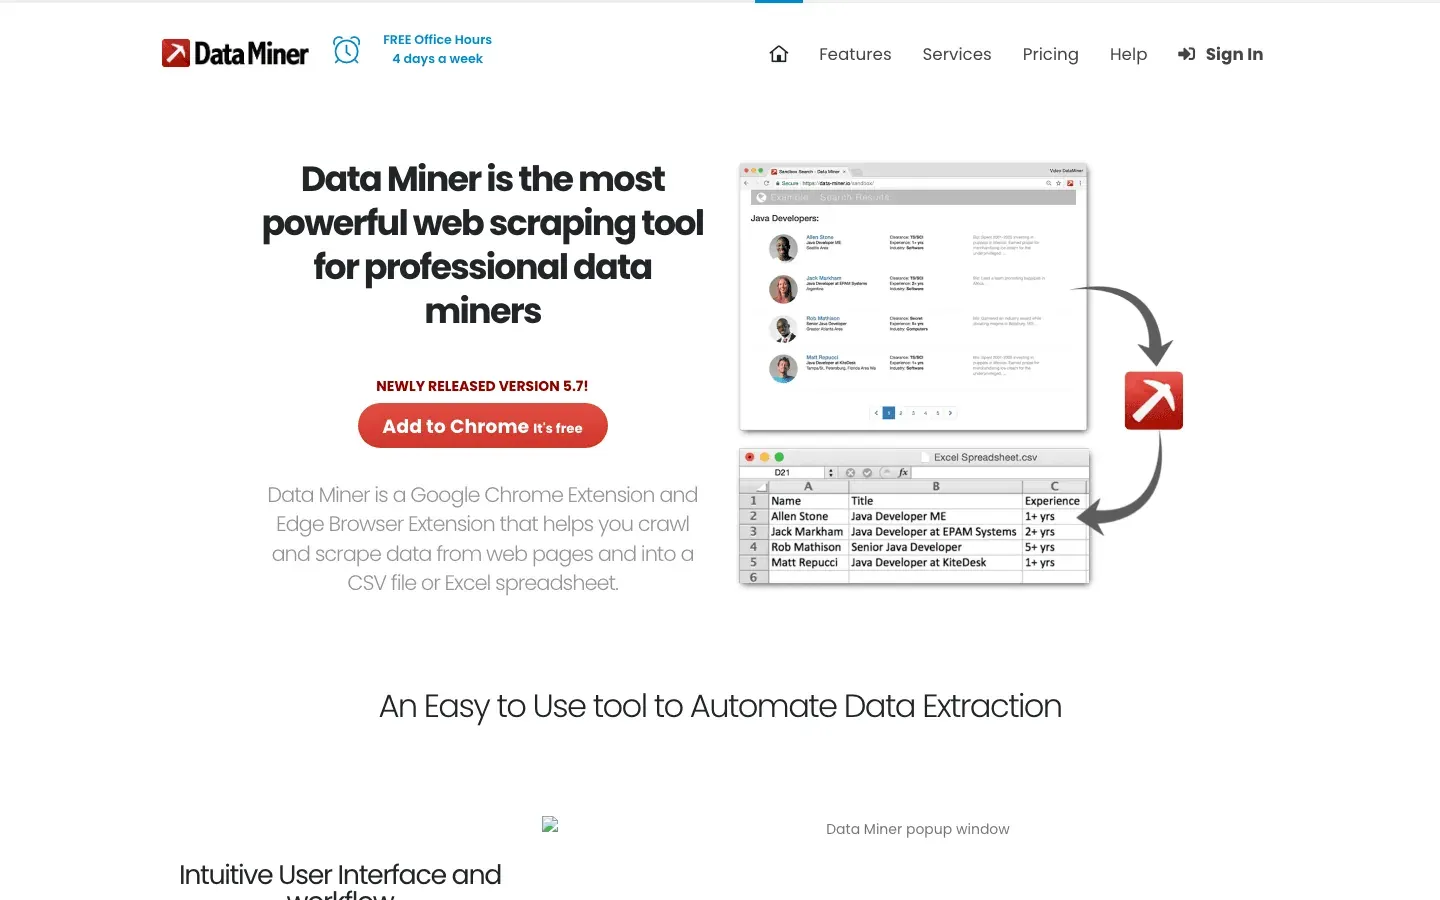 Data Miner là extension cho Chrome/Edge dành cho scraping nhanh theo template. Với hơn 50.000 extraction recipe công khai cho hơn 15.000 website, bạn thường chỉ cần một cú click là scrape xong trang.
- Tích hợp Google Sheets: Đẩy dữ liệu scrape trực tiếp lên Sheets.
- Recipe tùy chỉnh: Tự xây logic trích xuất bằng click chuột hoặc XPath.
- Phân trang & tự động hóa: Hỗ trợ scraping nhiều trang và chạy theo lịch.
- Giá: Có gói miễn phí; gói trả phí từ $19/tháng.
Phù hợp với analyst và marketer cần lấy dữ liệu nhanh, quy mô nhỏ đến trung bình, ngay trong trình duyệt.
6. WebHarvy
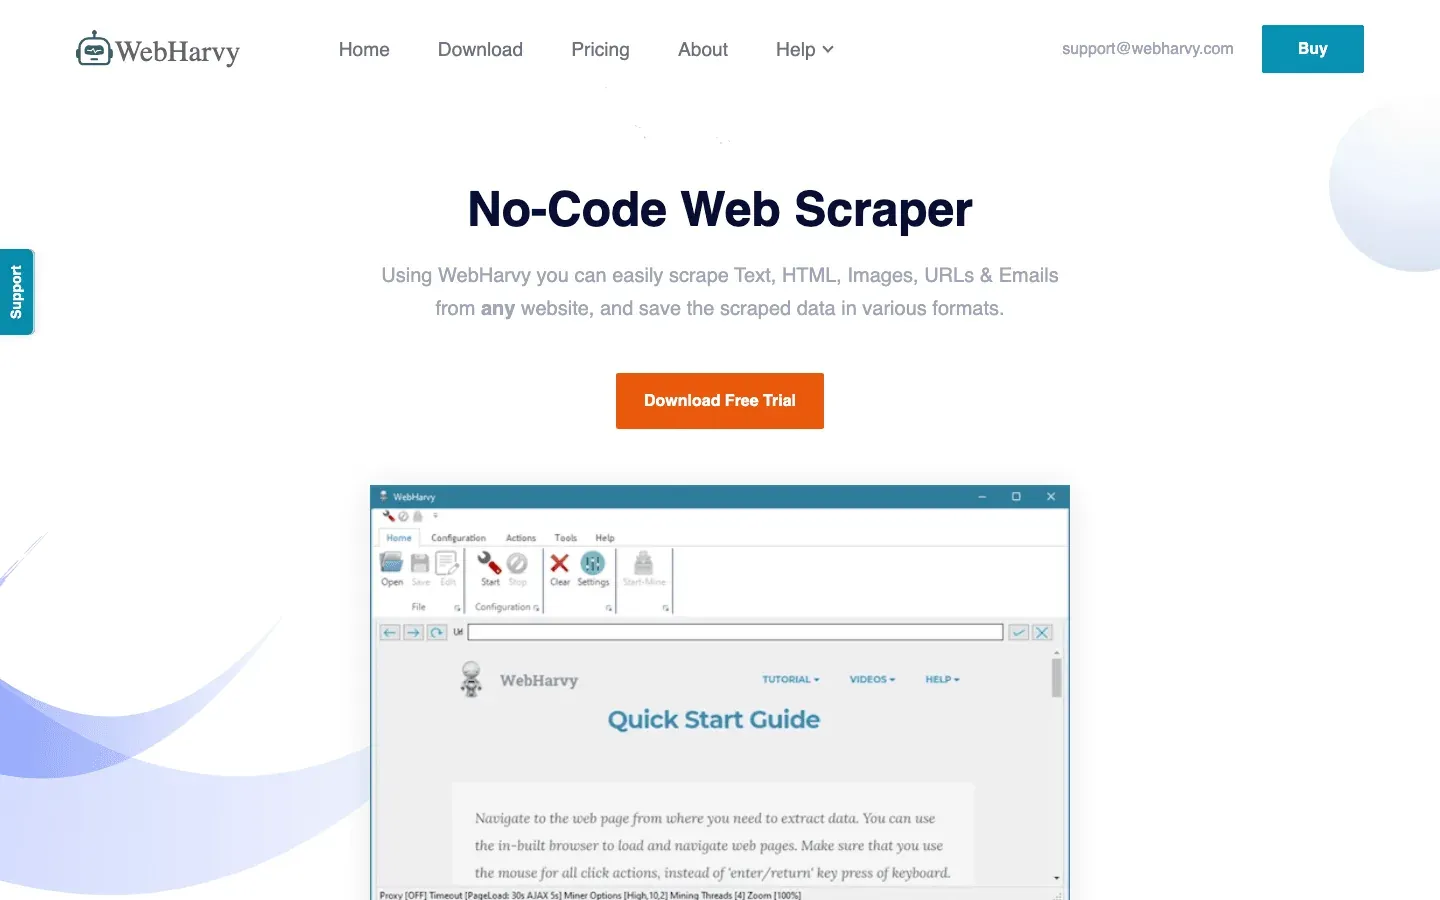 WebHarvy là ứng dụng desktop trên Windows với giao diện click để chọn và tự động nhận diện pattern. Chỉ cần chọn một phần tử, WebHarvy sẽ đánh dấu tất cả item tương tự để trích xuất.
- Hỗ trợ hình ảnh, văn bản, phân trang: Scrape ảnh sản phẩm, email, URL và nhiều hơn nữa.
- Lên lịch trên desktop: Hẹn giờ scrape ngay trên máy tính cá nhân.
- Giấy phép một lần: Khoảng $199 mỗi PC.
Rất phù hợp cho doanh nghiệp nhỏ muốn một công cụ đơn giản, không cần thuê bao để scrape định kỳ.
7. Import.io
 Import.io là nền tảng cloud cấp doanh nghiệp cho trích xuất dữ liệu quy mô lớn. Công cụ này có AI hỗ trợ làm sạch dữ liệu, giám sát thời gian thực và các tính năng tuân thủ mạnh.
- Tích hợp API: Đưa dữ liệu trực tiếp vào database, BI dashboard hoặc ứng dụng.
- Tuân thủ: Được thiết kế với GDPR và CCPA trong đầu.
- Giá: Hợp đồng doanh nghiệp; thuộc phân khúc cao cấp.
Phù hợp nhất cho tổ chức lớn cần pipeline dữ liệu web đáng tin cậy, có thể mở rộng và tuân thủ.
8. Apify
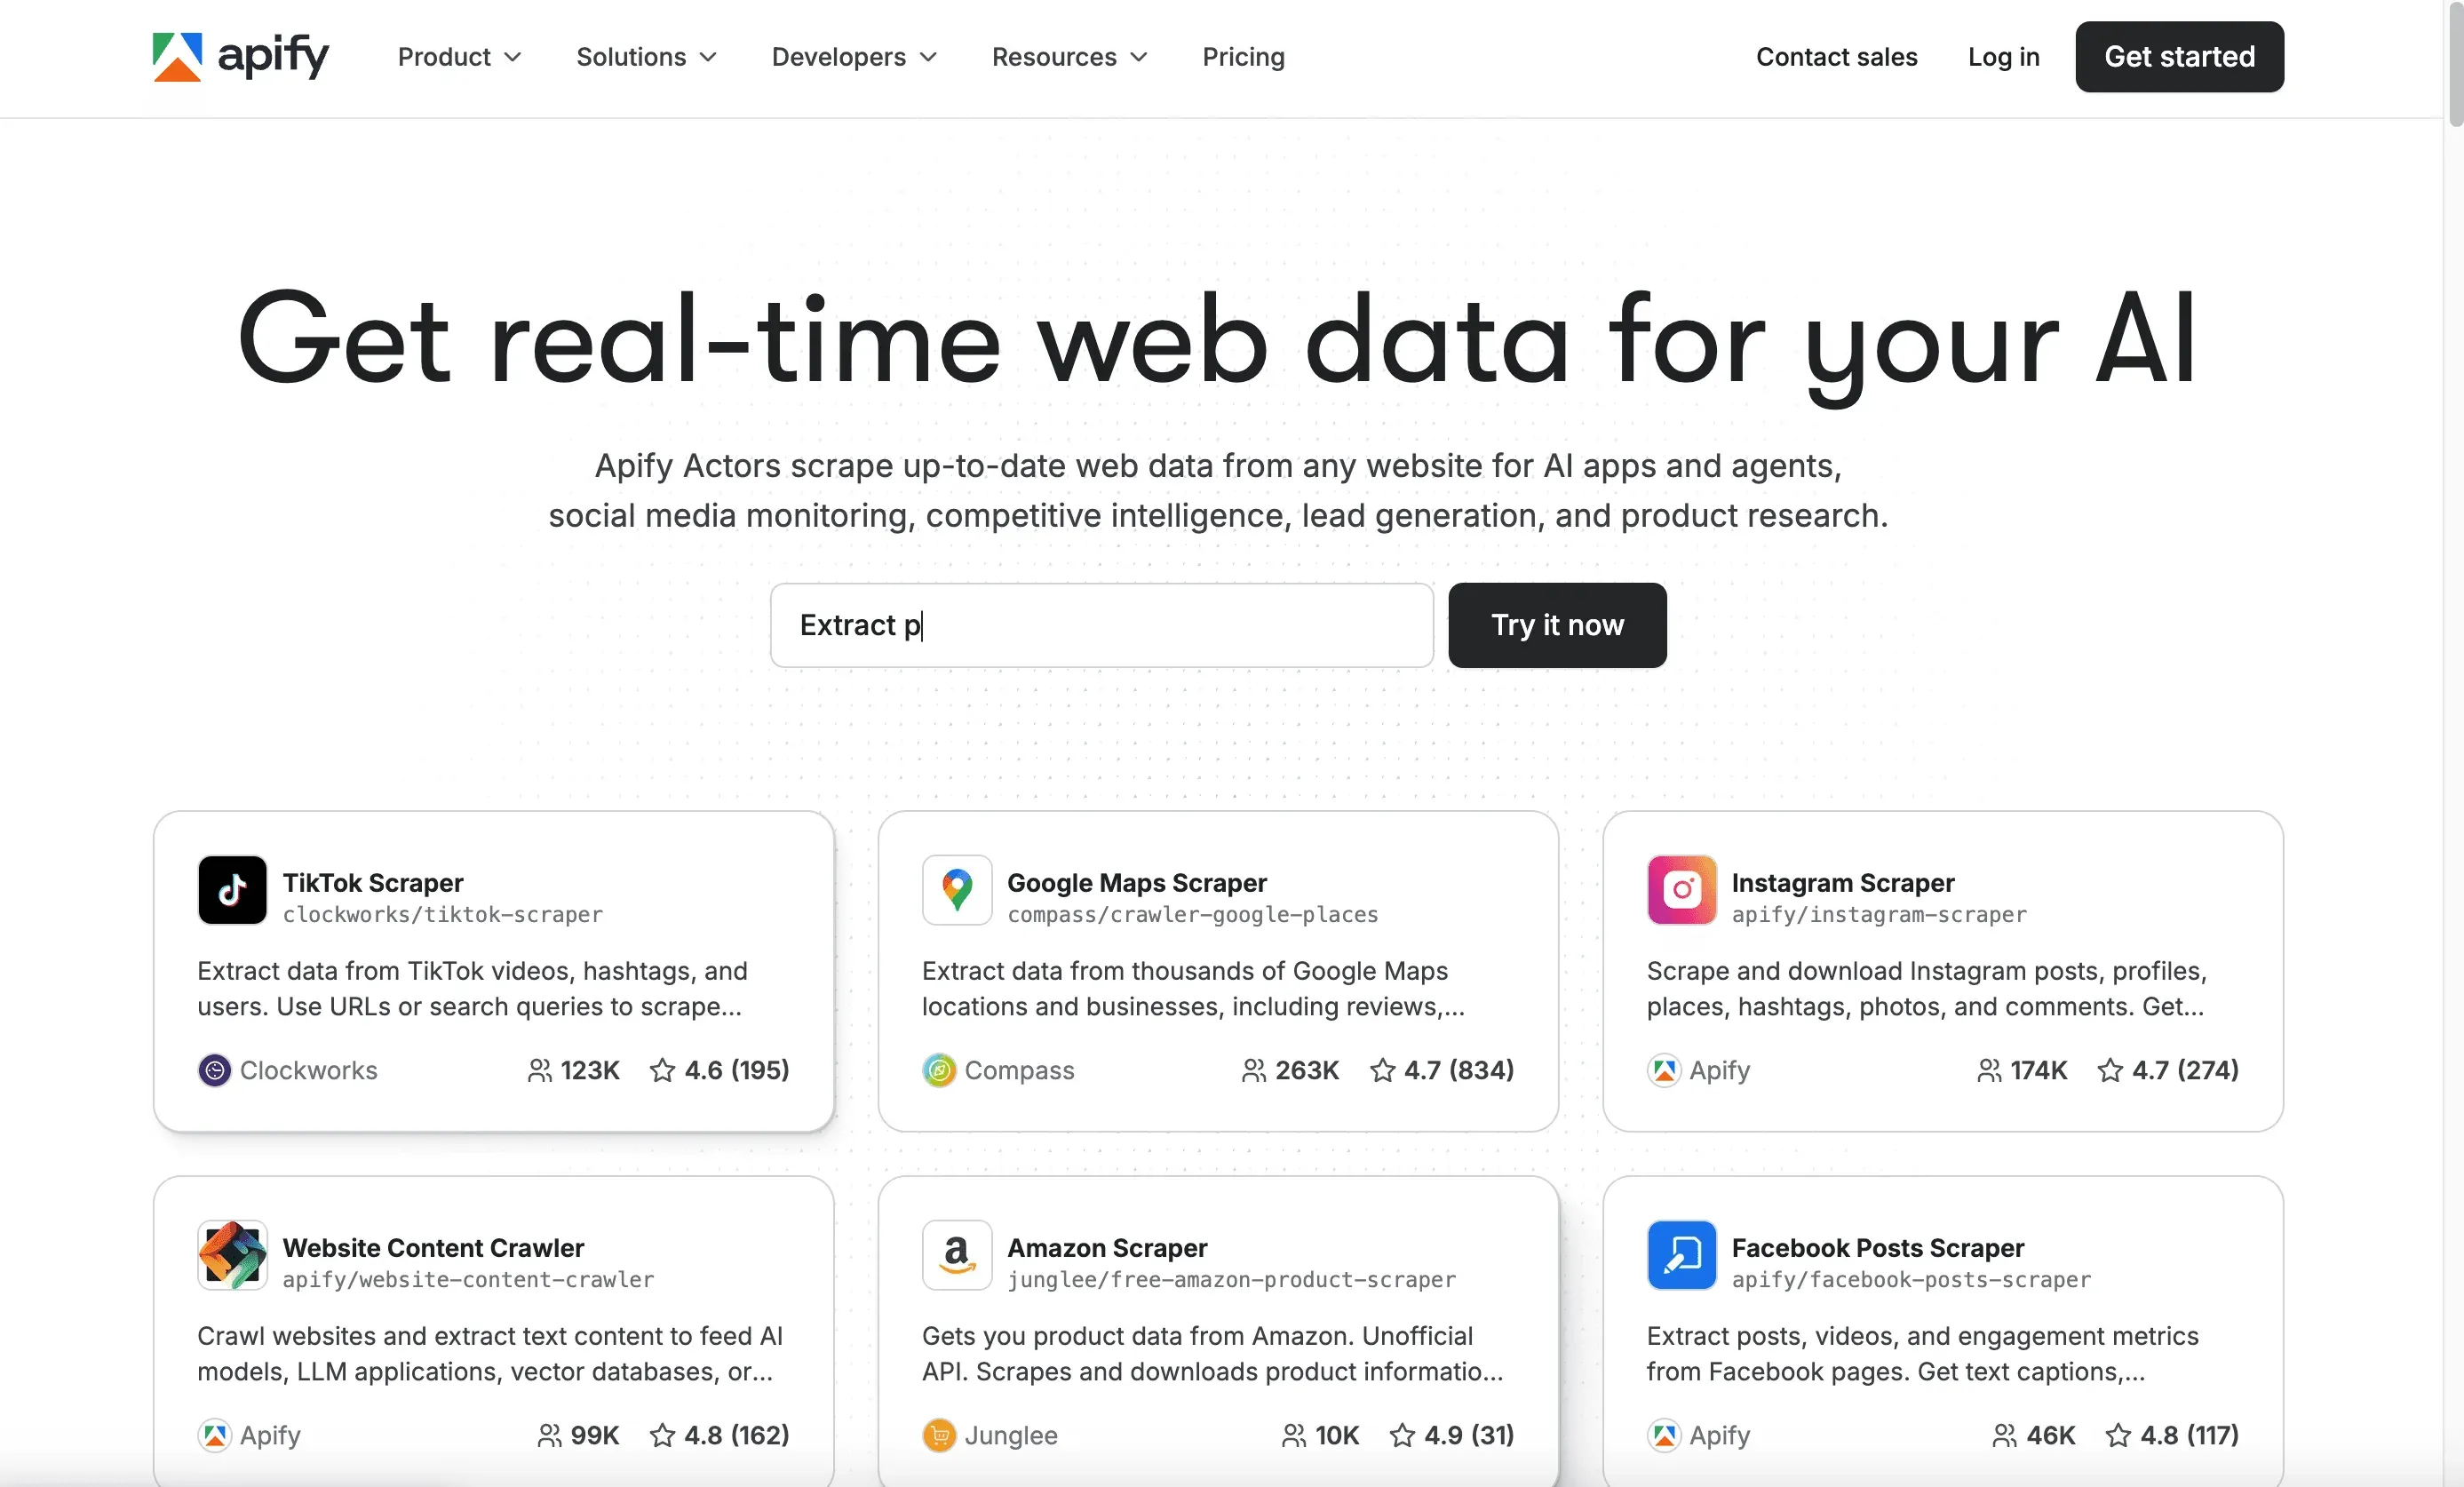 Apify là nền tảng tự động hóa trên cloud và marketplace cho các “actor” web scraping (bot). Bạn có thể dùng actor dựng sẵn cho các website phổ biến hoặc tự xây bằng JavaScript hay Python.
- Marketplace: Hàng trăm scraper sẵn dùng cho LinkedIn, Amazon và nhiều trang khác.
- Scheduling & API: Chạy, lên lịch và tích hợp actor qua API.
- Giá: Có gói miễn phí; sử dụng trả phí từ $49/tháng.
Lý tưởng cho developer và team am hiểu công nghệ muốn automation, linh hoạt và giải pháp do cộng đồng đóng góp.
9. Dexi.io
 Dexi.io là nền tảng cloud cho các dự án dữ liệu web theo nhóm. Công cụ này cung cấp tự động hóa workflow, lên lịch và tính năng quản lý team.
- Tự động hóa workflow: Xây và chia sẻ pipeline dữ liệu giữa các team.
- API & xuất dữ liệu: Tích hợp với database, lưu trữ cloud hoặc công cụ BI.
- Giá: Tùy chỉnh; hướng tới team và doanh nghiệp lớn.
Rất phù hợp cho tổ chức đang vận hành các dự án dữ liệu cộng tác, liên tục.
10. Helium Scraper
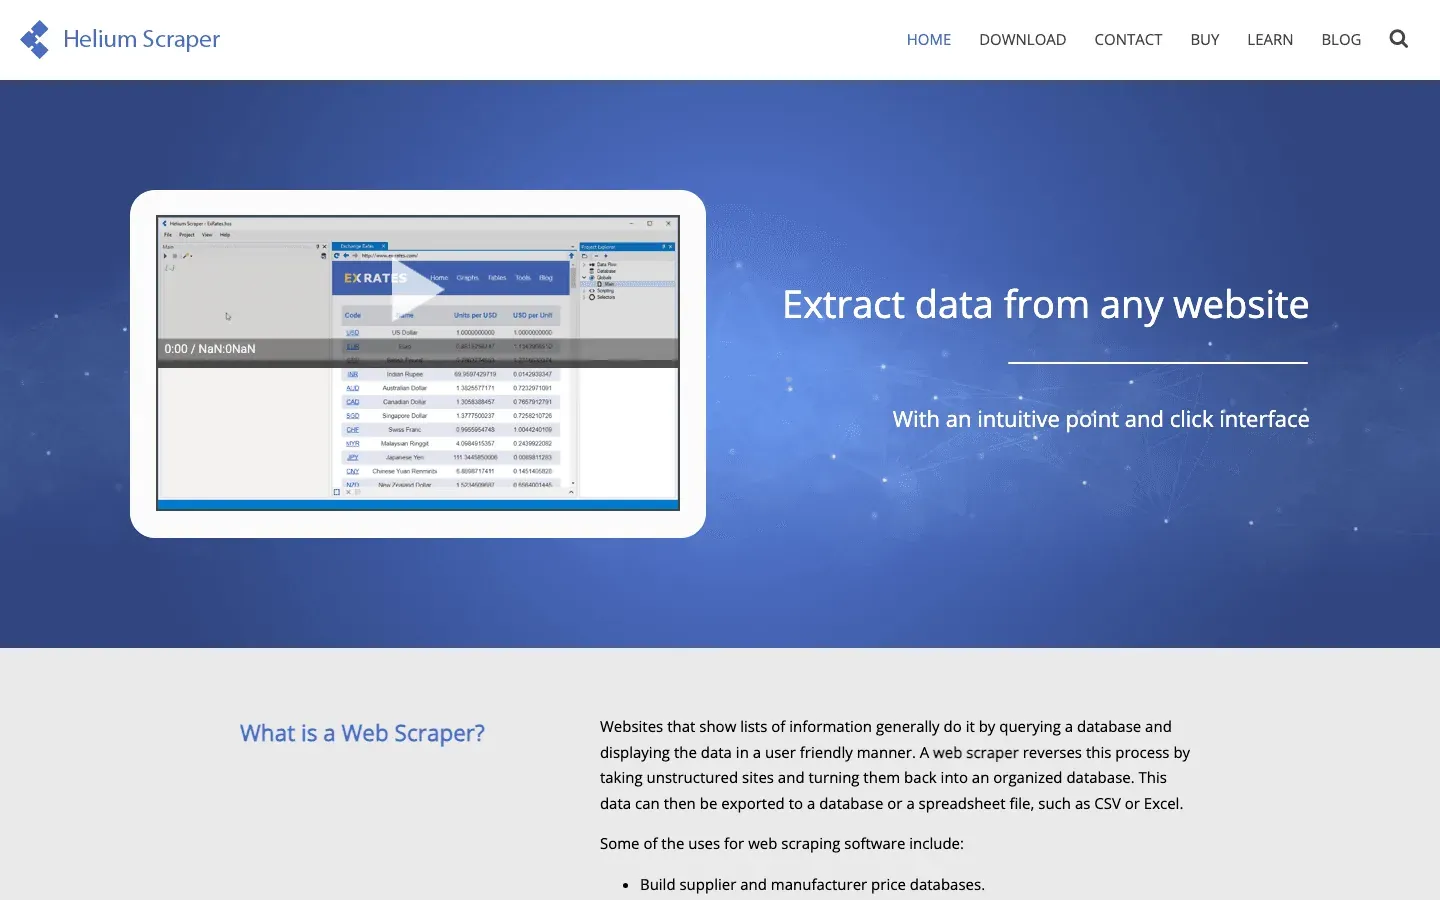 Helium Scraper là công cụ desktop kết hợp giữa trích xuất trực quan và khả năng scripting linh hoạt. Bạn có thể dùng click để làm hầu hết tác vụ, hoặc chuyển sang JavaScript tùy chỉnh cho logic nâng cao.
- Xử lý nội dung động: Scrape các website nhiều AJAX.
- Làm sạch & chuyển đổi dữ liệu: Có scripting tích hợp cho workflow tùy chỉnh.
- Giấy phép một lần: Khoảng $99.
Hoàn hảo cho power user muốn linh hoạt mà không phải trả phí thuê bao.
11. Web Scraper
 Web Scraper là extension Chrome miễn phí, thường là công cụ đầu tiên nhiều người biết đến khi bước vào web scraping. Bạn chỉ cần định nghĩa sitemap, click chọn phần tử và xuất sang CSV hoặc JSON.
- Crawling nhiều cấp: Theo link, xử lý phân trang và scrape dữ liệu lồng nhau.
- Miễn phí khi dùng cục bộ: Có bản cloud trả phí cho việc lên lịch và mở rộng quy mô.
Phù hợp cho người mới, sinh viên hoặc bất kỳ ai cần giải pháp nhanh, miễn phí cho tác vụ nhỏ.
12. Mozenda
 Mozenda là nền tảng cloud cấp doanh nghiệp, tập trung vào tuân thủ, khả năng mở rộng và dịch vụ quản lý. Giao diện click để chọn giúp bạn xây dựng các “agent” để trích xuất dữ liệu.
- Managed services: Đội ngũ Mozenda có thể xây và duy trì scraper cho bạn.
- Tuân thủ & hỗ trợ: Tập trung mạnh vào GDPR, CCPA và nhu cầu doanh nghiệp.
- Giá: Bắt đầu khoảng $500/tháng.
Phù hợp nhất cho tổ chức lớn muốn một giải pháp web data trọn gói, có thể mở rộng và được hỗ trợ mạnh.
13. SimpleIndex
 SimpleIndex là công cụ tự động hóa cho cả trích xuất dữ liệu từ tài liệu lẫn web, với trọng tâm vào OCR và indexing.
- Screen scraping OCR: Trích xuất dữ liệu từ tài liệu scan, PDF hoặc thậm chí form web hiển thị trên màn hình.
- Tích hợp: Xuất ra cơ sở dữ liệu và hệ thống quản lý tài liệu.
- Giấy phép một lần: Vài trăm USD cho mỗi workstation.
Rất phù hợp cho tổ chức kết hợp workflow dữ liệu từ tài liệu và web.
14. Datastreamer (trước đây là Spinn3r)
 Datastreamer (trước đây là Spinn3r) là nền tảng crawling nội dung thời gian thực cho blog, tin tức và mạng xã hội. Firehose API của nó cung cấp luồng nội dung mới liên tục từ hàng triệu nguồn.
- Lọc spam & xử lý ngôn ngữ: Dòng dữ liệu sạch và có cấu trúc.
- Truy cập API: Tích hợp trực tiếp vào hệ thống của bạn.
- Giá thuê bao: Tính theo mức sử dụng.
Phù hợp nhất cho media monitoring, tổng hợp tin tức hoặc team nghiên cứu cần luồng nội dung thời gian thực.
15. FMiner
 FMiner là công cụ dựng workflow trực quan cho các tác vụ web crawl phức tạp. Giao diện kéo-thả cho phép bạn thiết kế các routine scraping nhiều cấp và có điều kiện.
- Python scripting: Chèn code tùy chỉnh cho logic nâng cao.
- Đa nền tảng: Có trên Windows và Mac.
- Giấy phép một lần: Bắt đầu khoảng $168.
Phù hợp cho analyst hoặc data scientist muốn phác họa workflow phức tạp một cách trực quan.
16. G2 Webscraper
 G2 Webscraper (chỉ các công cụ được đánh giá cao trên G2) thường được khen vì sự đơn giản và hiệu quả. Người dùng rất thích những công cụ miễn phí, dễ dùng và tiết kiệm rất nhiều thời gian — như Web Scraper Chrome extension hoặc Data Miner.
- Đánh giá người dùng mạnh: Điểm số cao về độ dễ dùng và độ tin cậy.
- Thiết lập nhanh: Đường cong học tập thấp cho tác vụ cơ bản đến trung cấp.
Nếu bạn muốn một công cụ “cứ chạy là được” cho các nhu cầu scraping đơn giản, những lựa chọn được ưa chuộng trên G2 là một phương án an toàn.
Bảng so sánh: Các công cụ crawling nội dung hàng đầu trong nháy mắt
| Công cụ | Dễ sử dụng | Tự động hóa & tính năng | Định dạng xuất | Tuân thủ & quyền riêng tư | Giá | Phù hợp nhất cho |
|---|---|---|---|---|---|---|
| Thunderbit | ⭐⭐⭐⭐⭐ | AI fields, subpages, cloud | Excel, CSV, Sheets, Notion, Airtable, JSON | User-guided | Free, from $15/mo | Non-coders, sales, ops |
| Scrapy | ⭐ | Full code, async, plugins | CSV, JSON, DB | User-managed | Free, open source | Developers, big projects |
| Octoparse | ⭐⭐⭐⭐ | Visual, templates, cloud | CSV, Excel, JSON, API | User-guided | Free, from $75/mo | Analysts, e-commerce, no-coders |
| ParseHub | ⭐⭐⭐⭐ | Visual, dynamic, cloud | CSV, Excel, JSON, API | User-guided | Free, from $49/mo | Non-coders, complex sites |
| Data Miner | ⭐⭐⭐⭐⭐ | Templates, browser, Sheets | CSV, Excel, Sheets | User-guided | Free, from $19/mo | Quick browser jobs |
| WebHarvy | ⭐⭐⭐⭐⭐ | Visual, pattern detect | Excel, CSV, XML, JSON | User-guided | $199 one-time | Windows users, small biz |
| Import.io | ⭐⭐⭐⭐ | AI, cloud, monitoring | CSV, API, DB | GDPR, CCPA | Enterprise | Large orgs, compliance |
| Apify | ⭐⭐⭐ | Cloud, marketplace, API | JSON, API, Sheets | User-managed | Free, from $49/mo | Devs, automation, integrations |
| Dexi.io | ⭐⭐⭐ | Cloud, team, workflow | CSV, API, DB, Storage | User-guided | Custom | Teams, ongoing projects |
| Helium Scraper | ⭐⭐⭐ | Visual + scripting | CSV, DB | User-guided | $99 one-time | Power users, custom logic |
| Web Scraper | ⭐⭐⭐⭐⭐ | Sitemap, browser | CSV, JSON | User-guided | Free (local) | Beginners, small jobs |
| Mozenda | ⭐⭐⭐ | Cloud, managed, compliance | CSV, API, DB | GDPR, CCPA | $500+/mo | Enterprise, managed service |
| SimpleIndex | ⭐⭐⭐ | OCR, web, docs | DB, DMS | User-guided | $500 one-time | Docs + web data |
| Datastreamer | ⭐⭐ | Real-time, API | JSON, API | User-guided | Subscription | Media, news, research |
| FMiner | ⭐⭐⭐ | Visual workflow, Python | CSV, DB | User-guided | $168 one-time | Complex, visual workflows |
| G2 Webscraper | ⭐⭐⭐⭐⭐ | Simple, browser | CSV, JSON | User-guided | Free/varies | Simplicity, quick wins |
Hai công cụ từng được liệt kê ở đây hiện không còn được đưa vào danh sách nữa. Visual Web Ripper đã không được Sequentum duy trì từ năm 2018, và website của Content Grabber hiện trả về lỗi 404, trong khi dòng sản phẩm đã được thay bằng Sequentum Cloud. Hãy xác nhận tình trạng khả dụng hiện tại trước khi xây workflow xoay quanh một trong hai công cụ này.
Cách chọn đúng công cụ crawling nội dung cho doanh nghiệp của bạn
Chọn đúng công cụ là chuyện ghép nhu cầu của bạn với thế mạnh của sản phẩm. Đây là checklist nhanh của tôi:
- Xác định use case: Dùng một lần hay chạy liên tục? Quy mô nhỏ hay rất lớn? Dữ liệu công khai hay cần đăng nhập?
- Khớp với trình độ kỹ thuật: Người không biết code nên bắt đầu với Thunderbit, Octoparse, ParseHub hoặc WebHarvy. Developer có thể đi sâu vào Scrapy hoặc Apify.
- Kiểm tra nhu cầu xuất dữ liệu: Cần Excel, Sheets hay tích hợp API? Hãy đảm bảo công cụ hỗ trợ.
- Cân nhắc tuân thủ: Nếu bạn thuộc ngành có quy định chặt hoặc đang scrape dữ liệu cá nhân, hãy ưu tiên công cụ có tính năng compliance (Import.io, Mozenda).
- Bắt đầu nhỏ: Dùng gói miễn phí hoặc bản dùng thử để test trên dữ liệu thực trước khi cam kết.
- Nghĩ dài hạn: Nhu cầu của bạn có tăng lên không? Hãy chọn công cụ có thể scale cùng bạn.
Và nhớ rằng: đôi khi công cụ đơn giản nhất lại là lựa chọn phù hợp nhất. Đừng làm mọi thứ phức tạp nếu bạn chỉ cần một spreadsheet nhanh.
Quyền riêng tư dữ liệu và tuân thủ: cần lưu ý gì
Web scraping mở ra rất nhiều khả năng — nhưng cũng đi kèm trách nhiệm. Đây là cách để bạn làm đúng luật và đúng thực hành:
- Tôn trọng robots.txt và chính sách website: Luôn kiểm tra xem site có cho phép scraping không và làm theo hướng dẫn của họ.
- Tránh scrape dữ liệu cá nhân nếu không có lý do hợp pháp và sự đồng ý: GDPR và CCPA là những quy định không thể xem nhẹ.
- Đừng “đập” server quá mạnh: Hãy dùng throttling, delay và scheduling tích hợp sẵn để tránh bị chặn và cũng là người dùng internet có trách nhiệm.
- Dùng công cụ có tính năng compliance nếu bạn làm trong ngành nhạy cảm: Import.io và Mozenda được xây dựng với GDPR/CCPA trong đầu.
- Ghi lại hành động của bạn: Lưu hồ sơ về những gì bạn scrape và lý do, đặc biệt với mục đích kinh doanh hoặc các use case có quy định.
Scraping có đạo đức là scraping bền vững — và nó giúp doanh nghiệp của bạn tránh rủi ro.
Kết luận: Trao quyền cho team của bạn với công cụ crawling nội dung phù hợp
Web là cơ sở dữ liệu lớn nhất và lộn xộn nhất của doanh nghiệp bạn — và với công cụ crawling nội dung phù hợp, cuối cùng bạn có thể biến nó thành tài sản hữu ích. Dù bạn đang xây danh sách lead, theo dõi đối thủ hay nuôi dashboard thời gian thực, 18 công cụ này đều bao phủ mọi tình huống, mọi trình độ và mọi ngân sách.
Nếu bạn muốn con đường nhanh nhất để có kết quả, Thunderbit là lựa chọn số một của tôi cho người dùng doanh nghiệp: chạy bằng AI, không cần code, và có thể biến bất kỳ website nào thành bộ dữ liệu có cấu trúc chỉ trong vài phút. Nhưng dù nhu cầu của bạn là gì, hãy bắt đầu bằng bản dùng thử miễn phí, thử nghiệm và xem công cụ nào phù hợp nhất với workflow của bạn.
Tải tiện ích Thunderbit Chrome Extension Cài đặt, mở trang bạn cần, click một lần. Email Extractor, Phone Number Extractor và Image Extractor đều miễn phí trên mọi gói. Get Started Free
Sẵn sàng bỏ qua công việc copy-paste nhàm chán chưa? Hãy tải Thunderbit Chrome Extension và xem dữ liệu web có thể dễ đến mức nào. Và nếu bạn muốn đào sâu hơn vào web scraping, hãy xem Thunderbit Blog để có thêm hướng dẫn, mẹo và tutorial.
Dùng thử Thunderbit AI Web Scraper Get Started Free
Câu hỏi thường gặp
1. Công cụ crawling nội dung là gì, và khác gì so với một web scraper thông thường?
Công cụ crawling nội dung là một dạng web scraper được thiết kế để tự động trích xuất dữ liệu có cấu trúc từ website. Dù mọi web scraper đều thu thập dữ liệu, công cụ crawling nội dung thường có thêm các tính năng như lên lịch, điều hướng subpage, nhận diện trường bằng AI và tích hợp với workflow doanh nghiệp — khiến chúng mạnh hơn và thân thiện hơn với team kinh doanh.
2. Công cụ crawling nội dung nào tốt nhất cho người không rành kỹ thuật?
Thunderbit, Octoparse, ParseHub, Data Miner và WebHarvy đều rất phù hợp cho người không biết code. Thunderbit nổi bật nhờ sự đơn giản bằng AI và khả năng xuất ngay sang Excel, Sheets, Airtable hoặc Notion.
3. Làm sao để đảm bảo web scraping hợp pháp và tuân thủ?
Luôn tôn trọng điều khoản website, robots.txt và các luật về quyền riêng tư như GDPR và CCPA. Tránh scrape dữ liệu cá nhân nếu bạn không có lý do hợp pháp và sự đồng ý. Với các ngành nhạy cảm, hãy chọn công cụ có tính năng compliance tích hợp (ví dụ: Import.io, Mozenda).
4. Những công cụ này có xử lý được website động với JavaScript hoặc infinite scroll không?
Có — các công cụ như Thunderbit, Octoparse, ParseHub, Apify và FMiner có thể xử lý nội dung động, infinite scroll và điều hướng nhiều cấp. Một số trường hợp phức tạp có thể cần thêm bước cấu hình hoặc chạy trên cloud.
5. Khi chọn công cụ crawling nội dung cho doanh nghiệp, tôi nên cân nhắc gì?
Hãy xem xét kỹ năng kỹ thuật của team, quy mô dữ liệu bạn cần, yêu cầu xuất/tích hợp, các vấn đề tuân thủ và ngân sách. Bắt đầu bằng gói miễn phí hoặc bản dùng thử, rồi test trên use case thực tế trước khi quyết định.
Chúc bạn scraping vui vẻ — và mong dữ liệu của bạn luôn تازه, có cấu trúc, và sẵn sàng để hành động.
Tìm hiểu thêm




