
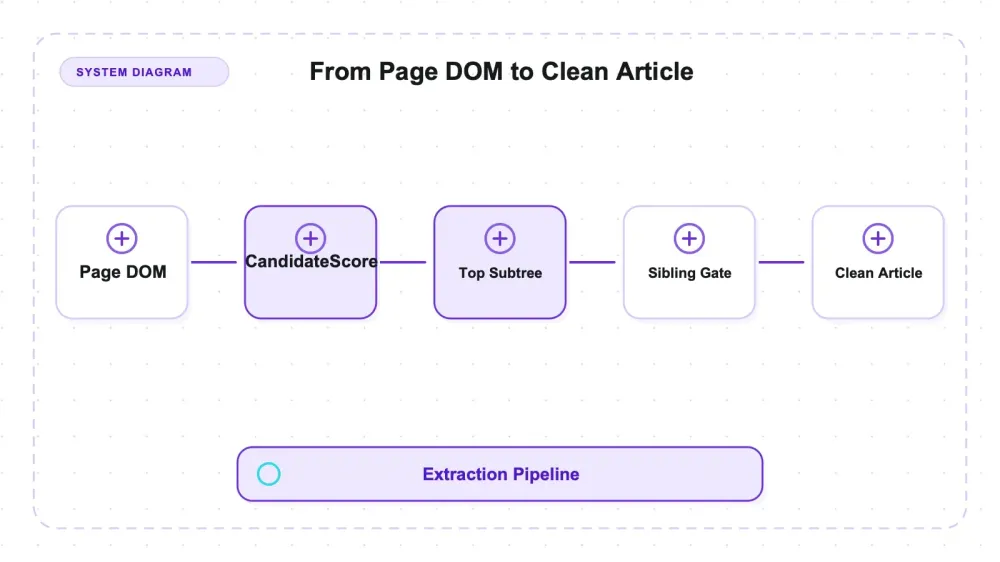
Mozilla's Readability là bản JavaScript độc lập của bộ trích xuất đứng sau Firefox's Reader View. Được phát hành dưới dạng gói Apache-2.0 @mozilla/readability, công cụ này chọn nội dung bài viết ngay từ DOM đang hiển thị. Vì vậy, khi chạy trong Node, nó cần một triển khai DOM như jsdom. Nó không tự tải trang, không chạy JavaScript của trang, và cũng không thực hiện trích xuất theo schema.
Phiên bản được kiểm thử là npm latest ở 0.6.0, phát hành ngày 3 tháng 3 năm 2025, với 11.361 sao trên repo tại thời điểm tôi kiểm tra vào ngày 27 tháng 7 năm 2026 (lần đẩy cuối là ngày 9 tháng 7 năm 2026, nên main đã đi trước gói đã phát hành khá xa). Tôi chạy nó với jsdom 29.1.1 trên Node v22.22.3, macOS arm64, đối chiếu với 22 fixture HTML được gắn nhãn sẵn cho mục đích này, và mọi số liệu trong bài đều đến từ đúng cấu hình đó. Khi tự tay dùng, đây là công cụ ít đòi hỏi nhất trong nhóm này: cài mất hai phút, không có binary, không cần browser nằm sẵn trong cache, và đầu ra giống hệt nhau ở mỗi lần chạy lại. Điều thú vị không nằm ở cách vận hành — mà ở chỗ các lỗi của nó có thể dự đoán được từ một vài hằng số trong mã nguồn, và một trong số đó quyết định nhiều hơn cả phần tài liệu mô tả.
Trên 22 fixture tổng hợp có kiểm soát, Readability khôi phục được toàn bộ 74 khối bài viết đã gắn nhãn. Kết quả có giới hạn này không có nghĩa là nó chưa bao giờ làm mất nội dung bài: benchmark công khai trên trang thật cho thấy recall là 0.982, và các kiểu lỗi đã biết không tái hiện được ở đây. Lỗi fixture dễ thấy nhất là phần nội dung anh em bị nhận nhầm, lọt qua một cổng lọc mật độ liên kết ở cấp mã nguồn là 0.25. Mức độ nghiêm trọng bề ngoài của nó thay đổi theo môi trường kiểm thử.
readability.js thực ra là gì, và ba điều nó không phải
Readability là một bước chấm điểm dựa trên luật lệ, chạy trên DOM. Nó duyệt các phần tử ứng viên, gán điểm nội dung cho từng phần tử, lan truyền điểm đó lên các phần tử tổ tiên, chọn cây con có điểm cao nhất, rồi làm sạch tiếp để loại bỏ những thứ giống như khung giao diện của trang. Toàn bộ chiến lược trích xuất bài viết chỉ có vậy — không có model, không có dữ liệu huấn luyện, không có luật riêng cho từng site. Đó là lý do nó hoạt động trên một trang mà nó chưa từng thấy — và cũng là lý do vì sao lỗi của nó có thể dự đoán từ mã nguồn, phần hay nhất của công cụ này.
Ba điều nó không phải, và cả ba thường khiến người dùng nhầm lẫn:
- Không phải bộ tải trang. Nó nhận
document, không nhận URL. Việc tải trang, thử lại, chống bot và thêm header là trách nhiệm của bạn. - Không phải bộ render. Không chạy JavaScript. DOM nào bạn đưa vào thì nó chỉ nhìn thấy đúng DOM đó.
- Không phải bộ trích xuất có cấu trúc. Bạn nhận được
title,byline,excerpt,content(HTML),textContent,length,siteName. Không có schema, không có dòng dữ liệu có kiểu, không có{name, price}.
Bốn hằng số làm phần lớn công việc
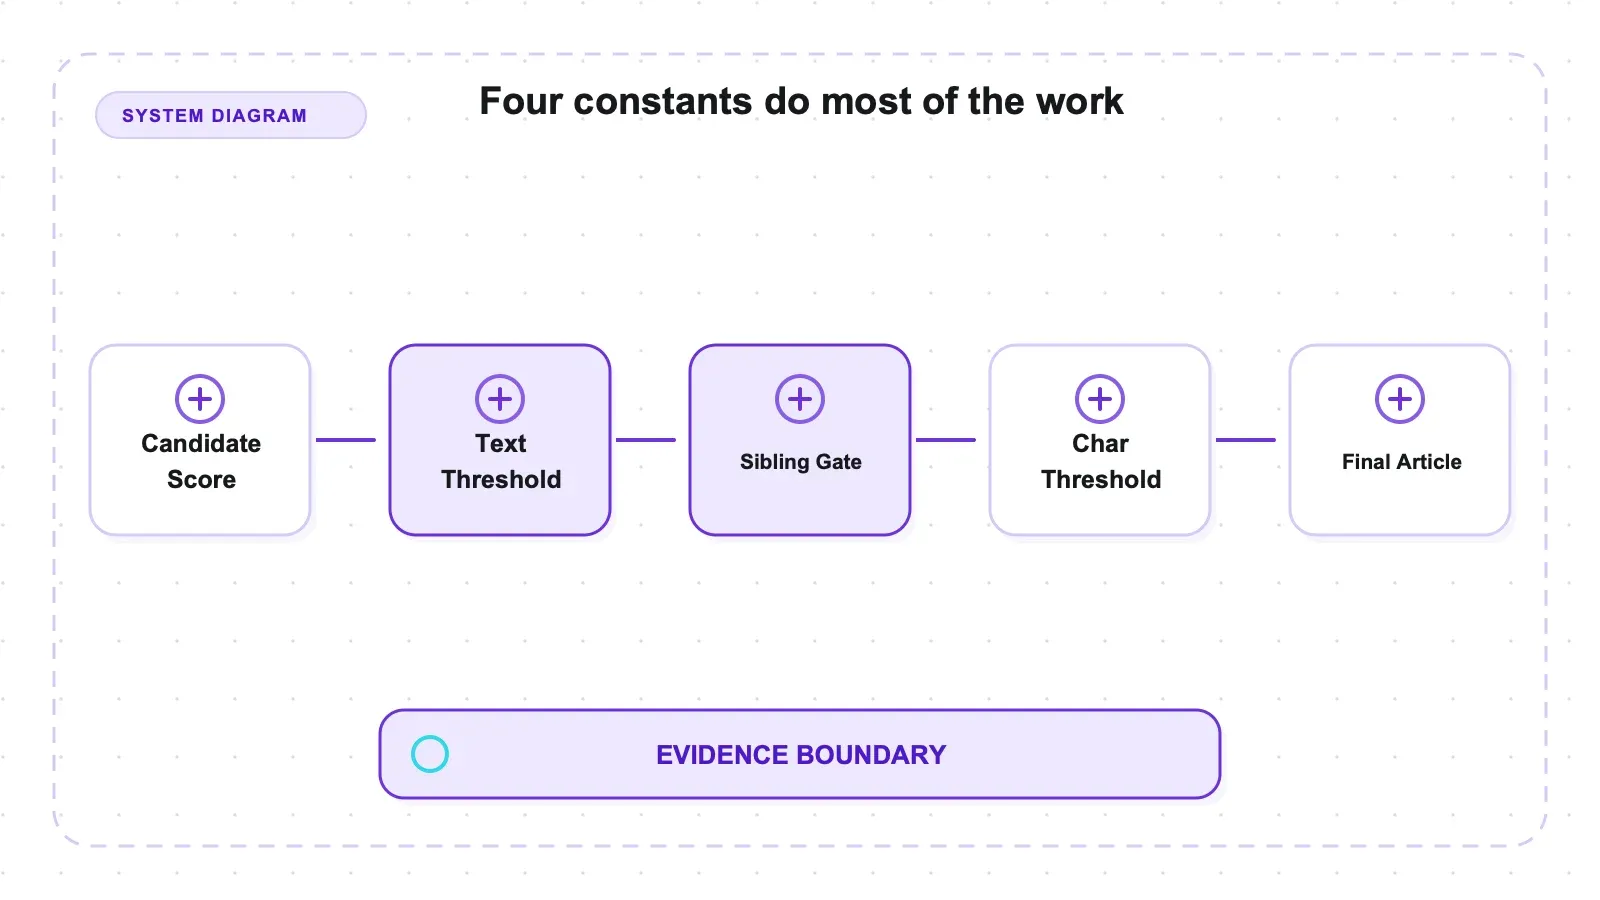
Đọc Readability.js trong node_modules cho bạn biết nhiều hơn bất kỳ trang tài liệu nào. Có bốn cơ chế quyết định phần lớn hành vi của thư viện:
- Điểm nội dung cho mỗi đoạn được chấm:
1 + (commaCount + 1) + min(floor(len / 100), 3). Các đoạn dưới 25 ký tự hoàn toàn không được tính. Điểm được đẩy lên các tổ tiên theo hệ số chia: cha nhận đủ điểm, ông nhận một nửa, còn các tổ tiên sâu hơn nhậnlevel · 3. DEFAULT_CHAR_THRESHOLD = 500— ngưỡng độ dài tối thiểu để một lần phân tích được xem là "thành công". Nếu thấp hơn, nó sẽ chạy lại với ít bước làm sạch hơn.- Biểu thức chính quy
unlikelyCandidates— khớp các chuỗi trong class và id nhưcomment,footer,menu,related,sidebar,social,sponsor. Các node khớp sẽ bị loại trước khi chấm điểm. - Cổng nối anh em trong
grabArticle— sau khi chọn được ứng viên đứng đầu, các node anh em của nó sẽ được cân nhắc thêm vào. Một node anh em sẽ được giữ nếu điểm riêng của nó vượt ngưỡng, hoặcnodeLength > 80 && linkDensity < 0.25, hoặcnodeLength < 80 && nodeLength > 0 && linkDensity === 0 && nó có dấu chấm.
Mật độ liên kết được tính bằng Σ(linkText.length · coef) / textLength, với coef = 0.3 cho các href chỉ là # và 1 trong các trường hợp còn lại. Cổng này giải thích các vụ rò rỉ từ node anh em được đo ở đây; nó không phải toàn bộ thuật toán trích xuất.
Thiết lập, và phần phụ thuộc không được nhắc trong lời giới thiệu
npm install @mozilla/readability jsdom là chạy được. Hai phút, không binary, không tải gì sau cài đặt, không browser nằm trong cache. Nếu xét riêng ở khâu cài đặt, công cụ này gần như lý tưởng.
Nhưng "không phụ thuộc" là nói về thuật toán, không phải runtime. Readability hoạt động trên một document sống, và trong Node điều đó có nghĩa là bạn phải tự cung cấp một triển khai DOM — ở đây là jsdom, phiên bản 29.1.1. jsdom không hề nhẹ, và với hầu hết pipeline, nó mới là chi phí chính trong vòng lặp chứ không phải phần trích xuất. Hãy tính trước chi phí này.
Một bẫy nữa khiến tôi phải chạy lại: Readability.parse() sẽ thay đổi DOM được đưa vào. Nếu parse cùng một jsdom document hai lần, lần thứ hai sẽ thấy một document đã bị lần đầu “xé” ra rồi. Mỗi lần parse trong bộ kiểm thử của tôi đều tạo jsdom mới. Nếu bạn đang lặp qua nhiều trang và tái dùng cùng một đối tượng document để tiết kiệm thời gian, đó chính là lỗi mà bạn sắp phải đi sửa.
Tôi đã kiểm thử như thế nào
Tôi không nhắm vào các trang tin thật ngoài đời. Trang thật cho bạn một điểm số nhưng không cho thấy vì sao — mà với heuristic, phần "vì sao" mới là giá trị cốt lõi. Thay vào đó, tôi tạo ra 22 fixture HTML chứa 91 khối được gắn nhãn (74 khối bài viết, 17 khối boilerplate), trong đó mọi từ trong một khối đều được tiền tố bằng chuỗi sentinel riêng của khối đó. Từ vựng giữa các khối là tách biệt, nên mỗi token được trích xuất sẽ ánh xạ chính xác về một khối, và các phép thử "khôi phục" hay "rò rỉ" là kiểm tra thuộc tập hợp đúng nghĩa, không phải so khớp mơ hồ.
Bước trích xuất và bước chấm điểm được tách riêng có chủ ý. Trình chạy Node chỉ xuất ra nội dung thô đã trích xuất, các giá trị boolean của isProbablyReaderable, và mật độ liên kết đã đo. Toàn bộ precision và recall được tính sau đó từ dữ liệu thô đối chiếu với nhãn, bằng một script riêng. Không có hằng số đánh giá nào được viết tay trong harness, và đó là cách duy nhất tôi tin vào con số của chính mình.
Sau đó tôi đưa chính xác cùng một bytes sang trafilatura 2.1.0 để so sánh trên cùng testbed. Mỗi fixture được phân tích ba lần; cả 22 đều cho ra text giống hệt theo từng byte ở mọi lần chạy.
Bạn có thể kiểm tra từng bước thay vì tin vào bảng tóm tắt. tests/build_fixtures.mjs tạo HTML đã chú thích và ground truth; tests/run_readability.mjs ghi lại kết quả trích xuất và đầu ra của predictor; còn tests/metrics.py chấm điểm các bản ghi đó sau cùng. Kết quả thô của Readability, các chỉ số đã tính, và so sánh cùng đầu vào được giữ trong artifacts/raw/. Việc tách này rất quan trọng khi kết quả trông đáng ngờ: bạn có thể biết parser trả text lạ, bộ nhãn sai, hay mã chấm điểm phân loại nhầm. Chạy lại trên bộ này giúp xác minh các khẳng định ở đây, nhưng đó vẫn chỉ là kiểm tra harness — không phải bằng chứng rằng mix trang thật của một môi trường triển khai sẽ có cùng phân bố lỗi.
Giới hạn phạm vi là có thật và rất quan trọng: đây là các trang tổng hợp có kiểm soát, không phải một corpus ngoài đời. Số liệu chuẩn cho trang thật đến từ benchmark công khai article-extraction-benchmark, nơi readability_js 0.6.0 — đúng phiên bản tôi kiểm thử — đạt word-F1 0.947 ± 0.005 (precision 0.914 ± 0.008, recall 0.982 ± 0.003) trên khoảng 181 trang thật. Tôi trích dẫn số này; tôi không tự tái hiện nó.
Các hàng benchmark của bản phát hành hiện tại được dùng ở đây; các hàng lịch sử đã lỗi thời bị loại bỏ. Bộ fixture có kiểm soát bổ sung phần phân rã theo từng khối, cho thấy dạng nội dung nào kích hoạt quy tắc nào, chứ không thay thế corpus trang thật công khai.
Recall hoàn hảo trong bộ fixture tổng hợp
74/74. Trên toàn bộ 22 fixture, Readability không bỏ sót một khối bài viết nào đã gắn nhãn — và trên mười một fixture tổng hợp sạch, có pha trộn giữa bài viết và boilerplate, micro-averaged token recall đạt 1.000. Không một câu bài viết nào bị mất.
Tuy nhiên cần kèm theo hai lưu ý:
Đây là các trang tổng hợp sạch, một cột, đơn giản. Bài viết thật thường lồng sâu hơn, chen quảng cáo giữa thân bài, và đôi khi mất luôn đoạn mở đầu vì một sai lệch trong chấm điểm — nhóm lỗi này đã được báo trong tracker (#437, #901, và lỗi mất nội dung trước bảng trong #922). Bộ fixture của tôi không kích hoạt bất kỳ lỗi nào trong số đó, nên tôi không khẳng định chúng đã được sửa — tôi chỉ nói rằng bài kiểm thử của tôi chưa chạm tới chúng. Trên trang thật, benchmark của phiên bản này là 0.982 recall, chứ không phải 1.000.
Dù vậy, hướng đi của kết quả mới là phần hữu ích. Vấn đề của Readability không phải là nó vứt bài viết của bạn đi. Vấn đề là nó còn mang theo thứ khác cùng lúc.
Con số precision, và vì sao nó cần ba nhãn
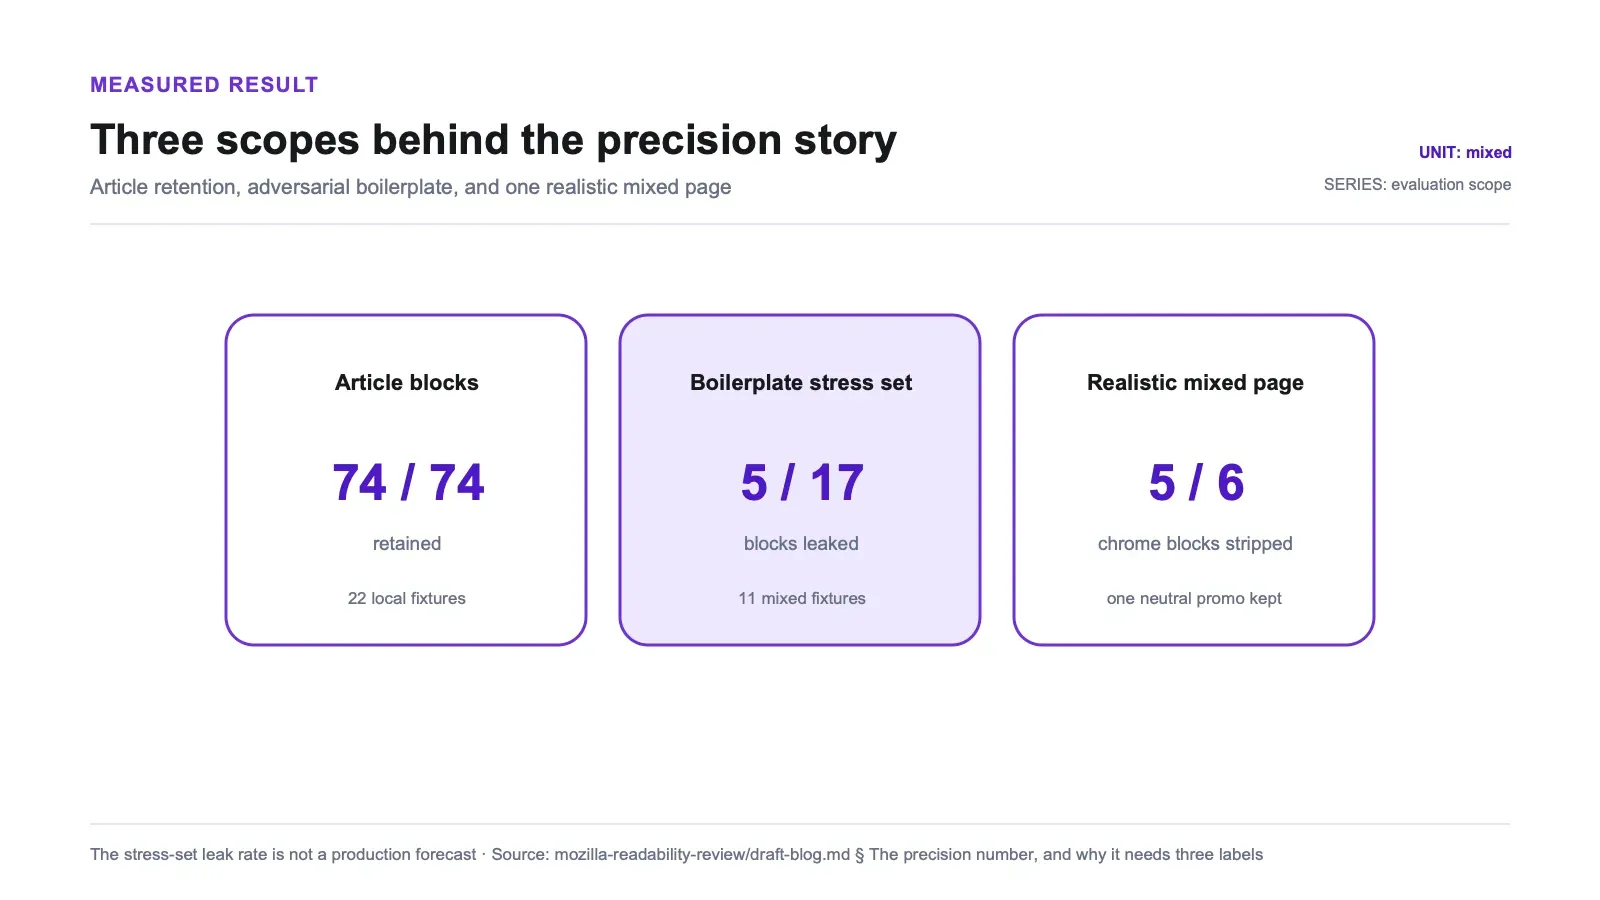
Một con số thì dễ trích dẫn nhưng khó bảo vệ. Trên mười một fixture pha trộn, Readability giữ lại 5 trên 17 khối boilerplate — tỷ lệ rò rỉ 0.294.
Đó không phải là tỷ lệ rò rỉ trong thực tế. Ba cấu hình khác nhau đo ba thứ khác nhau, và chỉ một cấu hình mô tả các trang thông thường:
| Con số này đang đo cái gì | Kết quả |
|---|---|
| Bộ fixture được gán trọng số theo hướng đối kháng — 6 trong 11 trang pha trộn được thiết kế để đánh bại cổng sibling | Giữ 5/17 khối boilerplate (0.294) |
Trang thực tế duy nhất — thân <article> được bao quanh bởi nav, banner quảng cáo, sidebar, comments, footer, cộng thêm một khối promo có class trung tính | Loại 5/6 khối chrome; giữ 1 |
| ~181 trang thật, benchmark công khai (không phải lần chạy của tôi) | precision 0.914, recall 0.982, word-F1 0.947 — readability_js 0.6.0 |
Hãy đọc hàng đầu tiên như một bài test chịu tải, không phải dự báo. Readability không rò rỉ 29% boilerplate ngoài đời thực. Trên trang thực tế mô phỏng, mọi thứ mang class mà regex unlikelyCandidates khớp — nav-menu, ad-banner, sidebar, comments, site-footer — đều bị loại sạch, cả năm khối. Khối duy nhất còn lại là khối tôi cố tình thiết kế để né regex đó.
Ngưỡng 0.25: nơi việc loại boilerplate dừng lại
Quy tắc nối anh em đã được mô tả trong mã nguồn. Nhưng theo tôi tìm được, chưa ai đo chính xác nó lật ở đâu. Vì vậy tôi dựng một dải đo: một <p class="teaser-block"> có class trung tính nằm ngoài <article>, một bài viết bốn đoạn đủ rõ ràng để chắc chắn thắng làm ứng viên đứng đầu, và chỉ thay đổi độ dài cùng mật độ liên kết của khối promo. Mật độ được tính bằng công thức riêng của Readability, đo tại thời gian chạy chứ không giả định trước:
| Khối promo | Độ dài text | Trên 80 ký tự | Mật độ liên kết đo được | Kết quả |
|---|---|---|---|---|
| Không có link | 126 | có | 0.000 | giữ lại |
| Một link ngắn | 126 | có | 0.143 | giữ lại |
| Một link dài hơn | 126 | có | 0.278 | bị loại |
| Một nửa text là link | 126 | có | 0.476 | bị loại |
| Một câu duy nhất, kết thúc bằng dấu chấm | 60 | không | 0.000 | giữ lại |
| Cùng text đó, không có dấu chấm | 59 | không | 0.000 | bị loại |
Điều kiện trong mã nguồn dùng ngưỡng 0.25; các mẫu đo được đã kẹp đúng hai phía của nó, với 0.143 được giữ và 0.278 bị loại. Một nhánh riêng giữ lại câu dài 60 ký tự kết thúc bằng dấu chấm và loại bỏ phiên bản 59 ký tự không có dấu chấm. Recall của bài viết vẫn là 4/4 ở mỗi nhánh, nên các mẫu này chỉ ra riêng hiệu ứng precision.
Ngoài môi trường kiểm thử, cổng này về cơ bản nói rằng: văn xuôi trung tính, dài, ít link đứng cạnh bài viết thì được xem là bài viết. Điều đó mô tả rất nhiều thứ không phải bài viết — một đoạn “Bài đọc liên quan” được viết như văn xuôi, lời mời đăng ký newsletter, ghi chú của biên tập viên, hoặc một teaser tài trợ mà đội marketing viết bằng câu hoàn chỉnh rồi gỡ link ra vì lý do tracking.
Trong một chỉ mục RAG, một đoạn promo ít link có thể trở thành một đoạn được trích xuất và tạo ra rủi ro khiến retrieval hoặc generation xem nó như nội dung bài viết. Quy tắc trong mã nguồn khiến kiểu lỗi này hoàn toàn có thể xảy ra; bài đánh giá này không chạy thử đánh giá retrieval hay quotation của mô hình từ đầu đến cuối.
Nếu cần lọc cứng theo từng site, hãy tiền lọc các container DOM đã biết từ nguồn, giữ lại quan hệ tổ tiên của node nguồn để so sánh trước khi serialize, hoặc áp dụng lọc theo mẫu text đã được kiểm chứng cẩn thận ở bước sau. Chỉ riêng HTML trả về có thể không còn cho biết một node ban đầu nằm ngoài container chính hay không. Cổng sibling này không thể điều chỉnh qua các tuỳ chọn công khai.
Ba giả định mà bộ fixture đã bác bỏ
Bộ fixture đã bác bỏ ba giả định: rằng charThreshold loại các bài viết ngắn, rằng cần thẻ semantic, và rằng nội dung ngắn không phải văn xuôi sẽ bị loại bỏ. Bằng chứng dưới đây là phần đáng chú ý; không cần bất kỳ tuyên bố preregistration nào.
charThreshold = 500 không phải là một vách đá
Cách hiểu phổ biến là bài viết dưới 500 ký tự sẽ trả về null. Thực tế không phải vậy. Tôi quét độ dài thân bài từ 120 đến 1500 ký tự với các giá trị charThreshold là 200, 500, và 1000:
| Độ dài thân bài | Parse thành công ở mọi ngưỡng | Độ dài nội dung trích xuất |
|---|---|---|
| 120 | có | 161 |
| 300 | có | 342 |
| 460 | có | 509 |
| 520 | có | 569 |
| 800 | có | 841 |
| 1500 | có | 1555 |
Phẳng lì. Độ dài trích xuất giống hệt nhau ở cả ba thiết lập ngưỡng, tại mọi kích thước thân bài. Ngưỡng này không quyết định việc có trả về hay không — nó quyết định có chạy lại bước lấy nội dung với các cờ làm sạch bị gỡ bỏ hay không, và trên một trang sạch thì không có gì để gỡ cả, nên sieve vẫn trả cùng nội dung. Ranh giới null thực sự là "không có chút text nào có thể trích xuất".
Và chính điều đó tạo ra lỗi thật ở đây, và nó còn khó chịu hơn việc trả null sai. Tôi đưa vào một trang gần như trống — chỉ có một thanh điều hướng và một đoạn giới thiệu bốn từ. Nó vẫn trả về thành công, và “bài viết” nó trả về bao gồm cả nav. Khi không có bài thật, Readability sẽ coi boilerplate là bài viết. Nếu bạn đang crawl ở quy mô lớn và xem kết quả không-null là "trang này có nội dung", thì giả định đó là sai.
Thẻ semantic không phải thứ đang làm việc chính
Tôi tưởng recall sẽ giảm khi bỏ đi phần khung semantic. Cùng một nội dung bài viết, hai lớp giao diện: một bên dùng <main><article><h1> và các class mô tả rõ ràng, bên kia dùng <div class="x1"> và các đoạn chỉ là <div> trần. Kết quả: khôi phục được 4/4 khối bài viết ở cả hai, và không rò rỉ boilerplate nào ở cả hai. Khi bài viết rõ ràng là khối text đậm nhất trên trang, cách chấm điểm theo độ dài và dấu phẩy vẫn tìm ra nó mà không cần trợ giúp semantic. Nói rằng “Readability cần thẻ <article>” chỉ là truyền miệng.
Giới hạn thật sự của nhận định này: trang của tôi chỉ có một khối nội dung quá rõ ràng. Nơi semantic có thể phát huy là một trang có hai cây con đậm nội dung đang cạnh tranh nhau, và tôi chưa test kiểu phân định đó.
Nội dung không phải văn xuôi vẫn được giữ nguyên
Quy tắc “các đoạn dưới 25 ký tự không được tính” khiến tôi nghĩ rằng bảng và chú thích sẽ bị mất. Nhưng tôi đoán sai lần nữa — quy tắc đó chỉ ảnh hưởng đến chấm điểm ứng viên, chứ không ảnh hưởng đến việc giữ lại. Khi container thắng, mọi thứ bên trong nó đi theo luôn:
| Loại nội dung bên trong bài viết | Readability | trafilatura |
|---|---|---|
| Các đoạn văn xuôi (×2) | giữ | giữ |
| Ô trong bảng dữ liệu (×2) | giữ | giữ |
Khối mã <pre> | giữ | giữ |
Đoạn <p> một dòng dưới 25 ký tự (×2) | giữ | giữ |
<figcaption> | giữ | bị loại |
| Tổng | 8/8 | 7/8 |
Đây là một trục mà bộ làm sạch mạnh tay hơn lại thua. Nếu trang của bạn là tài liệu hướng dẫn, tutorial, hoặc bất cứ thứ gì có code block và hình có chú thích, cách Readability giữ nguyên toàn bộ cây con chiến thắng là một điểm cộng.
isProbablyReaderable nói không trong khi parse() lại nói có
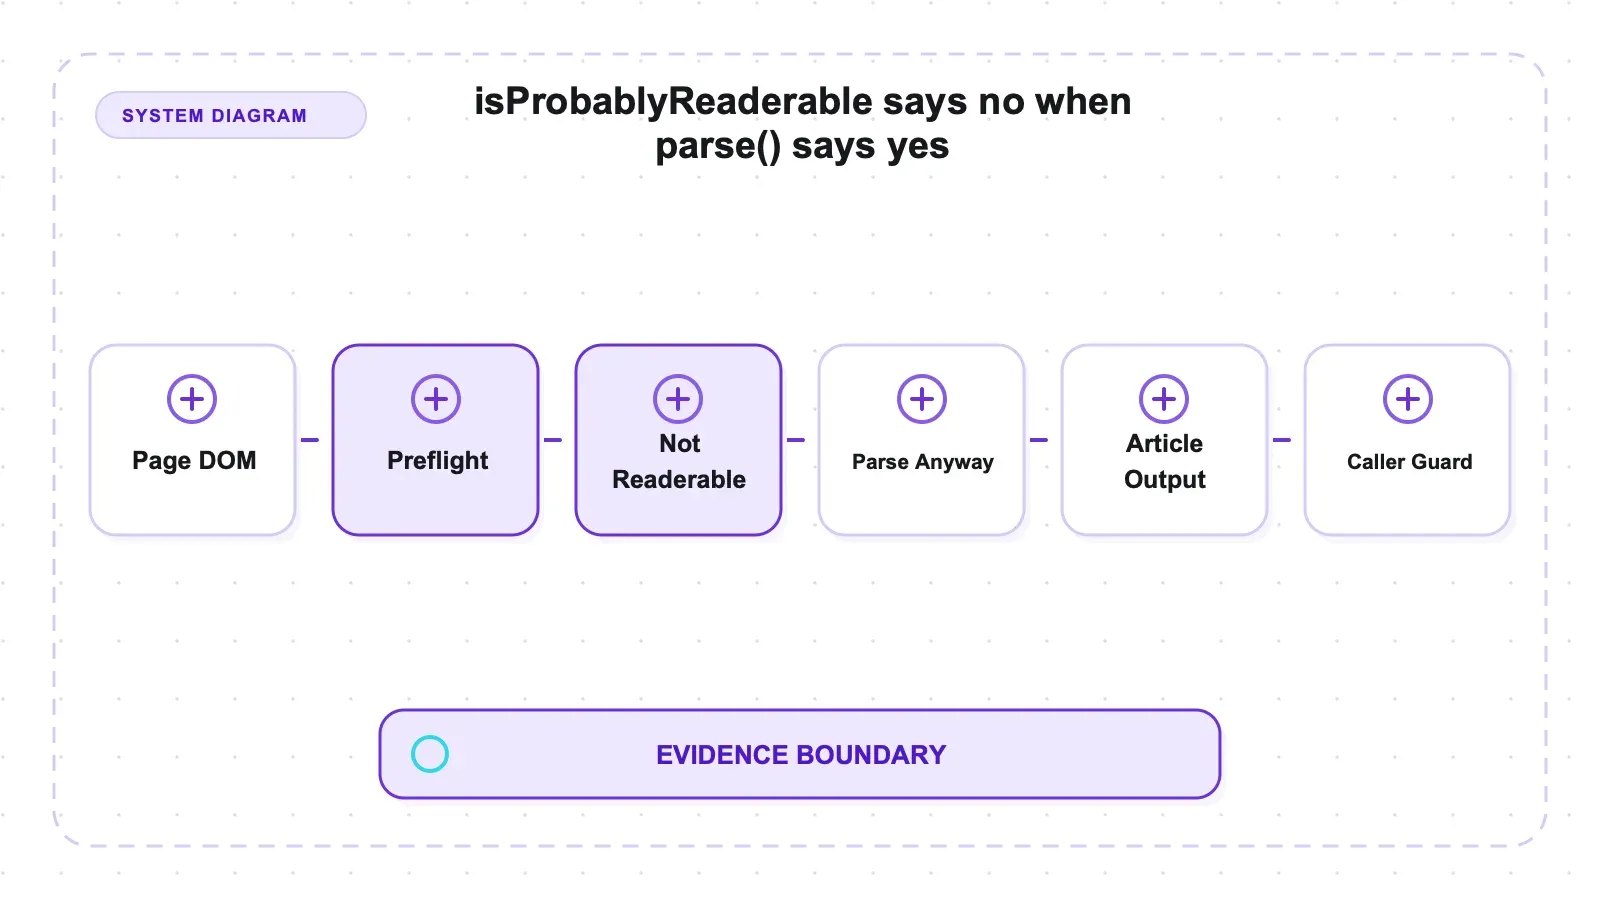
README gợi ý gọi isProbablyReaderable(doc) như một bước kiểm tra nhanh trước khi chạy parse đầy đủ. Trong thử nghiệm của tôi, cổng này từ chối ba kiểu trang khác nhau mà parse() vẫn xử lý tốt:
| Kiểu trang | Dự đoán của predictor | parse() | Thay đổi nào có tác dụng |
|---|---|---|---|
Nội dung chỉ nằm trong các phần tử <li> | false | thành công | không có — false ở mọi minScore 1–80 và mọi minContentLength 40–200 |
| Mười đoạn, mỗi đoạn dưới 140 ký tự | false | thành công | minContentLength ≤ 100 (minScore không có tác dụng) |
| Một đoạn dài 408 ký tự | false | thành công | minScore ≤ 10 (điểm ≈16.4) |
| Bài viết bình thường (đối chứng) | true | thành công | — |
Ba lỗi này có ba nguyên nhân khác nhau, và chỉ hai trong số đó có thể chỉnh. Trường hợp <li> là do cấu trúc: predictor chỉ chấm các node p, pre, và article (cộng thêm cha của div > br), nên một trang mà nội dung nằm trong list item sẽ không khớp gì cả, điểm bằng 0, và không có cách chỉnh ngưỡng nào cứu được — kiểu này đã được báo trong issue #662. Trường hợp nhiều đoạn ngắn là do cổng minContentLength bỏ qua từng đoạn trước khi chấm điểm, nên mười đoạn đủ ý vẫn cộng lại thành 0; hạ giá trị đó sẽ sửa được, còn chỉnh minScore thì không. Trường hợp một đoạn dài là do phép tính: điểm là sqrt(408 − 140) ≈ 16.4, thấp hơn minScore mặc định là 20 — một đoạn đơn lẻ cần 140 + 20² = 540 ký tự để tự vượt qua ngưỡng.
README có cảnh báo predictor có thể tạo âm tính giả. Điều tôi muốn bổ sung là quy tắc thực tế: đừng dùng nó làm cổng duy nhất. Nếu một trang quan trọng, hãy parse nó và kiểm tra độ dài kết quả. Chi phí parse không quá lớn so với chi phí dựng jsdom mà bạn đã trả rồi.
Cùng bytes, hai bộ trích xuất
Chạy trafilatura 2.1.0 trên cùng bộ fixture cho một cái nhìn sạch hơn so với việc đặt cạnh hai con số đo trên hai testbed khác nhau, vì đầu vào là giống hệt nhau từng byte:
| Chỉ số (11 fixture pha trộn) | @mozilla/readability | trafilatura |
|---|---|---|
| Recall khối bài viết | 1.000 | 1.000 |
| Số khối boilerplate được giữ | 5/17 (0.294) | 1/17 (0.059) |
| Token F1 (micro) | 0.948 | 0.969 |
| Recall nội dung không phải văn xuôi | 8/8 | 7/8 |
| Bài viết rất ngắn (120 ký tự), token F1 | 0.800 | 0.571 |
Không công cụ nào áp đảo trên bộ fixture này. Trafilatura giữ lại ít khối anh em hơn, trong khi Readability giữ được nhiều nội dung ngắn và không phải văn xuôi hơn. Precision token tuyệt đối của cả hai đều bị kéo xuống bởi tiêu đề không được gắn nhãn, nên số khối bị rò rỉ là tín hiệu trực tiếp sạch hơn. Benchmark trang thật công khai tình cờ sắp thứ tự word-F1 của chúng khá giống nhau, nhưng corpus và metric khác nhau nên đây không phải là xác thực chéo giữa các testbed.
Về độ bền, nói ngắn gọn: tôi đã chạy một bản twin cố tình làm lỗi của trang chuẩn (thẻ <p> không đóng, <b>/<i> lồng sai, một </div> thừa) và recall vẫn là 3/3, không rò rỉ gì, giống hệt bản chuẩn. Công ở đây thuộc về jsdom, nhờ bộ dựng cây HTML5 sửa lỗi trước khi Readability kịp nhìn thấy. Không fixture nào làm parser sập.
Ưu và nhược điểm
Ưu điểm
- Recall bài viết rất mạnh: khôi phục 74/74 khối đã gắn nhãn trên 22 fixture tổng hợp, token recall 1.000 trên bộ pha trộn.
- Lọc khung trang theo regex hoạt động ổn định — nav, banner quảng cáo, sidebar, comments và footer đều bị loại trên trang thực tế mô phỏng (5/6).
- Nội dung không phải văn xuôi được giữ nguyên hoàn toàn: bảng, code trong
<pre>, chú thích hình, và các dòng dưới 25 ký tự đều sống sót (8/8), trong khi trafilatura bỏ một chú thích. - Không phụ thuộc vào markup semantic — một bài viết dùng
<div>trung tính cho kết quả giống hệt phiên bản dùng<article>/<main>. - Bài viết ngắn không bị loại nhầm: nội dung sạch vẫn được lấy ra ở mức 120 ký tự, và kết quả giống nhau với
charThreshold200/500/1000. - Hoàn toàn xác định: cả 22 fixture đều trả về text giống hệt nhau qua ba lần chạy.
- Cài đặt trong hai phút, giấy phép Apache-2.0, và phiên bản trên npm đúng là phiên bản tôi đã kiểm thử (0.6.0), nên không có gì ở đây là lỗi thời.
Nhược điểm
- Cổng nối anh em có thể bị lợi dụng: văn xuôi promo dài, ít link, class trung tính gần như không thể phân biệt với nội dung bài viết và sẽ được nối vào nếu
linkDensity < 0.25. - Trên trang nghèo nội dung, nó trả về boilerplate như thể đó là bài viết thay vì
null— fixture gần như trống của tôi trả về luôn thanh điều hướng làm thân bài. isProbablyReaderablecho âm tính giả ở ba kiểu trang khác nhau, trong đó có một kiểu không thể sửa bằng mọi mức chỉnh.- Cần một DOM đầy đủ ở runtime — cách mô tả "không phụ thuộc" che mất chi phí jsdom, vốn là phần tốn kém chính trong vòng lặp.
parse()sửa đổi document đầu vào, nên bạn phải dựng lại DOM cho mỗi trang.- Không tải trang, không render JavaScript, không đầu ra có cấu trúc. Nó chỉ là một bước trong pipeline, không phải toàn bộ pipeline.
- Các miss trên trang thật được báo trong tracker (mất đoạn mở đầu và mất nội dung trước bảng) không tái hiện trên fixture của tôi, nên tôi không thể nói đó là lỗi hiếm hay đơn giản là trang của tôi chưa bao giờ chạm đúng kiểu đó.
Ai nên dùng, và ai nên bỏ qua
Hãy dùng Readability nếu bạn đã có sẵn HTML và muốn lấy bài viết ra bằng JavaScript thuần, trong một dịch vụ Node nơi việc thêm phụ thuộc Python sẽ bất tiện. (Tôi không thu thập timing theo đúng phân phối, nên tôi không khẳng định gì về tốc độ ngoài câu rằng "jsdom mới là phần chiếm chi phí chính trong vòng lặp, chứ không phải phần trích xuất.") Các tính năng reader-mode, lưu trữ bài viết offline, bản tin email, nút "clean view", extension trình duyệt, pipeline tài liệu có code block và chú thích hình — đó là đúng sân chơi, và các con số recall cho thấy nó làm tốt ở đó. Hành vi của nó cũng có thể đọc thẳng từ mã nguồn, điều này đáng giá hơn nghe có vẻ, nhất là khi bạn cần giải thích cho đồng nghiệp vì sao một khối cụ thể lại được giữ lại.
Hãy bỏ qua nó nếu độ chính xác trong việc loại boilerplate là chỉ số bạn bị chấm điểm, đặc biệt nếu bạn đang feed vào một LLM index mà một đoạn promo lạc chỗ có thể trở thành một chunk truy xuất được. Bỏ qua nó nếu trang của bạn render nội dung phía client, vì nó chỉ đọc DOM bạn đưa vào chứ không chạy JavaScript. Bỏ qua nó nếu thứ bạn cần là {title, price, sku} chứ không phải văn xuôi — không có cấu hình nào biến một bộ trích xuất nội dung thành một bộ trích xuất schema. Và nếu bạn đang xử lý các trang mà câu hỏi "trang này có bài viết hay không" là một câu hỏi thực sự, đừng tin giá trị không-null như câu trả lời.
Giải pháp thay thế, và Thunderbit nằm ở đâu trong bức tranh này
Đây không phải là lời chê một thư viện Apache-2.0 miễn phí do Mozilla duy trì — Readability là hạ tầng, đã chạy trong Firefox nhiều năm, và với bài toán trích xuất kiểu reader-mode thì nó là bản tham chiếu vì một lý do rõ ràng. Nếu bạn muốn nhìn rộng hơn, tôi có duy trì một bảng so sánh trong open-source scrapers roundup và một khảo sát rộng hơn trong the best web scraping tools.
Để xem cùng bộ fixture trên cả sáu bộ trích xuất, hãy xem so sánh sáu thư viện trích xuất bài viết.
Ghi chú của tác giả: Thunderbit là lựa chọn được quản lý của chúng tôi cho phần render và trích xuất từ URL đầu vào. Nó không được chạy trên bộ fixture này, nên không có ngụ ý nào về chất lượng tương đương. Ranh giới liên quan là: bạn đã có DOM và chỉ muốn trích xuất bài viết tại chỗ, hay bạn muốn tải trang/render và đầu ra có cấu trúc được vận hành như một dịch vụ. Tự host giúp tránh phí sử dụng của nhà cung cấp nhưng vẫn phải gánh chi phí hạ tầng và bảo trì.
Sự đánh đổi trung thực: Readability miễn phí, minh bạch, và bạn tự vận hành — bạn có thể đọc chính xác cổng nào đã quyết định đầu ra của mình, điều mà một API được quản lý không cho bạn thấy. Một stack được quản lý thì tốn tiền và giấu cơ chế bên trong, nhưng bù lại nó bao quát luôn các bước fetch-render-structure mà nếu không bạn phải tự ghép lại. Nếu bạn muốn phần có hỗ trợ AI trong phổ đó, tôi đã viết về scrape bất kỳ website nào bằng AI và về AI crawlers ở nơi khác. Hãy chọn theo đúng những bước bạn thật sự muốn sở hữu.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Readability là lựa chọn phù hợp khi bạn đã có DOM, chạy JavaScript/Node, và thích thỉnh thoảng giữ thêm nội dung anh em còn hơn là bỏ sót quá tay. Trong bộ fixture này, nó khôi phục toàn bộ 74 khối bài viết đã gắn nhãn và giữ lại bảng, code, cùng chú thích hình. Kết quả đó bị giới hạn bởi các trang đơn cột tổng hợp; recall trên trang thật công khai là 0.982, các trường hợp miss gần đoạn mở đầu/bên cạnh bảng không tái hiện được, và các trang nghèo nội dung có thể trả về boilerplate như bài viết.
Chỉ cần đánh giá đúng điểm yếu. Mặt dễ hỏng chính của nó trong bộ fixture này là precision, và nó nằm ngay tại một dòng mã nguồn cụ thể đã được ghi rõ: một node anh em dài hơn 80 ký tự với link density dưới 0.25 sẽ được nối vào bài viết của bạn, bất kể nó có thuộc bài hay không. Tôi đã thấy nó đổi trạng thái ở 0.143 so với 0.278 trên cùng một text. Benchmark trên trang thật báo precision 0.914 và recall 0.982. Nếu bạn đang đẩy text trích xuất vào một index để mô hình sau này trích dẫn, hãy kiểm tra cả boilerplate được giữ lại lẫn phần thân bị bỏ sót thay vì cho rằng một trong hai lỗi đó không tồn tại.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Mozilla Readability có loại bỏ toàn bộ boilerplate không?
Không, và con số còn phụ thuộc rất nhiều vào thứ bạn đang đo. Trên benchmark công khai của trang thật, readability_js 0.6.0 đạt precision 0.914 — nghĩa là khoảng 8,6% phần nó trả về không phải nội dung thân bài. Trên một trang test thực tế của tôi, nó loại được 5 trong 6 khối chrome (nav, quảng cáo, sidebar, comments, footer đều biến mất), chỉ giữ lại một đoạn promo có class trung tính. Trên bộ fixture tôi cố tình đặt trọng số với các khối được thiết kế để đánh bại heuristic, nó giữ 5/17 — con số cuối cùng đó là stress test, không phải tỷ lệ ngoài đời.
Tôi có cần jsdom để dùng readability.js trong Node không?
Có, hoặc một triển khai DOM khác. Readability là JavaScript thuần, nhưng nó hoạt động trên một đối tượng document sống, nên trong Node bạn phải tự cung cấp DOM — trong cấu hình của tôi là jsdom 29.1.1. Mô tả "không phụ thuộc" là nói về thuật toán, không phải runtime. Cũng lưu ý rằng parse() sẽ sửa đổi document nó nhận, nên hãy dựng DOM mới cho từng trang thay vì tái sử dụng một cái.
Tùy chọn charThreshold thực sự làm gì?
Không giống điều đa số người nghĩ. Nó không làm bài ngắn trả về null — tôi đã khôi phục được các bài sạch xuống tới 120 ký tự, với độ dài trích xuất giống nhau ở charThreshold 200, 500, và 1000. Ngưỡng này chỉ quyết định parser có chạy lại bước lấy nội dung với các cờ làm sạch bị gỡ bỏ hay không; trên một trang sạch thì không có gì để gỡ, nên đầu ra vẫn như nhau. Trường hợp null thật sự là một trang không có chút text nào có thể trích xuất, và ngay cả trang chỉ có nav của tôi vẫn trả về không-null, với nav được coi là bài viết.
Nên gọi isProbablyReaderable trước parse() không?
Hãy dùng nó như một gợi ý, không phải một cổng chặn. Nó trả về false trên ba kiểu trang mà parse() vẫn thành công: nội dung nằm trong các phần tử <li>, mười đoạn văn mỗi đoạn dưới 140 ký tự, và một đoạn đơn 408 ký tự. Trường hợp <li> không thể sửa bằng tinh chỉnh, vì predictor chỉ chấm các node p, pre, và article; trường hợp nhiều đoạn ngắn cần giảm minContentLength; trường hợp một đoạn dài cần giảm minScore, vì một đoạn đơn lẻ phải đạt tới 540 ký tự mới vượt ngưỡng mặc định. Nếu trang quan trọng, hãy parse nó rồi kiểm tra kết quả.
Readability hay trafilatura cho trích xuất bài viết?
Trên các byte fixture giống hệt nhau, trafilatura giữ ít boilerplate hơn (1/17 khối so với 5/17), còn Readability khôi phục được nhiều nội dung ngắn hơn và giữ lại một <figcaption> mà trafilatura bỏ mất. Hãy chọn theo mức chịu lỗi và runtime. Benchmark công khai là bối cảnh riêng, không phải sự xác thực cho kết quả fixture này.




