
Các công cụ tìm kiếm đã trở thành trang chủ của internet — và với doanh nghiệp hiện đại, chúng cũng là nguồn dữ liệu lớn nhất, lộn xộn nhất và giá trị nhất trên thế giới. Dù bạn đang theo dõi đối thủ, săn lead hay chỉ cố bắt kịp những thay đổi của thị trường, thông tin nằm trong Google, Bing và các công cụ tìm kiếm khác đều là vàng ròng. Nhưng có một vấn đề: sao chép kết quả tìm kiếm thủ công thì chán chẳng khác nào ngồi nhìn sơn khô, còn khả năng mở rộng thì cũng chỉ như một quầy nước chanh giữa bão tuyết.
Đó là lúc thu thập dữ liệu từ công cụ tìm kiếm phát huy tác dụng. Tôi đã tận mắt thấy những đội ngũ làm chủ kỹ năng này có thể mở khóa insight, tự động hóa nghiên cứu và vượt mặt đối thủ như thế nào. Nhưng tôi cũng đã thấy không ít người vướng rắc rối pháp lý, rào cản kỹ thuật, và vô số khoảnh khắc kiểu “Sao Google lại chặn tôi thế này?”. Vì vậy, nếu bạn đã sẵn sàng biến các công cụ tìm kiếm thành luồng tình báo kinh doanh của riêng mình — mà không giẫm phải “mìn” pháp lý hay mất ngủ vì CAPTCHA — hãy cùng tìm hiểu cách làm chủ việc thu thập dữ liệu từ công cụ tìm kiếm vào năm 2026.
Thu thập dữ liệu từ công cụ tìm kiếm là gì? Giải thích đơn giản
Hãy tách nó ra cho dễ hiểu: thu thập dữ liệu từ công cụ tìm kiếm là quá trình dùng công cụ tự động để trích xuất dữ liệu kết quả tìm kiếm — như tiêu đề, URL, đoạn trích, thứ hạng — từ các công cụ như Google hoặc Bing. Hãy tưởng tượng có một trợ lý robot có thể nhập truy vấn của bạn vào Google, chép toàn bộ kết quả và dán vào bảng tính cho bạn. Đó chính là thu thập dữ liệu từ công cụ tìm kiếm, theo cách ngắn gọn nhất.
Thay vì cuộn tay và sao chép thủ công, một trình thu thập dữ liệu sẽ “đọc” HTML của trang kết quả tìm kiếm (SERP) và kéo ra những thông tin bạn quan tâm. Ví dụ, bạn có thể muốn 100 kết quả Google hàng đầu cho từ khóa “best CRM software”, bao gồm tiêu đề, URL và đoạn trích của từng kết quả. Các trình thu thập nâng cao còn có thể lấy cả câu hỏi “Mọi người cũng hỏi”, đoạn trích nổi bật, hình ảnh hoặc vị trí quảng cáo.
Nó hoạt động như thế nào? Về cơ bản, trình thu thập dữ liệu sẽ gửi yêu cầu đến công cụ tìm kiếm, giả làm một trình duyệt thông thường. Sau đó, nó phân tích HTML trả về và trích xuất dữ liệu có cấu trúc. Điều hay là bạn có thể làm việc này cho hàng trăm, thậm chí hàng nghìn truy vấn trong thời gian một người chỉ kịp sao chép-dán một trang kết quả (Growth Marketing Pro).
Các trường hợp sử dụng phổ biến nhất trong kinh doanh:
- Theo dõi SEO: Giám sát thứ hạng website của bạn trên Google cho các từ khóa mục tiêu.
- Nghiên cứu đối thủ: Xem đối thủ của bạn xuất hiện ở đâu và như thế nào trên kết quả tìm kiếm.
- Tạo lead: Tìm danh bạ, danh sách hoặc hồ sơ LinkedIn để phục vụ sales outreach.
- Chiến lược nội dung: Khám phá các câu hỏi hoặc chủ đề đang thịnh hành cho nội dung mới.
Nếu bạn từng tự Googling tên công ty mình rồi ghi lại những gì thấy được, thì bạn đã làm phiên bản thủ công của việc này rồi. Thu thập dữ liệu từ công cụ tìm kiếm chỉ là làm điều đó ở quy mô lớn — và với ít caffeine hơn rất nhiều.
Vì sao thu thập dữ liệu từ công cụ tìm kiếm quan trọng với doanh nghiệp hiện đại
Hãy nhìn thẳng vào sự thật: công cụ tìm kiếm là mạch đập của thị trường. Dữ liệu chúng hiển thị phản ánh điều mọi người muốn, ai đang thắng, và xu hướng nào đang nổi lên. Đó là lý do gần 42% toàn bộ yêu cầu web scraping hiện nay nhắm vào kết quả của công cụ tìm kiếm (42%), biến đây thành nhóm lớn nhất trong lĩnh vực trích xuất dữ liệu web.
Dưới đây là cách các doanh nghiệp đang dùng thu thập dữ liệu từ công cụ tìm kiếm để tạo ra kết quả thực tế:
| Trường hợp sử dụng (đội ngũ) | Dữ liệu thu thập qua tìm kiếm | Lợi ích / Kết quả |
|---|---|---|
| Theo dõi SEO (Marketing) | Kết quả Google cho các từ khóa mục tiêu | Phát hiện lỗ hổng SEO, điều chỉnh nội dung, bảo vệ tăng trưởng traffic tự nhiên |
| Phân tích đối thủ (Ops) | Kết quả tìm kiếm về đối thủ | Tình báo theo thời gian thực, phản ứng với động thái của đối thủ, ví dụ hạ giá để tăng 4% doanh số (Browsercat) |
| Tạo lead (Sales) | SERP liệt kê khách hàng tiềm năng | Tạo danh sách triển vọng trong vài phút — ví dụ tìm được hơn 900 lead qua toán tử Google (Amplemarket) |
| Chiến lược nội dung (Marketing) | Kết quả tìm kiếm hàng đầu, câu hỏi liên quan | Nội dung dựa trên dữ liệu, mức độ liên quan cao hơn, ROI marketing tốt hơn (tăng 10–20% nhờ dữ liệu bên ngoài (Dataforest)) |
| Giám sát thương hiệu (Pháp lý/Ops) | Kết quả tìm kiếm về thương hiệu, hình ảnh | Phát hiện sớm vấn đề thương hiệu, hàng giả hoặc tin tiêu cực |
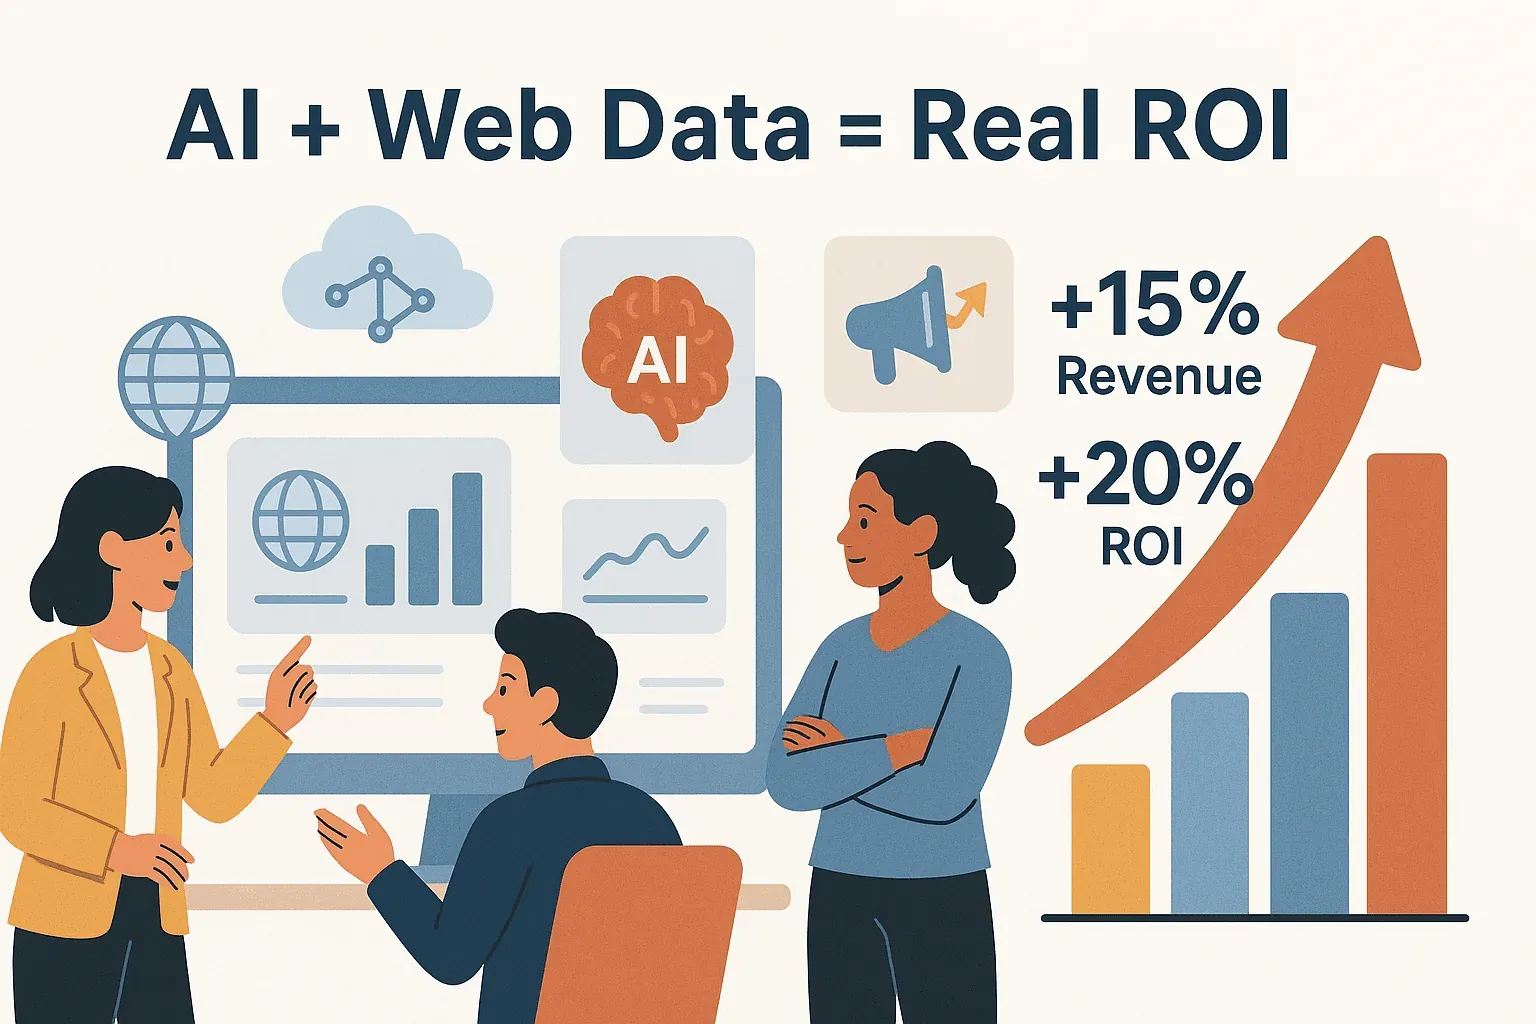
ROI là có thật: các công ty tích hợp dữ liệu web bên ngoài và AI vào hoạt động kinh doanh của họ ghi nhận doanh thu cao hơn 5–15% và ROI marketing cải thiện 10–20% (Dataforest). Và với việc 65% doanh nghiệp toàn cầu đang dùng công cụ trích xuất dữ liệu (65%) như một phần trong vận hành, scraping không còn là trò chơi của hacker nữa — mà là nhu cầu thiết yếu của doanh nghiệp.
Vượt qua rủi ro pháp lý và kỹ thuật khi thu thập dữ liệu từ công cụ tìm kiếm
Đây là phần bắt đầu “căng”: scraping công cụ tìm kiếm rất mạnh, nhưng cũng là một bãi mìn pháp lý và kỹ thuật nếu bạn không cẩn thận.
Khía cạnh pháp lý:
- Có hợp pháp không? Nhìn chung, việc scraping kết quả tìm kiếm công khai là hợp pháp (Datadome), nhưng vi phạm điều khoản dịch vụ (ToS) của công cụ tìm kiếm có thể khiến IP của bạn bị chặn hoặc nhận thư yêu cầu chấm dứt. Tòa án Mỹ đã phán rằng truy cập dữ liệu công khai không phải là tội phạm (xem hiQ v. LinkedIn), nhưng vi phạm ToS lại là vấn đề hợp đồng.
- Quyền riêng tư dữ liệu: Nếu bạn scrape dữ liệu cá nhân (dù là công khai), có thể vướng các vấn đề GDPR hoặc CCPA. Hãy ưu tiên thông tin công khai, không mang tính cá nhân, và luôn kiểm tra kỹ thứ bạn đang thu thập (Datadome).
- Robots.txt: Không có tính ràng buộc pháp lý, nhưng là một chuẩn của ngành. Nếu robots.txt nói “không được scraping”, hãy xem đó như đèn đỏ (Medium).
Rủi ro kỹ thuật:
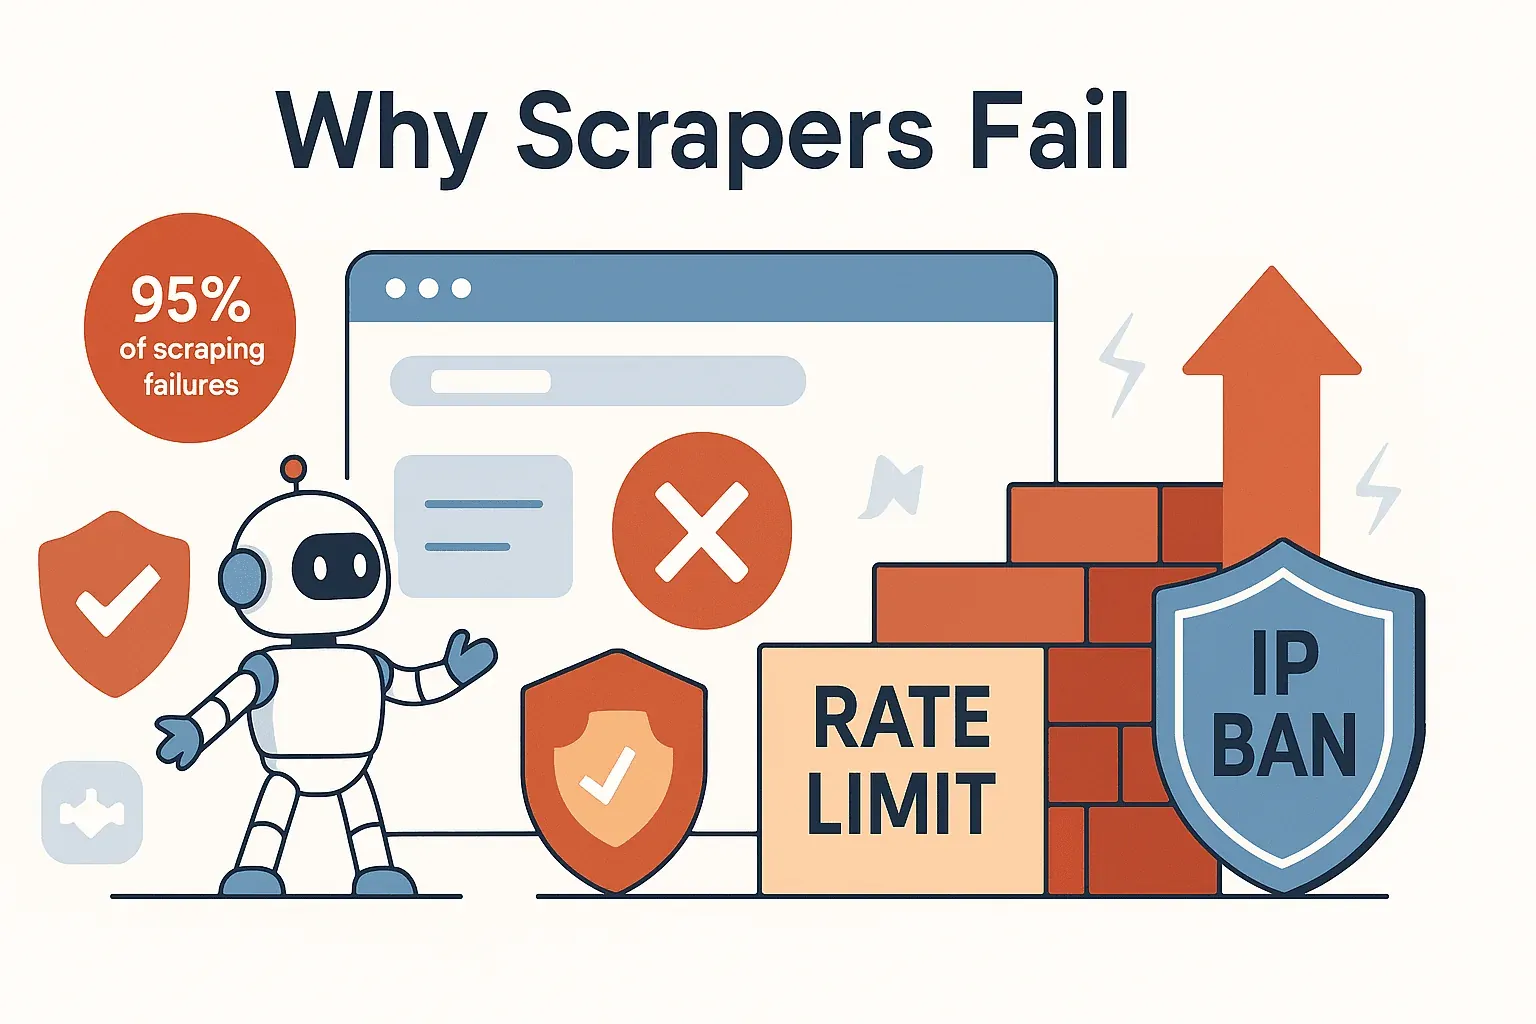
- CAPTCHA & chặn IP: Hơn 95% các lần scraping thất bại là do cơ chế chống bot (95%). Google và Bing dùng giới hạn tần suất, CAPTCHA và chặn IP để ngăn bot.
- Thay đổi bố cục: Công cụ tìm kiếm rất thích chỉnh HTML của chúng. Trình thu thập dữ liệu được viết cứng sẽ hỏng khi cấu trúc thay đổi.
- Phát hiện user-agent: Công cụ tìm kiếm có thể phục vụ HTML khác nhau cho di động và máy tính. Nếu trình thu thập của bạn trông “rất bot”, bạn có thể bị gắn cờ hoặc thấy dữ liệu khác.
 Mẹo để tránh rắc rối:
- Thu thập chậm, thêm độ trễ ngẫu nhiên và dùng proxy xoay vòng.
- Dùng chuỗi user-agent thực tế (giả làm Chrome, đừng như một con bot từ năm 1999).
- Kiểm tra robots.txt và ToS trước khi scrape.
- Không thu thập hoặc bán lại dữ liệu cá nhân.
- Theo dõi cập nhật pháp lý — luật riêng tư đang ngày càng chặt chẽ (Hogan Lovells).
Di động vs. máy tính: khác biệt chính khi thu thập dữ liệu từ công cụ tìm kiếm
Đây là một điểm khá thú vị: scrape Google trên điện thoại không giống với scrape trên laptop. Tại sao? Vì công cụ tìm kiếm hiển thị bố cục, tính năng, và thậm chí cả thứ hạng khác nhau tùy theo thiết bị.
Những khác biệt chính:
- Bố cục: SERP trên máy tính thường có nhiều cột hơn, thanh bên và đoạn trích giàu thông tin hơn. Di động là một cột, ít kết quả hiển thị cùng lúc hơn.
- Cấu trúc HTML: Google trên máy tính dùng các container như
<div class="g">, trong khi bản di động dùng thuộc tínhdata-vedhoặcdata-sncf(Webscraping.ai). Trình thu thập cần logic phân tích khác nhau cho từng loại. - Tính năng SERP: Di động hiển thị nhiều kết quả hình ảnh/video và local pack hơn; máy tính có nhiều đoạn trích nổi bật và thanh bên hơn (MarketingProfs).
- Phân trang: Máy tính thường dùng trang đánh số (
&start=10), trong khi di động có thể dùng cuộn vô hạn hoặc nút “Xem thêm kết quả” (ClickPower). - Khác biệt xếp hạng: Khoảng 13% website xếp hạng khác nhau giữa di động và máy tính (13%), và 30% URL ở trang đầu trên máy tính không xuất hiện trong top 10 trên di động (30%).
Mẹo hành động:
- Đặt user-agent của trình thu thập khớp với thiết bị mục tiêu của bạn (iPhone/Android cho di động, Chrome cho máy tính).
- Với di động, dùng trình duyệt headless để mô phỏng cuộn và kích thước viewport (Webscraping.ai).
- Kiểm thử trình thu thập trên cả hai thiết bị — đừng mặc định rằng một cấu hình là đủ cho tất cả.
Thunderbit: Cách dễ nhất để thu thập dữ liệu từ công cụ tìm kiếm
Thu thập kết quả tìm kiếm bằng AI Get Started Free
Nếu bạn đang nghĩ, “Nghe phức tạp quá”, thì bạn không hề đơn độc. Đó chính là lý do chúng tôi xây dựng Thunderbit. Thunderbit là một tiện ích mở rộng Chrome chạy bằng AI, giúp thu thập dữ liệu từ công cụ tìm kiếm dễ như hai cú nhấp — không cần code, không đau đầu vì selector, không cần bảo trì.
Điểm gì khiến Thunderbit nổi bật?
- AI gợi ý trường dữ liệu: AI của Thunderbit quét trang và gợi ý chính xác các trường cần trích xuất (như “Tiêu đề”, “URL”, “Đoạn trích”). Không còn phải đoán CSS selector.
- Scraping trang con & phân trang: Bạn muốn lấy nhiều hơn trang đầu tiên? Thunderbit có thể tự nhấp “Tiếp theo” hoặc tự cuộn, và thậm chí truy cập URL của từng kết quả để bổ sung thêm thông tin cho bảng của bạn.
- Prompt ngôn ngữ tự nhiên: Bạn có thể mô tả nhu cầu bằng tiếng Anh đơn giản (“Trích ngày từ đoạn trích” hoặc “Dịch sang tiếng Tây Ban Nha”), và AI của Thunderbit sẽ tự tìm cách thực hiện.
- Không cần code, chạy ngay trong trình duyệt: Hoạt động trực tiếp trong Chrome, nên bạn có thể scrape mọi trang công cụ tìm kiếm bạn nhìn thấy — nội dung động, cuộn vô hạn, gì cũng được.
- Xuất dữ liệu miễn phí: Xuất kết quả sang Excel, Google Sheets, Airtable hoặc Notion — không paywall, không phiền phức.
Thunderbit được hơn 100.000 người dùng trên toàn thế giới tin dùng trên Chrome Web Store, từ đội sales, marketer cho đến các founder độc lập.
Dùng thử Thunderbit cho việc thu thập dữ liệu từ công cụ tìm kiếm
Hướng dẫn từng bước: Thu thập dữ liệu từ công cụ tìm kiếm với Thunderbit
Sẵn sàng tự thử chưa? Đây là cách đi từ con số 0 đến “anh hùng dữ liệu tìm kiếm” chỉ trong bốn bước:
Bước 1: Cài đặt và thiết lập Thunderbit
- Vào trang Thunderbit Chrome Extension và nhấp “Add to Chrome”.
- Đăng ký hoặc đăng nhập (bắt đầu miễn phí).
- Ghim biểu tượng Thunderbit lên thanh công cụ để truy cập nhanh.
- Cấp quyền khi được yêu cầu — Thunderbit cần đọc các trang bạn muốn scrape.
Bước 2: Cấu hình mẫu thu thập dữ liệu công cụ tìm kiếm
- Mở Google (hoặc công cụ tìm kiếm bạn chọn) và chạy truy vấn.
- Nhấp biểu tượng Thunderbit để mở thanh bên.
- Nhấn “AI Suggest Fields.” AI của Thunderbit sẽ quét trang và đề xuất các cột như “Tiêu đề”, “URL” và “Đoạn trích”.
- Xem lại và chỉnh trường nếu cần. Muốn lấy ngày hoặc lọc quảng cáo? Hãy thêm trường tùy chỉnh hoặc tinh chỉnh prompt của AI (ví dụ: “Chỉ trích xuất kết quả tự nhiên”).
- Với nhu cầu nâng cao, thêm Field AI Prompt (như “Dịch đoạn trích sang tiếng Pháp” hoặc “Tóm tắt trong 10 từ”).
Bước 3: Bắt đầu scrape và thu thập dữ liệu
- Nhấp “Scrape.” Thunderbit sẽ trích xuất dữ liệu từ trang hiện tại.
- Cần thêm kết quả? Bật scraping phân trang — Thunderbit sẽ nhấp “Tiếp theo” hoặc cuộn khi cần, thu thập kết quả qua nhiều trang.
- Muốn chi tiết hơn? Dùng scraping trang con để truy cập URL của từng kết quả và trích thêm thông tin (như email liên hệ hoặc thẻ meta).
- Theo dõi tiến trình trong bảng điều khiển của Thunderbit. Nếu gặp CAPTCHA, hãy thử chuyển sang chế độ trình duyệt hoặc giảm tốc độ scrape.
Bước 4: Xuất và sử dụng dữ liệu của bạn
- Khi xong, xem trước dữ liệu trong chế độ bảng của Thunderbit.
- Xuất trực tiếp sang Excel, Google Sheets, Airtable hoặc Notion — hoặc tải về dưới dạng CSV/JSON.
- Dùng dữ liệu cho báo cáo SEO, danh sách lead, theo dõi đối thủ, hoặc bất kỳ nhu cầu kinh doanh nào của bạn.
Xây dựng chiến lược scraping linh hoạt với AI
Web thay đổi rất nhanh — đặc biệt là các công cụ tìm kiếm. Đó là lý do AI của Thunderbit được thiết kế để thích nghi:
- Xử lý thay đổi bố cục: Nếu Google chỉnh HTML, AI của Thunderbit thường vẫn có thể “bắt nhịp”, nhận diện mẫu mới và giữ cho dữ liệu chảy đều (Thunderbit Blog).
- Prompt ngôn ngữ tự nhiên: Mô tả nhu cầu bằng tiếng Anh đơn giản — Thunderbit có thể trích xuất, gắn nhãn, dịch hoặc tóm tắt dữ liệu ngay lập tức.
- Biến đổi dữ liệu ngay khi chạy: Muốn phân loại kết quả thành “thương mại” hay “thông tin”? Thêm prompt, và Thunderbit sẽ gắn nhãn khi đang scrape.
- Cải tiến liên tục: AI của Thunderbit ngày càng thông minh hơn theo thời gian, nên chiến lược scraping của bạn cũng tiến hóa cùng web.
Mẹo hay để luôn linh hoạt:
- Thường xuyên cập nhật prompt cho trường dữ liệu khi nhu cầu thay đổi.
- Lên lịch scrape định kỳ cho việc giám sát liên tục.
- Kết hợp scraping với các API chính thức (như Google Trends) để có insight phong phú hơn.
Ứng dụng thực tế: Biến dữ liệu thu thập từ công cụ tìm kiếm thành hiệu quả kinh doanh
Tìm hiểu thêm về data scraping Get Started Free
Đây là cách các đội ngũ đang dùng thu thập dữ liệu từ công cụ tìm kiếm để tạo ra tác động kinh doanh thực sự:
- Phân tích xu hướng thị trường: Scrape “Mọi người cũng hỏi” và gợi ý tự động để phát hiện xu hướng mới trước đối thủ.
- Theo dõi đối thủ: Thiết lập scrape hằng ngày cho các từ khóa hàng đầu — phát hiện đối thủ mới hoặc động thái giá trước khi chúng ảnh hưởng đến lợi nhuận của bạn.
- Tạo lead: Scrape Google để lấy danh sách ngành, sau đó dùng scraping trang con để thu thập thông tin liên hệ từ từng kết quả.
- Hiệu quả SEO: Theo dõi thứ hạng của bạn và đối thủ, phát hiện tụt hạng và điều chỉnh nội dung nhanh chóng.
- Tình báo quảng cáo: Scrape quảng cáo tìm kiếm để xem đối thủ đang chạy ưu đãi và thông điệp gì.
Ví dụ thực tế: Một nhà bán lẻ đã dùng dữ liệu giá đối thủ được scrape để hạ giá thấp hơn và ghi nhận doanh số tăng 4% (Browsercat). Một agency khác đã tạo danh sách hơn 900 lead trong một ngày bằng toán tử tìm kiếm Google và scraping — việc này nếu làm thủ công có thể mất hàng tuần (Amplemarket).
Xu hướng tương lai: Bức tranh đang thay đổi của thu thập dữ liệu từ công cụ tìm kiếm
Điều duy nhất không đổi trong thu thập dữ liệu từ công cụ tìm kiếm? Chính là sự thay đổi. Dưới đây là những gì đang ở phía trước:
- Kết quả tìm kiếm chạy bằng AI: Google đã đổi tên SGE thành AI Overviews vào tháng 5/2024, và đến tháng 4/2026 chúng xuất hiện trên khoảng 48% toàn bộ truy vấn Google — tăng từ 31% vào tháng 2/2025. Google cũng đưa AI Mode vào Chrome ngày 16/4/2026, và trải nghiệm AI của Bing giờ nằm dưới tên Copilot Search. SERP ngày càng mang tính hội thoại và ít có cấu trúc dự đoán được hơn, vì vậy trình thu thập dữ liệu cần xử lý khối trả lời AI, citation chips và bảng câu hỏi tiếp theo song song với các liên kết xanh cổ điển (Seer Interactive — AIO Impact on CTR, 2026 Update).
- Cơ chế chống bot mạnh hơn: Theo Imperva's 2026 Bad Bot Report, lưu lượng tự động hiện chiếm hơn 53% toàn bộ traffic web — và riêng bot xấu chiếm 37%. Hãy chuẩn bị cho nhiều CAPTCHA hơn, fingerprinting hơn và các lớp đăng nhập hơn, nhất là trên SERP có giá trị cao.
- Nền tảng scraping không cần code & chạy bằng AI: Các công cụ như Thunderbit đang khiến scraping trở nên dễ tiếp cận với mọi người, không chỉ lập trình viên.
- Thay đổi về pháp lý: Luật riêng tư đang siết chặt. Cơ quan quản lý đang kêu gọi các nền tảng chống lại scraping trái phép, đặc biệt là dữ liệu cá nhân (Hogan Lovells).
- Cách tiếp cận lai: Kết hợp scraping với API chính thức (như Google Custom Search) có thể sẽ trở thành chuẩn mực cho tuân thủ và độ tin cậy.
- Tìm kiếm bằng giọng nói, hình ảnh và AI: Khi tìm kiếm mở rộng sang trợ lý giọng nói và công cụ hình ảnh, sẽ xuất hiện những mặt trận scraping mới (ví dụ: scraping kết quả Google Lens hoặc câu trả lời bằng giọng nói).
Cách để đi trước:
- Dùng các công cụ biết tiến hóa cùng web (như Thunderbit).
- Hành xử có đạo đức — scrape một cách tôn trọng, tránh dữ liệu cá nhân và giảm tải cho máy chủ.
- Theo dõi cập nhật pháp lý và kỹ thuật.
- Tập trung vào chất lượng và tích hợp dữ liệu — scraping chỉ là bước đầu; giá trị thật nằm ở phân tích và hành động.
Kết luận & điểm chính cần nhớ
Thu thập dữ liệu từ công cụ tìm kiếm không còn chỉ là một mẹo của hacker nữa — mà là kỹ năng bắt buộc với bất kỳ doanh nghiệp nào muốn cạnh tranh, dựa trên dữ liệu và linh hoạt. Điều quan trọng là làm thông minh: hiểu bối cảnh pháp lý và kỹ thuật, dùng công cụ thích ứng như Thunderbit, và luôn gắn dữ liệu của bạn với kết quả kinh doanh thực tế.
Những điều cần nhớ:
- Thu thập dữ liệu từ công cụ tìm kiếm biến kết quả công khai thành tình báo kinh doanh có thể hành động.
- Lợi ích là rất lớn: insight nhanh hơn, lead tốt hơn, chiến lược thông minh hơn và ROI đo lường được.
- Nhưng bạn cần scrape có trách nhiệm — tôn trọng giới hạn pháp lý, thích ứng với thách thức kỹ thuật và tập trung vào chất lượng.
- Thunderbit giúp bất kỳ ai cũng có thể bắt đầu dễ dàng, với phát hiện trường bằng AI, scraping trang con/phân trang và quy trình không cần code.
- Tương lai rất năng động — hãy đón nhận AI, tuân thủ quy định và để chiến lược scraping của bạn liên tục tiến hóa.
Sẵn sàng xem việc thu thập dữ liệu từ công cụ tìm kiếm có thể làm gì cho doanh nghiệp của bạn chưa? Tải Thunderbit, thử scrape các từ khóa hàng đầu của bạn, và biến các công cụ tìm kiếm của thế giới thành lợi thế cạnh tranh riêng. Và nếu bạn muốn thêm mẹo, phân tích chuyên sâu hoặc hướng dẫn thực tế, hãy xem Thunderbit Blog.
Bắt đầu thu thập dữ liệu từ công cụ tìm kiếm với Thunderbit
Câu hỏi thường gặp
1. Thu thập dữ liệu từ công cụ tìm kiếm có hợp pháp không?
Nhìn chung, việc scraping kết quả tìm kiếm công khai là hợp pháp, nhưng vi phạm điều khoản dịch vụ của công cụ tìm kiếm có thể khiến IP của bạn bị chặn hoặc nhận thư yêu cầu chấm dứt. Tránh thu thập dữ liệu cá nhân và luôn kiểm tra robots.txt cùng ToS trước khi bắt đầu (Datadome).
2. Khác biệt giữa scraping kết quả tìm kiếm trên di động và máy tính là gì?
SERP trên di động và máy tính khác nhau về bố cục, cấu trúc HTML, tính năng và đôi khi cả thứ hạng. Để scrape cả hai cần user-agent và logic phân tích khác nhau (Webscraping.ai).
3. Thunderbit làm cho việc thu thập dữ liệu từ công cụ tìm kiếm dễ hơn như thế nào?
Thunderbit dùng AI để gợi ý trường dữ liệu, xử lý trang con và phân trang, đồng thời cho phép bạn dùng prompt ngôn ngữ tự nhiên cho các nhu cầu trích xuất tùy chỉnh — tất cả ngay trong trình duyệt, không cần code (Thunderbit Blog).
4. Những rủi ro kỹ thuật chính trong thu thập dữ liệu từ công cụ tìm kiếm là gì?
CAPTCHA, chặn IP và thay đổi bố cục là những rủi ro lớn nhất. Hãy scrape chậm, dùng proxy và chọn công cụ có khả năng thích nghi với thay đổi (như Thunderbit).
5. Tương lai của việc thu thập dữ liệu từ công cụ tìm kiếm sẽ ra sao?
Hãy kỳ vọng nhiều kết quả tìm kiếm do AI dẫn dắt hơn, biện pháp chống bot mạnh hơn và luật riêng tư ngày càng thay đổi. Các công cụ kết hợp AI, quy trình không cần code và tuân thủ quy định (như Thunderbit) sẽ dẫn đầu.
Chúc bạn scrape vui vẻ — và mong rằng kết quả tìm kiếm của bạn luôn có cấu trúc, có thể hành động và đi trước đối thủ một bước.
Tìm hiểu thêm
- Cách scrape trang kết quả tìm kiếm Google (SERP) - 3 phương pháp
- Cách scrape kết quả tìm kiếm Google không cần code
Dùng thử AI Web Scraper của Thunderbit cho công cụ tìm kiếm Get Started Free




