
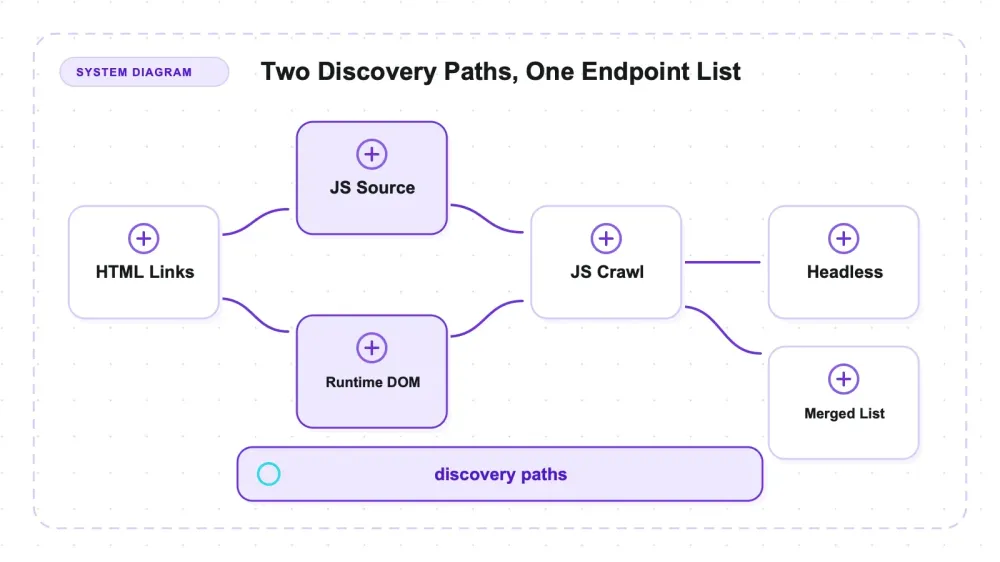
Katana là trình crawler khám phá endpoint của ProjectDiscovery — một binary viết bằng Go, phát hành theo giấy phép MIT, nhận một mục tiêu rồi trả về các URL và endpoint để đưa sang công cụ tiếp theo trong pipeline. Công cụ này có thể crawl ở chế độ HTTP không cần trình duyệt, hoặc dùng -headless để điều khiển Chromium. Hướng dẫn chính thức xem headless là lựa chọn có độ phủ cao hơn; bài thử này cho thấy vì sao loại endpoint quan trọng không kém số lượng.
Tôi dựng một site nhỏ với ba nhóm endpoint cố tình khác nhau và đo xem mỗi chế độ tìm được gì ở v1.6.1 với -d 4. HTML thông thường đều đạt 4/4 link và chuỗi ba bước đầy đủ ở cả bốn cấu hình. Phần khác biệt xuất hiện ở các endpoint lộ ra qua source JavaScript so với các thay đổi DOM lúc runtime.
Trên fixture này, headless tìm được nhóm runtime-DOM mà các chế độ browserless được thử đã bỏ sót, trong khi chế độ tiêu chuẩn với -jc lại tìm được các literal trong file JavaScript mà cả hai lần chạy headless đều không thấy. Không có hàng nào trong ma trận bốn lệnh bao phủ được cả hai nhóm. Scope, resume và hành vi known-files là các ranh giới thực tế còn lại.
Katana thực chất là gì
Katana crawler — trên GitHub là projectdiscovery/katana — được viết bằng Go và dùng giấy phép MIT. Tôi đã thử v1.6.1 vào ngày 27/07/2026; phiên bản rất quan trọng vì các kết quả về độ phủ và known-files bên dưới là quan sát gắn với từng bản build.
Nhãn phân loại ở đây quan trọng hơn thường lệ. Một endpoint-discovery crawler không phải công cụ trích xuất dữ liệu. Nếu bạn cần một go web crawler trả về tên sản phẩm và giá dưới dạng JSON có cấu trúc, thì katana không thuộc đúng “quầy hàng” đó — nó sẽ vui vẻ báo cho bạn rằng /products/1138 tồn tại, nhưng không nói gì về nội dung của trang ấy. Đó là thiết kế có chủ đích, và đánh giá nó theo khả năng trích xuất cũng giống như chấm điểm máy dò kim loại vì nó có định giá trang sức hay không.
Sân chơi đúng của nó là recon cho bảo mật tấn công và các pipeline tự động hóa: nhận STDIN, xuất URL, rồi pipe sang công cụ tiếp theo. Vì vậy cần nói rõ một cảnh báo hiển nhiên — mọi phép đo ở đây đều chạy trên một fixture tại 127.0.0.1 do chính tôi viết. Chỉ dùng katana trên hệ thống bạn sở hữu hoặc có văn bản cho phép kiểm thử, và không gì khác. Mọi thứ ở đây không nhằm né tránh phòng thủ của ai; nó chỉ nói về việc một lệnh cụ thể thực sự liệt kê được bao nhiêu bề mặt endpoint của một site.
Ba chế độ và mỗi chế độ nhìn thấy gì
Chế độ tiêu chuẩn là một HTTP client bằng Go. Nó tải trang, phân tích HTML, lần theo các href, và không hề khởi động trình duyệt. Nhanh, rẻ, nhưng mù với mọi thứ chỉ xuất hiện sau khi JavaScript chạy.
-jc (-js-crawl) gắn thêm bộ phân tích JavaScript vào luồng browserless đó. Nó tải các file .js được liên kết và trích các chuỗi có dạng URL từ source. Không chạy code, chỉ đọc source. Còn có -jsl (jsluice), được README mô tả là bộ phân tích nặng hơn, tốn bộ nhớ hơn — tôi không thử, nên không thể nói nó có thay đổi bức tranh độ phủ hay không.
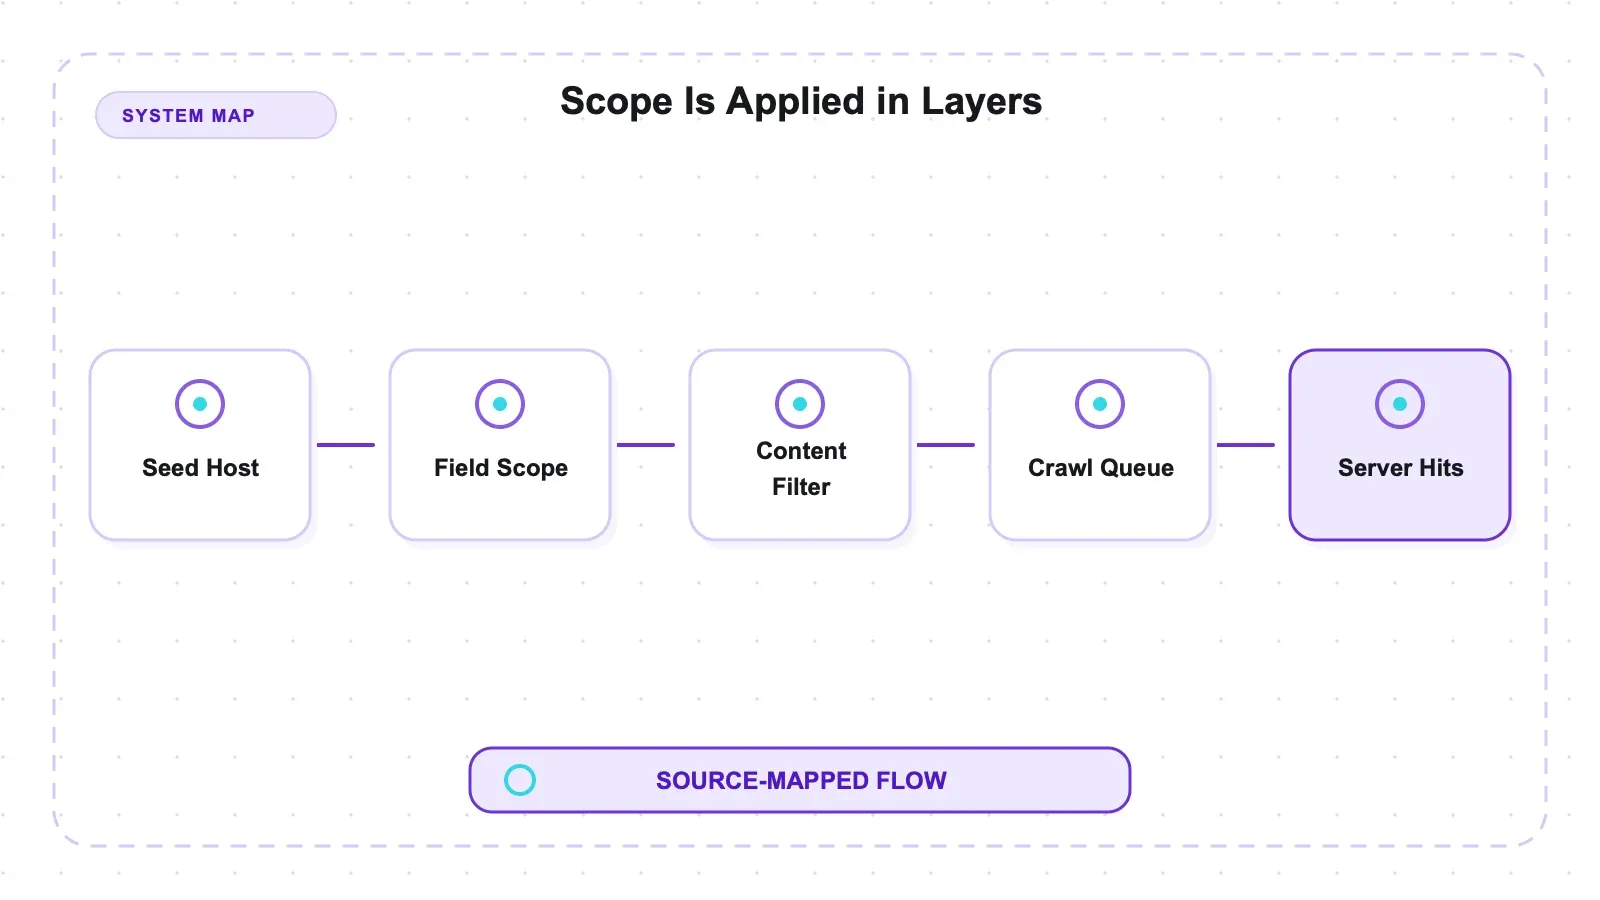
-headless điều khiển Chromium và thực thi script của trang. Trên fixture này, đó là chế độ Katana duy nhất trong các chế độ đã thử có thể khôi phục được đường dẫn được ghép từ nhiều mảnh rồi chèn vào DOM lúc runtime. Kết quả đó không chứng minh được mọi parser hay mọi chế độ Katana trong tương lai sẽ làm được như vậy.
Rồi đến mô hình scope, phần tôi muốn ghi nhớ trước khi gõ bất kỳ thứ gì vào môi trường production.
| Flag | Nó kiểm soát gì | Giá trị / mặc định |
|---|---|---|
-fs (field scope) | host nào được đưa vào phạm vi | dn, rdn, fqdn, hoặc regex tùy chỉnh — mặc định là rdn |
-cs và -cos | regex URL lọc bên trong field scope đó | — |
-kf | known files: robots.txt và sitemap.xml | README nói rằng cần tối thiểu depth 3 |
-d | độ sâu | mặc định 3 |
-resume | tiếp tục một lần crawl bị gián đoạn | — |
Thứ tự này không phải chuyện trang trí: nó quyết định regex host sẽ mở rộng crawl hay âm thầm làm trống nó.
Thiết lập: một binary, một dấu sao
Có ba cách cài, và chỉ một trong số đó cần toolchain:
| Cách cài | Yêu cầu |
|---|---|
Từ source: go install github.com/projectdiscovery/katana/cmd/katana@latest | yêu cầu được nêu là Go 1.25 trở lên |
| Binary biên dịch sẵn trên trang release | không cần toolchain |
| Docker image | không cần toolchain |
Máy tôi cài ở ~/go/bin/katana và lần nào cũng báo Current version: v1.6.1. Cho đến đây vẫn là câu chuyện Go rất dễ chịu: một file, không runtime.
Dấu sao nằm ở headless, nơi trình duyệt là một yêu cầu riêng, tách khỏi binary:
Nơi -headless chạy | Nó cần gì |
|---|---|
| Máy của tôi | katana tự phát hiện một Chromium đã cài sẵn; tôi không ghi lại bản build của trình duyệt cũng không chỉ định đường dẫn browser |
| Một server trống, theo hướng dẫn Ubuntu của dự án | cần apt install google-chrome-stable trước khi headless làm được gì |
| Cách chạy qua Docker | headless chạy với -system-chrome |
Trên một server trống, sự tiện lợi đó biến mất. Hãy tính ngân sách cho cả browser chứ không chỉ binary, ngay khi -headless xuất hiện trong command line.
Một chi tiết nhỏ nhưng đáng biết nếu bạn chạy trong CI: katana gọi GitHub để kiểm tra version khi khởi động. -duc sẽ tắt việc đó. Trên laptop thì gần như nhiễu; trên runner air-gapped hoặc bị giới hạn rate, nó là một chuyến round-trip mạng mỗi lần chạy mà bạn không hề yêu cầu. Các lần đo thời gian của tôi đều thêm -duc để số liệu phản ánh việc crawl chứ không phải gọi về nhà.
Tôi đã test như thế nào
Ba nhóm endpoint, được chọn có chủ đích vì chúng tách biệt các chế độ. Mọi thứ nằm trong một local fixture server, và ground truth được ghi lại trước khi bất kỳ lần crawl nào bắt đầu, nên recall được đo trên một tập cố định thay vì dựa vào những gì katana tình cờ in ra.
- Nhóm A — HTML thuần.
/page/a,/page/b,/page/c, cộng với chuỗi ba bước/depth/1 → /depth/2 → /depth/3. Bất kỳ crawler nào cũng nên lấy được. - Nhóm B — literal trong file JavaScript.
/api/js-endpoint-7và/api/js-endpoint-8chỉ tồn tại dưới dạng chuỗi literal trong file/static/app.jsđược link tới. Có thể đọc được mà không cần browser, nếu có công cụ chịu đọc JS. - Nhóm C — chỉ xuất hiện ở runtime-DOM. Một đường dẫn được ghép lúc runtime từ các mảnh (
'endpoint' + (6 * 7)) rồi script chèn vào DOM. Chuỗi/runtime-only/endpoint42không bao giờ xuất hiện liền mạch trong bất kỳ byte nào server gửi — không trong HTML, không trong source JS. Chỉ khi thực thi mới thấy được.
Ngoài ra còn có robots.txt, một sitemap.xml chứa hai endpoint <loc> không xuất hiện ở đâu khác, một route trả về 500, một dead link, và một link ngoài scope trỏ tới server thứ hai trên hostname khác.
Công cụ đo cũng quan trọng như fixture: server đếm những gì thực sự được fetch, nên các tuyên bố về scope và resume dựa trên hit truth thay vì stdout của katana. Các lần chạy thô được commit trong benchmark repo nếu bạn muốn kiểm tra phép tính của tôi.
Khoảng cách độ phủ mà ít ai đo
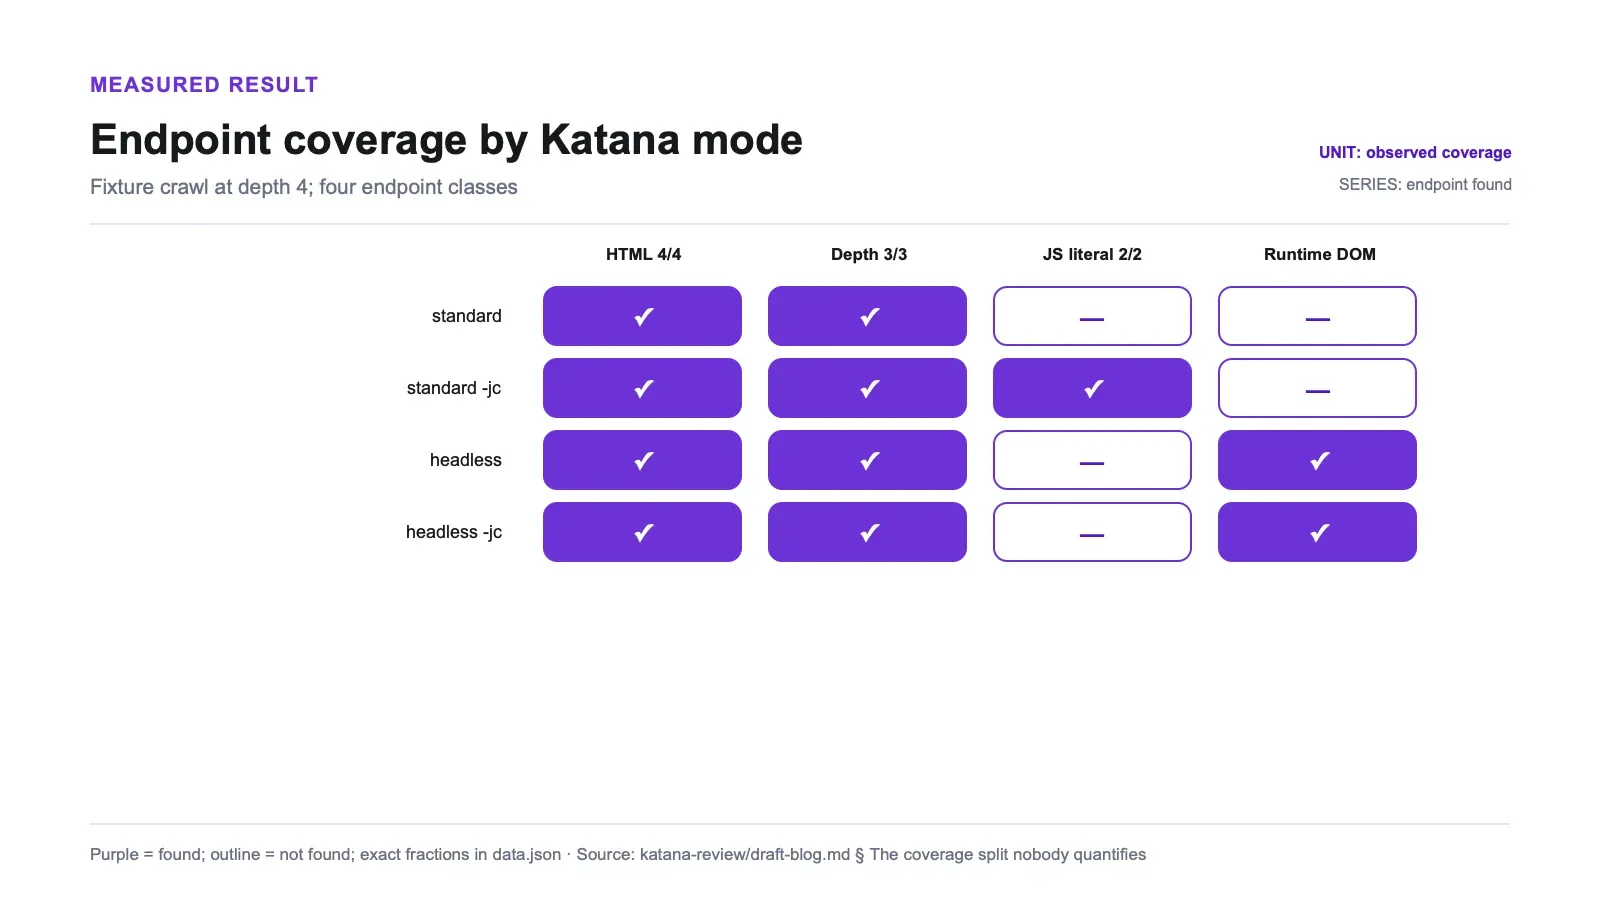
Ma trận theo từng chế độ và từng nhóm endpoint, tại -d 4:
| Chế độ | HTML links (A) | Depth chain (A) | JS-file literals (B) | Runtime-DOM (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | not found |
standard -jc | 4/4 | 3/3 | 2/2 | not found |
-headless | 4/4 | 3/3 | 0/2 | found |
-headless -jc | 4/4 | 3/3 | 0/2 | found |
Đọc hai cột cuối như một cặp là thấy vấn đề ngay. Nhóm B được tìm thấy bởi đúng một cấu hình: standard với -jc. Nhóm C được tìm thấy bởi đúng hai cấu hình: cả hai lần chạy headless. Không có hàng nào có hit ở cả hai cột. Bảng đầy đủ nằm trong discovery-summary.json, nơi trường tính toán headless_jc_covers_both có giá trị false.
Hệ quả thực tế là câu “chỉ cần dùng headless để có coverage tốt hơn” là chưa đủ cho bài test này. Headless không cộng thêm nhóm B lên trên kết quả standard; nó lấy lại nhóm C nhưng lại bỏ sót nhóm B. Muốn bao phủ toàn bộ các lớp đã cài trong fixture này cần hai lần crawl và gộp kết quả:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
Hàng -headless -jc là chỗ tôi muốn upstream giải thích nhất. Thêm JavaScript parser vào lần chạy headless không giúp gì thêm — vẫn 0/2 với nhóm B, trong mọi lần chạy, kể cả khi tái tạo lại từ đầu. Tôi đang báo cáo hành vi, không khẳng định đã truy được cơ chế; tôi không instrument internals của katana để biết vì sao đường browser không còn đóng góp các JS-file literals. Hãy xem đây là một quan sát tái lập được và là đề tài tốt cho một issue trên GitHub, chứ không phải chẩn đoán. (Điểm cần lưu ý thêm: tổ hợp -hl -jc hoàn tất sạch với return code 0 trên v1.6.1 ở macOS ARM, điều này trước đây không phải lúc nào cũng đúng.)
Docs chính thức mô tả headless là cho coverage tốt hơn, và đúng là nó có lợi ở nhóm render lúc runtime trong bài này. Tuy nhiên hướng dẫn đó không nêu rõ phép tách giữa source-literal và runtime-DOM này, nên hãy xem ma trận trên như lý do để tự test cả hai đường với chính các nhóm endpoint của bạn, không phải một phân loại phổ quát.
Headless tốn bao nhiêu thời gian thực
Ba lần chạy liên tiếp mỗi chế độ trên một máy đang rảnh:
| Chế độ | p50 | min–max | mean |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
Đó là tỷ lệ 5.1x, với khoảng đo gần như không chồng lấn — lần standard chậm nhất của tôi (13.17s) vẫn nhanh hơn lần headless nhanh nhất (66.78s) hơn 53 giây (cost-summary.json). Đây không phải nhiễu đo lường.
Một lưu ý về con số 13 giây đó: fixture của tôi cố ý có route 500 và một dead link, và standard mode phải chờ default -timeout 10 ở cả hai trường hợp. Tôi không chỉnh timeout để làm đẹp cho chế độ nhanh, nghĩa là một lần chạy standard được tinh chỉnh có lẽ sẽ nới rộng khoảng cách chứ không thu hẹp nó.
Tỷ lệ này là tín hiệu về năng lực local, không phải dự báo production. Mục tiêu thực tế thay đổi về latency, lỗi, mức độ xử lý script và lịch chạy, trong khi fixture này có đuôi timeout mặc định. Hãy dùng chênh lệch 5.1x đã đo để quyết định headless có cần một ngân sách và tập mục tiêu riêng hay không, rồi benchmark kế hoạch đó trên các host được phép, đại diện cho thực tế.
Scope vẫn giữ nguyên, nhưng một flag lại âm thầm không làm gì
Bài test scope dùng hai server: server chính trên 127.0.0.1, và một server thứ hai truy cập được dưới dạng localhost trên một cổng khác, phục vụ một path chỉ tồn tại ở đó. Vì vậy, nếu path ấy được hit thì chứng tỏ host ngoài scope thực sự đã được fetch, chứ không chỉ được in ra.
| Cấu hình | Host ngoài scope có bị fetch không? | Số hit trên server thứ hai |
|---|---|---|
mặc định (-fs rdn) | không | 0 |
-fs fqdn | không | 0 |
-cs localhost | không | 0 |
| `-fs '(127.0.0.1 | localhost)'` | có |
Kỷ luật scope là tin tốt: mặc định katana chỉ ở nhà, và phải có hành động rõ ràng mới mở rộng. Đó là mặc định đúng cho một công cụ được dùng trên hạ tầng của người khác.
Hàng thú vị là -cs localhost. Nó không mở rộng crawl sang host thứ hai — và nó cũng xuất ra 0 URL. Vì -cs lọc bên trong field scope, trong khi field scope vẫn là host chính, regex không khớp gì cả và crawl trả về tập rỗng thay vì báo lỗi. Nếu bạn từng viết regex scope nhắm đến một host muốn đưa vào rồi nhìn chằm chằm vào file output trống rỗng, thì đây là cơ chế đó (scope-summary.json). Muốn thêm host, hãy đặt -fs. Muốn thu hẹp trong số các host đã có, dùng -cs/-cos.
Resume thô hơn vẻ bề ngoài của flag
README mô tả flag này là -resume string resume scan using resume.cfg, nghe như một file được thả ngay trong thư mục làm việc. Thực ra không phải vậy. Trên máy tôi, checkpoint được ghi vào ~/.config/katana/resume-<xid>.cfg — đây là số liệu đo được chứ không phải đọc từ trang tài liệu, vì docs không nêu đường dẫn.
Điều bất ngờ hơn là nội dung bên trong. File chứa một map InFlightUrls chỉ có đúng một thứ: seed URL. Không phải tập đã duyệt, cũng không phải frontier. Vậy chuyện gì xảy ra khi tôi ngắt một lần crawl bằng SIGINT sau ba giây rồi resume lại?
| Lần chạy | Số path khác nhau |
|---|---|
| Full baseline crawl | 11 |
| Đã fetch trước khi bị ngắt | 10 |
| Bị resume fetch lại | cả 11, gồm toàn bộ 10 path đã xong |
Resume vẫn đi đến cùng một tập endpoint cuối, nên không có gì hỏng. Nhưng độ hạt của checkpoint là theo seed đầu vào, không phải theo từng URL — bộ lọc dedupe trong bộ nhớ không được lưu lại, nên khi resume một crawl chỉ có một seed, nó sẽ crawl lại seed đó từ đầu (resume-summary.json). Nếu bạn đưa cho katana một danh sách 500 host, resume sẽ giúp bạn tiết kiệm các host đã hoàn thành; hành vi đa-seed đó suy ra từ cách lưu state, nhưng tôi chỉ đo trường hợp một seed. Nếu bạn đang đào sâu vào một site cực lớn, resume mang lại độ đúng đắn chứ không tiết kiệm thời gian.
Known files: được yêu cầu, rồi bị bỏ qua
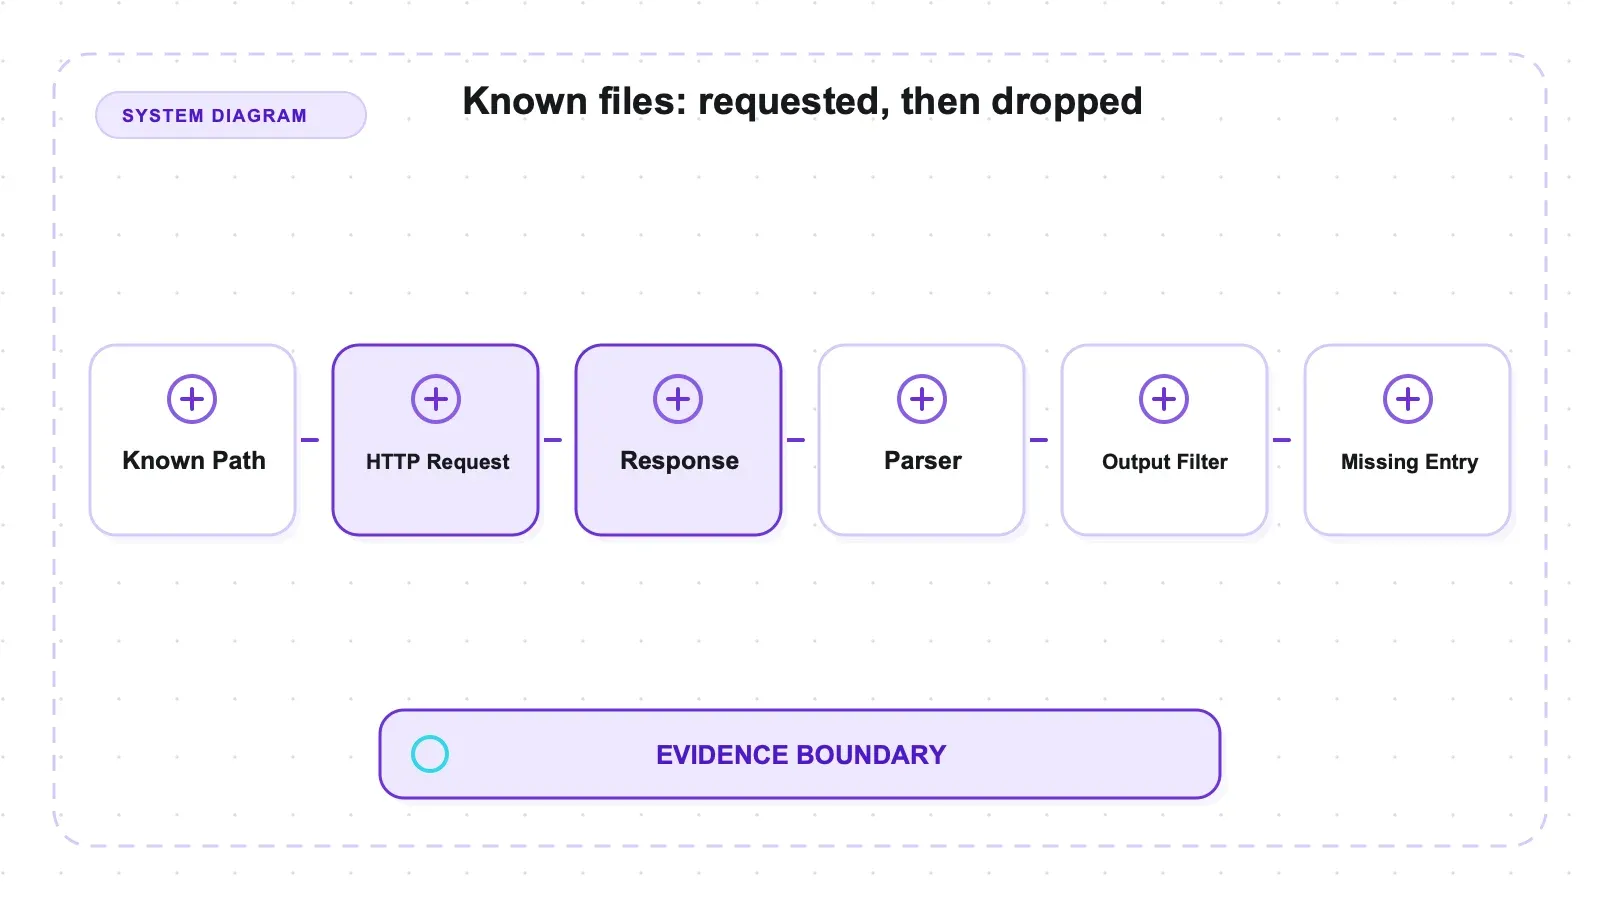
-kf all -d 3 có request cả hai file — robots.txt và sitemap.xml đều xuất hiện trong log hit của server — rồi sau đó khôi phục 0/2 endpoint được liệt kê trong các phần tử <loc> của sitemap đó. Recall 0.0.
Trước khi kết luận đây là giới hạn, tôi đã cố tìm xem có phải lỗi do mình. Mọi biến thể đều cho kết quả giống nhau:
| Biến thể đã thử | Endpoint <loc> trong sitemap được khôi phục |
|---|---|
-kf all | 0/2, recall 0.0 |
-kf sitemapxml | 0/2, recall 0.0 |
-kf robotstxt | 0/2, recall 0.0 |
| depth 3 | 0/2, recall 0.0 |
| depth 4 | 0/2, recall 0.0 |
| depth 5 | 0/2, recall 0.0 |
thêm -jc | 0/2, recall 0.0 |
seed trực tiếp từ /sitemap.xml | 0/2, recall 0.0 |
Yêu cầu được ghi tài liệu — dùng -kf, và đi sâu ít nhất ba mức — đều được đáp ứng mỗi lần. Đây không phải chuyện thiếu flag.
Quyết định hữu ích cần nói trước: trên fixture dùng IP literal này, đừng mặc định rằng request known files đồng nghĩa với việc các URL <loc> bên trong đã được đưa vào crawl. Hãy tự kiểm tra recall, hoặc tự trích chúng ra rồi seed thủ công.
Đường code v1.6.1 phù hợp với quan sát đó, nhưng tôi không instrument nó trong lúc chạy. Trong sitemapxml.go ở v1.6.1, NewNavigationRequestURLFromResponse tạo các navigation request từ <loc> mà không mang theo RootHostname đã được điền sẵn. Request sau đó đi qua ValidateScope; trong scope.go ở v1.6.1, nhánh IP-literal so sánh host của URL với root rỗng đó và có thể từ chối nó. Lệnh tùy chỉnh -fs '(127.0.0.1|localhost)' đi qua một nhánh scope khác trong bài test scope riêng, nên đây là cứu cánh được source dự đoán chứ không phải workaround đã đo cho -kf. Một lần xác nhận thử đã bị chặn bởi lỗi dialing thất thường trong client known-files trên host này; vì thế kết quả báo cáo vẫn là 0/2.
Điều tôi sẽ làm thật sự trong production, cho tới khi ai đó xác nhận flag này: tự fetch sitemap, trích các URL <loc>, rồi đưa chúng vào katana dưới dạng seed list. Hai dòng shell, không dính validation scope.
Có một điều hoạt động đúng như quảng cáo và xứng đáng một câu riêng: route 500 và dead link đều được fetch, ghi log, rồi bước qua. Mọi lần chạy browserless đều kết thúc với return code 0. Một crawler chết ngay khi gặp response lỗi đầu tiên là vô dụng khi chạy unattended, còn katana thì không như vậy.
Một kiểm tra độ phủ theo từng mục tiêu trước khi triển khai
Ma trận fixture hữu ích nhất như một mẫu để test các mục tiêu được phép của chính bạn. Hãy định nghĩa các nhóm endpoint trước khi chạy Katana: link thường, literal trong script được link tới, route chỉ sinh ra sau khi thực thi, và mục trong known-files là bốn nhóm khởi đầu hợp lý. Giữ một bộ ground truth nhỏ cho từng nhóm. Nếu không có danh sách đó từ trước, một stdout dài hơn có thể trông giống độ phủ tốt hơn dù thực ra một nhóm nào đó đã biến mất.
Hãy chạy browserless và headless như hai phép đo riêng biệt trước tiên. Lưu nguyên command, version Katana, bản build browser, return code và output. Chuẩn hóa rồi diff các tập endpoint thay vì chỉ so số dòng. Nếu standard -jc không đóng góp gì duy nhất trên mẫu của bạn, policy chỉ-headless có thể đủ; nếu hai tập khác nhau như ở đây, hãy giữ hai lần chạy tách biệt và merge sau khi thu thập. Không nên mặc định rằng thêm cả hai flag vào một command sẽ luôn bằng hợp của hai tập cho tới khi diff theo từng mục tiêu chứng minh điều đó.
Xác thực scope bằng chứng cứ nằm ngoài output của Katana. Đặt một URL canary trên host phải được loại trừ và kiểm tra request log của server đó. Đồng thời test host thứ hai dự định đưa vào nếu crawl cần mở rộng. Lần -cs localhost ở đây cho output rỗng vì lọc content-scope không mở rộng field scope; lệnh -fs '(127.0.0.1|localhost)' thì có chạm tới server thứ hai. Ghi lại regex chính xác rất quan trọng vì chỉ cần đổi một ký tự là regex đã khác, không chỉ là cách trình bày.
Hãy test việc gián đoạn và known files tách biệt với recall discovery. Với resume, ngắt một seed đại diện sau vài trang, lưu path checkpoint được tạo ra, rồi đếm xem bao nhiêu URL đã hoàn thành bị fetch lại. Với -kf, xác nhận cả việc robots/sitemap đã được request lẫn việc các URL <loc> đã cài sẵn có thật sự được đưa vào lịch crawl. Đó là hai khẳng định khác nhau. Trong fixture này, các file được fetch nhưng hai endpoint sitemap lại vắng mặt, nên cả log request lẫn output endpoint đều cần thiết để thấy ranh giới.
Cuối cùng, hãy thiết lập baseline chi phí local bằng các lần chạy liên tiếp trên một máy đang rảnh, rồi lặp lại trên các host đại diện. Giữ min, max và median chứ không chỉ một hệ số nhân. Con số 5.1x ở đây bao gồm cả hành vi lỗi và timeout của fixture; nó cho bạn biết headless xứng đáng có ngân sách riêng, chứ không nói production inventory sẽ mất bao lâu.
Ưu và nhược điểm
Ưu điểm:
- Recall hoàn hảo với HTML thường ở mọi chế độ — 4/4 link và chuỗi depth 3/3 đầy đủ, không cần cấu hình thêm.
-jcthực sự hoạt động ở chế độ browserless: khôi phục được 2/2 endpoint từ các string literal trong một file JS được link tới, không tốn chi phí browser.-headlesslà thứ duy nhất tìm được endpoint được ghép ở runtime — một lớp endpoint vốn dĩ không thể thấy bằng source parsing.- Mặc định scope khá an toàn. Host ngoài scope không bao giờ bị fetch ở chế độ mặc định,
-fs fqdn, hoặc-cs. - Một binary Go duy nhất, giấy phép MIT, build biên dịch sẵn và Docker image, I/O theo kiểu pipeline.
- Bền bỉ khi gặp lỗi: 500 và dead link không làm crawl dừng lại.
Nhược điểm:
- Không có một lần gọi nào bao phủ được cả endpoint trong JS file lẫn endpoint runtime-DOM. Muốn đủ coverage phải chạy hai lần và gộp.
-jckhông đóng góp gì khi chạy cùng-headless— 0/2 với nhóm B trong mọi lần headless.- Headless tốn gấp 5.1 lần wall time (p50 66.82s so với 13.08s, các khoảng không chồng lấn).
-resumecrawl lại các trang đã hoàn thành trong cùng một seed. Nó khôi phục endpoint set, không khôi phục thời gian của bạn.- Known files có request robots.txt và sitemap.xml nhưng vẫn khôi phục 0/2 endpoint
<loc>của sitemap khi nhắm IP. - Headless ngầm đòi hỏi có Chromium trên máy; câu chuyện “một binary” dừng lại ở browser.
- Chỉ khám phá. Không có trích xuất có cấu trúc, không chuyển đổi nội dung, không schema trường dữ liệu.
Những phần chưa thử, và vì vậy ngoài phạm vi của mọi con số ở đây: -jsluice, một bài test giới hạn depth riêng ở -d 1/-d 2, resume đa-seed, tự động điền form, và bất kỳ site production thật nào nặng JavaScript hay có cơ chế bảo vệ. Tất cả số liệu đều từ một máy (macOS arm64) trên local fixture.
Dành cho ai, và ai nên bỏ qua
Nếu công việc của bạn là tạo inventory endpoint cho hạ tầng mà bạn được phép chạm vào, katana có đúng hình dạng pipeline: plumbing STDIN/STDOUT, binary có thể phân phối, và cả chế độ browserless lẫn browser-backed. Cần hai lần chạy và merge trong fixture này cho các lớp endpoint đã cài; còn mục tiêu của bạn có cần cả hai lần hay không thì phải xác nhận trên các trang đại diện.
Nên bỏ qua nếu bạn cần dữ liệu chứ không phải địa chỉ. Katana sẽ không bao giờ đưa cho bạn bảng sản phẩm; nó chỉ đưa các URL nơi sản phẩm có thể tồn tại, và công đoạn trích xuất là việc của công cụ khác. Cũng nên bỏ qua nếu bạn cần một lệnh là xong — two-pass merge thì ổn trong pipeline nhưng hơi phiền ở prompt. Và nếu việc liệt kê của bạn dựa vào sitemap <loc> trong khi nhắm IP, hãy kiểm tra xem mình thực sự nhận được gì trước khi tin vào output, vì trên fixture của tôi đường đó trả về không gì cả.
Các lựa chọn thay thế, và ranh giới với extraction
Katana miễn phí, MIT-licensed và tự host. Nó giữ discovery, chọn chế độ, triển khai browser và gộp kết quả ở phía bạn.
Trong thế giới open source, so sánh hữu ích nên dựa vào nhiệm vụ thay vì ngôn ngữ. Colly là lựa chọn Go khác, nhưng đó là một library bạn tự biên dịch với callback của mình và nó không render JavaScript. Crawl4AI chạy browser thật và xuất Markdown cho các pipeline LLM, tức là một đầu ra hoàn toàn khác. Nếu bạn đang cân nhắc nhiều công cụ cùng lúc, bài tổng hợp open-source scraper của chúng tôi đặt các nhóm cạnh nhau rất rõ ràng.
Công bố: Thunderbit là sản phẩm của nhà xuất bản và không được thử trong fixture Katana này. Nó nằm ở phía sau trong nhóm managed extraction, chuyển trang thành text hoặc bản ghi có cấu trúc thay vì liệt kê bề mặt endpoint của một mục tiêu được phép. Một workflow có thể dùng cả hai nhóm, nhưng bài đánh giá này chỉ cung cấp bằng chứng cho hành vi discovery của Katana.
Thử Thunderbit để trích xuất dữ liệu web
Kết luận
Hãy dùng katana khi đầu ra cần là danh sách endpoint cho các mục tiêu bạn được phép crawl và bạn có thể xác minh độ phủ theo từng chế độ trên chính các mục tiêu đó. Trong fixture này, standard -jc khôi phục các literal JavaScript đã cài, còn headless khôi phục endpoint runtime-DOM; các chế độ browserless được thử của Katana không khôi phục được đường runtime đó. Scope mặc định cũng không fetch host thứ hai, và các lần chạy browserless vẫn đi tiếp sau 500 và dead link.
Các cảnh báo là về vận hành: có thể cần two-pass merge cho các lớp endpoint hỗn hợp, headless tốn khoảng năm lần wall time local, resume theo single-seed sẽ crawl lại các đường đã hoàn tất, và known-files recall là 0/2 khi nhắm IP. Đó là kết quả của v1.6.1 trên fixture, không phải cam kết với mọi site. Nhưng như vậy là đủ để xác định những kiểm tra mà một đánh giá production nên lặp lại.
Thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Katana lưu file resume ở đâu, và resume có bỏ qua các trang tôi đã crawl không?
Checkpoint nằm ở ~/.config/katana/resume-<xid>.cfg, chứ không phải resume.cfg trong thư mục làm việc như help text của flag gợi ý. Và không, nó không bỏ qua các trang đã hoàn thành: file chỉ lưu các seed URL đang chạy dở, nên khi resume một crawl chỉ có một seed, nó sẽ fetch lại toàn bộ 11 path baseline, gồm cả 10 path đã xong. Bạn nhận lại cùng endpoint set cuối cùng, nhưng không nhận lại thời gian đã tiết kiệm.
Vì sao -kf all có request sitemap.xml của tôi nhưng không crawl các URL bên trong?
Với mục tiêu IP, kết quả này phù hợp với một ranh giới validate scope hơn là lỗi flag. Trong code v1.6.1, parser sitemap của Katana tạo từng request <loc> mà không mang theo root hostname, và kiểm tra DNS-scope cho host IP-literal có thể từ chối URL đó; tôi không instrument lần chạy để xác nhận cơ chế này. Nó vẫn giữ ở mức 0 recall qua mọi biến thể flag, depth và seeding mà tôi đã thử. Một regex host -fs tùy chỉnh đi qua nhánh validate khác và là cách sửa mà source dự đoán — nhưng tôi không thể xác nhận bằng -kf trên máy của mình, nên hãy xem đó là chưa được kiểm chứng. Tự trích các URL <loc> rồi seed katana bằng chúng là cách tôi sẽ tin dùng hiện tại.
Khi báo cáo một bài test coverage của Katana, tôi nên lưu gì?
Ghi lại chính xác version và command của Katana, bao gồm biểu thức -fs từng byte một; định nghĩa các nhóm endpoint trước khi chạy; giữ log hit phía server bên cạnh stdout; và tách biệt hành vi đo được với giả thuyết dựa trên source. Với các lần chạy headless, cũng nên ghi bản build browser — bài test này đã không làm vậy, nên khả năng tái tạo bị giới hạn.
Tôi nên dùng -jc, -headless, hay cả hai?
Hãy chọn theo nhóm endpoint bạn cần. Trong fixture này, standard -jc tìm được các literal lưu trong file JavaScript, còn headless tìm được endpoint được chèn vào runtime DOM. Không chế độ nào bao phủ được cả hai nhóm một mình, nên chạy hai lượt rồi dedupe là lựa chọn có thể biện hộ cho các mục tiêu hỗn hợp.
Một URL lỗi có làm crawl dừng lại không? Không có trong lần chạy có kiểm soát này. Katana vẫn tiếp tục sau cả response 500 và dead link, rồi vẫn trả về các path khác có thể truy cập. Điều đó không thay thế cho việc tính toán lỗi trong production: hãy giữ log request lỗi và đặt ngưỡng lỗi chấp nhận được để một lần crawl chỉ thành công một phần không bị nhầm thành bao phủ đầy đủ.




