
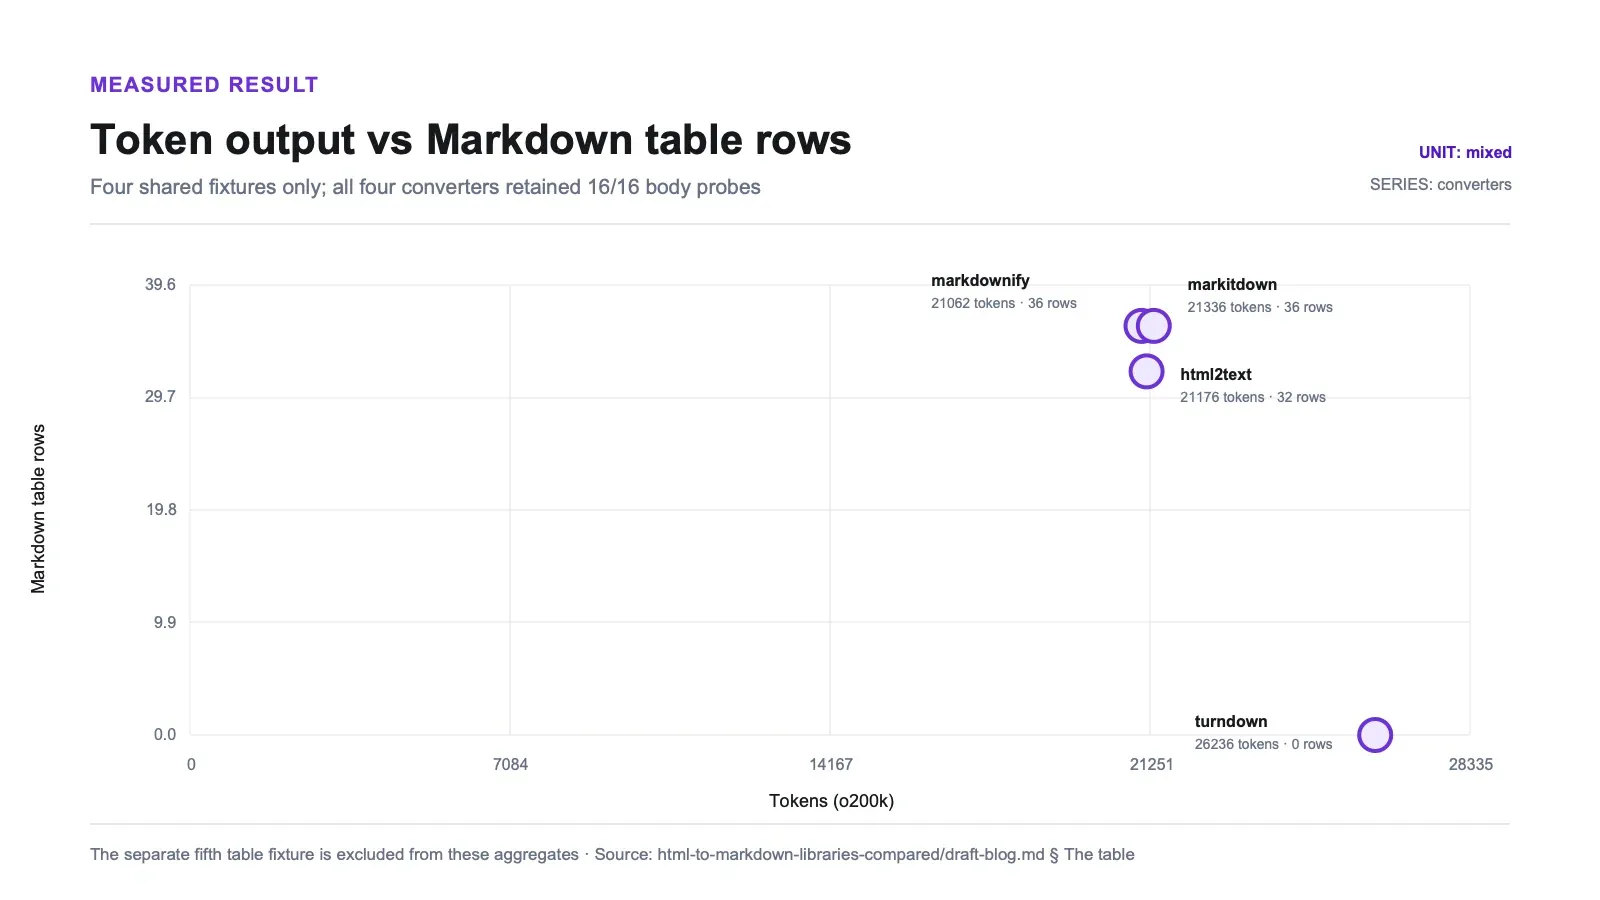
turndown là thư viện có nhiều sao GitHub nhất trong bốn thư viện được thử nghiệm tại thời điểm chụp dữ liệu metadata, với 11.386 sao. Trên bốn bộ HTML dùng chung, công cụ này tạo ra 0 bảng Markdown với cấu hình mặc định cốt lõi và dùng nhiều hơn 24,6% token so với markdownify khi xử lý cùng một đầu vào.
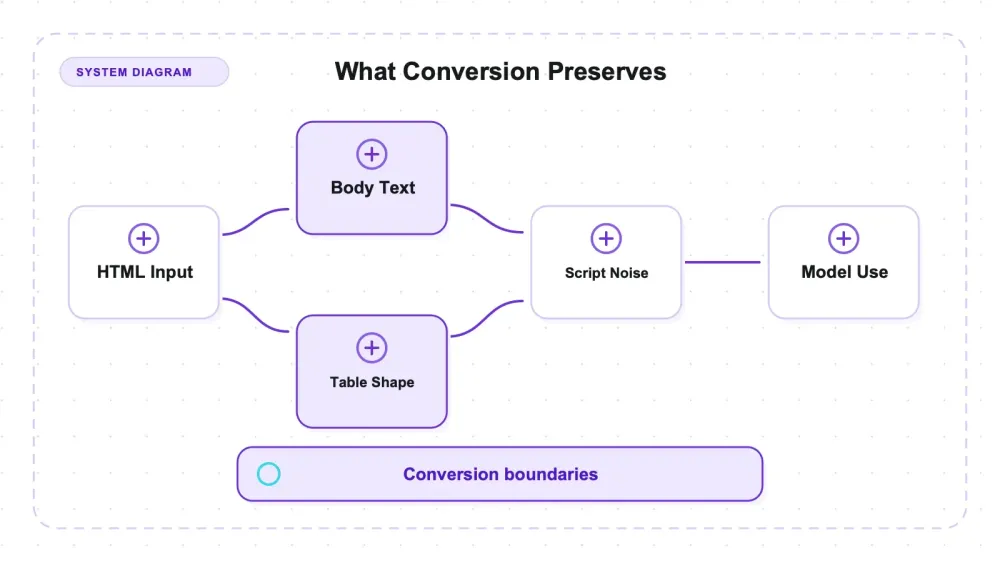
Cả bốn công cụ đều khôi phục được toàn bộ các probe nội dung. Khác biệt nằm hoàn toàn ở phần cấu trúc được giữ lại hay đánh mất, và cái giá của cấu trúc đó ở các bước xử lý tiếp theo.
Đã đo những gì, và trên bộ dữ liệu của ai
Bộ nghiên cứu này vốn đã có một gói thử nghiệm cho markitdown với năm tệp HTML và các chuỗi probe được đăng ký sẵn — các chuỗi chính xác được kiểm tra xem có còn tồn tại hay không, cùng các chuỗi boilerplate dùng để phát hiện phần chrome của trang. So sánh tổng hợp ở đây sử dụng bốn fixture dùng chung cho cả bốn bộ chuyển đổi: một danh mục hiệu sách, một trang trích dẫn, một bảng thống kê khúc côn cầu và bài viết Wikipedia về web scraping. Fixture thứ năm, Nothing but tables, chỉ được dùng như một bài kiểm tra chuyên sâu về bảng và không tính vào mức tổng hợp 24,6%.
Bốn công cụ gồm: turndown 7.2.4 (Node), markdownify 1.2.3, html2text 2025.4.15, và markitdown, trong đó các dòng số liệu đã công bố được dùng nguyên trạng. Các trang gồm: một danh mục hiệu sách, một trang trích dẫn, một bảng thống kê khúc côn cầu và bài viết Wikipedia về web scraping.
Mọi tên chỉ số bên dưới đều khớp đúng với trường artifact của markitdown theo từng cột, nên các hàng có thể đặt cạnh nhau mà không cần phải hòa giải hai định nghĩa khác nhau của cùng một thuật ngữ.
Bảng so sánh
| Bộ chuyển đổi | Probe phần thân | Số ký tự đầu ra | Token (o200k) | Byte/token | Số hàng bảng Markdown | Liên kết |
|---|---|---|---|---|---|---|
| turndown | 16/16 | 95,188 | 26,236 | 3.63 | 0 | 611 |
| markdownify | 16/16 | 76,868 | 21,062 | 3.65 | 36 | 599 |
| html2text | 16/16 | 76,452 | 21,176 | 3.61 | 32 | 545 |
| markitdown | 16/16 | 76,995 | 21,336 | 3.61 | 36 | 598 |
Bốn fixture — chính là những fixture mà markitdown cũng đã chạy. Số liệu đầy đủ theo từng fixture nằm trong fiveway-scores.json. Token được đếm bằng o200k_base; số hàng bảng của markitdown được đếm lại từ Markdown đã lưu của chính nó bằng cùng bộ đếm dùng cho các công cụ còn lại.
Khả năng giữ nguyên nội dung là hòa. Cả 16 probe nội dung trên bốn fixture đều được bốn công cụ giữ lại. Nếu câu hỏi duy nhất của bạn là "phần văn bản có đi qua được hay không", thì cả bốn đều trả lời là có.
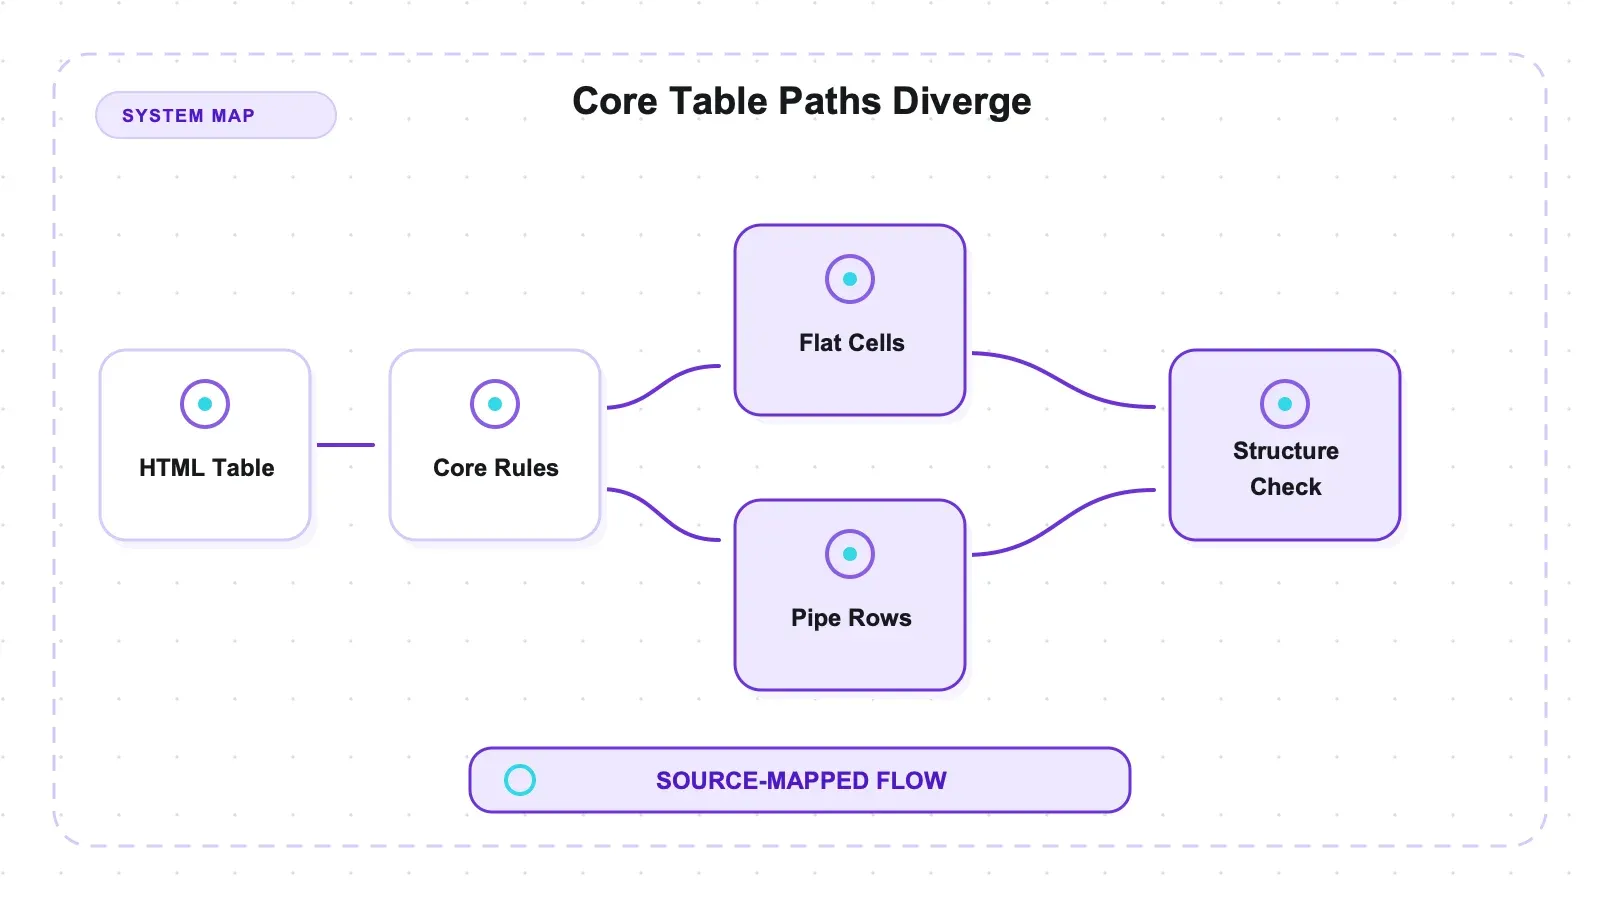
Cấu trúc thì không hòa. Trên bốn fixture dùng chung, markdownify và markitdown đều xuất ra 36 hàng bảng Markdown; html2text xuất ra 32; turndown không xuất ra hàng nào. Ở bài kiểm tra riêng chỉ có bảng, markdownify xuất 62 hàng và html2text 59; những hàng này không tính vào phần tổng hợp ở trên.
Chi phí token của turndown cao hơn 24,6%, và nguyên nhân không phải là do bảng. Tôi từng nghĩ vậy, nhưng số liệu theo từng fixture lại nói khác — xem bên dưới.
turndown làm gì với một bảng
Đây là fixture về thống kê khúc côn cầu, cùng một dữ liệu, hiển thị theo ba cách.
turndown:
Team Name

Year

Wins

Losses

Boston Bruins

1990

44

24
markdownify:
| Team Name | Year | Wins | Losses | ... |
| --- | --- | --- | --- | --- |
| Boston Bruins | 1990 | 44 | 24 | ... |
html2text:
Team Name  |  Year  |  Wins  |  Losses  | ...
---|---|---|---|---
Boston Bruins  |  1990  |  44  |  24  | ...
Mỗi giá trị đều được turndown giữ lại trong quá trình chuyển đổi, nên nó đạt 16/16 ở các probe. Nhưng điều không được giữ lại là giá trị đó thuộc về cột nào. Nhìn vào đầu ra của turndown, 44 chỉ còn là một con số nằm trên một dòng; bạn không thể suy ra đó là số trận thắng của Boston nếu không đếm vị trí và hy vọng không có ô nào trống. Trong fixture này, một số ô thực sự trống, nên cách đếm vị trí cũng không còn hiệu lực.
Với một mô hình đang đọc đầu ra, đó là khác biệt giữa một bảng có thể trả lời câu hỏi và một danh sách số liệu chỉ còn để đoán.
Đây không hẳn là lỗi, mà là một giới hạn đã được ghi nhận — phần lõi của turndown không xử lý bảng, và turndown-plugin-gfm tồn tại để bổ sung phần đó. Nhưng bản cài đặt mặc định không đi kèm plugin này, và con số 11.386 sao cho thấy rất nhiều người đang dùng bản mặc định.
Khoảng cách token thực sự đến từ đâu
Tôi đã viết đoạn trên với giả định rằng chênh lệch 24,6% token là do các bảng bị làm phẳng rồi tăng số ký tự. Nhưng khi xem theo từng fixture, hóa ra không phải.
| Fixture | turndown tokens ÷ markdownify tokens |
|---|---|
| Trang trích dẫn (không có bảng) | 0.99× |
| Danh mục hiệu sách | 1.06× |
| Thống kê khúc côn cầu (một bảng lớn) | 1.37× |
| Wikipedia (chủ yếu là văn xuôi, 9 hàng bảng) | 1.29× |
| Chỉ toàn bảng | 0.78× |
Ở fixture chỉ toàn bảng, turndown lại rẻ hơn 22% — vì khung pipe của Markdown cũng tốn token, mà turndown thì không tạo ra chúng. Chỉ riêng việc làm phẳng một bảng không phải là một khoản phạt token.
Fixture Wikipedia chiếm 74% tổng số liệu, và nó chỉ có 9 hàng bảng. Khoảng chênh 15.378 ký tự ở đó không thể là do bảng. Nguyên nhân là đây:
(function(){var className="client-js vector-feature-language-in-header-enabled…
.mw-parser-output cite.citation{font-style:inherit;word-wrap:break-word}…
(RLQ=window.RLQ||[]).push(function(){mw.config.set({"wgHostname":"mw-web…
turndown không loại bỏ nội dung bên trong <script> và <style>, trong khi markdownify và html2text đều có. Nếu đếm theo các marker chỉ xuất hiện trong các phần tử này, đầu ra của turndown chứa 10 marker script và 84 marker style trên toàn bộ fixture; hai công cụ còn lại đều bằng 0. Trên trang Wikipedia, 8 dòng JavaScript cấu hình và CSS nội tuyến của MediaWiki chiếm 14.644 ký tự — 95% toàn bộ phần chênh lệch (script-style-stripping.json).
Đó mới là phát hiện mà tôi thực sự sẽ hành động dựa trên. Một bảng bị làm phẳng là vấn đề cấu trúc mà bạn có thể nhìn thấy. Nhưng một khối JavaScript cấu hình bị lẫn trong Markdown thì chỉ là chi phí thuần túy, không mang thêm thông tin nào, và trên một trang thực tế nó lấn át mọi thứ khác trong phép so sánh này.
html2text có viết bảng, chỉ là bạn có thể không nhận ra
html2text đạt 32 hàng, trong khi markdownify và markitdown đạt 36, và phiên bản đầu của bộ đếm của tôi chỉ cho nó 1.
Đó là do quy tắc đếm của tôi, không phải do thư viện. html2text xuất ra Team Name | Year | Wins mà không có pipe đầu và cuối — đây là một dạng bảng Markdown phổ biến, nhưng lại vô hình với regex yêu cầu ^\|.*\|$. Tôi đã viết regex đó, chạy nó, rồi suýt báo rằng html2text không hỗ trợ bảng.
Thực ra thì có. Bộ đếm đã được sửa dùng một heuristic: một chuỗi các dòng có pipe liên tiếp, bên trong có một dòng phân tách. Với quy tắc đó, html2text tăng từ 1 lên 32. Đây không phải là một trình phân tích Markdown đầy đủ, nên các tổng số hàng chỉ nên được hiểu như số đo theo một bộ đếm đã mô tả rõ ràng, chứ không phải kết quả render phổ quát.
Điều đáng nhớ nếu bạn hậu xử lý Markdown bằng regex riêng: trong bốn thư viện này, có hai thư viện xuất ra pipe ở đầu/cuối dòng và một thư viện thì không.
Chi tiết về giấy phép mà ít ai nhắc tới
| Bộ chuyển đổi | Giấy phép | Cài đặt | Lần import đầu tiên | Số sao | Phát hành gần nhất |
|---|---|---|---|---|---|
| turndown | MIT | 3 gói npm, 8,8 MiB | 0,056 s | 11.386 | 2026-04-03 |
| markdownify | MIT | 5 gói, 1,8 MiB | 0,046 s | 2.235 | 2026-06-30 |
| html2text | GPL-3.0-or-later | 1 gói, 0,2 MiB | 0,077 s | 2.168 | 2025-04-15 |
| markitdown | Xem metadata của gói | Không đo trong lần cài đặt này | Không đo | — | — |
install-and-import.json. Mỗi thư viện được cài vào một môi trường trống riêng. Giấy phép được xác nhận từ ba nguồn: metadata của registry, repo GitHub, và tệp METADATA của chính gói đã cài, trong đó ghi License-Expression: GPL-3.0-or-later.
Thư viện nhẹ nhất trong so sánh cài đặt này — 1 gói, 0,2 MiB — lại là GPL-3.0-or-later. Điều đó có ảnh hưởng tới dự án hay không còn tùy cách phần mềm được kết hợp và phân phối. Hãy xem đây như một điểm kiểm tra lựa chọn cho người phụ trách giấy phép; bài viết này không phải tư vấn pháp lý. markitdown được hiển thị là chưa đo ở đây vì quá trình cài đặt và giấy phép của nó không được ghi lại trong artifact này.
Sự đánh đổi đó rất dễ bị bỏ qua vì giấy phép là thuộc tính duy nhất không hiện ra trong một benchmark.
Cả ba đều nhẹ hơn rất nhiều so với các thư viện trích xuất bài viết trong cùng nhóm — những thư viện đó nặng từ 21 đến 70 MiB. Một bộ chuyển đổi là thứ nhỏ hơn nhiều so với một bộ trích xuất, và đáng được tách riêng trong ngân sách phụ thuộc của bạn.
Hai yếu tố gây nhiễu tôi phải sửa trước khi bảng này đúng
Các con số ở trên là phiên bản thứ ba. Hai phiên bản đầu sai theo những cách đáng để chỉ ra, vì đều rất dễ lặp lại.
Năm fixture so với bốn. markitdown chỉ chạy bốn trong số năm tệp này; ba công cụ còn lại chạy đủ cả năm. Cộng dồn mỗi công cụ trên tập riêng của nó khiến markdownify có 98 hàng bảng so với 36 của markitdown, làm như thể có khoảng cách về năng lực. Nhưng nếu so trên cùng bốn fixture, kết quả là 36 so với 36 — hòa hoàn toàn. Fixture thứ năm lại chính là fixture nhiều bảng nhất, nên yếu tố nhiễu này đi theo hướng tệ nhất có thể, đẩy các công cụ mới lên cao gần gấp ba lần so với công cụ đã có.
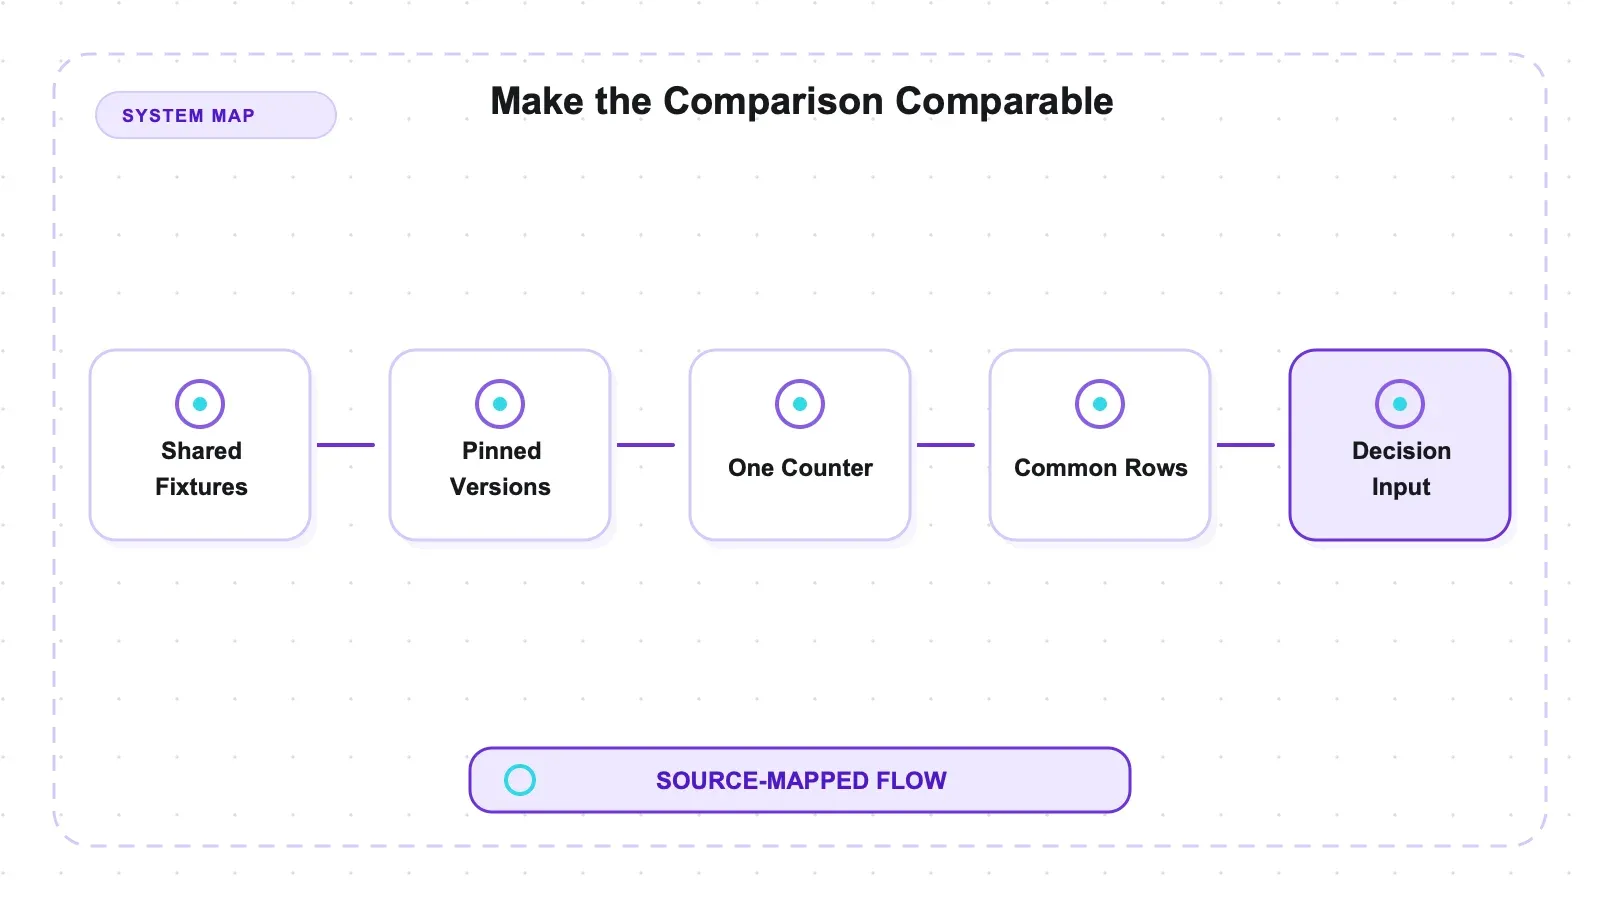
Hai bộ đếm, một cột. số md_table_rows đã công bố của markitdown đến từ mã nguồn của chính nó, thứ mà tôi chưa đọc. So sánh con số đó với bộ đếm của tôi có thể chỉ là so hai bộ đếm khác nhau chứ không phải so hai bộ chuyển đổi. Đầu ra Markdown của nó được lưu trên đĩa, nên cách sửa là chạy một bộ đếm duy nhất lên cả bốn công cụ — và khi làm vậy, số đếm lại của markitdown khớp chính xác với con số đã công bố theo từng fixture (0, 0, 27, 9). Các định nghĩa là nhất quán; chỉ là tôi không thể biết điều đó nếu không kiểm tra.
Cả hai sai sót này đều không thể nhìn thấy chỉ qua đầu ra. Nhưng cả hai đều có thể tạo ra một bảng sai một cách rất tự tin.
Nên dùng công cụ nào
Đầu ra cho mô hình, hoặc lưu nội dung có cấu trúc từ những trang như thế này? Hãy bắt đầu với markdownify. Nó hòa với markitdown về số hàng bảng đầu ra theo bộ đếm chung này, nằm trong nhóm token thấp nhất, dùng giấy phép MIT, và chỉ cài chiếm 1,8 MiB. Hãy tự kiểm tra trên kiểu trang của bạn trước khi chuẩn hóa.
Ngân sách phụ thuộc tính bằng kilobyte, và bạn không phân phối phần mềm? Dùng html2text. Một gói, 0,2 MiB, bảng vẫn nguyên vẹn. Kiểm tra câu chuyện GPL trước, và lưu ý bản phát hành gần nhất là tháng 4 năm 2025.
Bạn đã ở trong hệ Node rồi? Dùng turndown kèm turndown-plugin-gfm — và nhớ loại bỏ <script> cùng <style> khỏi HTML trước khi đưa vào, vì turndown sẽ không làm chuyện đó. Hai thiếu sót này làm tăng thêm một phần tư token và phá luôn cấu trúc bảng, mà bạn sẽ không thấy nếu không nhìn vào đầu ra.
Bạn vốn đã chuyển đổi các định dạng tài liệu khác? markitdown xử lý PDF, Office và nhiều loại khác nữa, và đầu ra HTML của nó cạnh tranh tốt với các công cụ chuyên dụng. Chỉ cần một phụ thuộc thay vì hai cũng đã là một lợi thế.
Khi nào một API được quản lý là phù hợp
Cả bốn công cụ này đều chỉ xử lý HTML mà bạn đã có sẵn. Chúng không tự đi lấy trang, không render JavaScript, và không xử lý lớp anti-bot — trong khi với nhiều mục tiêu thực tế, đó mới là nửa khó hơn.
Bộ công cụ dành cho developer của chúng tôi tại Thunderbit giải quyết phần đó. POST /distill nhận một URL và trả về Markdown sạch, sẵn cho LLM, với phần render và fetch đã được xử lý; POST /extract trả về JSON có cấu trúc khớp theo schema AI dựa trên JSON Schema bạn cung cấp, tức là một dạng đầu ra khác hẳn — các hàng dữ liệu thay vì một bảng Markdown rồi bạn phải tự phân tích tiếp. Cả hai đều có thể truy cập từ MCP server và CLI (npx @thunderbit/thunderbit-cli). Giá được công bố trên trang pricing của Thunderbit.
So sánh thẳng thắn: nếu bạn đã có HTML và chỉ cần Markdown, markdownify là miễn phí và làm việc rất tốt, còn bảng này cho bạn biết các đối thủ nào của nó cũng làm được như vậy. Nếu bạn phải tự lấy trang, hoặc bạn cần hàng dữ liệu có cấu trúc thay vì văn xuôi, thì đó là một khoản mua khác.
Để nhìn rộng hơn, tổng hợp các API web scraping của chúng tôi bao quát các lựa chọn hosted, còn bài trụ cột về open-source scraper bao quát các công cụ tự host. Chuyển HTML sang Markdown trong Python là phần hướng dẫn thực hành, còn llms.txt đang cố tiêu chuẩn hóa điều gì nói về hướng đi của cả lĩnh vực này.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Với khối lượng công việc gồm bốn fixture này, markdownify là lựa chọn mặc định mạnh nhất: cùng số hàng bảng đầu ra với markitdown theo bộ đếm chung, số token nằm trong phạm vi 1,3% so với các công cụ hiệu quả khác, giấy phép MIT, và cài chỉ chiếm 1,8 MiB.
Khoảng cách giữa mức độ phổ biến và hành vi đo được mới là phát hiện chính. turndown là một thư viện rất tốt nhưng có quá nhiều người cài mà không có plugin để xử lý bảng, và cái giá của việc đó là thêm một phần tư token cùng với cấu trúc bảng biến mất hoàn toàn. Không có con số nào trong số này xuất hiện nếu bạn không tự đếm.
Nếu chỉ lấy một điều: hãy kiểm tra bộ chuyển đổi của bạn làm gì với bảng trước khi tin đầu ra của nó cho một mô hình. Ba trong bốn công cụ này làm điều hợp lý. Công cụ phổ biến nhất thì không, trừ khi bạn đã yêu cầu nó làm vậy.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Turndown thực sự không hỗ trợ bảng sao?
Phần lõi của nó thì không. Bảng được cung cấp bởi turndown-plugin-gfm, một gói riêng biệt, và npm install turndown thông thường không bao gồm plugin này. Nếu không có plugin, mọi ô sẽ được giữ lại như các đoạn riêng lẻ — dữ liệu vẫn còn, nhưng quan hệ hàng và cột thì không. Trên bốn fixture, điều đó tạo ra 0 hàng bảng Markdown và nhiều hơn 24,6% token so với markdownify khi xử lý cùng nội dung.
Vì sao ban đầu html2text trông như không có bảng?
Vì bộ đếm của tôi yêu cầu pipe ở đầu và cuối dòng, trong khi html2text không xuất ra kiểu đó. Team Name | Year | Wins là Markdown hợp lệ và render đúng; nó chỉ là một phong cách khác so với | Team Name | Year |. Bộ đếm đã được sửa sẽ tìm một chuỗi dòng có pipe với một dòng phân tách ở giữa, giống như một trình phân tích, và html2text tăng từ 1 hàng lên 32. Nếu bạn hậu xử lý Markdown bằng regex riêng, đây chính là khác biệt sẽ làm bạn vấp.
GPL của html2text có phải là vấn đề thật không?
Còn tùy bạn kết hợp và phân phối phần mềm như thế nào. GPL-3.0-or-later có thể kéo theo nghĩa vụ mà MIT không có, nên hãy trao đổi với người phụ trách giấy phép trước khi chọn nó cho một sản phẩm có phân phối. Đây là điểm kiểm tra tuân thủ, không phải tư vấn pháp lý; danh tính giấy phép đã được xác nhận trong metadata của registry, repo, và tệp METADATA của gói đã cài.
Các số token này có ý nghĩa với những trang khác không?
Khoảng cách 24,6% chủ yếu đến từ việc turndown giữ lại nội dung <script> và <style>, nên nó sẽ thay đổi theo lượng nội dung kiểu này trên trang — rất nhiều trên một trang CMS hiện đại, gần như bằng không trên một trang tĩnh. Bảng kéo nó theo hướng ngược lại: ở fixture chỉ toàn bảng, turndown lại rẻ hơn 22%, vì nó không tạo khung pipe. Byte/token nằm trong khoảng 3.61 đến 3.65 cho cả bốn công cụ, nên mật độ đầu ra là như nhau và khác biệt nằm ở số lượng. Nếu con số này ảnh hưởng tới ngân sách, hãy đo trên chính corpus của bạn.
Những gì chưa được kiểm tra ở đây là gì?
Sự đa dạng trong thế giới thực — bốn fixture vẫn chỉ là bốn fixture. Danh sách lồng nhau, danh sách định nghĩa, chú thích chân trang và công thức toán. HTML lỗi, vốn là nơi các bộ chuyển đổi thường khác nhau nhiều nhất. Việc chuyển Markdown ngược lại HTML. docling, vốn cũng có cùng bộ fixture trên đĩa nhưng báo cáo chạy công khai của nó không cung cấp các trường này, nên nó bị bỏ qua thay vì ước lượng. Và cấu hình: html2text được chạy với body_width=0 vì mặc định 78 sẽ tự ngắt dòng cứng mọi dòng, điều đó đã làm thay đổi mọi ký tự và mọi số token trong bảng này.




