
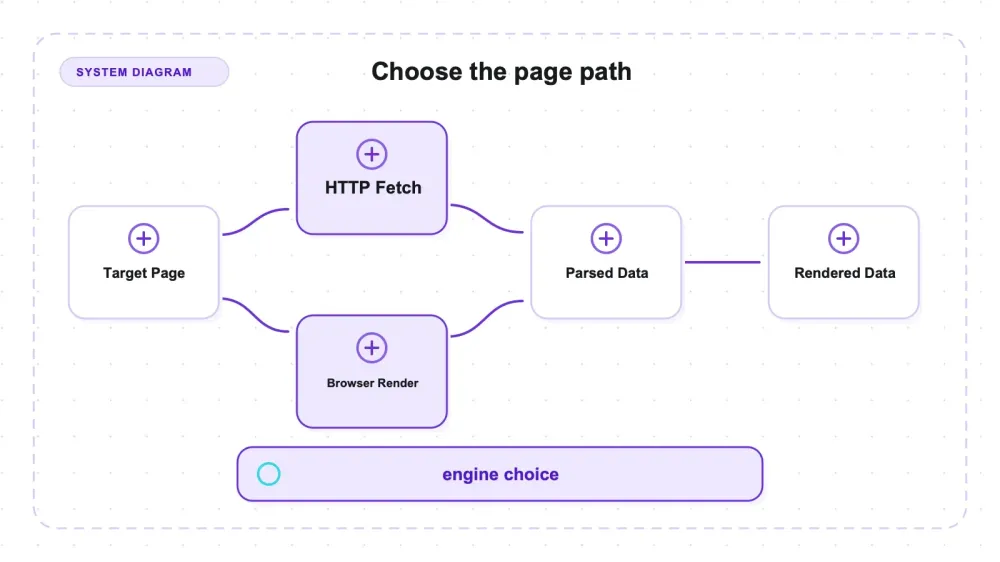
Điểm khiến Crawlee trở nên hữu ích là cơ chế điều phối crawl của nó hỗ trợ cả phân tích HTTP lẫn chạy trình duyệt. Vì vậy, cùng một URL có thể cho ra kết quả khác nhau tùy vào crawler được chọn và trạng thái sẵn sàng của trang.
Trên trang công khai Quotes to Scrape JS, CheerioCrawler tìm thấy 0 quote mục tiêu, trong khi PlaywrightCrawler tìm thấy 10 sau khi chờ .quote. Luồng vòng đời crawl thì khá giống nhau, nhưng đây hoàn toàn không phải kiểu đổi một dòng rồi chuyển từ class này sang class kia: handler của Cheerio dùng $, còn handler của Playwright dùng page, với cơ chế chờ rõ ràng và trích xuất ngay trong trình duyệt.
Crawlee thực sự là gì
Crawlee (dự án apify/crawlee, phiên bản 3.17.0) là một thư viện web scraping và tự động hóa trình duyệt dành cho Node.js và TypeScript. Nó hỗ trợ crawl qua HTTP với Cheerio hoặc JSDOM, và crawl bằng trình duyệt với Playwright hoặc Puppeteer. Dự án dùng giấy phép Apache-2.0; hãy xem kỹ các yêu cầu thông báo và ghi nhận nguồn nếu bạn phân phối lại.
Điều quan trọng về mặt tư duy là tách “lấy trang” ra khỏi “đọc trang”. Một hướng sẽ tải HTML thô và không chạy JavaScript. Hướng còn lại khởi chạy Chromium và có thể thực thi script của trang, nhưng vẫn cần một điều kiện sẵn sàng phù hợp, đồng thời vẫn có thể bỏ sót nội dung phụ thuộc tương tác, tải trễ, shadow DOM, lỗi API, hoặc bị chặn bởi bot. Crawlee cung cấp các khái niệm vòng đời tương ứng cho cả hai hướng này, chứ không phải những primitive DOM có thể thay thế trực tiếp cho nhau.
Đó là phần đáng hiểu trước khi bạn viết bất kỳ selector nào, vì việc chọn giữa hai engine sẽ quyết định scraper của bạn có trả về dữ liệu hay không trên một website cụ thể.
Tính năng chính: hai engine, một bề mặt API
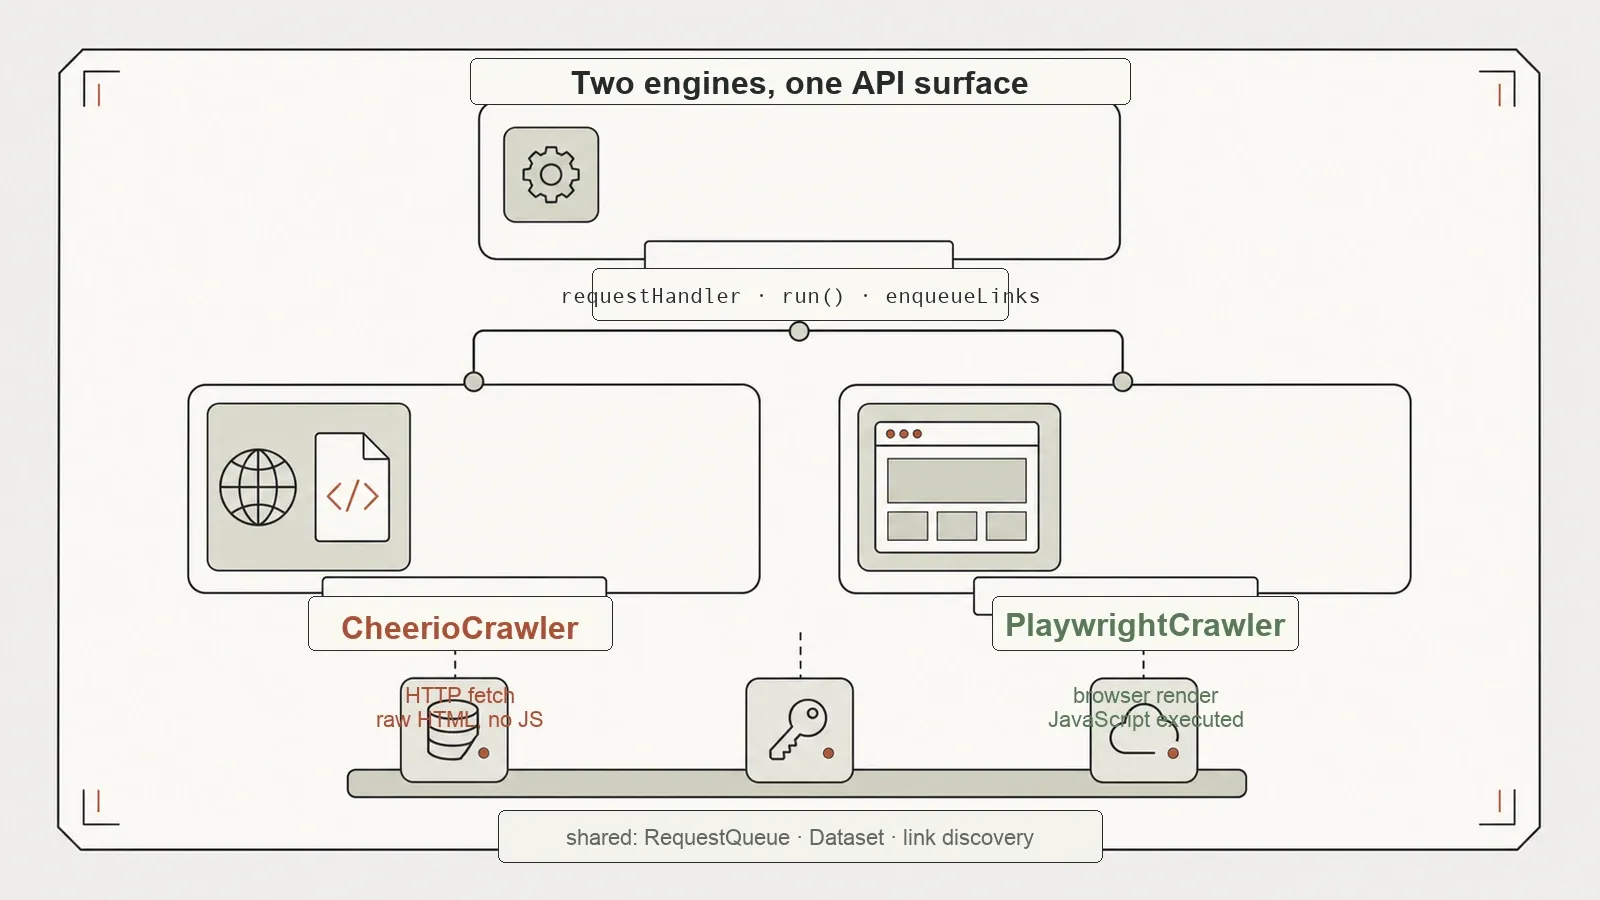
CheerioCrawler lấy HTML và phân tích bằng Cheerio; PlaywrightCrawler điều khiển Chromium và có thể chụp ảnh màn hình. Cả hai đều dùng requestHandler, đều có run(), và chia sẻ các khái niệm crawl như hàng đợi và khám phá liên kết. Tuy vậy, ngữ cảnh handler thì khác nhau: đường Cheerio được kiểm thử trích xuất bằng $, còn đường trình duyệt dùng page, waitForSelector và $$eval. Phần quản lý hàng đợi và vòng đời có thể giữ nguyên cách dùng quen thuộc, nhưng code trích xuất có thể cần adapter hoặc viết lại.
Ẩn bên dưới đó, Crawlee cung cấp phần “hạ tầng” mà một crawl thực sự cần. RequestQueue quản lý biên giới các URL cần ghé thăm, khử trùng lặp và theo dõi những gì đã làm xong. enqueueLinks phát hiện và thêm các URL mới vào hàng đợi (có thể lọc theo selector và theo hostname) để crawl có thể tự mở rộng. Dataset gom các bản ghi đã scrape để xuất ra sau đó. Mặc định, Crawlee lưu toàn bộ dữ liệu này vào thư mục cục bộ storage/ trên đĩa — tiện khi muốn resume, nhưng cũng hơi phiền nếu lần đầu bạn thấy một thư mục storage/ không hề yêu cầu xuất hiện trong project của mình (bộ test của tôi đã chuyển nó sang thư mục tạm và tắt persistence để giữ môi trường sạch).
Bản thân từng thành phần thì không có gì quá đặc biệt. Điều đáng nói là chúng được dùng chung giữa cả hai engine, nên queue, link discovery và dataset đều hoạt động giống nhau dù bạn crawl qua HTTP hay qua trình duyệt. Bạn học một API nhưng đổi lại có hai chiến lược lấy dữ liệu.
Cài đặt: trình duyệt phải cài riêng
Bản cài đặt được kiểm thử không đi kèm sẵn file thực thi Chromium sau khi cài package.
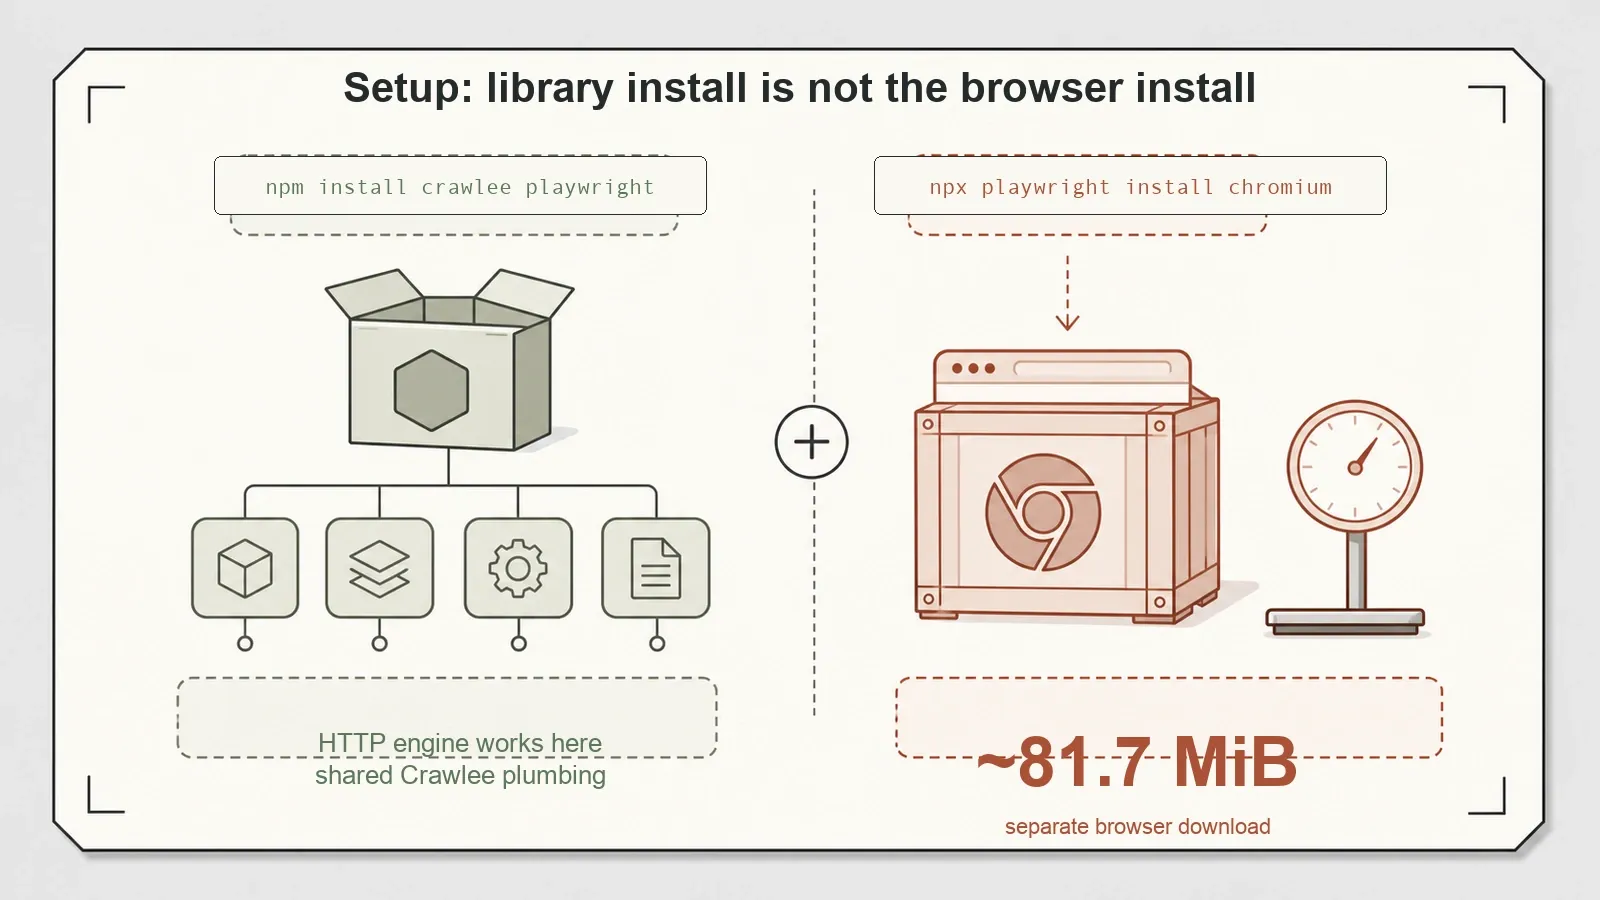
npm install crawlee playwright cài đặt trơn tru trên máy tôi — 85 package, 0 lỗ hổng, không có gì đáng ngại. Nếu dừng ở đó và chạy CheerioCrawler, mọi thứ vẫn hoạt động, vì crawl HTTP không cần trình duyệt.
Trong môi trường này, Chromium phải được cài riêng bằng npx playwright install chromium; nếu không, PlaywrightCrawler sẽ không khởi chạy được. Payload trình duyệt quan sát được vào khoảng 82 MiB, nhưng ghi chú gốc không lưu rõ đó là dung lượng tải xuống hay dung lượng trên đĩa. Đây là một quan sát cài đặt phụ thuộc máy, không phải đặc tính cố định của sản phẩm. Đường dẫn tài liệu và hành vi package có thể thay đổi, nên bài viết này không khẳng định việc thiếu sót đó là phổ quát hay vĩnh viễn không có tài liệu.
Hãy xem setup được kiểm thử như hai bước: cài Node packages, rồi cài trình duyệt mà đường Playwright sử dụng. Nên kiểm tra lại hướng dẫn cài đặt Crawlee và Playwright hiện hành theo đúng phiên bản và nền tảng bạn triển khai.
Thực hành: cùng một trang, hai đáp án rất khác nhau
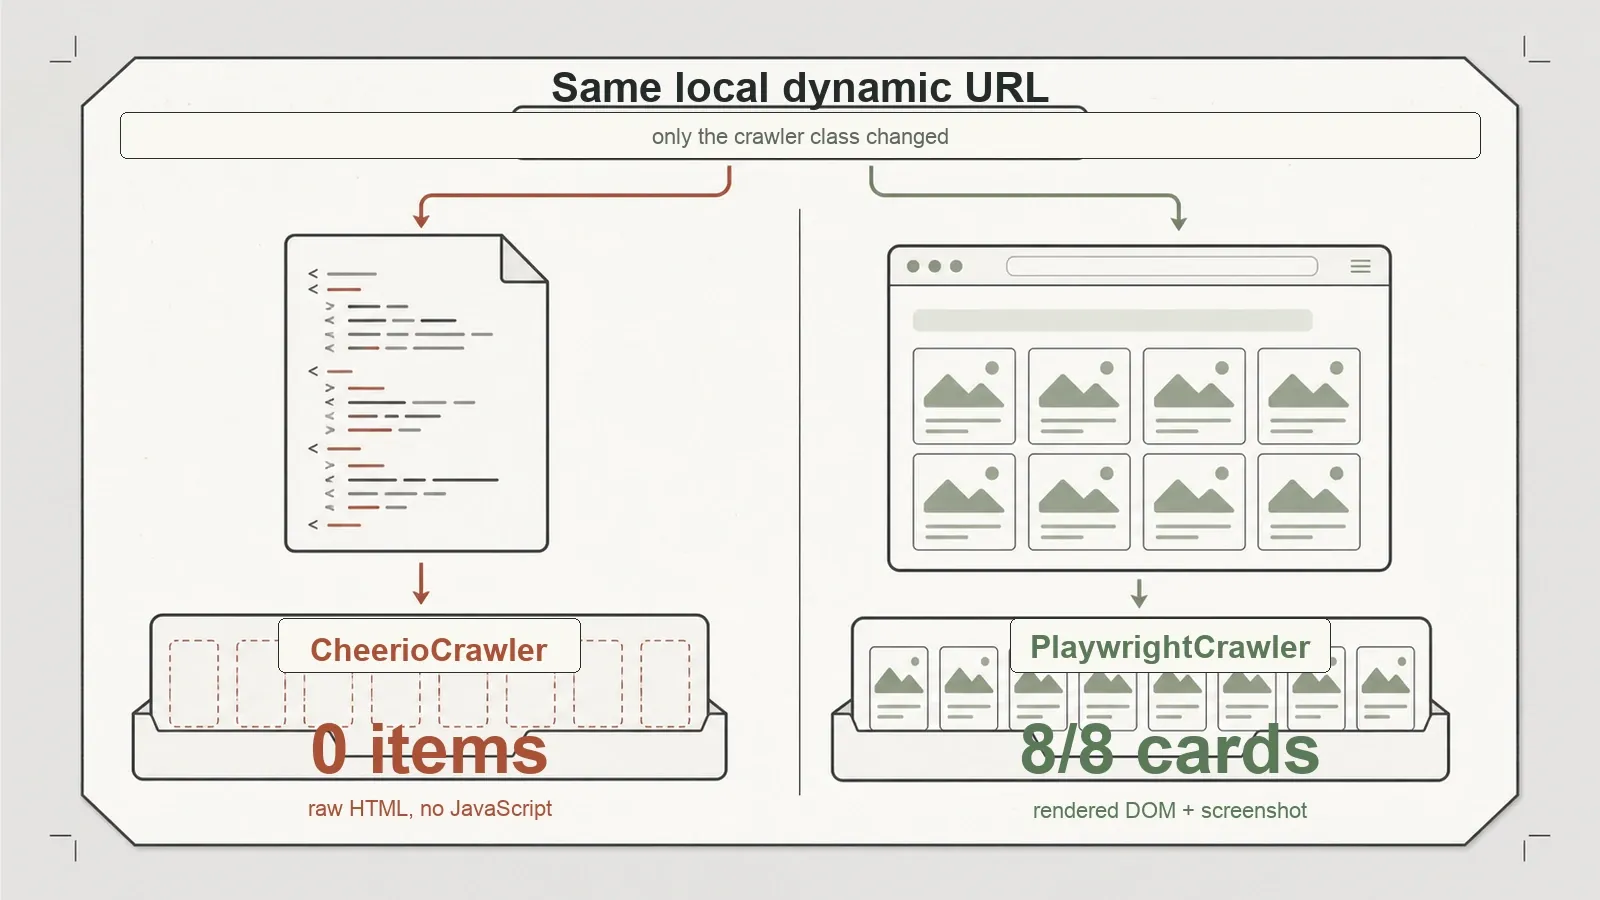
Bài test cốt lõi đã đưa cùng một fixture render bằng JavaScript qua cả hai crawler. URL và các trường mục tiêu là giống nhau; primitive trích xuất thì không.
Trên fixture local, CheerioCrawler trả về 0 thẻ sản phẩm mục tiêu vì chúng không có trong HTML thô. PlaywrightCrawler chờ #dynamic-products article.product-card, rồi trả về đủ 8 thẻ như mong đợi và chụp màn hình. Kết quả này xác nhận mức độ đầy đủ của fixture đối với các trường đã chọn sau khi chờ điều kiện đó; nó không có nghĩa là trình duyệt luôn nhìn thấy mọi trạng thái trang có thể có. File gốc và ảnh chụp màn hình nằm trong repo benchmark.
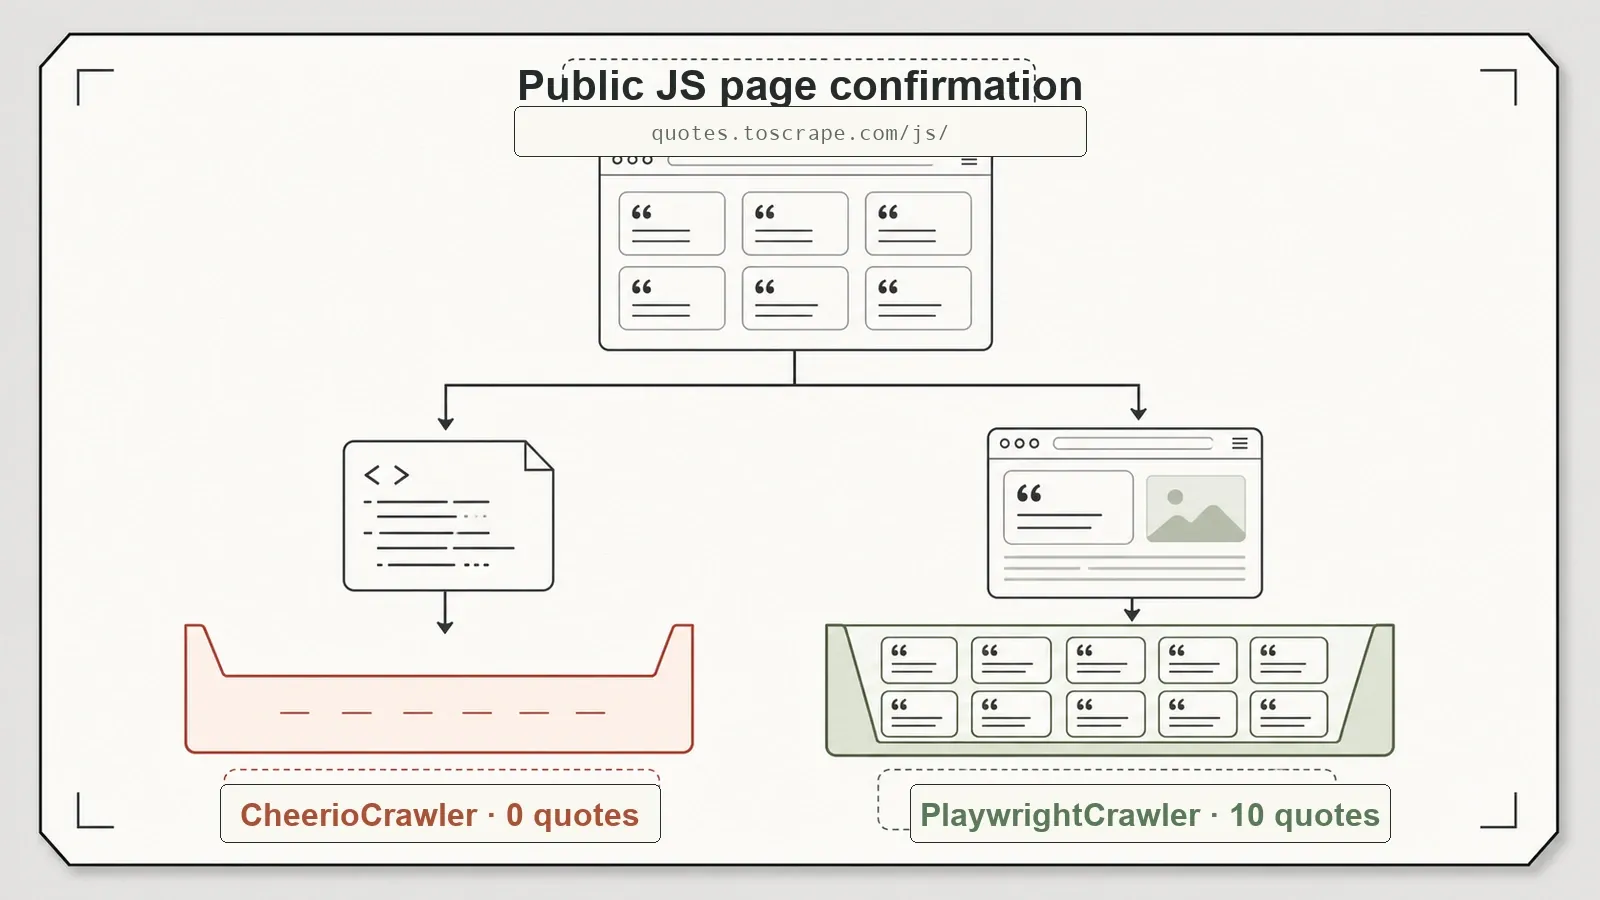
Trên trang công khai Quotes to Scrape JS, CheerioCrawler tìm thấy 0 quote mục tiêu, còn PlaywrightCrawler chờ .quote rồi trích xuất được 10. Điều này xác nhận ranh giới HTTP so với trình duyệt trên một mục tiêu công khai, trong khi class crawler, ngữ cảnh handler, điều kiện chờ và primitive trích xuất đều khác giữa hai nhánh.
Kết luận hữu ích ở đây nên hẹp hơn: hãy kiểm tra các trường bắt buộc ngay sau đường HTTP, và chỉ chuyển sang browser crawler khi phản hồi thô không có chúng. Handler của trình duyệt cũng phải chờ một điều kiện gắn với chính những trường đó.
Đường HTTP đã trả về đầy đủ bản ghi mong đợi trên các fixture catalog và article tĩnh có kiểm soát, giải mã đủ 8 mục từ một phản hồi JSON trực tiếp, duyệt một đồ thị giới hạn 11 trang, và chuyển một phản hồi 500 sang failedRequestHandler. Đây là các phép kiểm tra năng lực riêng biệt, không phải một con số độ chính xác duy nhất. Trên trang công khai Books to Scrape, selector đã cấu hình trả về 20 sản phẩm như một kiểm tra nhanh.
| Kiểm tra | Engine | Kết quả |
|---|---|---|
| Trích xuất tĩnh: catalog + phân trang | CheerioCrawler | 12/12 sản phẩm mong đợi |
| Trích xuất bài viết | CheerioCrawler | title + 3/3 đoạn văn |
| Truyền tải: phản hồi JSON trực tiếp | CheerioCrawler | 8/8 sản phẩm mong đợi |
| Duyệt: đồ thị liên kết nội bộ | CheerioCrawler | 11 trang, độ sâu {0:1, 1:3, 2:7} |
| Xử lý lỗi: HTTP 500 | CheerioCrawler | trạng thái được chuyển tới failure handler |
| Render: fixture local | CheerioCrawler | 0 thẻ mục tiêu trong HTML thô |
| Render: fixture local | PlaywrightCrawler | 8/8 sau khi chờ target-selector |
| Render: Quotes JS | CheerioCrawler | 0 quote mục tiêu trong HTML thô |
| Render: Quotes JS | PlaywrightCrawler | 10 sau khi chờ target-selector |
Thời gian chạy đầy đủ và số liệu từng bài test nằm trong results/crawlee-test-summary.json.
Bây giờ là các lưu ý cần nói thẳng, vì một lần chạy trên một máy duy nhất luôn có giới hạn và tôi không định tô hồng điều đó. Đây là số đo thời gian chạy, không phải benchmark chuẩn hóa — một máy, mỗi test một lần, nên hãy xem chi phí mỗi trang của browser path là “chậm hơn đáng kể so với các lượt Cheerio dưới một giây”, chứ không phải một con số công bố chính thức. Và còn một loạt thứ tôi không kiểm tra trong lượt này: xoay proxy, session pool, chạy quy mô lớn hàng trăm đến hàng nghìn trang, persistence và resume của RequestQueue sau khi crash, engine Puppeteer, cũng như trải nghiệm xuất dữ liệu của Dataset/KeyValueStore (ở đây tôi tự viết export thủ công). Tôi có thể xác nhận câu chuyện hai engine và độ chính xác ở cấp fixture. Tôi không thể xác nhận quy mô lớn hay khả năng chống chặn, nên tôi sẽ không nói như thể đã làm được.
Phần nào dùng chung, phần nào phải thay đổi
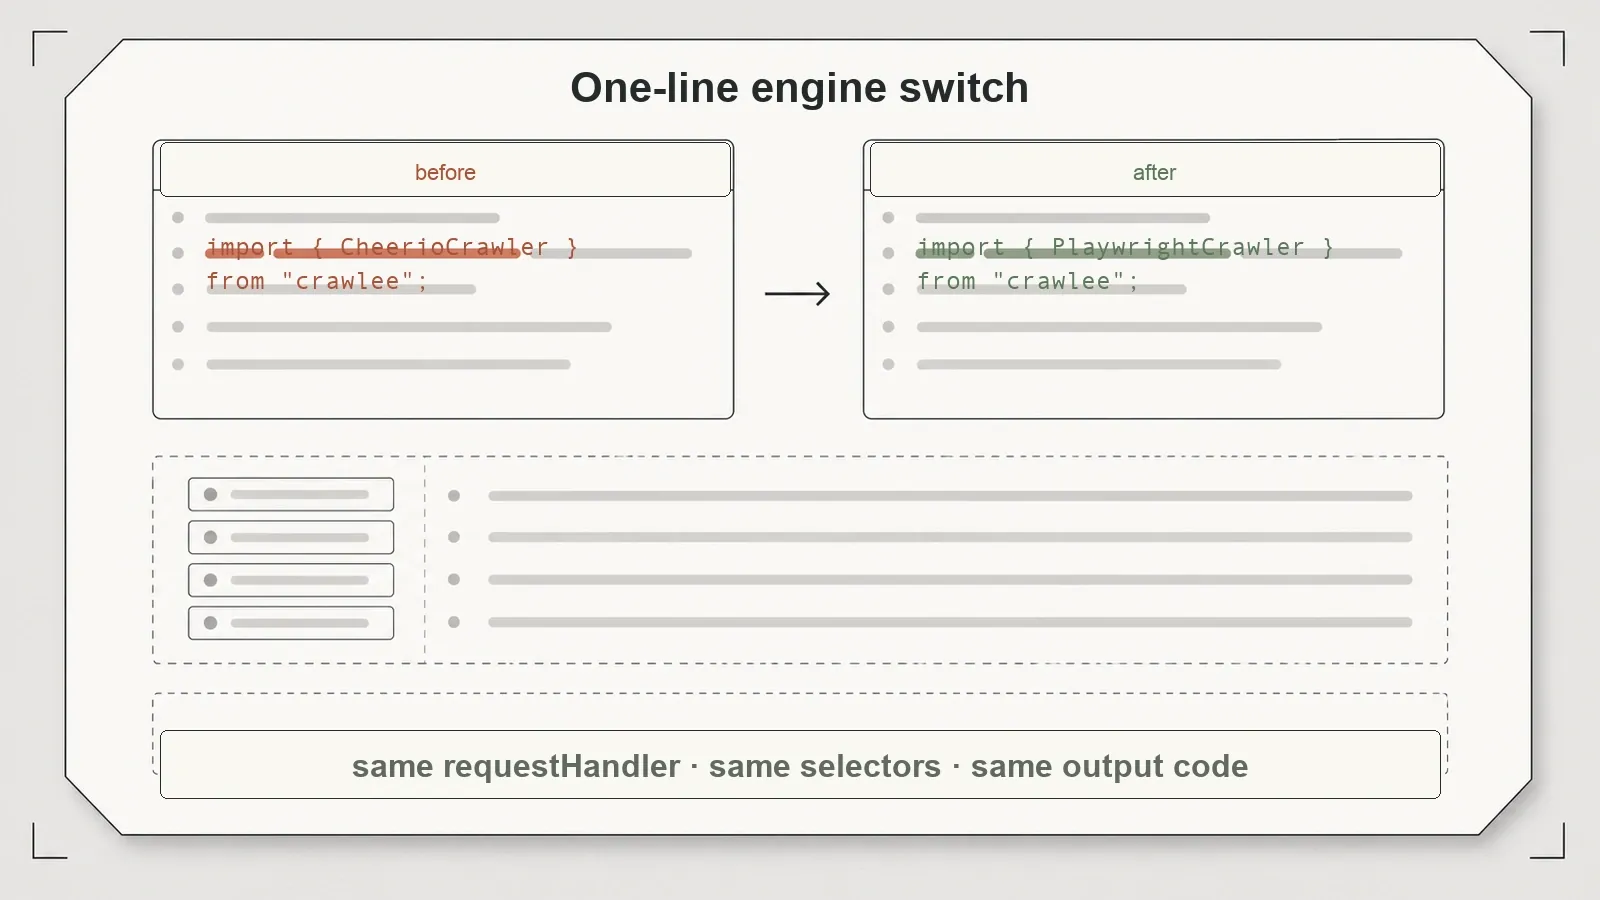
Bề mặt chung là điều phối crawl. Cả hai class crawler đều nhận requestHandler và đều có run(). Queue, metadata của request, khám phá liên kết, hook xử lý lỗi và các khái niệm lưu trữ có thể được tổ chức nhất quán quanh cả hai đường thực thi. Điều đó giúp đội ngũ giảm bớt phần hạ tầng phải học lại khi một target mới cần dùng trình duyệt.
Bề mặt truy cập trang thì không dùng chung. Handler của CheerioCrawler nhận access kiểu Cheerio như $ và có thể làm việc với nội dung phản hồi mà không cần trình duyệt. Handler của PlaywrightCrawler trong bài test này nhận page; nó chờ selector và evaluate trên DOM của trình duyệt. Dù cả hai handler có thể xuất cùng một schema bản ghi, chúng vẫn đi tới kết quả đó thông qua API khác nhau. Một adapter tái sử dụng có thể che bớt sự khác biệt này, nhưng bộ test ở đây không triển khai hay chứng minh điều đó.
Sự khác biệt này rất quan trọng cho việc ước lượng. Đổi class crawler có thể giữ nguyên queue, dataset và chính sách URL, nhưng selector, kiểm tra độ sẵn sàng, ảnh chụp màn hình, bước tương tác và xử lý lỗi vẫn có thể phải đổi. Vì vậy, bài viết này xem “hạ tầng crawl dùng chung” là lợi ích đã được kiểm chứng và không chấp nhận lời hứa “chỉ cần một dòng là migrate xong” nếu không có bằng chứng.
Một quy trình chọn engine thực tế
Hãy ưu tiên đường HTTP khi HTML trả về hoặc JSON trực tiếp đã chứa đủ trường cần thiết. Hãy định nghĩa một hợp đồng đầy đủ — key bắt buộc, số lượng item tối thiểu, hoặc target selector — và báo lỗi rõ ràng khi không đạt. Một mảng rỗng không có nghĩa là trang không có dữ liệu; trong hai trường hợp JavaScript ở đây, nó chỉ có nghĩa là representation được chọn không chứa phần tử mục tiêu.
| Điều kiện mục tiêu | Bắt đầu với | Chuyển sang khi |
|---|---|---|
| Trường bắt buộc có sẵn trong HTML trả về | CheerioCrawler | Selector hoặc trường bắt buộc bị thiếu |
| Một phản hồi JSON có thể tái lập đang chứa dữ liệu | CheerioCrawler | Request phụ thuộc vào trạng thái chỉ có trong trình duyệt |
| Trang chèn phần tử mục tiêu sau khi chạy script | PlaywrightCrawler | Không áp dụng; hãy định nghĩa readiness check riêng cho mục tiêu |
| Chưa biết loại target | HTTP trước, kèm kiểm tra đầy đủ | Kiểm tra thất bại với kết quả typed “representation incomplete” |
Khi thực thi là cần thiết, hãy chuyển lỗi typed đó sang browser handler. Trong bộ test này, trang local chờ #dynamic-products article.product-card, còn trang quotes công khai chờ .quote. Những điều kiện đó là một phần của hợp đồng trích xuất. Một load event chung chung sẽ không chứng minh dữ liệu ứng dụng đã tới, và bài test này cũng không ủng hộ một quy tắc chờ áp dụng cho mọi trường hợp.
Sau khi chuyển sang browser, hãy giữ schema đầu ra ổn định dù primitive DOM khác nhau. Ghi lại engine nào tạo ra kết quả, điều kiện sẵn sàng nào đã qua, và việc xác thực trường bắt buộc có thành công hay không. Như vậy, fallback từ HTTP sang browser sẽ quan sát được thay vì âm thầm biến trường thiếu thành một bản ghi hợp lệ.
Cuối cùng, hãy xem chi phí cài trình duyệt và vận hành như một đầu vào của triển khai. Quan sát khoảng 82 MiB chỉ có ý nghĩa như một ước lượng cỡ lớn tại máy local; bạn nên đo đúng bản build trình duyệt, nền tảng, hành vi cache và tác động image trong môi trường của mình. Xoay proxy, session, persistence, khôi phục sau crash và mức đồng thời cao vẫn cần các bài test riêng trước khi fixture này có thể dùng để quyết định ở quy mô production.
Ưu và nhược điểm
Ưu điểm:
- HTTP crawler và browser crawler dùng chung khái niệm vòng đời nhưng vẫn có ngữ cảnh trích xuất riêng theo engine.
- Trích xuất HTTP đạt độ đầy đủ 1.0 trên catalog tĩnh, bài viết và API JSON.
- Hạ tầng dùng chung cho cả hai engine:
RequestQueue,enqueueLinkscó kiểm soát độ sâu,Dataset. - Đường browser đã thực thi script của fixture và lấy đủ toàn bộ mục tiêu mong đợi trong hai bài test render bằng JS.
- Xử lý lỗi sạch sẽ — HTTP 500 được ghi nhận mà không làm sập chương trình.
- Giấy phép Apache-2.0; người dùng downstream nên xem lại các nghĩa vụ thông báo và ghi nhận nguồn.
Nhược điểm:
- Trong môi trường được kiểm thử, engine trình duyệt cần cài Chromium riêng; nếu không,
PlaywrightCrawlersẽ không chạy. - Đường HTTP không thể hiển thị các phần tử mục tiêu vốn không có trong HTML thô; nếu không kiểm tra đầy đủ, điều này có thể trông giống như kết quả rỗng hợp lệ.
- Đường trình duyệt phải gánh thêm binary trình duyệt và chi phí mỗi trang cao hơn trong lượt chạy này; kích thước và thời gian thay đổi theo build và nền tảng.
- Chạy mặc định sẽ để lại thư mục
storage/trên đĩa. - Chỉ dành cho Node/TypeScript — không giúp gì nếu stack của bạn là Python.
Dành cho ai — và ai nên bỏ qua
Crawlee phù hợp với đội Node hoặc TypeScript cần cả crawl HTTP lẫn crawl bằng trình duyệt dưới cùng một khái niệm queue và vòng đời. Một lộ trình thực tế là thử HTTP crawler trước, xác thực các trường bắt buộc, rồi đẩy lỗi đầy đủ typed sang browser handler với readiness condition riêng cho target. Code truy cập DOM của handler vẫn phụ thuộc engine, dù phần queue và link-discovery được dùng chung.
Hãy chỉnh lại kỳ vọng, hoặc tìm giải pháp khác, nếu bạn là team Python (Crawlee là Node/TS — có một bản port Python riêng, nhưng bộ kiểm thử này dùng thư viện Node), nếu toàn bộ target của bạn là tĩnh và bạn thích một HTTP scraper gọn nhẹ, hoặc nếu bạn cần hành vi đã được chứng minh ở quy mô lớn — xoay proxy, session pool, resume sau crash — những thứ mà phần thực hành này chưa đụng tới. Và nếu bạn dùng PlaywrightCrawler, hãy cài Chromium trước, nếu không nó sẽ không chạy.
Các lựa chọn thay thế, bao gồm vị trí của Thunderbit
Crawlee là phần mềm mã nguồn mở, bạn tự chạy và tự bảo trì. Nó không có phí theo từng lần gọi từ nhà cung cấp, nhưng chi phí vận hành vẫn gồm compute cho browser, bandwidth, proxy, lưu trữ, giám sát và công sức kỹ thuật. Bạn tự chịu trách nhiệm chọn crawler, binary trình duyệt, trạng thái lưu trữ và logic readiness.
Bài đánh giá liên quan: đánh giá scrapy-playwright.
Một dịch vụ trích xuất được quản lý sẽ chuyển trách nhiệm thu thập và định hình schema sang nhà cung cấp. Chúng tôi xây dựng Thunderbit, nhưng chưa chạy nó trên các fixture này, nên bài viết này không đưa ra so sánh về chất lượng, độ trễ, tính năng tương đương hay chi phí. Quyết định liên quan là đội của bạn muốn kiểm soát trong tiến trình như Crawlee hay muốn một ranh giới dịch vụ tính phí theo lần gọi.
Các bài benchmark liên quan: bài so sánh đầy đủ các scraper mã nguồn mở, Playwright và Puppeteer trên cùng trang, và bài đánh giá Scrapy không dùng trình duyệt, chạy lại request.
Thử Thunderbit để trích xuất dữ liệu web
Kết luận
Crawlee là một lựa chọn mạnh cho đội Node hoặc TypeScript muốn có điều phối crawl dùng chung cho cả HTTP và thực thi bằng trình duyệt. Các handler được kiểm thử không thể thay thế trực tiếp cho nhau: chuyển sang Playwright đòi hỏi page, một bước chờ target selector, và trích xuất ngay trên trình duyệt. Proxy, session, persistence, resume và hành vi ở quy mô lớn vẫn là câu hỏi mở.
Thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Điểm khác nhau thực sự giữa hai crawler của Crawlee là gì?
CheerioCrawler lấy HTML qua HTTP và không chạy JavaScript. PlaywrightCrawler điều khiển Chromium và có thể thực thi script của trang cũng như chụp màn hình, nhưng chi phí mỗi trang tại local cao hơn. Chúng chia sẻ khái niệm vòng đời, nhưng không có cùng ngữ cảnh handler: bộ test này dùng $ ở đường HTTP, còn dùng page, chờ target selector và evaluate phía trình duyệt ở đường Playwright.
Vì sao PlaywrightCrawler không chạy sau khi tôi đã cài Crawlee?
Trong môi trường được kiểm thử, việc cài package không cung cấp sẵn browser executable. Cài Chromium bằng npx playwright install chromium đã giải quyết lỗi khởi chạy. Payload quan sát được vào khoảng 82 MiB, nhưng phép đo gốc không giữ lại thông tin đó là dung lượng truyền tải hay dung lượng trên đĩa, nên hãy đo lại theo nền tảng và build của bạn.
CheerioCrawler có scrape được trang render bằng JavaScript không?
Nó không thể chạy JavaScript của trang. Tuy nhiên, nó vẫn có thể gọi một endpoint JSON mà client đang dùng, như fixture phản hồi trực tiếp đã cho thấy. Khi dữ liệu cần thiết chỉ xuất hiện sau khi trình duyệt thực thi, hãy dùng browser crawler và một điều kiện sẵn sàng gắn với các trường đó.
Crawlee có chính xác cho trích xuất tĩnh thông thường không? Trên các fixture được kiểm soát, các handler đã trả về đủ 12/12 sản phẩm catalog, 3/3 đoạn văn của bài viết, và 8/8 mục JSON trực tiếp mong đợi. Đây là các kiểm tra độ đầy đủ của fixture, không phải điểm chính xác tổng quát cho những website chưa được kiểm thử.
Crawlee có miễn phí cho mục đích thương mại không? Nó được phát hành theo Apache-2.0. Hãy xác nhận giấy phép hiện tại trong repository và xem kỹ các nghĩa vụ thông báo và ghi nhận nguồn cho cách bạn phân phối.
Trước khi đưa vào production, hãy kiểm tra những phần fixture này chưa chạm tới: chạy đồng thời lặp lại trên trang đại diện, hành vi proxy và session, khôi phục queue bền vững sau gián đoạn, dọn dẹp tiến trình browser, và export dataset khi có lỗi. Hãy lưu lại phiên bản browser và đường cài đặt đã dùng cùng với các kết quả đó. Hai class crawler giúp giảm sự khác biệt ở tầng điều phối, nhưng không loại bỏ nhu cầu có readiness check riêng cho từng engine, ngân sách tài nguyên và xử lý lỗi vận hành.




