
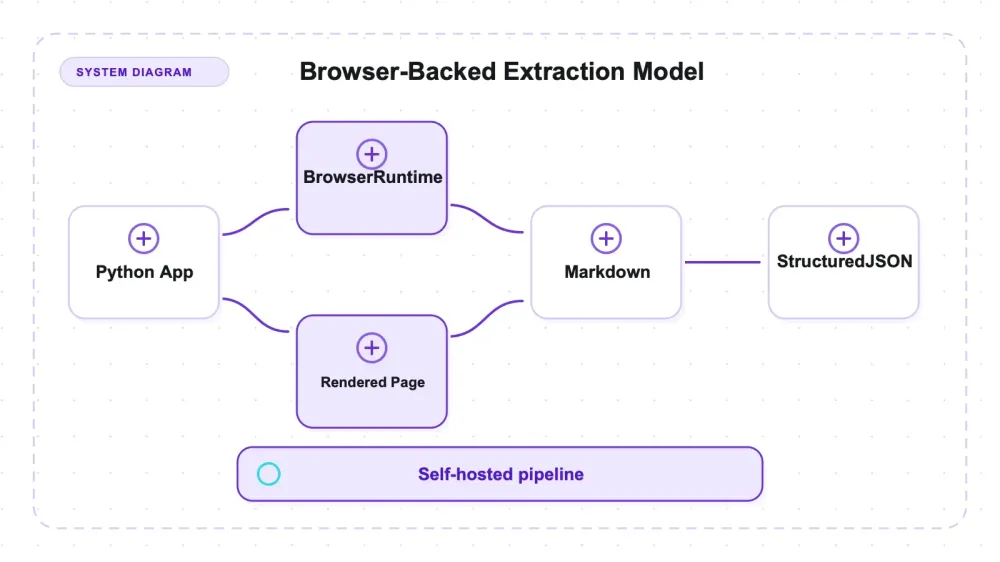
Một số bài so sánh scraper của bên thứ ba gán cho Crawl4AI khả năng "Adaptive Intelligence" — tức là selector có thể tự học cấu trúc trang và tự sửa khi markup thay đổi. Nhưng trong phạm vi API tôi thử nghiệm, tôi không thấy hành vi đó. Điều Crawl4AI thực sự cung cấp là tạo Markdown dựa trên trình duyệt, kèm trích xuất bằng CSS/XPath. Scrapling có một tính năng selector thích ứng riêng, với những giới hạn đã được nêu trong bài đánh giá của chính nó.
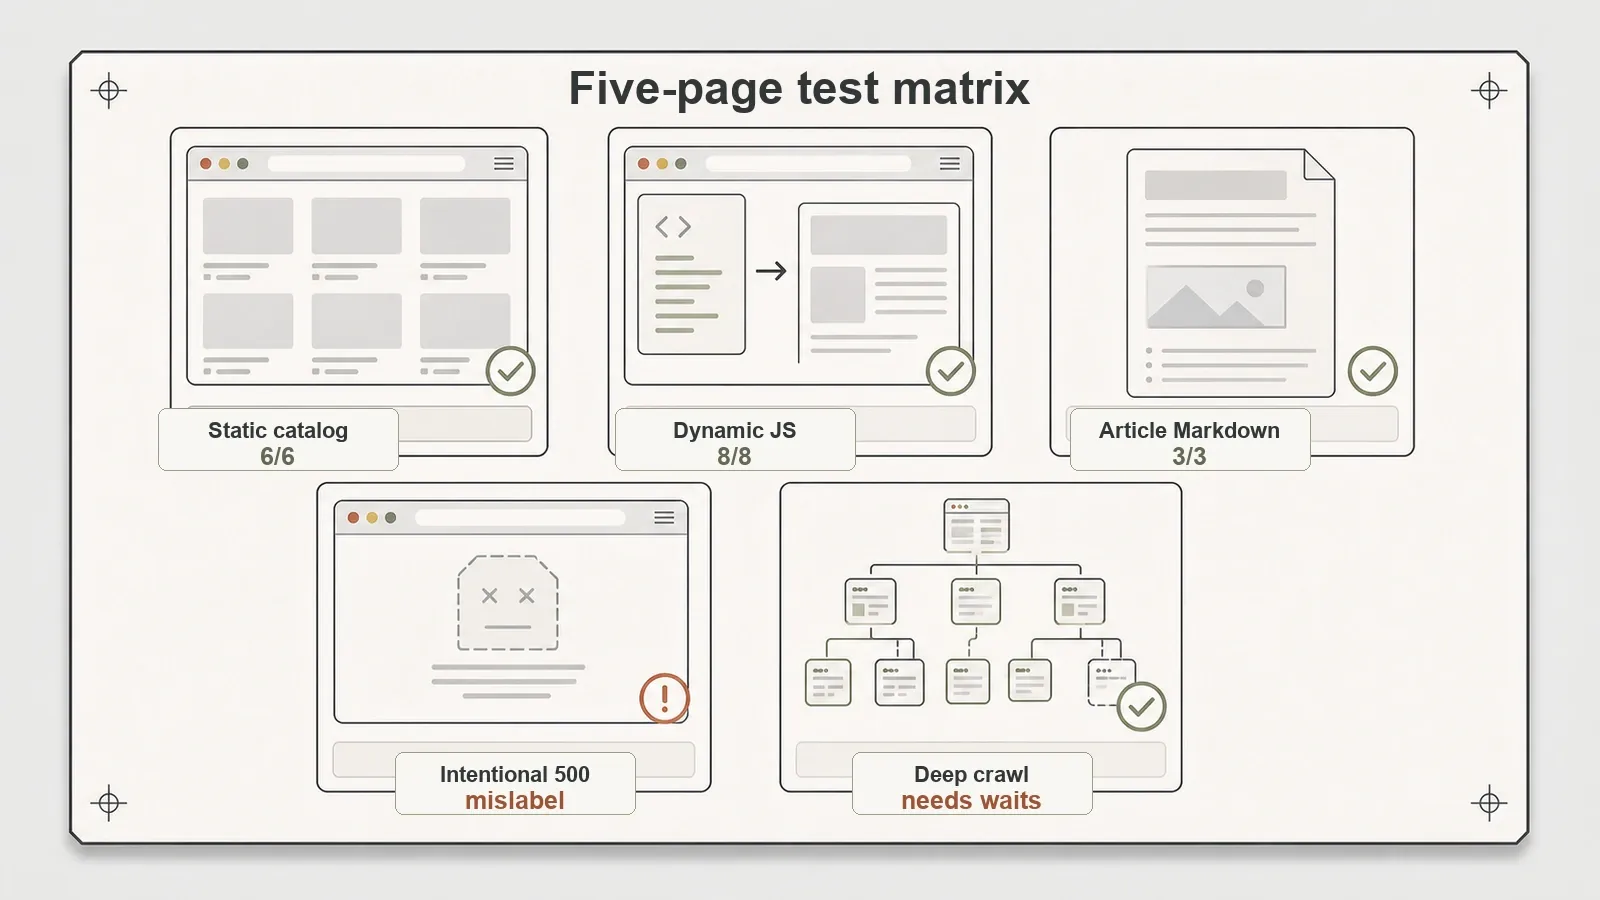
Tôi đã chạy Crawl4AI 0.9.0 trên 5 kiểu trang với dữ liệu đối chiếu đã biết: một danh mục tĩnh, một danh mục render bằng JavaScript, một bài viết có lẫn nội dung phụ, một trang lỗi 500 có chủ đích, và một đồ thị nhiều trang có liên kết qua lại. Các luồng Markdown và schema được thử nghiệm đều trả về đúng nội dung fixture mong đợi. Markdown thô vẫn giữ cả phần boilerplate, deep crawl cần chờ theo từng trang, và một lỗi 500 thông thường lại bị gắn nhãn mang màu sắc chống bot.
Crawl4AI thực sự là gì
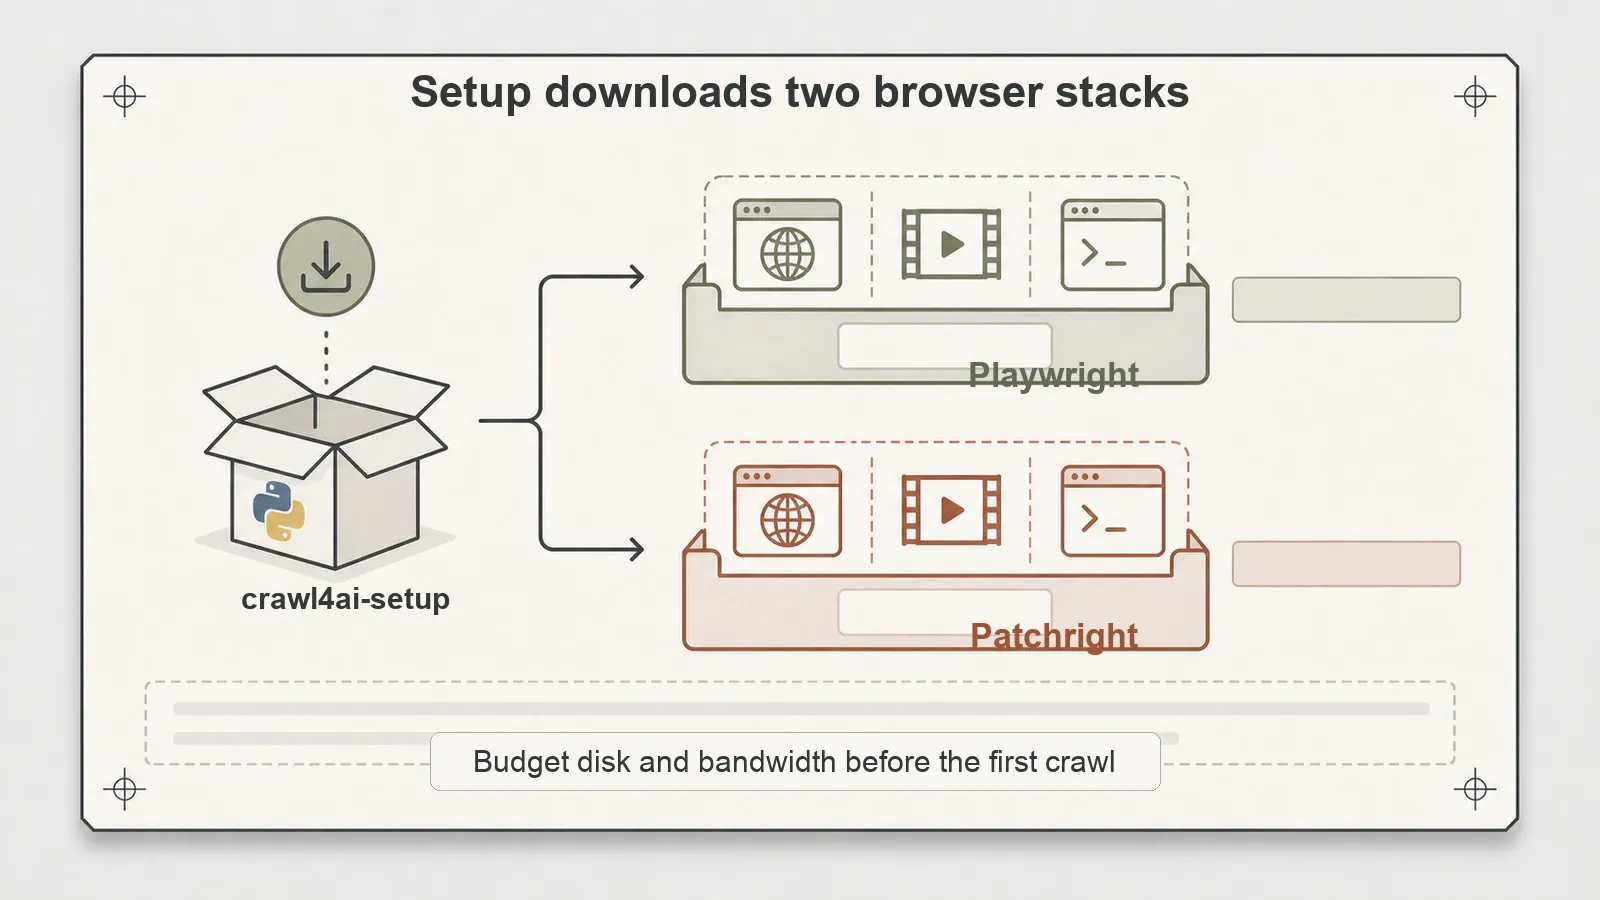
Hãy bắt đầu từ chỗ nhiều người hiểu sai ngay lúc cài đặt. Crawl4AI không phải là một trình phân tích Python nhỏ gọn. Lệnh crawl4ai-setup đầu tiên sẽ âm thầm kéo về hai bộ browser đầy đủ — Playwright và Patchright — và khi bạn hiểu điều đó, toàn bộ công cụ sẽ trở nên dễ hiểu: đây là một headless browser được kiểm soát, có thêm bộ chuyển đổi Markdown ở trên, khoác áo của một scraper.
Về mặt chính thức, đây là một thư viện mã nguồn mở Apache-2.0 để chuyển trang web thành Markdown cho pipeline RAG, agent và luồng dữ liệu. Tôi đã thử v0.9.0. Các primitive cốt lõi của nó gồm AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, tạo Markdown, và các chiến lược trích xuất bằng CSS/XPath hoặc LLM, theo hướng dẫn khởi động nhanh chính thức.
Mô hình tư duy quan trọng ở đây là: phần lớn thư viện parse sẽ gửi một HTTP request rồi phân tích bytes trả về; còn Crawl4AI điều khiển một trình duyệt thật. Việc render bằng browser đã được tích hợp sẵn, nên cài đặt nặng hơn một trình parse HTTP thuần túy, trong khi việc trích xuất ổn định từ các phần tử render bất đồng bộ vẫn có thể cần chờ rõ ràng. Không có gì tôi thử ở đây tự viết lại selector sau khi giao diện thay đổi. Hãy xem tuyên bố self-healing như một lỗi trong bài so sánh của bên thứ ba, trừ khi có nguồn chính thức cụ thể và API có thể tái hiện được.
Tính năng chính và cách nó hoạt động bên trong
Đường đi cho một trang đơn là phần cốt lõi. Bạn chỉ cần trỏ AsyncWebCrawler tới một URL, nó sẽ load trang trong browser, rồi trả về Markdown. Với quickstart chính thức trên example.com, vòng này mất 1,81 giây và trả về mã 200 sạch. Không có gì quá phức tạp, nhưng nó xác nhận đường đi tối thiểu hoạt động với gần như không cần cấu hình — không schema, không wait, không cấu hình browser.
Video hướng dẫn (1:02:38): Hướng dẫn chính thức Crawl4AI, đầy đủ 1 giờ với ví dụ Quickstart.
Trích xuất có cấu trúc là trụ cột thứ hai, và đó là thứ gần nhất với việc Crawl4AI “hiểu” một trang — nói cách khác, không phải suy luận, mà là schema do bạn tự viết. Thay vì chỉ đổ ra Markdown, bạn đưa cho nó một CSS schema qua JsonCssExtractionStrategy và nhận lại các object JSON với đúng trường bạn yêu cầu. Trên danh mục tĩnh local của tôi, nó trả về 6 bản ghi JSON sạch — tên sản phẩm, danh mục, giá, đánh giá, URL chi tiết — khớp cả 6 sản phẩm mong đợi. Đó là khác biệt giữa “đây là trang dưới dạng văn bản” và “đây là dữ liệu dưới dạng hàng”, và Crawl4AI làm được cả hai từ cùng một lượt crawl. Tuy nhiên, selector vẫn do bạn tự định nghĩa; công cụ sẽ khớp theo những gì bạn đưa vào, chứ không tự suy ra schema hộ bạn.
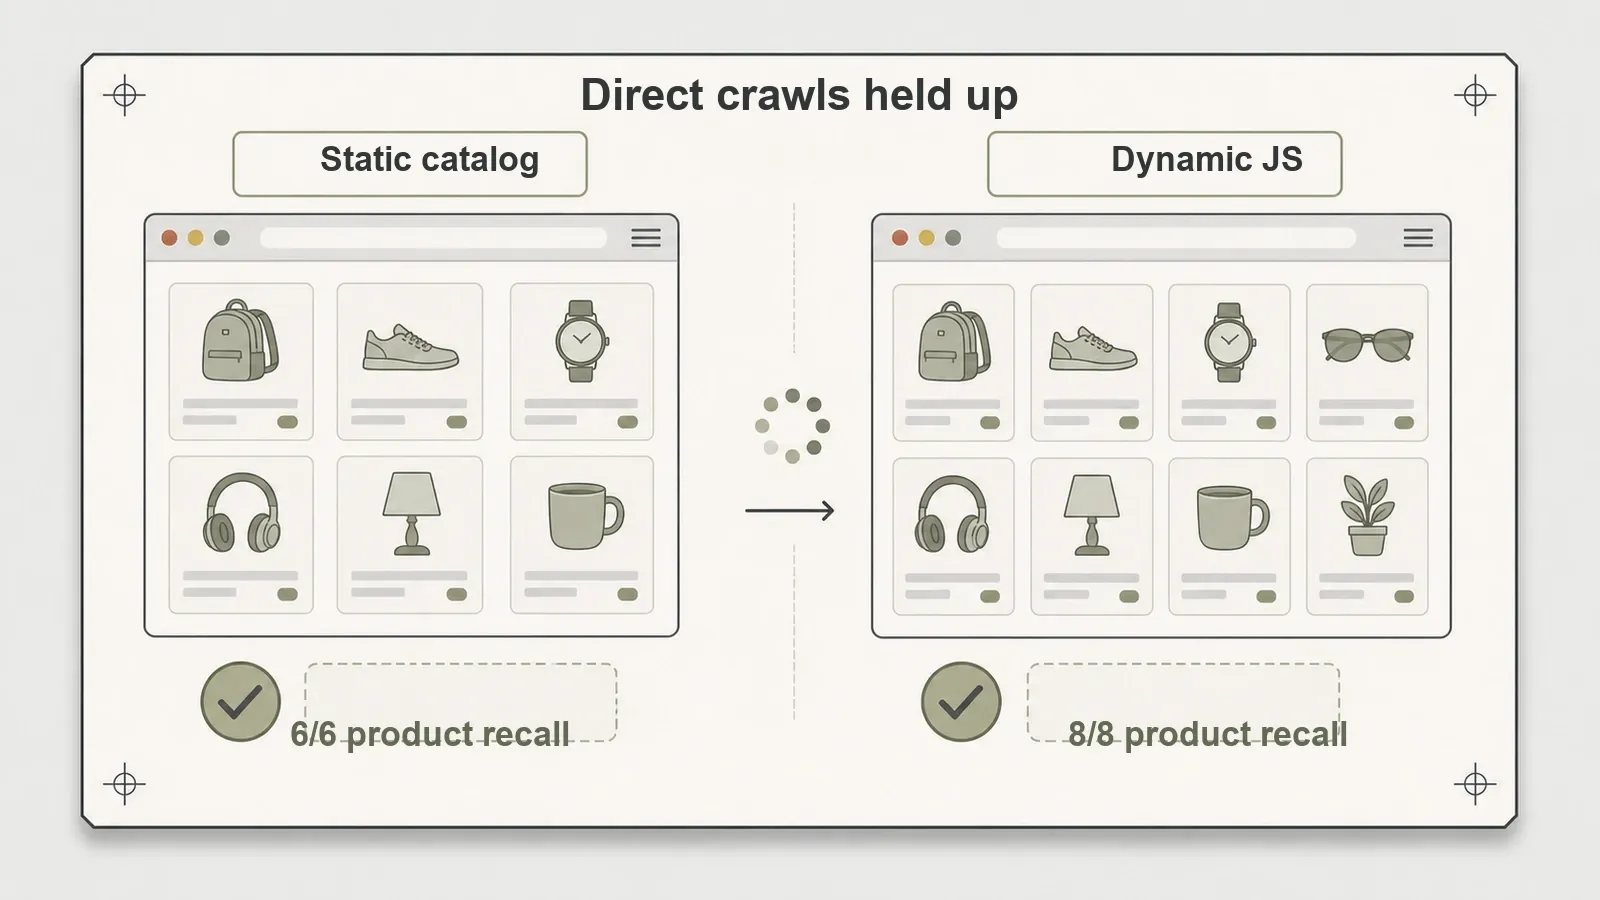
Render động là nơi sức mạnh của browser phát huy tác dụng. Trỏ nó tới một danh mục render bằng JavaScript với wait_for="css:.product-card" và nó sẽ chờ cho đến khi render phía client hoàn tất rồi mới trích xuất. Kết quả là 8/8 sản phẩm được thu hồi đầy đủ ở cả Markdown lẫn schema output trên fixture JS local của tôi, mất khoảng 1,56 giây. Trên trang công khai Quotes to Scrape JS page, nó bắt được các câu trích đã render và lưu được ảnh chụp màn hình dùng được — nội dung mà một request HTTP thuần túy sẽ không bao giờ thấy, vì trong HTML ban đầu không có gì để parse.
Tiếp theo là quy mô và crawling. arun_many() chạy đồng thời 6 trang chi tiết local với 6/6 recall trong 3,76 giây. Và Crawl4AI còn có các chiến lược deep crawl — BFS, DFS, BestFirst — để đi qua một đồ thị liên kết với giới hạn độ sâu, giới hạn số trang, lọc và chấm điểm. Một deep crawl BFS đã đi qua đồ thị liên kết của homepage fixture và kéo về năm trang. Đây là chỗ lời quảng bá bắt đầu tách khỏi thực tế, và tôi sẽ nói rõ hơn ở dưới.
Thiết lập: phần chẳng mấy ai nói trong phần mở đầu README
Việc cài đặt trên máy tôi vừa mượt hơn dự kiến ở một mặt, vừa nặng hơn ở mặt khác. pip install -U crawl4ai và smoke test đều thành công trên Python 3.14.2 trong macOS arm64. Specifier >=3.10 trên PyPI vốn đã bao gồm 3.14; kết quả này chỉ xác nhận bản cài đặt và workflow đã thử nghiệm, chứ không chứng minh khả năng tương thích rộng hơn.
Điểm gây cấn nhất là bước setup. crawl4ai-setup tải về tài nguyên browser cho cả Playwright lẫn Patchright — Chrome for Testing, FFmpeg, và Headless Shell. Nếu bạn dùng laptop dung lượng eo hẹp hoặc kết nối tính theo lưu lượng, đây là một cái giá thực sự, và tài liệu chỉ nhắc qua chứ không nói trước từ đầu. Sau đó crawl4ai-doctor chạy qua và crawl crawl4ai.com trong 14,65 giây — một bài kiểm tra đầu-cuối ổn, nhưng không phải benchmark của bất cứ thứ gì; tôi sẽ không suy ra tốc độ từ con số đó.
Kết luận cho phần setup trong bài đánh giá của bạn là: hãy dự trù cho tải browser, không chỉ cho lệnh pip install. Nó giống việc dựng hẳn một môi trường headless browser hơn là thả một thư viện vào script. Hai bộ browser sẽ được đặt lên đĩa trước khi bạn crawl bất kỳ trang thật nào, và đó là một chi phí một lần mà bạn phải trả dù workload của bạn có thực sự cần lớp stealth của Patchright hay không.
Thực hành: cái gì ổn, và cái gì tôi muốn cảnh báo
Có bốn kết quả đáng ghi lại cẩn thận, vì chúng chính là những sắc thái mà một trang marketing thường làm phẳng đi — và trong một trường hợp, còn gán nhãn sai.
Hai trang demo công khai cũng đi trọn đường thuận lợi. Trên homepage của Books to Scrape, Crawl4AI tạo ra 13.476 ký tự Markdown trong 2,43 giây. Trang Quotes JS công khai trả về 1.666 ký tự Markdown đã render trong khoảng 3,1 giây. Nhưng cả hai đều không chứng minh được gì về khả năng scale, site chống đối, độ ổn định dài hạn, session, proxy, retry hay hành vi bộ nhớ.
Fixture bài viết cho thấy một lưu ý về chất lượng Markdown. Crawl4AI bắt được tiêu đề và đủ 3/3 đoạn nội dung chính — tốt. Nhưng Markdown thô cũng giữ lại text của thanh điều hướng, link liên quan, dòng đăng ký và footer. Đó không phải bug; nếu không có content filter hoặc target selector, câu “chuyển trang này thành Markdown” thực sự nghĩa là chuyển toàn bộ trang. Bài học ở đây là phải phân biệt giữa chuyển Markdown thô và trích xuất bài viết sạch. Nếu bạn muốn loại sau, hãy dùng content filter như PruningContentFilter hoặc target selector — nhưng tôi chưa stress-test chúng, nên sẽ không đưa ra con số về độ sạch.
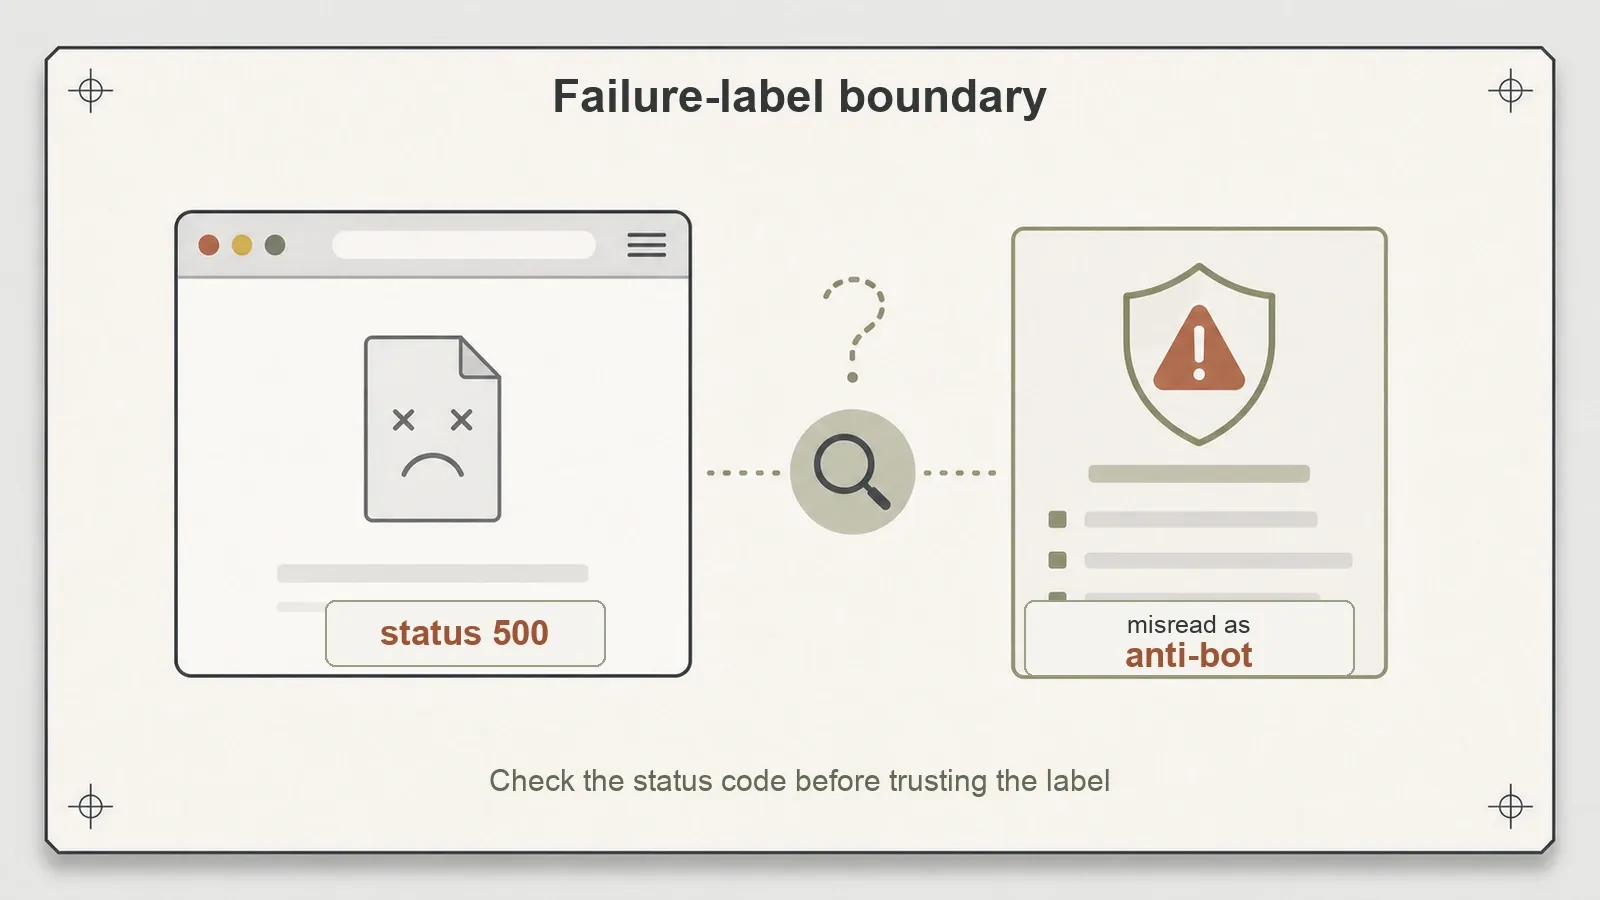
Trang lỗi hỏng là kết quả nói lên nhiều nhất. Tôi cố tình phục vụ một HTTP 500 với body rất nhỏ. Crawl4AI trả về success=false và status 500 — đúng — nhưng thông báo lỗi lại diễn giải thành "Blocked by anti-bot protection: Structural: minimal_text on small page." Không hề có tường chống bot nào ở đây. Đó chỉ là một trang lỗi nhỏ. Heuristic cấu trúc của Crawl4AI thấy quá ít text hiển thị và tự động nghiêng về cách giải thích chống bot. Với bất kỳ ai xây dựng trên nó, điều đó rất quan trọng: đừng tin nhãn "anti-bot" theo nghĩa đen. Hãy kiểm tra mã trạng thái và response thực tế trước khi kết luận site đang chặn bạn. Kết quả thô nằm trong repo benchmark tại results/local_failure_500.json.
Deep crawl cần cấu hình có chủ đích. Một lượt crawl động trực tiếp với wait_for chạy trơn tru, trong khi deep crawl BFS lại phát hiện catalog động và trả về thất bại. Phân loại minimal-text là hợp lý nếu hiểu là nó đọc trang trước khi các card render xong, và deep crawl đã không áp dụng wait của lượt crawl trực tiếp. Trong 5 trang, 3 thành công và 2 thất bại. Vì ở đây không có lượt chạy lại với cấu hình wait, chẩn đoán này vẫn chỉ là suy luận chứ chưa phải nguyên nhân được chứng minh.
Các con số thực tế ra sao
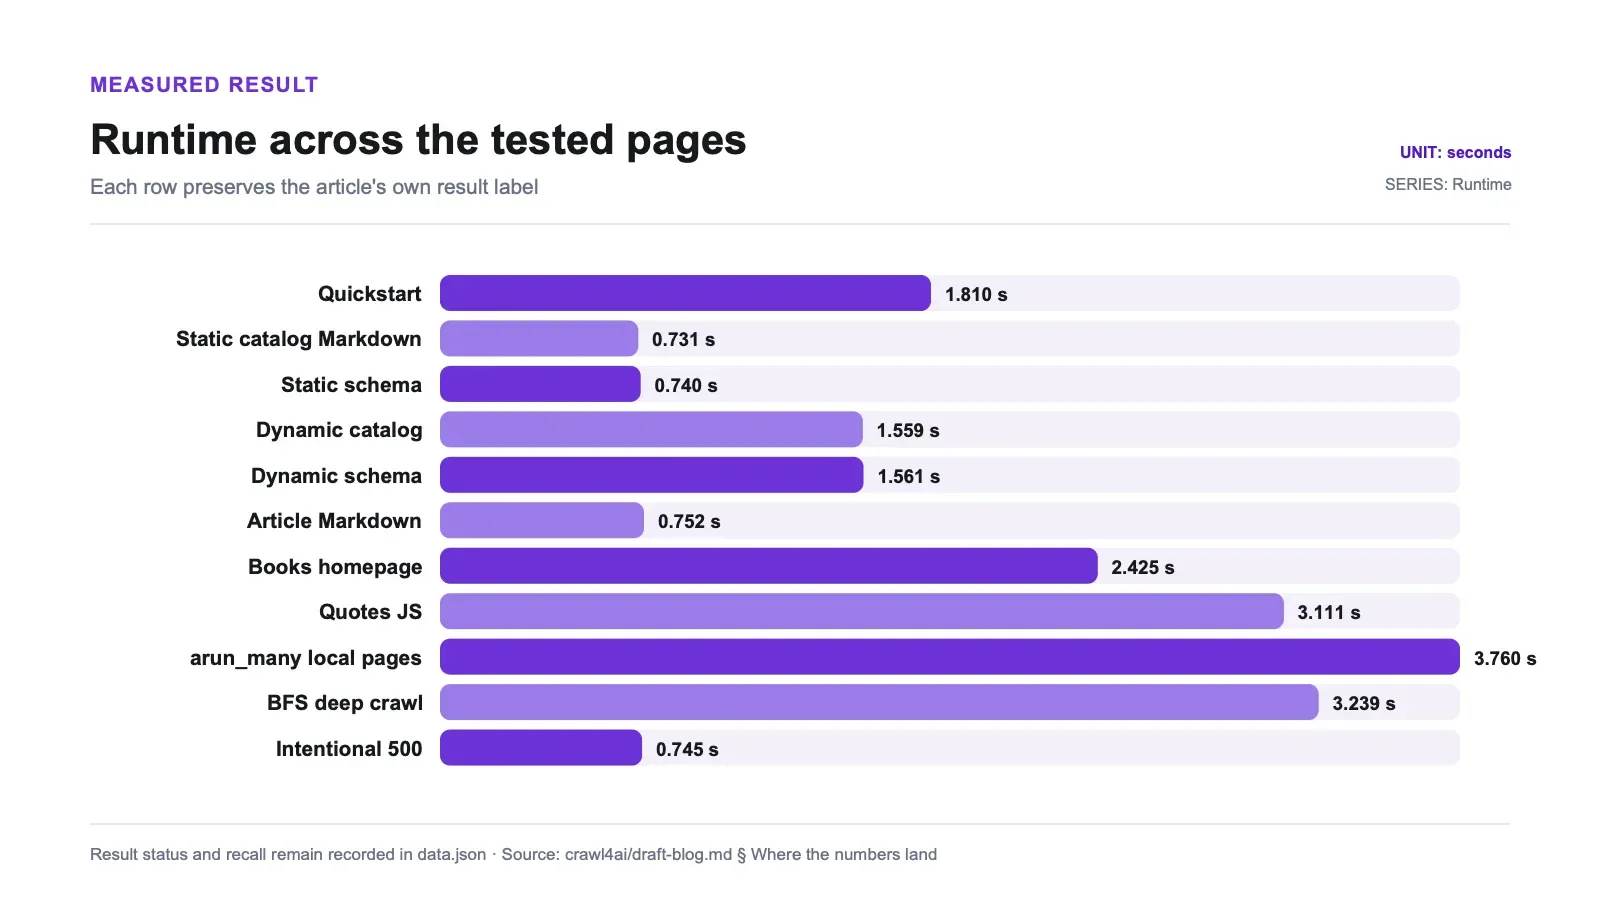
| Bài test | Kết quả | Thời gian thực tế quan sát được (một lượt chạy ghi nhận) |
|---|---|---|
Quickstart (example.com) | thành công, 200 | 1,81 giây |
| Danh mục tĩnh local (Markdown) | 6/6 sản phẩm được thu hồi | 0,731 giây |
| Trích xuất CSS schema tĩnh local | 6 bản ghi JSON | 0,740 giây |
Danh mục động local (wait_for) | 8/8 sản phẩm được thu hồi | 1,559 giây |
| Trích xuất CSS schema động local | 8 bản ghi JSON | 1,561 giây |
| Markdown bài viết | 3/3 đoạn (+ boilerplate) | 0,752 giây |
| Trang Books to Scrape công khai | 13.476 ký tự Markdown | 2,425 giây |
| Trang Quotes JS công khai | 1.666 ký tự Markdown, đã render | 3,111 giây |
arun_many() (6 trang local) | 6/6 recall | 3,760 giây |
| Deep crawl BFS local | tìm thấy 5 trang, 3 thành công / 2 thất bại | 3,239 giây |
| Trang 500 có chủ đích | thất bại, 500 (bị gắn nhãn sai là "anti-bot") | 0,745 giây |
Đây là các con số smoke test, không phải benchmark hiệu năng: bài viết không nêu phần cứng, số lần lặp, trạng thái warm/cold, trạng thái cache, kiểm soát concurrency hay độ biến thiên. Chúng chỉ cho thấy các workflow trong danh sách đã chạy xong trên máy này. Toàn bộ artifact của lần chạy nằm trong thư mục repo benchmark.
Nếu muốn một bài đo hiệu năng đủ tin cậy để ra quyết định, hãy lặp lại từng workflow trong session browser mới và session đã dùng rồi, báo cáo phân phối thay vì một con số lẻ, cố định bản browser, và ghi lại CPU, bộ nhớ, trạng thái cache, cùng concurrency. Cách đó sẽ tách được overhead của thư viện khỏi thời gian khởi động browser và biến động mạng.
| Yêu cầu | Mức độ phù hợp trong bài đánh giá này | Điều kiện chính |
|---|---|---|
| Render trang và trả về Markdown | Ứng viên tốt | Lọc boilerplate trước khi coi output là bài viết sạch |
| Trích xuất JSON theo schema | Ứng viên tốt | Bạn vẫn phải tự viết và duy trì CSS schema |
| Chờ nội dung trang bất đồng bộ | Được hỗ trợ | Xác định điều kiện wait_for rõ ràng, đúng mục tiêu |
| Deep crawl các trang động | Có điều kiện | Phải truyền tiếp quy tắc readiness; mặc định thử nghiệm cho ra lỗi một phần |
| Chạy như một trình parse HTTP nhỏ, nhẹ | Không phù hợp | Tài nguyên browser và việc duy trì chúng là một phần của triển khai |
| Dùng selector tự chữa lỗi | Không được chứng minh trong bài test này | Đừng suy ra điều đó từ đoạn quảng cáo so sánh không liên quan |
Ưu và nhược điểm
Ưu điểm:
- Một thư viện xử lý cả Markdown thô và JSON có cấu trúc theo CSS schema — không cần ghép hai công cụ riêng.
- Render bằng browser được tích hợp sẵn; các target render bất đồng bộ có thể cần
wait_forrõ ràng. - Các workflow một trang đã thử nghiệm hoàn thành trong thời gian quan sát ở trên; không có tuyên bố so sánh tốc độ nào được đưa ra.
- Giấy phép Apache-2.0 — thân thiện với thương mại, không có bất ngờ kiểu copyleft.
- Dự án đang hoạt động tốt với bản phát hành gần đây và cộng đồng lớn, sôi nổi.
Nhược điểm:
- Bước setup ban đầu nặng (hai bộ browser) và phần mở đầu đã nói nhẹ hơn thực tế.
- Markdown thô sẽ chứa boilerplate nếu bạn không cấu hình content filter.
- Deep crawl không tự chờ trang động — bạn phải cấu hình theo từng lượt crawl, nếu không sẽ gặp lỗi.
- Thông báo lỗi có thể gán nhãn sai một lỗi thường thành "anti-bot", khá khó hiểu trong log.
- Không có selector tự thích ứng, dù một số bài so sánh ngụ ý như vậy — schema là thứ bạn phải tự viết và tự duy trì.
- Bạn phải tự vận hành và duy trì môi trường browser, bao gồm cập nhật và xử lý hỏng hóc.
Dành cho ai — và ai nên bỏ qua
Crawl4AI đáng để đánh giá nếu bạn là developer đang xây dựng pipeline RAG hoặc agent, bạn thấy thoải mái khi vận hành một môi trường headless browser, và bạn muốn Markdown lẫn JSON có cấu trúc từ cùng một lần crawl. Các bài thử không bao gồm độ bền trước site chống đối, độ ổn định dài hạn, bộ nhớ, session, retry, proxy hay triển khai production, nên khuyến nghị ở đây chỉ giới hạn trong những workflow đã được thử.
Hãy bỏ qua — hoặc ít nhất là dừng lại suy nghĩ — nếu bạn muốn một HTTP parser nhỏ, ít phụ thuộc (thì đây là ngược lại hoàn toàn), nếu bạn không dư dung lượng và băng thông để tải browser, hoặc nếu bạn không muốn tự gánh việc bảo trì browser stack trong production. Và đặc biệt nên bỏ qua nếu bạn đến vì selector tự chữa lỗi: đó không phải thứ công cụ này có, và xây workflow dựa trên một tính năng nó không sở hữu rồi cũng sẽ quay lại cắn bạn. Với việc chỉ cần trích xuất text bài viết sạch, bỏ boilerplate, một công cụ nhẹ hơn được sinh ra đúng cho nhiệm vụ đó có thể phù hợp hơn.
Các lựa chọn thay thế, bao gồm Thunderbit nằm ở đâu
Nói thật mà nói: Crawl4AI là một thư viện mã nguồn mở miễn phí do bạn tự host và tự duy trì. Bạn có toàn quyền kiểm soát và không phải trả phí sử dụng cho nhà cung cấp, nhưng vẫn phải trả cho compute, băng thông, lưu trữ, cập nhật browser, schema và công việc vận hành.
Ở đầu bên kia là một dịch vụ scraping được quản lý như Thunderbit, nơi việc fetch và trích xuất được đặt sau một API. Thunderbit không được chạy qua các fixture này, nên bài viết này không đưa ra bất kỳ tuyên bố đối sánh nào về render, xử lý anti-bot, CAPTCHA, độ chính xác hay tốc độ. Điểm so sánh phù hợp nằm ở trách nhiệm vận hành: tự host thư viện dựa trên browser, hay trả tiền cho một dịch vụ để họ vận hành lớp đó.
Khác biệt nằm ở chỗ ai là người chạy browser. Với Crawl4AI, bạn sở hữu phần render, wait, schema và bảo trì. Với API được quản lý, bạn trả theo mỗi lần gọi và chuyển bớt trách nhiệm vận hành sang nhà cung cấp. Thí nghiệm này không so sánh hai hướng đi đó về kết quả đầu ra.
Các bài đánh giá benchmark liên quan: bài so sánh đầy đủ về open-source scraper, bài đánh giá self-hosted của Firecrawl, và bài đánh giá trích xuất bài viết của trafilatura.
Thử Thunderbit để trích xuất dữ liệu web
Kết luận
Crawl4AI là một lựa chọn hợp lý nếu bạn muốn trích xuất mã nguồn mở, chạy trên browser, cho ra Markdown và JSON theo schema, và bạn sẵn sàng tự chịu trách nhiệm với môi trường browser. Các workflow trực tiếp trên trang tĩnh và trang động có chờ đều thành công trong các fixture này. Apache-2.0 khá thoáng, dù bạn vẫn cần xem xét bình thường các phụ thuộc và điều khoản phân phối.
Hãy dự trù cho tài nguyên browser. Markdown thô cần được lọc trước khi trở thành bài viết sạch. Wait cho deep crawl phải được cấu hình có chủ đích, và log có chữ "anti-bot" thì phải đối chiếu với status code và response. Selector theo schema vẫn là thứ bạn phải tự viết và tự duy trì. Đó là những ranh giới quyết định đã được thử nghiệm; quy mô production và hành vi trên site chống đối vẫn còn là câu hỏi mở.
Thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Crawl4AI có selector thích ứng hoặc tự chữa lỗi không? Không. Dù một số bài so sánh gán cho nó "adaptive intelligence", Crawl4AI khớp theo CSS/XPath schema mà bạn viết — nó không fingerprint phần tử hay tìm lại chúng sau khi markup thay đổi. Trong quá trình thử nghiệm, trích xuất có cấu trúc đạt recall 6/6 và 8/8 với schema tôi tự viết tay. Nếu site đổi class, schema của bạn sẽ hỏng cho tới khi bạn cập nhật nó. Theo dõi phần tử tự chữa lỗi là tính năng của thư viện khác, không phải của công cụ này.
Tại sao phần cài đặt lại nặng như vậy?
crawl4ai-setup tải đầy đủ tài nguyên browser cho cả Playwright và Patchright — Chrome for Testing, FFmpeg và Headless Shell. Đó là cái giá của việc ship render browser thật. Hãy dành sẵn dung lượng đĩa và băng thông; nó nặng hơn một HTTP parser thuần túy, và bạn phải trả chi phí này ngay cả khi workload của mình không bao giờ dùng đến lớp stealth.
Crawl4AI có xử lý được trang render bằng JavaScript không?
Có, vì nó điều khiển một headless browser thật. Trong thử nghiệm, danh mục động với wait_for="css:.product-card" trả về đủ 8/8 sản phẩm, và trang Quotes JS công khai được render mượt. Nhưng điểm trừ là deep crawl không tự áp dụng wait đó cho các trang mới phát hiện — một crawl BFS đã thất bại trên một trang động mà nó tìm thấy vì không chờ. Bạn phải tự cấu hình waiting cho từng lượt crawl.
Crawl4AI cho tôi text bài viết sạch hay toàn bộ trang?
Theo mặc định là toàn bộ trang. Trong thử nghiệm, nó bắt được tất cả các đoạn nội dung chính nhưng cũng giữ lại text của thanh điều hướng, link liên quan và footer. Muốn trích xuất bài viết sạch thì bạn cần áp dụng content filter (như PruningContentFilter) hoặc target selector, thay vì chỉ dựa vào Markdown thô.
Tôi có thể tin vào thông báo lỗi của Crawl4AI không? Hãy đọc chúng với một chút hoài nghi. Một trang lỗi 500 có chủ đích với body rất nhỏ đã bị gắn nhãn "Blocked by anti-bot protection" chỉ vì heuristic text hiển thị thấp — thực tế không hề có tường anti-bot nào cả. Kết quả thô nằm trong repo benchmark. Luôn kiểm tra mã trạng thái HTTP và nội dung response thực tế trước khi kết luận site đang chặn bạn.




