
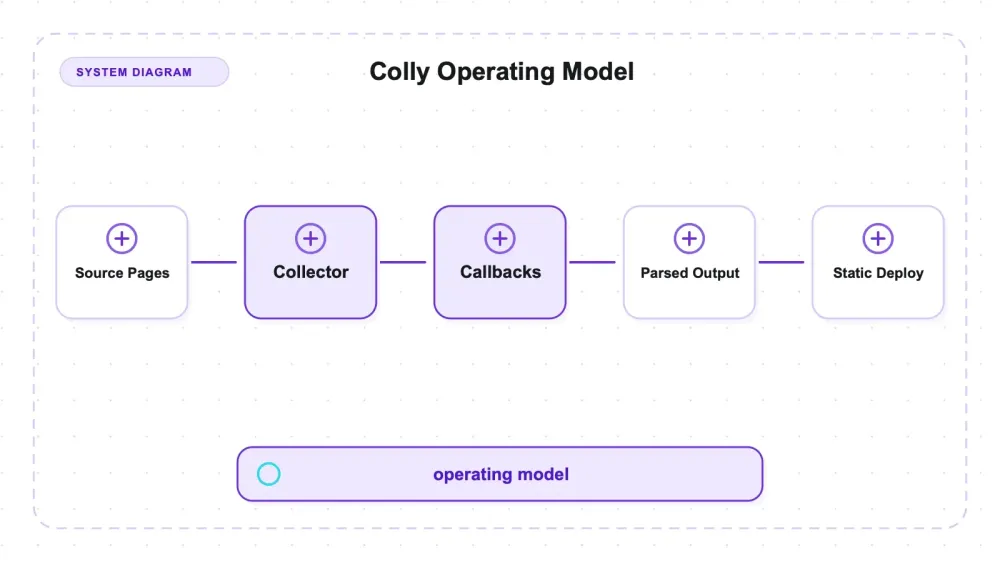
Tôi đã dựng một site fixture để kiểm tra những thứ mà một con số về số trang hay tốc độ của Colly không thể trả lời: liệu các callback của nó có trích xuất đúng bản ghi, chuyển lỗi HTTP sang OnError, đi theo một đồ thị crawl có giới hạn hay không, và lấy được nội dung được đẩy ra ngoài HTML đã render. Đây là một bài review về độ đúng và các ranh giới biên, chứ không phải bài benchmark thông lượng.
Trên bộ fixture được kiểm soát, Colly đã trích xuất đầy đủ mọi bản ghi tĩnh mong đợi, chuyển một phản hồi 500 sang OnError, và truy cập 17 URL trong đồ thị đã cấu hình giới hạn độ sâu. Nó trả về 0 phần tử mục tiêu trên hai trang mà phần tử chỉ xuất hiện sau khi JavaScript chạy xong. Một endpoint JSON có thể truy cập trực tiếp vẫn dùng được mà không cần trình duyệt — đây là điểm khác biệt quan trọng so với việc render UI phía client.
Colly thực sự là gì
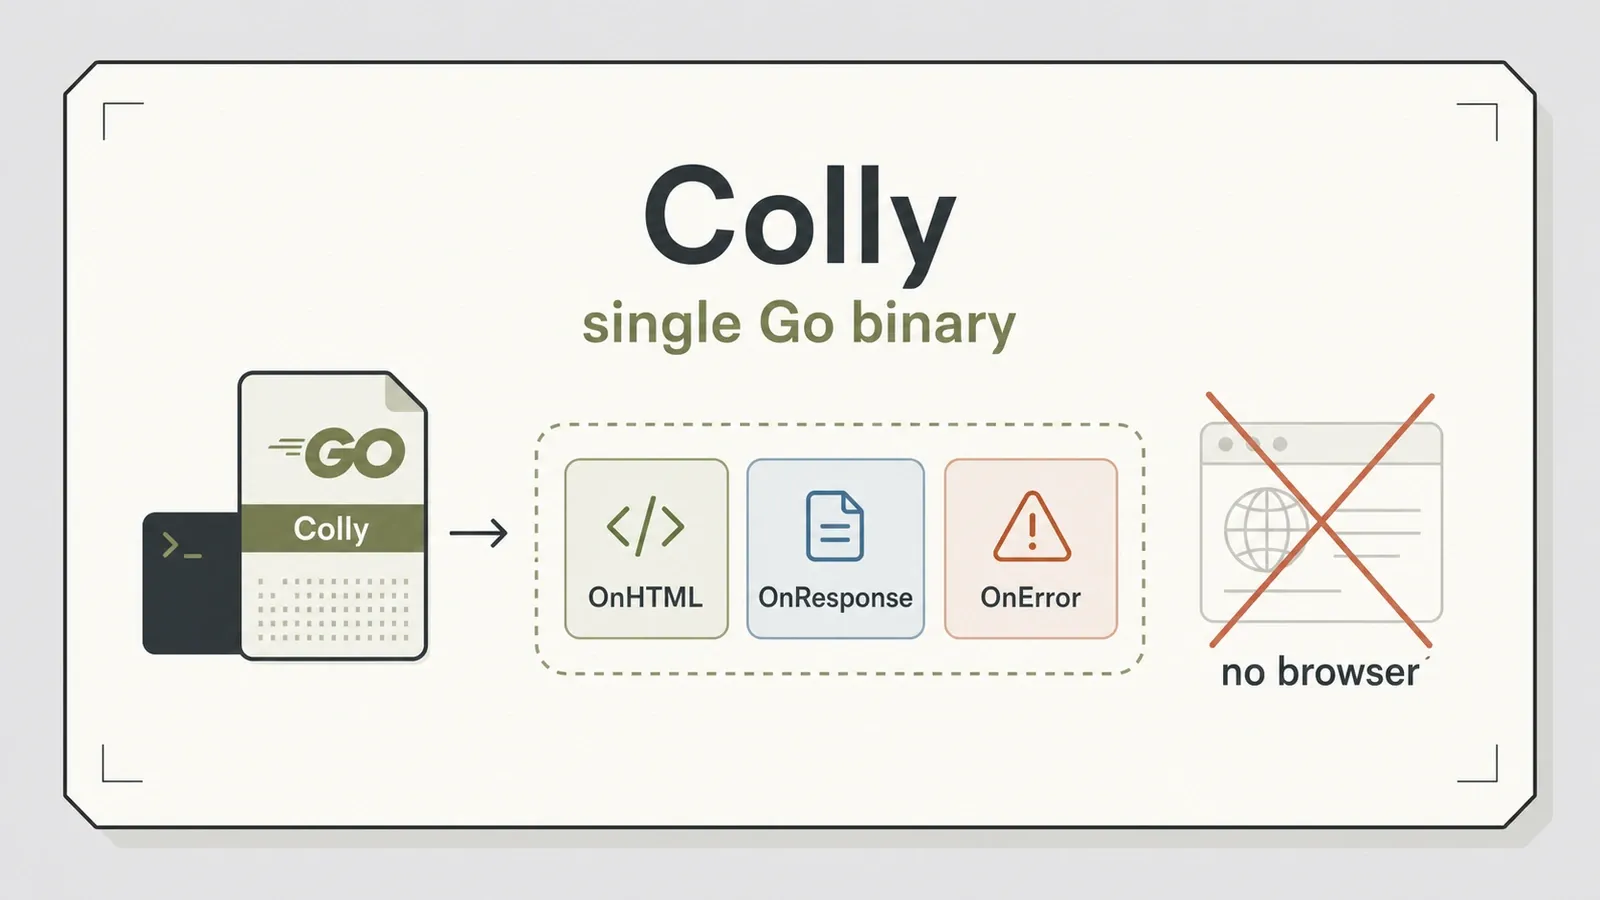
Colly tự mô tả là một "elegant scraper and crawler framework for Golang", và cách mô tả đó thực ra có nhiều ý nghĩa hơn vẻ bề ngoài của nó. Đây là một thư viện Go — khoảng 25.300 sao trên GitHub và 1.850 fork — phát hành theo giấy phép Apache-2.0. Nó không phải là một CLI bạn tải về rồi trỏ vào một URL. Bạn viết Go, import Colly, đăng ký vài callback, rồi biên dịch toàn bộ thành một file thực thi duy nhất.
Tư duy sử dụng của nó là theo hướng sự kiện. Bạn gắn handler vào một Collector: OnHTML chạy logic trích xuất cho các CSS selector khớp, OnResponse cung cấp nội dung phản hồi thô, và OnError xử lý các lỗi request. Handler cho link sẽ gọi Visit() trên các URL được phát hiện, còn MaxDepth giới hạn quá trình crawl theo chiều sâu. Với các đường đi chỉ dùng HTTP, máy đích không cần cài Go runtime riêng hay browser; việc file thực thi có hoàn toàn tĩnh hay không còn phụ thuộc vào cờ build và việc dùng CGO, mà lần thử này không ghi nhận phần đó.
Tính năng chính và cách chúng vận hành bên trong
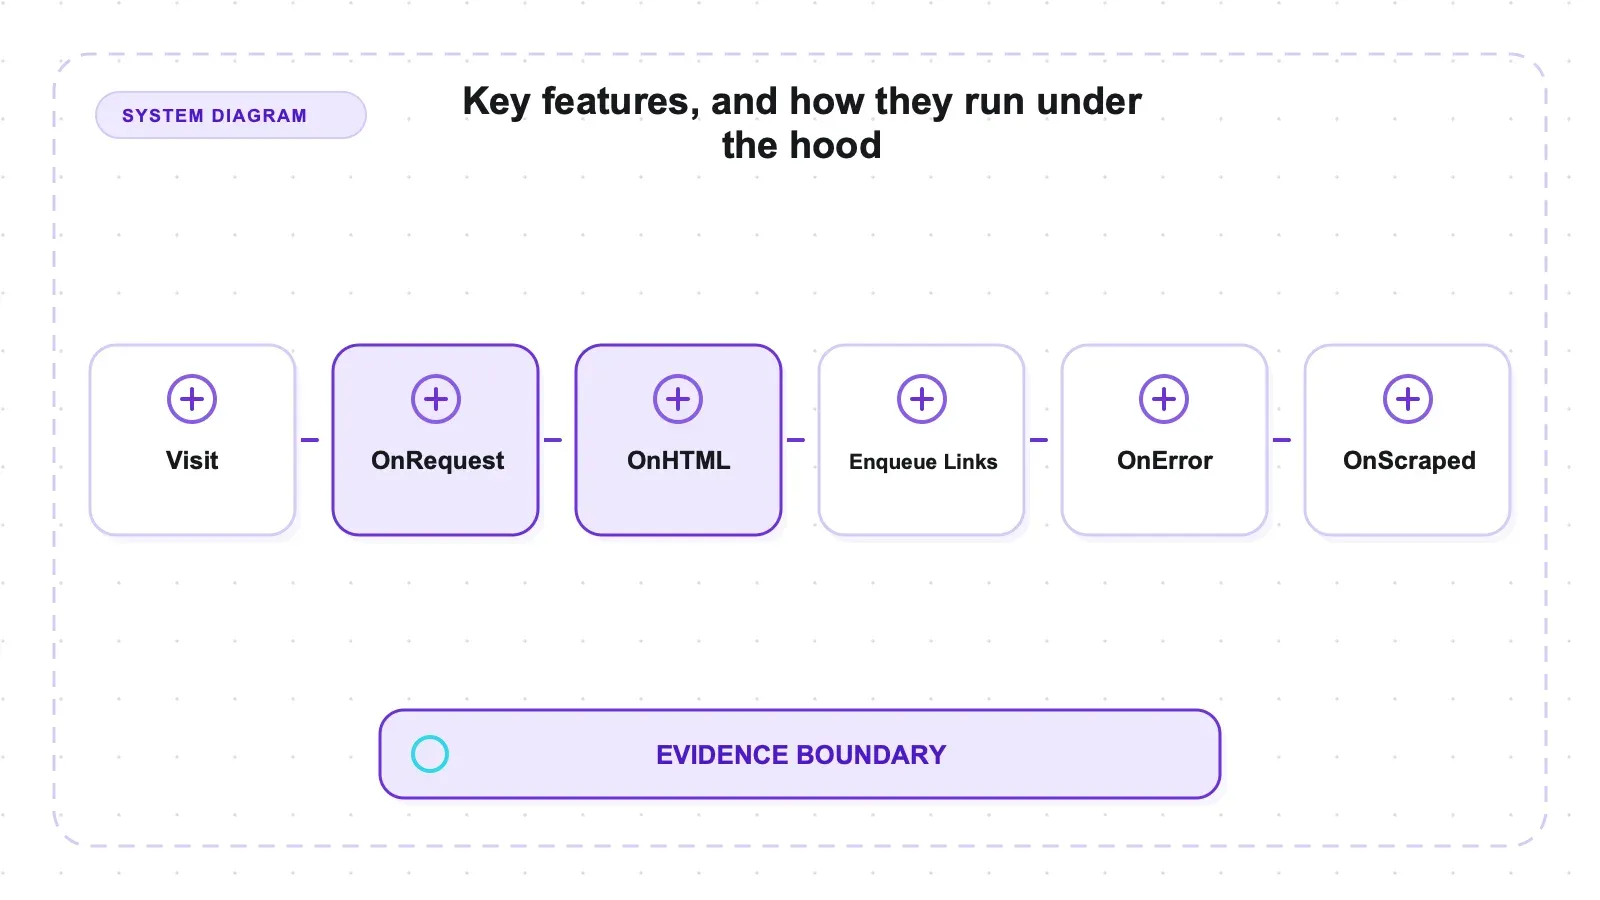
Điều quan trọng cần nắm là mô hình callback, vì chính nó làm Colly khác với kiểu script request-and-parse. Ba callback này xuất hiện trong mọi bài test tôi chạy.
OnHTML(selector, handler) là phần làm việc chính. Đăng ký nó với .product hoặc article p, và Colly sẽ gọi handler của bạn một lần cho mỗi phần tử khớp khi nó phân tích DOM. Đây là nơi dành cho trích xuất có cấu trúc, và nó rất dễ đọc — bạn đang mô tả thứ cần lấy, chứ không phải viết một vòng lặp parse.
OnResponse(handler) nằm thấp hơn một nấc và cho bạn byte thô của phản hồi. Khi mục tiêu trả về JSON thay vì HTML, bạn bỏ qua DOM hoàn toàn và tự unmarshal nội dung body. Chính callback này là lý do Colly xử lý gọn một API JSON trong lần thử của tôi mà không cần bất kỳ bước parse HTML nào.
OnError(handler) xử lý các lỗi request và có thể hiển thị status phản hồi cho code gọi. Trong test này, một phản hồi fixture có status 500 đã đi vào callback đã đăng ký. Retries, timeouts, lỗi DNS, connection reset, panic của callback, lưu trữ bền vững và cảnh báo đều chưa được kiểm tra.
Bên trên các callback là hai tính năng vận hành. MaxDepth giới hạn việc đi theo link theo semantics độ sâu của Colly. Một executable Go đã biên dịch cũng tránh được chuyện phải cài riêng ngôn ngữ runtime trên máy đích. Lần chạy này không ghi nhận cờ build hay trạng thái CGO, nên không thể khẳng định mọi file thực thi tạo ra đều là binary hoàn toàn tĩnh.
Thiết lập: cần có Go toolchain
Câu chuyện về phụ thuộc khá ngắn nhưng có thật, nên tôi nói trước khi bạn cài bất cứ thứ gì. Máy tôi test không có Go, và Colly là một thư viện Go — vì vậy bước đầu tiên là cài Go toolchain lên máy (tôi đã cài Go 1.26.5 qua Homebrew). Nếu đội của bạn không sống sẵn trong hệ sinh thái Go, thì đây mới là chỗ vướng: không phải Colly, mà là môi trường ngôn ngữ nó yêu cầu trước khi biên dịch được một dòng nào.
Khi Go đã sẵn sàng, go get github.com/gocolly/colly/v2 giải quyết về v2.3.0. Các đường đi được test không cần browser hay headless Chrome.
Có một điểm phiên bản dễ gây nhầm cho người đọc. Go module được resolve thành v2.3.0 (phát hành vào tháng 12/2025), trong khi mục mới nhất nhìn thấy trong giao diện Releases của GitHub là v2.2.0 (tháng 3/2025) tại thời điểm kiểm tra. Đây là khác biệt giữa version của module/repository với một release entry trên GitHub, chứ không phải giữa module và Git tag. Tôi đã test v2.3.0.
Thực hành: trích xuất và giới hạn vận hành
Tôi đã chạy Colly trên một server fixture tự chứa (Go httptest) cùng hai site demo công khai. Thư mục benchmark hiện tại và file results/colly-test-summary.json có để lộ artifact, nhưng cả hai link đều trỏ tới một nhánh đang thay đổi. Bài viết không cung cấp commit đã test, command chính xác, cờ build hay seed của fixture, nên đây chưa phải là một recipe có thể tái lập y hệt.
| Bài test | Mục tiêu | Kết quả |
|---|---|---|
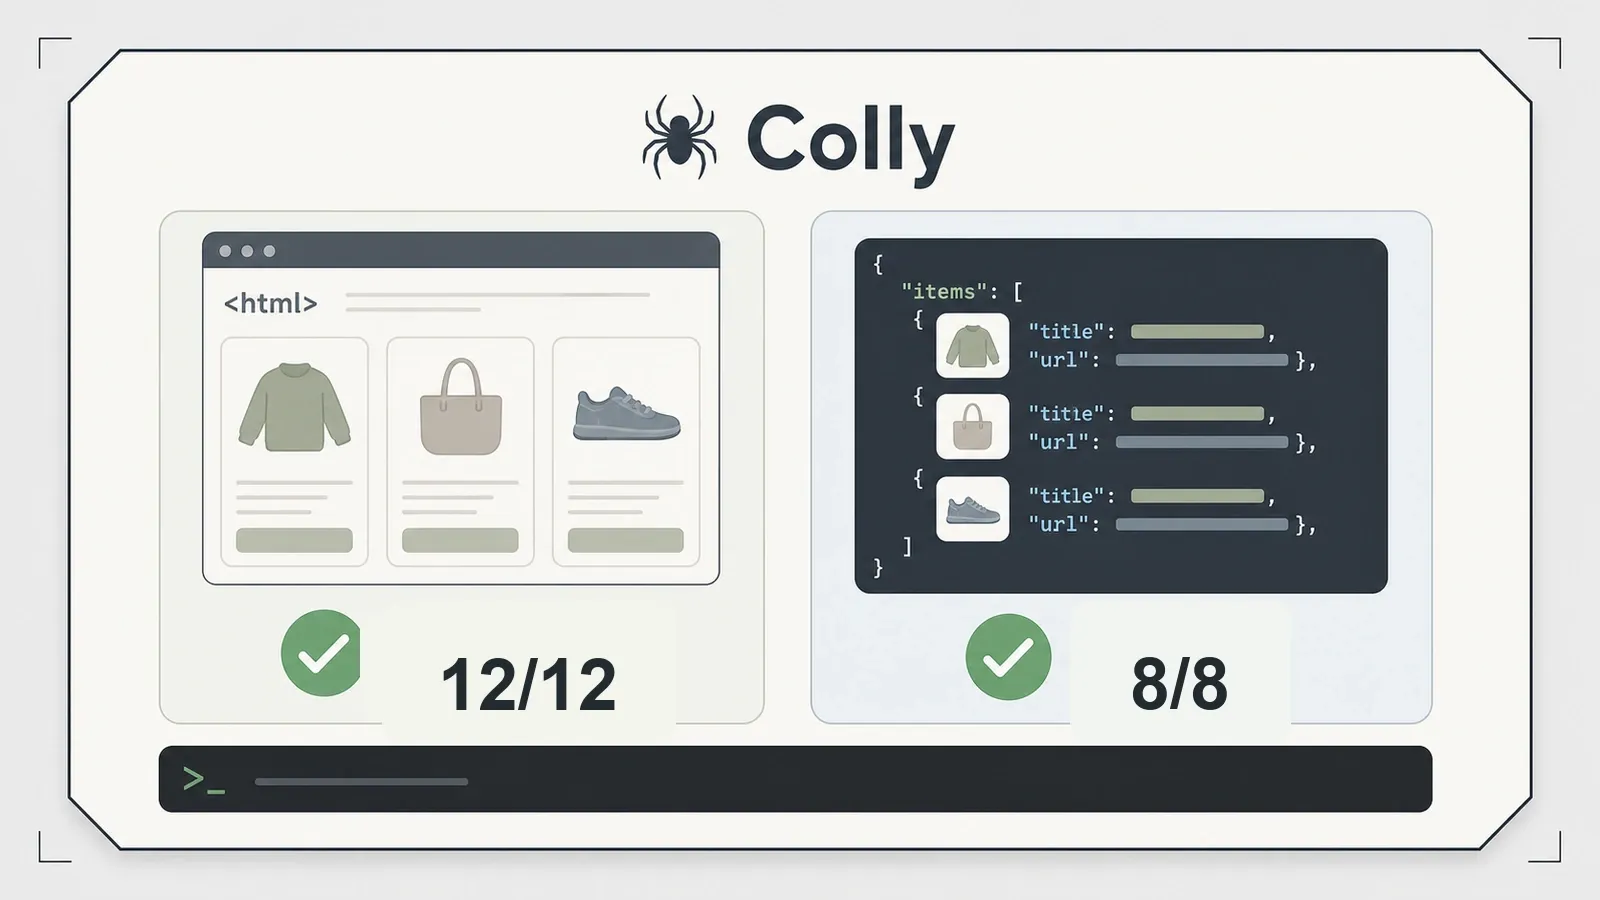
| Danh mục tĩnh + phân trang | fixture cục bộ | trích xuất 12/12 sản phẩm mong đợi |
| Trích xuất bài viết | fixture cục bộ | tiêu đề + 3/3 đoạn văn |
| Phản hồi JSON trực tiếp | fixture cục bộ | 8/8 mục mong đợi qua OnResponse |
| Xử lý HTTP 500 | fixture cục bộ | chuyển sang OnError, status 500 |
Đồ thị crawl (MaxDepth 2) | fixture cục bộ | 17 trang |
| Books to Scrape | demo công khai | 20 sản phẩm |
| Trang động (không JS) | fixture cục bộ | 0 thẻ card (đúng như mong đợi) |
| Quotes JS (không render) | demo công khai | 0 (đúng như mong đợi) |
Với các fixture tĩnh được kiểm soát, selector đã cấu hình cho ra đủ 12/12 bản ghi sản phẩm mong đợi và cả 3 đoạn văn bài viết mong đợi. Phản hồi JSON trực tiếp không hề đi qua HTML parser: OnResponse cung cấp body và harness tự decode đủ 8 mục mong đợi. Fixture 500 duy nhất đã đi vào OnError với status được lộ ra và không làm sập lần chạy đó; điều đó không đồng nghĩa với độ tin cậy khi vận hành không có giám sát. Trên trang công khai Books to Scrape, selector trả về 20 sản phẩm như một bài smoke test trên site thật.
Về mặt crawl đồ thị, collector được cấu hình với MaxDepth(2) theo quy ước seed-depth của harness và đã truy cập 17 URL trong đồ thị fixture. Kết quả này nói về độ phủ crawl, không phải tốc độ. Vết trace quan sát được — chứ không phải một tuyên bố tổng quát cho mọi đồ thị — nằm trong results/local_crawl_graph.json.
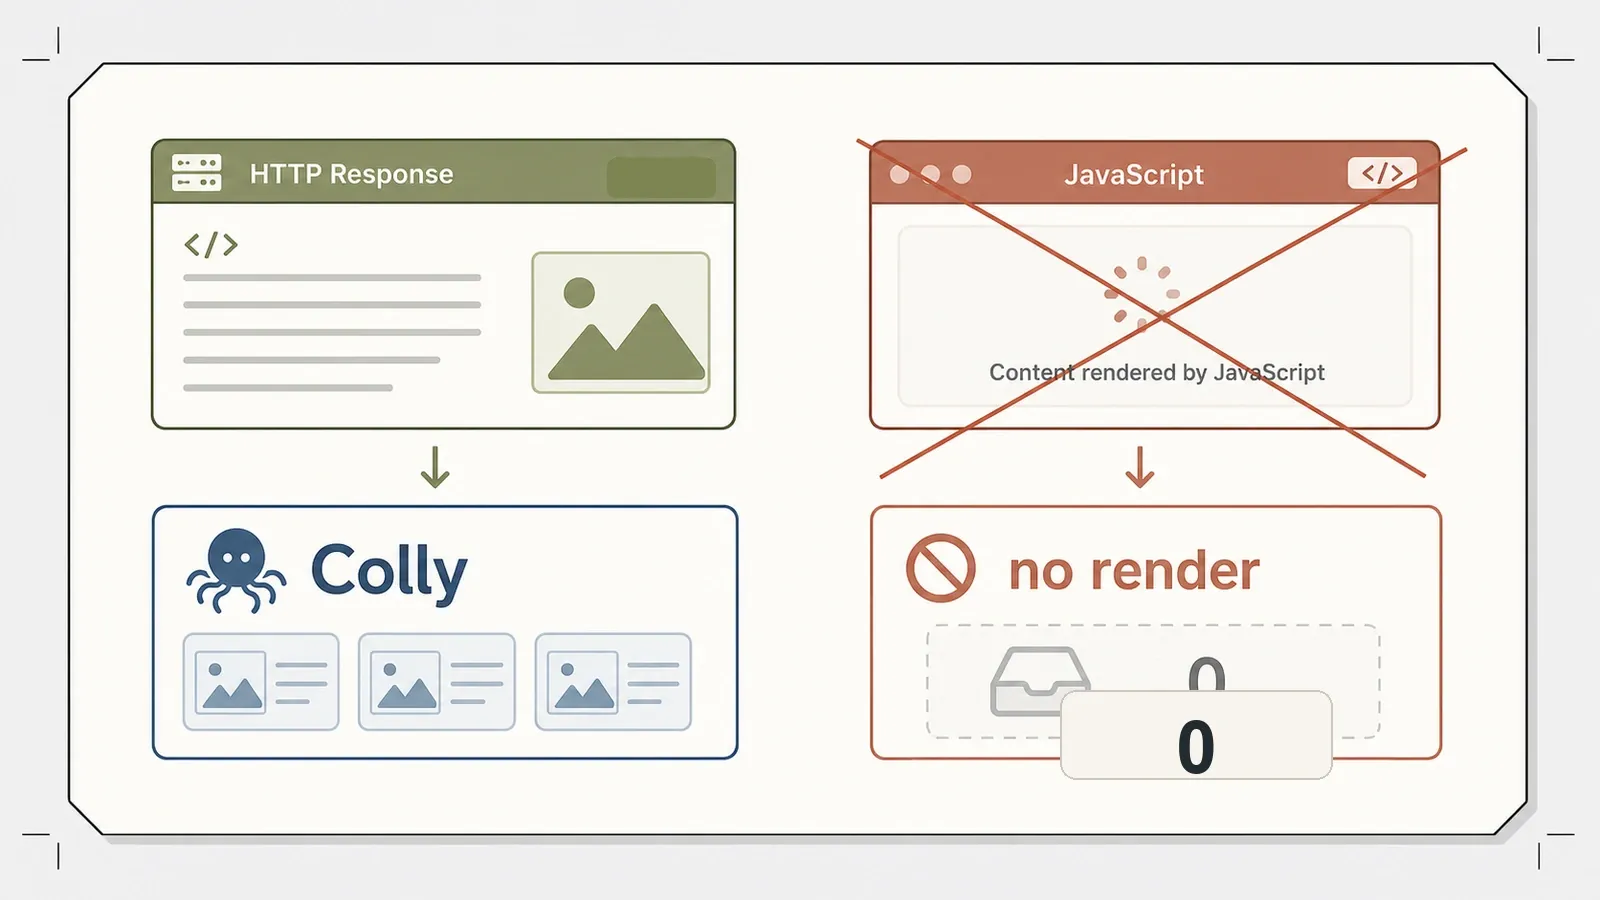
Colly không chạy JavaScript. Fixture render bằng JavaScript trả về 0 thẻ mục tiêu, và trang công khai Quotes to Scrape JS page cũng trả về 0 quote mục tiêu. Nếu phần tử chỉ tồn tại sau khi browser thực thi và không có endpoint nền nào truy cập được để cung cấp chúng, thì đường đi chỉ dùng HTTP sẽ không thể thấy các phần tử đó dưới dạng DOM đã render. Hãy ghép nó với một renderer, hoặc gọi trực tiếp endpoint nền khi có thể, như fixture JSON đã chứng minh.
Tôi không stress test async collector, cấu hình rate limiting hay politeness, xoay proxy, retries, hoặc backend hàng đợi và lưu trữ. Không có số đo thời gian chạy, thông lượng, concurrency, CPU, memory, độ trễ của target hay baseline so sánh nào được ghi nhận. Vì vậy bài viết này không đưa ra tuyên bố nào về tốc độ hay độ tin cậy khi chạy không giám sát.
Cách diễn giải kết quả fixture
Ba đường đi nội dung thành công này kiểm thử các hợp đồng khác nhau. Trường hợp danh mục và bài viết kiểm tra CSS selection trên HTML do server trả về. Mẫu số của chúng là các kỳ vọng fixture được viết trước khi trích xuất: mười hai bản ghi sản phẩm và ba đoạn văn bài viết. Việc báo cáo chúng là “expected records extracted” là có chủ ý. Lần chạy này không định nghĩa fuzzy matching, xử lý trùng lặp, dung sai với trường thiếu, hay một metric recall trên toàn bộ corpus, nên kết quả không nên bị phóng đại thành độ chính xác trích xuất tổng quát.
Trường hợp JSON bỏ qua bước chọn DOM. Colly nhận byte phản hồi qua OnResponse, còn harness thực hiện giải mã JSON. Đây là lý do “Colly không render JavaScript” không có nghĩa là mọi site phụ thuộc client đều không dùng được. Nếu nguồn dữ liệu mà client dùng là một endpoint có thể gọi trực tiếp và request có thể tái hiện ngoài browser, thì HTTP crawler vẫn có thể đủ. Xác thực, chữ ký sinh ra động, state chỉ có trong browser, và cơ chế chống bot có thể thay đổi câu trả lời đó; ở đây không kiểm thử yếu tố nào trong số đó.
Đường đi 500 kiểm thử việc dispatch, không phải khả năng phục hồi. Nó cho thấy callback OnError đã đăng ký nhận được response fixture đó và status của nó. Một crawler production vẫn cần chính sách rõ ràng cho mã có thể retry, backoff, lỗi kết thúc, lưu trữ và cảnh báo. Bài test này không cung cấp bằng chứng cho các lựa chọn đó, và “callback đã chạy” không có nghĩa là “job có thể tin cậy khi không giám sát”.
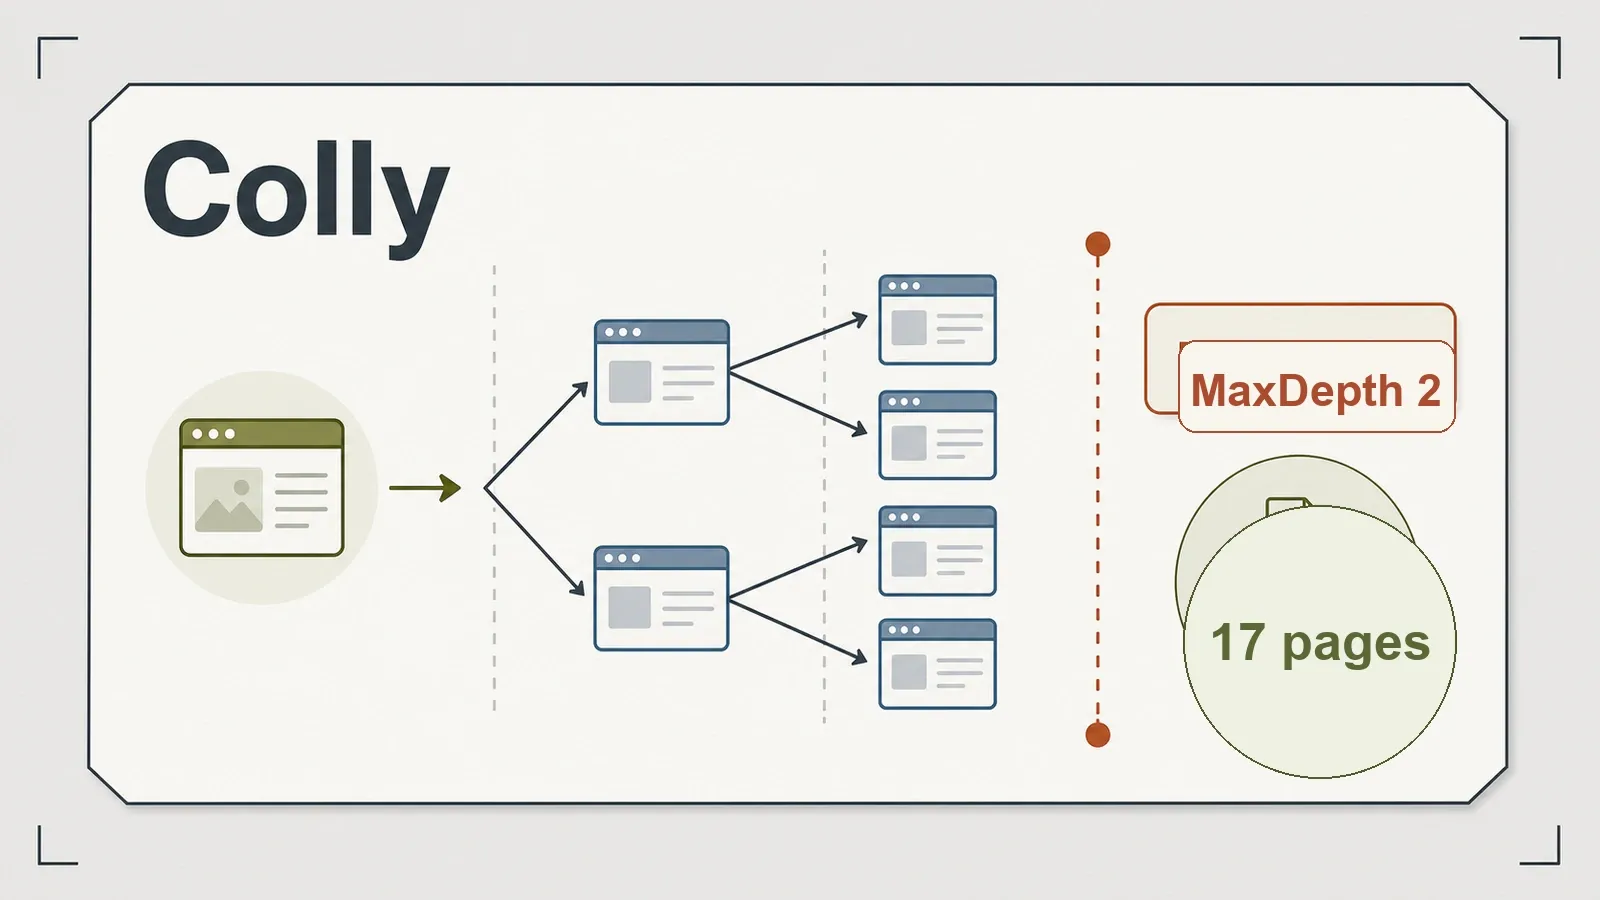
Đồ thị 17 URL cũng tương tự, chỉ mang tính hẹp. Nó xác nhận tập URL đã được ghé thăm của fixture này, theo quy ước seed này, với MaxDepth(2). Nó không chứng minh số trang mỗi giây, sự công bằng giữa các host, mức tăng memory, hay hành vi khi gặp vòng lặp và các dạng URL trùng lặp. Những điều đó cần các bài test workload và queue riêng.
Danh sách kiểm tra lựa chọn, dựa trên lần chạy này
Hãy bắt đầu từ phản hồi mà Colly thực sự nhận được. Nếu các trường cần thiết đã có sẵn trong HTML do server trả về, hãy dùng OnHTML và kiểm tra số lượng field hoặc các key bắt buộc trước khi chấp nhận một record. Nếu phản hồi là JSON, hãy xử lý body qua OnResponse và kiểm tra schema của nó. Nếu HTML chỉ là một lớp vỏ ứng dụng, hãy xem liệu có request nền truy cập được nào chứa dữ liệu hay không trước khi thêm browser.
| Phản hồi chứa gì | Đường đi của Colly | Tiêu chí chấp nhận |
|---|---|---|
| Các trường cần thiết trong HTML do server trả về | selector OnHTML | key bắt buộc và số lượng record mong đợi |
| Một payload JSON có thể gọi trực tiếp | OnResponse kèm decode JSON | kiểm tra schema và các trường bắt buộc |
| Một HTML shell được hỗ trợ bởi request có thể tái hiện | gọi endpoint nền | status phản hồi, schema và độ đầy đủ |
| Dữ liệu chỉ được tạo sau khi browser chạy | thêm renderer hoặc chọn browser crawler | mức sẵn sàng và độ đầy đủ theo từng mục tiêu |
Khi cần browser execution, hãy xem nó như một thành phần khác thay vì mong đợi một cờ của Colly sẽ bật chế độ render. Browser phải thiết lập trạng thái sẵn sàng, lộ nội dung đã render hoặc các phản hồi nền, rồi đưa dữ liệu vào phần còn lại của pipeline. Bài review này không kiểm thử kiểu tích hợp đó.
Khi triển khai, hãy ghi lại phiên bản Go, phiên bản module, cờ build, trạng thái CGO, command chính xác, seed của fixture và commit repository. Những chi tiết đó đang thiếu trong các link xuất bản hiện tại và chính là ranh giới giữa artifact có thể kiểm tra và khả năng tái lập bền vững. Về vận hành, hãy thêm ma trận lỗi và đo workload mà bạn thực sự quan tâm trước khi gọi hệ thống là nhanh hay đáng tin cậy.
Ưu và nhược điểm
Ưu điểm:
- Trích xuất thành công 12/12 sản phẩm danh mục mong đợi và 3/3 đoạn văn bài viết mong đợi qua
OnHTML. - Xử lý JSON gọn qua
OnResponse, không cần parse DOM — 8/8 mục API. - Phản hồi 500 trong test đã đi tới
OnErrorvới status được hiển thị. - Crawl giới hạn độ sâu đã đi được 17 trang từ một collector duy nhất.
- Biên dịch thành một executable Go; máy đích không cần Go runtime cài riêng cho các đường đi đã test.
- Giấy phép Apache-2.0 thân thiện và khá thoáng.
Nhược điểm:
- Không chạy JavaScript — nội dung render phía client trả về 0, hết.
- Cần Go toolchain; đội không dùng Go sẽ phải trả chi phí thiết lập này trước khi viết scraper nào.
- Module đã test (
v2.3.0) đi trước mục GitHub Release mới nhất quan sát được (v2.2.0). - Output là code của chính bạn — Colly đưa callback cho bạn, chứ không phải một dataset/feed exporter tích hợp sẵn như Scrapy.
- Async, rate limiting, proxy và queue backend có tồn tại nhưng chưa được test ở đây; thông lượng và quy mô vẫn chưa được đo.
Phù hợp với ai — và ai nên bỏ qua
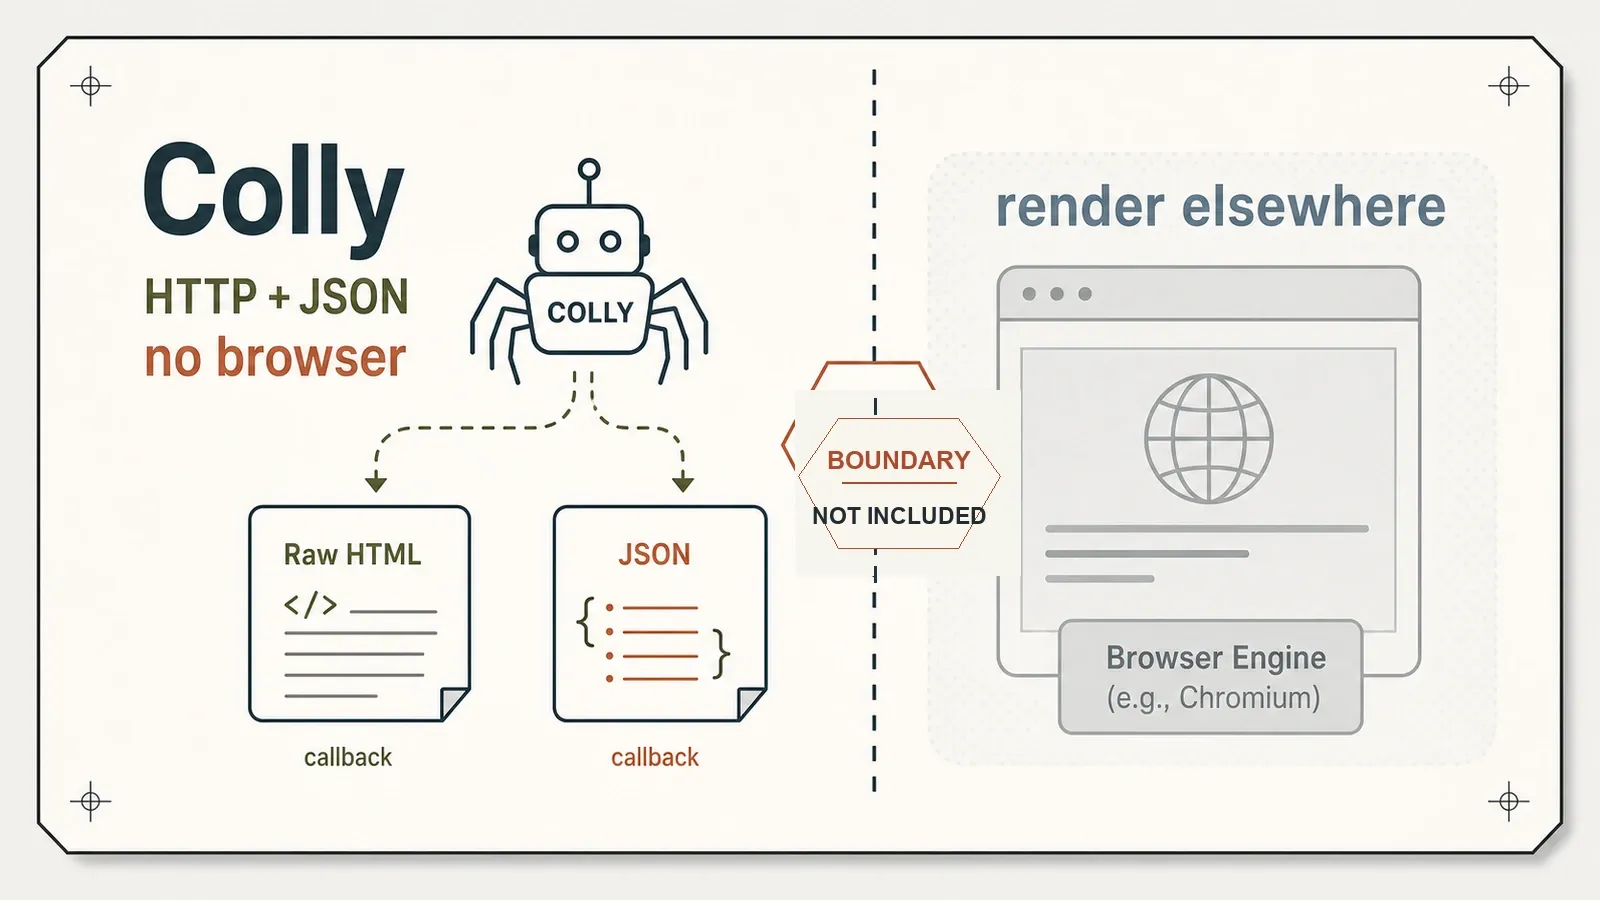
Colly phù hợp nếu bạn đã viết Go và nhắm tới HTML do server render hoặc JSON truy cập trực tiếp. Mô hình callback tách riêng các match có cấu trúc, payload thô và lỗi request. Một executable đã biên dịch cũng tránh được việc phải cài môi trường ngôn ngữ riêng trên máy đích, dù ở đây chưa xác minh link tĩnh hoàn toàn.
Hãy thêm renderer khi các phần tử mục tiêu chỉ xuất hiện sau khi browser chạy và không có endpoint nền nào hữu dụng. Một endpoint JSON trực tiếp vẫn có thể gọi mà không cần render. Colly cũng kém phù hợp hơn với đội không muốn dùng Go toolchain, hoặc những đội muốn một dịch vụ trích xuất lo luôn việc shaping schema và bảo trì selector.
Các lựa chọn thay thế, bao gồm vị trí của Thunderbit
Colly là phần mềm mã nguồn mở mà bạn tự vận hành. Nó không có phí sử dụng từ nhà cung cấp, nhưng bạn vẫn phải chịu chi phí compute, băng thông, proxy, storage, observability và công sức kỹ thuật. Bạn tự chịu trách nhiệm về hành vi request, callback parse, logic crawl, và tích hợp browser nếu target cần render.
Một dịch vụ trích xuất được quản lý sẽ chuyển một phần trách nhiệm đó sang nhà cung cấp. Chúng tôi xây dựng Thunderbit, nhưng chưa test nó trên các fixture này, nên bài viết này không đưa ra so sánh về render, chống bot, chất lượng, độ trễ hay chi phí. Điểm khác biệt đáng nói là quyền sở hữu: Colly đưa phản hồi HTTP và callback vào process Go của bạn; một dịch vụ được quản lý có thể chịu trách nhiệm thu thập và shaping schema với phí tính theo lần gọi.
Các bài review benchmark liên quan: so sánh đầy đủ các scraper mã nguồn mở, review crawler Python Scrapy, và review selector thích ứng của Scrapling.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Colly là một lựa chọn mạnh cho các đội Go nhắm tới HTML do server render hoặc JSON trực tiếp và sẵn sàng tự quản lý code trích xuất của mình. Các fixture ở đây hỗ trợ việc trích xuất đúng bản ghi mong đợi, một trace crawl bị giới hạn, và một callback 500 quan sát được — nhưng không hỗ trợ tuyên bố về tốc độ, quy mô hay độ tin cậy khi chạy không giám sát. DOM render phía browser cần một đường đi khác, trừ khi endpoint dữ liệu nền có thể gọi trực tiếp.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Bài review này có đo tốc độ của Colly không? Không. Nó đo việc trích xuất đúng bản ghi mong đợi, xử lý JSON trực tiếp, một callback lỗi, và phạm vi phủ của một đồ thị crawl fixture. Nó không đo thời gian chạy, thông lượng, concurrency, CPU, memory hay baseline so sánh.
Colly có thể scrape các trang render bằng JavaScript không? Colly không thực thi JavaScript của trang. Vì vậy đường đi HTTP đã test không tìm thấy các phần tử chỉ xuất hiện trong DOM đã render. Tuy nhiên nó vẫn có thể gọi trực tiếp một JSON endpoint nền có thể truy cập, như fixture JSON đã cho thấy. Hãy dùng renderer khi việc thực thi là bắt buộc và không có request nền nào tái hiện được cung cấp dữ liệu.
Tôi có cần biết Go để dùng Colly không?
Có. Colly là một thư viện Go, không phải CLI độc lập — bạn import nó, đăng ký callback (OnHTML, OnResponse, OnError), rồi biên dịch. Máy tôi test không có Go, nên bước thiết lập bắt đầu bằng việc cài Go toolchain (1.26.5). Nếu đội của bạn chưa ở trong hệ sinh thái Go, thì môi trường này mới là chi phí thiết lập thực sự.
Vì sao version tôi cài không khớp với GitHub release mới nhất của Colly?
Go module được resolve thành v2.3.0 (tháng 12/2025), trong khi mục GitHub Release mới nhất quan sát được là v2.2.0 (tháng 3/2025). Tôi đã test v2.3.0; đây là khác biệt giữa các bề mặt version, không phải bằng chứng của việc cài đặt lỗi.
Colly có miễn phí cho mục đích thương mại không? Có, giấy phép là Apache-2.0, khá thoáng và thân thiện với thương mại. Như mọi khi, hãy xác nhận giấy phép hiện tại trên repo trước khi xây dựng trên đó.
Trước khi đưa vào production, hãy bổ sung các bài test phản ánh rủi ro vận hành thay vì suy luận từ fixture. Hãy đo thời gian của các lần crawl lặp lại trên target đại diện, ghi CPU và peak memory, kiểm thử các lỗi có thể retry và lỗi kết thúc, và xác minh tính lịch sự khi chạy đồng thời. Nếu việc lưu trạng thái là quan trọng, hãy dừng và tiếp tục lại một crawl trong khi kiểm tra cách xử lý trùng lặp và trạng thái queue. Nếu sự đơn giản khi triển khai là quan trọng, hãy ghi lại chính xác cấu hình compiler và linker rồi kiểm tra các phụ thuộc runtime của executable tạo ra. Không điều gì trong số đó thay đổi những gì fixture hiện tại đã chứng minh; chúng chỉ quyết định liệu cùng một cấu hình thư viện đó có phù hợp với một job production cụ thể hay không.




