
Hầu hết mọi người cứ nghĩ rằng chỉ cần cắm một IP proxy vào là có thể scrape mọi thứ, vào được bất kỳ trang nào bị giới hạn theo khu vực, hay chạy 50 tài khoản mạng xã hội mà chẳng gặp rắc rối gì. Nhưng thực tế thì không phải vậy. (Còn lâu mới đúng.)
Bức tranh proxy năm 2026 phức tạp hơn — và cũng có giá trị thương mại lớn hơn — so với những gì đa số bài hướng dẫn thường nói. Quy mô thị trường proxy server hiện được ước tính vào khoảng 1,9 tỷ USD vào năm 2026, tăng trưởng khoảng 6,5% CAGR đến năm 2031, nhờ web scraping, theo dõi giá, xác minh quảng cáo và thu thập dữ liệu quy mô lớn. Tuy nhiên, khoảng cách giữa “tôi đã mua proxy” và “tôi đang lấy được dữ liệu ổn định” ngày càng lớn hơn, vì các hệ thống anti-bot ngày càng tinh vi. Hướng dẫn này sẽ giải thích proxy thực chất là gì, cách chọn đúng loại (kèm giá thực tế năm 2026), cách thiết lập, điều gì khiến bạn bị chặn, khi nào bạn thậm chí không cần tự quản lý proxy, và những bẫy thanh toán có thể làm cả người mua nhiều kinh nghiệm cũng mắc kẹt. Sales, vận hành, ecommerce, nghiên cứu thị trường — dù bạn làm gì — đây là tài liệu thực chiến mà tôi ước mình đã có khi bắt đầu bước vào lĩnh vực này.
Proxy là gì và chúng hoạt động như thế nào?
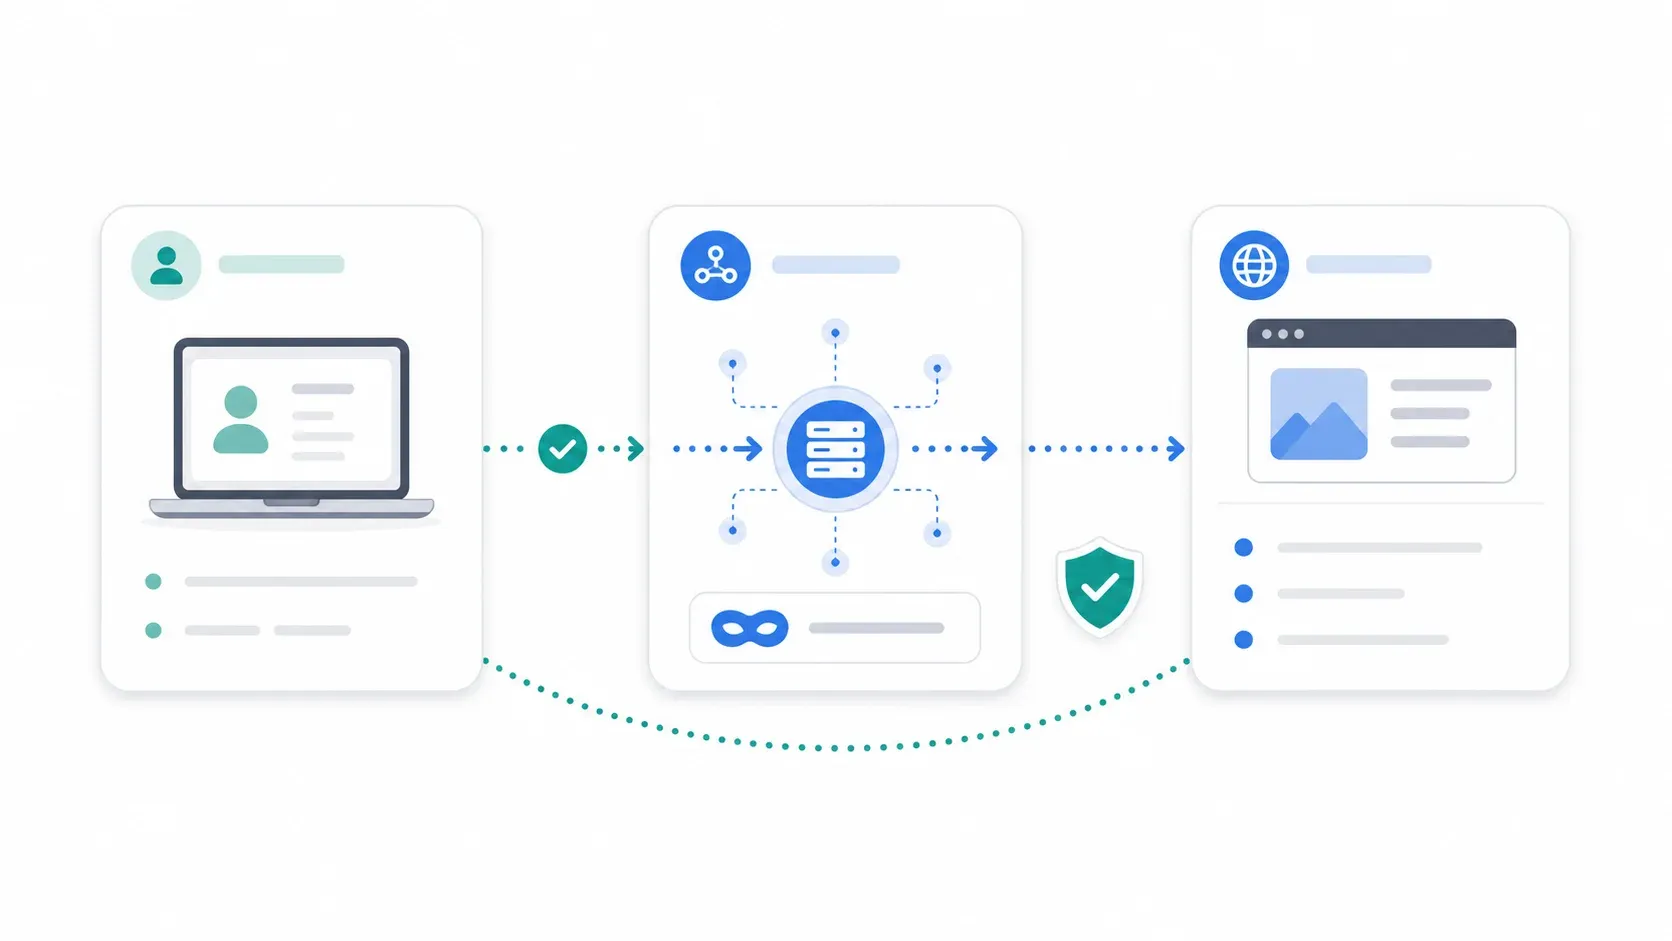
Proxy server nằm giữa thiết bị của bạn (hoặc công cụ scraping) và website bạn đang truy cập. Khi dùng proxy, request của bạn sẽ đi đến proxy trước, proxy chuyển tiếp đến website đích, website phản hồi về proxy, rồi proxy gửi kết quả lại cho bạn. Website đích chỉ thấy IP của proxy, không thấy IP thật của bạn.
Hãy tưởng tượng như có một người khác đi lấy thư hộ bạn từ hộp thư P.O. box. Người gửi sẽ không bao giờ nhìn thấy địa chỉ nhà bạn — họ chỉ thấy P.O. box.
Luồng hoạt động cơ bản như sau:
Thiết bị / scraper của bạn → Proxy server → Website đích
                                ↓
Thiết bị / scraper của bạn ← Proxy server ← Website đích
Một điểm rất quan trọng cần phân biệt: proxy hoạt động ở tầng ứng dụng. Chúng định tuyến lưu lượng cho một trình duyệt, một ứng dụng hoặc một thư viện scraping cụ thể — chứ không phải mặc định là toàn bộ traffic của thiết bị. Điều này khác với VPN, vốn thường bọc toàn bộ lưu lượng ở cấp hệ thống. Phần so sánh đó tôi sẽ nói ngay tiếp theo.
Những hiểu lầm phổ biến cần bỏ ngay:
- “Proxy khiến tôi vô hình.” Proxy có thể che IP, nhưng không tự động che browser fingerprint, TLS handshake, DNS leak, cookie hay mẫu hành vi. BrowserLeaks không chỉ lộ IP và vị trí, mà còn cả dữ liệu WebRTC, DNS, TLS và HTTP/2 fingerprint — những thứ vẫn có thể tố cáo bạn dù đang dùng proxy.
- “Residential proxy thì không thể bị chặn.” Đúng là khó bị gắn cờ hơn. Nhưng không có nghĩa là miễn nhiễm. Các nhà cung cấp anti-bot chấm điểm hành vi và độ nhất quán của thiết bị, chứ không chỉ nguồn IP.
- “Rotate càng nhiều càng tốt.” Rotate quá mức có thể trông rất thiếu tự nhiên, làm hỏng session và khiến uy tín IP bị đốt nhanh hơn.
- “Proxy miễn phí là đủ cho công việc kinh doanh.” Browserless phát hiện tỷ lệ thành công dưới 5% trên nhiều danh sách proxy công khai miễn phí trong một bài test năm 2026. Không phải lỗi gõ.
Proxy vs. VPN: Bạn thực sự cần cái nào?
Mọi bài viết về proxy đều nên có phần so sánh này. Nhiều bài bỏ qua. Proxy và VPN đều thay đổi IP mà bên ngoài nhìn thấy. Nhưng điểm giống nhau gần như chỉ dừng ở đó.
| Khía cạnh | Proxy | VPN |
|---|---|---|
| Mã hóa | Tùy loại. HTTPS proxy mã hóa đến proxy; HTTP proxy truyền dữ liệu dạng rõ | Luôn có — đường hầm mã hóa toàn bộ |
| Phạm vi lưu lượng | Theo ứng dụng, theo trình duyệt hoặc theo công cụ | Toàn hệ thống (mọi traffic của thiết bị) |
| Ảnh hưởng tốc độ | Thường nhanh hơn (ít overhead hơn) | Chậm hơn một chút (do chi phí mã hóa) |
| Phù hợp nhất cho | Scraping, mở khóa theo khu vực, multi-account, xác minh quảng cáo, theo dõi giá | Quyền riêng tư, an toàn khi dùng Wi‑Fi công cộng, truy cập từ xa cho doanh nghiệp |
| Mô hình chi phí | Tính theo GB, theo IP hoặc theo port (linh hoạt) | Thường $2–4/tháng cố định trong các gói dài hạn |
| Độ phức tạp vận hành | Cao hơn — phải quản lý loại IP, rotation, session, block | Thấp hơn cho nhu cầu duyệt web thông thường |
Hướng dẫn giá VPN năm 2026 của Norton cho thấy các gói VPN dài hạn rẻ nhất vào khoảng $1–4/tháng. Trong khi đó, nhà cung cấp proxy thường tính theo GB, theo IP hoặc theo port, vì vậy người dùng trên Reddit hay than rằng proxy “đắt hơn” dù từ góc nhìn người dùng cuối nó “làm ít hơn”.
Khi nào chọn Proxy thay vì VPN, và ngược lại?
Dùng proxy khi:
- Bạn scrape website ở quy mô lớn và cần rotate IP giữa các request
- Bạn cần dữ liệu theo khu vực (ví dụ: kiểm tra giá ở Đức khi đang ngồi ở Texas)
- Bạn quản lý nhiều tài khoản và muốn mỗi tài khoản trông như một người dùng khác nhau
- Bạn làm xác minh quảng cáo và cần kiểm soát chi tiết vị trí IP đầu ra
Dùng VPN khi:
- Bạn muốn bảo vệ toàn bộ traffic của thiết bị khi dùng Wi‑Fi công cộng
- Bạn cần truy cập từ xa cho doanh nghiệp với mã hóa
- Mục tiêu là duyệt web ưu tiên riêng tư, không phải trích xuất dữ liệu
Dùng cả hai khi:
- Bạn vận hành hoạt động scraping từ mạng nội bộ doanh nghiệp, nơi mọi traffic phải được mã hóa, nhưng vẫn cần định tuyến proxy theo từng công cụ để xoay vòng IP
Nếu mục tiêu chính của bạn là trích xuất dữ liệu có cấu trúc — danh sách sản phẩm, thông tin liên hệ, kết quả tìm kiếm — hãy đọc tiếp. Phía sau sẽ có phần nói về trường hợp bạn có thể không cần tự quản lý proxy.
Các loại proxy được giải thích dễ hiểu
“Proxy” là một thuật ngữ bao trùm hơn 10 loại khác nhau, và chọn sai loại là sai lầm phổ biến nhất — đồng thời đắt đỏ nhất — trong lĩnh vực này. Hãy tách chúng theo kiến trúc/mục đích và theo nguồn IP.
Forward, Reverse và Transparent Proxy
- Forward proxy: Nằm trước client, định tuyến các request đi ra ngoài. Đây là loại mà đa số mọi người nghĩ tới khi nhắc đến “proxy”. Loại này dùng cho scraping, truy cập theo khu vực và quản lý tài khoản.
- Reverse proxy: Nằm trước server, xử lý traffic đi vào. Website sử dụng loại này (ví dụ Cloudflare, Nginx). Bạn, với vai trò là người scrape hay người dùng doanh nghiệp, không mua reverse proxy — website mới là bên triển khai.
- Transparent proxy: Hoạt động mà người dùng cuối không biết. Thường được tổ chức dùng để lọc nội dung hoặc cache. Không phải loại bạn mua cho dữ liệu.
Anonymous proxy và High-Anonymity (Elite) proxy
- Anonymous proxy che IP thật của bạn nhưng vẫn có thể để lộ rằng bạn đang dùng proxy (thông qua các header như
X-Forwarded-For). - High-anonymity (elite) proxy che cả IP lẫn việc bạn đang đi qua proxy. Chúng xóa toàn bộ header nhận diện.
Khi nào điều này quan trọng? Anonymous đủ cho nhu cầu mở khóa cơ bản theo khu vực hoặc scraping ít nhạy cảm. Elite là lựa chọn khi website đích có anti-bot mạnh và bạn cần trông như một người dùng bình thường.
SOCKS5 proxy: Khi HTTP proxy là chưa đủ
SOCKS5 proxy hoạt động ở tầng mạng thấp hơn so với HTTP/HTTPS proxy. Chúng có thể xử lý mọi loại traffic — không chỉ request web — nên hữu ích cho ứng dụng không chạy trên browser, traffic UDP, hoặc các công cụ cần định tuyến linh hoạt hơn. Các nhà cung cấp lớn như Bright Data, Oxylabs, Decodo, NetNut và IPRoyal đều hỗ trợ SOCKS5 ở một số gói, theo bảng benchmark SOCKS5 năm 2026 của AIMultiple.
Đổi lại, SOCKS5 hơi khó cấu hình hơn proxy HTTP tiêu chuẩn, và không phải công cụ nào cũng hỗ trợ sẵn.
Residential, Datacenter, ISP và Mobile proxy: Khung ra quyết định kèm giá năm 2026
Người mua proxy nào cũng hỏi cùng một câu: “Tôi nên mua loại nào, và sẽ tốn bao nhiêu?”
Dưới đây là giá năm 2026 lấy từ trang chính thức của nhà cung cấp — số thực, không phải khoảng ước lượng mơ hồ.
Residential proxy: Uy tín cao, chi phí cũng cao
Residential proxy dùng IP được nhà mạng cấp cho các hộ gia đình thật, nên website rất tin tưởng — traffic trông như người dùng bình thường ở nhà.
- Phù hợp nhất cho: Scraping các site có anti-bot gắt (ecommerce, mạng xã hội, travel), nghiên cứu thị trường theo khu vực
- Nhược điểm: Đắt theo GB, chậm hơn datacenter
- Ví dụ giá 2026:
- Bright Data: pay-as-you-go khoảng ~$8/GB niêm yết, khuyến mãi ~$4/GB, bậc theo khối lượng xuống tới ~$3/GB
- Oxylabs: $6/GB gói starter, $5/GB basic, $4/GB advanced, $2.50/GB corporate
- Decodo: $3.75/GB ở mức 3GB, $3.00/GB ở mức 50GB, với các gói quảng bá từ $2/GB
- IPRoyal: residential proxy từ $1.75/GB
Khoảng giá thực tế: khoảng USD $2–8/GB với các gói phổ biến trên thị trường. Nhà cung cấp giá rẻ và chương trình khuyến mãi có thể thấp hơn; cam kết doanh nghiệp đôi khi còn giảm thêm mức giá hiệu dụng.
Residential proxy hỗ trợ cả session rotating (đổi IP theo mỗi request hoặc theo khoảng thời gian — tốt cho scraping không trạng thái) và session sticky (giữ cùng IP trong một khoảng thời gian — tốt cho luồng đăng nhập hoặc thao tác nhiều bước).
Datacenter proxy: Nhanh, rẻ, nhưng dễ bị phát hiện hơn
Datacenter proxy đến từ các nhà cung cấp cloud hosting — nhanh và rẻ, nhưng không gắn với nhà mạng thật. Hệ thống anti-bot có thể gắn cờ loại này bằng ASN gần như không cần cố.
- Phù hợp nhất cho: Scraping khối lượng lớn trên các site ít được bảo vệ, theo dõi thứ hạng SEO, kiểm tra tình trạng sẵn sàng đơn giản
- Nhược điểm: Dễ bị chặn hơn trên các mục tiêu được bảo vệ tốt (mạng xã hội, marketplace)
- Ví dụ giá 2026:
- Bright Data: datacenter proxy từ khoảng ~$0.90/IP
- Oxylabs: datacenter proxy khoảng ~$1.20/IP (tính theo IP, băng thông không giới hạn theo nguyên tắc sử dụng hợp lý)
ISP proxy: Lựa chọn ở giữa
ISP proxy nằm trong môi trường giống datacenter nhưng mang IP được đăng ký dưới tên nhà mạng thật — tốc độ của datacenter nhưng độ tin cậy kiểu ISP.
- Phù hợp nhất cho: Session dài, quản lý mạng xã hội, multi-account
- Ví dụ giá 2026:
- Oxylabs: ISP proxy $1.60/IP gói starter, $1.30/IP advanced, $1.20/IP premium
- Bright Data: ISP proxy từ khoảng ~$1.30/IP
Đây là câu trả lời cho câu hỏi muôn thuở trên forum: “ISP và residential khác gì nhau thật sự?” Khác biệt nằm ở vị trí hosting so với cách IP được đăng ký. ISP proxy nhanh và ổn định hơn cho session kéo dài; residential proxy có đa dạng IP hơn cho các tác vụ scraping cần xoay vòng liên tục.
Mobile proxy: Khó chặn nhất
Mobile proxy đi qua mạng di động của nhà mạng (4G/5G). Hàng nghìn người dùng thật cùng chia sẻ dải NAT của nhà mạng, nên nếu chặn một IP đầu ra thì có nguy cơ ảnh hưởng nhầm đến người dùng thật. Website biết điều này và thường ngại ra tay.
- Phù hợp nhất cho: Tự động hóa mạng xã hội, xác minh quảng cáo, các tài khoản cực kỳ nhạy với việc bị khóa
- Nhược điểm: Đắt nhất, tốc độ chậm hơn, nguồn cung hạn chế
- Giá 2026: Decodo niêm yết mobile proxy từ $2.25/GB. Thực tế có thể kỳ vọng khoảng USD $4–25/GB hoặc tính theo IP/tháng tùy nhà cung cấp và gói.
Bảng quyết định tổng hợp
| Loại proxy | Phù hợp nhất cho | Mức ẩn danh/độ tin cậy | Tốc độ | Tín hiệu giá 2026 | Rủi ro bị phát hiện | Kiểu session |
|---|---|---|---|---|---|---|
| Residential | Ecommerce, travel, social, nghiên cứu theo khu vực | Cao | Trung bình | Phổ biến $2–8/GB | Trung bình-thấp | Rotating hoặc sticky |
| Datacenter | Theo dõi SEO, scraping đơn giản, khối lượng lớn | Thấp-trung bình | Cao | Khoảng ~$0.90–1.20/IP | Cao trên site được bảo vệ | Dedicated/shared |
| ISP | Ổn định tài khoản, multi-account, session dài | Trung bình-cao | Cao | Khoảng ~$1.20–1.60/IP | Trung bình | Sticky/static |
| Mobile | Mạng xã hội, xác minh quảng cáo, tài khoản nhạy cảm | Rất cao | Thấp-trung bình | $4–25/GB hoặc theo IP/tháng | Thấp (nhưng không miễn nhiễm) | Sticky/rotating |
| SOCKS5 | Ứng dụng không chạy trên browser, UDP, định tuyến linh hoạt | Phụ thuộc nguồn IP | Phụ thuộc | Thường là tùy chọn giao thức | Phụ thuộc | Phụ thuộc |
Lưu ý: Giá thay đổi rất nhanh. Luôn kiểm tra trang nhà cung cấp trước khi chốt mua.
Cây quyết định 3 câu hỏi: Loại proxy nào phù hợp với bạn?
-
Tôi dùng proxy để làm gì?
- Scraping → residential hoặc datacenter (tùy mức phòng vệ của site)
- Multi-account → mobile hoặc ISP
- Quyền riêng tư/mở khóa cơ bản theo khu vực → anonymous hoặc elite
-
Tôi có cần giữ session không?
- Có (luồng đăng nhập, giỏ hàng, quản lý tài khoản) → sticky sessions
- Không (scraping không trạng thái, kiểm tra SERP) → rotating sessions
-
Ngân sách của tôi trên mỗi GB là bao nhiêu?
- Hạn chế → datacenter
- Trung bình → ISP hoặc residential
- Linh hoạt → mobile
Cách thiết lập và sử dụng proxy: Từng bước một
- Độ khó: Cơ bản
- Thời gian cần thiết: Khoảng 15–20 phút cho lần thiết lập đầu tiên
- Bạn cần: Tài khoản nhà cung cấp proxy, trình duyệt Chrome (hoặc công cụ scraping bạn chọn), và một URL đích để thử
Bước 1: Chọn nhà cung cấp proxy và gói dịch vụ
Bảng xếp hạng từ các trang tổng hợp review thường có yếu tố quảng cáo trả tiền. Cảm nhận của cộng đồng trên Reddit và forum chuyên ngành thường cho góc nhìn thật hơn. Các tiêu chí nên xem:
- Kích thước IP pool và phạm vi địa lý
- Có hỗ trợ kiểu session nào (rotating, sticky hay cả hai)
- Giới hạn băng thông và mô hình tính phí (theo GB, theo IP, flat rate)
- Có bản dùng thử hay không — luôn nên bắt đầu bằng trial hoặc gói pay-as-you-go trước khi cam kết hợp đồng tháng
Bước 2: Cấu hình proxy trong trình duyệt hoặc công cụ của bạn
Với cách dùng trên browser, phương án phổ biến nhất là dùng tiện ích quản lý proxy. FoxyProxy là một lựa chọn mã nguồn mở phổ biến cho Chrome. Quy trình thiết lập:
- Cài FoxyProxy từ Chrome Web Store
- Mở phần tùy chọn của FoxyProxy
- Chọn cấu hình proxy thủ công
- Nhập Host/IP và port từ dashboard của nhà cung cấp
- Thêm username và password nếu cần
- Bật chế độ FoxyProxy để định tuyến traffic qua proxy
Với công cụ scraping (Puppeteer, Playwright, script tự viết), bạn thường truyền thông tin xác thực proxy theo định dạng:
http://username:password@host:port
socks5://username:password@host:port
Hầu hết nhà cung cấp proxy đều có tài liệu hướng dẫn riêng cho dịch vụ của họ và các công cụ phổ biến.
Bước 3: Kiểm tra kết nối proxy
Trước khi chạy workload thật, hãy xác minh bốn điều:
- Truy cập một trang kiểm tra IP như WhatIsMyIPAddress.com để xác nhận IP đã thay đổi
- Kiểm tra vị trí proxy có khớp với khu vực mục tiêu hay không
- Dùng BrowserLeaks để kiểm tra WebRTC leak, DNS leak, TLS fingerprint và các tín hiệu khác có thể làm lộ danh tính thật của bạn
- Với kiểm tra fingerprint nâng cao hơn, thử PixelScan để xác nhận browser fingerprint đồng nhất với vị trí của proxy
Nếu IP đã đổi nhưng BrowserLeaks vẫn cho thấy WebRTC leak lộ IP thật, thì cấu hình proxy của bạn chưa hoàn chỉnh. Hãy sửa rò rỉ trước khi tiếp tục.
Bước 4: Rotate proxy và quản lý session
- Với scraping không trạng thái: Thiết lập khoảng thời gian rotate — đổi IP sau mỗi N request hoặc sau mỗi N phút. Nhiều nhà cung cấp có endpoint backconnect tự động xử lý rotation.
- Với multi-account hoặc session đã đăng nhập: Dùng sticky session để mỗi tài khoản luôn đi qua cùng một IP. Cấu hình thời lượng session theo tùy chọn của nhà cung cấp (thường 1–30 phút với residential sticky session).
Sự khác nhau giữa rotation do nhà cung cấp quản lý (backconnect) và rotation thủ công rất quan trọng. Backconnect đơn giản hơn — bạn chỉ cần gọi một URL gateway, còn nhà cung cấp sẽ xoay IP ở phía sau. Rotation thủ công nghĩa là bạn tự duy trì danh sách IP và tự luân chuyển.
Bước 5: Theo dõi và xử lý sự cố
- Theo dõi block, CAPTCHA hoặc mã trạng thái 403/429 đột ngột — đó là dấu hiệu bạn cần điều chỉnh tốc độ rotate, đổi loại proxy, hoặc giảm tốc độ request
- Theo dõi mức sử dụng băng thông trên dashboard của nhà cung cấp để tránh bất ngờ về hóa đơn
- Chú ý session bị rớt, đặc biệt với sticky session trên residential proxy. Các thread trên Reddit liên tục nhắc đây là vấn đề vận hành có thật, không chỉ là lỗi của người mới.
Vì sao proxy bị chặn: Anti-bot thực sự phát hiện bạn như thế nào?
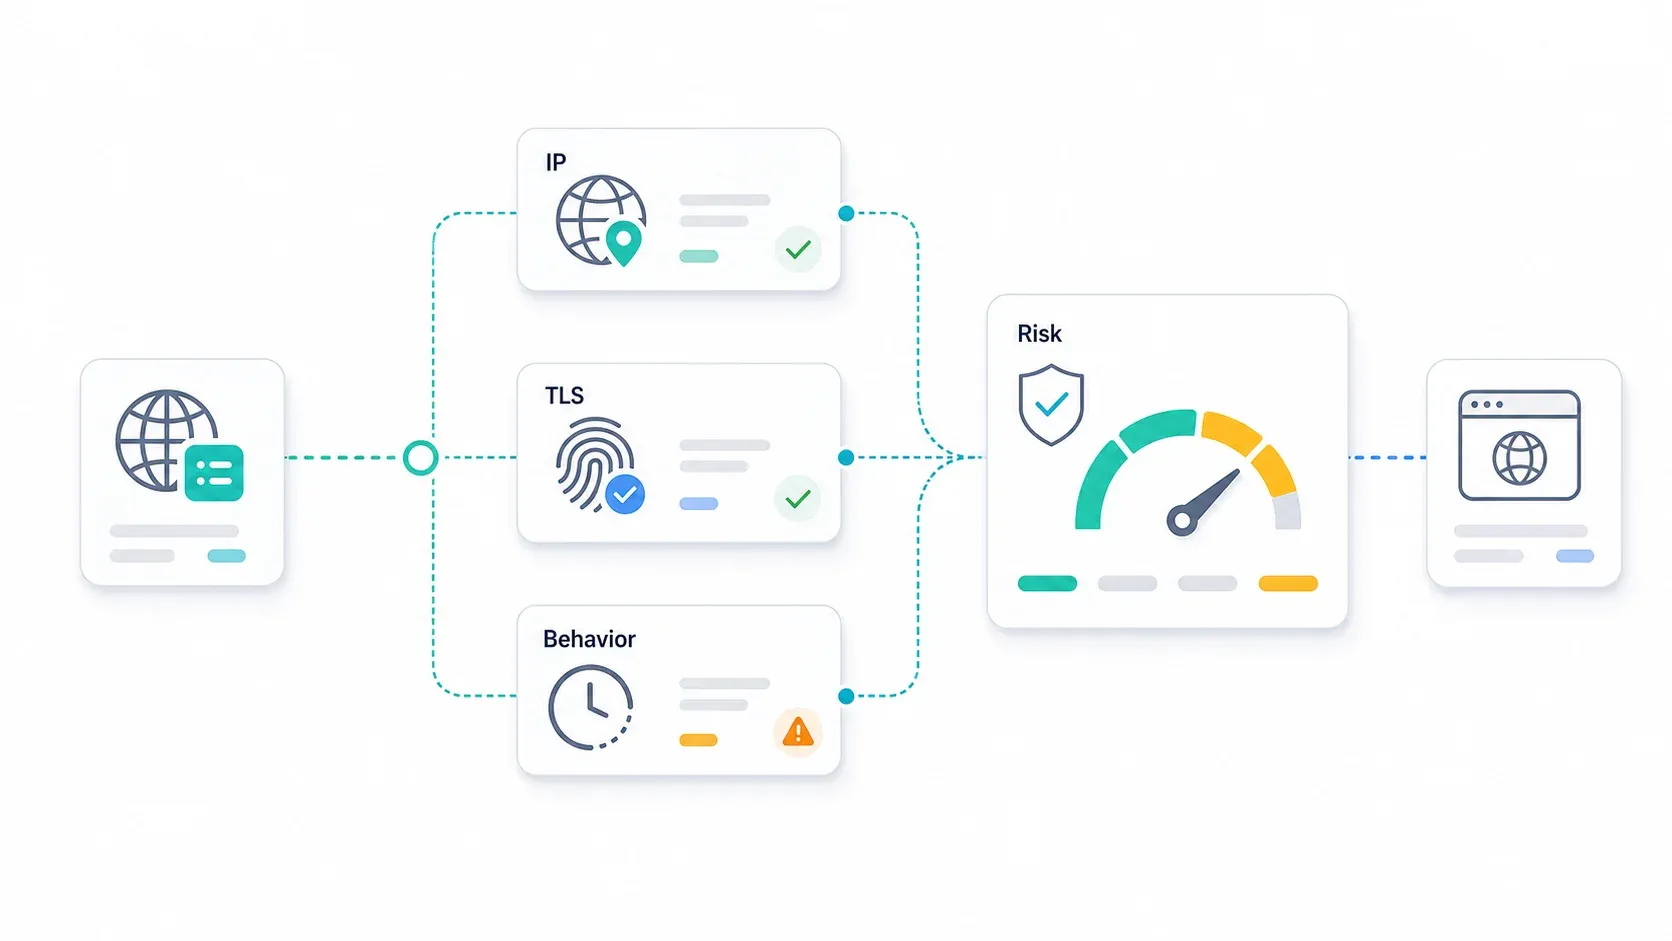
Chỉ một IP proxy thôi đã không đủ từ nhiều năm nay. Và còn lâu mới đủ. Các hệ thống anti-bot hiện đại từ Cloudflare, DataDome và F5 Distributed Cloud dùng cơ chế phát hiện nhiều lớp, vượt xa việc kiểm tra IP có thuộc datacenter hay không.
Lớp 1: Chấm điểm uy tín IP
Website và nhà cung cấp anti-bot gán điểm tin cậy cho địa chỉ IP dựa trên:
- IP đó có thuộc ASN của datacenter hay không (rất dễ bị gắn cờ)
- IP có nằm trong dải của nhà cung cấp proxy nổi tiếng hay không
- Độ tuổi và lịch sử lạm dụng của IP
- Điểm “sạch” của residential IP — ngay cả IP residential cũng có thể bị gắn cờ nếu bị dùng quá gắt
Hướng dẫn bot mitigation của DataDome nói rõ rằng lọc IP chỉ là một phần trong bộ nhận diện rộng hơn. Residential và mobile IP có độ tin cậy nền cao hơn, nhưng không phải vé thông hành.
Lớp 2: Fingerprint trình duyệt và TLS
Ngay cả khi IP rất sạch, client của bạn vẫn có thể tự tố mình. Hệ thống anti-bot sẽ kiểm tra:
- Canvas và WebGL fingerprint — khác biệt trong cách render tiết lộ browser/OS thật
- TLS JA3/JA4 hash — bản thân TLS handshake cũng tạo fingerprint. Cloudflare mô tả JA4 như một phần trong bộ công cụ rộng hơn bao gồm TLS, HTTP và SSH.
- Thiết lập HTTP/2 và HTTP/3 — hướng dẫn 2026 của Scrapfly giải thích cách các nhà cung cấp anti-bot lớn kết hợp fingerprint ở tầng giao thức thành hệ thống phát hiện nhiều lớp
- Độ phân giải màn hình, timezone, locale, font — nếu không khớp với thứ một người dùng bình thường ở vị trí của proxy sẽ có, bạn sẽ bị gắn cờ
Các nghiên cứu học thuật gần đây về TLS fingerprinting tiếp tục xác nhận rằng tín hiệu ở tầng handshake đang được dùng tích cực để phân biệt bot với người thật.
Lớp 3: Phân tích hành vi
Distributed Cloud Bot Defense của F5 nhấn mạnh phân tích hành vi và dự đoán mối đe dọa. Các hệ thống anti-bot theo dõi:
- Mẫu thời gian request — các khoảng cách quá đều (ví dụ đúng 2.000 giây/lần) là dấu hiệu bot rất rõ
- Chuyển động chuột và hành vi cuộn — hoặc sự vắng mặt của chúng
- Luồng điều hướng — người thật không vào 500 trang sản phẩm liên tiếp mà chẳng bao giờ bấm vào một category nào
- Request bùng nổ — ném 100 request trong 10 giây là quá lộ
Danh sách kiểm tra thực tế để tránh bị chặn
- Khớp quốc gia của proxy với timezone, locale và ngôn ngữ của trình duyệt
- Đừng ghép user agent di động với độ phân giải màn hình desktop
- Giữ cho header, TLS version, phiên bản trình duyệt và user agent nhất quán
- Dùng sticky session cho các thao tác đăng nhập hoặc nhiều bước
- Tránh khoảng cách request tuyệt đối giống nhau — hãy thêm độ biến thiên tự nhiên, theo cụm
- Giảm tốc trước khi nâng cấp loại proxy. Tốc độ request thường quan trọng hơn số tiền bạn đổ vào proxy.
- Kiểm tra WebRTC và DNS leak bằng BrowserLeaks trước khi chạy chiến dịch trả phí
- Khi sticky session rớt giữa chừng, hãy xác định đó là lỗi chất lượng từ nhà cung cấp hay là phản ứng phát hiện trước khi thay đổi toàn bộ setup của bạn
Khi nào bạn cần proxy cho scraping — và khi nào API scraping AI xử lý thay bạn?
Web scraping và thu thập dữ liệu là lý do số 1 khiến người ta tìm thông tin về proxy. Một phần đáng kể người mua proxy thực ra đang mua hạ tầng để giải quyết bài toán trích xuất dữ liệu — nhưng nhiều người không biết rằng có một con đường đơn giản hơn.
Bạn vẫn cần proxy khi…
- Bạn đang chạy automation tùy chỉnh bằng Puppeteer hoặc Playwright với yêu cầu session cụ thể
- Bạn duy trì session mạng xã hội dài hạn (quản lý nhiều tài khoản trong nhiều ngày hoặc nhiều tuần)
- Bạn làm xác minh quảng cáo theo khu vực, cần kiểm soát chi tiết vị trí IP đầu ra
- Bạn xây dựng công cụ nội bộ cần session xác thực bền vững
Trong những trường hợp này, quản lý proxy là một phần công việc. Không có đường tắt.
Bạn có thể không cần quản lý proxy khi…
- Mục tiêu của bạn là trích xuất dữ liệu có cấu trúc: danh sách sản phẩm, thông tin liên hệ, kết quả tìm kiếm, dữ liệu bất động sản
- Bạn dành nhiều thời gian hơn để debug rotation, xử lý CAPTCHA hơn là phân tích dữ liệu thu được
- Bạn cần đầu ra sạch dạng JSON hoặc Markdown, chứ không phải HTML thô
Đây là nơi các API scraping gốc AI phát huy tác dụng. Chúng xử lý anti-bot, render JS và CAPTCHA ở backend — để bạn không phải tự cấu hình proxy pool, logic rotation hay gói residential IP.
Cách API, MCP Server và CLI của Thunderbit thay thế việc quản lý proxy cho trích xuất dữ liệu
Ở đây, sự thẳng thắn về phạm vi quan trọng hơn lời quảng cáo bán hàng. Thunderbit không phải là giải pháp thay thế proxy cho mọi trường hợp. Nó mạnh nhất khi nhiệm vụ là “lấy dữ liệu có cấu trúc một cách ổn định” — chứ không phải “cho tôi kiểm soát thủ công hoàn toàn danh tính mạng.”
Đây là những gì công cụ của chúng tôi cung cấp cho workflow trích xuất dữ liệu:
- Open API:
POST /extractvới JSON Schema sẽ trả về dữ liệu có cấu trúc.POST /distillchuyển trang thành Markdown sạch. Cả hai đều xử lý render JS, né anti-bot và CAPTCHA mà bạn không cần cấu hình proxy pool.suggest_fieldsmiễn phí;distilltốn 1 credit;extracttốn 20 credit mỗi lần gọi. - MCP Server: Các công cụ
thunderbit_extractvàthunderbit_distillcho phép AI agents (Claude, Cursor) scrape ngay trong lúc làm việc — rất phù hợp cho research agent và pipeline enrich dữ liệu. - CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema schema.jsonchạy từ terminal, CI hoặc cron. Không cần browser, không cần cấu hình proxy. - Chrome Extension: Với người không chuyên kỹ thuật, Thunderbit Chrome Extension cung cấp tùy chọn 2-click, xử lý toàn bộ phức tạp về proxy và anti-bot ở phía sau.
| Khía cạnh | Tự quản lý proxy | Thunderbit API / MCP / CLI |
|---|---|---|
| Thời gian thiết lập | Tài khoản nhà cung cấp, loại proxy, thông tin xác thực, cấu hình browser/công cụ, quy tắc rotation | API key hoặc thiết lập MCP/CLI, rồi gọi extract/distill |
| Bảo trì | Theo dõi block, chất lượng IP, session, CAPTCHA, băng thông, thay đổi từ nhà cung cấp | Theo dõi credit, chất lượng schema, trạng thái API/job |
| Xử lý anti-bot | Bạn tự phối hợp proxy, browser stack, fingerprinting, giới hạn tốc độ | Thunderbit lo phần trừu tượng hóa cho các trường hợp được hỗ trợ |
| Đầu ra | Thường là HTML hoặc phản hồi thô; bạn phải tự viết parser | JSON có cấu trúc, Markdown hoặc field theo schema |
| Phù hợp nhất cho | Automation tùy chỉnh, session tài khoản, xác minh quảng cáo, kiểm soát chính xác IP đầu ra | Trích xuất dữ liệu công khai có cấu trúc và workflow nghiên cứu của AI agent |
| Mô hình chi phí | Theo GB/IP/port cộng với hạ tầng scraper | Trích xuất/distill theo credit |
Với các workflow như theo dõi giá ecommerce, tìm lead từ directory, hoặc tổng hợp listing bất động sản, cách tiếp cận API loại bỏ cả một nhóm phiền toái về hạ tầng. Nếu muốn đào sâu hơn, hãy xem các hướng dẫn của chúng tôi về AI web scraping, web scraping không cần code, và các AI web scraper tốt nhất trên blog Thunderbit.
Bẫy thanh toán proxy: Vì sao băng thông chưa dùng của bạn biến mất, và cách tránh trả quá tay
Thanh toán proxy là nơi ngành này trở nên thật sự khó hiểu — và cũng là nơi người mua dễ bị thiệt. Các thread trên forum đầy rẫy chuyện người dùng bất ngờ vì băng thông hết hạn, các gói “unlimited” nhưng bị throttling, và nhà cung cấp biến mất chỉ sau một đêm.
Các mô hình thanh toán proxy phổ biến và đánh đổi của chúng
| Mô hình thanh toán | Cách hoạt động | Cần lưu ý |
|---|---|---|
| Tính theo GB | Trả tiền theo băng thông sử dụng | Mức giá biến động rất mạnh theo loại proxy; rất dễ vượt ngân sách |
| Trả cố định theo IP/port | Trả theo mỗi IP, thường kèm “băng thông không giới hạn” | Có giới hạn fair-use, throttling hoặc treo tài khoản nếu dùng nặng |
| Băng thông không giới hạn | Phí tháng cố định | Gần như luôn có throttling tốc độ hoặc giới hạn fair-use ẩn trong điều khoản |
| Pay-as-you-go | Nạp tiền và trừ dần | Thường đắt nhất theo GB; phù hợp để test |
Vì sao nhà cung cấp residential proxy để băng thông chưa dùng của bạn hết hạn?
Phần lớn nhà cung cấp residential proxy dùng chu kỳ hết hạn traffic 30 ngày. Mua 10GB, dùng 3GB, thì 7GB còn lại thường biến mất vào cuối tháng. Đây không phải chỉ là tham lam ngẫu nhiên — chi phí peering và băng thông khiến việc cung cấp gói rollover rất tốn. Nhưng cảm giác vẫn rất khó chịu khi bạn đang trả $5/GB.
Một số nhà cung cấp hiện đã có traffic rollover hoặc không hết hạn:
- IPRoyal nhấn mạnh rằng traffic residential proxy “không bao giờ hết hạn” và hỗ trợ mua linh hoạt theo nhu cầu
- ProxyEmpire nói rằng có dữ liệu rollover, phần GB chưa dùng sẽ được chuyển sang kỳ sau
- DataImpulse quảng bá traffic residential $1/GB với băng thông không hết hạn
Mẹo: Mua băng thông theo lượng nhỏ hơn để giảm lãng phí. Nạp 5GB mà bạn chắc chắn dùng hết trong 30 ngày sẽ tốt hơn gói 50GB mà một nửa bị mất hạn.
Checklist đánh giá nhà cung cấp (ngoài lời quảng cáo)
Trước khi chốt bất kỳ nhà cung cấp proxy nào, hãy đi qua các bước này:
- Có dùng thử và chính sách hoàn tiền không — nếu không có trial, đó là một dấu hiệu đáng nghi
- Uy tín cộng đồng — cảm nhận trên Reddit trong các subreddit như r/proxies và r/webscraping đáng tin hơn các trang tổng hợp review. Tìm tên nhà cung cấp kèm “scam,” “exit scam,” hoặc “billing” để lộ ra các phàn nàn thật.
- SLA uptime và lịch sử uptime thực tế — yêu cầu dữ liệu lịch sử, không chỉ con số marketing
- Minh bạch về nguồn IP — residential IP có được lấy từ chương trình opt-in hợp pháp hay từ P2P SDK botnet? Bright Data công bố trang sourcing/trust mô tả nguồn residential IP minh bạch. Threat Intelligence Group của Google đã báo cáo một đợt triệt phá năm 2026 liên quan đến một mạng proxy residential lớn bị cho là bị kẻ xấu khai thác — nhắc chúng ta rằng không phải mọi IP pool đều giống nhau.
- Cam kết vùng phủ địa lý có thực tế không — test bằng trial trước khi mua gói dựa trên quốc gia được quảng cáo
- Lịch sử exit scam — nhà cung cấp đã từng bị cáo buộc đóng cửa đột ngột hoặc biến mất tiền chưa?
Các lỗi proxy phổ biến và cách tránh
Những sai lầm dưới đây dễ làm cả người mới lẫn người có kinh nghiệm vấp phải.
Lỗi 1: Dùng proxy miễn phí cho công việc kinh doanh
Proxy miễn phí chậm, không ổn định và thường ghi log traffic của bạn. Một số còn chèn quảng cáo hoặc malware. Bài test năm 2026 của Browserless cho thấy tỷ lệ thành công dưới 5% trên nhiều danh sách proxy miễn phí công khai. Tuyệt đối không dùng proxy miễn phí cho bất kỳ thứ gì liên quan đến thông tin đăng nhập, dữ liệu nhạy cảm hoặc workflow production.
Lỗi 2: Chọn sai loại proxy so với mục đích
Dùng datacenter proxy để scrape mạng xã hội (tỷ lệ bị chặn cao) hoặc dùng mobile proxy đắt tiền cho việc theo dõi SEO cơ bản (lãng phí ngân sách) là hai kiểu lệch mục đích phổ biến nhất. Hãy tham khảo cây quyết định ở trên — nó tồn tại là có lý do.
Lỗi 3: Bỏ qua tính nhất quán của fingerprint
Rotate IP nhưng vẫn giữ nguyên browser fingerprint thì chẳng giải quyết được gì. Timezone, ngôn ngữ, độ phân giải màn hình và user agent phải khớp với vị trí địa lý của proxy. Một request từ “German residential IP” nhưng locale en-US, timezone Pacific và một phiên bản Chrome còn chưa tồn tại sẽ bị gắn cờ ngay lập tức.
Lỗi 4: Rotate quá nhiều hoặc quá ít
Rotate quá nhanh trông rất đáng ngờ và có thể làm cháy uy tín IP. Rotate quá chậm thì dồn quá nhiều request vào từng IP. Điểm cân bằng phụ thuộc độ nhạy anti-bot của site mục tiêu — hãy bắt đầu thận trọng (mỗi 5–10 request rotate một lần) rồi điều chỉnh theo tỷ lệ bị chặn.
Lỗi 5: Bỏ qua việc sticky session bị rớt
Sticky session bị rớt giữa chừng là nỗi bực mình lặp đi lặp lại trong các thread proxy trên Reddit. Trước khi đại tu toàn bộ setup, hãy xác định đó là lỗi chất lượng từ nhà cung cấp (liên hệ hỗ trợ, thử nhà cung cấp khác) hay là phản ứng phát hiện (kiểm tra fingerprint, giảm tốc).
Proxy setup nhìn nhanh: Bảng tóm tắt
| Loại proxy | Phù hợp nhất cho | Mức ẩn danh | Tốc độ | Tín hiệu giá 2026 | Rủi ro bị phát hiện | Kiểu session |
|---|---|---|---|---|---|---|
| Residential | Ecommerce, travel, social, nghiên cứu theo khu vực | Cao | Trung bình | $2–8/GB | Trung bình-thấp | Rotating hoặc sticky |
| Datacenter | Theo dõi SEO, scraping đơn giản | Thấp-trung bình | Cao | Khoảng ~$0.90–1.20/IP | Cao trên site được bảo vệ | Dedicated/shared |
| ISP | Ổn định tài khoản, multi-account | Trung bình-cao | Cao | Khoảng ~$1.20–1.60/IP | Trung bình | Sticky/static |
| Mobile | Mạng xã hội, xác minh quảng cáo | Rất cao | Thấp-trung bình | $4–25/GB | Thấp | Sticky/rotating |
| SOCKS5 | Ứng dụng không chạy trên browser, UDP, định tuyến linh hoạt | Phụ thuộc nguồn | Phụ thuộc | Tùy chọn giao thức | Phụ thuộc | Phụ thuộc |
| Rotating | Scraping không trạng thái, crawl diện rộng | Phụ thuộc nguồn | Phụ thuộc | Do nhà cung cấp quản lý | Thấp hơn nếu nhịp độ hợp lý | IP mới mỗi request/khoảng thời gian |
| Dedicated | Tác vụ ổn định, định tuyến dự đoán được | Phụ thuộc | Cao | Theo IP/port | Shared có thể kéo theo vấn đề | Static |
Hãy đánh dấu trang này lại. Nó sẽ giúp bạn tránh những sai lầm proxy đắt đỏ nhất.
Kết luận và điểm chính cần nhớ
Proxy năm 2026 mạnh hơn và cũng phức tạp hơn bao giờ hết. Các quyết định cốt lõi không đổi, nhưng yêu cầu triển khai thì có:
- Hiểu bạn cần loại proxy nào. Residential, datacenter, ISP và mobile proxy phục vụ các mục đích khác nhau — chọn sai sẽ vừa tốn tiền vừa dễ bị chặn.
- Khớp loại proxy với use case và ngân sách. Dùng cây quyết định. Đừng mua mobile proxy để kiểm tra thứ hạng SEO, và cũng đừng dùng datacenter proxy để scrape mạng xã hội.
- Thiết lập đúng với fingerprint nhất quán. Rotate IP mà không đồng bộ timezone, locale, user agent và TLS fingerprint chỉ là “an ninh biểu diễn”.
- Theo dõi thanh toán. Hết hạn băng thông chưa dùng, giới hạn fair-use và chênh lệch giá theo GB giữa các loại proxy có thể làm ngân sách đội lên rất nhanh.
- Cân nhắc xem API scraping AI có thể loại bỏ hoàn toàn việc quản lý proxy hay không. Với dữ liệu có cấu trúc — danh sách sản phẩm, thông tin liên hệ, kết quả tìm kiếm — các công cụ như API và CLI của Thunderbit sẽ trừu tượng hóa toàn bộ lớp proxy/anti-bot và trả dữ liệu sạch trực tiếp.
Anti-bot sẽ tiếp tục tiến hóa. Xu hướng rất rõ: các công cụ AI che đi sự phức tạp của hạ tầng đang thắng thế, và các đội ngũ áp dụng chúng sẽ dành nhiều thời gian hơn để phân tích dữ liệu, ít thời gian hơn để gỡ lỗi cấu hình proxy. Nếu bạn tò mò, Thunderbit Chrome Extension có gói miễn phí để thử, và kênh YouTube của chúng tôi có các video hướng dẫn cho những workflow trích xuất phổ biến.
Không có một “proxy tốt nhất” duy nhất. Chỉ có proxy tốt nhất cho điều bạn đang cố làm — và giờ bạn đã có khung để tìm ra nó.
Câu hỏi thường gặp
1. Dùng proxy có hợp pháp không?
Proxy là công cụ hợp pháp ở hầu hết các khu vực pháp lý. Tính hợp pháp phụ thuộc vào cách bạn dùng chúng — scraping dữ liệu công khai thường ổn, nhưng luôn phải tôn trọng điều khoản dịch vụ của website, cơ chế truy cập và các quy định bảo vệ dữ liệu như GDPR. Đây không phải là tư vấn pháp lý; hãy hỏi chuyên gia nếu use case của bạn liên quan đến dữ liệu nhạy cảm hoặc ngành được quản lý chặt.
2. Proxy năm 2026 giá bao nhiêu?
Tùy loại. Datacenter proxy thường khoảng ~$0.90–1.20/IP. Residential proxy phổ biến ở mức $2–8/GB trên các gói thông dụng. ISP proxy nằm khoảng ~$1.20–1.60/IP. Mobile proxy là đắt nhất, từ $4–25/GB hoặc theo IP/tháng. Giá thay đổi khá nhiều theo nhà cung cấp, quy mô IP pool và thời hạn cam kết — luôn kiểm tra trang giá hiện tại trước khi mua.
3. Tôi có thể dùng proxy miễn phí để web scraping không?
Không khuyến nghị cho bất kỳ nhu cầu kinh doanh nghiêm túc nào. Proxy miễn phí không ổn định, chậm, và thường làm lộ dữ liệu qua logging, chèn quảng cáo hoặc malware. Bài test năm 2026 của Browserless cho thấy tỷ lệ thành công dưới 5% trên nhiều danh sách proxy công khai miễn phí. Với scraping production, hãy đầu tư vào nhà cung cấp trả phí hoặc dùng API trừu tượng hóa việc quản lý proxy hoàn toàn.
4. Khác nhau giữa proxy và VPN là gì?
Proxy thường định tuyến traffic cho một trình duyệt, một ứng dụng hoặc một công cụ cụ thể và không phải lúc nào cũng mã hóa kết nối. VPN mã hóa toàn bộ traffic của thiết bị ở cấp hệ thống. Proxy phù hợp hơn cho scraping, mở khóa theo khu vực và multi-account. VPN phù hợp hơn cho quyền riêng tư, an toàn khi dùng Wi‑Fi công cộng và truy cập từ xa cho doanh nghiệp. Xem bảng so sánh chi tiết ở phần trước.
5. Khi nào nên dùng API scraping AI thay vì tự quản lý proxy?
Khi mục tiêu của bạn là trích xuất dữ liệu có cấu trúc — danh sách sản phẩm, thông tin liên hệ, kết quả tìm kiếm, dữ liệu bất động sản — và bạn đang tốn nhiều thời gian hơn vào rotation proxy, xử lý CAPTCHA và tránh bị khóa hơn là phân tích dữ liệu. API scraping AI như Thunderbit xử lý anti-bot, render JS và CAPTCHA ở backend, trả về dữ liệu có cấu trúc sạch mà bạn không phải quản lý hạ tầng proxy. Bạn vẫn cần proxy riêng cho automation browser tùy chỉnh, session xác thực dài hạn, hoặc kiểm soát IP đầu ra chính xác.
Tìm hiểu thêm




