
Đến khoảng tab trình duyệt thứ mười bốn và máy tính giá thứ ba, tôi nhận ra rằng việc chọn một dịch vụ web scraping vào năm 2026 còn khó hơn cả việc tự scrape dữ liệu. Thị trường đã bùng nổ — từ tiện ích Chrome không cần code, API thô, các stack doanh nghiệp nặng về proxy, công cụ trích xuất bằng AI cho đến các agency trọn gói, tất cả đều đang tranh nhau cùng một khoản ngân sách.
Tôi đã dành vài tuần để thử 12 dịch vụ web scraping trên các tác vụ thực tế: lấy dữ liệu sản phẩm từ các trang ecommerce, trích xuất lead từ thư mục doanh nghiệp, và scrape danh sách việc làm có phân trang cùng các trang con. Mục tiêu không phải là xếp hạng tính năng trong môi trường lý tưởng, mà là trả lời một câu hỏi rất thực tế: dịch vụ nào thật sự phù hợp với đội ngũ nào?
Theo báo cáo dữ liệu web công khai của Bright Data, 82% tổ chức hiện xem dữ liệu web công khai là yếu tố then chốt cho tương lai của họ. Báo cáo thị trường 2025 của ScrapeOps cho thấy hơn 65% tổ chức dùng web scraping để xây dựng bộ dữ liệu phục vụ phân tích và AI. Tuy vậy, khảo sát năm 2026 của Apify lại cho thấy 46,7% chuyên gia vẫn phụ thuộc hoàn toàn vào code nội bộ, cùng với “thuế bảo trì” đi kèm.
Trước khi đi vào các công cụ, đây là phần giải thích ngắn về khía cạnh pháp lý của việc scrape dữ liệu.
Tôi đã đánh giá các dịch vụ web scraping tốt nhất như thế nào
Đây là những gì tôi xem xét. Tôi chọn các tiêu chí này sau khi thấy những vấn đề thực sự xảy ra sau giai đoạn demo, chứ không chỉ dựa trên trang tính năng.
- Dễ thiết lập / mức độ kỹ thuật cần có — Người không biết code có thể tạo giá trị trong vòng 10 phút không?
- Chống bot & xử lý proxy — Dịch vụ có tự lo proxy và CAPTCHA hay đó là việc của bạn?
- Kết xuất JavaScript — Có xử lý tốt các trang động, nhiều JS ngay từ đầu không?
- Định dạng xuất dữ liệu & tích hợp — Có đưa dữ liệu vào Sheets, Airtable hoặc Notion mà không cần viết code nối ghép không?
- Lập lịch / giám sát tự động — Có thể thiết lập scrape lặp lại mà không cần cron job không?
- Khả năng mở rộng — Chạy ổn ở 100 trang thì liệu có còn ổn ở 1 triệu trang không?
- Minh bạch giá & chi phí ở quy mô lớn — Bạn có dự đoán được hóa đơn tháng sau không, hay sẽ bị bất ngờ?
- Trích xuất bằng AI vs. bộ chọn thủ công — Công cụ có dùng AI để suy luận trường dữ liệu hay bạn phải tự viết CSS/XPath?
- Gánh nặng bảo trì theo thời gian — Điều gì xảy ra khi trang đích đổi giao diện?
Điểm cuối cùng này cần được nhấn mạnh. Đánh giá từ người dùng cho các công cụ như Octoparse, Apify, Browse AI và Bright Data đều lặp lại cùng một kiểu phàn nàn: không rõ cách tính credit, selector bị gãy sau khi website đổi giao diện, chạy cloud thất bại trên các trang được bảo vệ, và độ dốc học tập tăng mạnh sau bản demo đầu tiên. “Gánh nặng bảo trì” không phải là một tiêu chí phụ cho đẹp. Nó chính là yếu tố quyết định liệu bạn còn dùng công cụ đó sau sáu tháng hay không.
Loại dịch vụ web scraping nào phù hợp với đội ngũ của bạn?
Trước khi so sánh từng công cụ, việc hữu ích nhất tôi có thể làm là giúp bạn đi thẳng đến đúng nhóm sản phẩm. Thị trường web scraping không phải chỉ là một thị trường. Nó là năm thị trường chồng lấn lên nhau, và chọn sai nhóm còn lãng phí thời gian hơn cả chọn sai công cụ trong đúng nhóm.
| Tình huống của bạn | Loại dịch vụ nên dùng | Vì sao | Những lựa chọn phù hợp từ danh sách này |
|---|---|---|---|
| Đội ngũ không thiên về kỹ thuật (sales, marketing, ops) cần dữ liệu nhanh | Tiện ích Chrome không cần code | Cách nhanh nhất từ website đến bảng tính, ít rào cản thiết lập nhất | Thunderbit, Browse AI, Octoparse |
| Developer cần tích hợp scraping vào app hoặc pipeline | Scraping API | Nhiều quyền kiểm soát hơn, webhook, job bất đồng bộ, phù hợp CI/CD hơn | ScrapingBee, ScraperAPI, ZenRows |
| Đội ngũ đưa dữ liệu vào workflow AI/LLM | API trích xuất gốc AI | Output ưu tiên Markdown/JSON, giảm công đoạn làm sạch HTML | Thunderbit API, Firecrawl, Diffbot |
| Doanh nghiệp cần hạ tầng proxy + xử lý khối lượng lớn | Nền tảng thu thập dữ liệu full-stack | Proxy đi kèm, chống bot, SLA, concurrency cao | Bright Data, Oxylabs, Apify |
| Công ty muốn nhận dữ liệu thành phẩm, không muốn tự vận hành công cụ | Managed service / agency | Nhà cung cấp lo từ xây dựng, theo dõi, QA đến bàn giao | ScrapeHero |
Đây không phải là lý thuyết. Hướng dẫn build-vs-buy năm 2026 của Zyte nói rất rõ về đánh đổi này: tự xây thì kiểm soát được nhưng gánh bảo trì liên tục; stack lai tạo ra mảng vá vận hành; còn dịch vụ managed sẽ giảm gánh nặng nội bộ nhưng hạn chế sự linh hoạt tự phục vụ.
Trích xuất bằng AI vs. selector CSS/XPath truyền thống
Đây là rẽ nhánh kỹ thuật lớn nhất của thị trường hiện nay.
Scraping truyền thống giống như đi theo bản đồ kho báu với tọa độ chính xác. Bạn kiểm tra trang, tìm selector như .product-title, viết quy tắc trích xuất, test, rồi hy vọng ngày mai website vẫn y nguyên. Khi đội frontend đổi tên class hoặc bọc nội dung trong một div mới, scraper của bạn sẽ hỏng.
Scraping bằng AI thì giống như hỏi một trợ lý thông minh: “Hãy tìm tên sản phẩm, giá và tình trạng tồn kho trên trang này.” Thay vì hard-code con đường, bạn mô tả đích đến.
Dưới đây là hai luồng này trong thực tế:
Luồng truyền thống:
- Inspect phần tử trong DevTools
- Xác định class
.product-titlehoặc XPath - Viết quy tắc trích xuất
- Test trên các trang mẫu
- Sửa mỗi khi website đổi class
Luồng dùng AI (ví dụ: Thunderbit):
- Mở trang và nhấp một lần
- AI tự chọn các cột — tên sản phẩm, giá, đánh giá
- Nếu muốn khác đi thì chỉnh, hoặc chỉ cần mô tả điều bạn cần
- Còn lại cứ để nó chạy và nhận bảng kết quả
Nghiên cứu công bố còn hẹp hơn so với quảng cáo marketing. Một bài báo trên Scientific Reports năm 2025 ghi nhận crawler AI cho độ chính xác trích xuất cao hơn 35% và hiệu quả xử lý cao hơn 40% so với crawler truyền thống, nhưng dữ liệu thử nghiệm là kho lưu trữ báo chí chứ không phải trang sản phẩm hay thư mục doanh nghiệp, nên tôi sẽ không áp các con số đó trực tiếp cho các website trong bài này. Bài review Springer năm 2025 hữu ích hơn: các mô hình AI thích nghi tốt hơn với cấu trúc thay đổi, nhưng vẫn cần retrain hoặc cơ chế dự phòng khi domain hay pattern đổi đáng kể.
| Khía cạnh | Truyền thống (CSS/XPath) | Trích xuất bằng AI |
|---|---|---|
| Thời gian thiết lập | 15–60 phút mỗi website | ~30 giây |
| Kỹ năng kỹ thuật | Cấp developer | Không cần |
| Xử lý thay đổi giao diện và website mới | Dễ gãy — phải viết rule mới sau mỗi lần đổi giao diện, và cho từng website mới | Thường thích nghi — đọc lại trang từ đầu mỗi lần chạy |
| Tính dự đoán | Xác định — cùng một rule luôn lấy cùng một trường | Xác suất — đôi khi chọn nhầm trường, nên vẫn cần kiểm tra ngẫu nhiên |
| Gắn nhãn / biến đổi dữ liệu | Bước hậu xử lý riêng | Có thể gắn nhãn, dịch, phân loại ngay khi scrape |
| Phù hợp nhất | Pipeline ổn định, khối lượng lớn, do dev sở hữu | Website đa dạng, layout thay đổi, người dùng không biết code |
Khác biệt rõ nhất trong thực tế là bảo trì. Không có con số công khai nào đáng tin về tần suất scraper bị gãy, nên tôi sẽ không bịa ra một con số ở đây. Điều nhất quán là dạng phàn nàn trên G2 và Capterra với các công cụ dựa trên selector trong danh sách này: hiếm khi công cụ không lấy được dữ liệu ngay từ đầu, mà thường là nó ngừng lấy được sau khi website thay đổi.
Thunderbit là ví dụ rõ ràng nhất cho mô hình AI-first trong danh sách này. AI của nó tự chọn các trường đáng lấy chỉ sau một lần nhấp, hoặc bạn có thể mô tả dữ liệu cần lấy bằng một câu ngắn, và Field AI Prompts của nó có thể gắn nhãn, dịch, tóm tắt hoặc phân loại dữ liệu ngay trong lúc trích xuất — không chỉ sau đó. Open API của nó cung cấp cả endpoint Distill và Extract, nên cùng một mô hình trích xuất AI cũng có thể dùng theo chương trình.
Thử scraping bằng AI với Thunderbit
Tổng quan 12 dịch vụ web scraping tốt nhất
| Dịch vụ | Loại | Phù hợp nhất cho | Chống bot/Proxy | Kết xuất JS | Trích xuất bằng AI | Gói miễn phí | Giá khởi điểm (tháng-tháng) | Tùy chọn xuất dữ liệu |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Tiện ích Chrome không cần code + API | Đội ngũ không thiên về kỹ thuật | ⚠️ Xử lý trên cloud | ✅ | ✅ Trường dữ liệu được AI ánh xạ | ✅ 6 trang miễn phí | Miễn phí; gói trả phí từ $15/tháng | Excel, CSV, JSON, Sheets, Airtable, Notion |
| Bright Data | Nền tảng full-stack | Pipeline quy mô doanh nghiệp | ✅ Mạng proxy hàng đầu | ✅ | ⚠️ Một phần / lớp AI mới hơn | ✅ 5K bản ghi/tháng | Không có mức tối thiểu hàng tháng | JSON, CSV, API, webhook |
| Oxylabs | Proxy doanh nghiệp + scraping | Scrape SERP, website được bảo vệ | ✅ Proxy residential / datacenter | ✅ | ⚠️ Hạn chế | ⚠️ Dùng thử | ~$49/tháng | JSON, CSV, API |
| Apify | Nền tảng + marketplace | Developer, người xây automation | ✅ Qua cấu hình proxy | ✅ | ⚠️ Một số actor | ✅ $5 miễn phí/tháng | $29/tháng + phí sử dụng | JSON, CSV, Excel, API |
| ScrapingBee | Dịch vụ API | Pipeline của developer | ✅ Tích hợp sẵn | ✅ | ⚠️ Một số trích xuất AI | ✅ 1,000 credit | $49/tháng | JSON, HTML, Markdown, API |
| ScraperAPI | Dịch vụ API | Theo dõi giá ở quy mô lớn | ✅ Luân chuyển sẵn | ✅ | ❌ | ⚠️ Dùng thử 7 ngày, 5K credit | $49/tháng | JSON, CSV, API |
| ZenRows | Dịch vụ API | Website chống bot mạnh | ✅ Anti-bot cao cấp | ✅ | ⚠️ Beta | ✅ 5K credit/tháng | $19/tháng | JSON, API |
| Octoparse | Desktop no-code + cloud | Scraping trực quan không cần code | ✅ Tích hợp sẵn | ✅ | ⚠️ Tự động nhận diện hạn chế | ✅ Gói miễn phí (10 tác vụ) | $39/tháng | Excel, CSV, JSON, HTML, XML, DB, Sheets |
| Diffbot | Nền tảng AI/NLP | Dữ liệu doanh nghiệp có cấu trúc | ⚠️ Cơ bản đến trung bình | ✅ | ✅ Dựa trên NLP | ✅ 10K credit/tháng | $299/tháng | JSON, CSV, API |
| Firecrawl | API cho developer (AI) | Pipeline LLM/RAG | ✅ Tích hợp sẵn | ✅ | ✅ Markdown + dữ liệu có cấu trúc | ✅ 1,000 credit/tháng | $19/tháng | Markdown, JSON, HTML, API |
| Browse AI | Giám sát không cần code | Phát hiện thay đổi, người không biết code | ⚠️ Cơ bản | ✅ | ⚠️ Dựa trên template | ✅ 50 credit/tháng | $48/tháng | CSV, JSON, Sheets, Airtable, API |
| ScrapeHero | Dịch vụ quản lý/agency | Doanh nghiệp muốn giao trọn gói | ✅ Quản lý hoàn toàn | ✅ | N/A | ❌ | Từ $199/tháng | Bàn giao tuỳ chỉnh |
Mẫu hình rất rõ ràng.
Thunderbit, Browse AI và Octoparse tối ưu cho tốc độ thiết lập. ScrapingBee, ScraperAPI và ZenRows tối ưu cho kiểm soát của developer. Bright Data, Oxylabs và Apify tối ưu cho quy mô và hạ tầng. Firecrawl và Diffbot tối ưu cho output dạng AI. ScrapeHero tối ưu cho việc bạn không phải tự vận hành bất cứ thứ gì.
1. Thunderbit
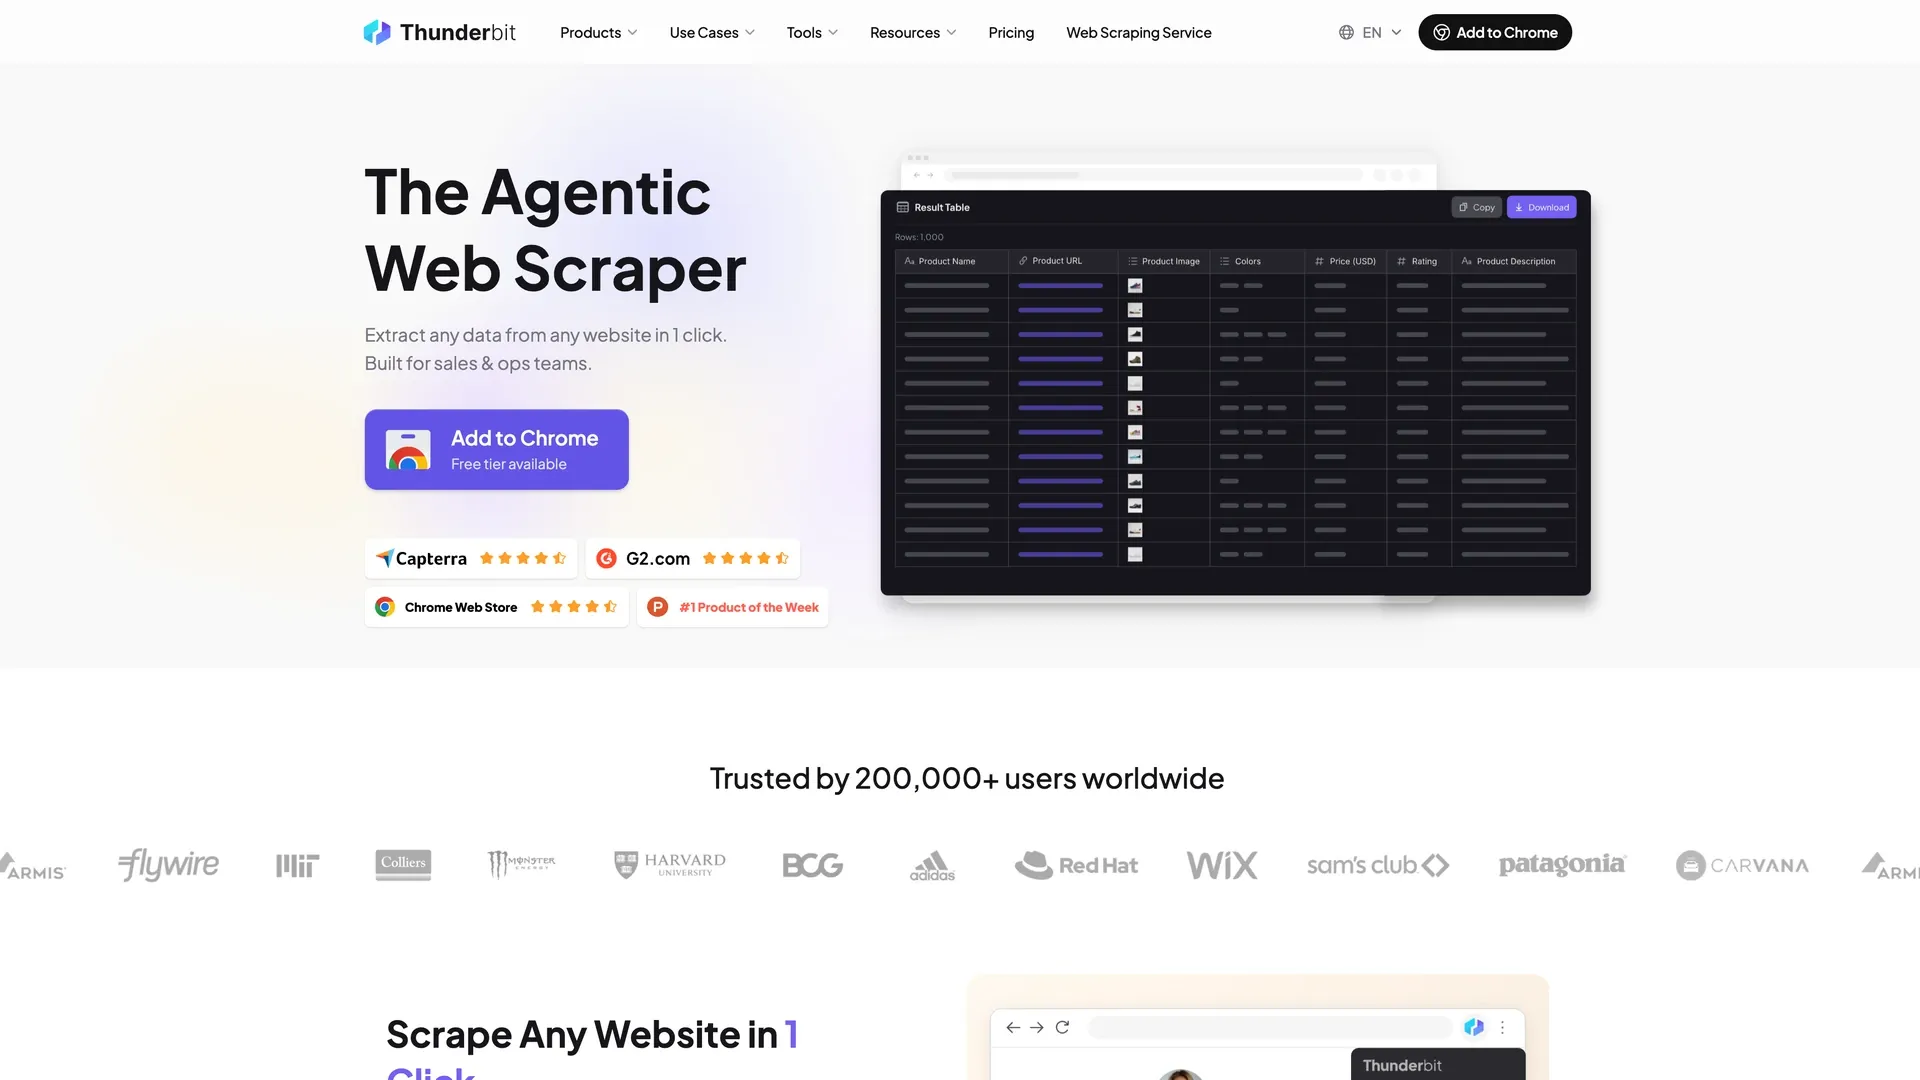 Thunderbit là sản phẩm dễ dùng nhất trong danh sách này cho người không có nền tảng kỹ thuật nhưng muốn đi từ website sang bảng tính mà không cần đụng vào selector nào. Quy trình cốt lõi cực kỳ trực tiếp: mở tiện ích Chrome trên bất kỳ trang nào và nhấp một lần — AI sẽ tự xác định những trường dữ liệu đáng lấy và tự chạy tác vụ, còn nếu bạn muốn thứ gì cụ thể hơn, chỉ cần mô tả bằng tiếng Anh tự nhiên. Đối với hầu hết các trang, đó thực sự là toàn bộ quy trình. Không CSS selector. Không XPath. Không inspect element.
Điểm làm Thunderbit khác biệt là nó không chỉ trích xuất trường dữ liệu. Nó còn có thể gắn nhãn, dịch, tóm tắt, phân loại và định dạng lại dữ liệu ngay trong lúc scrape bằng Field AI Prompts. Điều này quan trọng vì nút thắt thực sự với người dùng doanh nghiệp thường không phải là khâu trích xuất, mà là công đoạn dọn dẹp sau khi xuất dữ liệu. Với Thunderbit, bạn có thể scrape một trang sản phẩm tiếng Pháp và nhận đầu ra tiếng Anh kèm nhãn cảm xúc — chỉ trong một lượt.
Tính năng chính:
- Thiết lập không cần selector — chỉ một lần nhấp là AI tự chọn cột cho bạn, hoặc bạn chỉ cần nói điều mình muốn
- Chế độ trình duyệt cho các trang cần đăng nhập và chế độ cloud (50 trang mỗi lần) cho scrape nhanh các trang công khai
- Scrape trang con để tự động bổ sung dữ liệu chi tiết vào danh sách
- Xử lý phân trang và cuộn vô hạn tích hợp sẵn
- Lập lịch bằng ngôn ngữ tự nhiên cho giám sát định kỳ (ví dụ: “mỗi thứ Hai lúc 9 giờ sáng”)
- Mẫu scraper tức thì cho các website phổ biến như Amazon, Zillow, Google Maps và Indeed
- Open API với endpoint
DistillvàExtractcho nhu cầu của developer - Hỗ trợ 34 ngôn ngữ bao gồm dịch ngay trong lúc trích xuất
Cách xuất dữ liệu là một trong những lợi thế rõ nhất của Thunderbit. Nó cho phép xuất miễn phí, gốc hệ thống sang Excel, CSV, JSON, Google Sheets, Airtable và Notion — bao gồm cả xử lý ảnh trong xuất sang Airtable và Notion. Với đội sales sống trong Sheets hoặc đội marketing tổ chức nghiên cứu trong Notion, điều này loại bỏ hẳn một bước chuyển đổi mà các công cụ API-first thường bắt bạn tự làm.
Giá: Tính theo credit. Gói miễn phí có 6 trang mỗi tháng, kèm dùng thử 7 ngày cho các tính năng Pro. Gói browser trả phí bắt đầu từ $15/tháng nếu thanh toán tháng, hoặc $9/tháng khi thanh toán năm. API có bảng giá riêng: 600 đơn vị miễn phí ban đầu, sau đó $29/tháng cho 6,000 đơn vị ở gói Starter, $72/tháng cho 60,000 ở Pro 1, $120/tháng cho 120,000 ở Pro 2, và một thanh trượt lên tới 480,000 đơn vị mỗi tháng. Nếu trả theo năm, mức giá là $16/tháng cho 60,000 đơn vị mỗi năm ở Starter và $40/tháng cho 600,000 đơn vị ở Pro 1.
Ưu điểm:
- Mức ma sát thiết lập thấp nhất trong toàn bộ so sánh này
- Xuất dữ liệu theo hướng bảng tính ngay từ đầu, không phải JSON rồi tự xử lý
- Biến đổi dữ liệu bằng AI ngay trong lúc trích xuất, không chỉ sau đó
- Phù hợp mạnh với sales, ecommerce, nghiên cứu và bất động sản
Nhược điểm:
- Có hai hệ credit khác nhau: extension tính 1 credit cho mỗi hàng đầu ra (2 nếu scrape trang con), còn API tính 1 unit cho mỗi trang Distill và 20 unit cho mỗi trang Extract — bạn phải lập ngân sách riêng cho từng hệ
- Gói miễn phí chỉ có 6 trang/tháng, thấp hơn nhiều so với các nhà cung cấp API ở đây (Firecrawl 1,000 credit/tháng, ZenRows 5,000, Diffbot 10,000)
- Tự phục vụ không đi tới quy mô enterprise: gói browser cao nhất được công bố là Pro ở mức $38/tháng nếu thanh toán tháng, và sau đó là báo giá Business tùy chỉnh
Phù hợp nhất cho: Tạo lead sales, theo dõi đối thủ ecommerce, nghiên cứu marketing, scrape việc làm và thư mục doanh nghiệp, danh sách bất động sản.
2. Bright Data
 Bright Data là lựa chọn của khách hàng enterprise khi họ muốn một nhà cung cấp duy nhất cho proxy, scraping API, bộ dữ liệu, SERP API, và ngày càng nhiều hơn là trích xuất hỗ trợ AI. Nó giống một stack thu thập dữ liệu hoàn chỉnh hơn là một sản phẩm đơn lẻ.
Bảng giá Web Scraper API được công khai: gói miễn phí 5,000 bản ghi mỗi tháng, pay-as-you-go khoảng $1.50 cho mỗi 1,000 bản ghi, và gói scale $499/tháng với 384,000 bản ghi gồm sẵn và $1.30 cho mỗi 1,000 bản ghi sau đó. Một bản ghi ở đây là một mục được trích xuất — một dòng trong bảng — chứ không phải một trang được tải. Residential proxy bắt đầu từ $4/GB. Ngoài ra còn có datasets có cấu trúc, Scraper Studio, AI scraper và hỗ trợ MCP.
Tính năng chính:
- Mạng proxy cực mạnh (residential, datacenter, mobile, ISP)
- Render trình duyệt đầy đủ và xử lý CAPTCHA đã bao gồm trong giá Web Scraper API
- Marketplace datasets cho dữ liệu được thu thập sẵn
- Tư thế tuân thủ cấp enterprise với Trust Center và các chứng chỉ liên quan
Giá: Pay-as-you-go từ khoảng $1.50/1K bản ghi; gói scale từ $499/tháng.
Ưu điểm: Quy mô và hạ tầng proxy gần như không đối thủ. Quản trị enterprise rất rộng. Nhược điểm: Phức tạp hơn mức mà đa số đội mid-market cần. Giá nhanh chóng trở nên đắt khi cộng API, proxy và các lớp bổ sung. Nền tảng vẫn giả định có một người chịu trách nhiệm kỹ thuật, dù đã có các tính năng AI mới.
Phù hợp nhất cho: Pipeline Fortune 500, đội dữ liệu scrape hàng triệu trang, scrape đa vùng địa lý nơi chất lượng proxy rất quan trọng, doanh nghiệp cần tuân thủ chính thức.
3. Oxylabs
 Oxylabs là lựa chọn proxy + scraping doanh nghiệp thuần mạnh nhất cho những đội ưu tiên độ tin cậy trên các mục tiêu được bảo vệ. Nó cung cấp residential và datacenter proxy, Web Scraper API, SERP Scraper API, Web Unblocker và một lớp Headless Browser mới hơn.
Giá bắt đầu từ $49/tháng cho Web Scraper API, và mức giá trên mỗi kết quả phụ thuộc vào cả website mục tiêu lẫn gói bạn đang dùng. Ở gói Micro $49, một website thông thường — tức không phải Amazon hay Google — có giá $1.15 cho mỗi 1,000 kết quả nếu không render JS và $1.35 nếu có render; lên gói Advanced $249 thì hai con số này là $0.95 và $1.25, và tiếp tục giảm ở các tầng cao hơn. Residential proxy bắt đầu từ $6/GB và giảm xuống $2.50/GB khi đạt 1TB.
Tính năng chính:
- Hạ tầng proxy rất mạnh với luân chuyển và quản lý session tự động
- SERP Scraper API được xây riêng cho giám sát công cụ tìm kiếm
- Mô hình chỉ tính phí khi thành công trên các sản phẩm chính
- Trust Center và tư thế tuân thủ rõ ràng
Giá: Từ $49/tháng; không có gói miễn phí thường xuyên (chỉ dùng thử).
Ưu điểm: Proxy đáng tin cậy, rất tốt cho scrape SERP, tư thế tin cậy enterprise mạnh. Nhược điểm: Số lượng kết quả công bố trên mỗi gói giả định Amazon không render JS — trên một website thông thường, gói Micro $49 chỉ tương đương khoảng 42,600 kết quả, không phải 98,000. Vì mức giá trên mỗi 1,000 thay đổi theo cả website đích và cấp gói, hai đội scrape cùng khối lượng có thể nhận hóa đơn rất khác nhau.
Phù hợp nhất cho: Đội SEO, giám sát SERP quy mô enterprise, khối lượng công việc lớn phụ thuộc nhiều proxy.
4. Apify
 Apify là nền tảng kiểu marketplace linh hoạt nhất trong danh sách này. Nó kết hợp chạy trên cloud, lưu trữ, lập lịch, log, API và một hệ sinh thái rất lớn các “Actor” dựng sẵn — Apify Store hiện có hơn 59,000 Actor. Thay vì tự build mọi scraper, bạn thường có thể bắt đầu từ một actor có sẵn cho Google Maps, Amazon, Instagram, TikTok hoặc một crawler nội dung website tổng quát.
Tính năng chính:
- Marketplace cực lớn với scraper dựng sẵn
- Apify SDK cho phát triển actor tuỳ chỉnh
- Quản lý proxy và chạy cloud tích hợp sẵn
- API, lưu trữ, lập lịch và log rất mạnh
Giá tính theo mức dùng: gói miễn phí có $5 chi tiêu, sau đó $29/tháng ở Starter, $199 ở Scale, $999 ở Business — tất cả đều có thêm tính phí compute unit. Sự linh hoạt này rất mạnh, nhưng việc dự đoán chi phí hàng tháng khó hơn so với các sản phẩm API đơn giản.
Ưu điểm: Cộng đồng lớn, nhiều scraper sẵn có, phù hợp từ hobby tới production và tự động hóa nghiêm túc. Nhược điểm: Tuỳ biến hoặc debug actor có đường cong học tập. Giá compute unit cộng phí actor cộng proxy có thể khó đoán. Phù hợp builder hơn người dùng doanh nghiệp chỉ muốn bảng tính.
Phù hợp nhất cho: Developer và người xây automation, đội muốn tái sử dụng scraper sẵn có, workflow kết hợp tự build và mua.
5. ScrapingBee
 ScrapingBee là một trong những scraping API dễ hiểu và dễ tích hợp nhất. Nó tập trung vào render Chrome headless, luân chuyển proxy và API gọn gàng thay vì cố trở thành một nền tảng trực quan.
Giá bắt đầu từ $49/tháng cho 250,000 credit và 50 request đồng thời, gói Startup là $99/tháng cho 1,000,000 credit và 100 request đồng thời. Người dùng mới nhận 1,000 credit API miễn phí. Điểm cần lưu ý: render JS, premium proxy, ảnh chụp màn hình và trích xuất AI đều tiêu hao credit với hệ số cao hơn.
Tính năng chính:
- REST API rất gọn
- Endpoint riêng cho Amazon, Google, YouTube, Walmart và ChatGPT
- Có thể trả về HTML, JSON, Markdown hoặc plain text
- Phù hợp với pipeline AI/LLM vì output Markdown giúp giảm công đoạn làm sạch
Ưu điểm: Thân thiện với developer, render JS ổn định, giá cơ bản minh bạch. Nhược điểm: Gói $49 là 250,000 credit, nhưng đó chỉ là 250,000 request thường — render JS, premium proxy, screenshots và AI extraction mỗi thứ đều tốn hơn 1 credit mỗi lần gọi, nên trên mục tiêu thực tế bạn sẽ lấy được ít trang hơn rất nhiều so với con số quảng cáo. Mức concurrency gắn với gói (50 request song song ở Freelance), nên thông lượng có thể đẩy bạn lên gói cao hơn trước khi đạt ngưỡng volume. Vẫn cần sở hữu code.
Phù hợp nhất cho: Developer tích hợp scraping vào backend, đội muốn API dễ dùng, pipeline LLM cần output ưu tiên văn bản.
6. ScraperAPI
 ScraperAPI vẫn là một trong những lựa chọn API có cấu trúc mạnh nhất cho theo dõi ecommerce và scraping hàng loạt theo lịch. Trọng tâm sản phẩm rất đơn giản: một endpoint gói sẵn proxy, retry, render JS, định vị địa lý và output có cấu trúc.
Giá bắt đầu từ $49/tháng cho 100,000 credit và 20 thread, gói Startup là $149/tháng cho 1,000,000 credit và 50 thread. Ngoài ra còn có dùng thử 7 ngày với 5,000 credit, không cần thẻ. Điều đáng chú ý ở ScraperAPI là lớp có cấu trúc: API bất đồng bộ, webhook delivery, DataPipeline cho dự án ít code, và structured endpoints cho Amazon, eBay, Google, Redfin và Walmart.
Tính năng chính:
- Endpoint có cấu trúc mạnh cho ecommerce lớn và lĩnh vực tìm kiếm
- Hỗ trợ async và webhook tốt
- Cạnh tranh mạnh cho giám sát khối lượng lớn
- Nhiều tuỳ chọn render và geotargeting
Ưu điểm: Credit dùng thử hào phóng, tài liệu tốt, đáng tin cậy cho giám sát ecommerce. Nhược điểm: Hệ số credit khiến việc mô hình hóa chi phí khó hơn. Không có AI extraction thực sự cho các trang bất kỳ. Chỉ dành cho developer.
Phù hợp nhất cho: Giám sát giá ecommerce, phân tích cạnh tranh, pipeline tìm kiếm và marketplace.
7. ZenRows
 ZenRows là chuyên gia chống bot. Nó tập trung vào việc vượt qua Cloudflare, DataDome, Akamai, Imperva và các lớp bảo vệ tương tự, trong khi vẫn giữ trải nghiệm developer hiện đại.
Giá bắt đầu từ $19/tháng ở gói Build (45,000 credit, 20 request đồng thời). Build thực ra là một thanh trượt — $29 cho 80,000 credit, $39 cho 120,000 — và phía trên là Launch $69/tháng cho 250,000 credit và 50 request đồng thời, cùng Growth $199/tháng cho 1.2 triệu; đây là giá thanh toán tháng, còn thanh toán năm được giảm 17%. Mô hình chi phí dựa trên hệ số: render JS là 5x, premium proxy là 10x, và dùng cả hai là 25x.
Tính năng chính:
- Tập trung rất mạnh vào các website được bảo vệ nặng
- Tài liệu và phạm vi chống bot rất rộng
- Hệ sinh thái tích hợp hiện đại gồm LangChain, LlamaIndex và MCP
- Chỉ tính phí cho request thành công
Ưu điểm: Tỉ lệ thành công chống bot rất tốt trên mục tiêu khó. Nhược điểm: Chi phí tăng rất nhanh trên workload có bảo vệ. Một trang cần cả render JS lẫn premium proxy sẽ tốn 25 credit thay vì 1, nên gói $19 nhìn như 45,000 trang thực ra chỉ còn khoảng 1,800 trang trên mục tiêu khó.
Phù hợp nhất cho: Developer scrape mục tiêu khó, job giám sát chống bot nặng, đội quan tâm nhiều hơn đến việc vượt qua bảo vệ hơn là trải nghiệm bảng tính.
8. Octoparse
 Octoparse là scraper desktop không cần code kiểu cổ điển: trình dựng workflow trực quan với thực thi trên desktop, lập lịch trên cloud, điều hướng trình duyệt tích hợp và khả năng xuất dữ liệu rộng. Nếu Thunderbit là lựa chọn AI-first “một nhấp”, thì Octoparse là lựa chọn dựng flow trực quan cho người muốn mô hình hóa logic trích xuất từng bước.
Giá phức tạp hơn vẻ ngoài. Trung tâm trợ giúp liệt kê giá hàng tháng — Basic $39/tháng, Standard từ $83/tháng và Professional $299/tháng — trong khi trang giá chính mặc định theo thanh toán năm, nên headline price hiển thị là $69/tháng cho Standard và $249/tháng cho Professional. Đó là cùng một gói với hai chu kỳ thanh toán, không phải hai bảng giá mâu thuẫn; khoảng trống thực sự là Basic, vì trang giá không hiển thị gói này. Vì vậy hãy kiểm tra kỹ giá được trích theo chu kỳ nào trước khi so sánh. Trang giá cũng nhấn mạnh các add-on như residential proxy, xử lý CAPTCHA, thiết lập crawler và dịch vụ dữ liệu quản lý trọn gói.
Tính năng chính:
- Trình dựng workflow trực quan trưởng thành
- Xuất dữ liệu rộng: Excel, CSV, JSON, HTML, XML, Google Sheets, database
- Có sẵn lập lịch và tự động hóa trên cloud
- Mẫu scraper cho các website phổ biến
Ưu điểm: Không cần code, tốt cho scraping lặp lại quy mô vừa, nhiều lựa chọn xuất dữ liệu. Nhược điểm: Cần bảo trì nhiều hơn các công cụ AI-native khi layout thay đổi (dựa trên selector). Các site động hoặc được bảo vệ vẫn có thể gây khó khăn. UX ưu tiên desktop có thể nặng hơn các công cụ ưu tiên trình duyệt.
Phù hợp nhất cho: Người dùng no-code cần kiểm soát nhiều hơn một prompt AI đơn giản, scraping lặp lại quy mô vừa, đội quen với flow trực quan.
9. Diffbot
 Diffbot là nền tảng trích xuất AI cấp enterprise nhất trong danh sách. Thông điệp của nó không phải là “scrape trang này” mà là “hiểu loại trang này và biến nó thành dữ liệu có cấu trúc ở quy mô lớn.” Sản phẩm gồm Extract, Crawl, Natural Language và Knowledge Graph.
Giá bắt đầu miễn phí với 10,000 credit, sau đó là $299/tháng cho Startup (250,000 credit), $899 cho Plus (1,000,000 credit) và các gói enterprise tuỳ chỉnh. Một trang web được trích xuất tiêu chuẩn tốn một credit; xuất bản ghi Knowledge Graph đắt hơn đáng kể.
Tính năng chính:
- Hiểu rất tốt loại trang tự động (bài viết, sản phẩm, thảo luận)
- Rất phù hợp để xây dựng knowledge graph và pipeline thực thể
- Trích xuất dựa trên NLP — không cần selector
- Hỗ trợ cao cấp và định vị enterprise
Ưu điểm: Khả năng hiểu cấu trúc trang bằng AI rất mạnh, cực kỳ tốt cho xây knowledge graph. Nhược điểm: Đắt cho dự án nhỏ hoặc dùng không thường xuyên. Quy trình DQL và KG có đường cong học tập. Quá mạnh so với bài toán scrape bảng tính đơn giản.
Phù hợp nhất cho: Doanh nghiệp xây bộ dữ liệu có cấu trúc, dự án knowledge graph và entity resolution, pipeline ingest nặng về NLP.
10. Firecrawl
 Firecrawl là công cụ ingest LLM thiên về developer nhất trong nhóm. Nó chuyển URL thành Markdown sạch, HTML, ảnh chụp màn hình hoặc JSON có cấu trúc, và được xây quanh một API đơn giản thay vì một ứng dụng trực quan.
Giá rất rõ: miễn phí với 1,000 credit mỗi tháng, Hobby với 5,000 credit, Standard với 100,000, Growth với 500,000, Scale với 1,000,000, và Enterprise cao hơn nữa. Gói khởi điểm là $19/tháng, hoặc $16/tháng nếu thanh toán năm.
Tính năng chính:
- Output Markdown sạch cho RAG và pipeline LLM
- Hỗ trợ JSON có cấu trúc bằng schema hoặc prompt
- Tài liệu developer tốt và mức độ chấp nhận open-source cao
- Các tầng browser concurrency mạnh hơn ở gói cao
Ưu điểm: Sinh ra để đưa dữ liệu vào LLM. Giá vào cửa hợp lý. Output sạch. Nhược điểm: Dành cho developer. Có playground và một bộ công cụ miễn phí cho từng trang, nhưng không công cụ nào chạy job lặp lại — bất cứ thứ gì bạn muốn lập lịch, xử lý hàng loạt hoặc nối vào pipeline đều là API call hoặc SDK. Credit hết hạn vào cuối tháng ở mọi gói dưới Scale $749. Và thang gói có một khoảng nhảy ở giữa: slider credit là 5,000, 6,500, 8,000 trang mỗi tháng, rồi nhảy thẳng lên 100,000 — gói Standard $99.
Phù hợp nhất cho: Pipeline RAG, AI agent, ingest và phân tích nội dung.
11. Browse AI
 Browse AI nên được hiểu trước hết là một sản phẩm giám sát có khả năng scrape, chứ không chỉ là một scraper kiêm giám sát. Điểm mạnh nhất của nó là phát hiện thay đổi định kỳ: giá, tồn kho, văn bản, ảnh chụp màn hình và thay đổi trang theo thời gian.
Giá bắt đầu với gói miễn phí 50 credit mỗi tháng, sau đó là Personal $48/tháng cho 2,000 credit và Professional theo thanh trượt — $87 cho 5,000 credit, $162 cho 10,000, lên tới $399 cho 30,000 — còn Premium được báo giá từ $500/tháng nếu thanh toán năm. Khi thanh toán năm, Personal là $19/tháng và Professional là $69. Credit được tiêu hao dựa trên số hàng và độ phức tạp của tác vụ: một trang bạn mở để lấy chính dữ liệu của nó là một task với mức tối thiểu một credit, mười hàng cũng chỉ tốn một credit, còn các site cao cấp sẽ tốn gấp hai đến mười lần.
Tính năng chính:
- Định hướng monitoring và cảnh báo rất tốt
- Phù hợp với kiểm tra giá hoặc tồn kho định kỳ
- Tích hợp với Sheets, Airtable, webhook và workflow API
- Thiết lập đầu tiên nhanh cho người không thiên về kỹ thuật
Ưu điểm: Rất tốt cho các use case kiểu “có gì thay đổi”, dễ thiết lập cho người không biết code. Nhược điểm: Kém linh hoạt hơn các scraper tổng quát trên những site lạ hoặc phức tạp. Khả năng biến đổi dữ liệu bằng AI tích hợp sẵn còn hạn chế so với Thunderbit.
Phù hợp nhất cho: Đội ecommerce theo dõi giá đối thủ, người không biết code cần cảnh báo thay đổi.
12. ScrapeHero
 ScrapeHero là ngoại lệ vì đây không chủ yếu là một công cụ phần mềm. Đây là một dịch vụ scraping được quản lý. Bạn nói họ cần dữ liệu gì, và đội của họ sẽ xây dựng, duy trì, QA và bàn giao bộ dữ liệu.
Giá phản ánh mô hình dịch vụ: dự án theo yêu cầu bắt đầu từ $550 mỗi website, gói Business hàng tháng từ $199 cho tối đa hai website với 1–5K trang mỗi site, Enterprise Basic từ $1,500/tháng cho tối đa bốn website với tổng số trang được gộp lại và phần tăng thêm tính $650–$2,200 cho mỗi triệu trang, còn Enterprise Premium từ $8,000. Phí thiết lập là một khoản riêng trả một lần ở Business và Enterprise Basic. Quy trình bàn giao bao gồm đội dự án riêng, QA thủ công và định dạng tuỳ chỉnh.
Tính năng chính:
- Gần như không phải bảo trì ở phía khách hàng
- QA thủ công và định dạng bàn giao tuỳ chỉnh
- Phù hợp cho dự án đa website phức tạp
- Tư thế tuân thủ cho yêu cầu enterprise
Ưu điểm: Không phải bảo trì, xử lý tốt dự án phức tạp, dịch vụ cao cấp. Nhược điểm: Đắt hơn so với công cụ tự phục vụ. Thời gian phản hồi ban đầu chậm hơn so với tự làm. Không hề là self-serve.
Phù hợp nhất cho: Doanh nghiệp thuê ngoài scraping, đội coi trọng việc nhận dữ liệu hơn là sở hữu công cụ, dự án đa website phức tạp thay đổi thường xuyên.
Chi phí thực sự của các dịch vụ web scraping ở mức 10K, 100K và 1M trang
So sánh các dịch vụ theo giá là chuyện khó chịu vì nhà cung cấp tính theo nhiều đơn vị khác nhau — trang, bản ghi, credit, thời gian compute, hàng hoặc mức tối thiểu dự án. Vì vậy bảng dưới đây báo cáo con số duy nhất còn ý nghĩa sau khi quy đổi: thẻ của bạn thực sự bị trừ bao nhiêu trong tháng đó. Mọi con số đều là giá niêm yết tháng-tháng của gói rẻ nhất đủ cho mức volume đó tính theo trang thuần — không có render JavaScript, không có premium proxy — và đã trừ đi phần miễn phí hàng tháng do nhà cung cấp công bố. Phí proxy, add-on CAPTCHA và thời gian kỹ thuật không được cộng vào con số; chúng được ghi rõ ở cột cuối. Khi không có gói nào được công bố chạm tới mức volume đó, ô tương ứng sẽ ghi Custom quote thay vì kéo căng gói cao nhất cho vừa. Và khi nhà cung cấp không bán theo trang, ô sẽ ghi chính xác họ bán theo gì thay vì tự bịa ra giá theo trang.
| Dịch vụ | Gói miễn phí | Hóa đơn/tháng ở 10K trang | Hóa đơn/tháng ở 100K trang | Hóa đơn/tháng ở 1M trang | Cách tính và những gì con số chưa bao gồm |
|---|---|---|---|---|---|
| Thunderbit API | 600 unit, một lần | $72 Pro 1 | $120 Pro 2 | Báo giá tuỳ chỉnh | Distill tính 1 unit mỗi trang, Extract 20. 600 unit miễn phí là khoản cấp một lần, không phải hạn mức hàng tháng, nên không cần trừ gì cả. Tự phục vụ dừng ở 480,000 unit/tháng. |
| Bright Data | 5,000 bản ghi/tháng | $7.50 cho 10K bản ghi | $142.50 cho 100K bản ghi | $1,293 cho 1M bản ghi | Tính theo bản ghi — một mục được trích xuất, một dòng trong bảng — không phải theo trang được tải, nên một trang danh sách có thể tiêu tốn nhiều bản ghi. Trừ 5,000 bản ghi miễn phí khỏi cả ba mức. Ở 1M, gói Scale tốt hơn pay-as-you-go: $499 cộng 611,000 bản ghi thêm ở $1.30/1K. |
| Oxylabs | Dùng thử, 2K kết quả | $49 Micro | $249 Advanced | $999 Business | Tính theo kết quả thành công với mức giá do website đích và cấp gói quyết định. Số lượng kết quả nổi bật trên trang giá giả định Amazon không render JS — trên website thường với $1.15/1,000, gói Micro $49 chỉ khoảng 42,600 kết quả chứ không phải 98,000. Kết quả dùng thử không gia hạn, nên không cần trừ. |
| Apify | $5 mức dùng/tháng | Từ $29/tháng + phí sử dụng | Từ $29/tháng + phí sử dụng | Từ $29/tháng + phí sử dụng | Không tính theo trang. Phí gói là mức dùng trả trước — $29 Starter, $199 Scale, $999 Business — được tiêu vào compute unit và các Actor trên Store có giá theo kết quả riêng, nên chỉ nhìn số trang thì không ra hóa đơn. Proxy là add-on riêng. |
| ScrapingBee | 1,000 credit, một lần | $49 Freelance | $49 Freelance | $99 Startup | 1 credit cho request thường. Render JS, premium proxy, screenshots và AI extraction đều tốn nhiều credit hơn, nên trên mục tiêu thực tế bạn mua được ít trang hơn nhiều so với con số quảng cáo. Credit khi đăng ký không gia hạn, nên không cần trừ. |
| ScraperAPI | Dùng thử 7 ngày, 5,000 credit | $49 Hobby | $49 Hobby | $149 Startup | 1 credit cho request thường, nhưng Amazon là 5 và Google là 25. Ở mốc 100K trang, gói Hobby vừa đầy, không còn dư cho retry. Credit dùng thử không gia hạn, nên không cần trừ. |
| ZenRows | 5,000 credit/tháng | $19 Build | $39 Build | $199 Growth | 1 credit cho trang thường, 25 cho trang cần cả JS lẫn premium proxy. 5,000 credit miễn phí được trừ trước — còn 5,000, 95,000 và 995,000 trang tính phí — nhưng điều đó không làm đổi gói bạn phải mua. |
| Octoparse | Gói miễn phí, 10 tác vụ | Từ $39/tháng | Từ $39/tháng | Từ $39/tháng | Tính theo số tác vụ và concurrency trên cloud, không theo trang, nên không có volume trang nào khớp trực tiếp với một tier: Basic $39, Standard $83, Professional $299 theo tháng-tháng. Residential proxy và CAPTCHA được bán như add-on: $3/GB và $1–1.5 cho mỗi nghìn lần giải. |
| Diffbot | 10,000 credit/tháng | $0, gói miễn phí đủ | $299 Startup | $899 Plus | 1 credit cho mỗi trang được trích xuất. 10,000 credit miễn phí mỗi tháng được trừ ở đây đúng như ở mọi nơi khác: ở 10K nó bao trọn tháng, ở 100K còn 90,000 trang phải mua, ở 1M còn 990,000. |
| Firecrawl | 1,000 credit/tháng | $99 Standard | $99 Standard | $749 Scale | 1 credit mỗi trang scrape. Trừ credit miễn phí thì còn 9,000 trang ở mốc 10K, vẫn vượt Hobby 5,000, nên tier không đổi. Credit không được chuyển sang tháng sau dưới Scale. |
| Browse AI | 50 credit/tháng | $162 Professional | Báo giá tuỳ chỉnh | Báo giá tuỳ chỉnh | Tính bằng credit: một trang chi tiết là một task với mức tối thiểu một credit, và mười hàng cũng tốn một credit, nên một trang danh sách 50 hàng sẽ tốn năm credit. Site cao cấp tốn gấp hai đến mười lần. Self-serve dừng ở 30,000 credit/tháng, nên cao hơn mức đó sẽ phải báo giá. |
| ScrapeHero | Không có | Từ $199/tháng | Từ $1,500/tháng | Từ $1,500/tháng | Báo giá theo website, độ phức tạp và tần suất refresh chứ không theo trang: Business bao gồm tối đa 2 site với 1–5K trang mỗi site, Enterprise Basic gộp trang trên tối đa 4 site và cộng thêm $650–$2,200 cho mỗi triệu trang bổ sung. Phí thiết lập là một lần và tính riêng. |
Một vài ghi chú quan trọng:
- Sản phẩm browser của Thunderbit tính theo hàng và hướng tới người dùng, nên hàng ở trên dùng API — cụ thể là endpoint Distill, 1 unit mỗi trang Markdown, vì các hàng API khác cũng đang tính như vậy. Structured Extract là 20 unit mỗi trang, điều đó sẽ đẩy 10K trang lên $240 thay vì $72.
- Chi phí Apify phụ thuộc rất mạnh vào thời gian chạy actor, bộ nhớ và các dịch vụ bổ sung như proxy.
- ZenRows, ScrapingBee và ScraperAPI đều trông rẻ trên các trang công khai đơn giản, nhưng sẽ đắt nhanh khi cần render JS, premium proxy hoặc mục tiêu chống bot mạnh.
- Kinh tế đơn vị của ScrapeHero khác vì bạn đang trả cho kỹ thuật, QA và quản lý dự án — không chỉ cho compute.
Chi phí ẩn mà gần như mọi trang giá đều đánh giá thấp là bảo trì. Chi phí proxy nhìn có vẻ rẻ trên giấy, nhưng khi tính cả retry, duy trì parser, session bị chặn và công sức kỹ thuật, các dịch vụ scraping gộp thường thắng về tổng chi phí sở hữu.
Nếu bạn chỉ scrape thỉnh thoảng, phía no-code thường rẻ hơn để bắt đầu: gói miễn phí của Thunderbit gồm 6 trang mỗi tháng, và các gói browser trả phí bắt đầu từ $15/tháng, hoặc khoảng $9/tháng nếu thanh toán năm. Các dịch vụ API ở đây không phải cái nào cũng đắt hơn ngay từ đầu — ZenRows và Firecrawl đều bắt đầu từ $19/tháng — nhưng khối lượng nhỏ nhất họ bán cũng đã là hàng nghìn trang mỗi tháng, nên bạn đang trả cho năng lực mà có thể chưa dùng hết. Với pipeline enterprise ở mức 1M+ trang, các nền tảng full-stack hoặc managed service lại hợp lý hơn về mặt kinh tế dù giá niêm yết cao hơn, vì họ đã gói cả chi phí proxy.
Dữ liệu scrape của bạn đi đâu? So sánh xuất dữ liệu và tích hợp
JSON không giống Google Sheets. Với người không biết code, điểm đến của dữ liệu scrape quan trọng không kém gì quá trình trích xuất.
| Dịch vụ | CSV | JSON | Excel | Google Sheets | Airtable | Notion | CRM/API/Webhook |
|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ Gốc | ✅ Gốc | ✅ Gốc | Có API |
| Bright Data | ✅ | ✅ | ❌ Không native | Gián tiếp | Gián tiếp | Gián tiếp | API/webhook mạnh |
| Oxylabs | ✅ | ✅ | ❌ Không native | Gián tiếp | Gián tiếp | Gián tiếp | API mạnh |
| Apify | ✅ | ✅ | ✅ | Qua tích hợp | Qua tích hợp | Qua tích hợp | API mạnh |
| ScrapingBee | Qua công cụ | ✅ | ❌ | ❌ | ❌ | ❌ | API mạnh |
| ScraperAPI | ✅ trên structured endpoints | ✅ | ❌ | ❌ | ❌ | ❌ | API/webhook mạnh |
| ZenRows | Hạn chế | ✅ | ❌ | ❌ | ❌ | ❌ | API mạnh |
| Octoparse | ✅ | ✅ | ✅ | ✅ Gốc | ⚠️ Qua Zapier | ❌ | API, DB, Zapier |
| Diffbot | ✅ | ✅ | ❌ | Hỗ trợ qua workflow | Gián tiếp | Gián tiếp | API |
| Firecrawl | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | API |
| Browse AI | ✅ | ✅ | ❌ | ✅ Gốc | ✅ Gốc | ❌ | API, webhook, Zapier/Make |
| ScrapeHero | ✅ | ✅ | ✅ | Bàn giao tuỳ chỉnh | Bàn giao tuỳ chỉnh | Bàn giao tuỳ chỉnh | Bàn giao API/DB tuỳ chỉnh |
Đây là một trong những lợi thế rõ nhất của Thunderbit. Nếu đội của bạn sống trong Google Sheets hoặc Notion, các dịch vụ chỉ có API sẽ thêm bước nữa: phải viết code để chuyển JSON, tải lên thủ công, rồi lặp lại. Việc Thunderbit xuất miễn phí sang Sheets, Airtable và Notion — bao gồm cả upload ảnh vào Notion và Airtable — loại bỏ hoàn toàn ma sát này. Kết hợp với lập lịch scrape, dữ liệu có thể tự động chảy vào đúng nơi cần đến theo nhịp định kỳ mà không cần glue code.
Điều gì xảy ra khi website thay đổi? Bảo trì và độ tin cậy
Scraper sẽ hỏng. Đây là nỗi đau số một của toàn thị trường này.
Thị trường chia thành ba hồ sơ bảo trì:
- Công cụ dựa trên selector (Octoparse, nhiều actor của Apify, template của Browse AI): hỏng khi site đổi layout, cần cập nhật rule thủ công.
- Dịch vụ API có lớp parser trừu tượng (structured endpoints của ScraperAPI, structured datasets của Bright Data): xử lý tốt các site phổ biến nhưng gặp khó với trang ngách hoặc niche nơi parser chưa được build sẵn.
- Công cụ dùng AI (Thunderbit, Firecrawl, Diffbot): đọc lại trang từ đầu mỗi lần chạy, nên hầu hết thay đổi layout không cần cập nhật rule. Chế độ lỗi chuyển từ “selector bị gãy” sang “AI hiểu sai” — và thường dễ sửa bằng cách chỉnh prompt hơn là viết lại selector từ đầu.
Có một nút thắt độ tin cậy khác ngoài việc layout thay đổi: xử lý chống bot.
- Bright Data, Oxylabs và ZenRows là mạnh nhất ở mảng này.
- ScraperAPI và ScrapingBee khá ổn cho các target phổ biến có bảo vệ.
- Browse AI và Octoparse dễ gặp khó hơn trên các site động được bảo vệ mạnh.
- Chế độ browser của Thunderbit giúp ích cho các trang cần đăng nhập và cá nhân hóa, nơi các công cụ chỉ có API thường làm phức tạp thêm.
Kết luận: nếu bạn muốn gánh nặng bảo trì thấp nhất, trích xuất bằng AI (Thunderbit, Firecrawl, Diffbot) xử lý thay đổi layout tốt hơn các công cụ dựa trên selector. Nếu mối lo chính của bạn là chống bot, Bright Data, Oxylabs và ZenRows là những lựa chọn mạnh nhất. Phần lớn đội ngũ phải đối mặt với cả hai vấn đề, nên quyết định “loại nào phù hợp với đội của bạn” ở đầu bài này quan trọng hơn bất kỳ so sánh tính năng nào.
Những cân nhắc pháp lý và đạo đức khi web scraping
Scrape dữ liệu công khai thường là hợp pháp, nhưng điều đó không có nghĩa mọi use case đều an toàn. Các đội vẫn nên tôn trọng robots.txt khi phù hợp, kiểm tra điều khoản sử dụng, và tuân thủ luật bảo vệ dữ liệu cá nhân như GDPR và CCPA khi liên quan tới thông tin cá nhân. Các vụ án như hiQ v. LinkedIn ủng hộ quan điểm rằng scrape dữ liệu công khai không tự động là vi phạm CFAA ở Mỹ, nhưng các vấn đề về hợp đồng, bản quyền và quyền riêng tư vẫn là rủi ro riêng. Những nhà cung cấp enterprise như Bright Data, Oxylabs và ScrapeHero công khai tiếp thị các tính năng tuân thủ và quản trị. Với tất cả những người khác: hãy xin tư vấn pháp lý phù hợp với trường hợp của bạn trước khi scrape ở quy mô lớn. Để xem thêm bối cảnh, hãy đọc hướng dẫn của chúng tôi về tác động pháp lý của web scraping.
Vậy cuối cùng nên chọn dịch vụ web scraping nào?
Đủ rồi với các bảng so sánh. Đây là bản tóm tắt ngắn sau khi thử cả 12 công cụ:
Đội ngũ doanh nghiệp không thiên về kỹ thuật (sales, ops, marketing): Thunderbit. Scraping AI một nhấp, xuất miễn phí sang Sheets/Airtable/Notion, và ít phải sửa lại hơn nhiều khi website đổi layout. Nó giải quyết cùng lúc hai nguồn ma sát lớn nhất — độ phức tạp khi thiết lập và ma sát khi xuất dữ liệu sau scrape.
Developer xây dựng pipeline scraping:
- ScrapingBee nếu bạn muốn trải nghiệm API gọn gàng nhất
- ScraperAPI nếu bạn muốn structured endpoints và giám sát ecommerce định kỳ
- ZenRows nếu vấn đề thật của bạn là chống bot
Đội ngũ đưa dữ liệu vào workflow AI/LLM:
- Firecrawl nếu output cần Markdown hoặc JSON theo schema
- Thunderbit API nếu cùng đội cũng cần đường no-code, vì extension và API dùng cùng mô hình trích xuất
- Diffbot nếu bạn đang xây một lớp kiến thức enterprise
Doanh nghiệp cần quy mô lớn + hạ tầng proxy:
- Bright Data cho stack enterprise rộng nhất
- Oxylabs nếu độ tin cậy trên mục tiêu được bảo vệ là quan trọng nhất
Đội muốn một marketplace scraper dựng sẵn: Apify.
Công ty muốn giao hẳn việc bàn giao: ScrapeHero.
Đội ngũ nhạy cảm về ngân sách nhưng cần monitoring không cần code: Browse AI.
Người dùng no-code muốn trình dựng desktop trực quan với mức kiểm soát thủ công cao hơn: Octoparse.
Với phổ nhu cầu doanh nghiệp rộng nhất, Thunderbit vẫn là lựa chọn thắng vì nó loại bỏ hai rào cản giết chết việc áp dụng: thiết lập kỹ thuật và ma sát khi xuất dữ liệu. Hãy thử gói miễn phí hoặc cài Chrome extension để tự kiểm chứng. Và nếu Thunderbit không phù hợp, hãy thử thêm vài công cụ khác trong danh sách này — chưa bao giờ có thời điểm tốt hơn để ngừng copy-paste thủ công. Để xem video hướng dẫn cách các công cụ này hoạt động trong thực tế, hãy xem kênh YouTube Thunderbit.
Thử tiện ích Thunderbit Chrome
Câu hỏi thường gặp
Dịch vụ web scraping là gì?
Dịch vụ web scraping là một công cụ hoặc nhà cung cấp dịch vụ quản lý giúp thu thập dữ liệu từ website thay cho bạn. Một số là ứng dụng no-code chạy ngay trong trình duyệt, một số là API dành cho developer, và một số là agency quản lý trọn gói, bàn giao dữ liệu sạch mà bạn không cần tự vận hành hạ tầng.
Tôi có cần biết code để dùng dịch vụ web scraping không?
Không phải lúc nào cũng cần. Các công cụ như Thunderbit, Browse AI và Octoparse được xây cho người không chuyên kỹ thuật. Các dịch vụ API như ScrapingBee, ScraperAPI, Firecrawl và ZenRows giả định có developer tham gia. ScrapeHero nằm ở phía còn lại — đội của họ sẽ xử lý toàn bộ dự án cho bạn.
Dịch vụ web scraping nào tốt nhất cho doanh nghiệp nhỏ?
Với hầu hết doanh nghiệp nhỏ, Thunderbit là gợi ý an toàn nhất. Nó có gói miễn phí không hết hạn (6 trang mỗi tháng), ít rào cản thiết lập và xuất dữ liệu trực tiếp sang các đích thân thiện với doanh nghiệp như Google Sheets, Airtable và Notion. Browse AI cũng phù hợp nếu nhu cầu chính là theo dõi thay đổi theo thời gian.
Dịch vụ web scraping giá bao nhiêu?
Biên độ rất rộng. Một số dịch vụ có gói miễn phí hoặc bản dùng thử. Các API dành cho developer trong danh sách này bắt đầu từ khoảng $19 đến $49 mỗi tháng, và các nền tảng AI cấp enterprise cao hơn nhiều — như Diffbot là $299. Công cụ no-code thường bắt đầu từ khoảng $15 đến $48 mỗi tháng. Dịch vụ enterprise và managed service có thể nhanh chóng lên tới hàng trăm hoặc hàng nghìn đô mỗi tháng. Câu chuyện chi phí lớn hơn không chỉ là giá thuê bao mà còn là các hệ số cho render JS, premium proxy, và thời gian nội bộ cần để giữ scraper hoạt động.
Dịch vụ web scraping có hợp pháp không?
Thường là có nếu dữ liệu là công khai, nhưng tính hợp pháp còn phụ thuộc vào website, loại dữ liệu, khu vực pháp lý của bạn và cách bạn dùng đầu ra. Vấn đề riêng tư, bản quyền và hợp đồng vẫn quan trọng, ngay cả khi scrape các trang công khai. Hãy tham khảo tư vấn pháp lý cho trường hợp cụ thể của bạn.
Thử Thunderbit cho web scraping bằng AI Get Started Free
Tìm hiểu thêm



