
Web đang ngập dữ liệu, và nói thật nhé—không ai có thời gian ngồi copy-paste từng dòng qua hàng ngàn danh sách sản phẩm hay trang giá đối thủ. Nếu bạn đang dùng Linux (như tôi vẫn dùng cho phần lớn công việc tự động hóa và phát triển), bạn hẳn cũng biết nền tảng này là một “cỗ máy” cực mạnh cho các đội ngũ làm việc dựa trên dữ liệu. Thực tế, các hệ thống thuộc họ Unix đang vận hành 91,9% số website mà hệ điều hành của chúng được xác định, trong đó Linux là biến thể phổ biến nhất với khoảng cách rất lớn. Nhưng vấn đề là: tìm đúng web scraper cho Linux thật sự hợp với quy trình của bạn—dù bạn là người dùng doanh nghiệp không chuyên kỹ thuật hay một lập trình viên “cứng”—có khi còn khó hơn mò kim đáy bể.
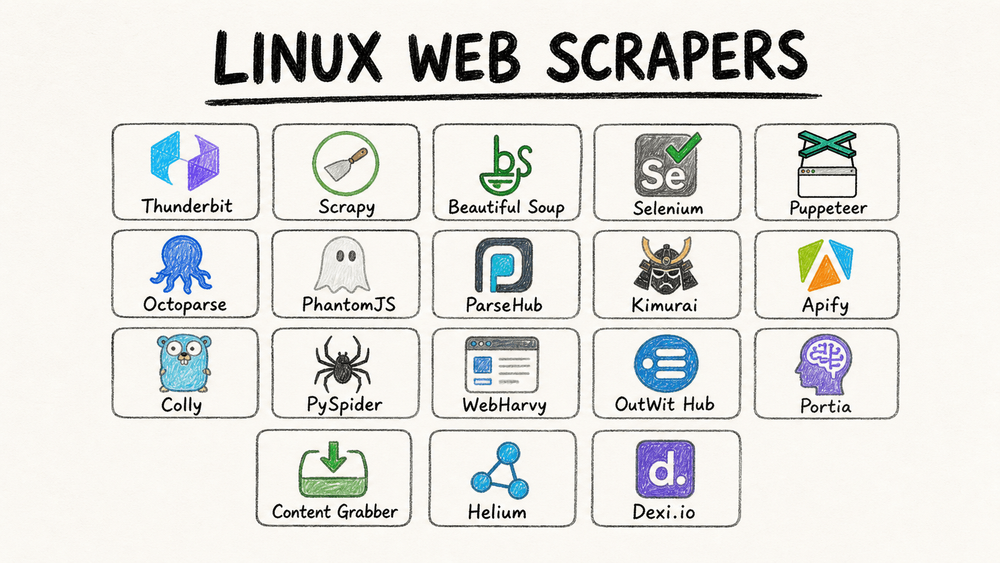
Vì vậy, tôi đã tổng hợp bài phân tích chuyên sâu này về 18 công cụ web scraping Linux tốt nhất cho năm 2026. Từ các giải pháp AI, không cần code như Thunderbit (đúng, đây là sản phẩm mà đội ngũ của tôi và tôi đã xây dựng) cho đến những framework kinh điển dành cho lập trình viên như Scrapy và Beautiful Soup, danh sách này sẽ giúp bạn chọn nhanh web scraper tốt nhất cho Linux đúng theo nhu cầu—khỏi phải thử đi thử lại đầy mệt mỏi.
Vì Sao Công Cụ Web Scraping Linux Lại Quan Trọng Với Người Dùng Doanh Nghiệp
Bỏ qua công đoạn copy-paste trước khi chọn công cụ Thunderbit chạy trong Chrome trên máy Linux của bạn — không cần cài gói, không cần driver, chỉ cần 1 click là ra bảng dữ liệu có cấu trúc. Get Started Free
Nói thẳng ra: thu thập dữ liệu thủ công là sát thủ của năng suất. Nhiều nghiên cứu cho thấy các đội vẫn phải dựa vào copy-paste có thể lãng phí hàng giờ mỗi tuần và tỷ lệ lỗi lên tới gần 5%—đó là công thức dẫn đến sai sót tốn kém và bỏ lỡ cơ hội (Thunderbit Blog). Linux, với độ ổn định, bảo mật và tính linh hoạt cao, là nền tảng lý tưởng để chạy các scraper cần hoạt động 24/7—dù bạn dùng máy cá nhân, máy chủ hay cloud.
Các trường hợp sử dụng phổ biến của công cụ web scraping Linux:
- Tạo lead: Đội sales trích xuất dữ liệu từ danh bạ, mạng xã hội hoặc các trang review để có liên hệ mới mà không phải làm thủ công (Thunderbit Blog).
- Theo dõi giá: Đội thương mại điện tử tự động lấy giá và tồn kho của đối thủ để luôn giữ giá bán cạnh tranh và cập nhật.
- Nghiên cứu đối thủ: Marketing và vận hành theo dõi sản phẩm mới, đánh giá và từ khóa SEO—không còn phải “bay trong mù mờ”.
- Phân tích thị trường: Nhà phân tích tổng hợp tin tức, diễn đàn và dữ liệu mạng xã hội để phát hiện xu hướng theo thời gian thực.
- Tự động hóa quy trình: Một số công cụ (đặc biệt là công cụ tích hợp AI) còn có thể tự động hóa quy trình web, như điền form hoặc thao tác trên dashboard, ngay từ máy Linux của bạn.
Điều tuyệt nhất là gì? Công cụ web scraping Linux phù hợp có thể trao quyền cho cả người không chuyên kỹ thuật—không chỉ lập trình viên—để khai thác dữ liệu web và đưa ra quyết định kinh doanh nhanh hơn, thông minh hơn.
Chúng Tôi Đã Chọn Web Scraper Tốt Nhất Cho Linux Như Thế Nào
Không phải scraper nào cũng giống nhau, đặc biệt là trên Linux. Đây là các tiêu chí tôi dùng:
- Tương thích với Linux: Mọi công cụ trong danh sách đều chạy native trên Linux, qua trình duyệt, hoặc có cách xử lý đơn giản (như Wine hay truy cập cloud).
- Dễ sử dụng: Từ prompt AI bằng ngôn ngữ tự nhiên đến giao diện trực quan kiểu point-and-click, tôi ưu tiên các công cụ giúp người không biết code vẫn có thể ra kết quả nhanh—nhưng cũng không bỏ qua người dùng nâng cao muốn toàn quyền kiểm soát.
- Sức mạnh trích xuất dữ liệu: Có xử lý được nội dung động, phân trang, subpage và nhiều kiểu dữ liệu khác nhau không? Có vượt qua được các chiêu chống scrape không?
- Khả năng mở rộng và tự động hóa: Lên lịch, scrape trên cloud, crawl phân tán—đây là những thứ bắt buộc cho các dự án dữ liệu nghiêm túc.
- Tích hợp và xuất dữ liệu: CSV, Excel, Google Sheets, API—nếu không lấy dữ liệu ra được thì còn ý nghĩa gì?
- Giá và giấy phép: Miễn phí, mã nguồn mở hay trả phí—luôn có lựa chọn cho mọi ngân sách, từ founder độc lập đến doanh nghiệp lớn.
- Cộng đồng và hỗ trợ: Cộng đồng hoạt động mạnh, tài liệu tốt và hỗ trợ nhanh sẽ tạo khác biệt rất lớn khi bạn gặp sự cố.
Tôi cũng kết hợp phản hồi thực tế từ người dùng, đánh giá trong ngành và trải nghiệm trực tiếp của mình với những công cụ này. Cùng đi vào danh sách nhé.
1. Thunderbit
 Thunderbit là lựa chọn hàng đầu của tôi cho người dùng doanh nghiệp đang tìm một web scraper cho Linux thật sự dễ dùng. Là một tiện ích Chrome tích hợp AI, nó chạy mượt trên Linux (chỉ cần mở Chrome hoặc Chromium) và cho phép bạn scrape dữ liệu từ bất kỳ website nào chỉ với một cú click.
Điểm nổi bật của Thunderbit:
- Prompt ngôn ngữ tự nhiên: Chỉ cần mô tả bạn muốn gì (“Trích xuất toàn bộ tên sản phẩm và giá trên trang này”), AI của Thunderbit sẽ lo phần còn lại.
- AI Suggest Fields: Chỉ cần click một lần, Thunderbit sẽ quét trang và gợi ý cột cùng kiểu dữ liệu—không cần chọn field thủ công.
- Scrape subpage và phân trang: Cần thêm chi tiết? Thunderbit có thể vào từng subpage (như trang chi tiết sản phẩm) và tự động làm giàu bảng dữ liệu của bạn.
- Scrape trên cloud hoặc local: Có thể scrape cùng lúc tới 50 trang trên cloud, hoặc dùng chế độ trình duyệt cho những website cần đăng nhập.
- Xuất dữ liệu tức thì: Một click để xuất sang Excel, Google Sheets, Airtable, Notion, CSV hoặc JSON—luôn miễn phí.
- Công cụ bổ sung: Trích xuất email, số điện thoại và hình ảnh chỉ với một click. AI autofill còn có thể tự động điền form.
Giá: Gói miễn phí (6 trang/tháng), các gói trả phí bắt đầu từ 15 USD/tháng cho 500 dòng (Thunderbit Pricing). Người dùng rất thích phần “gần như không cần học gì” và cách nó “biến hàng giờ làm việc thành vài phút” (Product Hunt Reviews). Với tác vụ lớn, bạn có thể cần chia thành nhiều lần chạy nhỏ hơn, nhưng với hầu hết nhu cầu doanh nghiệp, đây là công cụ tiết kiệm thời gian cực lớn.
Tương thích Linux: 100%. Chỉ cần chạy Chrome/Chromium trên desktop hoặc server Linux.
Phù hợp nhất cho: Người dùng doanh nghiệp không chuyên kỹ thuật (sales, marketing, vận hành) muốn thiết lập nhanh và dễ nhất.
Dùng thử Thunderbit miễn phí trên Linux Chạy trong Chrome trên mọi máy Linux — không cần build package, không cần cài driver, chỉ 1 click là trích xuất. Get Started Free
2. Scrapy
 Scrapy là chuẩn vàng cho các lập trình viên Python muốn một web scraper cho Linux linh hoạt và có khả năng mở rộng. Đây là mã nguồn mở, tốc độ cực nhanh (crawl bất đồng bộ), và có thể xử lý từ các tác vụ scrape đơn giản đến những chiến dịch crawl phân tán quy mô lớn.
Tính năng chính:
- Crawl bất đồng bộ, tốc độ cao—rất phù hợp để scrape hàng nghìn trang.
- Khả năng mở rộng mạnh: Hỗ trợ plugin cho proxy, CAPTCHA và nhiều thứ khác.
- Tích hợp với hệ sinh thái dữ liệu Python: Xuất ra JSON, CSV, cơ sở dữ liệu hoặc pandas.
- Xử lý cookie, session và tự điều chỉnh tốc độ.
Giá: Miễn phí 100% và mã nguồn mở.
Tương thích Linux: Native (cài qua pip). Chạy rất tốt trên server và container.
Phù hợp nhất cho: Lập trình viên xây scraper tùy chỉnh, quy mô lớn.
Lưu ý: Người không biết code sẽ cần thời gian làm quen, nhưng nếu bạn biết Python thì Scrapy rất khó bị vượt qua.
3. Beautiful Soup
 Beautiful Soup là một thư viện Python nhẹ dùng để phân tích HTML và XML. Đây là lựa chọn quen thuộc cho các tác vụ scrape nhanh, đơn giản hoặc xử lý những trang web lộn xộn.
Tính năng chính:
- API đơn giản, dễ hiểu—rất tốt cho người mới.
- Kết hợp tốt với requests để tải trang.
- Xử lý HTML lỗi khá mềm dẻo.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: 100% (thuần Python).
Phù hợp nhất cho: Lập trình viên và nhà khoa học dữ liệu làm các tác vụ scrape hoặc parse nhỏ đến vừa.
Hạn chế: Không xử lý JavaScript hay nội dung động—nên kết hợp với Selenium hoặc Puppeteer nếu cần.
4. Selenium
 Selenium là framework tự động hóa trình duyệt kinh điển. Nó cho phép bạn điều khiển Chrome, Firefox hoặc trình duyệt khác để scrape các website động, nặng JavaScript.
Tính năng chính:
- Điều khiển trình duyệt thật—có thể đăng nhập, click, cuộn và tương tác như người dùng.
- Hỗ trợ Python, Java, C# và nhiều ngôn ngữ khác.
- Chế độ headless để chạy trên server Linux.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: Hỗ trợ đầy đủ (chỉ cần cài đúng browser driver).
Phù hợp nhất cho: Kỹ sư QA, lập trình viên scrape và bất kỳ ai cần mô phỏng hành vi người dùng.
Lưu ý: Tốn tài nguyên và chậm hơn các scraper chỉ dùng HTTP, nhưng đôi khi đó là cách duy nhất để lấy được dữ liệu.
5. Puppeteer
 Puppeteer là thư viện Node.js của Google để điều khiển Chrome/Chromium headless. Nó giống Selenium nhưng có API JavaScript hiện đại và tích hợp chặt với tính năng của Chrome.
Tính năng chính:
- Chạy JavaScript, xử lý nội dung động và chụp screenshot.
- Nhanh, ổn định và dễ dùng với dev Node.js.
- Chặn request mạng và tài nguyên không mong muốn.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: Tự cài Chromium; mặc định chạy headless.
Phù hợp nhất cho: Lập trình viên scrape các ứng dụng web hiện đại hoặc website một trang (SPA).
6. Octoparse
 Octoparse là một web scraper không cần code với giao diện kéo-thả và rất nhiều mẫu dựng sẵn. Dù ứng dụng desktop chỉ có cho Windows/Mac, người dùng Linux vẫn có thể truy cập nền tảng cloud của Octoparse qua trình duyệt hoặc chạy ứng dụng Windows bằng Wine.
Tính năng chính:
- Hơn 100 mẫu scrape dựng sẵn cho Amazon, eBay, Zillow, v.v.
- Trình thiết kế workflow trực quan—point-and-click để xây scraper.
- Scrape và lên lịch trên cloud—để máy chủ của Octoparse lo phần nặng.
- Xuất dữ liệu sang Excel, CSV, JSON và cơ sở dữ liệu.
Giá: Gói miễn phí (10 tác vụ, khoảng 50K dòng/tháng). Các gói trả phí bắt đầu từ 69 USD/tháng cho gói Standard (thanh toán theo năm); Professional là 249 USD/tháng. (Octoparse Pricing)
Tương thích Linux: Truy cập cloud/web; ứng dụng desktop qua Wine.
Phù hợp nhất cho: Người không biết code cần dữ liệu thương mại điện tử hoặc marketplace nhanh.
7. PhantomJS
 PhantomJS là một trình duyệt WebKit headless từng là lựa chọn hàng đầu cho tự động hóa trình duyệt nhẹ. Hiện nay nó đã bị khai tử, nhưng vẫn chạy trên Linux cho các tác vụ legacy hoặc đơn giản.
Tính năng chính:
- Có thể viết script bằng JavaScript.
- Xử lý được mức độ JavaScript vừa phải và chụp screenshot/PDF.
- Không cần giao diện đồ họa.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: Native binary.
Phù hợp nhất cho: Dự án cũ hoặc môi trường không thể cài Chrome.
Lưu ý: Chính thức bị ngừng phát triển từ 2017, phát triển dừng vào tháng 3/2018; bản phát hành cuối là v2.1.1. Không có bản vá bảo mật, không có JavaScript engine hiện đại, và hỏng trên hầu hết website ngày nay. Với dự án mới, hãy dùng Puppeteer hoặc Playwright. Công cụ này vẫn được nhắc đến vì bạn có thể gặp nó trong các stack scrape Linux legacy được bàn giao lại.
8. ParseHub
 ParseHub là một web scraper trực quan, đa nền tảng với ứng dụng Linux native. Công cụ này rất hợp cho người không biết code nhưng muốn scrape các website phức tạp, động.
Tính năng chính:
- Giao diện point-and-click—chọn phần tử, xây workflow bằng trực quan.
- Xử lý nội dung động, bản đồ, cuộn vô hạn và nhiều hơn nữa.
- Chạy và lên lịch trên cloud.
- Xuất ra CSV, JSON hoặc qua API.
Giá: Gói miễn phí (5 dự án), gói trả phí từ 189 USD/tháng.
Tương thích Linux: Ứng dụng native cho Linux, Windows, Mac.
Phù hợp nhất cho: Nhà phân tích và người dùng bán kỹ thuật muốn có quyền kiểm soát mà không cần code.
9. Kimurai
 Kimurai là một framework web scraping bằng Ruby hỗ trợ Linux native. Nó giống Scrapy nhưng dành cho dev Ruby.
Tính năng chính:
- Hỗ trợ nhiều trình duyệt: Headless Chrome, Firefox, PhantomJS hoặc HTTP thuần.
- Xử lý bất đồng bộ cho độ đồng thời cao.
- DSL Ruby gọn gàng để viết spider.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: 100% (Ruby).
Phù hợp nhất cho: Lập trình viên Ruby hoặc team Rails cần scrape tùy chỉnh, đồng thời cao.
10. Apify
 Apify là một nền tảng web scraping trên cloud với SDK mã nguồn mở và marketplace chứa các “actor” dựng sẵn. Bạn có thể chạy scraper trên máy Linux hoặc trên cloud.
Tính năng chính:
- SDK cho Node.js, Python và nhiều ngôn ngữ khác.
- Marketplace các scraper dựng sẵn.
- Chạy trên cloud, lên lịch và tích hợp API.
Giá: Có gói miễn phí, tính phí theo mức sử dụng cloud.
Tương thích Linux: CLI/SDK chạy trên Linux; nền tảng cloud truy cập qua trình duyệt.
Phù hợp nhất cho: Dev muốn kết hợp code tùy chỉnh với hạ tầng cloud có sẵn.
11. Colly
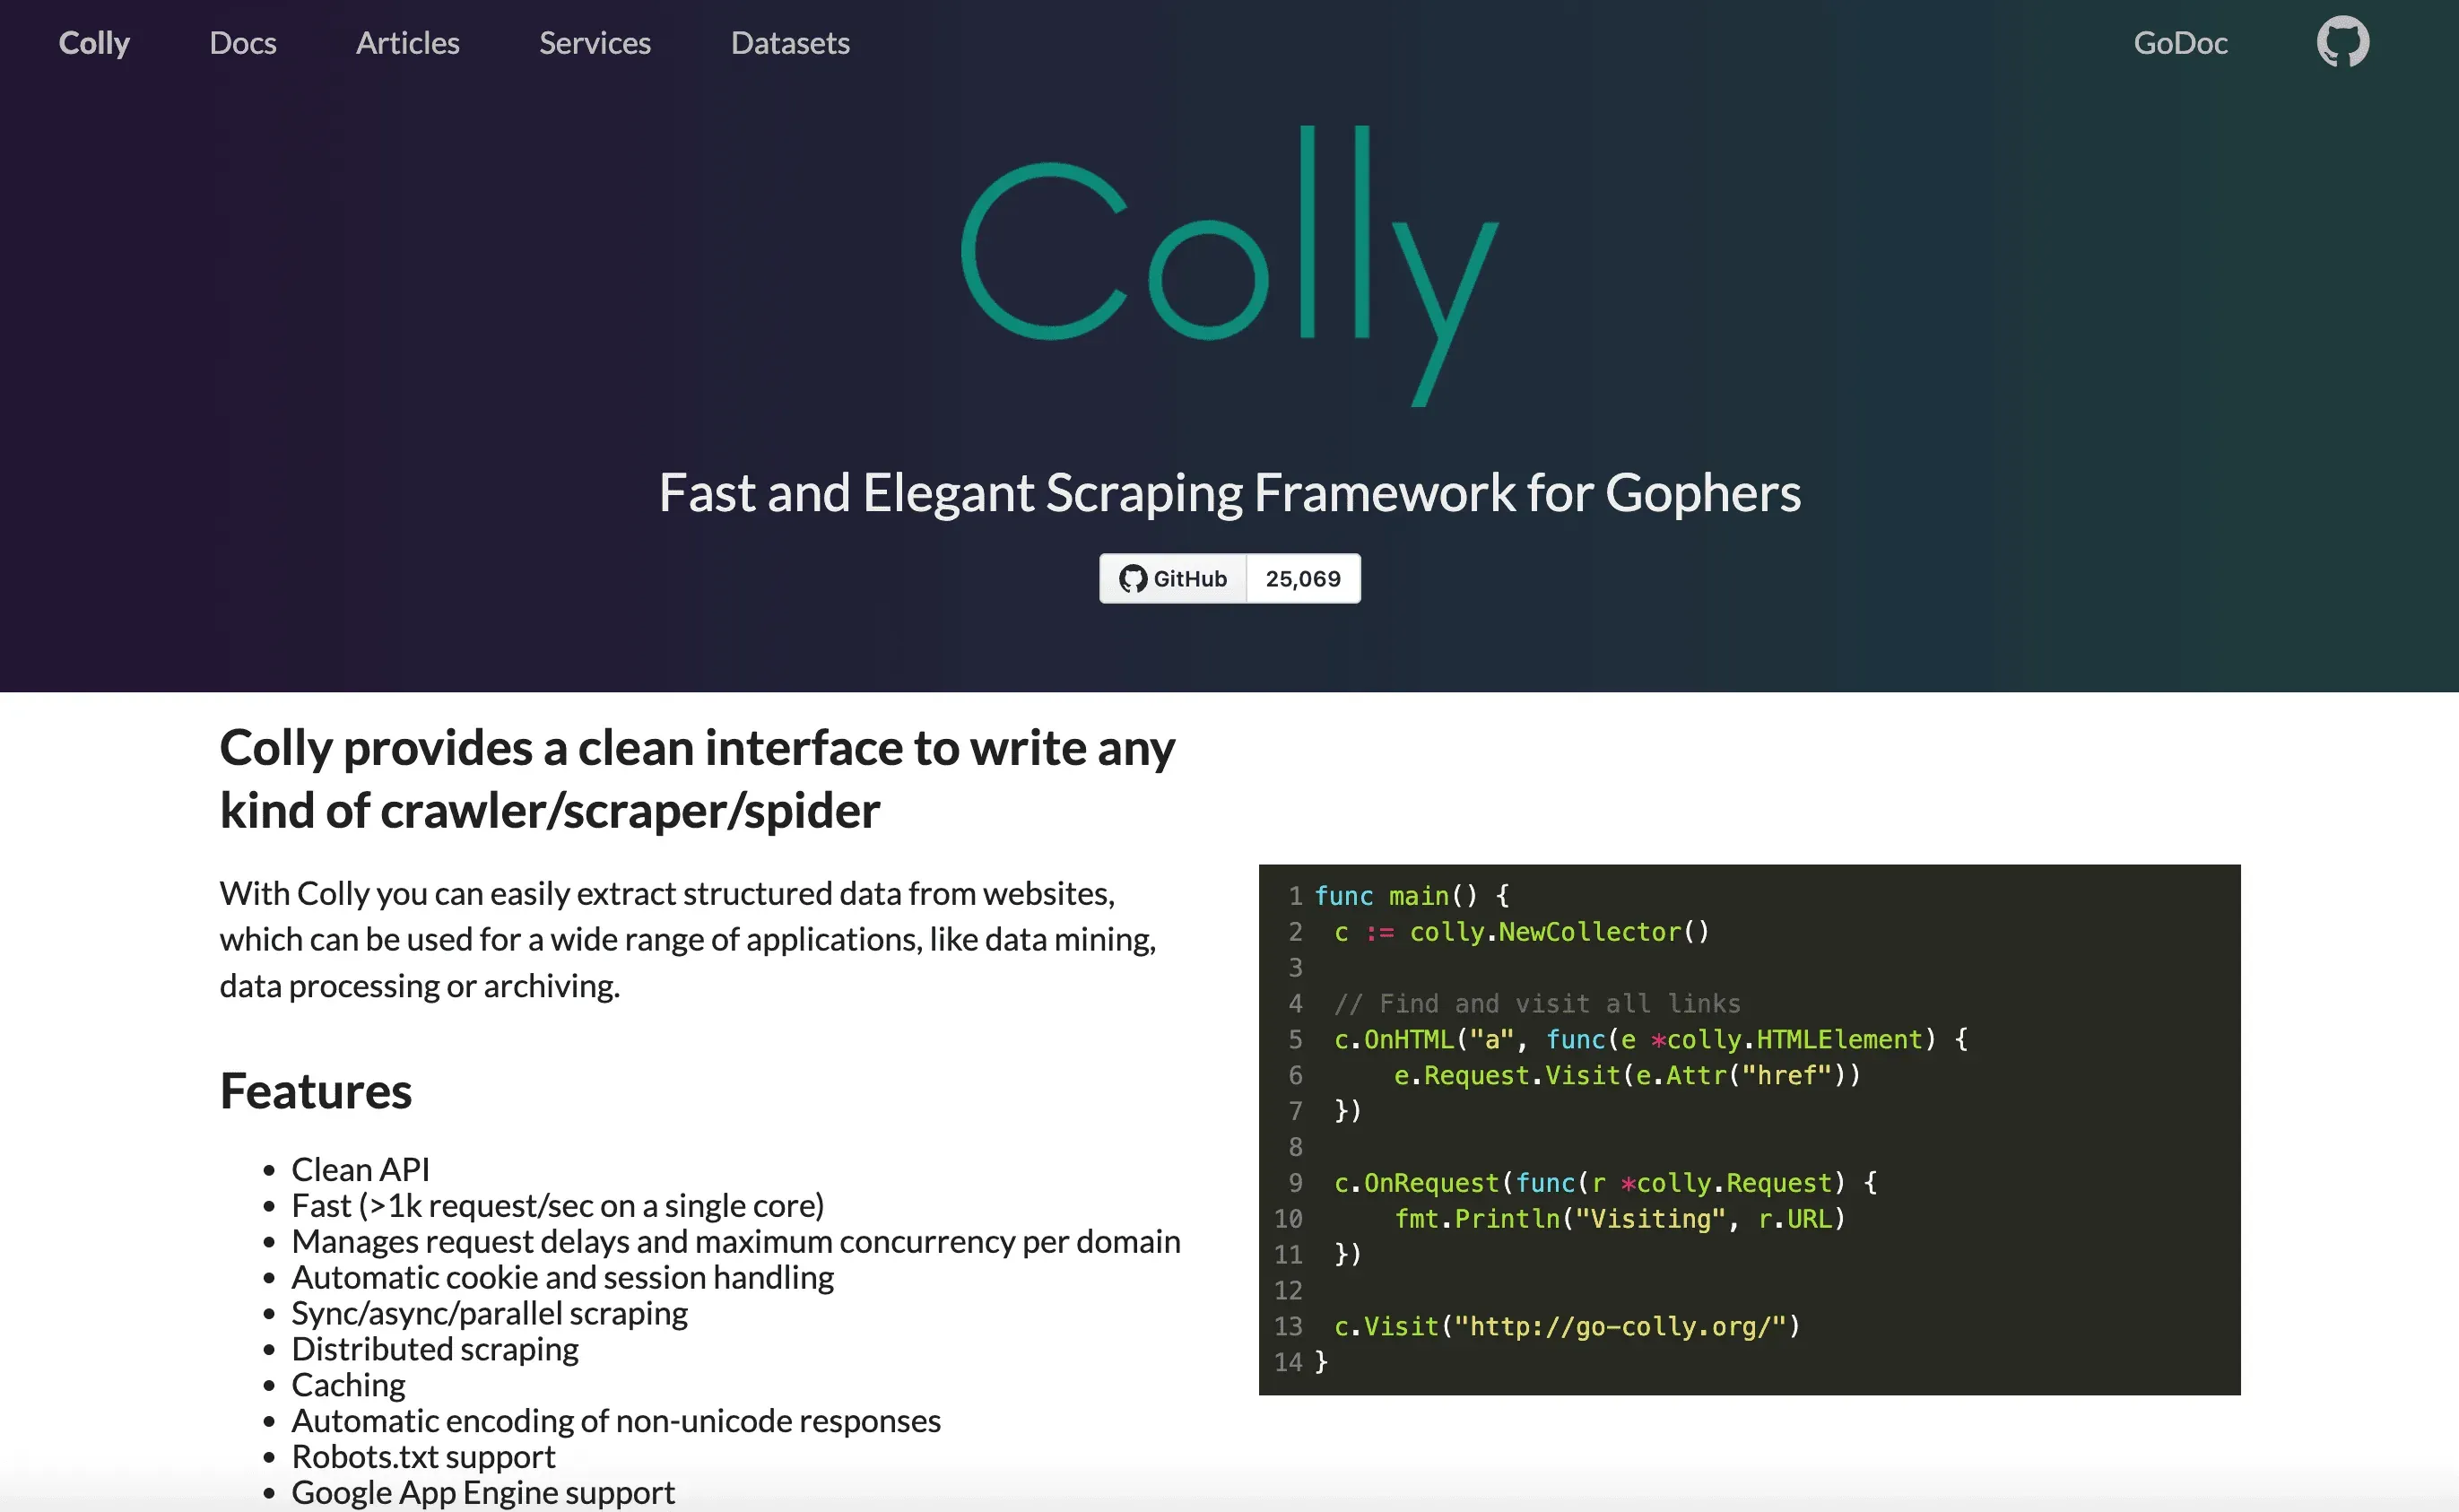 Colly là một framework web scraping bằng Go được xây dựng để đạt tốc độ và hiệu quả cao. Nếu bạn là Go developer, đây là công cụ dành cho bạn.
Tính năng chính:
- Scrape cực nhanh, đồng thời cao—hơn 1.000 request/giây trên một core.
- Crawl lịch sự (tôn trọng robots.txt), quản lý session/cookie.
- Bộ nhớ tiêu thụ thấp.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: Native Go binaries.
Phù hợp nhất cho: Lập trình viên Go cần scraping hiệu năng cao.
12. PySpider
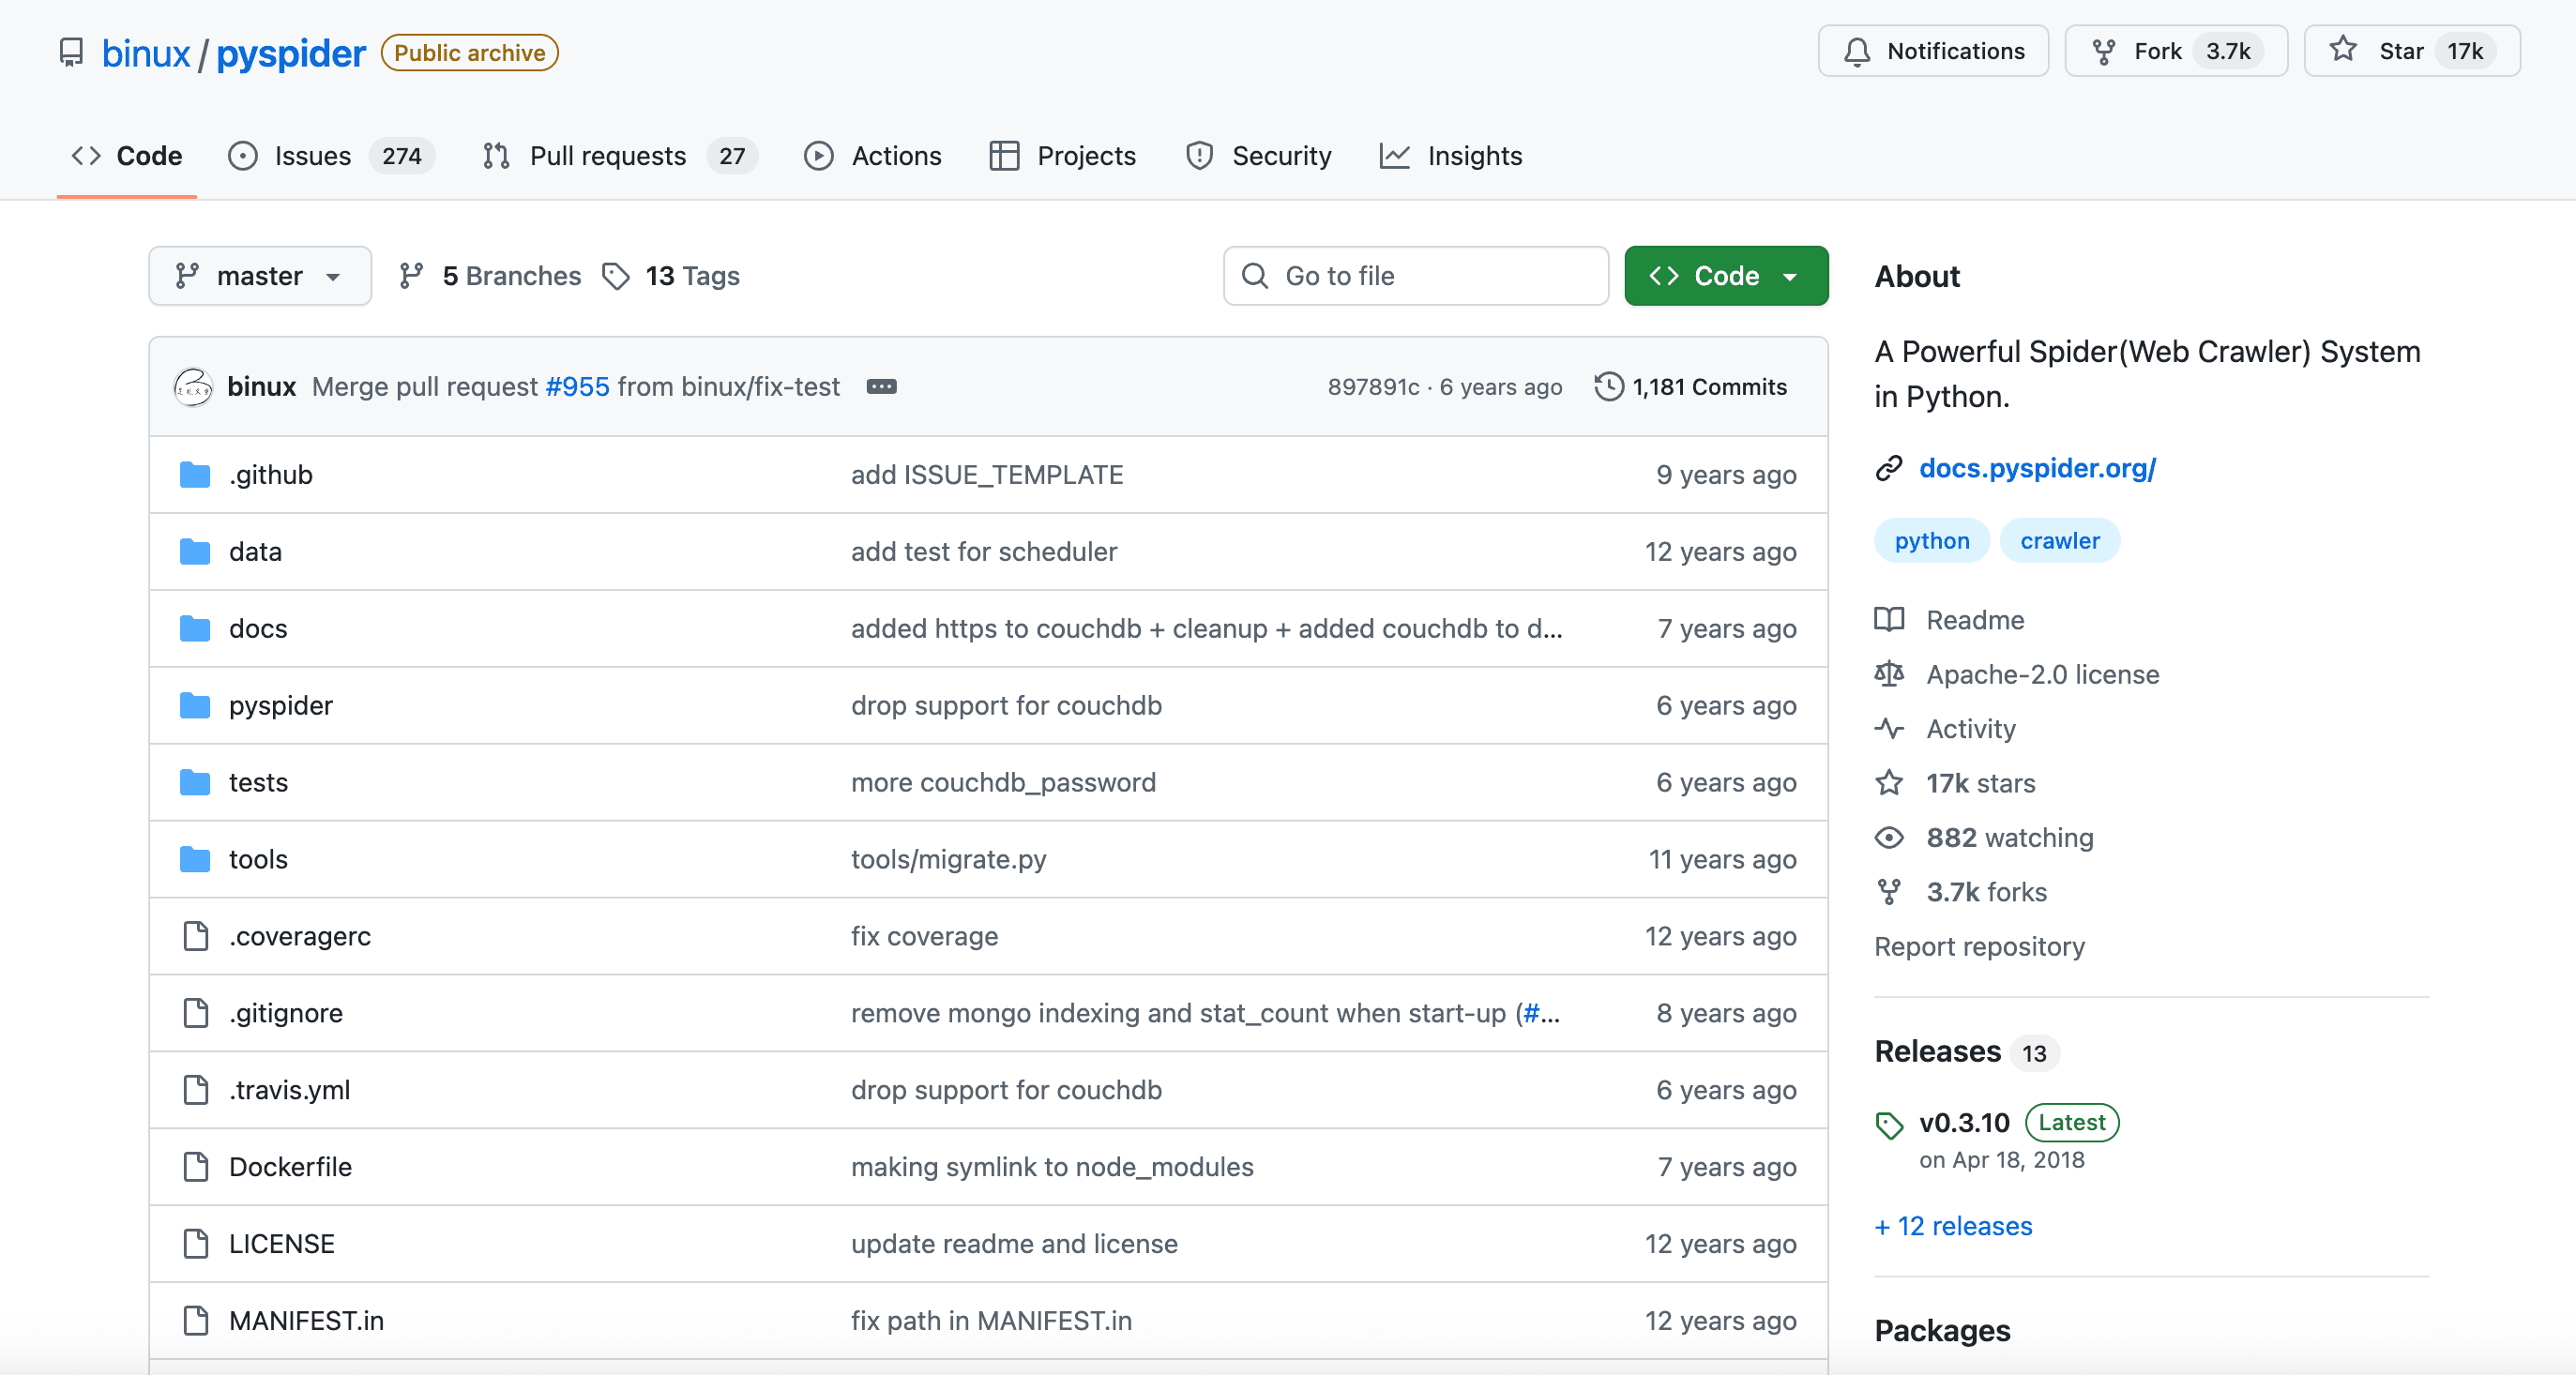 PySpider là một hệ thống web crawler bằng Python có giao diện web — bạn có thể quản lý, lên lịch và theo dõi các lượt crawl ngay trên trình duyệt. Cần nói rõ từ đầu: repo này đã được đánh dấu là public archive trên GitHub và tác giả gốc không còn phát hành bản mới, nên những gì bạn thấy gần như là “có gì dùng nấy”. Nếu bạn chỉ cần kiểu UI/dashboard của nó trên Linux thì vẫn chạy; còn với thứ bạn định phụ thuộc lâu dài, hãy xem nó như một giải pháp legacy.
Tính năng chính:
- Giao diện web để viết script và giám sát.
- Crawl phân tán, lên lịch và thử lại.
- Tích hợp với cơ sở dữ liệu và message queue.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: Thiết kế cho triển khai Linux.
Phù hợp nhất cho: Team chấp nhận fork và tự duy trì UI web cho nhiều dự án scrape (đừng kỳ vọng có bản sửa từ upstream).
13. WebHarvy
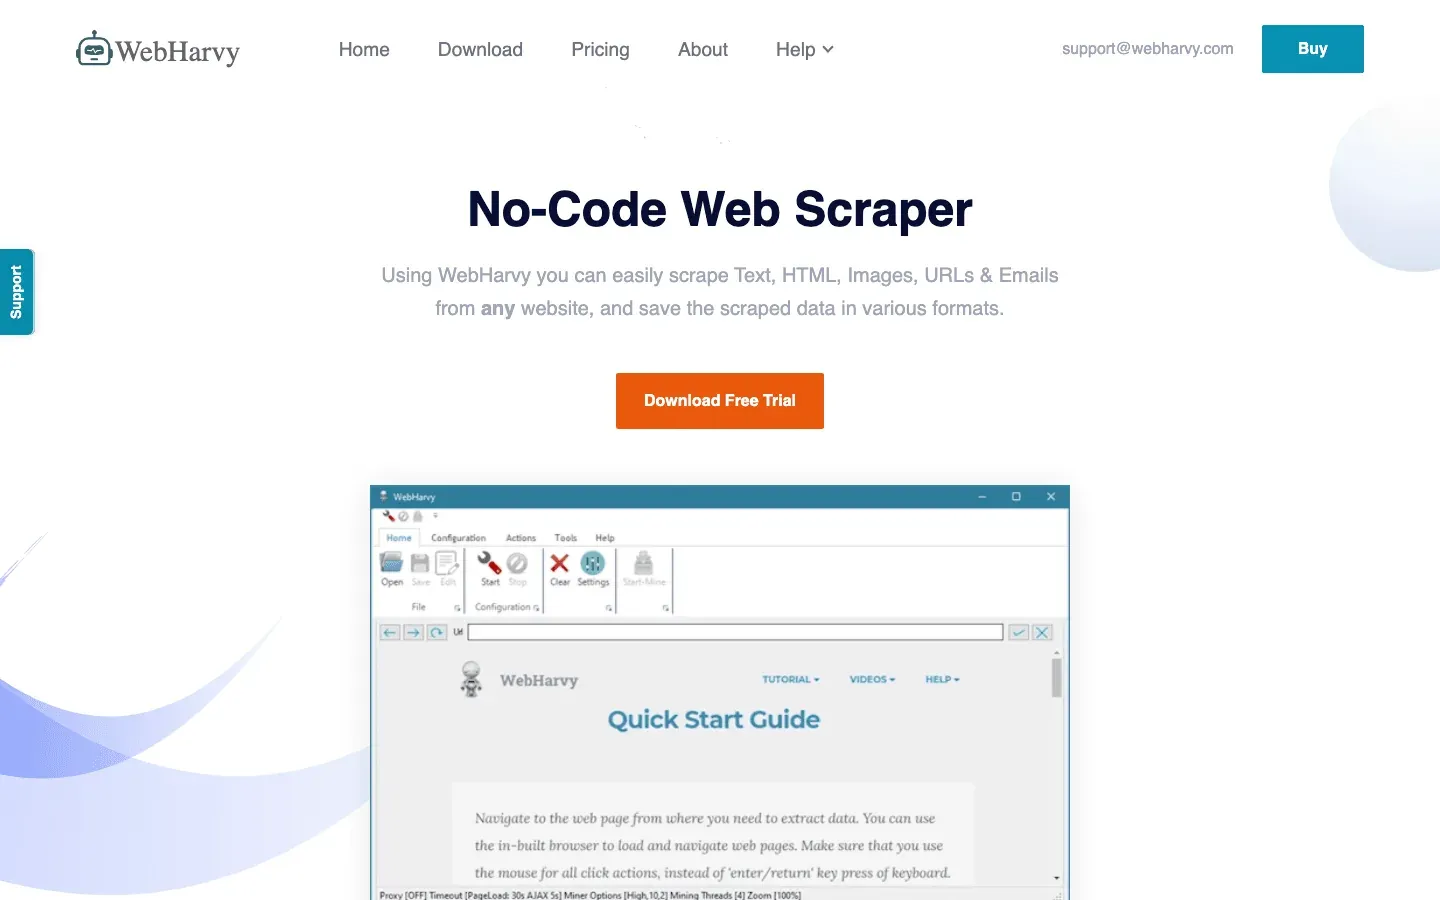 WebHarvy là một scraper trực quan kiểu point-and-click dành cho Windows, nhưng người dùng Linux có thể chạy qua Wine. Công cụ này nổi tiếng nhờ khả năng nhận diện mẫu dữ liệu và mô hình mua một lần.
Tính năng chính:
- Duyệt và click để chọn dữ liệu—không cần code.
- Tự động nhận diện mẫu cho danh sách.
- Xuất ra CSV, JSON, XML, SQL.
Giá: Khoảng 129 USD bản quyền một lần.
Tương thích Linux: Chạy qua Wine hoặc VM.
Phù hợp nhất cho: Người mới hoặc cá nhân chuyên nghiệp muốn một scraper trực quan, nhanh gọn.
14. OutWit Hub
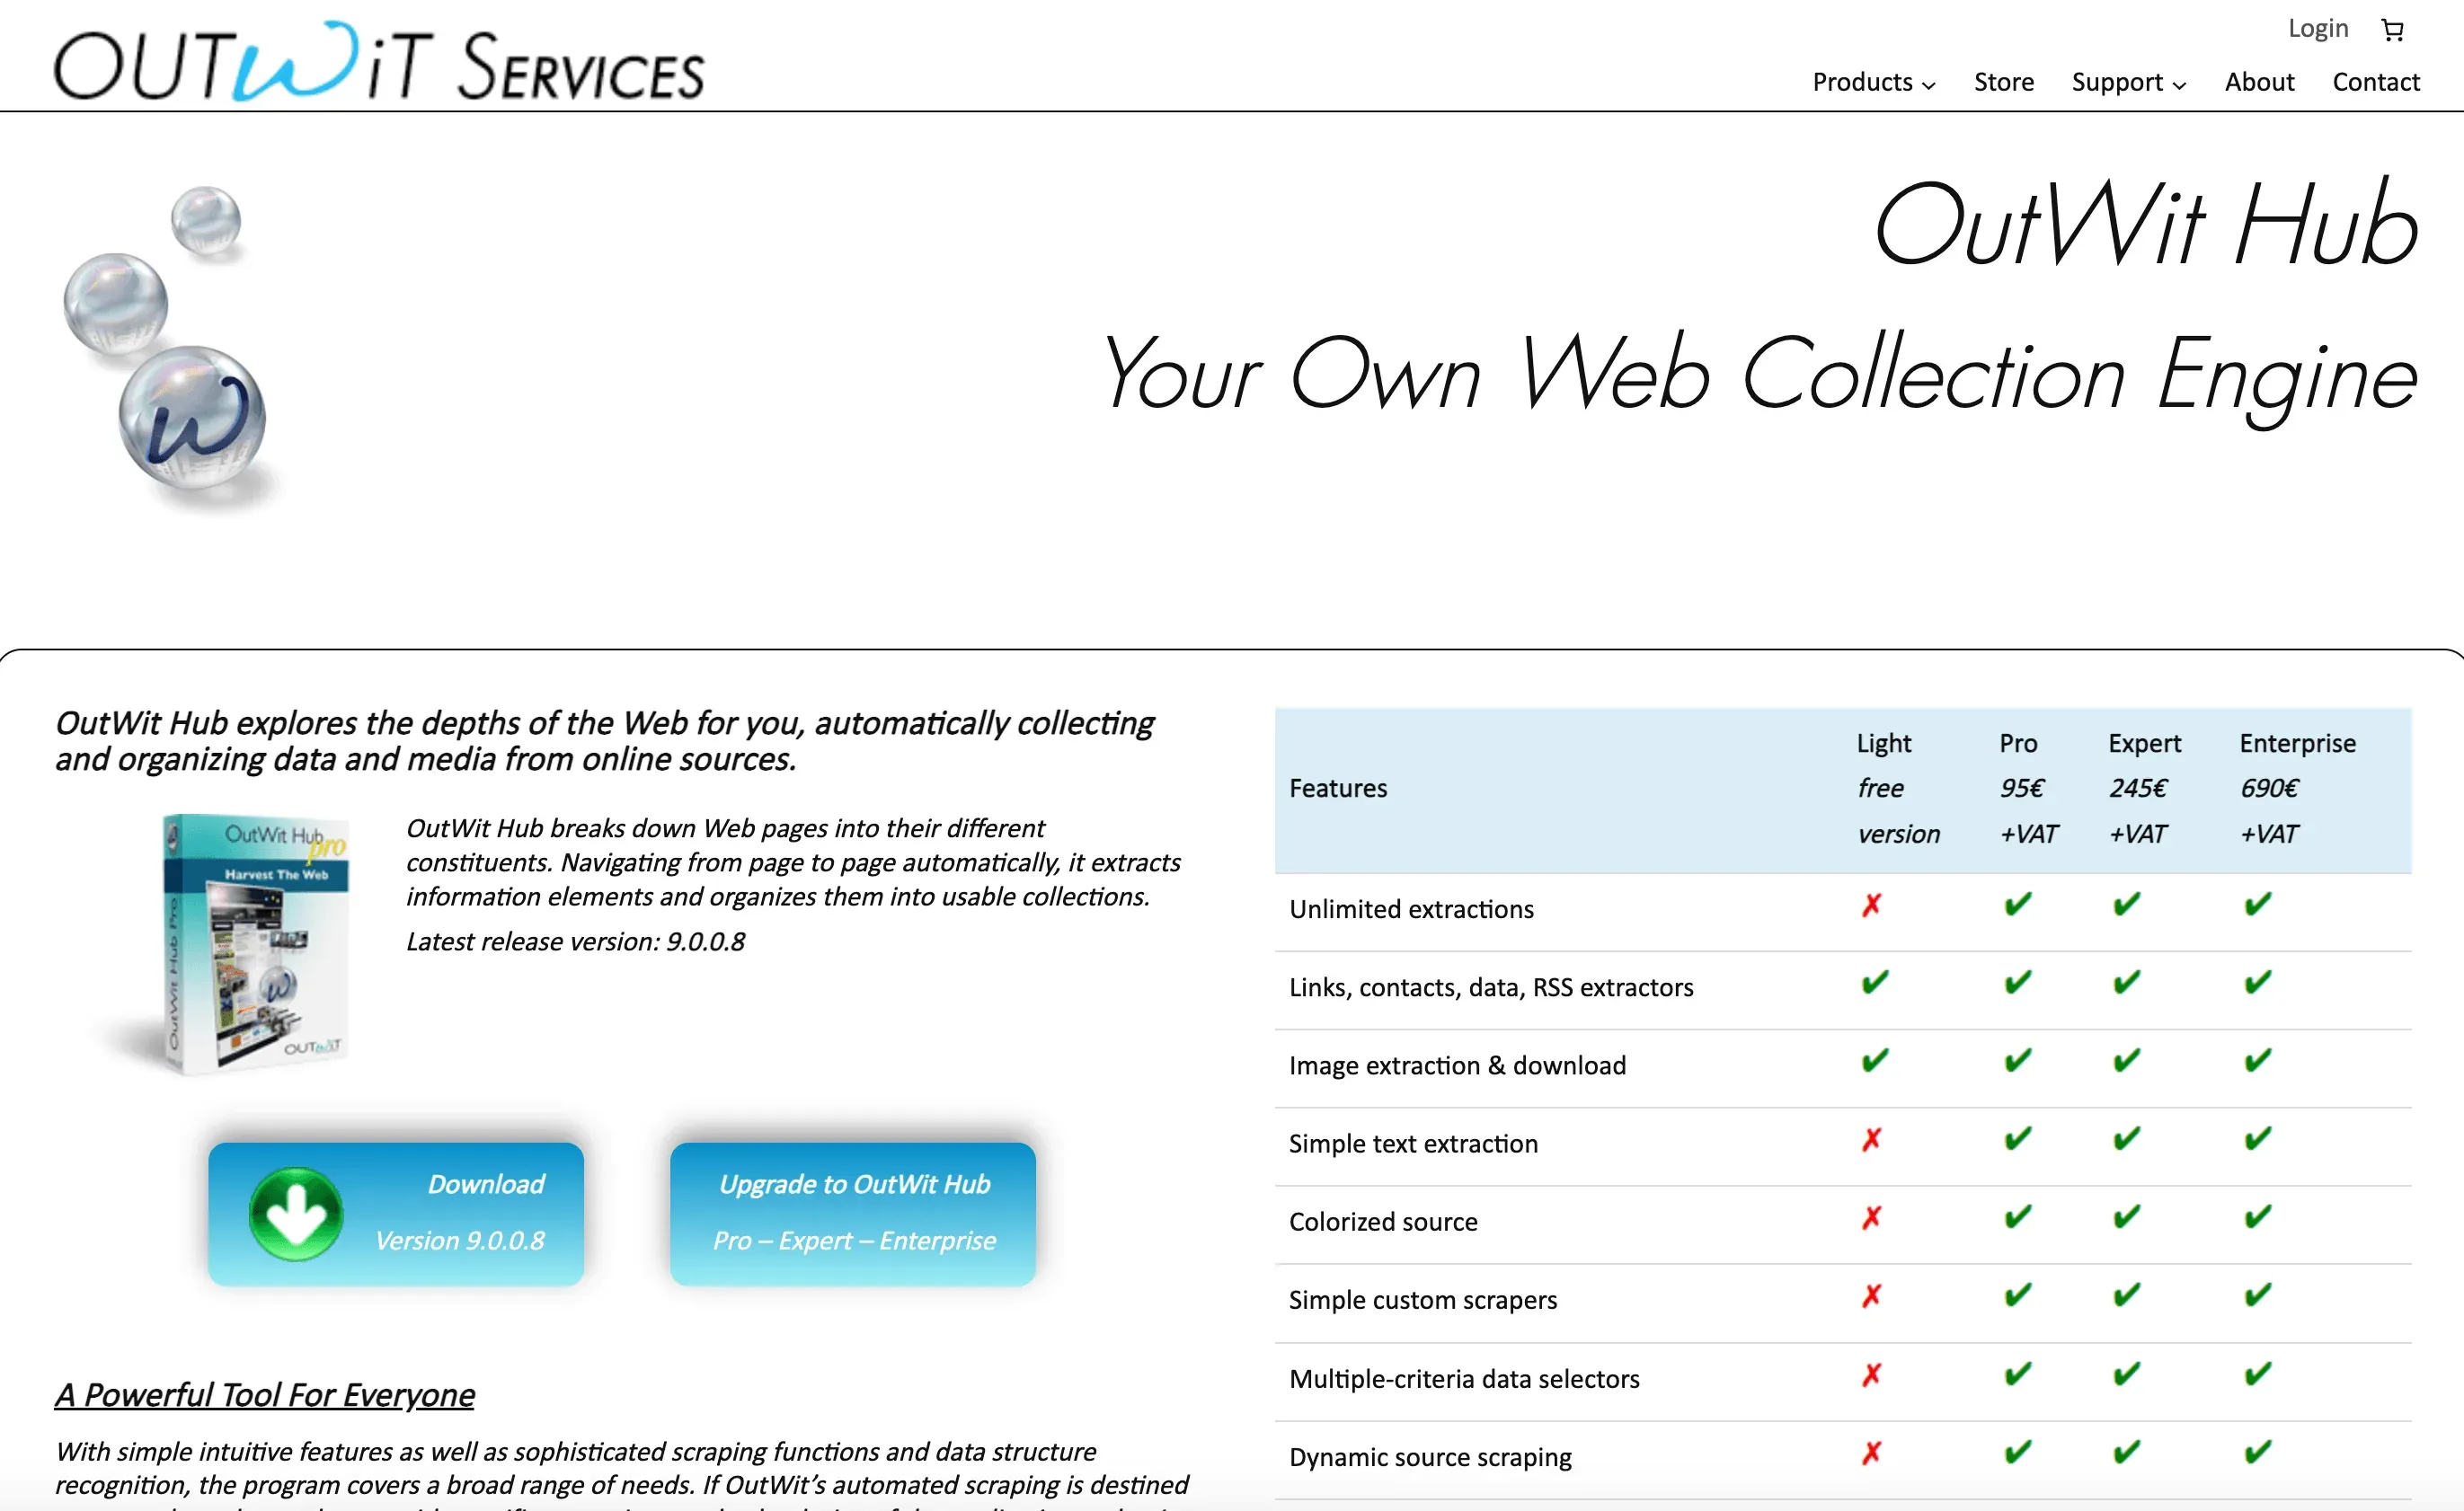 OutWit Hub là một ứng dụng GUI native trên Linux cho web scraping. Nó tự nhận diện mẫu dữ liệu và cung cấp các tính năng trích xuất và tự động hóa rất mạnh.
Tính năng chính:
- Tự phát hiện link, hình ảnh, bảng, email và nhiều loại dữ liệu khác.
- Trình soạn thảo script để trích xuất tùy chỉnh.
- Tự động hóa macro và lên lịch.
Giá: Có bản miễn phí (giới hạn); bản Pro trả phí — xem cửa hàng của nhà cung cấp để biết giá hiện tại.
Tương thích Linux: Ứng dụng native cho Linux, Windows, Mac.
Phù hợp nhất cho: Người không biết code nhưng hơi thiên về kỹ thuật, muốn scraper desktop có giao diện GUI.
15. Portia
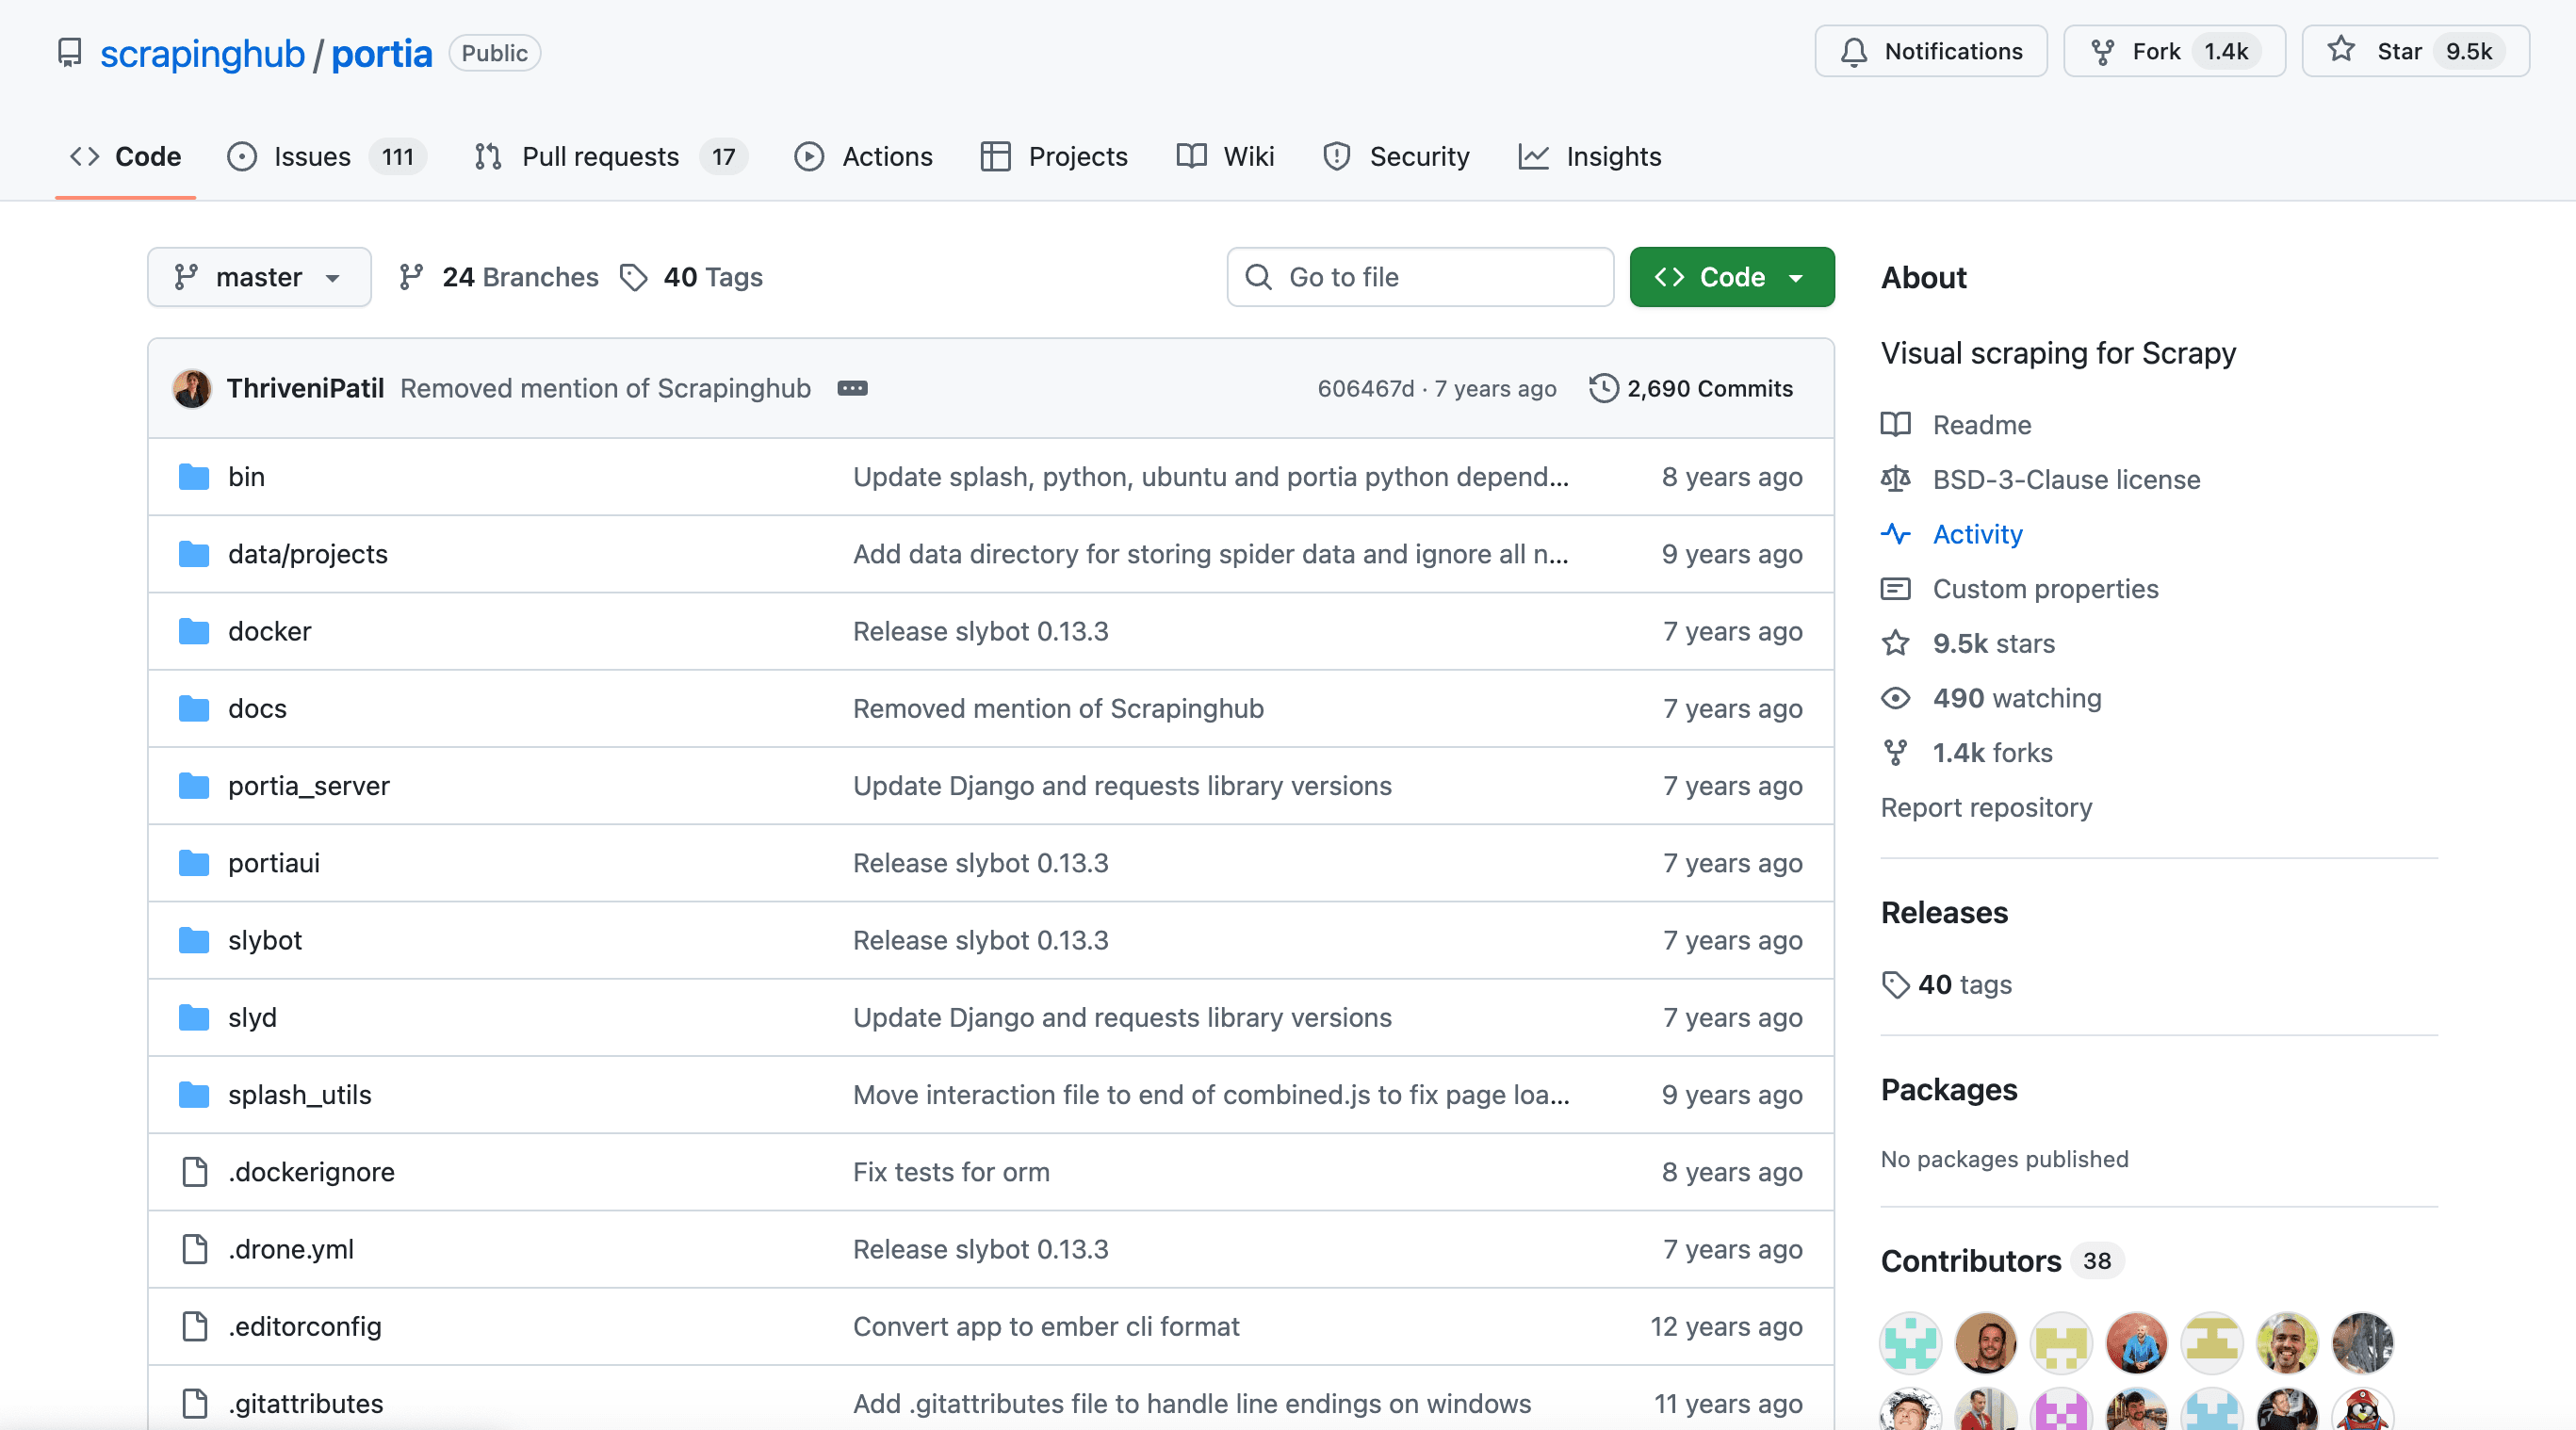 Portia là một web scraper trực quan mã nguồn mở từ Scrapinghub. Nó chạy trên trình duyệt và cho phép bạn annotate các trang để “huấn luyện” scraper — nhưng lưu ý, repo này đã hơn một năm không có cập nhật đáng kể, nên nó dần rơi vào trạng thái “dùng thì tự chịu rủi ro”. Nếu bạn muốn ý tưởng annotation trực quan nhưng có phát triển tích cực hơn, ParseHub hoặc Thunderbit là lựa chọn sạch sẽ hơn.
Tính năng chính:
- Giao diện dựa trên trình duyệt cho trích xuất trực quan.
- Tích hợp với Scrapy cho các dự án tùy chỉnh.
- Mã nguồn mở và có thể mở rộng.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: Dựa trên trình duyệt; hoạt động trên mọi hệ điều hành.
Phù hợp nhất cho: Người dùng muốn scraping trực quan mã nguồn mở, có tích hợp với Scrapy.
16. Sequentum Enterprise (trước đây là Content Grabber)
 Sequentum Enterprise là một scraper trực quan cấp doanh nghiệp dành cho Windows, nhưng có thể chạy trên Linux qua Wine hoặc ảo hóa.
Tính năng chính:
- Trình chỉnh sửa trực quan kết hợp scripting C# cho logic nâng cao.
- Quản lý đa agent và lên lịch.
- Tích hợp với cơ sở dữ liệu, API và nhiều hơn nữa.
Giá: Giấy phép doanh nghiệp, báo giá theo từng triển khai.
Tương thích Linux: Qua Wine hoặc VM.
Phù hợp nhất cho: Agency và các team lớn quản lý nhiều dự án scrape.
17. Helium
 Helium là một thư viện Python giúp đơn giản hóa tự động hóa Selenium. Nó được thiết kế để việc viết script trình duyệt trở nên tự nhiên hơn, giống cách con người thao tác hơn.
Tính năng chính:
- Lệnh trực quan như
click("Login")hoặcwrite("email"). - Tự động hóa Chrome và Firefox.
- Rất hợp cho các tác vụ script và tự động hóa nhanh.
Giá: Miễn phí và mã nguồn mở.
Tương thích Linux: Chạy trên Linux (xây dựng trên Selenium).
Phù hợp nhất cho: Người dùng Python thấy Selenium quá cồng kềnh.
18. Dexi.io
 Dexi.io là một nền tảng trích xuất dữ liệu và tự động hóa trên cloud. Nó có thể truy cập qua trình duyệt, nên người dùng Linux không cần cài gì vẫn dùng được.
Tính năng chính:
- Trình thiết kế workflow trực quan cho scraping và tự động hóa.
- Lên lịch, biến đổi dữ liệu và tích hợp API.
- Khả năng mở rộng và hỗ trợ ở cấp doanh nghiệp.
Giá: Hiện được bán dưới tên Mozenda: dùng thử miễn phí 14 ngày, gói Pilot 500 USD/tháng, gói doanh nghiệp báo giá riêng.
Tương thích Linux: Web app—chạy trên mọi hệ điều hành.
Phù hợp nhất cho: Chuyên gia và doanh nghiệp cần trích xuất dữ liệu web có khả năng mở rộng và tích hợp tốt.
Bảng So Sánh Nhanh: Công Cụ Web Scraping Linux Trong Một Cái Nhìn
| Công cụ | Loại / Tính năng chính | Phù hợp nhất cho | Giá | Tương thích Linux |
|---|---|---|---|---|
| Thunderbit | Tiện ích Chrome AI, 1 click, subpage, cloud/local | Người dùng doanh nghiệp không chuyên kỹ thuật | Miễn phí, từ 15 USD/tháng | ✔ Chrome trên Linux |
| Scrapy | Framework Python, async, CLI, mở rộng mạnh | Lập trình viên, scraper tùy chỉnh quy mô lớn | Miễn phí | ✔ Native |
| Beautiful Soup | Thư viện Python, phân tích HTML/XML đơn giản | Dev, nhà khoa học dữ liệu, tác vụ nhỏ | Miễn phí | ✔ Native |
| Selenium | Tự động hóa trình duyệt, site nặng JS | QA, dev, nội dung động | Miễn phí | ✔ Native |
| Puppeteer | Node.js, headless Chrome, render JS | Dev Node, web app hiện đại | Miễn phí | ✔ Native |
| Octoparse | Không cần code, kéo-thả, cloud templates | Người không biết code, e-commerce | Miễn phí, từ 69 USD/tháng | ◐ Cloud/Wine |
| PhantomJS | Headless WebKit, script JS | Legacy, nhẹ, không cần Chrome | Miễn phí | ✔ Native |
| ParseHub | Trực quan, đa nền tảng, point-and-click | Nhà phân tích, người dùng bán kỹ thuật | Miễn phí, từ 189 USD/tháng | ✔ Native |
| Kimurai | Framework Ruby, đa trình duyệt, async | Dev Ruby, đồng thời cao | Miễn phí | ✔ Native |
| Apify | Nền tảng cloud, SDK, marketplace | Dev, kết hợp custom/cloud | Có gói miễn phí, tính theo dùng | ✔ Native/Cloud |
| Colly | Framework Go, nhanh, đồng thời cao | Dev Go, hiệu năng cao | Miễn phí | ✔ Native |
| PySpider | Python, web UI, lên lịch, phân tán | Team, nhiều dự án | Miễn phí | ✔ Native |
| WebHarvy | Trực quan, nhận diện mẫu, license một lần | Người mới, cá nhân chuyên nghiệp | ~129 USD một lần | ◐ Wine/VM |
| OutWit Hub | GUI native, tự phát hiện dữ liệu, scripting | Người không biết code, GUI desktop | Miễn phí; Pro trả phí (xem nhà cung cấp) | ✔ Native |
| Portia | Mã nguồn mở, trực quan, chạy trên trình duyệt | Mã nguồn mở, tích hợp Scrapy | Miễn phí | ✔ Trình duyệt |
| Sequentum Enterprise | Enterprise, trực quan, scripting, multi-agent | Agency, team lớn | $$$, báo giá theo dự án | ◐ Wine/VM |
| Helium | Python, Selenium đơn giản hóa, API trực quan | Người dùng Python, tự động hóa nhanh | Miễn phí | ✔ Native |
| Dexi.io | Cloud, workflow trực quan, lên lịch, API | Doanh nghiệp, tự động hóa có khả năng mở rộng | Từ 500 USD/tháng (qua Mozenda) | ✔ Trình duyệt |
Cách Chọn Web Scraper Phù Hợp Cho Linux: Những Điểm Cần Cân Nhắc
Chưa chắc cần gói nào? Hãy bắt đầu từ lựa chọn dễ nhất Nếu bạn không muốn phải duy trì selector, hãy để AI tự xác định field cho bạn — 1 click rồi xuất sang Sheets, Excel, Airtable hoặc Notion. Get Started Free
Chọn đúng công cụ là chuyện phải khớp nhu cầu với kỹ năng của bạn:
- Trình độ kỹ thuật: Người không biết code nên nghiêng về Thunderbit, ParseHub, Octoparse hoặc OutWit Hub. Lập trình viên có thể khai thác sức mạnh lớn hơn với Scrapy, Puppeteer, Colly hoặc Kimurai.
- Độ phức tạp của dữ liệu: Với trang tĩnh, Beautiful Soup hoặc Colly rất nhanh và đơn giản. Với website động, nặng JavaScript, bạn nên dùng Selenium, Puppeteer hoặc một công cụ trực quan hỗ trợ JS.
- Quy mô và tần suất: Với tác vụ một lần, công cụ no-code hoặc cloud scraper là đủ. Với crawl lớn, theo lịch, hãy chọn Scrapy, PySpider hoặc Apify.
- Nhu cầu tích hợp: Cần xuất sang Excel, Sheets hay cơ sở dữ liệu? Hãy chắc rằng công cụ bạn chọn hỗ trợ đúng quy trình đó.
- Ngân sách: Có rất nhiều lựa chọn miễn phí và mã nguồn mở cho lập trình viên. Với người dùng doanh nghiệp, Thunderbit và ParseHub là điểm khởi đầu hợp lý, còn team enterprise có thể đầu tư vào Dexi.io hoặc Sequentum Enterprise.
- Hỗ trợ & cộng đồng: Công cụ mã nguồn mở thường có cộng đồng lớn; công cụ thương mại thì có hỗ trợ riêng.
Mẹo nhỏ: Đừng ngại kết hợp nhiều công cụ. Dùng Thunderbit để thử nhanh và nhận diện mẫu dữ liệu, rồi chuyển sang Scrapy cho crawl quy mô sản xuất. Hoặc dùng Selenium để đăng nhập và lấy session cookies, sau đó giao phần scrape tốc độ cao cho Colly hoặc Scrapy.
Kết Luận: Tìm Web Scraping Tool Linux Tốt Nhất Cho Năm 2026
Người dùng Linux trong năm 2026 có rất nhiều lựa chọn. Dù bạn muốn một công cụ no-code tích hợp AI cho kết quả chỉ trong vài phút (Thunderbit), một framework mạnh mẽ cho lập trình viên (Scrapy, Colly), hay một nền tảng cấp doanh nghiệp (Dexi.io), luôn có một web scraper cho Linux phù hợp với nhu cầu và quy trình làm việc của bạn.
Điểm chính cần nhớ:
- Linux là nền tảng của hạ tầng dữ liệu hiện đại—phần lớn scraper hàng đầu đều chạy native hoặc qua trình duyệt.
- Công cụ AI và no-code đang dân chủ hóa web scraping cho người dùng doanh nghiệp.
- Framework dành cho lập trình viên vẫn chiếm ưu thế về tính linh hoạt, tốc độ và quy mô.
- Hãy thử trước khi mua—đa số công cụ đều có bản miễn phí hoặc dùng thử.
Sẵn sàng bắt đầu chưa? Tải Thunderbit hoặc xem Thunderbit Blog để đọc thêm các hướng dẫn về web scraping, tự động hóa và tăng trưởng dựa trên dữ liệu.
Khám phá AI Web Scraper của Thunderbit Bỏ qua việc viết script và cron job — để AI đọc trang và trả cho bạn một bảng dữ liệu chỉ sau 1 click. Get Started Free
Câu Hỏi Thường Gặp
1. Web scraper nào dễ dùng nhất cho Linux nếu tôi không biết code?
Thunderbit là lựa chọn hàng đầu cho người không chuyên kỹ thuật. Nó chạy như một tiện ích Chrome trên Linux, dùng AI để tự động hóa mọi thứ và cho phép bạn scrape dữ liệu chỉ với một click.
2. Web scraper Linux nào tốt nhất cho các dự án tùy chỉnh quy mô lớn?
Scrapy là lựa chọn quen thuộc của lập trình viên. Nó nhanh, có khả năng mở rộng và tùy biến rất cao—rất phù hợp cho các lượt crawl lớn, lặp lại thường xuyên.
3. Tôi có thể scrape các website nặng JavaScript hoặc động trên Linux không?
Có! Hãy dùng Selenium hoặc Puppeteer để điều khiển trình duyệt thật và trích xuất nội dung động. Các công cụ trực quan như ParseHub và Thunderbit cũng hỗ trợ website động.
4. Có công cụ web scraping Linux miễn phí nào cho mục đích kinh doanh không?
Hoàn toàn có. Scrapy, Beautiful Soup, Selenium, Colly, PySpider và Kimurai đều miễn phí và mã nguồn mở. Thunderbit và ParseHub có gói miễn phí cho các tác vụ nhỏ.
5. Làm sao chọn giữa scraper no-code và scraper viết code trên Linux?
Nếu bạn muốn nhanh và đơn giản, hãy chọn no-code (Thunderbit, ParseHub, Octoparse). Nếu bạn cần linh hoạt, tự động hóa hoặc tích hợp với hệ thống khác, các công cụ dựa trên code (Scrapy, Puppeteer, Colly) sẽ là lựa chọn tốt hơn.
Chúc bạn scrape vui vẻ — và mong các dự án dữ liệu chạy trên Linux của bạn mượt hơn cả một bản cài Ubuntu mới tinh. Nếu muốn xem thêm mẹo về web scraping, hãy ghé Thunderbit Blog hoặc đăng ký kênh YouTube để xem các hướng dẫn thực hành.
Dùng thử AI Web Scraper cho Linux Get Started Free
Tìm hiểu thêm



