
Một lượt tìm kiếm trên GitHub với từ khóa "tiktok scraper" trả về 339 repository. Khoảng 48% trong số đó đã hơn một năm không được cập nhật, và ít nhất 4 repository đã được gắn nhãn archived.
Nếu bạn từng clone một repo TikTok scraper nổi tiếng, loay hoay cả tiếng vì dependency, rồi cuối cùng nhận về kết quả bằng 0 — bạn không hề đơn độc. Repository TikTok scraper có nhiều sao nhất trên GitHub, drawrowfly/tiktok-scraper, hiện vẫn có hơn 5.000 stars. Nhưng phần issue của nó lại đầy những cuộc thảo luận như #812: "is this amazing tool still working?" và #824: "Is this still working?" — cả hai đều báo không có dữ liệu đầu ra. Tại Thunderbit, tôi đã theo dõi tình trạng của các repo TikTok scraping trong nhiều tháng, và một điều rất rõ ràng: những công cụ này hỏng rất nhanh, và đa số chẳng bao giờ được sửa lại. Bài viết này là cuốn cẩm nang sinh tồn thực tế mà tôi ước mình đã có khi mới bắt đầu đánh giá các repo này. Chúng ta sẽ xem repo nào còn sống, repo nào đã chết, nên làm gì thay thế, và cách tránh lãng phí hàng giờ vào code đã ngừng hoạt động từ trước khi bạn tìm thấy nó.
Vì sao đa số TikTok Scraper trên GitHub bị hỏng và cứ hỏng mãi
TikTok không phải là mục tiêu scraping thông thường. Giao diện web của nền tảng này thay đổi liên tục. Khác với một trang sản phẩm thương mại điện tử tĩnh hay danh mục thư mục, TikTok thường xuyên đổi endpoint, cập nhật cơ chế chống bot bằng dấu vân tay trình duyệt, thay đổi cách render trang, và bổ sung yêu cầu session/token mới — đôi khi chỉ trong vài tuần sau lần thay đổi trước.
Người duy trì mã nguồn mở là những tình nguyện viên. Khi TikTok tung ra một bản cập nhật làm gãy đường request của scraper, repo có thể nằm im ở trạng thái lỗi trong nhiều ngày, nhiều tuần, hoặc vĩnh viễn. Đây không phải là lời chê các maintainer — mà là sự lệch pha mang tính cấu trúc giữa một nền tảng thay đổi nhanh, có nguồn lực mạnh, và các lập trình viên không được trả công, còn phải đi làm công việc khác.
Ngay cả những repo TikTok scraper tốt nhất cũng thường chạy trong vòng lặp "hỏng rồi sửa" liên tục. Nếu bạn định dùng một repo như vậy, bạn cần có chiến lược để đánh giá, xử lý lỗi, và chuẩn bị phương án dự phòng.
Cơ chế chống bot của TikTok: bạn đang đối mặt với gì
- Giới hạn tốc độ request. Tài liệu official developer docs của TikTok đã nêu rõ hạn mức request ngay cả với tích hợp được phê duyệt. Các scraper không chính thức sẽ chạm ngưỡng này nhanh hơn rất nhiều.
- Ràng buộc cookie và session. Những repo hiện đại như davidteather/TikTok-Api yêu cầu
ms_token; các repo cũ như drawrowfly/tiktok-scraper lại dùngtt_webid_v2trong ví dụ; Evil0ctal/Douyin_TikTok_Download_API còn tài liệu hóamsToken,ttwid,X-BogusvàA_Bogus. TikTok kiểm tra xem request của bạn có giống một phiên duyệt web thật hay không. - Dấu vân tay trình duyệt. Hướng dẫn anti-bot của ScrapFly giải thích vì sao website so sánh header, cookie, TLS signature và các đặc trưng trình duyệt mà JavaScript nhìn thấy với lưu lượng người dùng thật. Phần phân tích browser fingerprinting của họ bao gồm Canvas, WebGL, WebRTC, font và các tín hiệu runtime. Fingerprinting giống như TikTok kiểm tra thẻ căn cước của trình duyệt bạn — nếu trình duyệt, cookie, timing và dấu hiệu mạng không khớp, request sẽ trông giả ngay cả trước khi nội dung được trả về.
- Phát hiện theo hành vi. Các thread trên Reddit về TikTok scraping thường nhắc rằng các phiên Playwright mới tạo có thể kích hoạt CAPTCHA. Các bài viết cộng đồng từ 2025–2026 ngày càng mô tả cơ chế phát hiện dựa vào thời điểm thao tác và chất lượng tương tác, chứ không chỉ dựa vào việc dùng lại IP.
- Tham số request được mã hóa/ký. Evil0ctal ghi rõ
X-BogusvàA_Bogus; các gist cộng đồng cũ xoay quanh việc ký URL và tạo token. TikTok ngày càng kỳ vọng request mang theo cùng những “dấu đóng” như lưu lượng từ chính trình duyệt/ứng dụng của họ. - CAPTCHA và luồng xác minh. Sự tồn tại của repo solver CAPTCHA dành riêng cho TikTok và các thread Reddit về thử thách puzzle cho thấy CAPTCHA vẫn là một phần của lớp chống bot.
Vì sao maintainer mã nguồn mở không thể theo kịp
Vòng đời thường luôn giống nhau: một developer viết TikTok scraper, nó nổi lên trên GitHub, TikTok vá chỗ đó, rồi maintainer hoặc sửa, hoặc bỏ.
Hai repo sau minh họa rất rõ mô hình này:
- drawrowfly/tiktok-scraper vẫn có 5.052 stars và 889 forks, nhưng lần cập nhật cuối là ngày 19/05/2023. Đây là repo TikTok scraper theo đúng cụm từ tìm kiếm được sao nhiều nhất trên GitHub, nhưng giờ đọc như một tư liệu lịch sử: rất nổi, rất được tin dùng, nhưng không còn được duy trì.
- davidteather/TikTok-Api có 6.301 stars, 1.177 forks, và lần cập nhật cuối vào ngày 01/04/2026. Luồng release cho thấy hoạt động bảo trì đáng kể vào tháng 4/2025, tháng 7/2025, tháng 10/2025 và tháng 4/2026 — bao gồm sửa lỗi crawl video người dùng và thêm các điều khiển proxy/session mới. Nhưng ngay cả dự án khỏe hơn này cũng công khai cảnh báo rằng TikTok có thể chặn request và người dùng có thể cần proxy, Playwright, cùng logic session tùy chỉnh.
Mẫu hình rất đơn giản:
- Repo TikTok scraper cũ, ít cập nhật, gần như chắc chắn đã chết.
- Repo còn hoạt động thì thường vẫn rất mong manh.
- Điểm khác biệt duy nhất là tháng này có còn ai ở đó để vá lỗi hay không.
Checklist 60 giây để kiểm tra sức sống của repo: cách đánh giá bất kỳ TikTok Scraper nào trên GitHub
Trước khi clone bất kỳ thứ gì, hãy chạy checklist này. Chỉ mất chưa đến một phút nhưng có thể giúp bạn tiết kiệm hàng giờ bực bội.
| Tín hiệu | 🟢 Tốt | 🟡 Rủi ro | 🔴 Chết |
|---|---|---|---|
| Lần push có ý nghĩa gần nhất | < 3 tháng trước | 3–12 tháng trước | 12+ tháng trước |
| Số issue đang mở | Ít, issue mới có phản hồi | Tăng dần, maintainer vẫn thỉnh thoảng phản hồi | Nhiều báo cáo "broken/blocked/not working" nhưng không ai trả lời |
| Phàn nàn gần đây của người dùng | Chủ yếu là câu hỏi cài đặt | Lẫn lộn giữa cài đặt và lỗi hỏng | Lặp đi lặp lại "zero output," "403," "still working?" |
| Mô hình auth/session hiện tại | Có tài liệu về session/cookie | Dựa nhiều vào token nhưng có tài liệu | Phụ thuộc endpoint web cũ, không có hướng dẫn auth mới |
| Bề mặt cài đặt | Thiết lập rõ ràng, có kiểm chứng | Có vài bước thủ công | Dependency cũ, thiếu ghi chú setup hiện đại |
| CI/test | Có test và còn mới | Có test nhưng độ phủ không rõ | Không có test hoặc action đã lỗi thời |
| Mức độ phù hợp của dữ liệu | Khớp với nhu cầu thực tế của bạn | Chỉ đáp ứng một phần nhu cầu | Giải quyết một bài toán khác hoàn toàn |
Cách kiểm tra từng tín hiệu trong chưa đầy 60 giây
- Ngày push cuối: Nhìn ở phần đầu repo trên GitHub. Nếu thấy “last pushed 2 years ago”, bạn có thể dừng luôn.
- Issue đang mở: Bấm tab Issues. Đọc lướt các tiêu đề mới nhất. Tìm
not working,403,blocked,captchahoặczero output. - Phàn nàn của người dùng: Nếu 5 issue mở đầu tiên đều là biến thể của “cái này không còn chạy nữa”, vậy là đủ rõ.
- Mô hình auth/session: Mở README. Tìm hướng dẫn hiện tại như
ms_token, setup Playwright hoặc ghi chú proxy. Nếu README vẫn nhắc endpoint của năm 2023, bỏ qua. - Bề mặt cài đặt: Kiểm tra có file requirements, hỗ trợ Docker hay hướng dẫn setup rõ ràng không. Nếu README chỉ viết “npm install” và Node version được test gần nhất là 14, hãy chuẩn bị tinh thần có vấn đề.
- CI/test: Kiểm tra tab Actions. Nếu test đang fail hoặc không có, thì việc xử lý lỗi chỉ là đoán mò.
- Phạm vi dữ liệu: Repo có thực sự mô tả đúng loại dữ liệu bạn cần không (profile, metadata video, comment, hashtag)? Nhiều repo chỉ tải video, chứ không trích xuất dữ liệu có cấu trúc.
Các dấu hiệu đỏ nghĩa là “bỏ đi”
- Repo đã được archived.
- README ghi “no longer maintained.”
- Commit gần nhất vẫn nhắc đến phiên bản TikTok API từ hơn 2 năm trước.
- Issue tràn ngập báo cáo “doesn't work” mà maintainer đã im lặng nhiều tháng.
- Repo có nhiều stars nhưng rất ít forks gần đây hoặc pull request.
Mẹo nhỏ: tìm trong tab Issues với is:issue is:open "not working" hoặc is:issue is:open "403". Nếu kết quả dày đặc và mới gần đây, repo nhiều khả năng đã hỏng.
Các repo TikTok Scraper phổ biến trên GitHub: kiểm tra tình trạng thật thà (2026)
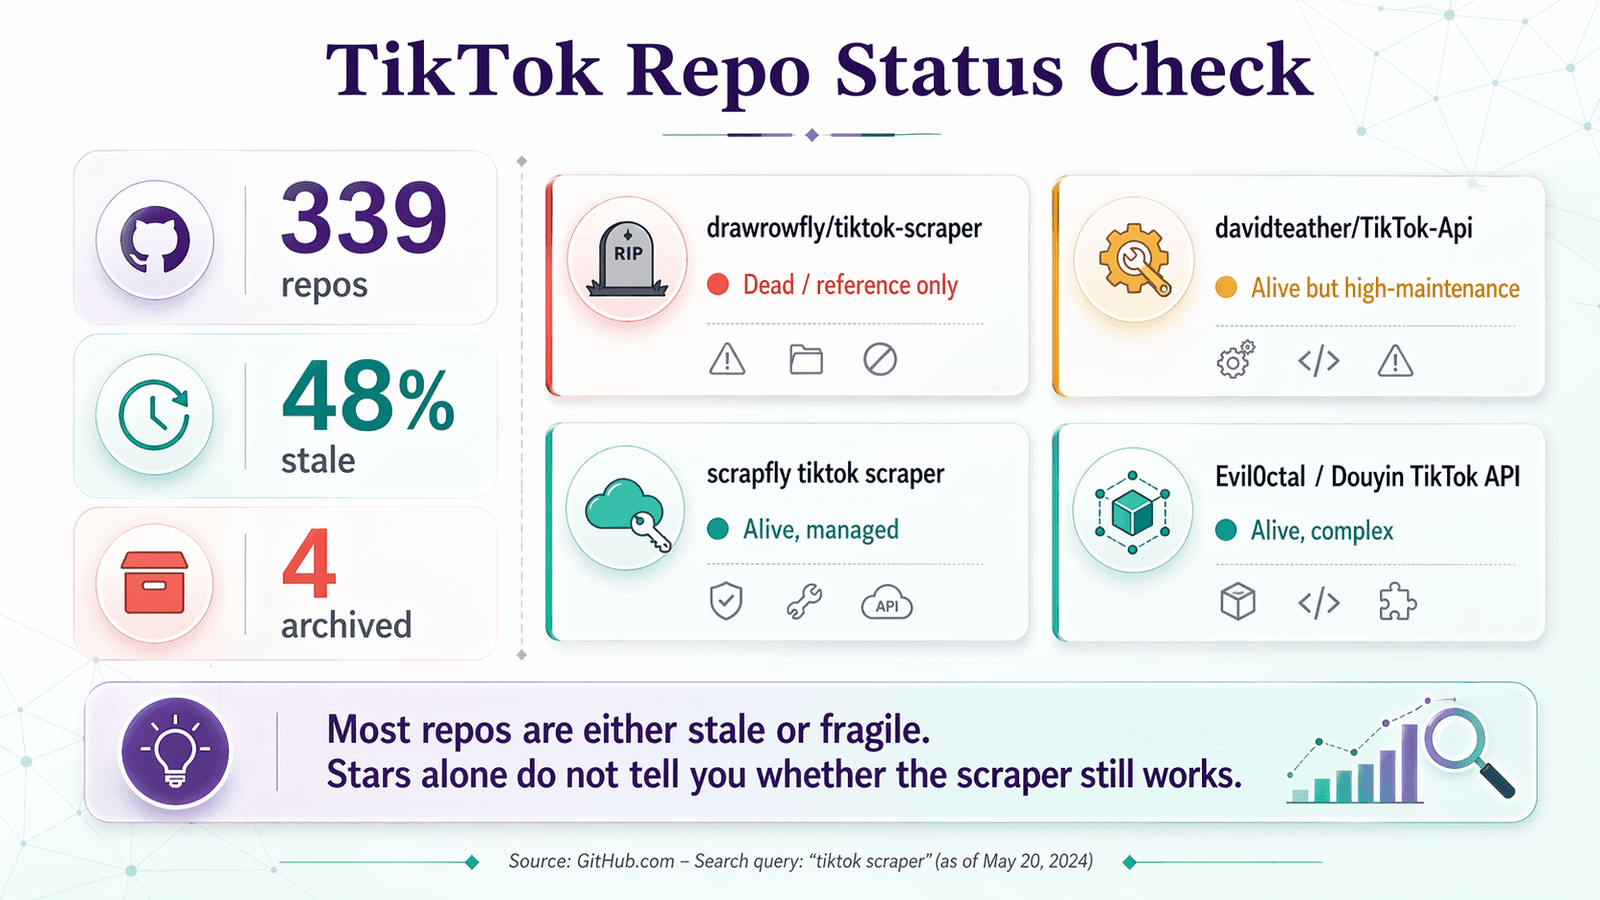
Dưới đây là checklist sức sống của repo áp dụng cho các repo bạn thực sự sẽ thấy khi tìm "tiktok scraper" trên GitHub:
| Repo | Lần push cuối | Stars | Issue đang mở | Kết luận | Ghi chú |
|---|---|---|---|---|---|
| drawrowfly/tiktok-scraper | 2023-05-19 | 5,052 | 58 | 🔴 Đã chết / chỉ để tham khảo | Vẫn nổi tiếng, nhưng quá cũ để dùng cho production năm 2026 |
| davidteather/TikTok-Api | 2026-04-01 | 6,301 | 134 | 🟡 Còn sống nhưng phải bảo trì nhiều | Lựa chọn OSS mạnh nhất; cần Playwright, token, thường cả proxy |
| scrapfly/scrapfly-scrapers/tiktok-scraper | 2026-04-21 | 938 (repo cha) | ~0 (monorepo) | 🟡 Còn sống, nhưng không phải OSS thuần | Hiện tại và hữu ích, nhưng cần ScrapFly API key |
| Evil0ctal/Douyin_TikTok_Download_API | 2025-10-12 | 17,397 | 135 | 🟡 Còn sống, rộng tính năng, phức tạp | Dự án đa nền tảng nhiều tính năng; gần với một platform cho power user hơn |
| naseif/tiktok-scraper | 2024-07-26 | 107 | 13 | 🟡 Rủi ro | Repo nhỏ hơn, có complaint mở quanh user info và hashtag flows |
| loewehancara1rmyv/Tiktok-scraper | 2026-01-12 | 4 | 0 | 🔴 Quá mới để tin | Repo trình diễn, chưa được cộng đồng kiểm chứng |
drawrowfly/tiktok-scraper
Trong nhiều năm, trình scraper/downloader TypeScript này gần như là câu trả lời mặc định cho truy vấn “tiktok scraper github” — xử lý feed user, trend, hashtag và music. Đến năm 2026, tốt nhất nên xem nó như tài liệu lịch sử. Lần push cuối là tháng 5/2023, và hàng đợi issue vẫn còn các báo cáo chưa giải quyết kiểu “still working?” và “zero output” từ giai đoạn 2023–2025. Nếu bạn đọc bài này vì đã clone repo đó rồi mà nhận về không gì cả, bạn không hề cô đơn.
davidteather/TikTok-Api
Đây là wrapper dữ liệu TikTok mã nguồn mở đáng tin nhất còn sống trong năm 2026. Dự án này đang hoạt động, có release gần đây, và tài liệu hóa rõ ràng cách cài Playwright, cách dùng async, xử lý token, hỗ trợ proxy và khả năng khôi phục session. Nhưng đây không phải công cụ “clone là chạy”. README của chính nó nói rằng EmptyResponseException thường có nghĩa là TikTok đang chặn request, và lịch sử thảo luận cho thấy vấn đề lặp lại quanh ms_token, lỗi trích xuất comment, KeyError: 'ItemModule', và lỗi theo từng endpoint. Kết luận: còn sống, hữu ích, dành cho developer, và phải bảo trì nhiều.
Các repo đáng chú ý khác
- scrapfly/scrapfly-scrapers/tiktok-scraper: Hiện tại và có giá trị về mặt kỹ thuật, nhưng README yêu cầu
SCRAPFLY_KEY. Đây là ví dụ code cho một nền tảng scraping được quản lý, không phải công cụ miễn phí độc lập. - Evil0ctal/Douyin_TikTok_Download_API: Hỗ trợ TikTok và Douyin, mô tả logic ký (
X-Bogus,A_Bogus,msToken), và hỗ trợ comment, follower, playlist, v.v. Dự án này đòi hỏi kỹ thuật cao và ngày càng gắn với các tham chiếu API trả phí. Issue tracker vẫn có bug report trong năm 2026 quanh link video và endpoint thông tin user. Còn sống và nhiều tính năng, nhưng rất phức tạp. - naseif/tiktok-scraper: Quy mô nhỏ, có complaint mở. Rủi ro khi dùng cho production.
- loewehancara1rmyv/Tiktok-scraper: 4 stars, 0 issues, quá mới để tin. Bài Medium quảng bá nó đã làm vậy một cách khá thiếu kiểm chứng.
TikTok Official API vs. GitHub Scrapers vs. công cụ no-code: khung ra quyết định
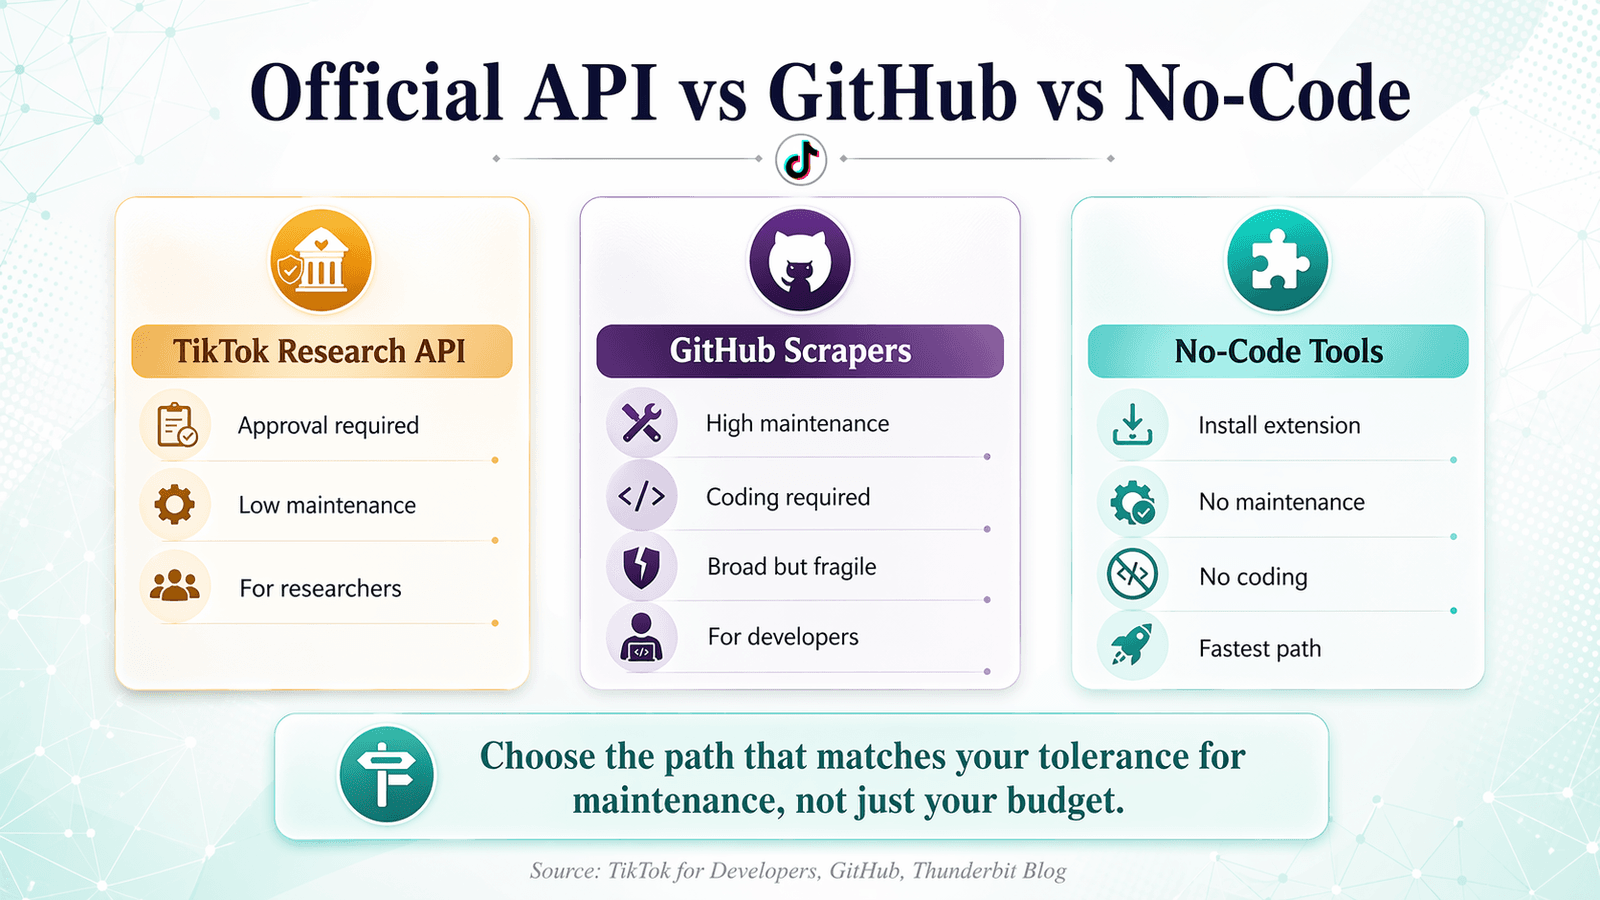
Nhiều bài so sánh của đối thủ hoặc bỏ qua đường truy cập chính thức của TikTok, hoặc nhảy thẳng từ “dùng GitHub” sang “mua dịch vụ của chúng tôi”. Dưới đây là so sánh trung lập của cả ba hướng:
| Yếu tố | TikTok Research API | GitHub Scraper | Công cụ no-code (ví dụ: Thunderbit) |
|---|---|---|---|
| Rào cản truy cập | Cần hồ sơ xin duyệt cho học thuật/doanh nghiệp; khoảng 4 tuần để xét duyệt | Git clone + setup | Cài extension trình duyệt |
| Phạm vi dữ liệu | Chỉ các endpoint được phê duyệt (account, video, comment, shop) | Rộng (profile, video, comment, hashtag, shop) | Dữ liệu nhìn thấy trên trang (profile, video, engagement, hashtag) |
| Gánh nặng bảo trì | Thấp (chính thức, ổn định) | Cao (repo dễ hỏng khi TikTok cập nhật) | Không có (AI tự thích ứng khi layout đổi) |
| Rủi ro bị chặn | Không (được cấp quyền) | Cao | Thấp (dựa trên trình duyệt, giống người dùng thật) |
| Chi phí | Miễn phí (nếu được duyệt) | Miễn phí nhưng tốn thời gian | Có gói miễn phí; gói tính theo credit từ $15/tháng |
| Có cần code không | Có (Python/R) | Có (Python/Node.js) | Không |
| Phù hợp nhất cho | Nhà nghiên cứu, giới học thuật, tổ chức được duyệt | Developer sẵn sàng bảo trì | Marketer, sales, ops, người không lập trình |
Khi nào nên chọn TikTok Research API
Research API của TikTok là con đường chính thức sạch nhất nếu bạn đủ điều kiện. Các nhà nghiên cứu đủ chuẩn ở Mỹ, châu Âu và Brazil có thể nộp đơn để nghiên cứu nội dung công khai và dữ liệu tài khoản. Các nhóm dữ liệu có sẵn gồm account, follower/following, video thích, video ghim, video đăng lại, nội dung, comment và shop. Codebook cung cấp các field như video_description, view_count, like_count, comment_count, share_count, và các field cấp comment như text, reply_count, create_time.
Điểm trừ: phạm vi đủ điều kiện khá hạn chế, chỉ dành cho tổ chức học thuật và nhà nghiên cứu độc lập/phi lợi nhuận đủ điều kiện ở một số khu vực, cộng thêm nhà nghiên cứu đã được thẩm định theo quy trình DSA của EU. Nếu bạn là team growth hay agency cần dữ liệu vận hành nhanh, đây không phải lựa chọn phù hợp.
TikTok cũng có Commercial Content API cho dữ liệu quảng cáo và nội dung nhà quảng cáo, hữu ích cho nghiên cứu minh bạch nhưng không phải scraping tổng quát.
Khi nào GitHub Scraper vẫn còn hợp lý
GitHub scraper vẫn hợp lý với developer cần truy cập không chính thức vào dữ liệu công khai vượt ngoài cổng duyệt của API chính thức, và sẵn sàng tự bảo trì stack. Ví dụ như scraping lưới profile hiển thị, hashtag, comment, playlist hoặc metadata video trong một pipeline tùy chỉnh, nơi việc fork repo và vá lỗi là chấp nhận được.
Nhưng cần nói thật: đây không phải setup một lần rồi xong. Ngay cả repo đáng tin nhất năm 2026 như davidteather/TikTok-Api vẫn yêu cầu người dùng có thể cần Playwright, cookie/token, proxy, và factory tùy chỉnh cho page/session.
Khi nào công cụ no-code như Thunderbit là lựa chọn hợp lý
Scrape dữ liệu TikTok bằng AI Get Started Free
Bạn không phải developer? Hay là developer đã chán vòng lặp hỏng-sửa? Một công cụ AI chạy trên trình duyệt là con đường nhanh nhất để lấy dữ liệu TikTok có cấu trúc.
Chúng tôi xây dựng Thunderbit như một AI web scraper hoạt động dưới dạng Chrome extension. Trên TikTok, nó đọc bất kỳ trang hiển thị nào (profile, video, hashtag, kết quả tìm kiếm), gợi ý cột bằng “AI Suggest Fields”, rồi bạn chỉ cần bấm “Scrape” để trích xuất dữ liệu có cấu trúc. Trang TikTok scraper tool mô tả các field như ngày đăng, thời lượng video, lượt thích, lượt chia sẻ, lượt lưu, comment, lượt xem và hashtag. Mẫu image scraper cho thấy cách thu thập thumbnail bài đăng, URL, caption, handle của creator và tín hiệu tương tác từ trang profile. Mẫu hashtag scraper bao gồm video URL, username creator, mô tả, thời gian đăng, lượt xem, lượt thích, comment, chia sẻ, âm thanh và URL ảnh bìa.
Scrape theo subpage cho phép bạn đi vào từng trang video từ danh sách profile và bổ sung thêm bảng với chỉ số tương tác, caption và hashtag — rất hữu ích cho marketer xây dựng database influencer hoặc phân tích nội dung đối thủ.
Không cần bảo trì, không cần xử lý cài đặt, không cần cấu hình chống chặn. AI tự thích ứng khi layout TikTok thay đổi. Xuất dữ liệu miễn phí sang Google Sheets, Excel, Airtable, Notion, CSV hoặc JSON.
Nếu bạn đã đốt hàng giờ vào các repo GitHub bị hỏng, đây là một lựa chọn hoàn toàn nghiêm túc — không phải lời chào mời ép mua.
Dùng thử Thunderbit để scrape TikTok
Xử lý lỗi cài đặt: sửa 5 lỗi setup TikTok Scraper GitHub phổ biến nhất
Lỗi cài đặt là nguyên nhân gây đau đầu được nhắc đến nhiều thứ ba trong các diễn đàn về TikTok scraping, nhưng hầu như không có hướng dẫn lớn nào thực sự giúp bạn sửa. Đây là những gì thường hỏng.
Xung đột phiên bản Node.js
Vấn đề: Nhiều repo TikTok scraper cũ (đặc biệt là drawrowfly/tiktok-scraper) được xây cho Node.js 14–16. Nếu bạn đang chạy Node 20+, npm install có thể fail âm thầm hoặc tạo binary không tương thích.
Cách xử lý: Dùng nvm (Node Version Manager) để cài và chuyển sang đúng phiên bản:
nvm install 16
nvm use 16
npm install
Nếu repo không nêu rõ phiên bản Node, hãy kiểm tra field engines trong package.json hoặc xem cấu hình CI.
Lỗi dependency Python và setup Playwright
Vấn đề: davidteather/TikTok-Api yêu cầu Python 3.9+ và Playwright với các browser binary cụ thể. Người dùng thường gặp lỗi kiểu “browser not found” hoặc xung đột dependency.
Cách xử lý: Luôn dùng virtual environment, rồi cài browser của Playwright một cách tường minh:
python -m venv .venv
source .venv/bin/activate   # Trên Windows: .venv\Scripts\activate
pip install TikTokApi
python -m playwright install
Nếu playwright install vẫn fail, hãy kiểm tra package manager của hệ điều hành xem có thiếu dependency hệ thống nào không (ví dụ libnss3 trên Ubuntu).
Lỗi quyền trên Linux/Ubuntu
Vấn đề: Dùng sudo pip install sẽ làm hỏng môi trường Python hệ thống và dẫn tới chuỗi lỗi dependency.
Cách xử lý: Tuyệt đối không dùng sudo pip install. Hãy tạo virtual environment trước:
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Cách này cô lập dependency của scraper khỏi Python hệ thống.
Lỗi đường dẫn và encoding trên Windows
Vấn đề: CMD trên Windows có lỗi encoding và giới hạn độ dài đường dẫn, dễ làm hỏng quá trình cài scraper, nhất là khi Playwright tải browser binary vào thư mục lồng nhau quá sâu.
Cách xử lý: Dùng WSL (Windows Subsystem for Linux) hoặc Git Bash thay vì CMD. WSL cho bạn một môi trường Linux đầy đủ ngay trong Windows:
wsl --install
# Sau đó mở terminal WSL và làm theo các bước setup Linux
Cách nhanh nhất: dùng Docker để bỏ qua hẳn lỗi dependency
Vấn đề: Tất cả các lỗi ở trên.
Cách xử lý: Nếu bạn quen dùng Docker, hãy container hóa môi trường scraper. Một Dockerfile cơ bản cho TikTok scraper viết bằng Python có thể trông như sau:
FROM python:3.11-slim
RUN apt-get update && apt-get install -y libnss3 libatk-bridge2.0-0 libdrm2 libxcomposite1 libxdamage1 libxrandr2 libgbm1 libasound2
RUN pip install TikTokApi playwright && python -m playwright install --with-deps chromium
WORKDIR /app
COPY . .
CMD ["python", "scrape.py"]
Cách này đảm bảo môi trường tái lập được bất kể hệ điều hành máy bạn là gì. Nếu scraper chạy được trong Docker, thì lỗi phát sinh bên ngoài Docker là lỗi môi trường chứ không phải lỗi code.
Sơ đồ xử lý lỗi:
- Repo có chạy thành công ví dụ của chính nó không? → Nếu không, kiểm tra phiên bản runtime.
- Phiên bản runtime đúng chưa? → Kiểm tra cài browser/Playwright.
- Browser đã cài xong chưa? → Kiểm tra token/cookie.
- Token/cookie hợp lệ chưa? → Kiểm tra TikTok có đang chặn session không.
- Tất cả đều fail? → Coi như repo đã hỏng, không phải lỗi người dùng. Hãy đổi công cụ.
Best practice chống ban cho TikTok Scraping (không cần trả tiền proxy)
Người dùng trên forum liên tục than phiền về việc bị ban và bị phát hiện: “chúng làm tài khoản của bạn bị khóa, nên phát sinh thêm chi phí” và “không dùng Apify hay API trả phí đắt tiền.” Dưới đây là các cách làm miễn phí, thực tế, không cần mua gói proxy.
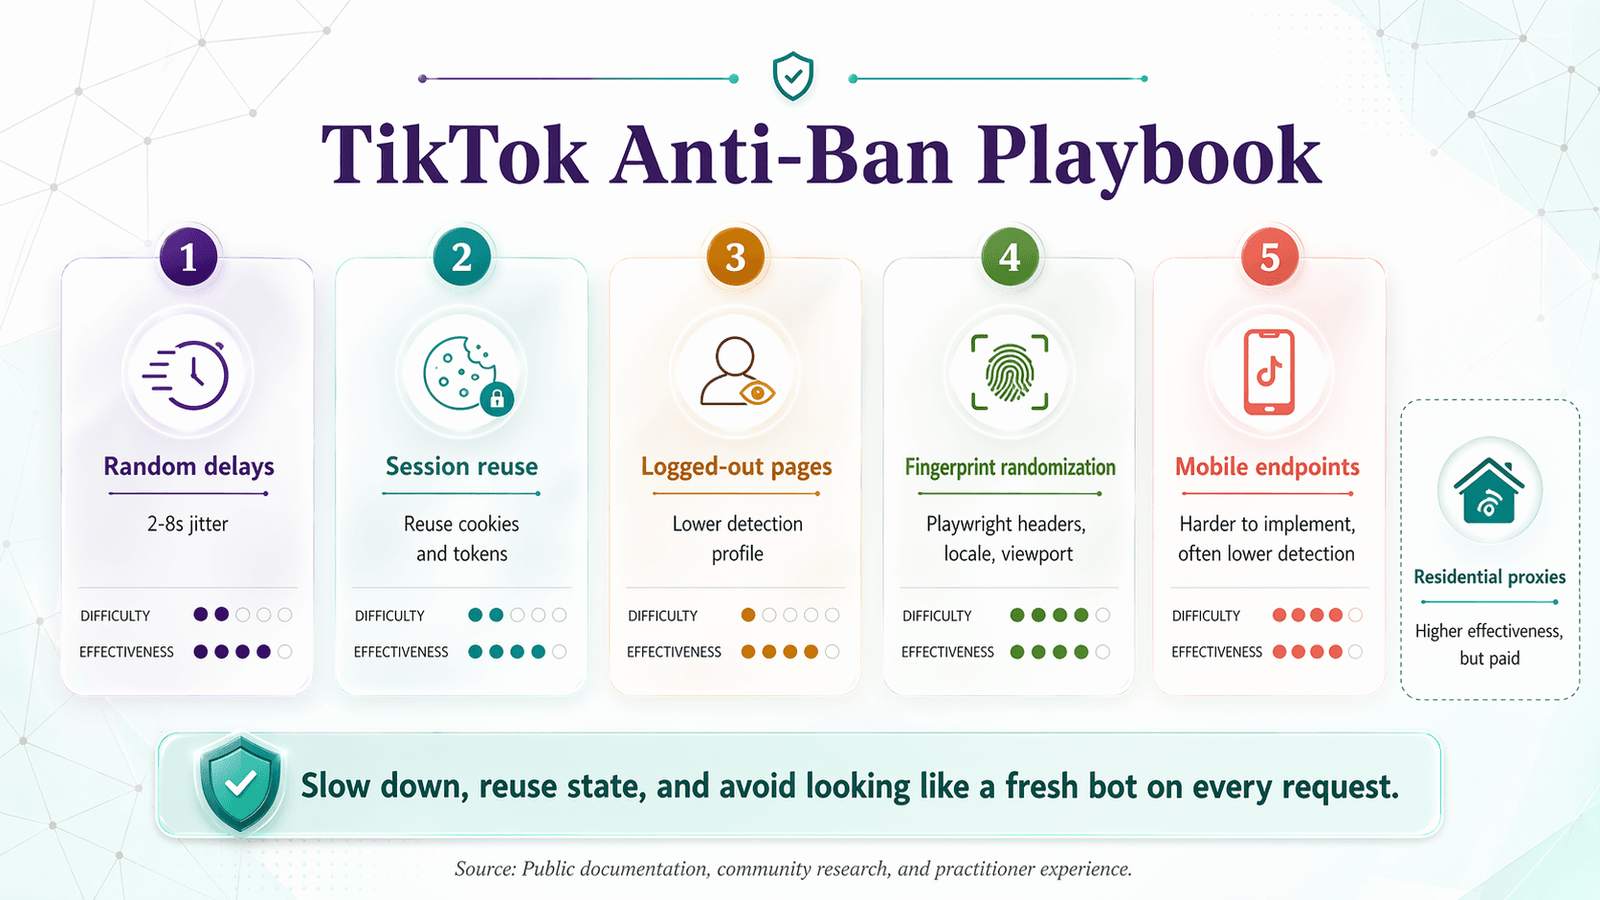
| Thực hành | Độ khó | Chi phí | Hiệu quả |
|---|---|---|---|
| Chèn độ trễ request ngẫu nhiên (jitter 2–8 giây) | Dễ | Miễn phí | Trung bình |
| Xoay vòng session/cookie | Trung bình | Miễn phí | Trung bình |
| Chỉ scrape trang công khai khi đã đăng xuất | Dễ | Miễn phí | Trung bình |
Tôn trọng robots.txt + header giới hạn tốc độ | Dễ | Miễn phí | Mức nền |
| Random hóa fingerprint trình duyệt headless (Playwright) | Trung bình | Miễn phí | Cao |
| Dùng endpoint API mobile của TikTok (ít bị phát hiện hơn) | Khó | Miễn phí | Cao |
| Xoay vòng proxy residential | Trung bình | $20–100/tháng | Cao |
Những kỹ thuật miễn phí thật sự hữu ích
Độ trễ request ngẫu nhiên. Đừng bắn request theo vòng lặp quá nhanh. Hãy thêm độ trễ ngẫu nhiên 2–8 giây giữa các request. Đây là cách đơn giản nhất bạn có thể làm:
import time, random
time.sleep(random.uniform(2, 8))
Tái sử dụng session và cookie. Đừng tạo session mới cho từng request. Hãy dùng lại cookie và trạng thái session trong một loạt request, rồi mới xoay vòng. Đó cũng chính là lý do các repo hiện đại hỏi ms_token thay vì hứa hẹn scraping không trạng thái.
Chỉ scrape các trang công khai khi đã đăng xuất. TikTok-Api nói rõ rằng nó không hỗ trợ route cần đăng nhập người dùng và chỉ hoạt động trên dữ liệu nhìn thấy khi đã đăng xuất. Scrape khi đăng xuất có hồ sơ bị phát hiện thấp hơn so với phiên xác thực.
Tôn trọng robots.txt. robots.txt hiện tại của TikTok chặn hoàn toàn nhiều user-agent và chỉ cho phép một tập hợp đường dẫn công khai hạn chế cho crawl thông thường. Điều đó không có nghĩa là bạn có thể scraping mạnh tay, nhưng tôn trọng nó sẽ giảm nguy cơ bị blacklist IP ngay lập tức.
Kỹ thuật trung cấp để tăng tỉ lệ thành công
Random hóa fingerprint của headless browser. Nếu dùng Playwright, hãy random kích thước viewport, user-agent, timezone và locale cho mỗi session. Điều này làm scraper của bạn trông như một người dùng thật khác nhau mỗi lần, thay vì cùng một bot với IP mới.
Dùng endpoint API mobile của TikTok. Một số thành viên cộng đồng báo cáo tỉ lệ bị phát hiện thấp hơn khi nhắm vào endpoint kiểu mobile thay vì frontend web. Kỹ thuật này khó triển khai hơn và ít tài liệu hơn, nhưng là một cách có thật cho người dùng nâng cao.
Khi nào bạn thực sự cần proxy (và lựa chọn hợp túi tiền)
Ở quy mô lớn, các kỹ thuật miễn phí không đủ. Xoay vòng proxy residential là phương án chuẩn cho scraping TikTok khối lượng lớn. Tôi sẽ không giới thiệu một dịch vụ proxy trả phí cụ thể ở đây, nhưng lời khuyên chung là: tránh proxy datacenter (TikTok phát hiện rất gắt) và tìm các pool proxy residential hoặc mobile có xoay vòng theo request.
Ngoài ra, các công cụ chạy trên trình duyệt như Thunderbit có thể bỏ qua câu hỏi proxy vì chúng chạy ngay trong session trình duyệt của bạn, mô phỏng người dùng thật. Điều đó không có nghĩa là chúng miễn nhiễm ở quy mô lớn, nhưng với các nhu cầu marketing hoặc nghiên cứu thông thường (vài chục đến vài trăm trang, không phải hàng triệu), đây là một hướng đi đơn giản hơn rất nhiều.
Thực tế bạn sẽ lấy được dữ liệu gì? Mẫu output thật từ TikTok Scraper
Người dùng muốn biết họ thực sự nhận được loại dữ liệu nào trước khi quyết định dùng công cụ — nhưng hầu hết bài hướng dẫn đều bỏ qua phần này. Dưới đây là cấu trúc field tiêu biểu, dựa trên tài liệu nguồn.
Dữ liệu profile
| Username | Tên hiển thị | Follower | Đang theo dõi | Tổng lượt thích | Bio | Đã xác minh | URL profile |
|---|---|---|---|---|---|---|---|
| @examplecreator | Jane Doe | 1,240,000 | 312 | 48,700,000 | "Cooking + comedy 🍳" | ✅ | tiktok.com/@examplecreator |
| @travelwithmark | Mark S. | 890,000 | 150 | 22,100,000 | "Travel vlogger 🌍" | ❌ | tiktok.com/@travelwithmark |
| @fitnessmaya | Maya L. | 2,100,000 | 88 | 91,300,000 | "Workouts & wellness" | ✅ | tiktok.com/@fitnessmaya |
Nguồn có thể lấy: GitHub scraper (TikTok-Api, Evil0ctal), Research API, Thunderbit (từ các trang profile hiển thị).
Metadata video
| URL video | Caption | Lượt xem | Lượt thích | Comment | Chia sẻ | Nhạc | Hashtag | Ngày đăng | Thời lượng |
|---|---|---|---|---|---|---|---|---|---|
| tiktok.com/@ex/video/123 | "Best pasta trick ever 🍝" | 4,200,000 | 312,000 | 8,400 | 21,000 | "Italian Vibes – DJ Marco" | #pasta #cooking #hack | 2026-03-15 | 0:42 |
| tiktok.com/@ex/video/456 | "POV: your cat judges you" | 9,100,000 | 1,100,000 | 23,000 | 55,000 | "Original Sound" | #cat #pov #funny | 2026-04-01 | 0:18 |
| tiktok.com/@ex/video/789 | "Morning routine nobody asked for" | 1,800,000 | 98,000 | 3,200 | 7,500 | "Chill Morning – LoFi" | #routine #morning | 2026-04-10 | 1:02 |
Nguồn có thể lấy: GitHub scraper (TikTok-Api, Evil0ctal), Research API (các field gồm video_description, view_count, like_count, comment_count, share_count, music_id, hashtag_names, video_duration), Thunderbit (các field cấp video).
Dữ liệu comment
| Người bình luận | Nội dung comment | Lượt thích | Thời gian | Trả lời |
|---|---|---|---|---|
| @user_abc | "I tried this and it actually works 😂" | 1,200 | 2026-03-16T08:12:00Z | 14 |
| @chef_dan | "Add garlic next time, trust me" | 890 | 2026-03-16T09:45:00Z | 7 |
| @randomfan99 | "This is the content I'm here for" | 340 | 2026-03-16T11:30:00Z | 2 |
Nguồn có thể lấy: GitHub scraper (TikTok-Api, Evil0ctal), Research API (các field gồm text, like_count, reply_count, create_time), Thunderbit (từ phần comment hiển thị).
Dữ liệu hashtag và tìm kiếm
| Hashtag | URL video nổi bật | Tổng lượt xem | Đang trend |
|---|---|---|---|
| #pasta | tiktok.com/@ex/video/123 | 4,200,000 | Có |
| #cooking | tiktok.com/@chef/video/321 | 11,000,000 | Có |
| #hack | tiktok.com/@tips/video/654 | 2,900,000 | Không |
Nguồn có thể lấy: GitHub scraper (tùy repo), Thunderbit (mẫu hashtag scraper).
Lưu ý: không có repo nào đảm bảo luôn lấy đủ mọi field trong mọi thời điểm. Cấu trúc response của TikTok thay đổi liên tục, và ngay cả maintainer cũng cảnh báo điều đó. Hãy xem các ví dụ này như dạng minh họa, không phải cam kết tuyệt đối.
Cách scrape dữ liệu TikTok chỉ với 2 cú click bằng Thunderbit (từng bước)
Mệt mỏi với vòng lặp hỏng-sửa? Đây là hướng không cần code — lối thoát cho bất kỳ ai đã thử repo GitHub nhưng thất bại.
- Cài Thunderbit Chrome Extension.
- Mở trang TikTok bạn muốn scrape — profile, trang kết quả tìm kiếm, hashtag, hoặc một video cụ thể.
- Nhấn “AI Suggest Fields.” AI của Thunderbit sẽ đọc trang và gợi ý cột: username, follower, caption video, lượt thích, hashtag, v.v.
- Chỉnh field nếu cần, rồi nhấn “Scrape.” Dữ liệu sẽ được đổ vào một bảng có cấu trúc.
- Dùng Subpage Scraping để làm giàu dữ liệu. Bấm vào từng video từ danh sách profile và kéo thêm field: caption đầy đủ, chi tiết nhạc, số comment, số chia sẻ.
- Xuất sang Google Sheets, Excel, Airtable hoặc Notion — hoàn toàn miễn phí.
Không cần bảo trì, không cần xử lý cài đặt, không cần cấu hình chống chặn. AI tự động thích ứng với thay đổi layout của TikTok.
Làm giàu dữ liệu TikTok bằng Subpage Scraping
Sau khi scrape danh sách video từ profile hoặc trang hashtag, hãy bấm “Scrape Subpages” để AI đi vào từng trang video và lấy thêm field. Cách này đặc biệt hữu ích cho marketer đang xây dựng database influencer hoặc phân tích nội dung đối thủ — bạn có một bảng đầy đủ dữ liệu tương tác cấp video mà không cần tự bấm qua hàng chục trang.
Xuất và sử dụng dữ liệu TikTok của bạn
Thunderbit xuất dữ liệu sang Google Sheets, Excel, Airtable, Notion, CSV hoặc JSON — hoàn toàn miễn phí. Các trường hợp dùng phổ biến:
- Đưa dữ liệu vào bảng tính để phân tích tương tác.
- Gửi sang Airtable làm CRM theo dõi influencer.
- Đẩy vào Notion để cả nhóm cùng cộng tác nghiên cứu nội dung.
Để xem Thunderbit xử lý trích xuất dữ liệu web như thế nào sâu hơn, hãy xem hướng dẫn web scraping cho người mới hoặc xem video trên kênh YouTube của Thunderbit.
Giữ đúng luật: điều khoản sử dụng của TikTok và tuân thủ khi scraping
Quan điểm pháp lý của TikTok rất rõ ràng. bài viết trên blog về quyền riêng tư và scraping của nền tảng nêu rằng Terms of Service cấm các script tự động thu thập thông tin hoặc tương tác với dịch vụ theo cách không được phép, đồng thời đề cập trực tiếp đến việc vượt qua giới hạn truy cập. Community Guidelines của TikTok cũng cấm các nỗ lực lừa đảo nhằm lấy thông tin thông qua script tự động hoặc web crawling.
Hướng dẫn thực tế:
- Chỉ dùng dữ liệu công khai. Đừng scrape nội dung riêng tư hoặc bị khóa đăng nhập.
- Tôn trọng rate limit. Đừng spam server của TikTok.
- Tuân thủ luật bảo vệ dữ liệu. GDPR và CCPA vẫn áp dụng nếu bạn thu thập, lưu trữ hoặc phân tích dữ liệu cá nhân.
- Dùng Research API khi đủ điều kiện. Đây là đường an toàn nhất về mặt tuân thủ.
- Đây không phải tư vấn pháp lý. Hãy hỏi chuyên gia cho trường hợp cụ thể của bạn.
Xem thêm hướng dẫn về tác động pháp lý của web scraping để hiểu rõ hơn bối cảnh pháp lý.
Làm gì khi repo TikTok Scraper trên GitHub của bạn chết
Bản tóm tắt ngắn gọn:
- Luôn chạy checklist Repo Vitals trong 60 giây trước khi clone bất kỳ TikTok scraper nào từ GitHub. Hầu hết repo đã chết sẵn.
- Hiểu rõ lựa chọn của bạn. Official API, GitHub scraper và công cụ no-code phục vụ các nhóm người dùng và mục đích khác nhau.
- Nếu vẫn chọn GitHub, hãy dành thời gian cho việc xử lý cài đặt và cấu hình chống chặn. Hãy chấp nhận việc phải bảo trì liên tục.
- Biết mình sẽ nhận được dữ liệu gì trước khi gắn bó với một công cụ. Hãy kiểm tra field đầu ra chứ không chỉ nhìn số stars.
- Nếu bạn không phải developer (hoặc đã ngán các repo hỏng), hãy thử công cụ no-code như Thunderbit — hai cú click, dữ liệu có cấu trúc, xuất miễn phí.
Dữ liệu TikTok bạn cần là có thể lấy được. Câu hỏi chỉ là bạn muốn dành thời gian để bảo trì scraper hay muốn dùng dữ liệu đó vào việc thực tế. Hãy chọn cách phù hợp với kỹ năng và nhu cầu của bạn, và đừng để một repo GitHub đã chết cướp mất thêm một buổi chiều của bạn.
Dùng thử Thunderbit để lấy dữ liệu TikTok
Câu hỏi thường gặp
Có repo TikTok scraper nào trên GitHub vẫn hoạt động trong năm 2026 không?
Có, nhưng danh sách khá ngắn. davidteather/TikTok-Api là lựa chọn mã nguồn mở đáng tin nhất còn được duy trì hoạt động tính đến tháng 4/2026. Evil0ctal/Douyin_TikTok_Download_API cũng còn sống nhưng phức tạp hơn. Repo có nhiều stars nhất, drawrowfly/tiktok-scraper, đã không được cập nhật từ tháng 5/2023 và về cơ bản là đã chết. Luôn chạy checklist Repo Vitals trước khi đầu tư thời gian vào bất kỳ repo nào.
Scrape TikTok có hợp pháp không?
Điều khoản sử dụng của TikTok cấm rõ ràng việc scraping tự động. Dữ liệu công khai nằm trong vùng xám pháp lý, và điều này thay đổi theo từng khu vực pháp lý. Con đường an toàn nhất là dùng Research API chính thức nếu bạn đủ điều kiện. Nếu bạn scrape dữ liệu công khai, hãy chỉ dùng nội dung có thể truy cập công khai, tôn trọng rate limit và tuân thủ GDPR/CCPA. Đây không phải tư vấn pháp lý — hãy hỏi chuyên gia cho tình huống của bạn.
Tôi có thể scrape TikTok mà không cần code không?
Có. Các công cụ AI chạy trên trình duyệt như Thunderbit cho phép bạn trích xuất dữ liệu TikTok có cấu trúc (profile, metadata video, hashtag, chỉ số tương tác) mà không cần viết code. TikTok Research API cũng yêu cầu lượng code tối thiểu với người đã được duyệt. Với người không lập trình, công cụ no-code là hướng nhanh và đáng tin cậy nhất.
Tôi có thể lấy những dữ liệu nào từ TikTok scraper?
Các loại dữ liệu phổ biến gồm thông tin profile (username, follower, bio, trạng thái xác minh), metadata video (caption, lượt xem, lượt thích, comment, chia sẻ, nhạc, hashtag, thời lượng, ngày đăng), comment (nội dung, lượt thích, thời gian, trả lời), và dữ liệu hashtag/tìm kiếm (video nổi bật, tổng lượt xem, trạng thái trend). Field cụ thể phụ thuộc vào công cụ và phương pháp — xem phần ví dụ output ở trên để biết chi tiết.
Vì sao TikTok scraper của tôi cứ bị chặn?
TikTok dùng nhiều lớp chống bot: giới hạn tốc độ, ràng buộc cookie/session, fingerprint trình duyệt, phát hiện hành vi, tham số request được mã hóa và luồng CAPTCHA. Nguyên nhân thường gặp khiến bị chặn gồm gửi request quá nhanh, dùng session sạch/mới cho từng request, chạy headless browser với fingerprint mặc định, hoặc dùng proxy datacenter. Xem phần best practice chống ban ở trên để biết các cách xử lý miễn phí và trả phí.




