
Tuần trước, một người dùng nhắn cho chúng tôi: "Tôi cần giá, mô tả và dữ liệu biến thể từ 14 cửa hàng Shopify của đối thủ — hạn chót là thứ Sáu." Tính ra là khoảng 4.000 trang sản phẩm. Copy-paste thủ công ư? Không đời nào.
Nếu bạn từng cố kéo dữ liệu sản phẩm từ một cửa hàng Shopify — giá, hình ảnh, mô tả, biến thể, đánh giá — bạn sẽ hiểu cảm giác đau đầu đó. Tính đến năm 2026, đã có hơn 2,8 triệu cửa hàng Shopify đang hoạt động, và chẳng cửa hàng nào có nút "xuất dữ liệu cho người ngoài" cả. Trong khi đó, 72% doanh nghiệp cho biết họ chủ động theo dõi giá của đối thủ, còn các nhà cung cấp dịch vụ ecommerce nói rằng chỉ riêng việc tải thủ công một sản phẩm có biến thể và hình ảnh cũng đã mất 15 đến 30 phút. Nhân lên cho vài trăm sản phẩm là bạn mất cả tuần làm việc.
Đó là lý do các tiện ích Chrome scraper cho Shopify đã trở thành một phần quen thuộc trong bộ công cụ ecommerce — phục vụ nghiên cứu đối thủ, tìm sản phẩm dropshipping, chuyển đổi danh mục, và hơn thế nữa. Tuy nhiên, phần lớn các bài viết "scraper tốt nhất" chỉ liệt kê tính năng mà không cho thấy thực sự điều gì xảy ra khi chạy chúng trên các cửa hàng Shopify thật. Bài này thì khác. Tôi đã thử 8 tiện ích trên các storefront thực tế, chạm phải những hàng rào chống bot thật, và xác định công cụ nào lấy được dữ liệu sản phẩm sâu mà bạn cần — và công cụ nào chỉ dừng ở bề mặt.
Vì sao đội ecommerce cần tiện ích Chrome Shopify scraper
Các cửa hàng Shopify là kho dữ liệu sản phẩm cực kỳ hữu ích về mặt thương mại. Nhưng nếu là người ngoài, bạn sẽ không có nút tải CSV. Bạn chỉ thấy một storefront. Để biến storefront đó thành thông tin có thể hành động, bạn cần scraper — và các trường hợp sử dụng này vượt xa chuyện "tôi muốn danh sách tên sản phẩm".
Câu hỏi thực sự là: bạn cần dữ liệu gì, và cho quy trình nào? Dưới đây là cách những trường hợp ecommerce phổ biến nhất gắn với các trường dữ liệu cụ thể:
Nghiên cứu giá đối thủ
Bạn cần: tên sản phẩm, giá, giá so sánh, và giá theo từng biến thể. Đây là nền tảng của chiến lược định giá động — không chỉ biết đối thủ bán bao nhiêu, mà còn biết họ giảm giá thế nào, gói sản phẩm ra sao, và định giá theo size hoặc màu như thế nào.
Tìm sản phẩm dropshipping
Bạn cần: tên sản phẩm, toàn bộ ảnh (không chỉ ảnh thumbnail), mô tả đầy đủ, và ngày đăng. Việc sắp xếp theo ngày đăng mới nhất giúp bạn phát hiện xu hướng hoặc sản phẩm vừa ra mắt trước khi thị trường bị bão hòa.
Nhập catalog vào cửa hàng của bạn
Bạn cần: tên sản phẩm, body HTML, toàn bộ ảnh, biến thể, SKU và giá — lý tưởng nhất là ở định dạng CSV sẵn sàng để import vào Shopify. Không phải công cụ nào cũng xuất ra dữ liệu sạch như vậy.
Ước tính tốc độ bán hàng
Bạn cần: tên sản phẩm và tồn kho, được theo dõi theo thời gian. Bằng cách chụp mức tồn kho theo lịch định kỳ, bạn có thể ước đoán tốc độ đối thủ đang bán hàng — một chỉ báo gần đúng nhưng hữu ích khi không có dữ liệu doanh số trực tiếp.
Tìm kiếm khách hàng tiềm năng (chủ cửa hàng)
Bạn cần: tên cửa hàng, email liên hệ, số điện thoại, và đôi khi cả app hoặc stack công nghệ mà cửa hàng đang dùng. Đội sales dùng dữ liệu này để tạo danh sách tiếp cận theo từng ngách hoặc công nghệ.
Dưới đây là bảng tham chiếu nhanh:
| Trường hợp sử dụng | Các trường dữ liệu quan trọng cần có | Quy trình đề xuất |
|---|---|---|
| Nghiên cứu giá đối thủ | Tên, giá, giá so sánh, giá theo biến thể | Crawl trang danh sách + làm giàu dữ liệu từ trang con cho biến thể |
| Tìm sản phẩm dropshipping | Tên, giá, ảnh (toàn bộ), mô tả, ngày đăng | Crawl trang con + sắp xếp theo ngày đăng mới nhất |
| Nhập catalog vào cửa hàng của bạn | Tên, body HTML, ảnh, biến thể, SKU, giá | Crawl toàn bộ trang con → xuất CSV tương thích Shopify import |
| Ước tính doanh số | Tên, số lượng tồn kho (theo thời gian) | Crawl theo lịch → theo dõi trên Google Sheets |
| Tạo lead (chủ cửa hàng) | Tên cửa hàng, email, số điện thoại, app đang dùng | Crawl trang liên hệ của cửa hàng + dùng công cụ trích email/số điện thoại |
Tôi đã đánh giá 8 tiện ích Chrome Shopify scraper này như thế nào
Tôi cài cả 8 tiện ích và chạy chúng trên cùng một nhóm cửa hàng Shopify thật — bao gồm cửa hàng công khai, cửa hàng có bảo vệ Cloudflare, và cửa hàng đã tắt products.json. Tôi không chỉ xem danh sách tính năng. Tôi muốn biết thực sự chuyện gì xảy ra khi bạn bấm "scrape" trên một trang collection Shopify đang hoạt động.
Dưới đây là 8 tiêu chí tôi dùng, và lý do từng tiêu chí lại quan trọng riêng với Shopify:
| Tiêu chí | Vì sao quan trọng với Shopify scraping |
|---|---|
| Dễ cài đặt | Người không rành kỹ thuật có thể bắt đầu scrape trong chưa tới 5 phút không? |
| Trường dữ liệu trích xuất | Có lấy được tên, giá, ảnh, mô tả, biến thể, VÀ đánh giá không — hay chỉ dữ liệu bề mặt? |
| Làm giàu từ trang con | Có thể scrape trang danh sách rồi tự động truy cập từng trang sản phẩm để lấy thông tin đầy đủ không? |
| Xử lý phân trang | Có thể scrape qua nhiều trang sản phẩm (bấm pagination hoặc cuộn vô hạn) không? |
| Khả năng chống bot | Có xử lý được Cloudflare Turnstile hoặc bảo vệ bot của Shopify mà không bị lỗi không? |
| Định dạng xuất dữ liệu | CSV, Excel, Google Sheets, Airtable, Notion, CSV sẵn sàng cho Shopify import? |
| Scrape theo lịch/lặp lại | Có thể theo dõi giá hoặc thay đổi tồn kho tự động theo thời gian không? |
| Minh bạch về giá | Giới hạn gói miễn phí, hệ thống credit, phí cố định — và thứ bạn thực sự nhận được |
Với khung đánh giá đó, đây là hiệu quả của từng công cụ.
1. Thunderbit — Shopify scraper dùng AI, sinh ra cho người không biết code
Thunderbit là công cụ chúng tôi xây dựng tại Thunderbit, được thiết kế riêng cho người dùng doanh nghiệp muốn có dữ liệu sản phẩm sâu mà không phải viết code, cấu hình CSS selector hay mất 20 phút để cài đặt. Quy trình trên một cửa hàng Shopify thực sự chỉ một cú nhấp: mở trang collection và bấm One Click Extract — AI sẽ đọc trang, tự suy ra các cột (tên, giá, hình ảnh, v.v.), rồi kéo dữ liệu danh sách về.
Nhưng điểm khác biệt thực sự — và cũng là phần mà hầu hết bài viết đối thủ bỏ qua — là chuyện xảy ra ngay sau đó.
Làm giàu trang con: tính năng thay đổi toàn bộ cuộc chơi
Sau khi scrape trang danh sách, bạn bấm "Scrape Subpages." AI của Thunderbit sẽ truy cập từng URL sản phẩm và bổ sung dữ liệu từ trang chi tiết vào bảng gốc: mô tả đầy đủ, toàn bộ ảnh gallery, tùy chọn biến thể, SKU, số lượng đánh giá, và nhiều hơn nữa. Đây chính là bước biến một bảng tính sơ sài thành bộ dữ liệu nghiên cứu đối thủ thực sự dùng được.
Tôi sẽ phân tích sâu hơn vì sao điều này quan trọng (và cho xem so sánh trước/sau) ở một phần riêng bên dưới.
Điểm mạnh chính khi scrape Shopify
- One Click Extract đọc trang Shopify và tự xác định cấu trúc cột phù hợp — không cần CSS selector, không cần cài đặt thủ công
- Scrape trang con lấp đầy những khoảng trống mà trang danh sách thường thiếu (mô tả đầy đủ, tùy chọn biến thể, gallery ảnh, đánh giá)
- Chế độ cloud scraping cho trích xuất hàng loạt nhanh trên cửa hàng công khai; chế độ browser scraping cho cửa hàng có Cloudflare hoặc yêu cầu đăng nhập
- Xử lý phân trang (bấm nút và cuộn vô hạn)
- Scrape theo lịch để theo dõi giá/tồn kho liên tục — chỉ cần mô tả lịch bằng ngôn ngữ tự nhiên (ví dụ: "mỗi thứ Hai lúc 9 giờ sáng")
- Bộ trích xuất email và số điện thoại miễn phí cho nhu cầu tạo lead
- Xuất sang Excel, Google Sheets, Airtable, Notion, CSV, JSON — bao gồm cả định dạng thân thiện với Shopify import
- Field AI Prompt cho phép thêm hướng dẫn riêng cho từng cột (ví dụ: "phân loại thành 3 nhóm sản phẩm" hoặc "dịch mô tả sang tiếng Anh")
Điểm còn hạn chế
- Mô hình tính phí theo credit khiến việc scrape quy mô rất lớn (hàng chục nghìn sản phẩm) cần gói trả phí
- Xử lý bằng AI mất thêm vài giây mỗi dòng so với scraper dựa trên template ở các trang quá đơn giản
Giá
- Gói miễn phí: 6 trang (hoặc tối đa 10 với bản dùng thử), tất cả export đều miễn phí
- Starter: $15/tháng, 500 credit/tháng
- Gói Professional: từ $38/tháng (3.000 credit) đến $249/tháng (20.000 credit)
- Quy tắc credit: 1 dòng đầu ra = 1 credit cho web scraping; 1 dòng đầu ra = 2 credit cho scrape trang con; export luôn miễn phí
Phù hợp nhất cho: Đội ecommerce không rành kỹ thuật nhưng cần dữ liệu sản phẩm Shopify sâu nhất với cấu hình tối thiểu — và muốn theo dõi đối thủ theo thời gian.
Dùng thử Thunderbit để scrape Shopify Lấy tên sản phẩm, giá, biến thể và hình ảnh từ bất kỳ cửa hàng Shopify nào — chỉ cần bấm một lần, không phải cấu hình selector. Get Started Free
2. Instant Data Scraper — Lựa chọn tự nhận diện tự động, không cần cấu hình
Instant Data Scraper là tiện ích Chrome miễn phí dùng thuật toán heuristic để tự phát hiện dữ liệu dạng bảng trên trang web. Hoàn toàn không cần cấu hình — mở trang collection Shopify, bấm biểu tượng tiện ích, và nó sẽ cố gắng nhận diện rồi hiển thị dữ liệu sản phẩm dưới dạng bảng.
Trong quá trình thử nghiệm, nó hoạt động khá tốt trên các trang collection dùng theme Dawn tiêu chuẩn của Shopify, nhận ra tên, giá và URL ảnh thumbnail chỉ trong vài giây. Nhưng với các store có layout không chuẩn, nó đôi khi lấy nhầm link điều hướng hoặc nội dung footer thay vì sản phẩm — bạn phải tự xem lại đầu ra.
Điểm mạnh chính khi scrape Shopify
- Hoàn toàn miễn phí, không giới hạn sử dụng
- Tự động phát hiện nên gần như không mất thời gian cài đặt — phù hợp cho các lần xuất dữ liệu nhanh, dùng một lần
- Hỗ trợ phân trang (có thể tự bấm "trang tiếp theo")
- Xuất ra CSV và XLSX
Điểm còn hạn chế
- Tự động phát hiện lúc được lúc không trên các cửa hàng Shopify có layout không chuẩn
- Không có làm giàu trang con: bạn chỉ lấy được những gì nằm trên trang danh sách (tên, giá, thumbnail), không có mô tả đầy đủ, biến thể hay đánh giá
- Không có AI để làm sạch, gắn nhãn hay biến đổi dữ liệu
- Không có tính năng lên lịch, không có cloud scraping
- Không xuất trực tiếp sang Google Sheets, Airtable hoặc Notion
Giá
- Hoàn toàn miễn phí
Phù hợp nhất cho: Bất kỳ ai cần xuất nhanh, miễn phí và không cần cấu hình dữ liệu hiển thị trên trang danh sách từ một cửa hàng Shopify tiêu chuẩn.
3. Web Scraper — Trình dựng sitemap trực quan
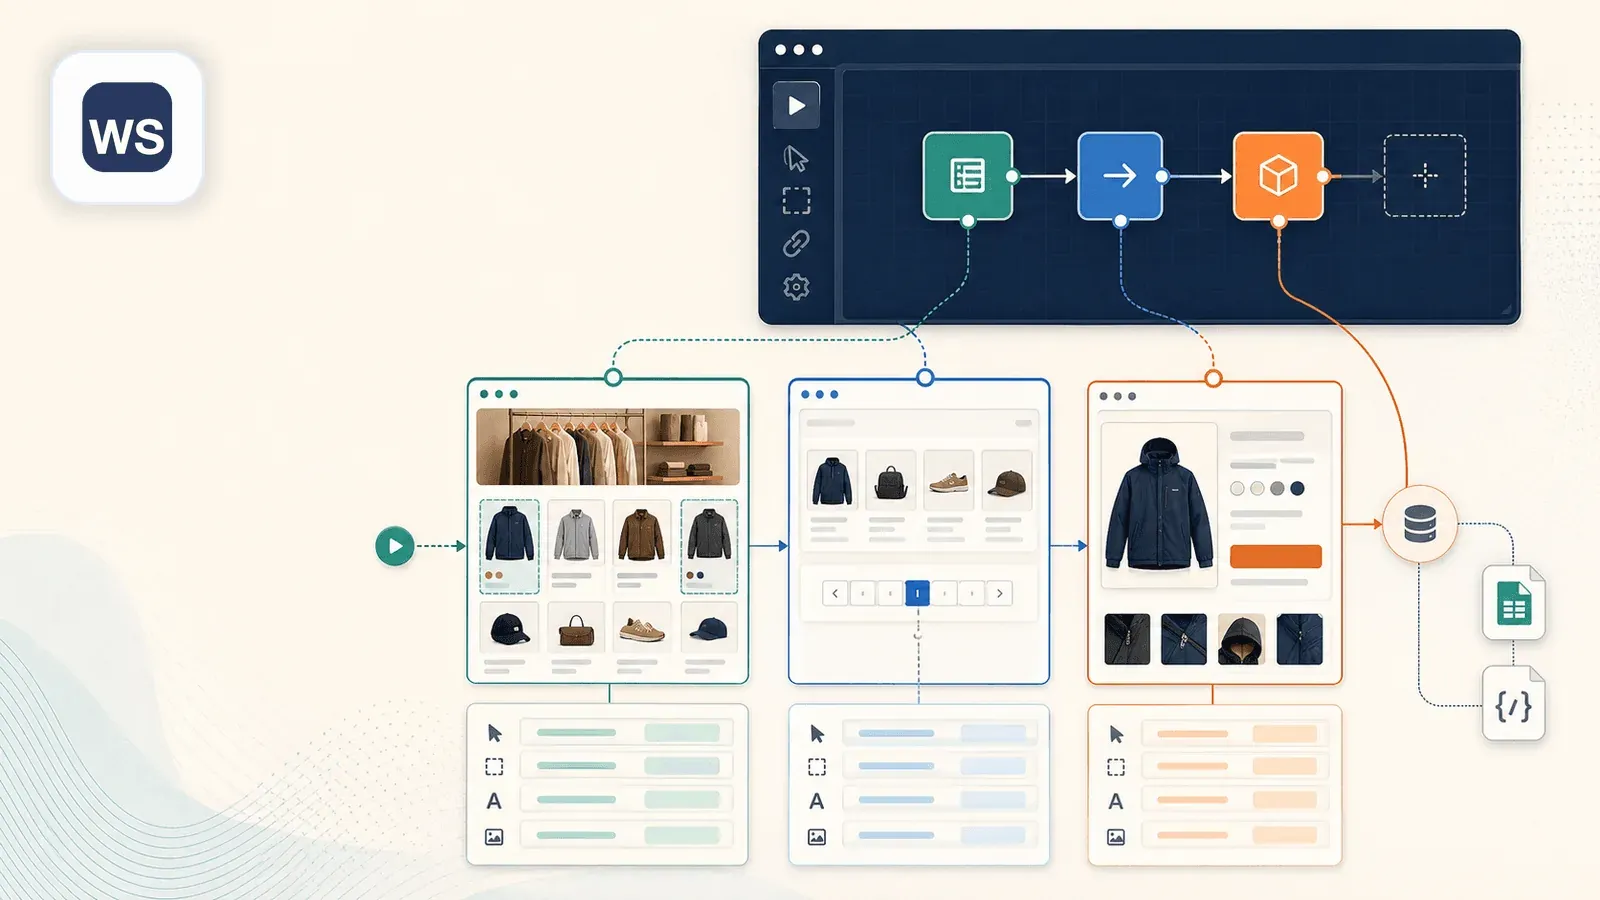
Web Scraper (webscraper.io) là tiện ích Chrome point-and-click kinh điển để xây dựng "sitemap" — tức công thức scrape, nơi bạn chọn phần tử trên trang và định nghĩa luồng scraping. Trên Shopify, bạn sẽ tạo sitemap bằng cách click vào tên sản phẩm, giá, hình ảnh, rồi cấu hình quy tắc phân trang và theo liên kết.
Điểm mạnh chính khi scrape Shopify
- Trình dựng selector trực quan cho phép kiểm soát tốt hơn các công cụ tự động nhận diện
- Có thể đi theo link sang trang con (trang chi tiết sản phẩm) — nhưng bạn phải cấu hình thủ công selector cha-con trong sitemap
- Xử lý phân trang nếu thiết lập đúng
- Scrape trên trình duyệt miễn phí; có gói cloud trả phí (từ $50/tháng)
- Xuất ra CSV; các gói cloud hỗ trợ Google Sheets và các định dạng khác
Điểm còn hạn chế
- Mất thời gian cài đặt hơn: tạo sitemap với selector cha-con khiến tôi mất khoảng 15 phút cho một store Shopify mới
- Scrape trang con đòi hỏi cấu hình thủ công selector link và child sitemap — không phải làm giàu dữ liệu bằng một cú nhấp
- Sitemap dễ hỏng khi cửa hàng Shopify đổi layout hoặc class CSS
- Đường cong học tập cao hơn so với các lựa chọn dùng AI
Giá
- Tiện ích trình duyệt: Miễn phí
- Gói cloud: Project $50/tháng, Professional $100/tháng, Scale từ $200/tháng
Phù hợp nhất cho: Người dùng kỹ thuật muốn kiểm soát chi tiết luồng scraping và không ngại tự xây công thức.
4. Data Miner — Scraper dựa trên recipe
Data Miner (dataminer.io) được xây dựng xoay quanh "recipe" — các template scrape dựng sẵn hoặc tùy chỉnh mà bạn áp lên một trang. Có thư viện recipe công khai, nên bạn có thể tìm thấy template Shopify do người dùng khác chia sẻ, hoặc tự tạo bằng cách chọn phần tử trên trang.
Điểm mạnh chính khi scrape Shopify
- Thư viện recipe có thể đã có sẵn template Shopify do người dùng khác chia sẻ
- Trình dựng recipe trực quan cho cấu hình scrape tùy chỉnh
- Xử lý phân trang bằng cấu hình recipe
- Xuất ra CSV, Excel, Google Sheets và TSV
- Có workflow crawl để ghé từng trang chi tiết sau khi đi qua trang danh sách
Điểm còn hạn chế
- Gói miễn phí chỉ giới hạn 500 trang/tháng
- Recipe dựa trên CSS selector nên dễ hỏng khi layout cửa hàng thay đổi
- Không có gợi ý trường dữ liệu hay biến đổi dữ liệu bằng AI
- Không có workflow làm giàu trang con một cú nhấp — phải tạo recipe crawl riêng cho trang chi tiết
- Có crawl theo lịch nhưng không phải là trải nghiệm lên lịch đơn giản nhất
Giá
- Miễn phí: 500 trang/tháng
- Solo: $19.99/tháng
- Small Business: $49/tháng
- Business: $99/tháng
- Business Plus: $200/tháng
Phù hợp nhất cho: Người thích làm việc với template và muốn tận dụng thư viện recipe để rút ngắn thời gian thiết lập trên các website phổ biến.
5. Simplescraper — Công cụ trích xuất gọn nhẹ
Simplescraper (simplescraper.io) là một tiện ích Chrome tối giản kết hợp scraper trên cloud, ưu tiên sự đơn giản. Bạn click vào các phần dữ liệu trên trang Shopify, Simplescraper sẽ tạo CSS selector và trích xuất dữ liệu tương ứng.
Điểm mạnh chính khi scrape Shopify
- Giao diện sạch, tối giản — học rất nhanh
- Có cloud scraping cho tác vụ theo lịch và xử lý khối lượng lớn
- Có API cho developer muốn tích hợp dữ liệu scrape vào workflow
- Xuất ra CSV, JSON, Google Sheets, Airtable và qua webhook
- Có khái niệm deep scraping để theo link sang trang chi tiết
- Hỗ trợ workflow cần đăng nhập cho các store phụ thuộc session
Điểm còn hạn chế
- Cách làm thủ công dựa trên selector — không có AI tự nhận diện trường
- Scrape trang con cần thêm cấu hình
- Cộng đồng nhỏ hơn và ít template dựng sẵn hơn Web Scraper hoặc Data Miner
- Gói miễn phí chỉ có 100 credit (1 trang render bằng JS = 2 credit)
- Giá gói trả phí ít minh bạch trên website chính thức hơn nhiều đối thủ
Giá
- Miễn phí: 100 credit
- Gói trả phí: Các nguồn bên thứ ba liệt kê Plus khoảng ~$39/tháng, Pro khoảng ~$70/tháng, Premium khoảng ~$150/tháng (theo dữ liệu giá từ G2)
Phù hợp nhất cho: Người muốn một scraper cloud hiện đại, nhẹ, tích hợp tốt và không cần nhận diện trường bằng AI.
6. Octoparse — Tiện ích Chrome đi kèm ứng dụng desktop
Octoparse (octoparse.com) chủ yếu là một ứng dụng desktop có kèm tiện ích Chrome. Nó cung cấp cả trình dựng workflow trực quan lẫn template dựng sẵn cho các website phổ biến, bao gồm cả hướng dẫn scrape riêng cho Shopify.
Điểm mạnh chính khi scrape Shopify
- Template Shopify dựng sẵn cho các tác vụ scrape phổ biến
- Ứng dụng desktop mạnh mẽ với tính năng nâng cao: xoay IP, scrape theo lịch, trích xuất trên cloud
- Xử lý tốt phân trang, cuộn vô hạn và nội dung tải bằng AJAX
- Khả năng xử lý anti-bot được tài liệu hóa mạnh nhất trong danh sách này, bao gồm tự động xử lý CAPTCHA
- Xuất ra CSV, Excel, JSON, HTML, XML, database và Google Sheets
Điểm còn hạn chế
- Chỉ riêng tiện ích Chrome thì bị giới hạn — phần lớn tính năng mạnh cần ứng dụng desktop
- Ứng dụng desktop có đường cong học tập cao hơn với trình dựng workflow trực quan
- Gói miễn phí bị giới hạn; dùng nghiêm túc thì cần gói trả phí
- Thiết lập nặng hơn so với các công cụ thuần Chrome extension — không lý tưởng cho một lần scrape nhanh 5 phút
- Ứng dụng desktop chỉ hỗ trợ Windows/Mac (không hoàn toàn chạy trên trình duyệt)
Giá
- Gói miễn phí có sẵn
- Basic: $39/tháng
- Standard: khoảng $83/tháng (tháng), khoảng $75/tháng (năm)
- Professional: khoảng $299/tháng (tháng), khoảng $208/tháng (năm)
- Enterprise: tùy chỉnh
Phù hợp nhất cho: Đội ngũ cần scraping quy mô doanh nghiệp với xoay IP, xử lý anti-bot và tác vụ cloud lặp lại — và không ngại dùng ứng dụng desktop.
7. Bardeen — Scraper ưu tiên tự động hóa
Bardeen (bardeen.ai) là nền tảng tự động hóa trình duyệt, kết hợp web scraping với workflow automation. Người dùng xây "playbook" để vừa scrape dữ liệu vừa đẩy sang ứng dụng khác — hiểu đơn giản là: "nếu tôi scrape cái này, thì đẩy nó vào CRM của tôi."
Điểm mạnh chính khi scrape Shopify
- Tự động hóa workflow vượt ra ngoài việc scrape: scrape dữ liệu Shopify → làm giàu → đẩy vào CRM hoặc bảng tính trong cùng một playbook
- Tích hợp với hơn 100 app (Google Sheets, Airtable, Notion, HubSpot, Slack, v.v.)
- Tính năng AI cho trích xuất và phân loại dữ liệu
- Chạy ngay trong trình duyệt — không cần ứng dụng desktop
- Tự động hóa theo thời gian/ngày để lên lịch
Điểm còn hạn chế
- Chủ yếu là công cụ automation, không phải scraper chuyên dụng — tính năng scraping không sâu bằng các công cụ chuyên biệt
- Việc tạo playbook có thể gây rối với người chỉ muốn trích xuất danh sách sản phẩm
- Gói miễn phí chỉ 100 credit
- Làm giàu trang con và xử lý phân trang kém trực quan hơn các công cụ scraping chuyên dụng
- Quá nhiều chức năng nếu bạn chỉ cần scrape dữ liệu mà không cần automation phía sau
Giá
- Miễn phí: 100 credit
- Basic: $10/tháng, 100 credit/tháng
- Premium: $50/tháng, 1.000 credit/tháng (khoảng $40/tháng nếu trả năm)
- Enterprise: tùy chỉnh
- Mô hình credit: 1 credit cho mỗi dòng scrape, 3 credit cho mỗi dòng làm giàu
Phù hợp nhất cho: Đội ngũ muốn scrape dữ liệu Shopify rồi đẩy ngay vào các app phía sau (CRM, bảng tính, Slack) trong cùng một workflow tự động.
8. Listly — Công cụ chuyển danh sách sang bảng tính
Listly (listly.io) được thiết kế riêng để biến danh sách và bảng trên web thành dữ liệu sẵn sàng cho spreadsheet. Bấm tiện ích trên một trang collection Shopify và Listly sẽ cố gắng nhận diện danh sách sản phẩm rồi xuất ra dạng bảng tính.
Điểm mạnh chính khi scrape Shopify
- Giao diện cực kỳ đơn giản — thiết kế cho việc trích xuất danh sách chỉ bằng một cú nhấp
- Nhận diện tốt các cấu trúc danh sách lặp lại (như grid sản phẩm)
- Xuất thẳng sang Excel và Google Sheets
- Có tính năng nhóm scraping để xử lý nhiều URL cùng lúc
- Hỗ trợ lên lịch trên gói Business
Điểm còn hạn chế
- Chỉ làm được những gì nó tự nhận diện trên trang — không có cấu hình trường tùy chỉnh
- Không có làm giàu trang con — chỉ xuất dữ liệu ở mức trang danh sách
- Khó với các theme Shopify không chuẩn hoặc site render JavaScript nặng
- Gói miễn phí rất hạn chế (10 URL/tháng)
- Tùy chọn xuất dữ liệu ít hơn đối thủ (chủ yếu Excel và Sheets)
Giá
- Miễn phí: 10 URL/tháng, trích xuất 1 trang cơ bản, tải Excel, xuất Google Sheet
- Light: $30/tháng ($187.20/năm)
- Business: $90/tháng ($993.60/năm) — thêm trích xuất nâng cao, trích xuất nhóm, lên lịch, tự động cuộn/bấm, API beta
Phù hợp nhất cho: Người muốn con đường đơn giản nhất từ trang collection Shopify sang bảng tính — và không cần dữ liệu sản phẩm sâu.
So sánh 8 tiện ích Chrome Shopify scraper
Dưới đây là bảng so sánh đầy đủ. Tôi cố gắng mô tả cụ thể ở từng ô thay vì chỉ đánh dấu có/không — vì "hỗ trợ phân trang" có thể rất khác nhau tùy công cụ.
| Công cụ | Dễ cài đặt | Trường dữ liệu | Làm giàu trang con | Phân trang | Xử lý anti-bot | Định dạng xuất | Lên lịch | Gói miễn phí / Giá |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Rất dễ (dẫn dắt bằng AI, 1 click) | Mạnh nhất cho người không rành kỹ thuật (AI tự xác định tất cả trường liên quan) | Có — làm giàu bằng một cú nhấp | Có (bấm + cuộn vô hạn) | Cloud cho trang công khai, browser cho trang được bảo vệ | Sheets, Airtable, Notion, CSV, JSON, Excel | Có (lên lịch bằng ngôn ngữ tự nhiên) | Miễn phí 6 trang; trả phí từ $15/tháng |
| Instant Data Scraper | Cực dễ (không cần cấu hình) | Tốt cho dữ liệu ở mức danh sách | Không | Có (tự nhận diện trang tiếp theo) | Chỉ browser, không có câu chuyện anti-bot rõ ràng | CSV, XLSX | Không | Miễn phí |
| Web Scraper | Trung bình-khó (tạo sitemap thủ công) | Linh hoạt nếu sitemap được xây đúng | Có, nhưng thủ công qua selector link | Có (nếu cấu hình sitemap) | Chạy trên browser local; xoay proxy ở gói cloud | CSV ở local; nhiều định dạng hơn ở cloud | Có trên gói cloud | Tiện ích miễn phí; cloud từ $50/tháng |
| Data Miner | Trung bình (dựa trên recipe) | Tốt nếu có recipe sẵn hoặc tự xây | Có, nhưng cần crawl nhiều bước | Có (cấu hình recipe) | Chủ yếu chạy phía browser | CSV, Excel, Sheets, TSV | Có crawl tự động | Miễn phí 500 trang/tháng; trả phí từ $19.99/tháng |
| Simplescraper | Dễ-trung bình (dựa trên selector) | Ổn cho trích xuất nhẹ | Có deep scraping nhưng không phải một cú nhấp | Có (hỗ trợ cuộn vô hạn) | Xoay proxy và thân thiện với login | CSV, JSON, Sheets, Airtable, webhook | Có | Miễn phí 100 credit; có gói trả phí |
| Octoparse | Khó hơn (ứng dụng desktop) | Rất mạnh khi cấu hình đúng | Có, qua workflow hoặc template | Có (AJAX, cuộn vô hạn) | Mạnh nhất về anti-bot (xoay IP, CAPTCHA) | CSV, Excel, JSON, HTML, XML, DB, Sheets | Có ở gói Standard trở lên | Miễn phí; Basic $39/tháng; cloud từ khoảng $83/tháng |
| Bardeen | Trung bình (trình dựng playbook) | Tốt khi gắn với automation | Có thể trong logic workflow, nhưng không ưu tiên Shopify | Có thể | Chạy trong browser, anti-bot không phải trọng tâm | CSV, Sheets, Airtable, Notion | Có qua automation | Miễn phí 100 credit; Basic $10/tháng; Premium $50/tháng |
| Listly | Rất dễ (nhận diện danh sách bằng 1 click) | Tốt nhất cho các dòng danh sách nhìn thấy được | Không | Hạn chế trong cấu trúc danh sách được phát hiện | Tối thiểu | Excel, Sheets, CSV/JSON API ở gói Business | Có ở gói Business | Miễn phí 10 URL/tháng; Light $30/tháng; Business $90/tháng |
Kết luận nhanh theo ưu tiên
Nếu bạn cần dữ liệu sản phẩm Shopify sâu nhất với thiết lập tối thiểu, Thunderbit với AI + làm giàu trang con là bộ đôi mạnh nhất. Nếu bạn cần xuất nhanh, miễn phí, không lằng nhằng, Instant Data Scraper hoạt động tốt với các trang đơn giản. Nếu bạn muốn toàn quyền kiểm soát và không ngại tự xây recipe, Web Scraper hoặc Octoparse là những lựa chọn mạnh. Còn nếu mục tiêu thực sự là scrape → tự động hóa → đẩy vào CRM, Bardeen là nền tảng workflow đáng xem.
Scrape trang danh sách chỉ là một nửa công việc: quy trình làm giàu trang con
Đây là phần tôi ước mọi bài viết về Shopify scraper khác đều có — vì đây là khoảng trống lớn nhất trong nội dung đối thủ, và cũng là nỗi bực mình số 1 mà tôi nghe từ người dùng ecommerce.
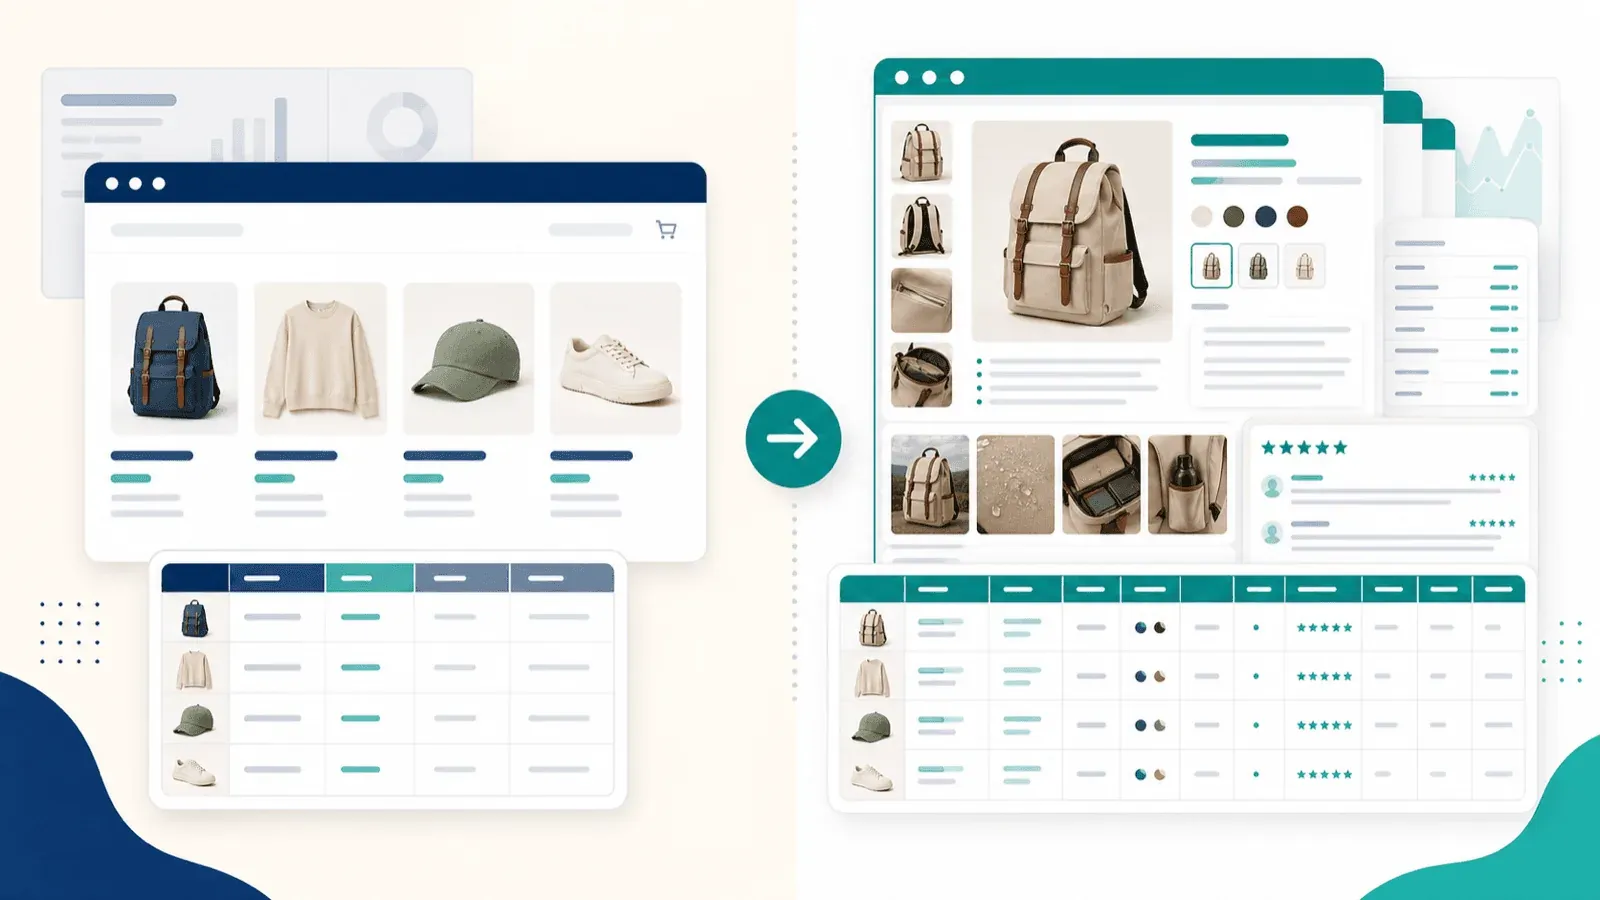
Khi bạn scrape trang collection Shopify (trang danh sách), bạn chỉ nhận được dữ liệu bề mặt: tên, giá, ảnh thumbnail, có thể là mô tả bị cắt ngắn. Nhưng những trường dữ liệu bạn thực sự cần cho phân tích đối thủ, nhập catalog, hoặc nghiên cứu dropshipping lại nằm trên từng trang chi tiết sản phẩm.
Bạn nhận được gì từ trang danh sách so với sau khi làm giàu trang con
| Trường dữ liệu | Chỉ từ trang danh sách | Sau khi làm giàu trang con |
|---|---|---|
| Tên sản phẩm | ✅ | ✅ |
| Giá | ✅ | ✅ |
| Ảnh thumbnail | ✅ | ✅ + toàn bộ ảnh gallery |
| Mô tả ngắn | ⚠️ Bị cắt ngắn | ✅ Mô tả HTML đầy đủ |
| Biến thể (size, màu) | ❌ | ✅ |
| SKU / Tồn kho | ❌ | ✅ |
| Đánh giá / xếp hạng | ❌ | ✅ |
Đó là một khác biệt rất lớn.
Một file export chỉ lấy trang danh sách sẽ cho bạn một bảng tính nông. Một file export đã làm giàu từ trang con sẽ cho bạn bộ dữ liệu nghiên cứu đối thủ thực sự dùng được.
Cách scrape trang con hoạt động trong Thunderbit (từng bước)
- Mở trang collection/danh sách của cửa hàng Shopify
- Bấm "One Click Extract" — Thunderbit đọc trang và tự xác định các cột (tên, giá, hình ảnh, link, v.v.)
- Bấm "Scrape" để lấy dữ liệu từ trang danh sách
- Bấm "Scrape Subpages" — AI sẽ truy cập từng URL sản phẩm và nối dữ liệu từ trang chi tiết (mô tả đầy đủ, toàn bộ ảnh, biến thể, đánh giá) vào bảng gốc
- Xuất bảng dữ liệu đã được làm giàu sang Excel, Google Sheets, Airtable, Notion hoặc CSV
Toàn bộ quy trình chỉ mất vài phút với một collection thông thường, và bạn sẽ có một bộ dữ liệu mà nếu làm thủ công có thể tốn hàng giờ.
Dùng thử Thunderbit để scrape trang con Vượt qua trang collection: Thunderbit sẽ ghé từng trang sản phẩm và thêm các trường dữ liệu sâu hơn vào bảng của bạn. Get Started Free
Những công cụ nào khác hỗ trợ làm giàu trang con?
- Web Scraper: Có, nhưng phải cấu hình sitemap thủ công với selector link và child sitemap — mỗi store thường mất 15-20 phút thiết lập
- Octoparse: Có, qua workflow builder hoặc template — mạnh nhưng setup nặng hơn
- Data Miner: Có, thông qua workflow crawl nhiều bước — không phải thao tác một cú nhấp
- Simplescraper: Có khái niệm deep scraping, nhưng ít kiểu "cắm là chạy"
- Instant Data Scraper, Listly, Bardeen: Không có tài liệu nào cho thấy làm giàu trang con một cú nhấp cho Shopify
Sự khác biệt giữa "về mặt kỹ thuật có thể theo link với 20 phút cấu hình thủ công" và "làm giàu bằng một cú nhấp" chính là khác biệt giữa công cụ dành cho kỹ sư scraper và công cụ dành cho người vận hành ecommerce.
Khi products.json của Shopify không hoạt động — và vì sao Chrome extension là phương án dự phòng
Nếu bạn từng đọc các hướng dẫn scrape Shopify khác, hẳn bạn đã thấy mẹo /products.json: chỉ cần thêm /products.json vào URL cửa hàng Shopify là bạn sẽ nhận được dữ liệu sản phẩm có cấu trúc ở dạng JSON. Đây là một endpoint có thật, và khi nó hoạt động thì rất tiện.
products.json hoạt động như thế nào
Các cửa hàng Shopify cung cấp một JSON API endpoint tại /products.json trả về dữ liệu sản phẩm có cấu trúc. Bạn có thể phân trang bằng ?page=2&limit=250 (tối đa 250 sản phẩm mỗi trang).
Các trường thường trả về gồm: title, body_html, vendor, product_type, tags, published_at, variants (kèm price, compare_at_price, sku, available), và images.
products.json còn thiếu gì
- Không có dữ liệu đánh giá hoặc số lượng rating
- Định dạng mô tả hạn chế hơn so với trang render thật
- Các metafield tùy chỉnh thường không được bao gồm
- Ảnh ở cấp biến thể có thể không nhất quán
- Không có nội dung merchandising đã render, badge hay social proof
Khi products.json bị vô hiệu hóa
Tôi đã chạy kiểm tra HTTP trực tiếp trên 8 storefront Shopify thật vào ngày 27/4/2026. Kết quả khá rõ ràng:
| Cửa hàng | Kết quả |
|---|---|
| kith.com | ✅ Hoạt động — JSON sạch |
| colourpop.com | ✅ Hoạt động |
| allbirds.com | ✅ Hoạt động |
| brooklinen.com | ✅ Hoạt động |
| negativeunderwear.com | ✅ Hoạt động |
| gymshark.com | ❌ Bị chặn — trả về HTML 403 thay vì JSON |
| mvmt.com | ⚠️ Bị vô hiệu hóa một phần — trang HTML 200, không phải JSON |
| fashionnova.com | ❌ Bị vô hiệu hóa — 404 |
Năm trong tám cửa hàng trả về JSON sạch. Ba cửa hàng thì không.
Người dùng trên các diễn đàn cũng báo cáo điều tương tự: "Không hiểu sao, một số cửa hàng Shopify chọn không công khai products.json." Các store có mật khẩu, store dùng cấu hình API riêng, và tên miền bị Cloudflare bảo vệ đều có thể phá vỡ cách làm này.
Phương án dự phòng bằng Chrome extension
Khi products.json không có sẵn, scraper dạng Chrome extension sẽ lấy dữ liệu trực tiếp từ trang đã render (DOM). Đây là giá trị cốt lõi của các scraper chạy trên trình duyệt: chúng nhìn và trích xuất những gì bạn nhìn thấy trong trình duyệt, bất kể API có tồn tại hay không. Điều đó khiến Chrome extension trở thành phương án B đáng tin cậy — và thường là phương án A khi bạn cần dữ liệu đã render như đánh giá, nội dung merchandising, hay toàn bộ gallery ảnh.
Bảo vệ anti-bot: thực tế xảy ra gì khi bạn scrape cửa hàng Shopify
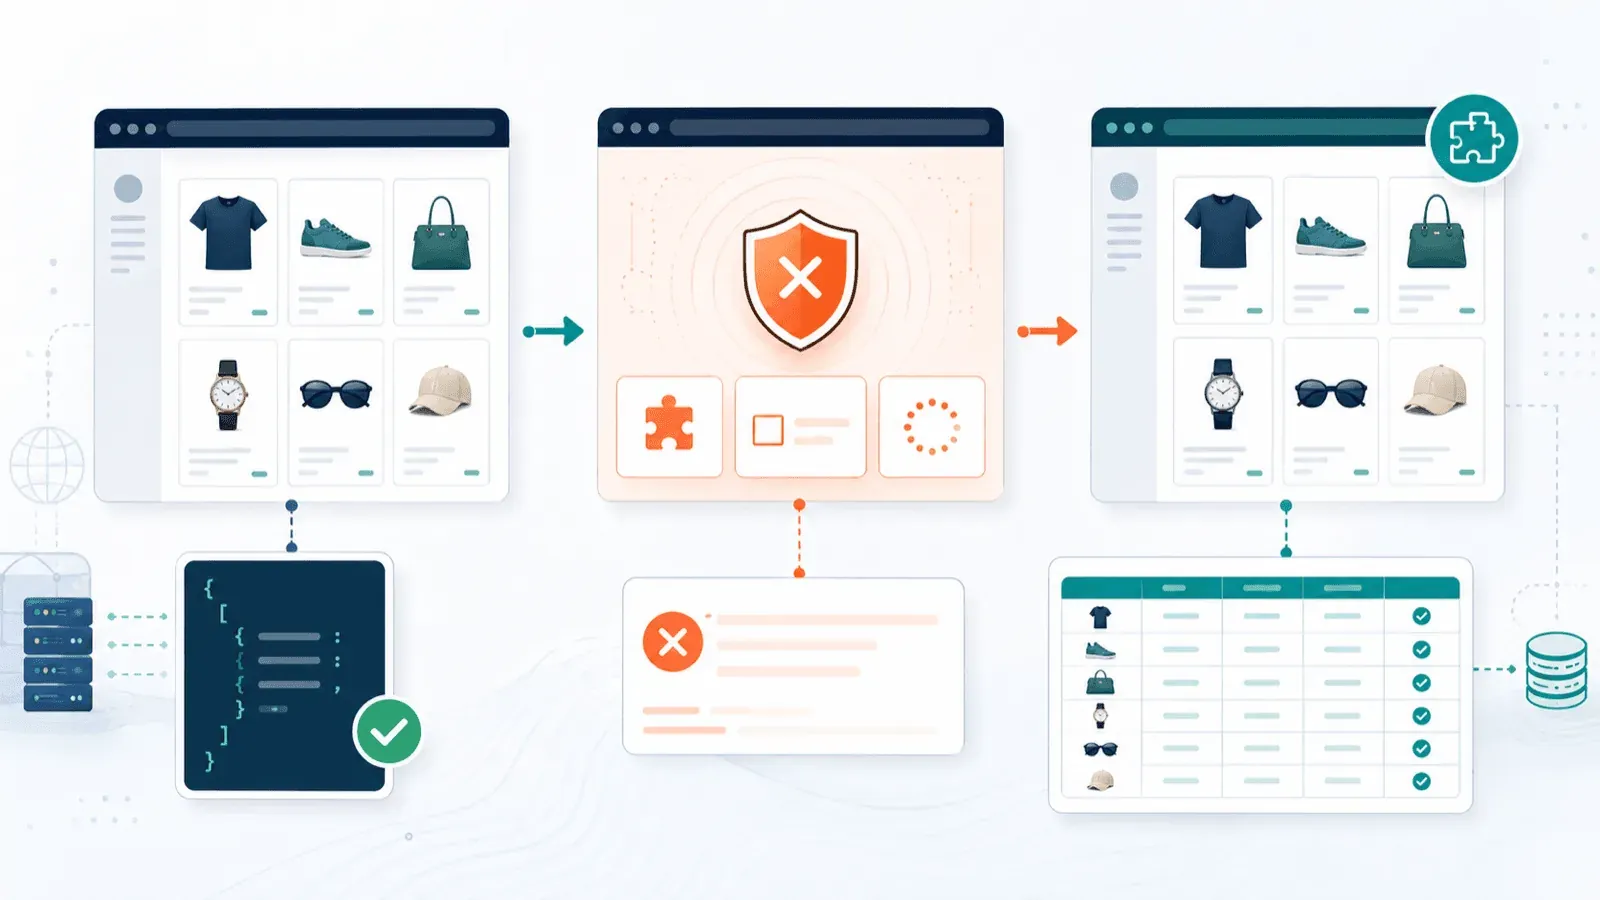
Phần lớn bài viết về Shopify scraper giả định mọi cửa hàng đều mở toang. Thực tế không phải vậy. Store Leads báo cáo rằng 99,2% cửa hàng Shopify dùng hạ tầng Cloudflare. Điều đó không có nghĩa là mọi cửa hàng đều chặn scraper mạnh tay, nhưng cho thấy hạ tầng để chặn là ở khắp nơi.
Trong thực tế, mức độ sẽ nằm trên một phổ như sau:
Dễ scrape
- Cửa hàng công khai, không có Cloudflare bảo vệ quá gắt
- Cửa hàng bật products.json
- Cửa hàng dùng theme Shopify tiêu chuẩn (cấu trúc DOM nhất quán)
Khó scrape hơn
- Cửa hàng được Cloudflare bảo vệ (CAPTCHA, Turnstile)
- Cửa hàng yêu cầu đăng nhập hoặc có mật khẩu
- Shopify Plus dùng lớp bảo mật tùy chỉnh
- Cửa hàng áp dụng giới hạn tốc độ nghiêm ngặt
Mỗi công cụ xử lý tình huống anti-bot ra sao
| Tình huống | Cách tiếp cận tốt nhất | Công cụ xử lý được |
|---|---|---|
| Cửa hàng công khai, không anti-bot | Cloud scraping (nhanh) | Thunderbit (chế độ cloud), Instant Data Scraper, đa số công cụ khác |
| Cửa hàng bị Cloudflare bảo vệ | Scrape bằng browser (dùng session của bạn) | Thunderbit (chế độ browser), Web Scraper, Octoparse |
| Cửa hàng cần đăng nhập / riêng tư | Scrape bằng browser với session đã đăng nhập | Thunderbit (chế độ browser), Web Scraper, Simplescraper |
| products.json bị tắt | Trích xuất từ DOM của trang đã render | Tất cả Chrome extension (đây là điểm mạnh của chúng) |
Hai chế độ cloud/browser của Thunderbit thực sự rất quan trọng ở đây. Chế độ cloud nhanh cho scraping hàng loạt trên các cửa hàng công khai. Chế độ browser dùng chính phiên Chrome thật của bạn khi lớp chống bot yêu cầu như vậy. Sự linh hoạt này đã cứu tôi trên gymshark.com, nơi request cloud bị chặn nhưng chế độ browser vẫn chạy ổn.
Scrape Shopify theo lịch: theo dõi giá và tồn kho theo thời gian
Scrape một lần thì hữu ích. Nhưng đội vận hành ecommerce thường cần thông tin đối thủ liên tục — không chỉ một ảnh chụp tại một thời điểm. Thay đổi giá, biến động tồn kho, sản phẩm mới ra mắt: mọi thứ diễn ra liên tục. Một người dùng trong diễn đàn nói rất đúng: "Sẽ hữu ích hơn nếu thấy mức tồn kho hiện tại và các ảnh chụp cho thấy mức đó đang giảm dần."
Thế nhưng gần như không có bài viết đối thủ nào nhắc đến việc scrape theo lịch hoặc lặp lại. Đây là một khoảng trống rất rõ.
Cách monitoring Shopify theo lịch hoạt động
- Thiết lập scrape định kỳ cho collection hoặc trang sản phẩm của đối thủ
- Dữ liệu được xuất sang Google Sheets (hoặc Airtable) sau mỗi lần chạy, tạo thành chuỗi thời gian của giá và tồn kho
- Dùng dữ liệu để theo dõi: giảm/tăng giá, hết hàng, thêm sản phẩm mới, mô hình theo mùa
Thiết lập scrape theo lịch với Thunderbit
Thunderbit làm chuyện này cực kỳ đơn giản.
Bạn chỉ cần mô tả lịch bằng ngôn ngữ tự nhiên (ví dụ: "mỗi thứ Hai lúc 9 giờ sáng"), nhập URL cửa hàng Shopify, rồi bấm "Schedule." Thunderbit sẽ tự chạy scrape và xuất dữ liệu đến nơi bạn chọn. Không cần cron job, không cần code, không cần bộ lập lịch bên thứ ba.
Hỗ trợ lên lịch của cả 8 công cụ
| Công cụ | Có lên lịch không? |
|---|---|
| Thunderbit | Có — lên lịch bằng ngôn ngữ tự nhiên |
| Instant Data Scraper | Không |
| Web Scraper | Có — ở gói cloud |
| Data Miner | Có crawl tự động, nhưng không phải cách lên lịch đơn giản nhất |
| Simplescraper | Có |
| Octoparse | Có — ở gói Standard trở lên |
| Bardeen | Có — qua tự động hóa theo thời gian/ngày |
| Listly | Có — ở gói Business |
Nếu theo dõi đối thủ liên tục là một phần trong workflow của bạn, đây là điểm khác biệt cực kỳ quan trọng. Hầu hết tiện ích Chrome miễn phí đều không có tính năng này.
Tiện ích Chrome Shopify scraper nào phù hợp với nhu cầu của bạn?
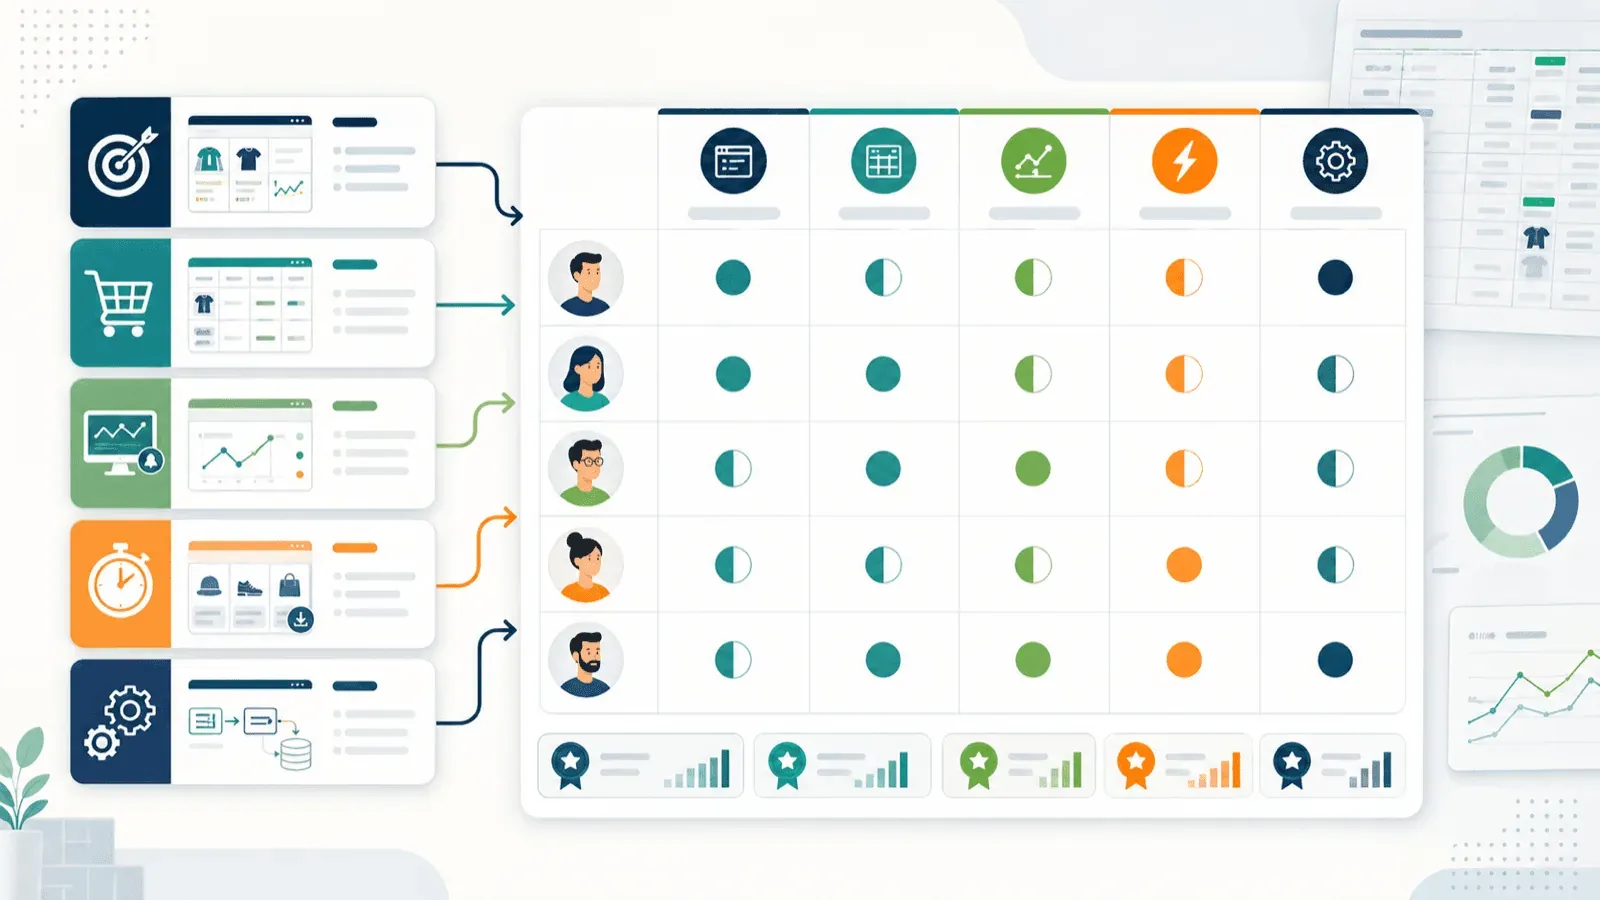
Thay vì kết luận chung chung kiểu "hãy chọn cái bạn thích", dưới đây là ma trận quyết định gắn với từng trường hợp sử dụng cụ thể:
| Trường hợp sử dụng | Khuyến nghị tốt nhất | Lý do |
|---|---|---|
| Nghiên cứu giá đối thủ | Thunderbit | Trang danh sách + làm giàu trang con + lên lịch = quy trình giá hoàn chỉnh |
| Xuất dữ liệu nhanh, một lần | Instant Data Scraper | Con đường miễn phí nhanh nhất khi bạn chỉ cần dữ liệu danh sách hiển thị |
| Nhập catalog vào Shopify của bạn | Thunderbit | Dữ liệu đầy đủ từ trang con + xuất CSV/Excel thân thiện với Shopify import |
| Theo dõi giá/tồn kho liên tục | Thunderbit hoặc Octoparse | Lên lịch no-code dễ nhất so với khả năng enterprise mạnh nhất |
| Tạo lead (thông tin liên hệ chủ store) | Thunderbit | Tích hợp sẵn bộ trích xuất email/số điện thoại + xuất dữ liệu có cấu trúc |
| Tự động hóa nhiều bước phức tạp | Bardeen | Scrape, làm giàu và đẩy vào app phía sau trong một workflow |
| Người dùng kỹ thuật muốn toàn quyền kiểm soát | Web Scraper hoặc Octoparse | Kiểm soát tốt nhất đối với selector, luồng và logic trích xuất |
Kết luận
Scraping Shopify năm 2026 không còn là câu hỏi liệu bạn có lấy được dữ liệu sản phẩm hay không — mà là bạn có thể làm sâu đến đâu, nhanh đến đâu, và workflow đó có lặp lại được hay không. Phần lớn bài viết trong lĩnh vực này chỉ dừng ở trang danh sách. Giá trị thực nằm ở làm giàu trang con, theo dõi theo lịch, và xử lý những tình huống anti-bot mà các cửa hàng Shopify thật sự ném vào bạn.
Nếu bạn muốn xem điều đó trong thực tế — từ trang collection đến bộ dữ liệu đã làm giàu đầy đủ chỉ với vài cú nhấp — hãy thử Thunderbit. Và nếu Thunderbit không phải lựa chọn hoàn hảo, Instant Data Scraper là điểm khởi đầu miễn phí khá ổn cho các tác vụ đơn giản, còn Web Scraper và Octoparse là lựa chọn mạnh cho người dùng kỹ thuật muốn kiểm soát nhiều hơn.
Chúc bạn scrape hiệu quả — và mong dữ liệu sản phẩm của bạn luôn đầy đủ, có cấu trúc, và giàu biến thể.
Dùng thử Thunderbit để scrape Shopify Get Started Free
Câu hỏi thường gặp
1. Scrape dữ liệu từ cửa hàng Shopify có hợp pháp không?
Dữ liệu sản phẩm công khai trên các cửa hàng Shopify thường có thể được truy cập bởi bất kỳ ai vào website. Tuy nhiên, tính hợp pháp còn phụ thuộc vào khu vực pháp lý của bạn, Điều khoản dịch vụ của cửa hàng và cách bạn sử dụng dữ liệu. Việc scrape giá công khai để phân tích cạnh tranh là thực hành khá phổ biến; còn sao chép nguyên văn nội dung để tái xuất bản thì rủi ro cao hơn. Đây không phải là tư vấn pháp lý — hãy tham khảo chuyên gia cho tình huống cụ thể của bạn.
2. Tôi có thể scrape các cửa hàng Shopify yêu cầu đăng nhập hoặc mật khẩu không?
Có, nhưng bạn sẽ cần scraper dựa trên browser dùng session Chrome đã đăng nhập của bạn. Cloud scraper thường không truy cập được các trang bị khóa đăng nhập. Chế độ browser của Thunderbit, Web Scraper (local), và workflow đăng nhập của Simplescraper đều hỗ trợ tình huống này.
3. Tôi có thể scrape bao nhiêu sản phẩm từ một cửa hàng Shopify cùng lúc?
Điều này phụ thuộc vào công cụ và gói bạn dùng. Endpoint products.json của Shopify phân trang ở mức 250 sản phẩm mỗi trang. Chế độ cloud của Thunderbit xử lý tối đa 50 trang cùng lúc. Các gói miễn phí của đa số công cụ đều giới hạn theo trang, dòng hoặc credit — nên hãy kiểm tra giới hạn gói trước khi bắt đầu một công việc lớn.
4. Khác nhau giữa cloud scraping và browser scraping trên Shopify là gì?
Cloud scraping chạy trên máy chủ từ xa — nhanh hơn và phù hợp hơn với các store công khai không có lớp chống bot. Browser scraping dùng session Chrome cục bộ của bạn, nên có thể xử lý các store được Cloudflare bảo vệ, yêu cầu đăng nhập, hoặc nhạy với khu vực. Thunderbit có cả hai chế độ, và việc chọn chế độ nào thường phụ thuộc vào việc store có chặn request từ xa hay không.
5. Tôi có thể xuất dữ liệu Shopify đã scrape thẳng sang Google Sheets hoặc Airtable không?
Có, nhưng không phải công cụ nào cũng hỗ trợ. Thunderbit xuất sang Google Sheets, Airtable, Notion, Excel, CSV và JSON — tất cả đều miễn phí. Data Miner và Listly hỗ trợ Google Sheets. Simplescraper hỗ trợ Sheets và Airtable. Octoparse hỗ trợ Google Sheets ở các gói cao hơn. Bardeen tích hợp với Sheets, Airtable và Notion. Instant Data Scraper chỉ xuất CSV và XLSX, không tích hợp trực tiếp với Sheets.
Tìm hiểu thêm




