
Internet đang phát triển nhanh hơn cả tốc độ tôi nghiện cà phê – mà nói thật, điều đó đã nói lên rất nhiều điều rồi. Đến năm 2026, việc trích xuất dữ liệu web không chỉ là một kỹ năng đặc biệt dành cho những người mê dữ liệu nữa; nó sẽ trở thành xương sống của kinh doanh thông minh, đào tạo AI và tự động hóa. Dù bạn đang theo dõi xu hướng thị trường, cung cấp dữ liệu cho các mô hình ngôn ngữ lớn (LLM) thế hệ tiếp theo, hay chỉ đơn giản là cố gắng theo dõi giá cả của đối thủ cạnh tranh, nhu cầu về dữ liệu web có cấu trúc, thời gian thực chưa bao giờ cao đến thế. Và cốt lõi của cơn sốt vàng dữ liệu này? Chính là Python. Với hệ sinh thái khổng lồ và cú pháp dễ tiếp cận, Python vẫn là ngôn ngữ hàng đầu cho việc web scraping, cung cấp sức mạnh cho mọi thứ từ các script dùng một lần nhanh chóng đến các trình thu thập dữ liệu quy mô công nghiệp.
Nhưng đây mới là điều quan trọng: việc chọn đúng gói web scraping Python có thể quyết định sự thành bại của dự án của bạn. Tôi đã chứng kiến các nhóm lãng phí cả ngày trời để vật lộn với các bức tường chống bot bằng công cụ sai, hoặc đốt hàng giờ để phân tích HTML lộn xộn trong khi một thư viện thông minh hơn có thể hoàn thành công việc chỉ trong vài phút. Vì vậy, với tư cách là một người đã dành nhiều năm trong lĩnh vực SaaS, tự động hóa và AI (và đã xây dựng Thunderbit để giúp mọi người dễ dàng scraping hơn), tôi đã tổng hợp 12 gói web scraping Python tốt nhất cho năm 2026—mỗi gói đều có những điểm mạnh, đặc điểm riêng và trường hợp sử dụng lý tưởng. Hãy cùng tìm hiểu và tìm ra lựa chọn hoàn hảo cho cuộc phiêu lưu dữ liệu tiếp theo của bạn nhé.
Tại sao các gói web scraping Python phù hợp lại quan trọng
Scrape dữ liệu từ bất kỳ trang web nào bằng AI Get Started Free
Thực tế mà nói: không phải tất cả các dự án web scraping đều giống nhau. Đôi khi bạn chỉ cần lấy một vài giá sản phẩm từ một trang tĩnh. Những lúc khác, bạn lại phải vật lộn với một trang web nặng JavaScript khó chịu hơn cả một con mèo khi tắm. Gói phù hợp có thể giúp bạn tiết kiệm hàng giờ (hoặc thậm chí hàng ngày), giảm lỗi và giúp bạn tránh các cạm bẫy phổ biến như bị chặn bot hoặc HTML bị hỏng.
Sự phổ biến của Python trong web scraping không chỉ là lời đồn thổi. Các thư viện như requests và urllib3 có hơn 1 tỷ lượt tải xuống mỗi tháng, và hầu như mọi công cụ scraping lớn đều ưu tiên Python. Nhưng với sức mạnh lớn đi kèm với trách nhiệm lớn: chọn sai công cụ, và bạn có thể thấy mình bị mắc kẹt trong một dự án chậm hơn cả internet quay số. Chọn đúng, và bạn sẽ có được dữ liệu sạch, có cấu trúc trước khi cà phê của bạn nguội.
Cách chúng tôi chọn các gói web scraping Python tốt nhất
Tôi không chỉ ném phi tiêu vào biểu đồ PyPI đâu nhé. Đây là cách tôi đánh giá từng gói:
- Hiệu suất & Đồng thời: Nó có thể lấy hàng trăm (hoặc hàng nghìn) trang một cách nhanh chóng không?
- Dễ sử dụng: Nó có thân thiện với người mới bắt đầu không, hay nó đòi hỏi bằng tiến sĩ khoa học máy tính?
- Sức mạnh phân tích HTML: Nó có xử lý được mã đánh dấu bị hỏng, hỗ trợ bộ chọn XPath/CSS và giúp việc trích xuất dữ liệu dễ dàng không?
- Hỗ trợ nội dung động: Nó có thể xử lý các trang web nặng JavaScript không, hay nó chỉ dành cho các trang tĩnh?
- Cộng đồng & Tài liệu: Có một cộng đồng người dùng phát triển mạnh và tài liệu vững chắc không, hay bạn sẽ bị mắc kẹt trong địa ngục Stack Overflow?
- Trường hợp sử dụng tốt nhất: Nó dành cho các script nhanh, trình thu thập dữ liệu quy mô lớn, hay một cái gì đó ở giữa?
Tôi cũng đã xem xét phản hồi của nhà phát triển trong thế giới thực, các điểm chuẩn gần đây và những trải nghiệm (đôi khi đau đớn) của riêng tôi trong lĩnh vực này. Giờ thì, hãy cùng gặp gỡ các ứng cử viên nhé.
1. Thunderbit
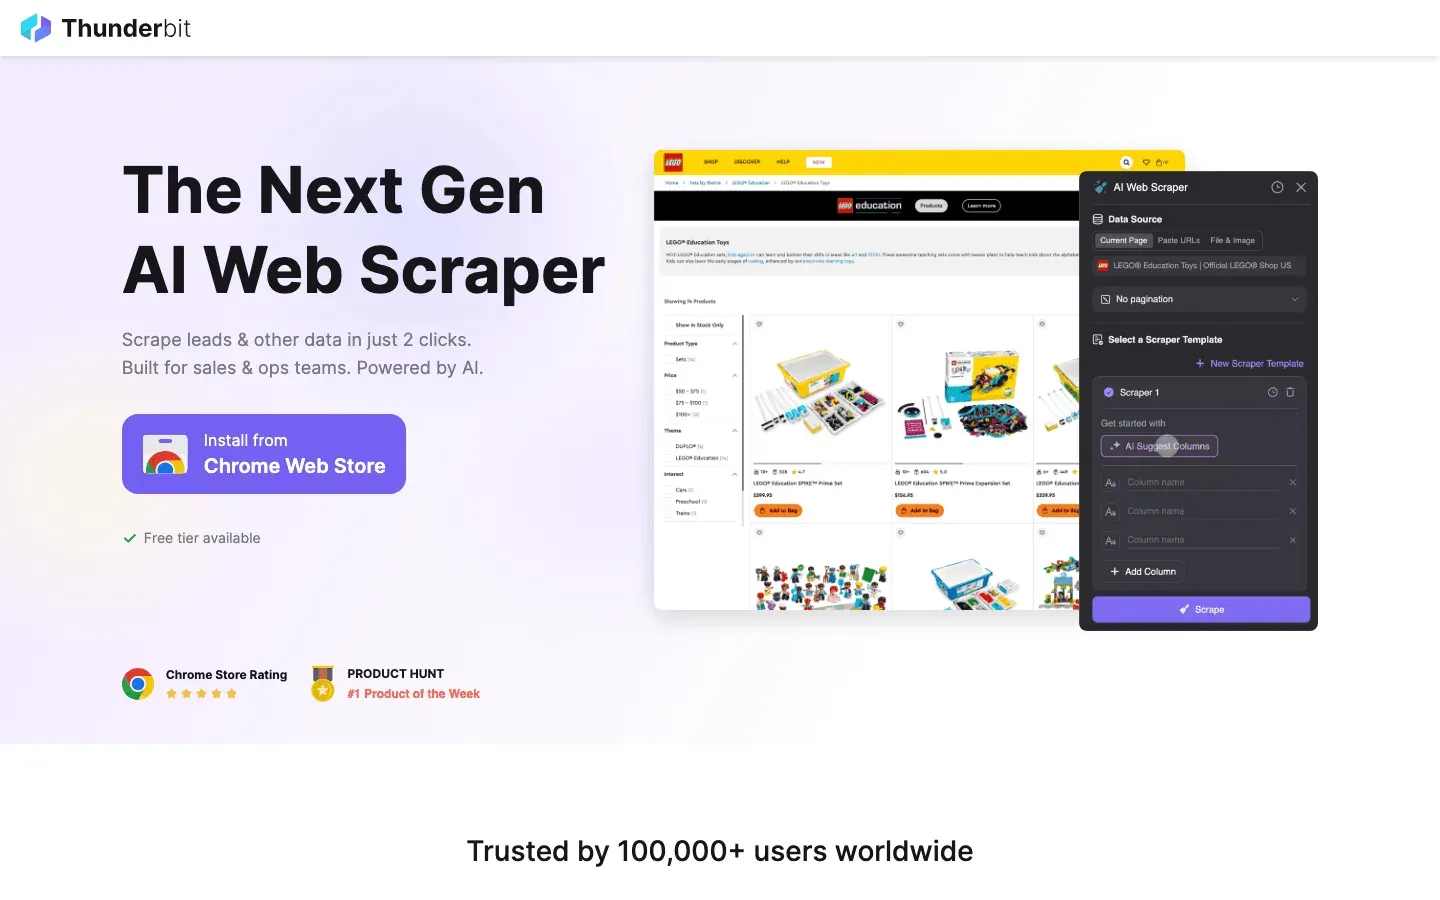 Thunderbit không phải là thư viện Python điển hình của bạn đâu—nó là một tiện ích mở rộng Chrome được hỗ trợ bởi AI đang thay đổi cuộc chơi cho web scraping, đặc biệt đối với các nhà phát triển Python muốn tốc độ, độ chính xác và một chút phép thuật AI. Điều gì làm cho Thunderbit nổi bật? Nó cho phép bạn sử dụng hướng dẫn ngôn ngữ tự nhiên để cho AI biết bạn muốn dữ liệu nào, và sau đó nó xử lý mọi thứ: gợi ý trường, điều hướng trang con, phân trang, và thậm chí xuất ra Excel, Google Sheets, Notion, hoặc Airtable.
Thunderbit là một cứu cánh cho việc scraping dữ liệu phức tạp, không có cấu trúc—hãy nghĩ đến các thư mục lộn xộn, danh sách sản phẩm, hoặc các trang web mà HTML giống như “nghệ thuật trừu tượng” hơn là “tài liệu có cấu trúc”. Tính năng AI Suggest Fields của nó đọc trang và đề xuất các cột tốt nhất, trong khi Subpage Scraping cho phép bạn làm phong phú tập dữ liệu của mình bằng cách tự động truy cập các trang chi tiết được liên kết. Và nếu bạn mệt mỏi với những rắc rối chống bot, các tùy chọn scraping dựa trên trình duyệt và đám mây của Thunderbit sẽ giúp bạn.
Các nhà phát triển Python yêu thích Thunderbit để tạo mẫu nhanh, tạo khách hàng tiềm năng và nghiên cứu thị trường. Bạn có thể sử dụng đầu ra của nó trực tiếp trong quy trình dữ liệu Python của mình, hoặc thậm chí tự động hóa các quy trình scraping bằng API của nó. Nó không phải là một thư viện mã truyền thống, nhưng nó nhanh chóng trở thành một lựa chọn yêu thích cho bất kỳ ai muốn dành ít thời gian viết mã hơn và nhiều thời gian phân tích dữ liệu hơn.
Các tính năng chính:
- Gợi ý trường và trích xuất dữ liệu được hỗ trợ bởi AI
- Xử lý các trang con, phân trang, và thậm chí cả PDF/hình ảnh
- Xuất ra CSV, Excel, Google Sheets, Notion, Airtable
- Không yêu cầu viết mã—hoàn hảo cho cả người dùng không chuyên về kỹ thuật và các chuyên gia Python muốn di chuyển nhanh
- Có gói miễn phí; các gói trả phí mở rộng theo nhu cầu của bạn
Tốt nhất cho: Tạo khách hàng tiềm năng, nghiên cứu thị trường, tạo mẫu nhanh, và scraping dữ liệu web phức tạp hoặc lộn xộn.
Thử Thunderbit AI Web Scraper miễn phí
2. Beautiful Soup
 Beautiful Soup là công cụ phân tích HTML gốc trong Python. Nếu bạn mới bắt đầu, hoặc cần trích xuất dữ liệu từ các trang web tĩnh, đây là người bạn tốt nhất của bạn. Beautiful Soup xuất sắc trong việc điều hướng và phân tích HTML có cấu trúc kém (“tag soup”), khiến nó trở thành một cứu cánh cho việc scraping các trang web không tuân thủ các quy tắc.
API thân thiện với người mới bắt đầu—hãy nghĩ đến .find(), .select(), và .text—và nó kết hợp hoàn hảo với requests để lấy các trang web. Bên dưới, bạn có thể chọn các trình phân tích khác nhau (như lxml để tăng tốc độ hoặc html5lib để tương thích tối đa). Tài liệu rất tuyệt vời, và cộng đồng rất lớn.
Các tính năng chính:
- API trực quan, Pythonic để điều hướng HTML/XML
- Xử lý mã đánh dấu bị hỏng hoặc không nhất quán một cách duyên dáng
- Hoạt động với nhiều trình phân tích để tăng tốc độ hoặc tương thích
- Cộng đồng lớn và vô số hướng dẫn
Tốt nhất cho: Các script nhanh, scraping trang tĩnh và người mới bắt đầu muốn có một đường cong học tập nhẹ nhàng.
Tìm hiểu thêm về Beautiful Soup
3. Scrapy
 Scrapy là nhà vô địch hạng nặng cho việc thu thập dữ liệu web tự động, quy mô lớn. Nếu bạn cần scraping hàng trăm hoặc hàng nghìn trang, quản lý các pipeline, hoặc lên lịch các công việc định kỳ, Scrapy là framework mà hầu hết các nhóm đều lựa chọn. Nó vẫn chạy trên một Twisted reactor bên dưới, nhưng kể từ bản phát hành 2.14, một phần lớn các nội bộ bất đồng bộ của nó đã được viết lại thành các coroutine
asyncio gốc, và hiện có các điểm vào AsyncCrawlerProcess / AsyncCrawlerRunner hoạt động tốt với phần còn lại của hệ sinh thái bất đồng bộ Python hiện đại. Nó nhanh, hỗ trợ thu thập dữ liệu đồng thời, các pipeline mục để làm sạch dữ liệu và xuất ra JSON, CSV hoặc cơ sở dữ liệu.
Scrapy có thể mở rộng, với các plugin cho proxy, bộ nhớ đệm và thậm chí cả kết xuất JavaScript hạn chế (thông qua tích hợp Splash hoặc Selenium). Đường cong học tập dốc hơn Beautiful Soup, nhưng nếu bạn nghiêm túc về dữ liệu web ở quy mô lớn, Scrapy là thứ bạn sẽ phát triển cùng.
Các tính năng chính:
- Thu thập dữ liệu bất đồng bộ thông qua Twisted reactor + các coroutine
asynciogốc (Scrapy 2.14+, Python 3.10+) - Các pipeline tích hợp để làm sạch và lưu trữ dữ liệu
- Xuất ra nhiều định dạng (JSON, CSV, DB)
- Cộng đồng lớn, năng động và hệ sinh thái plugin
Tốt nhất cho: Các dự án scraping quy mô lớn, định kỳ, các pipeline dữ liệu và bất kỳ ai cần tốc độ và độ tin cậy.
4. Selenium
 Selenium là công cụ hàng đầu để scraping các trang web nặng JavaScript hoặc tương tác. Nó tự động hóa các trình duyệt thực (Chrome, Firefox, v.v.), cho phép bạn mô phỏng các hành động của người dùng như nhấp chuột, cuộn và gửi biểu mẫu. Nếu dữ liệu bạn cần chỉ xuất hiện sau khi JavaScript chạy, Selenium có thể lấy được nó—bất kể trang web khó chịu đến mức nào.
Sự đánh đổi? Selenium chậm và tốn tài nguyên. Bạn đang chạy một trình duyệt đầy đủ cho mỗi lần scraping, vì vậy đừng mong đợi xử lý hàng nghìn trang mỗi phút. Nhưng đối với những trường hợp “không có công cụ nào khác có thể làm được”, Selenium là một cứu cánh.
Các tính năng chính:
- Tự động hóa trình duyệt đầy đủ (hỗ trợ Chrome, Firefox, Edge, v.v.)
- Xử lý nội dung được kết xuất bằng JavaScript và các yếu tố tương tác
- Hỗ trợ chế độ headless để scraping nhanh hơn, không có giao diện người dùng
- Cộng đồng lớn và tài liệu phong phú
Tốt nhất cho: Scraping các trang web động, nặng JavaScript, tự động hóa luồng đăng nhập và xử lý CAPTCHA hoặc các tương tác người dùng phức tạp.
Đọc thêm về điểm mạnh và điểm yếu của Selenium
5. PyQuery
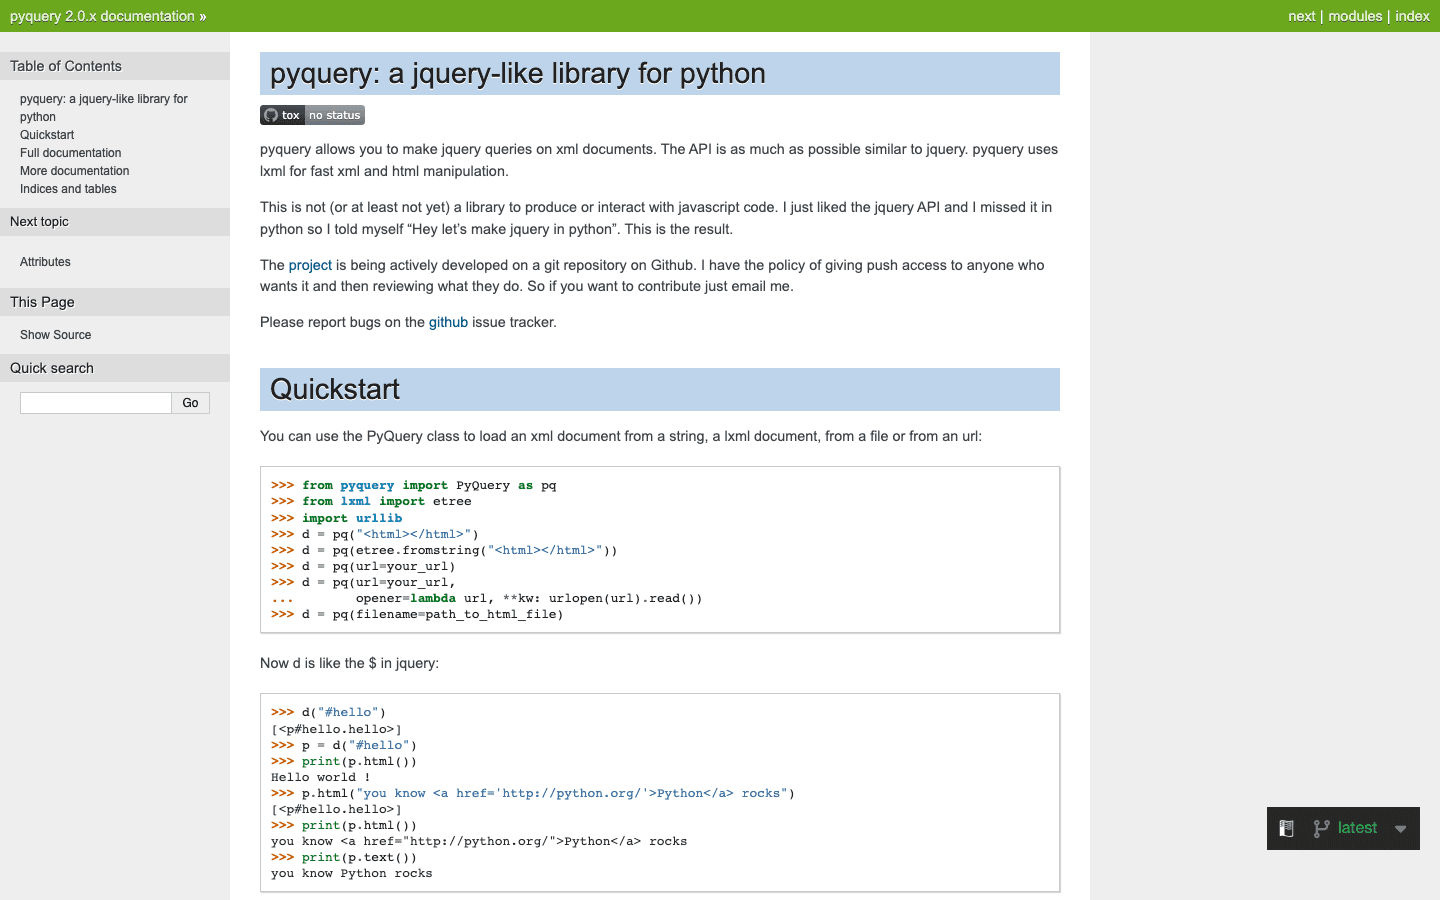 PyQuery mang cú pháp kiểu jQuery vào Python, làm cho việc phân tích HTML trở nên quen thuộc với bất kỳ ai đã làm việc với jQuery trong JavaScript. Nó bao bọc trình phân tích
lxml nhanh và cho phép bạn sử dụng các bộ chọn CSS như $('div.classname') để tìm các phần tử.
PyQuery rất tốt cho việc tạo mẫu nhanh và cho các nhà phát triển muốn mã ngắn gọn, dễ đọc. Nó nhanh hơn Beautiful Soup cho các truy vấn phức tạp và tích hợp dễ dàng với các công cụ bất đồng bộ hoặc Selenium cho các quy trình làm việc nâng cao hơn.
Các tính năng chính:
- Bộ chọn và cú pháp giống jQuery trong Python
- Phân tích nhanh với backend lxml
- Tuyệt vời cho các nhà phát triển chuyển từ JavaScript
- Hỗ trợ chuỗi và các truy vấn ngắn gọn
Tốt nhất cho: Tạo mẫu, người hâm mộ jQuery và bất kỳ ai muốn viết ít mã hơn để phân tích HTML.
Hướng dẫn và so sánh PyQuery
6. LXML
 LXML là công cụ phân tích HTML và XML nhanh nhất trong Python. Được xây dựng trên các thư viện C
libxml2 và libxslt, nó nổi tiếng về hiệu suất và hỗ trợ mạnh mẽ cho các bộ chọn XPath và CSS. Nếu bạn đang xử lý các tài liệu lớn hoặc cần chạy các truy vấn phức tạp, lxml là lựa chọn tốt nhất của bạn.
Nó có thể được sử dụng trực tiếp hoặc làm backend cho Beautiful Soup hoặc PyQuery. API hơi nâng cao hơn, nhưng tốc độ và tính linh hoạt đáng giá cho các công việc lớn.
Các tính năng chính:
- Phân tích nhanh nhất có sẵn trong Python
- Hỗ trợ đầy đủ cho các bộ chọn XPath và CSS
- Xử lý các tài liệu lớn và phức tạp một cách hiệu quả
- Có thể được sử dụng độc lập hoặc làm trình phân tích cho các thư viện khác
Tốt nhất cho: Phân tích hiệu suất cao, scraping quy mô lớn và các dự án yêu cầu truy vấn nâng cao.
Tại sao lxml nổi bật trong việc phân tích
7. Requests
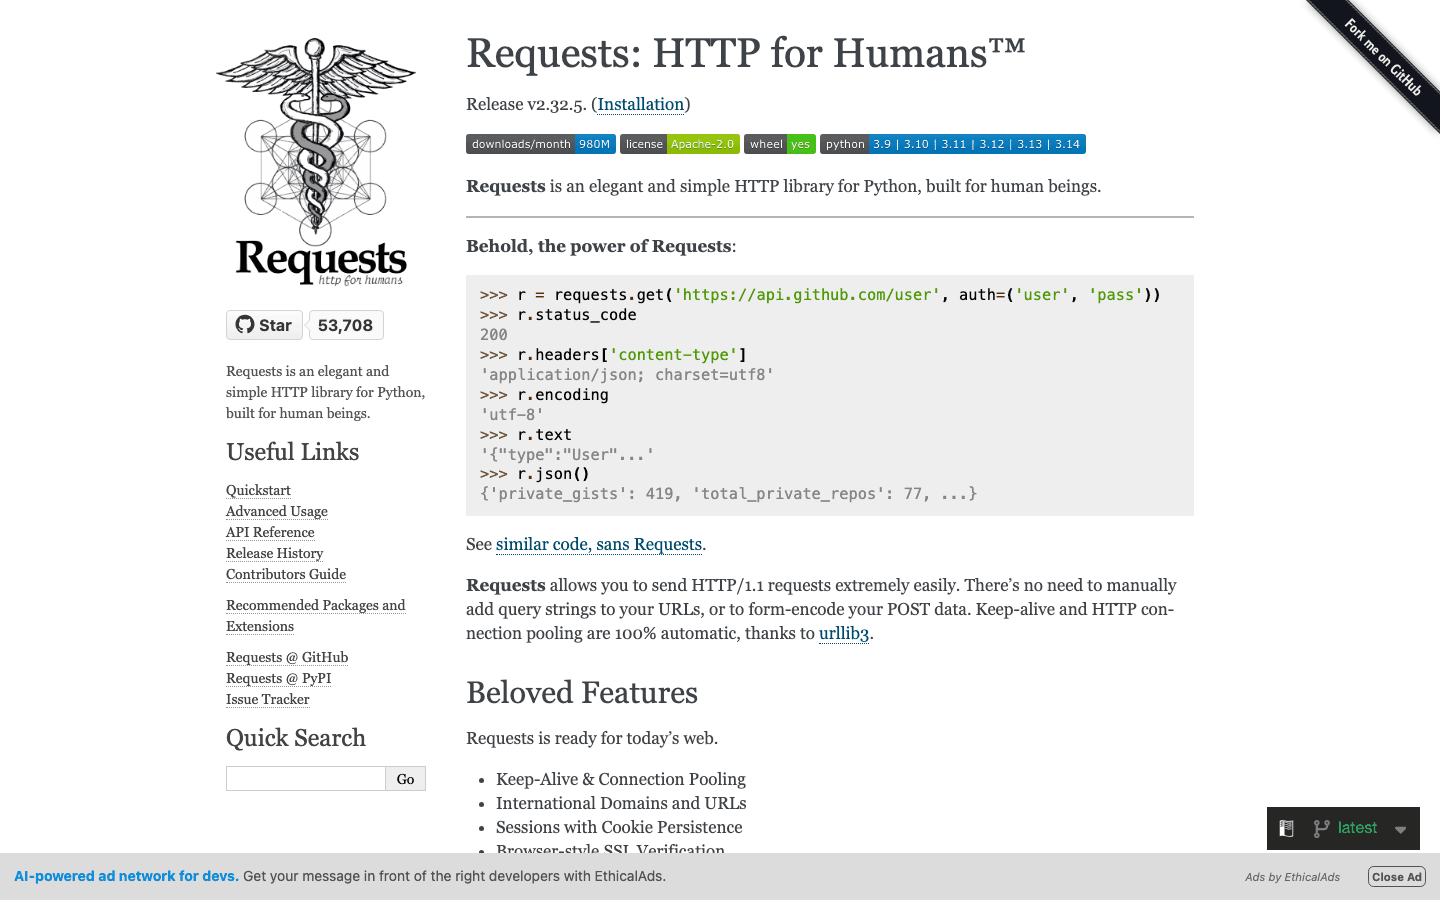 Requests là tiêu chuẩn thực tế để thực hiện các yêu cầu HTTP trong Python. API sạch, trực quan của nó giúp việc lấy các trang web dễ dàng như
requests.get(url). Nó xử lý cookie, phiên và thậm chí giải mã JSON ngay lập tức.
Trong khi Requests là đồng bộ (mỗi yêu cầu chờ hoàn thành), nó hoàn hảo cho các script nhanh và scraping quy mô nhỏ. Kết hợp nó với Beautiful Soup hoặc lxml để có một quy trình scraping cổ điển.
Các tính năng chính:
- API đơn giản, Pythonic cho các yêu cầu HTTP
- Xử lý cookie, phiên và chuyển hướng
- Tích hợp liền mạch với các thư viện phân tích
- Cộng đồng và tài liệu lớn
Tốt nhất cho: Các script đơn giản, scraping trang tĩnh và người mới bắt đầu muốn bắt đầu nhanh chóng.
Xem tại sao Requests lại phổ biến đến vậy
8. MechanicalSoup
 MechanicalSoup là một thư viện nhẹ tự động hóa các tương tác trình duyệt đơn giản—như điền biểu mẫu hoặc điều hướng các luồng đăng nhập nhiều bước—mà không cần khởi chạy một trình duyệt đầy đủ. Nó bao bọc
requests và Beautiful Soup, làm cho nó nhanh hơn và nhẹ hơn nhiều so với Selenium đối với các trang web không phụ thuộc nhiều vào JavaScript.
Nếu bạn cần đăng nhập, gửi biểu mẫu hoặc nhấp qua một vài trang (và trang web không quá động), MechanicalSoup là một lựa chọn trung gian tuyệt vời.
Các tính năng chính:
- Tự động điền biểu mẫu và điều hướng
- Được xây dựng trên Requests và Beautiful Soup
- Nhẹ và nhanh (không có chi phí trình duyệt)
- Dễ sử dụng cho các tương tác vừa phải
Tốt nhất cho: Các trang web yêu cầu đăng nhập hoặc gửi biểu mẫu, các tác vụ tự động hóa đơn giản và bất kỳ ai muốn tránh chi phí của Selenium.
Hướng dẫn MechanicalSoup
9. Aiohttp
 Aiohttp là công cụ bất đồng bộ mạnh mẽ cho các yêu cầu web tốc độ cao, đồng thời. Nếu bạn cần scraping hàng trăm trang một cách nhanh chóng, aiohttp cho phép bạn gửi các yêu cầu song song, giảm đáng kể tổng thời gian chạy. Trong một điểm chuẩn, việc scraping 50 trang chỉ mất 3 giây với aiohttp, so với 16 giây khi sử dụng các yêu cầu đồng bộ (xem sự khác biệt về hiệu suất).
Aiohttp yêu cầu viết mã async def và sử dụng await, nhưng những lợi ích về tốc độ đáng giá cho các công việc quy mô lớn.
Các tính năng chính:
- Framework client/server HTTP bất đồng bộ
- Hỗ trợ phiên, cookie và HTTP/2
- Tăng tốc đáng kể cho các yêu cầu đồng thời
- Tích hợp với các thư viện phân tích bất đồng bộ
Tốt nhất cho: Scraping tốc độ cao, quy mô lớn, thu thập API và bất kỳ ai thoải mái với lập trình bất đồng bộ.
10. Twisted
 Twisted là công cụ mạng dựa trên sự kiện cung cấp sức mạnh cho Scrapy. Mặc dù nó không phải là một thư viện scraping, nhưng người dùng nâng cao có thể sử dụng Twisted trực tiếp để xây dựng các trình thu thập dữ liệu tùy chỉnh, xử lý các giao thức không phải HTTP hoặc triển khai các spider siêu đồng thời.
Twisted mạnh mẽ nhưng có đường cong học tập dốc. Nó tốt nhất cho các kịch bản tùy chỉnh cao hoặc khi xây dựng các framework từ đầu.
Các tính năng chính:
- Mạng dựa trên sự kiện cho HTTP, WebSockets, SSH và hơn thế nữa
- Hỗ trợ SSL, đồng thời và các giao thức tùy chỉnh
- Nền tảng cho công cụ bất đồng bộ của Scrapy
- Rất linh hoạt cho các trường hợp sử dụng nâng cao
Tốt nhất cho: Các giao thức tùy chỉnh, xây dựng các framework scraping và người dùng nâng cao cần kiểm soát tối đa.
11. Grab
 Grab là một bộ công cụ scraping tất cả trong một kết hợp các yêu cầu HTTP, phân tích, tự động hóa, xoay vòng proxy và xử lý CAPTCHA. Nó có tinh thần tương tự như Scrapy nhưng nhằm mục đích dễ học và sử dụng hơn, với hỗ trợ tích hợp cho proxy, bộ nhớ đệm và các spider bất đồng bộ.
Tính năng nổi bật của Grab là hệ thống Grab:Spider của nó, có thể chạy hàng nghìn yêu cầu song song bằng cách sử dụng multicurl. Nếu bạn cần một giải pháp tất cả trong một với ít thiết lập hơn Scrapy, Grab đáng để xem xét.
Các tính năng chính:
- Hỗ trợ tích hợp cho proxy, xoay vòng user-agent và bộ nhớ đệm
- Hệ thống spider bất đồng bộ cho đồng thời cao
- Phân tích XPath và kiến trúc mô-đun
- Được sử dụng trong sản xuất cho scraping quy mô lớn
Tốt nhất cho: Các dự án scraping tất cả trong một, các tác vụ nặng proxy và người dùng muốn sức mạnh mà không có sự phức tạp của Scrapy.
12. Urllib3
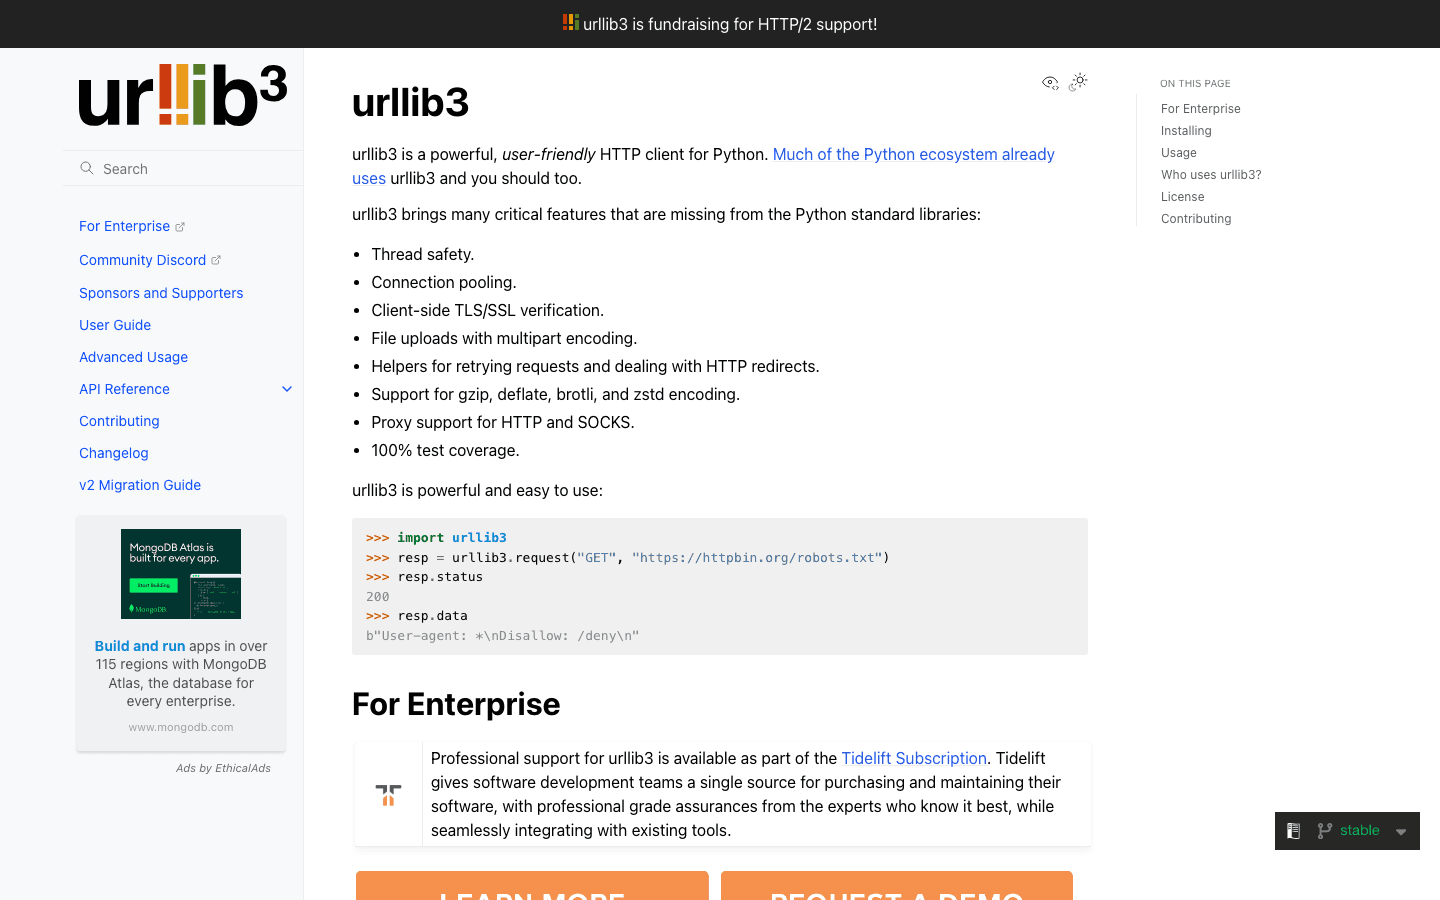 Urllib3 là công cụ HTTP cấp thấp cung cấp sức mạnh cho nhiều client Python, bao gồm Requests. Nó cung cấp nhóm kết nối, an toàn luồng, thử lại và kiểm soát chi tiết các kết nối HTTP. Mặc dù hầu hết các nhà phát triển sử dụng nó một cách gián tiếp, urllib3 là lựa chọn hàng đầu của bạn khi bạn cần hiệu suất tối đa hoặc đang xây dựng các thư viện cấp cao hơn.
Nó không thân thiện với người mới bắt đầu như Requests, nhưng nó đã được thử nghiệm và rất đáng tin cậy.
Các tính năng chính:
- Nhóm kết nối và an toàn luồng
- Kiểm soát chi tiết các kết nối HTTP
- Được sử dụng làm nền tảng cho nhiều thư viện khác
- Hiệu suất cao cho các yêu cầu lặp lại
Tốt nhất cho: Các client HTTP tùy chỉnh, trình thu thập dữ liệu đa luồng và các nhà phát triển xây dựng trên đỉnh ngăn xếp HTTP của Python.
Xem vai trò của urllib3 trong scraping
Bảng so sánh: Các gói web scraping Python trong nháy mắt
| Gói | Dễ sử dụng | Hiệu suất | Nội dung động | Sức mạnh phân tích | Cộng đồng/Tài liệu | Tốt nhất cho |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | Nhanh (đám mây/cục bộ) | Có (qua AI) | Trường tự động, trang con | Đang phát triển (xu hướng AI) | Tạo khách hàng tiềm năng, nghiên cứu thị trường, người dùng không cần mã |
| Beautiful Soup | ★★★★★ (dễ) | Trung bình | Không | HTML/XML, dễ tha thứ | Rất lớn | Trang tĩnh, người mới bắt đầu |
| Scrapy | ★★☆☆☆ (dốc) | ★★★★★ (rất cao) | Chỉ plugin | CSS/XPath, pipeline | Lớn, năng động | Scraping quy mô lớn, định kỳ |
| Selenium | ★★☆☆☆ (trung bình) | ★☆☆☆☆ (chậm) | Có (đầy đủ) | DOM đầy đủ, JS | Trưởng thành | Trang web nặng JS, tương tác |
| PyQuery | ★★★★☆ (jQuery) | Nhanh (lxml) | Không* | Bộ chọn jQuery | Trung bình | Tạo mẫu, nhà phát triển jQuery |
| LXML | ★★★☆☆ (nâng cao) | ★★★★★ (nhanh nhất) | Không | XPath/CSS, XML | Trung bình | Tài liệu lớn, truy vấn nâng cao |
| Requests | ★★★★★ (rất dễ) | ★★☆☆☆ (đồng bộ) | Không | HTTP, JSON | Rất lớn | Các script đơn giản, trang tĩnh |
| MechanicalSoup | ★★★★☆ (dễ) | ★★☆☆☆ (đồng bộ) | Không | Biểu mẫu, điều hướng | Nhỏ | Luồng đăng nhập, tự động hóa biểu mẫu |
| Aiohttp | ★★☆☆☆ (bất đồng bộ) | ★★★★★ (đồng thời) | Không | HTTP bất đồng bộ | Lớn (bất đồng bộ) | Scraping tốc độ cao, đồng thời |
| Twisted | ★☆☆☆☆ (phức tạp) | ★★★★★ (tùy chỉnh) | Không | Mạng, giao thức | Chuyên biệt | Framework tùy chỉnh, người dùng nâng cao |
| Grab | ★★★☆☆ (mô-đun) | ★★★★☆ (bất đồng bộ) | Không | Proxy, XPath | Nhỏ | Tất cả trong một, nặng proxy/captcha |
| Urllib3 | ★★★★☆ (cấp thấp) | ★★★★☆ (được nhóm) | Không | HTTP, nhóm | Rất lớn | Client tùy chỉnh, trình thu thập dữ liệu đa luồng |
*PyQuery có thể được kết hợp với Selenium cho các trang web động.
Cách chọn gói web scraping Python phù hợp với nhu cầu của bạn
Data Scraping là gì và cách thực hiện vào năm 2026 Get Started Free
Vậy, bạn nên chọn gói nào? Đây là bảng tổng hợp của tôi:
- Trang tĩnh, công việc nhỏ, hoặc bạn mới bắt đầu scraping: Bắt đầu với Requests + Beautiful Soup.
- Scraping quy mô lớn, định kỳ hoặc sản xuất: Scrapy hoặc Grab (cho nhu cầu tất cả trong một).
- Các trang web nặng JavaScript hoặc tương tác: Selenium (hoặc Thunderbit nếu bạn muốn scraping không cần mã, được hỗ trợ bởi AI).
- Scraping tốc độ cao, đồng thời: Aiohttp (nếu bạn thoải mái với bất đồng bộ).
- Tự động hóa biểu mẫu hoặc luồng đăng nhập: MechanicalSoup (cho các trang web đơn giản), Selenium (cho JS phức tạp).
- Phân tích nâng cao hoặc tài liệu lớn: LXML hoặc PyQuery.
- Mạng tùy chỉnh hoặc công việc giao thức: Twisted.
- Tạo mẫu nhanh, tạo khách hàng tiềm năng hoặc dữ liệu lộn xộn/không có cấu trúc: Thunderbit.
Và đừng ngại kết hợp—nhiều quy trình làm việc kết hợp các công cụ này để đạt hiệu quả tối đa. Ví dụ, bạn có thể sử dụng Selenium để kết xuất một trang, sau đó chuyển HTML cho Beautiful Soup hoặc PyQuery để phân tích.
Kết luận: Tăng cường web scraping của bạn với các công cụ Python phù hợp
Web scraping vào năm 2026 mạnh mẽ hơn—và cần thiết hơn—bao giờ hết. Với các gói web scraping Python phù hợp, bạn có thể biến sự hỗn loạn của web thành dữ liệu sạch, có thể hành động cho doanh nghiệp, nghiên cứu hoặc ý tưởng lớn tiếp theo của bạn. Dù bạn là một nhà phát triển dày dặn kinh nghiệm hay chỉ mới bắt đầu tìm hiểu về dữ liệu, có một công cụ trong danh sách này phù hợp với nhu cầu của bạn.
Nếu bạn muốn xem scraping không cần mã, được hỗ trợ bởi AI trông như thế nào, hãy dùng thử Thunderbit. Và nếu bạn muốn có thêm mẹo, phân tích chuyên sâu và hướng dẫn, hãy xem Blog Thunderbit để biết những thông tin mới nhất về web scraping, tự động hóa và các quy trình làm việc dựa trên dữ liệu.
Chúc bạn scraping vui vẻ—và mong rằng các bộ chọn của bạn luôn khớp, proxy của bạn không bao giờ thất bại và dữ liệu của bạn sạch như mã của bạn.
Câu hỏi thường gặp
1. Gói web scraping Python tốt nhất cho người mới bắt đầu là gì?
Đối với hầu hết người mới bắt đầu, sự kết hợp giữa Requests và Beautiful Soup là cách dễ nhất để bắt đầu. Cả hai đều có API trực quan, vô số hướng dẫn và xử lý hầu hết các tác vụ scraping trang tĩnh.
2. Làm cách nào để scraping các trang web nặng JavaScript bằng Python?
Sử dụng Selenium để tự động hóa một trình duyệt thực, hoặc thử Thunderbit để scraping không cần mã, được hỗ trợ bởi AI có thể xử lý nội dung động. Đối với nhu cầu quy mô lớn, Scrapy có thể được kết hợp với Splash hoặc Selenium.
3. Gói nào tốt nhất cho scraping quy mô lớn, tốc độ cao?
Scrapy được xây dựng cho việc thu thập dữ liệu bất đồng bộ, quy mô lớn. Nếu bạn cần tốc độ cao hơn nữa và thoải mái với mã bất đồng bộ, aiohttp là lựa chọn hàng đầu cho các yêu cầu đồng thời.
4. Tôi có thể kết hợp các gói này trong quy trình làm việc của mình không?
Hoàn toàn có thể! Nhiều nhà phát triển sử dụng Requests hoặc Selenium để lấy trang, sau đó phân tích bằng Beautiful Soup, lxml hoặc PyQuery. Đầu ra của Thunderbit có thể được đưa vào các script Python để phân tích thêm.
5. Thunderbit là thư viện Python hay công cụ độc lập?
Thunderbit là một tiện ích mở rộng Chrome và nền tảng được hỗ trợ bởi AI, không phải là một thư viện Python truyền thống. Tuy nhiên, đầu ra của nó (CSV, Excel, Sheets, Notion, Airtable) tích hợp liền mạch vào các pipeline dữ liệu Python, khiến nó trở thành một công cụ mạnh mẽ cho các nhà phát triển Python.
6. Các tác nhân mã hóa AI có thay thế các thư viện scraping Python vào năm 2026 không? Chưa, nhưng chúng đáng để tìm hiểu. Các công cụ như Claude Code và OpenAI Codex có thể tạo ra một script Requests + Beautiful Soup hoặc Scrapy hoạt động từ một lời nhắc bằng tiếng Anh đơn giản trong vài giây, điều này thực sự hữu ích cho các công việc một lần và tạo mẫu. Đối với các luồng trình duyệt ngôn ngữ tự nhiên (đăng nhập, JS động, điều hướng nhiều bước), Browser Use là tùy chọn mã nguồn mở mà mọi người đang tìm kiếm, và Firecrawl phổ biến khi mục tiêu là cung cấp markdown sạch cho một LLM. Không có công cụ nào trong số này loại bỏ những phần khó khăn—các biện pháp chống bot, giới hạn tốc độ và TOS vẫn áp dụng—và đối với các trình thu thập dữ liệu sản xuất ở quy mô lớn, Scrapy + aiohttp vẫn thắng về chi phí và kiểm soát. Hãy coi các tác nhân AI là một cách nhanh hơn để viết trình scraping, chứ không phải là một sự thay thế trực tiếp cho các thư viện trong danh sách này.
Bạn muốn đi trước trong thế giới web scraping? Đăng ký Kênh YouTube Thunderbit và theo dõi Blog Thunderbit để biết thêm các hướng dẫn, so sánh và mẹo tự động hóa.
Thử Thunderbit AI Web Scraper miễn phí Get Started Free
Tìm hiểu thêm




