
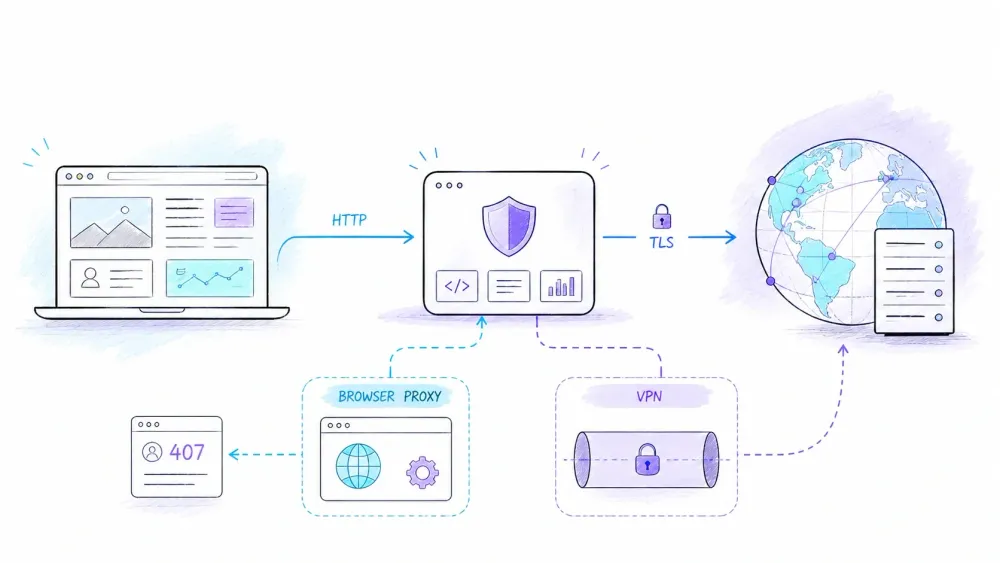
เปิดการตั้งค่าเครือข่ายบนโทรศัพท์หรือแล็ปท็อป แล้วคุณอาจเห็นตัวเลือก HTTP Proxy ที่มีให้เลือก เช่น ปิด, กำหนดเอง และอัตโนมัติ แนวทางที่ปลอดภัยและง่ายที่สุดคือ: ถ้าไม่ได้มีผู้ดูแลที่ไว้ใจได้หรือแอปพลิเคชันใดแอปพลิเคชันหนึ่งให้รายละเอียดพร็อกซีมา อย่าเดาขึ้นมาเอง ที่อยู่พร็อกซีไม่ใช่สวิตช์เร่งความเร็วหรือโหมดความเป็นส่วนตัว แต่มันคือการเปลี่ยนเส้นทางที่คำขอ HTTP ของคุณจะวิ่งไป
หน้าต่างตั้งค่าขนาดเล็กนี้ซ่อนเรื่องที่ใหญ่กว่าที่คิด HTTP proxy อาจใช้บังคับนโยบายของบริษัท, ส่งต่อ API calls ของนักพัฒนา, แคชผลลัพธ์ที่ใช้ร่วมกัน, หรือสร้างอุโมงค์สำหรับ HTTPS ก็ได้ ขณะที่ reverse proxy ก็ทำงานได้อีกฝั่งหนึ่ง คือยืนอยู่หน้าฝั่งเว็บไซต์แทนที่จะอยู่หน้าผู้ใช้งาน แต่บทบาทเหล่านี้ไม่ได้แปลว่าเครือข่ายนั้นจะเป็นส่วนตัว ไม่เปิดเผยตัวตน เร็ว หรือได้รับอนุญาตโดยอัตโนมัติ
คู่มือนี้จะอธิบายตามโปรโตคอล ไม่ใช่ตามคำโฆษณา: HTTP proxy คืออะไร, ระหว่างทางข้อมูลจริงส่งผ่านอะไรบ้าง, CONNECT ต่างจากการ forward ทั่วไปอย่างไร, SOCKS5 และ VPN อยู่ตรงไหน, และจะ debug พร็อกซีอย่างไรโดยไม่ต้องมั่วเปลี่ยนทีเดียวห้าค่า
HTTP Proxy คืออะไร?
HTTP proxy คือคนกลางที่รับคำขอ HTTP แล้วพยายามตอบสนองคำขอนั้นด้วยการส่งต่อคำขอ, ส่งผลลัพธ์ที่เก็บไว้ถ้ามีสิทธิ์ทำ, หรือส่งคำตอบของตัวเองกลับไป RFC 9110 เรียกพร็อกซีที่ไคลเอนต์เลือกใช้ว่าเป็น agent สำหรับส่งต่อข้อความ โดยปกติไคลเอนต์จะรู้จักมันผ่านการตั้งค่าของแอป, การตั้งค่าของระบบปฏิบัติการ, ไฟล์ Proxy Auto-Configuration (PAC), หรือ environment variables
สำหรับ forward proxy แบบชัดเจน เส้นทางจะมีลักษณะดังนี้:
client  --->  forward proxy  --->  origin server
        <---                 <---
ไคลเอนต์จะเชื่อมต่อกับพร็อกซีก่อน จากนั้นพร็อกซีจึงเปิดหรือใช้การเชื่อมต่อไปยังปลายทางซ้ำอีกครั้ง ฝั่ง origin มักจะมองเห็นการเชื่อมต่อเครือข่ายของพร็อกซีเป็นคู่สนทนาทันที แต่แค่ตรงนี้ยังไม่พอจะบอกว่าเป็นการปกปิดตัวตนจริง ๆ ได้ ทั้ง header, cookie, fingerprint ของเบราว์เซอร์, session ที่ยืนยันตัวตนแล้ว, พฤติกรรม DNS และ log ต่าง ๆ ยังสามารถชี้กลับมาหาผู้ใช้หรือองค์กรได้อยู่ “origin เห็น IP ต้นทางคนละตัว” กับ “ผู้ใช้ไม่ระบุตัวตน” เป็นคนละเรื่องกันมาก
HTTP proxy ก็ไม่ใช่การเข้ารหัสเช่นกัน HTTP ธรรมดายังคงเป็น HTTP ธรรมดา เว้นแต่จะมีชั้นความปลอดภัยอื่นคุ้มครอง HTTPS สามารถผ่านพร็อกซีไปได้ในรูปแบบอุโมงค์ TLS แต่ตัวเข้ารหัสมาจาก TLS ไม่ใช่จากคำว่า proxy
HTTP Proxy แบบ Explicit จัดการคำขออย่างไร
ความแตกต่างสำคัญจะเห็นที่ target ของ request เมื่อไคลเอนต์ HTTP/1.1 คุยตรงกับ origin server โดยทั่วไปจะส่งแบบ origin-form:
GET /reports/weekly HTTP/1.1
Host: example.com
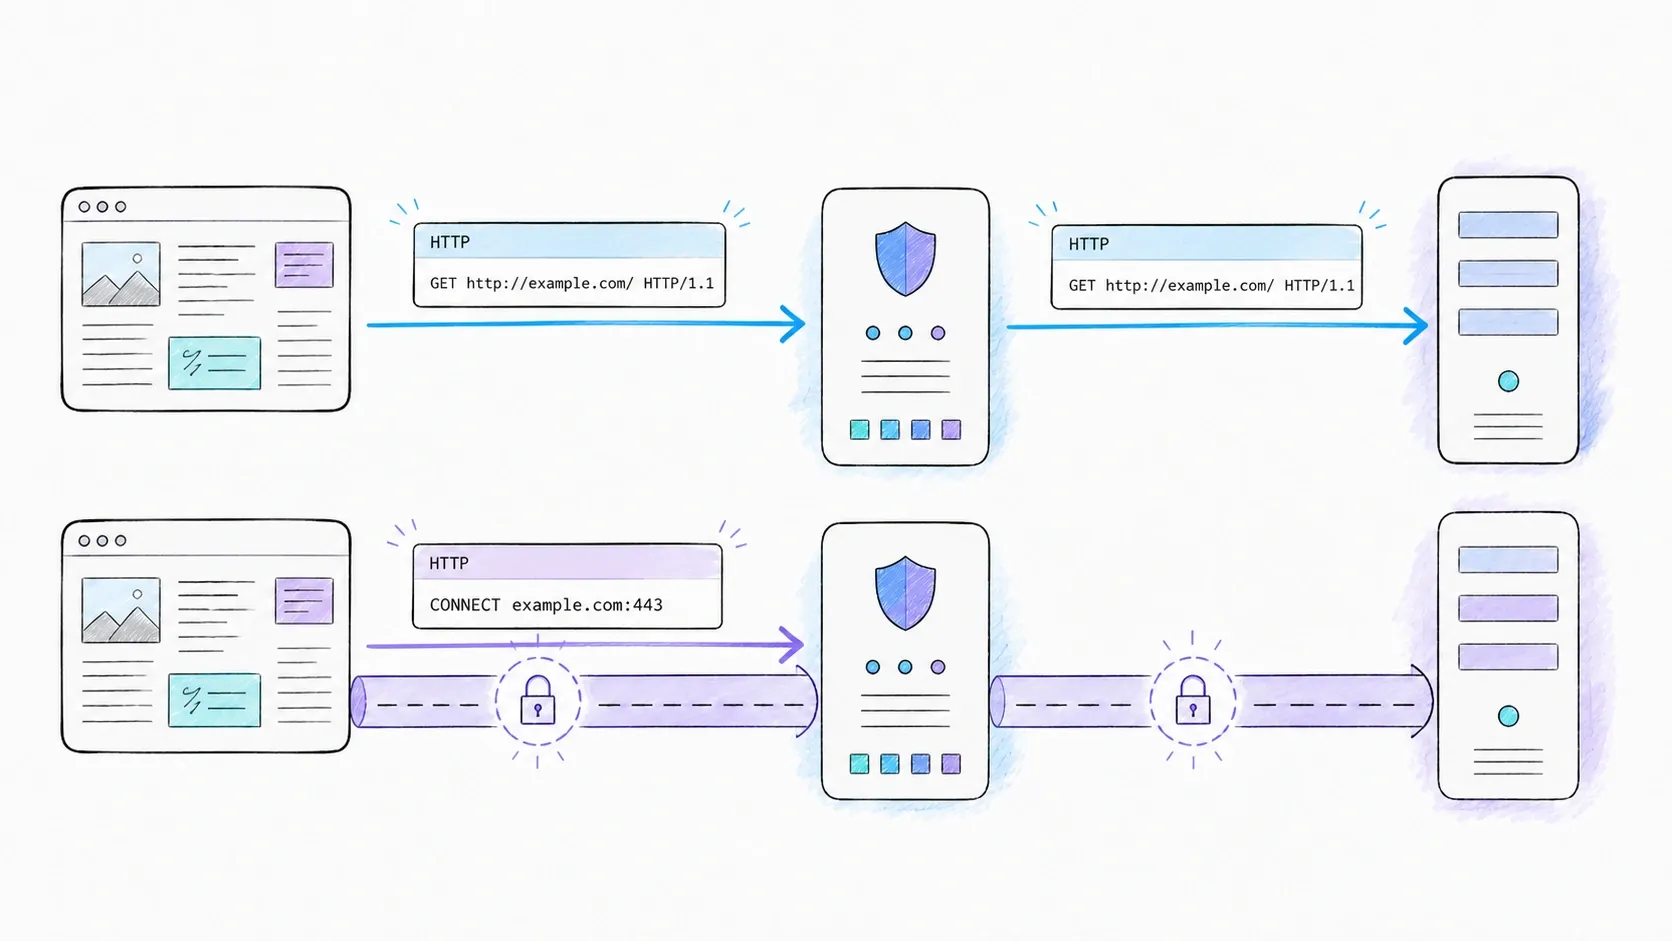
แต่เมื่อไคลเอนต์เดียวกันส่งคำขอ HTTP ปกติไปยัง explicit proxy RFC 9112 กำหนดให้ใช้ absolute-form เพื่อให้พร็อกซีระบุปลายทางได้:
GET http://example.com/reports/weekly HTTP/1.1
Host: example.com
ลำดับการทำงานโดยทั่วไปคือ:
- ไคลเอนต์เลือกพร็อกซีตามกฎการตั้งค่าที่ใช้อยู่
- เชื่อมต่อไปยังพร็อกซีและส่งคำขอที่ระบุ URI เป้าหมาย
- พร็อกซีอาจตรวจสอบสิทธิ์ของไคลเอนต์, บังคับใช้นโยบาย, ตรวจ cache, หรือปฏิเสธคำขอ
- หากอนุญาตให้ส่งต่อ พร็อกซีจะส่งคำขอที่เหมาะสมไปยัง origin
- คำตอบจะย้อนกลับผ่านพร็อกซี พร็อกซีอาจเพิ่ม metadata ของตัวกลาง, แปลงข้อความเมื่ออนุญาต, บันทึกคำตอบที่แคชได้, หรือแค่ส่งต่อเฉย ๆ
คำว่า “อาจ” ในรายการนี้สำคัญมาก HTTP บอกถึงพฤติกรรมที่เป็นไปได้และกฎการทำงานร่วมกัน ไม่ได้การันตีว่าพร็อกซีทุกตัวจะกรองเนื้อหา แคชผลลัพธ์ เขียน header ใหม่ หรือซ่อนตัวระบุเสมอ
ถ้าพร็อกซีต้องการยืนยันตัวตน ก็สามารถตอบกลับด้วย 407 Proxy Authentication Required ได้ ซึ่งต่างจาก 401 Unauthorized: 407 เกี่ยวกับ credentials สำหรับพร็อกซี ส่วน 401 เกี่ยวกับ origin server RFC 9110 อธิบายความแตกต่างนี้ไว้ชัดเจน และ credentials ก็ยังต้องวิ่งผ่านช่องทางที่ปลอดภัยเหมาะสมด้วย การยืนยันตัวตนแบบ Basic ไม่ได้สร้างความลับของข้อมูลขึ้นมาเอง
HTTPS ผ่าน HTTP Proxy: CONNECT คืออุโมงค์ ไม่ใช่การเข้ารหัส
สำหรับปลายทาง HTTPS ไคลเอนต์มักขอให้พร็อกซีเปิด TCP tunnel ด้วย CONNECT โดย request target จะใช้ authority-form คือ host กับ port ไม่ใช่ full URL:
CONNECT example.com:443 HTTP/1.1
Host: example.com:443
หลังจากได้รับคำตอบสำเร็จ การเชื่อมต่อจะกลายเป็นอุโมงค์ จากนั้นไคลเอนต์จะทำ TLS handshake กับ example.com ผ่าน byte stream นั้น:
client == TLS ==[ proxy relays bytes ]== TLS endpoint at origin
ในโมเดลการทำ tunnel แบบปกตินี้ พร็อกซีจะเห็น metadata ของการเชื่อมต่อ เช่น ผู้ใช้พร็อกซี, ปลายทาง, เวลา, และจำนวนไบต์ แต่เนื้อหา HTTPS ของ request และ response จะถูกเข้ารหัสโดย TLS ตัวอุโมงค์เองไม่ใช่กลไกการเข้ารหัส ความต่างนี้สำคัญมากตอนแก้ปัญหา เพราะ CONNECT อาจสำเร็จ แต่ TLS handshake ขั้นถัดไปล้มเหลวได้
บางเครือข่ายที่มีการจัดการอย่างเป็นทางการอาจทำ TLS interception ที่ได้รับอนุญาต ในกรณีนั้นตัวกลางจะเป็นฝ่ายจบ TLS connection หนึ่งแล้วสร้างอีก connection หนึ่งไปยัง origin ไคลเอนต์จึงต้องเชื่อถือ certificate authority ที่ใช้ในการติดตั้งนั้น แล้วตัวกลางจึงตรวจสอบเนื้อหา HTTP ได้ เพราะมันเป็น TLS endpoint เอง ไม่ใช่เพราะ HTTP proxy ทุกตัวอ่าน HTTPS ได้โดยอัตโนมัติ นี่ควรเป็นนโยบายที่ประกาศและดูแลอย่างชัดเจนบนอุปกรณ์ที่มีการจัดการ ไม่ใช่การปิด certificate verification แบบลัดขั้นตอนเพื่อแก้ error ในงานจริง
ฝั่งพร็อกซีก็มีขอบเขตความปลอดภัยเช่นกัน การอนุญาต CONNECT ไปยัง host และ port ใดก็ได้อาจทำให้พร็อกซีกลายเป็นทางผ่านไปยังบริการที่ไม่ควรถูกเปิดเผย ดังนั้นพร็อกซีในงาน production ควรจำกัดปลายทางและพอร์ตตามวัตถุประสงค์การใช้งาน
Forward, Reverse, Explicit และ Interception Proxy
คำเรียกพร็อกซีมักทำให้สับสน เพราะเอาสองมิติมายัดรวมไว้ในรายการเดียว
มิติแรกคือ ใครเป็นฝ่ายเลือกตัวกลาง:
- Forward proxy ถูกเลือกแทนฝั่งไคลเอนต์ มันควบคุมหรือช่วยให้การเข้าถึงออกจากไคลเอนต์หรือเครือข่ายนั้นทำได้
- Reverse proxy หรือ gateway ในความหมายของ HTTP จะยืนอยู่หน้าหนึ่งหรือหลาย origin server ผู้ใช้เข้าหาบริการสาธารณะ ส่วน gateway จะเลือก backend, จบ TLS, แคชผลลัพธ์ที่เข้าเงื่อนไข, หรือใช้นโยบายฝั่งเซิร์ฟเวอร์
มิติที่สองคือ ทราฟฟิกมาถึงตัวกลางได้อย่างไร:
- Explicit proxy เป็นพร็อกซีที่ไคลเอนต์รู้จักผ่านการตั้งค่าอย่างชัดเจน ไคลเอนต์จงใจจัดรูปแบบคำขอให้มัน หรือเปิด
CONNECTtunnel ไปหา - Interception proxy รับทราฟฟิกที่ถูก redirect โดยเครือข่าย โดยที่ไคลเอนต์ไม่ได้ตั้ง explicit proxy แบบปกติไว้
สองคำนี้สามารถซ้อนกันได้ เช่น forward proxy ขององค์กรอาจเป็น explicit ส่วน network gateway อาจ intercept ทราฟฟิกขาออกบางส่วน ขณะที่ reverse proxy มักมองไม่เห็นเป็น hop แยกสำหรับผู้ใช้ แต่ก็ยังเป็นเซิร์ฟเวอร์ที่ไคลเอนต์เชื่อมต่อไปหาอยู่ดี
Interception ไม่ใช่แค่ “explicit proxy แต่ซ่อนหน้าการตั้งค่า” มันอาจกระทบสมมติฐานเรื่องที่อยู่ปลายทาง, การยืนยันตัวตน, TLS และ path MTU แนวทาง interception ของ Squid อธิบายข้อจำกัดด้านการใช้งานเหล่านี้ไว้หลายข้อ ถ้าเครือข่ายไม่สามารถรองรับได้ ผลที่ได้มักเป็นความล้มเหลวแบบครึ่ง ๆ กลาง ๆ ที่อธิบายยาก แทนที่จะเป็นข้อความ error ที่ชัดเจน (ซึ่งดูเหมือนจะเป็นของโปรดของทุกคน)
คำอย่าง anonymous, elite, และ high-anonymity ส่วนใหญ่เป็นหมวดหมู่ของผู้ให้บริการ ไม่ใช่ความสามารถทาง HTTP อย่างเป็นทางการ ควรประเมินพฤติกรรมที่ตรวจสอบได้จริงที่คุณต้องการ—header, egress IP, การยืนยันตัวตน, logging, DNS resolution และนโยบาย tunnel—แทนที่จะเชื่อว่าป้ายชื่อใดป้ายชื่อหนึ่งคือการรับประกันความปลอดภัย
HTTP Proxy vs. SOCKS5 vs. VPN
ไม่มีการจัดอันดับแบบสากลที่พิสูจน์ได้ว่าตัวไหน “เร็วกว่า ถูกกว่า หรือเป็นส่วนตัวกว่า” เสมอไป ประสิทธิภาพขึ้นอยู่กับระยะทาง ความแออัด การเข้ารหัส การติดตั้ง โปรโตคอล และปลายทาง ส่วนต้นทุนก็ขึ้นกับผู้ให้บริการและรูปแบบ deployment ให้เทียบกันที่ขอบเขตการควบคุมแทน
| คำถาม | HTTP proxy | SOCKS5 proxy | VPN |
|---|---|---|---|
| ไคลเอนต์ใช้ interface แบบไหน? | การส่งต่อ HTTP และโดยมากใช้ CONNECT เพื่อทำ tunnel | คำสั่งของโปรโตคอล SOCKS | tunnel เสมือน/ระดับเครือข่ายที่ระบบปฏิบัติการหรือ VPN client จัดการ |
| ทราฟฟิกแบบไหนใช้ได้? | ทราฟฟิกจากแอปที่รองรับ HTTP proxy ที่ตั้งไว้ | TCP และอาจรวม UDP association เมื่อฝั่ง client/server รองรับ | ทราฟฟิกที่ถูกเลือกด้วย routing และนโยบาย split tunnel |
| กลไกนี้รับประกันการเข้ารหัส payload ไหม? | ไม่ | ไม่ | โดยปกติ VPN tunnel จะปกป้องทราฟฟิกภายในขอบเขตที่กำหนด แต่รายละเอียดของโปรโตคอลและนโยบายยังมีผล |
| มักตั้งค่าที่ไหน? | แอป, ระบบปฏิบัติการ, PAC/WPAD, หรือ environment | รายแอปหรือราย library | ระบบปฏิบัติการหรือ VPN client บางครั้งตั้งค่าแยกตามแอป |
| ใครเป็นคน resolve DNS ปลายทาง? | ขึ้นอยู่กับ client, โหมดของ request และการติดตั้ง | ขึ้นอยู่กับว่าลูกค้าส่งปลายทางมาอย่างไร | ขึ้นอยู่กับ routing ของ VPN และนโยบาย DNS |
| คำถามตัดสินใจที่ดีที่สุด | แอปที่คุย HTTP ได้นี้ต้องมีตัวกลางหรือไม่? | แอปนี้ต้องการ interface สำหรับ relay ที่ทั่วไปกว่านี้หรือไม่? | เส้นทางของอุปกรณ์หรือแอปใดควรถูกส่งเข้า encrypted network tunnel? |
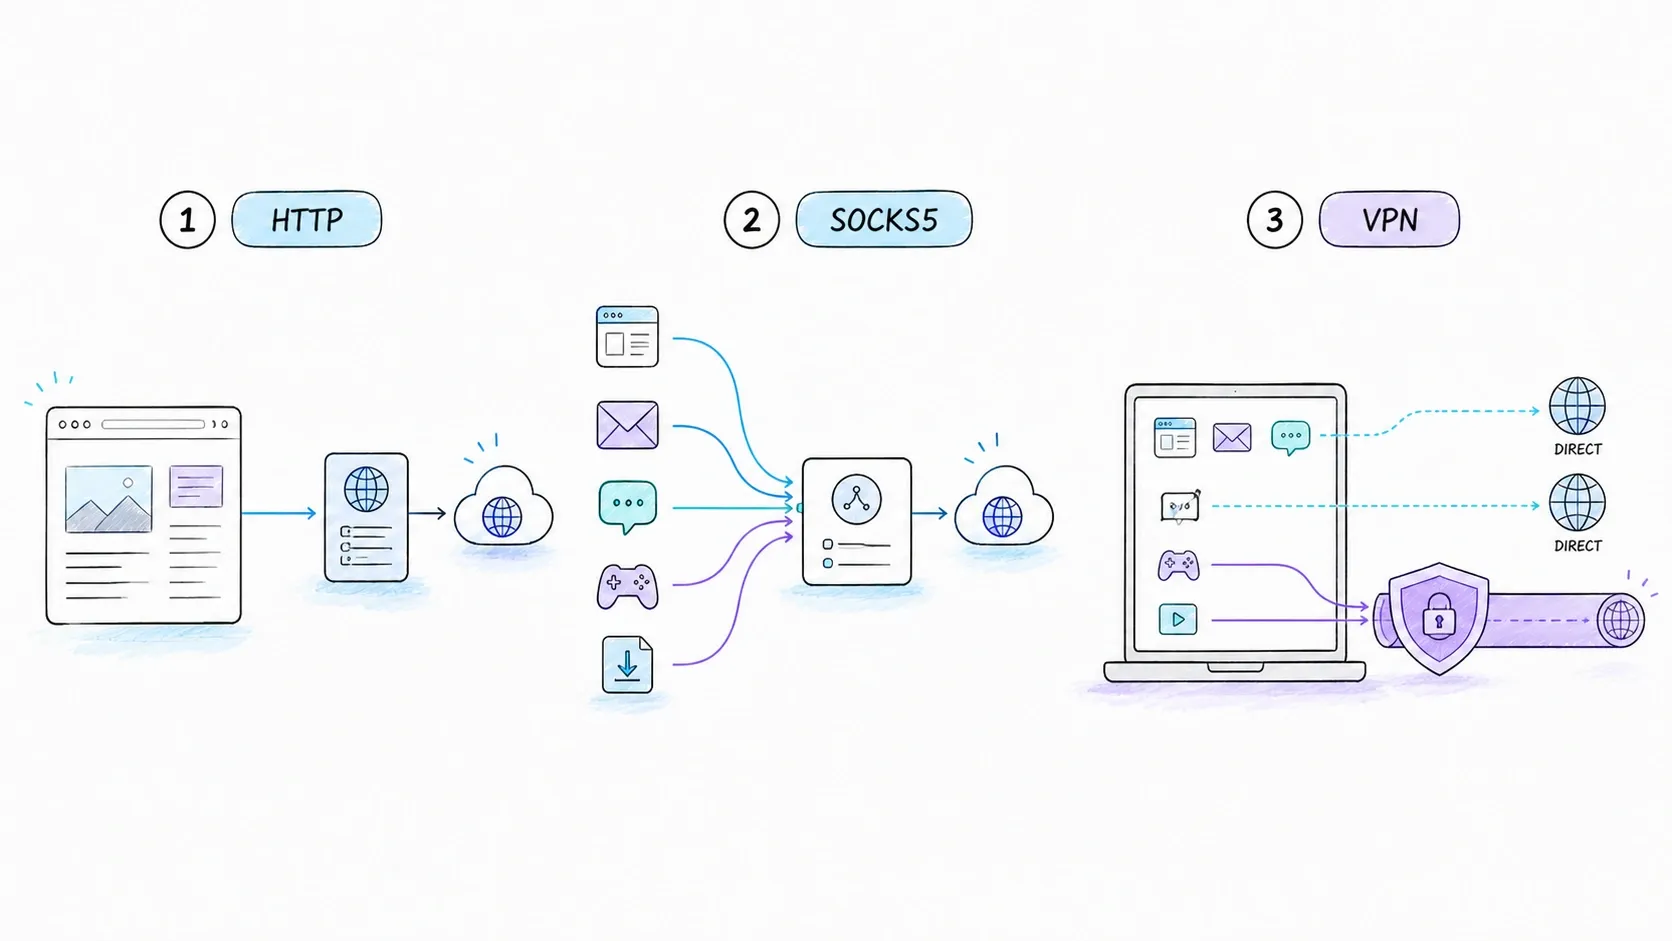
SOCKS5 กำหนด CONNECT, BIND, และ UDP ASSOCIATE ทำให้มันเป็นโปรโตคอลที่กว้างกว่า HTTP forwarding เฉพาะทาง แต่ก็ยังไม่ได้สัญญาว่าจะเข้ารหัสหรือปกปิดตัวตน ความปลอดภัยขึ้นอยู่กับการยืนยันตัวตน ช่องทางที่ปกป้องอยู่ภายนอก พฤติกรรมของ endpoint และผู้ดูแลระบบ
VPN โดยทั่วไปทำงานที่ขอบเขตเครือข่ายที่กว้างกว่า แต่ประโยคที่ว่า “VPN จะพาทุก byte จากอุปกรณ์ไปหมดเสมอ” นั้นไม่จริง การทำ split tunneling สามารถเลือกได้ว่าจะรวมเส้นทางหรือแอปใดไว้หรือไม่ไว้ใน tunnel เอกสาร VPN deployment ของ Apple เป็นตัวอย่างหนึ่งของแพลตฟอร์มที่รองรับพฤติกรรม VPN แบบจำกัดขอบเขต
ให้เลือกตามขอบเขตและความไว้วางใจ ไม่ใช่ตามป้ายคำเดียว ถ้ามีเพียง HTTP client ตัวเดียวที่ต้องออกผ่าน gateway ของบริษัท VPN ทั้งอุปกรณ์อาจไม่จำเป็น ถ้าแอปหลายตัวต้องเข้าถึงเครือข่ายส่วนตัว การตั้งค่า HTTP proxy แยกทีละตัวอาจไม่ใช่ abstraction ที่เหมาะ
ควรเปิด HTTP Proxy ไว้หรือปิดดี?
สำหรับเครือข่ายบ้านที่ไม่ได้มีการจัดการจากส่วนกลาง ควรปิดไว้ เว้นแต่บริการที่คุณตั้งใจใช้และไว้ใจได้จะให้ address, port, และวิธียืนยันตัวตนมาเอง การเปิด public proxy แบบสุ่มเท่ากับส่งทราฟฟิกไปหาผู้ดูแลที่คุณยังไม่ได้ประเมิน
สำหรับอุปกรณ์ที่องค์กร โรงเรียน หรือหน่วยงานดูแลอยู่ ให้ทำตามคำแนะนำล่าสุดของผู้ดูแลระบบ อย่าลบค่าที่ไม่คุ้นเคยก่อนตรวจสอบว่าอุปกรณ์นั้นถูกจัดการผ่านระบบ device management, VPN/security client หรือผู้ดูแลอยู่หรือไม่ พร็อกซีอาจเป็นส่วนหนึ่งของการควบคุมการเข้าถึง การลบมันออกอาจทำให้เข้าใช้งานไม่ได้หรือผิดนโยบาย แม้ว่าการท่องเว็บทั่วไปจะดูยังใช้ได้ก็ตาม
คำว่า “Auto” โดยมากหมายถึง URL ของ PAC หรือกลไกการค้นหาอัตโนมัติ PAC file คือ JavaScript ที่สามารถคืนค่าเส้นทางต่างกันสำหรับ URL ต่างกันได้ เช่น ส่ง hostname ภายในผ่านพร็อกซี ขณะที่ต่อกับเว็บไซต์สาธารณะโดยตรง นั่นหมายความว่าเบราว์เซอร์อาจใช้ได้กับปลายทางหนึ่ง แต่ล้มเหลวอีกปลายทางหนึ่ง แม้จะเห็นการตั้งค่าเหมือนกันก็ตาม
เมนูจริงเปลี่ยนไปตามเวอร์ชัน ดังนั้นให้ใช้เอกสารล่าสุดของผู้ผลิตแทนภาพหน้าจอจากบทความเก่า คำถามที่ควรถามจริง ๆ คือ:
- การตั้งค่านี้ถูกจัดการโดยองค์กร หรือผู้ใช้กรอกเอง?
- เป็น Manual, PAC/Auto หรือเฉพาะแอป?
- ครอบคลุมโปรโตคอลและปลายทางใดบ้าง?
- มีกฎ bypass เช่น
NO_PROXYหรือ "exclude simple hostnames" หรือไม่? - ถ้าแอป, ระบบปฏิบัติการ, environment และ PAC ไม่ตรงกัน อันไหนจะชนะ?
คำถามสุดท้ายนี้ขึ้นอยู่กับไคลเอนต์ Chrome/Chromium โดยทั่วไปจะผสานกับการแก้ไข proxy ของแพลตฟอร์ม แต่ก็มี rules ของตัวเองที่ระบุไว้ Firefox ใช้การตั้งค่าการเชื่อมต่อของตัวเองได้ ส่วนเครื่องมือบรรทัดคำสั่งมักอ่าน environment variables แยกต่างหาก ดังนั้นการตั้ง system proxy ไว้จึงไม่ได้แปลว่าทุกแอปจะใช้มันเสมอ
ใช้ HTTP Proxy ใน curl และ Python
สำหรับคำขอครั้งเดียว --proxy ของ curl ทำให้เห็นการเลือกใช้อย่างชัดเจน:
curl --fail-with-body --show-error \
  --proxy 'http://proxy.example:8080' \
  'https://api.example.com/health'
ถ้าต้องยืนยันตัวตน อย่าใส่ secret จริงลงในซอร์สโค้ด, ประวัติ shell, ภาพหน้าจอ หรือโค้ดตัวอย่างในบทความ ให้ใช้กลไก credentials ที่ได้รับอนุมัติสำหรับสภาพแวดล้อมของคุณ ตัวอย่างนี้ใช้ placeholder โดยตั้งใจ:
curl --fail-with-body --show-error \
  --proxy 'http://proxy.example:8080' \
  --proxy-user "$PROXY_USER:$PROXY_PASSWORD" \
  'https://api.example.com/data'
สำหรับงานอัตโนมัติระยะยาว ควร fail closed ถ้านโยบายบอกว่าคำขอต้องใช้พร็อกซี อย่าดัก error ของพร็อกซีแล้วลองต่อแบบ direct เงียบ ๆ เพราะ fallback แบบ direct อาจเปิดเผย egress IP ของไคลเอนต์หรือเลี่ยงนโยบายการเข้าถึงได้
Python Requests รองรับการกำหนด mapping ชัดเจน:
import os
import requests

proxy_url = os.environ["APP_PROXY_URL"]
proxies = {
    "http": proxy_url,
    "https": proxy_url,
}

response = requests.get(
    "https://api.example.com/health",
    proxies=proxies,
    timeout=(5, 20),
)
response.raise_for_status()
print(response.json())
คีย์ https ด้านบนหมายถึง “ใช้พร็อกซีนี้กับปลายทาง HTTPS” ไม่ได้หมายความว่าไคลเอนต์ต้องสร้าง TLS ไปยังพร็อกซี เสมอไป URL พร็อกซีแบบ http:// ยังสามารถรับ CONNECT แล้วส่งต่อ TLS ไปยัง origin ได้ Requests ยังมีเอกสารเกี่ยวกับการใช้ environment variables และการจัดการ CA bundle ใน advanced proxy guide ด้วย
พฤติกรรมของ environment ก็ไม่ได้เหมือนกันทุกตัว curl ตั้งใจรองรับตัวแปร http_proxy ตัวเล็ก ขณะที่เครื่องมือหรือ environment อื่นอาจยอมรับรูปแบบตัวพิมพ์ต่างกัน การจับคู่ของ NO_PROXY, การรองรับ CIDR, จุดนำหน้า, พอร์ต, พฤติกรรม loopback และลำดับความสำคัญยังต่างกันไป ให้ถือเอกสารของ runtime ที่ใช้อยู่เป็นสัญญาหลัก อย่าคิดว่าถ้า curl ใช้ได้แล้ว Requests, Go, เบราว์เซอร์ และ container จะเลือกเส้นทางเดียวกันทั้งหมด
และอย่าใช้วิธีนี้เพื่อ “แก้” ปัญหา certificate:
# อย่าใช้วิธีนี้เพื่อปกปิดปัญหา certificate ใน production
requests.get("https://api.example.com", verify=False)
ถ้าเป็น proxy ตรวจสอบที่ได้รับอนุญาตและใช้ CA ส่วนตัว ให้ติดตั้งหรืออ้างอิง trust bundle ที่ถูกต้อง แต่ถ้าไม่ได้รับอนุญาต ให้หยุดและตรวจสอบก่อน
แก้ปัญหา HTTP Proxy ทีละชั้น
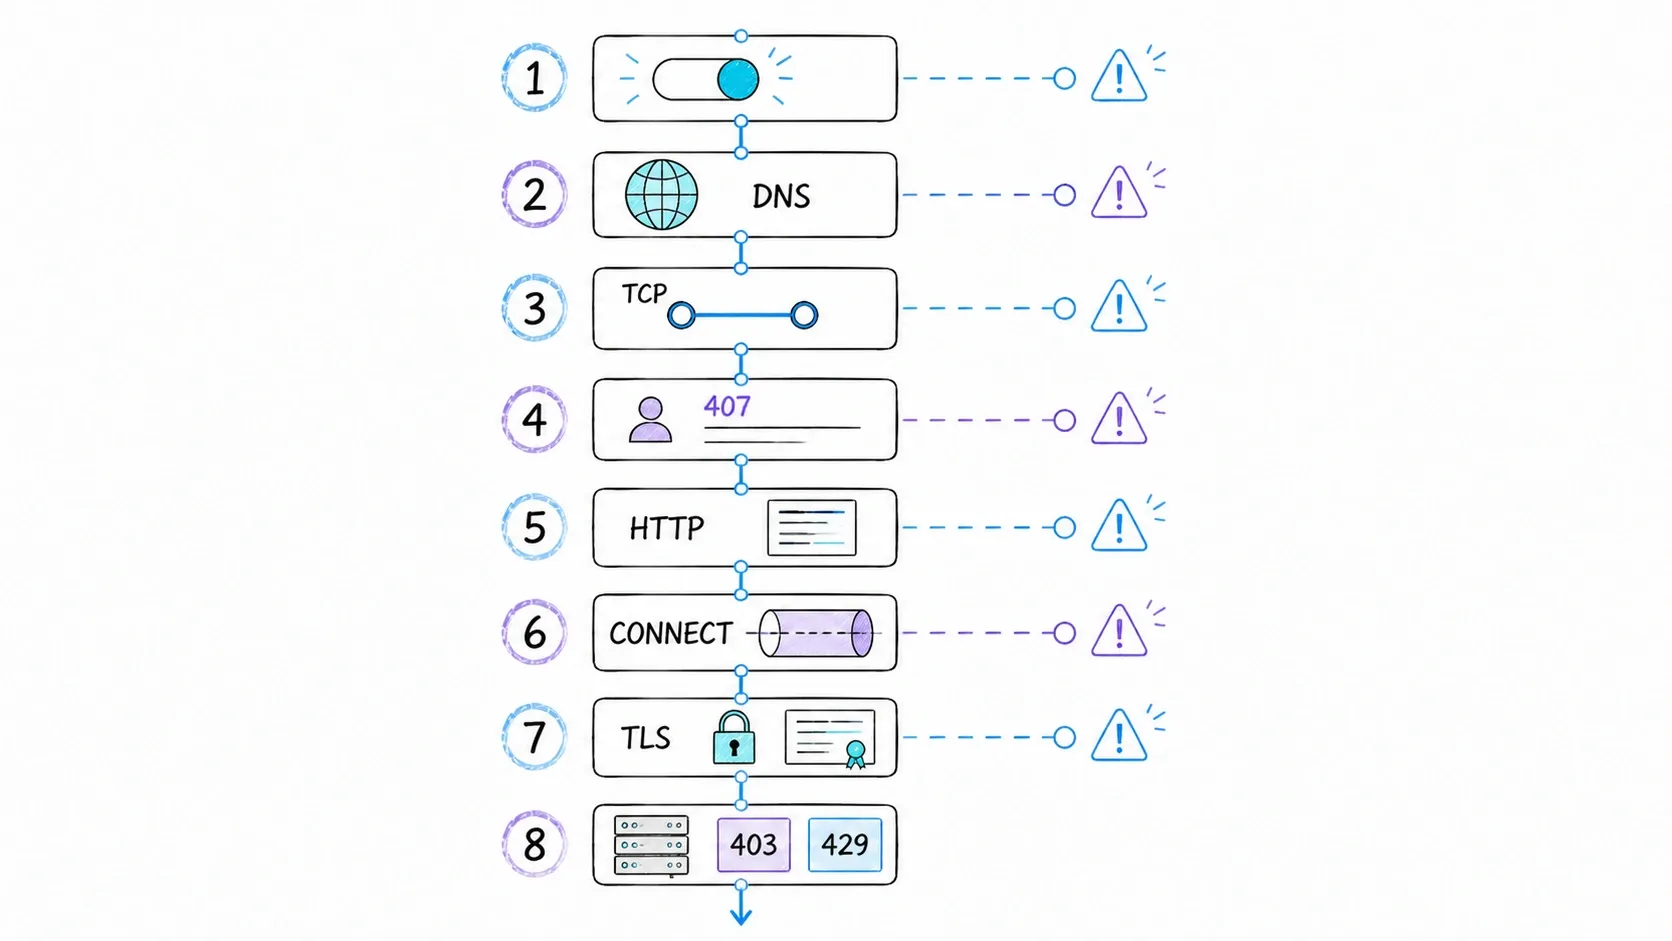
ปัญหาพร็อกซีจะจัดการได้ง่ายขึ้นเมื่อทดสอบทีละชั้น:
- การเลือกการตั้งค่า: ตรวจสอบว่าแอปที่ล้มเหลวใช้งานพร็อกซีจากแหล่งไหนจริง ๆ — manual, system settings, PAC, environment หรือการตั้งค่าเฉพาะของมันเอง ดูกฎ bypass ด้วย
- การ resolve ชื่อ: ดูว่าไคลเอนต์ resolve ปลายทางเองในเครื่อง หรือส่ง hostname ให้พร็อกซี resolve ให้ ทดสอบ hostname ของพร็อกซีแยกต่างหาก
- การเข้าถึง TCP: ไคลเอนต์เชื่อมต่อไปยัง host และ port ของพร็อกซีได้ไหม ถ้า timeout ตรงนี้ นั่นไม่ใช่ error ของ HTTP
- การยืนยันตัวตนของพร็อกซี:
407หมายถึงพร็อกซีกำลังขอ credentials อย่าสับสนกับ401จาก origin - HTTP forwarding: สำหรับปลายทาง HTTP ธรรมดา ให้ดู status code และตรวจว่าคำขอใช้ absolute-form target ถูกต้องหรือไม่
- นโยบาย CONNECT: สำหรับ HTTPS ให้ตรวจว่าพร็อกซีอนุญาต host และ port ปลายทางหรือไม่ ถ้า tunnel ถูกปฏิเสธ ก็จะไม่ถึงขั้น TLS
- TLS: หลัง
CONNECTสำเร็จ ให้ตรวจสอบ certificate identity, trust chain, การเจรจาโปรโตคอล และว่าควรมี interception ที่ได้รับอนุญาตหรือไม่ - คำตอบจาก origin:
403,404, หรือ429จากปลายทางไม่ได้แปลว่าเป็นความผิดของพร็อกซีโดยอัตโนมัติ และไม่ได้อนุญาตให้เปลี่ยนตัวตนหรือเลี่ยงการควบคุม
ตัวกลางบางตัวจะส่งฟิลด์ Proxy-Status ที่มีรายละเอียดสำหรับวิเคราะห์ปัญหามาให้ด้วย ถ้ามีให้ใช้ได้เลย แต่ไม่ควรวางแผนแก้ปัญหาทั้งหมดโดยพึ่งมันเพียงอย่างเดียว Log จาก client, proxy และ origin ยังเป็นวิธีที่น่าเชื่อถือที่สุดในการระบุว่าชั้นไหนล้มเหลว
แล้ว Proxy Caching ล่ะ?
การแคชแบบใช้ร่วมกันมีประโยชน์ แต่เกิดขึ้นแบบมีเงื่อนไข ไม่ได้เกิดขึ้นอัตโนมัติ RFC 9111 กำหนดให้ shared cache ต้องพิจารณาวิธี, cache key, ความสด, response directives, authorization และกฎ revalidation ก่อนนำ response กลับมาใช้ซ้ำ
มี directives สี่ตัวที่มักถูกเข้าใจผิด:
privateบอกให้ shared cache ไม่ต้องเก็บ response นั้น (หรือ fields ที่ระบุ)no-storeบอกไม่ให้ caches เก็บ message ไว้ แต่ RFC ก็เตือนชัดว่าไม่ใช่กลไกความเป็นส่วนตัวที่สมบูรณ์no-transformขอให้ตัวกลางไม่แปลง representationproxy-revalidateมีผลต่อการนำ response ที่เก่าแล้วกลับมาใช้ใหม่ ไม่ได้ทำให้ response ที่แคชไม่ได้กลายเป็นแคชได้
เมื่อ HTTPS ถูกทำ tunnel แบบ end to end พร็อกซีฝั่ง forward จะมองไม่เห็นเนื้อหาภายใน ดังนั้นมันจึงไม่สามารถทำหน้าที่เป็น HTTP content cache สำหรับข้อความที่เข้ารหัสอยู่ใน tunnel นั้นได้ reverse proxy หรือ gateway ที่จบ TLS แบบได้รับอนุญาตเป็นสถาปัตยกรรมที่ต่างออกไป
HTTP Proxies, Web Scraping และ Thunderbit
ระบบเก็บข้อมูลอาจใช้พร็อกซีเพื่อควบคุม egress, routing ตามภูมิภาค, แยกภาระงาน, หรือคง network identity ให้เสถียร สิ่งเหล่านี้คือความสามารถด้าน routing ไม่ใช่ใบอนุญาตในการเข้าถึง พร็อกซีไม่ได้ให้สิทธิ์เก็บข้อมูลจากหน้าเว็บ, ไม่ได้ลบ access control, และไม่ได้รับประกันว่าเป้าหมายจะยอมรับคำขอเสมอไป สถานะอย่าง 403 และ 429 หรือ CAPTCHA ต้องการการจัดการตามนโยบาย ไม่ใช่สูตร “เปลี่ยนชนิดพร็อกซีแล้วจะจบ” แบบอัตโนมัติ
นอกจากนี้ยังมีคำถามเรื่อง abstraction ด้วย forward proxy แบบดิบ ๆ ให้ interface สำหรับ routing หรือ tunneling ระดับ HTTP แก่นักพัฒนา แต่แอปยังต้องรับผิดชอบการดึงข้อมูล, rendering, parsing, schema validation, retry, observability และการตัดสินใจด้าน compliance เอง
อินเทอร์เฟซของ Thunderbit อยู่ในชั้นที่สูงกว่า Thunderbit documentation อธิบายการดึงข้อมูลจาก URL พร้อมความสามารถด้าน rendering และ routing ขณะที่ Web Scraper API อธิบายโหมดผลลัพธ์สองแบบ: Markdown ที่สะอาดจาก URL หรือ JSON ตาม schema สิ่งนี้ช่วยลดโครงสร้าง crawler และ parsing ที่ทีมต้องดูแลลงได้มาก แต่ไม่ได้สร้างความสำเร็จแบบครอบคลุมทุกเป้าหมาย ไม่ได้ลัดผ่าน access control และไม่ได้ตัดสินว่าอนุญาตให้เก็บข้อมูลหรือไม่
ใช้ interface ระดับล่างเมื่อคุณต้องการควบคุมพฤติกรรมการรับส่งข้อมูลโดยตรง และพร้อมดูแล crawler ส่วนที่เหลือเอง ใช้ interface สำหรับ extraction ระดับสูงกว่าเมื่อความต้องการจริงคือข้อมูลหน้าเว็บแบบมีโครงสร้าง และขอบเขตบริการที่เอกสารรองรับตรงกับงาน นั่นคือความรับผิดชอบทางวิศวกรรมคนละแบบ ไม่ใช่พร็อกซีคนละยี่ห้อ
สรุปประเด็นสำคัญ
- HTTP proxy คือคนกลางที่ส่งต่อข้อความ ไม่ใช่ฟีเจอร์ความเป็นส่วนตัวหรือการเข้ารหัสอัตโนมัติ
- การ forward แบบ explicit ของ HTTP ใช้ URI แบบ absolute ส่วน HTTPS มักเริ่มด้วยคำขอ
CONNECT host:portแล้วจึงทำ TLS ผ่านอุโมงค์ - พร็อกซีแบบ tunnel โดยปกติจะอ่าน HTTP body ที่ถูก TLS ป้องกันไม่ได้ แต่ gateway ที่ทำ TLS interception แบบได้รับอนุญาตเป็นอีกสถาปัตยกรรมหนึ่ง
- forward/reverse และ explicit/interception คือคนละมิติ
- HTTP proxy, SOCKS5 และ VPN ควรเทียบกันตามขอบเขตทราฟฟิก, การตั้งค่า, ความไว้วางใจ และนโยบาย routing ไม่ใช่คำเคลมเรื่องความเร็วหรือราคาแบบเหมา ๆ
- ถ้าไม่มีผู้ดูแลที่ไว้ใจได้หรือแอปที่ตั้งใจใช้ให้ข้อมูลพร็อกซีมา ให้ปิดการตั้งค่าพร็อกซีไว้
- ในงานอัตโนมัติ ให้กำหนดการใช้พร็อกซีอย่างชัดเจน ปกป้อง credentials เข้าใจกฎ bypass และ precedence และ fail closed เมื่อพร็อกซีเป็นข้อบังคับ
คำถามที่พบบ่อย
HTTP proxy เหมือนกับ VPN ไหม?
ไม่เหมือน HTTP proxy ให้ interface สำหรับ forward หรือ tunnel ที่เข้าใจ HTTP สำหรับแอปที่เลือกใช้ ส่วน VPN จะสร้าง network tunnel และเปลี่ยน routing สำหรับทราฟฟิกที่นโยบายของมันครอบคลุม แต่ป้ายชื่อทั้งสองอย่างเดียวไม่ได้พิสูจน์ความไม่ระบุตัวตน และการทำ split tunneling ของ VPN ก็หมายความว่าไม่ได้ครอบคลุมทั้งอุปกรณ์เสมอไป
HTTP proxy มองเห็นทราฟฟิก HTTPS ได้ไหม?
ใน CONNECT tunnel แบบปกติ พร็อกซีจะส่งต่อ TLS bytes และอ่านเนื้อหา HTTP ที่ปกป้องไว้ไม่ได้ แต่ยังเห็น metadata ของการเชื่อมต่อได้ หาก gateway ที่ได้รับอนุญาตจบ TLS ด้วย CA ที่ไคลเอนต์ที่มีการจัดการเชื่อถือได้ มันจะตรวจสอบเนื้อหาได้ เพราะมันเป็น endpoint ของการเชื่อมต่อ TLS สองฝั่ง
407 Proxy Authentication Required หมายความว่าอะไร?
พร็อกซีกำลังท้าทายให้ไคลเอนต์ส่ง credentials สำหรับพร็อกซี มันต่างจากคำขอ 401 ที่มาจาก origin ให้ตรวจวิธียืนยันตัวตนที่ได้รับอนุมัติและช่องทางที่ปกป้องไว้อย่างเหมาะสมก่อนส่ง credentials
HTTP proxy ซ่อน IP ของฉันได้ไหม?
โดยปกติ origin จะเห็นการเชื่อมต่อจากพร็อกซีเป็นคู่สนทนาทางเครือข่ายโดยตรง แต่ไม่ได้แปลว่ามันจะไม่ระบุตัวตนได้จริง ๆ เพราะ forwarded headers, การยืนยันตัวตน, cookies, fingerprints, พฤติกรรม DNS และ log ต่าง ๆ ยังอาจระบุถึงไคลเอนต์ได้
จำเป็นต้องใช้พร็อกซีสำหรับ web scraping ไหม?
ไม่จำเป็นเสมอไป คำตอบขึ้นกับเป้าหมายที่ได้รับอนุญาต, ปริมาณคำขอ, ข้อกำหนดด้านภูมิภาค, สถาปัตยกรรม และกฎการเข้าถึงที่เว็บไซต์กำหนด พร็อกซีช่วยเรื่อง routing และ egress control ได้ แต่ไม่ทดแทนการขออนุญาต, การจำกัดอัตรา, การแยกข้อมูล, monitoring หรือ error handling
ทำไมบางแอปถึงไม่สนใจ system proxy ของฉัน?
แต่ละแอปอาจใช้แหล่งตั้งค่าและลำดับความสำคัญต่างกัน บางตัวอิง OS, บางตัวใช้ค่าของตัวเอง และเครื่องมือบรรทัดคำสั่งอาจอ่าน environment variables แยกต่างหาก ให้ตรวจเอกสารของแอปที่มีปัญหาและกฎ bypass ของมัน แทนที่จะคิดว่าหน้าตั้งค่าของระบบควบคุมทุกอย่าง
เรียนรู้เพิ่มเติม




