
เว็บกำลังโตแบบก้าวกระโดดจนแทบตามไม่ทัน—ภายในปี 2026 คาดว่าปริมาณทราฟฟิกบนอินเทอร์เน็ตเกือบครึ่งหนึ่งจะมาจากบอต และสัดส่วนมหาศาลก็มาจากธุรกิจที่ใช้การดึงข้อมูลมาขับเคลื่อนงานขาย การปฏิบัติการ และการวิเคราะห์คู่แข่ง ผมเห็นกับตาว่า web scraping ค่อย ๆ เปลี่ยนจาก “มีไว้ก็ดี” สำหรับสายเทคนิค กลายเป็นของจำเป็นสำหรับแทบทุกทีม ตั้งแต่ฝ่ายขายไปจนถึงนายหน้าอสังหาฯ แต่ประเด็นคือ: บริษัท web scraping ไม่ได้ดีเท่ากันทุกเจ้า และการเลือกให้ถูกอาจเป็นเส้นแบ่งระหว่างเวิร์กโฟลว์อัตโนมัติที่ลื่นไหล กับสัปดาห์ที่ต้องปวดหัวกับการก็อปปี้วางข้อมูลทั้งวัน
ดังนั้นผมเลยลงมือค้นคว้าอย่างจริงจัง และคัดบริษัท web scraping ชั้นนำสำหรับปี 2026 มาให้แล้ว ไม่ว่าคุณจะเป็นผู้ใช้ที่ไม่ถนัดเทคนิคและอยากได้ข้อมูลในไม่กี่คลิก หรือเป็นนักพัฒนาที่ต้องการคุมทุกอย่างได้เต็มมือ รายการนี้รวบรวมตัวเลือกที่ดีที่สุดไว้ครบ พร้อมมุมมองตรง ๆ ว่าแต่ละเจ้าเก่งเรื่องอะไร และมีข้อจำกัดตรงไหนบ้าง ไปดูกันเลย
ทำไมธุรกิจถึงต้องใช้บริษัท Web Scraping ชั้นนำ
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI Get Started Free
ถ้าคุณเคยพยายามสร้างรายชื่อลีด เฝ้าดูราคาคู่แข่ง หรือดึงข้อมูลสินค้าออกมาจากหลายสิบหรือหลายพันหน้า คุณคงรู้ดีว่าการเก็บข้อมูลด้วยมือมันเหนื่อยแค่ไหน ช้า เสี่ยงผิดพลาด และพูดตรง ๆ คือไม่มีใครอยากทำทั้งวัน นี่แหละเหตุผลที่ web scraping โตขึ้นจนกลายเป็นอุตสาหกรรมจริงจัง โดยธุรกิจเอาไปใช้ตั้งแต่ การหาลีด การติดตามราคา ไปจนถึงการวิจัยตลาดและการวิเคราะห์ความรู้สึกของผู้ใช้
หัวใจสำคัญจริง ๆ คือ “ระบบอัตโนมัติ” บริษัท web scraping สมัยใหม่ช่วยให้คุณ:
- ทำให้การค้นคว้าซ้ำ ๆ เป็นอัตโนมัติ ไม่ต้องคัดลอกวางจนเมื่อยมือ
- ขยายสเกล ไปยังหลายพันหน้าได้โดยไม่ต้องเพิ่มงานแบบทวีคูณ
- เชื่อมข้อมูลเข้ากับเครื่องมือที่คุณใช้ประจำ เช่น Excel, Google Sheets, Notion และ CRM
- ตามคู่แข่งให้ทันหรือแซงหน้า ด้วยข้อมูลที่สดกว่า ละเอียดกว่า และได้เร็วกว่า
แต่พอมีตัวเลือกเยอะขนาดนี้ จะเลือกยังไง? ตรงนี้แหละที่บทความนี้จะช่วยคุณได้
เราประเมินบริษัท Web Scraping ชั้นนำอย่างไร
เครื่องมือดึงข้อมูลไม่ได้ถูกสร้างมาเพื่อผู้ใช้ทุกคน หรือทุกงานเหมือนกัน นี่คือเกณฑ์ที่ผมใช้ในการคัดเลือก:
- ใช้งานง่าย: คนไม่เขียนโค้ดสามารถเริ่มใช้ได้ไวไหม? หน้าตาเข้าใจง่ายหรือเปล่า?
- ระบบอัตโนมัติและฟีเจอร์: รองรับ pagination, subpages, scheduling และคอนเทนต์แบบ dynamic ไหม?
- ความสามารถในการรองรับสเกล: รับมือโปรเจกต์ใหญ่ได้หรือเหมาะกับงานเล็ก ๆ มากกว่า?
- การเชื่อมต่อข้อมูล: ส่งออกหรือเชื่อมต่อกับเครื่องมืออื่นได้สะดวกแค่ไหน?
- ราคา: มีแพ็กเกจฟรีไหม? เหมาะกับ SMB และขยายไปองค์กรได้หรือไม่?
- การสนับสนุนและคอมมูนิตี้: มีบทเรียน เทมเพลต และความช่วยเหลือจริงเมื่อคุณต้องการหรือไม่?
ผมยังดูด้วยว่าแต่ละบริษัทมีจุดเด่นเฉพาะอะไร เพราะบางครั้งเครื่องมือที่ “ดีที่สุด” คือเครื่องมือที่เข้ากับเวิร์กโฟลว์ของคุณที่สุด ไม่ใช่แค่ตัวที่มีฟีเจอร์เยอะที่สุด
เอาล่ะ ไปดูรายชื่อกันเลย
1. Thunderbit
 Thunderbit คือ AI web scraper ที่ผมตื่นเต้นที่สุดสำหรับปี 2026—ไม่ใช่แค่เพราะผมมีส่วนร่วมในการสร้างมัน! Thunderbit ออกแบบมาสำหรับผู้ใช้งานสายธุรกิจที่ต้องการ “ข้อมูล” ไม่ใช่ “ความปวดหัว” ส่วนขยาย Chrome ของมันช่วยให้คุณดึงข้อมูลจากเว็บไซต์ใดก็ได้ด้วยคำสั่งภาษาธรรมชาติและคำแนะนำฟิลด์จาก AI ไม่ต้องเขียนโค้ด ไม่ต้องใช้เทมเพลต ไม่ต้องเครียด
ทำไม Thunderbit ถึงโดดเด่น:
- ดึงข้อมูลได้ในคลิกเดียว: แค่กด “One-Click Extract” แล้วให้ AI ของ Thunderbit จัดการต่อ
- รองรับ Subpage และ Pagination: ดึงรายการหลักได้ง่าย แล้วให้ AI เข้าไปเก็บรายละเอียดจากแต่ละหน้าต่อ
- เทมเพลตพร้อมใช้ทันที: สำหรับเว็บไซต์ยอดนิยมอย่าง Amazon, Zillow, Shopify ฯลฯ ใช้เทมเพลตสำเร็จรูปเพื่อดึงข้อมูลได้ในคลิกเดียว
- ส่งออกข้อมูลฟรี: Export ไปยัง Excel, Google Sheets, Notion หรือ Airtable ได้โดยไม่มี paywall มากั้นข้อมูลของคุณ
- AI Data Enrichment: ติดป้าย กำหนดหมวดหมู่ และแปลข้อมูลได้ระหว่างดึงข้อมูล
- ตั้งเวลาและดึงข้อมูลบนคลาวด์: ตั้งงานแบบทำซ้ำหรือรันบนคลาวด์เพื่อความเร็ว
- มีแพ็กเกจฟรีจริง: ดึงได้ฟรีสูงสุด 6 หน้า หรือ 10 หน้าเมื่อได้ trial boost แพ็กเกจเสียเงินเริ่มต้นที่ $15/เดือน
Thunderbit ได้รับความไว้วางใจจากผู้ใช้กว่า 200,000 คนทั่วโลก ตั้งแต่ทีมขายไปจนถึงผู้ประกอบการอีคอมเมิร์ซ ถ้าคุณอยากได้ประสบการณ์ web scraping ที่ง่ายและเป็นมิตรกับผู้ใช้ที่สุดในปี 2026 Thunderbit ถือว่าเป็นตัวเลือกที่ยากจะมีใครสู้ได้
อยากดูว่ามันทำงานยังไง? ดาวน์โหลดส่วนขยาย Chrome แล้วลองด้วยตัวเองได้เลย
2. Scrapy
 Scrapy คือเฟรมเวิร์ก Python แบบโอเพนซอร์สที่นักพัฒนาหลายคนเลือกใช้เมื่ออยากควบคุมทุกอย่างได้เต็มที่ มันทรงพลัง ยืดหยุ่น และผ่านศึกมาหนัก ตั้งแต่งาน crawl เว็บเล็ก ๆ ไปจนถึงการดึงข้อมูลหลายล้านหน้า
เหมาะกับ: ทีมเทคนิค วิศวกรข้อมูล และคนที่ใช้ Python ได้คล่อง
ฟีเจอร์เด่น:
- สร้างกฎแบบกำหนดเอง: สร้าง spider ให้รองรับโครงสร้างเว็บไซต์ได้ทุกรูปแบบ
- รองรับงานขนาดใหญ่และทำงานเร็ว: จัดการงานดึงข้อมูลระดับใหญ่ได้ พร้อมระบบจัดการ error ที่แข็งแรง
- เชื่อมกับระบบนิเวศ Python ได้ดี: ใช้ร่วมกับ Pandas, Jupyter และเครื่องมืออื่น ๆ ได้ง่าย
- ฟรีและโอเพนซอร์ส: ไม่มีค่าไลเซนส์ และมีคอมมูนิตี้ใหญ่ช่วยสนับสนุน
ข้อควรรู้: Scrapy มีเส้นโค้งการเรียนรู้พอสมควร ถ้าคุณไม่ได้เขียนโค้ด เครื่องมือนี้อาจไม่ใช่คำตอบที่เหมาะที่สุด แต่สำหรับนักพัฒนาแล้ว มันคือเครื่องมือทรงพลังตัวจริง (ScraperAPI).
3. ParseHub
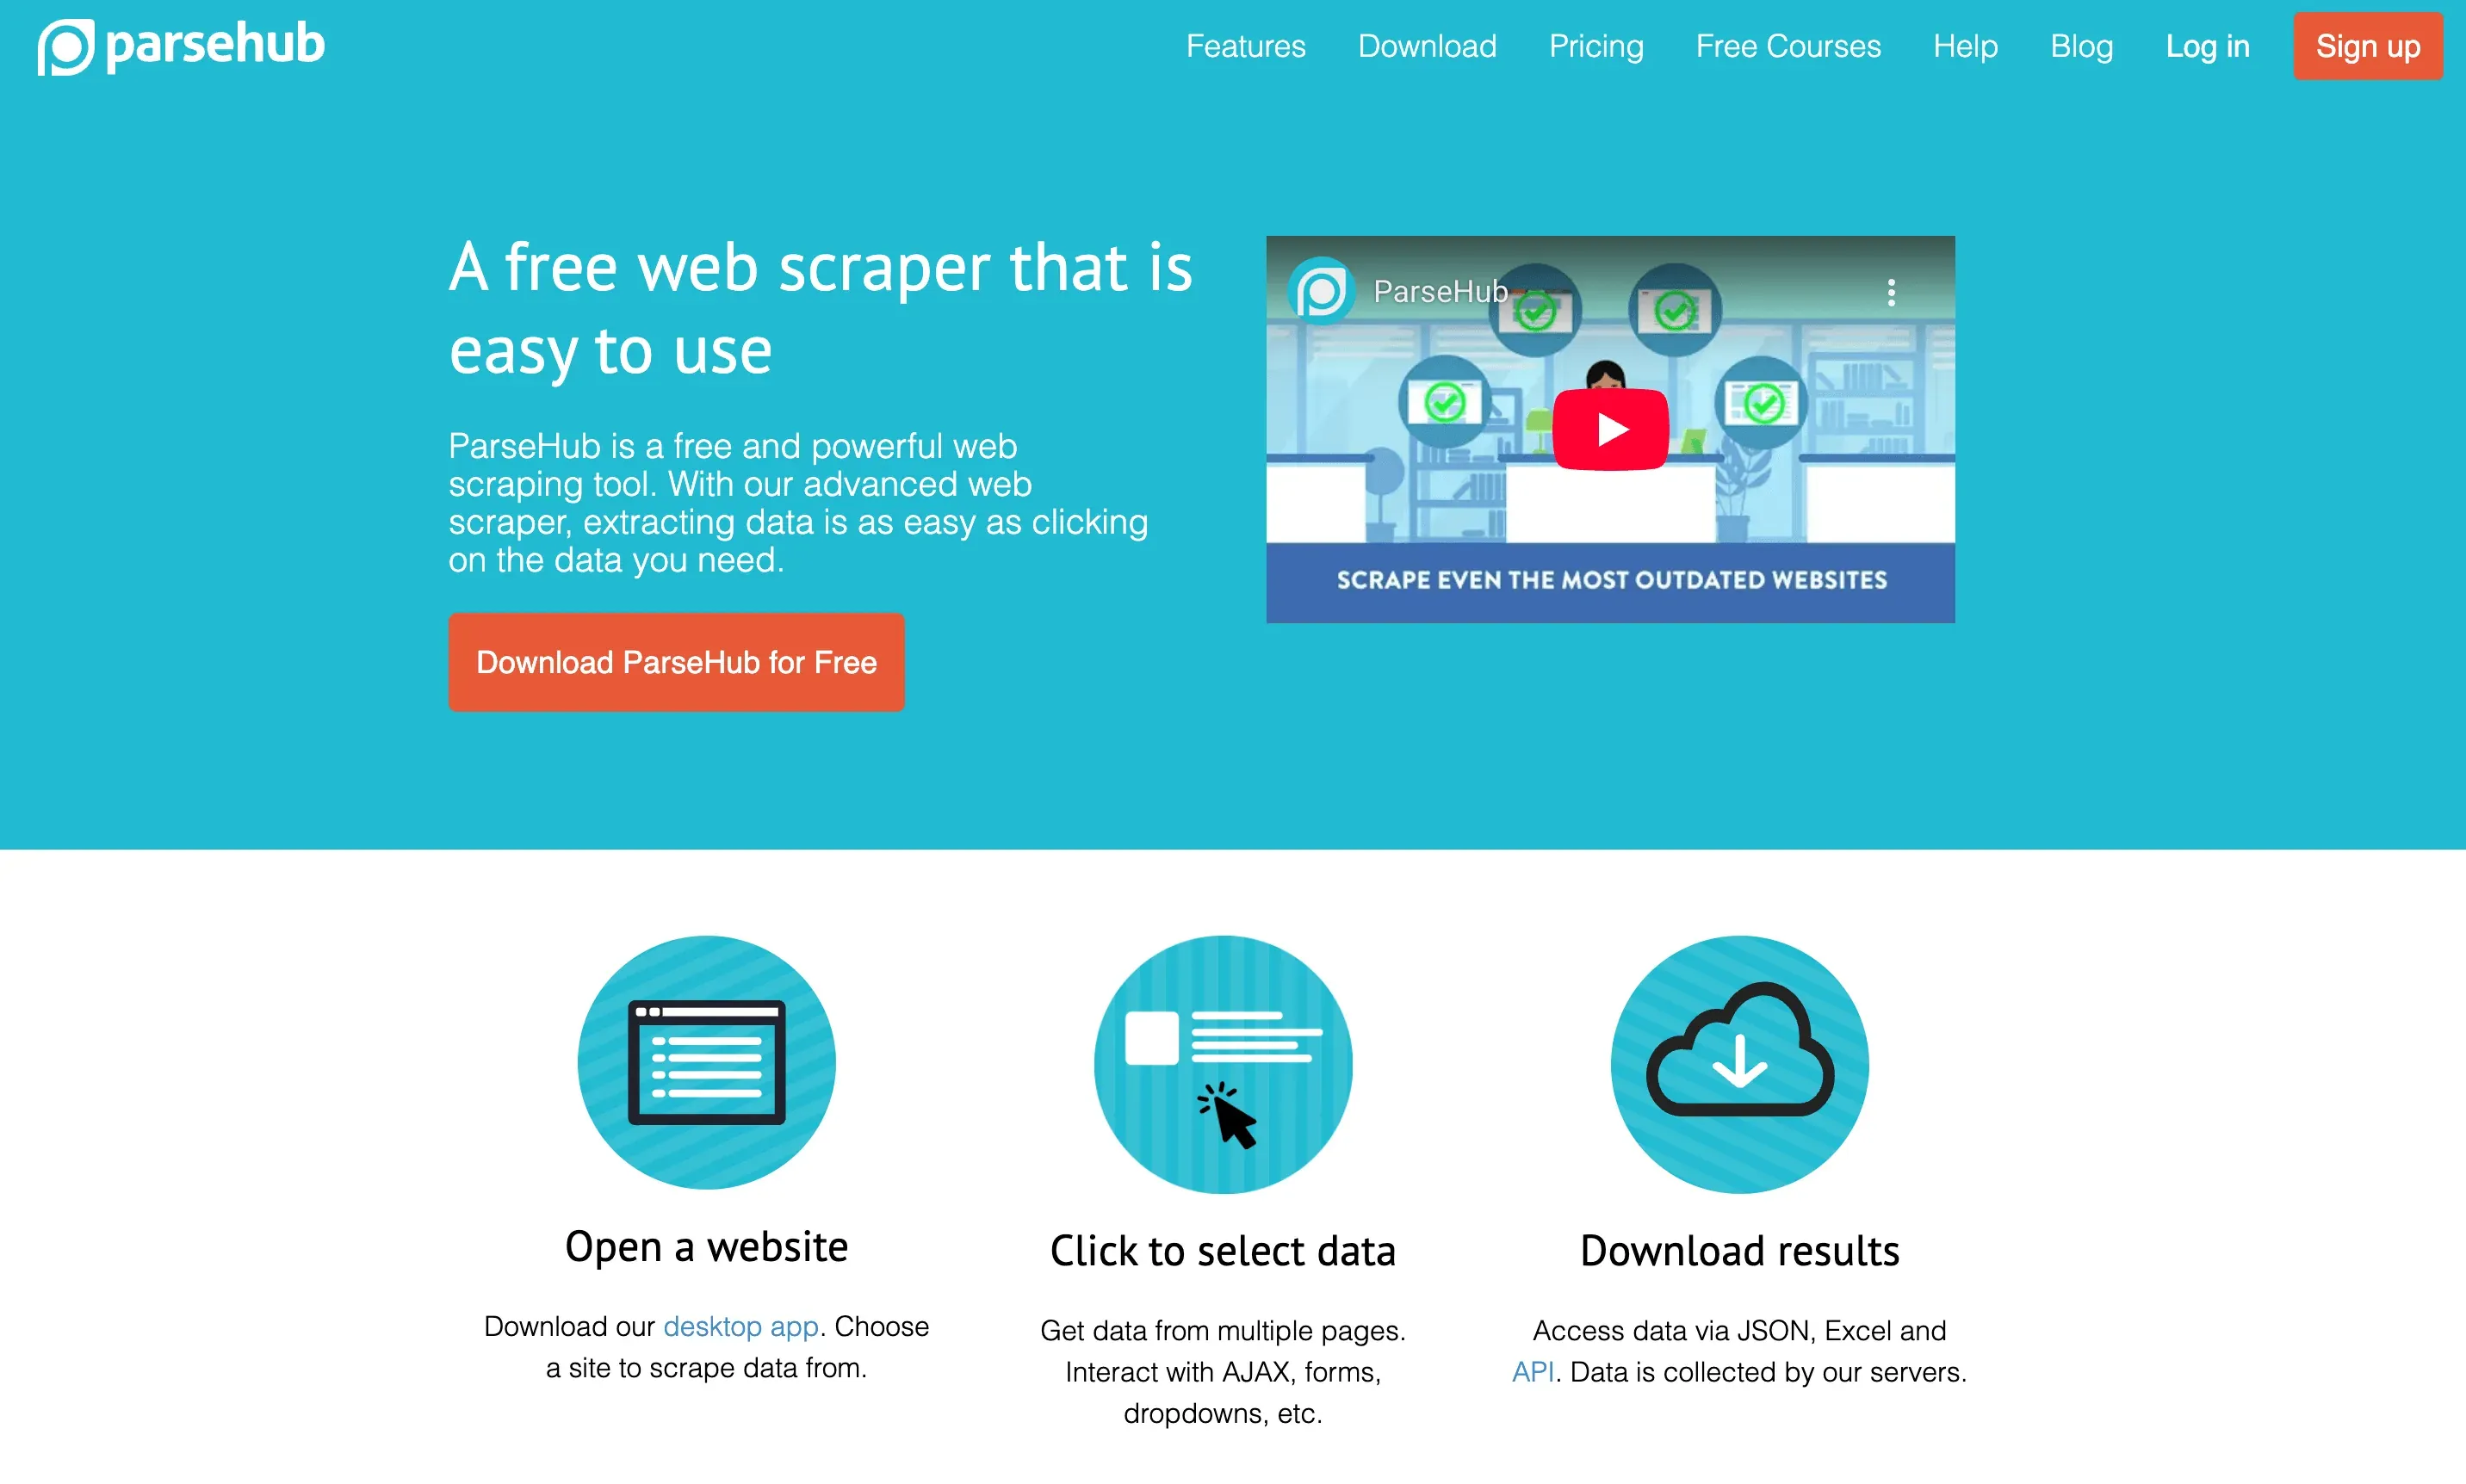 ParseHub คือแอปเดสก์ท็อปที่ทำให้การดึงข้อมูลจากเว็บดูเป็นภาพและเข้าถึงง่าย จุดเด่นคืออินเทอร์เฟซแบบ point-and-click ที่ช่วยให้คุณสร้างตัวดึงข้อมูลได้โดยไม่ต้องเขียนโค้ด
เหมาะกับ: SMB, นักวิจัย และผู้ใช้ที่ไม่เขียนโค้ดแต่ต้องการความยืดหยุ่น
ฟีเจอร์เด่น:
- เวิร์กโฟลว์แบบภาพ: คลิกเลือกข้อมูลและสร้างตรรกะสำหรับ pagination กับ subpages ได้
- ตั้งเวลารันบนคลาวด์: ให้ระบบทำงานตามเวลา แม้คอมพิวเตอร์คุณจะปิดอยู่
- ตัวเลือกการส่งออก: ดาวน์โหลดเป็น CSV, Excel หรือ JSON
- แผนฟรี: 5 โปรเจกต์ และสูงสุด 200 หน้า/รอบ; แพ็กเกจเสียเงินเริ่มต้นที่ $189/เดือน
ParseHub ได้รับความนิยมมากเป็นพิเศษสำหรับการดึงข้อมูลรายการ รีวิว และข้อมูลอีคอมเมิร์ซ (ScraperAPI).
4. Octoparse
 Octoparse คือแพลตฟอร์ม web scraping แบบ no-code ที่ลากวางได้ และเน้นระบบอัตโนมัติในระดับสเกล เหมาะมากสำหรับทีมที่ต้องการตั้งค่างานซับซ้อนโดยไม่ต้องเขียนสคริปต์
เหมาะกับ: ทีมการตลาด ทีมวิจัย และทีมปฏิบัติการ
ฟีเจอร์เด่น:
- เวิร์กโฟลว์แบบลากวาง: สร้างตัวดึงข้อมูลผ่านหน้าจอ รองรับคอนเทนต์แบบ dynamic และ infinite scroll
- ดึงข้อมูลบนคลาวด์และตั้งเวลาได้: รันงานบนคลาวด์และตั้งงานซ้ำได้
- หมุน IP และกันการบล็อก: มีฟีเจอร์ในตัวสำหรับเว็บที่ดึงข้อมูลยาก
- ส่งออกไป Excel, Sheets, ฐานข้อมูล: เชื่อมเข้ากับเวิร์กโฟลว์ของคุณได้ง่าย
- แผนฟรี: สูงสุด 10,000 records/เดือน; แพ็กเกจเสียเงินเริ่มต้นที่ $83/เดือน หรือ $69/เดือนเมื่อจ่ายรายปี
Octoparse ได้รับการยอมรับในเรื่องความเร็วและความสามารถในการรับมือโปรเจกต์ขนาดใหญ่ (ScraperAPI).
5. DataMiner
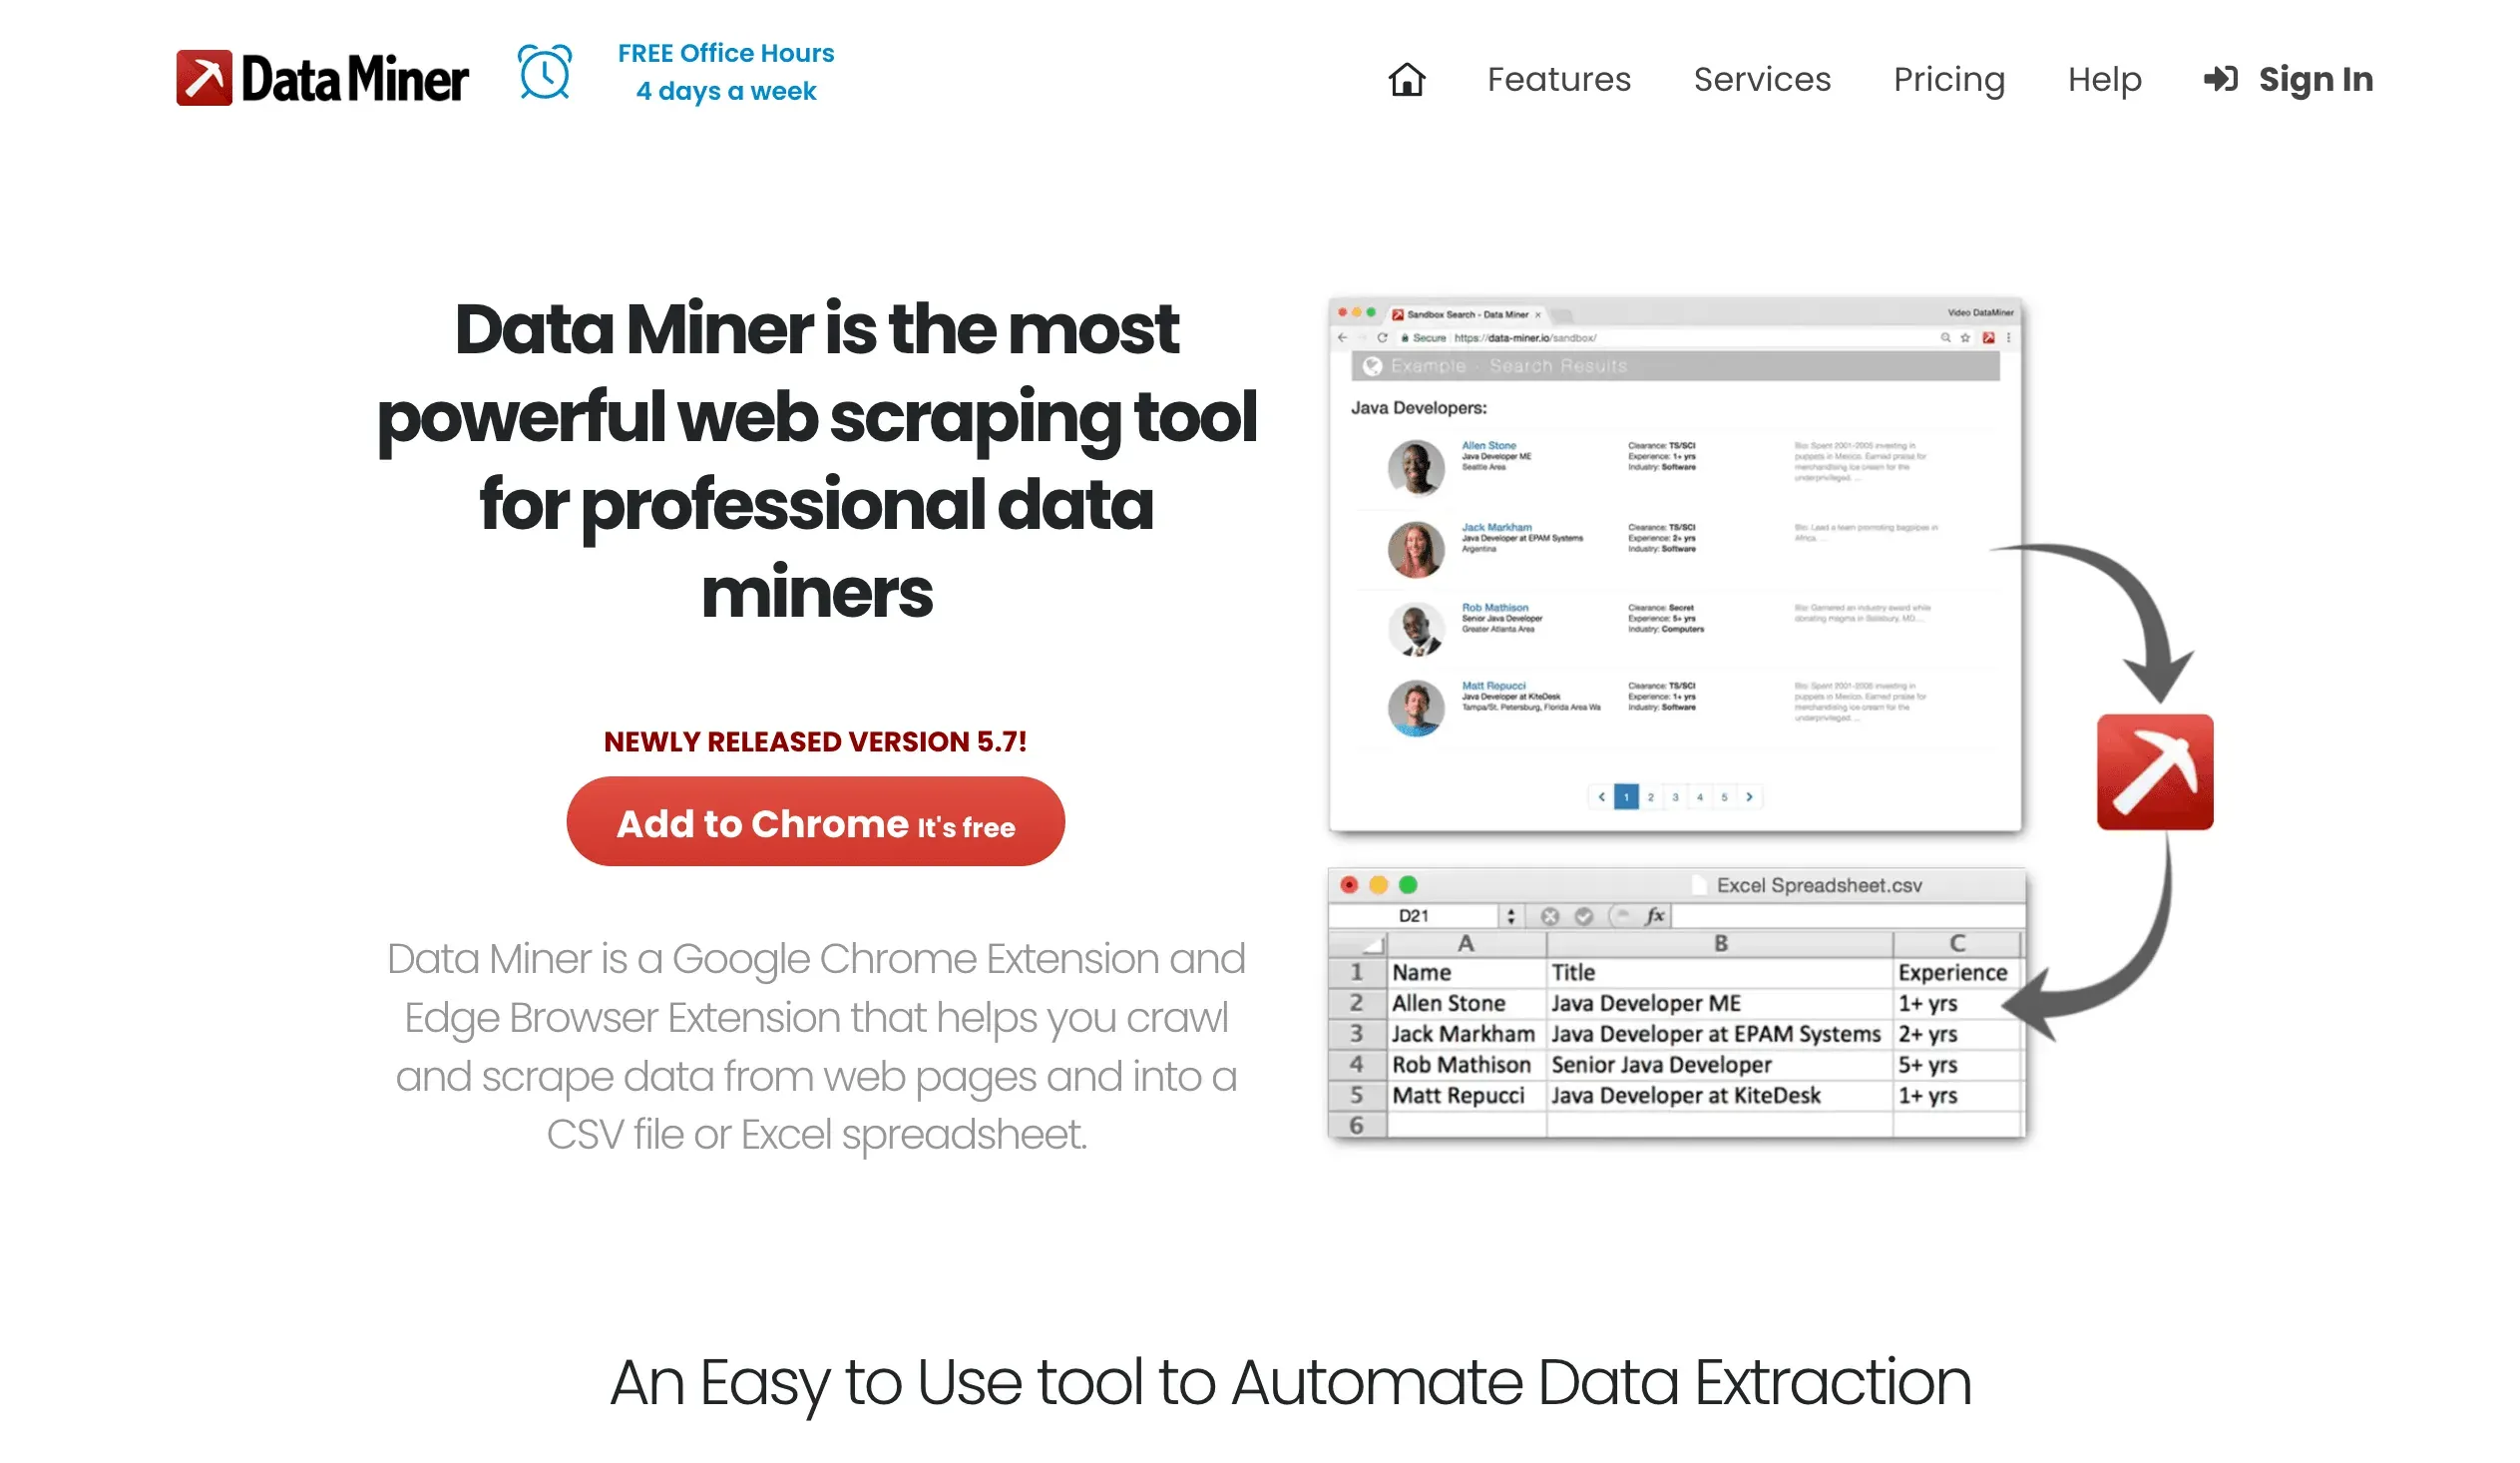 DataMiner คือส่วนขยาย Chrome ที่พา web scraping มาอยู่ในเบราว์เซอร์ของคุณ เหมาะมากสำหรับงานดึงข้อมูลเร็ว ๆ แบบใช้เทมเพลต เช่น ตาราง รายการ และเว็บที่ไม่ซับซ้อน
เหมาะกับ: ผู้ใช้ทั่วไป ทีม sales ops และคนที่ใช้ Chrome เป็นหลัก
ฟีเจอร์เด่น:
- Template Marketplace: มีสูตรสำเร็จมากกว่า 60,000 แบบสำหรับเว็บไซต์ยอดนิยม
- ดึงข้อมูลแบบ point-and-click: เลือกข้อมูลผ่านหน้าจอได้ ไม่ต้องเขียนโค้ด
- ส่งออกไป Excel/Google Sheets: Export ได้ด้วยคลิกเดียว
- แผนฟรี: 500 หน้า/เดือน; แพ็กเกจเสียเงินเริ่มต้นที่ $19/เดือน
DataMiner เป็นตัวเลือกโปรดสำหรับงานเร็ว ๆ และผู้ใช้ที่ไม่ถนัดด้านเทคนิค (DataMiner).
6. Import.io
 Import.io คือแพลตฟอร์มระดับองค์กรที่มุ่งเปลี่ยนคอนเทนต์บนเว็บให้เป็นข้อมูลโครงสร้างสำหรับงานวิเคราะห์และ business intelligence
เหมาะกับ: องค์กรที่มีความต้องการข้อมูลขนาดใหญ่และต้องเชื่อมต่อหลายระบบ
ฟีเจอร์เด่น:
- บริการแบบจัดการให้: ทีมของ Import.io สามารถสร้างและดูแลตัวดึงข้อมูลให้คุณได้
- UI แบบภาพ: สร้าง workflow การดึงข้อมูลได้โดยไม่ต้องเขียนโค้ด
- เข้าถึงผ่าน API: นำข้อมูลที่ดึงมาไปเชื่อมกับแอปและแดชบอร์ดได้โดยตรง
- ความปลอดภัยและการปฏิบัติตามข้อกำหนด: มีเครื่องมือระดับองค์กร เช่น การควบคุม PII masking และอื่น ๆ
ราคา: ขอใบเสนอราคาแบบกำหนดเอง โดยทั่วไปเริ่มราว $199/เดือน (PromptCloud).
7. Apify
 Apify คือแพลตฟอร์ม automation ที่เป็นมิตรกับนักพัฒนา มี marketplace ขนาดใหญ่ของ “Actors” หรือบอตดึงข้อมูลสำเร็จรูป และยังสร้าง workflow เองได้ตามต้องการ
เหมาะกับ: นักพัฒนา เอเจนซี และทีมที่อยากได้ความยืดหยุ่น
ฟีเจอร์เด่น:
- Actor Marketplace: มีตัวดึงข้อมูลสำเร็จรูปสำหรับเว็บไซต์ยอดนิยม หรือจะสร้างของตัวเองก็ได้
- โครงสร้างคลาวด์: รันงานดึงข้อมูลในสเกลใหญ่ ตั้งเวลา และเชื่อมต่อ API ได้
- เชื่อมกับ GitHub: ทำ workflow และ CI/CD อัตโนมัติ
- จ่ายตามการใช้งาน: มีเครดิตฟรี แล้วคิดค่าบริการตามการใช้งาน; แพ็กเกจเสียเงินเริ่มต้นที่ $29/เดือน
Apify เหมาะทั้งกับโปรเจกต์ง่ายและโปรเจกต์ซับซ้อน (Black Bear Media).
8. Diffbot
 Diffbot ใช้ AI และ knowledge graph เพื่อแปลงคอนเทนต์เว็บที่ไม่มีโครงสร้าง ให้กลายเป็นข้อมูลแบบมีโครงสร้างและเครื่องอ่านได้ มองง่าย ๆ นี่คือ “สมอง” ของโลก web scraping
เหมาะกับ: องค์กร นักวิจัย และคนที่ต้องการการดึงข้อมูลอัตโนมัติในสเกลใหญ่
ฟีเจอร์เด่น:
- AI-driven extraction: จดจำบทความ สินค้า องค์กร และอื่น ๆ ได้อัตโนมัติ
- Knowledge Graph: เข้าถึงกราฟข้อมูลเว็บที่ใหญ่ที่สุดในโลกผ่าน API
- Data Enrichment: ดึงหน่วยข้อมูลที่เกี่ยวข้อง ข่าว และบริบทเพิ่มเติมเข้ามาได้
- API-first: เชื่อมเข้ากับเครื่องมือ BI และ data pipeline ได้ง่าย
ราคา: เริ่มต้นที่ $299/เดือน (Diffbot Pricing).
9. WebHarvy
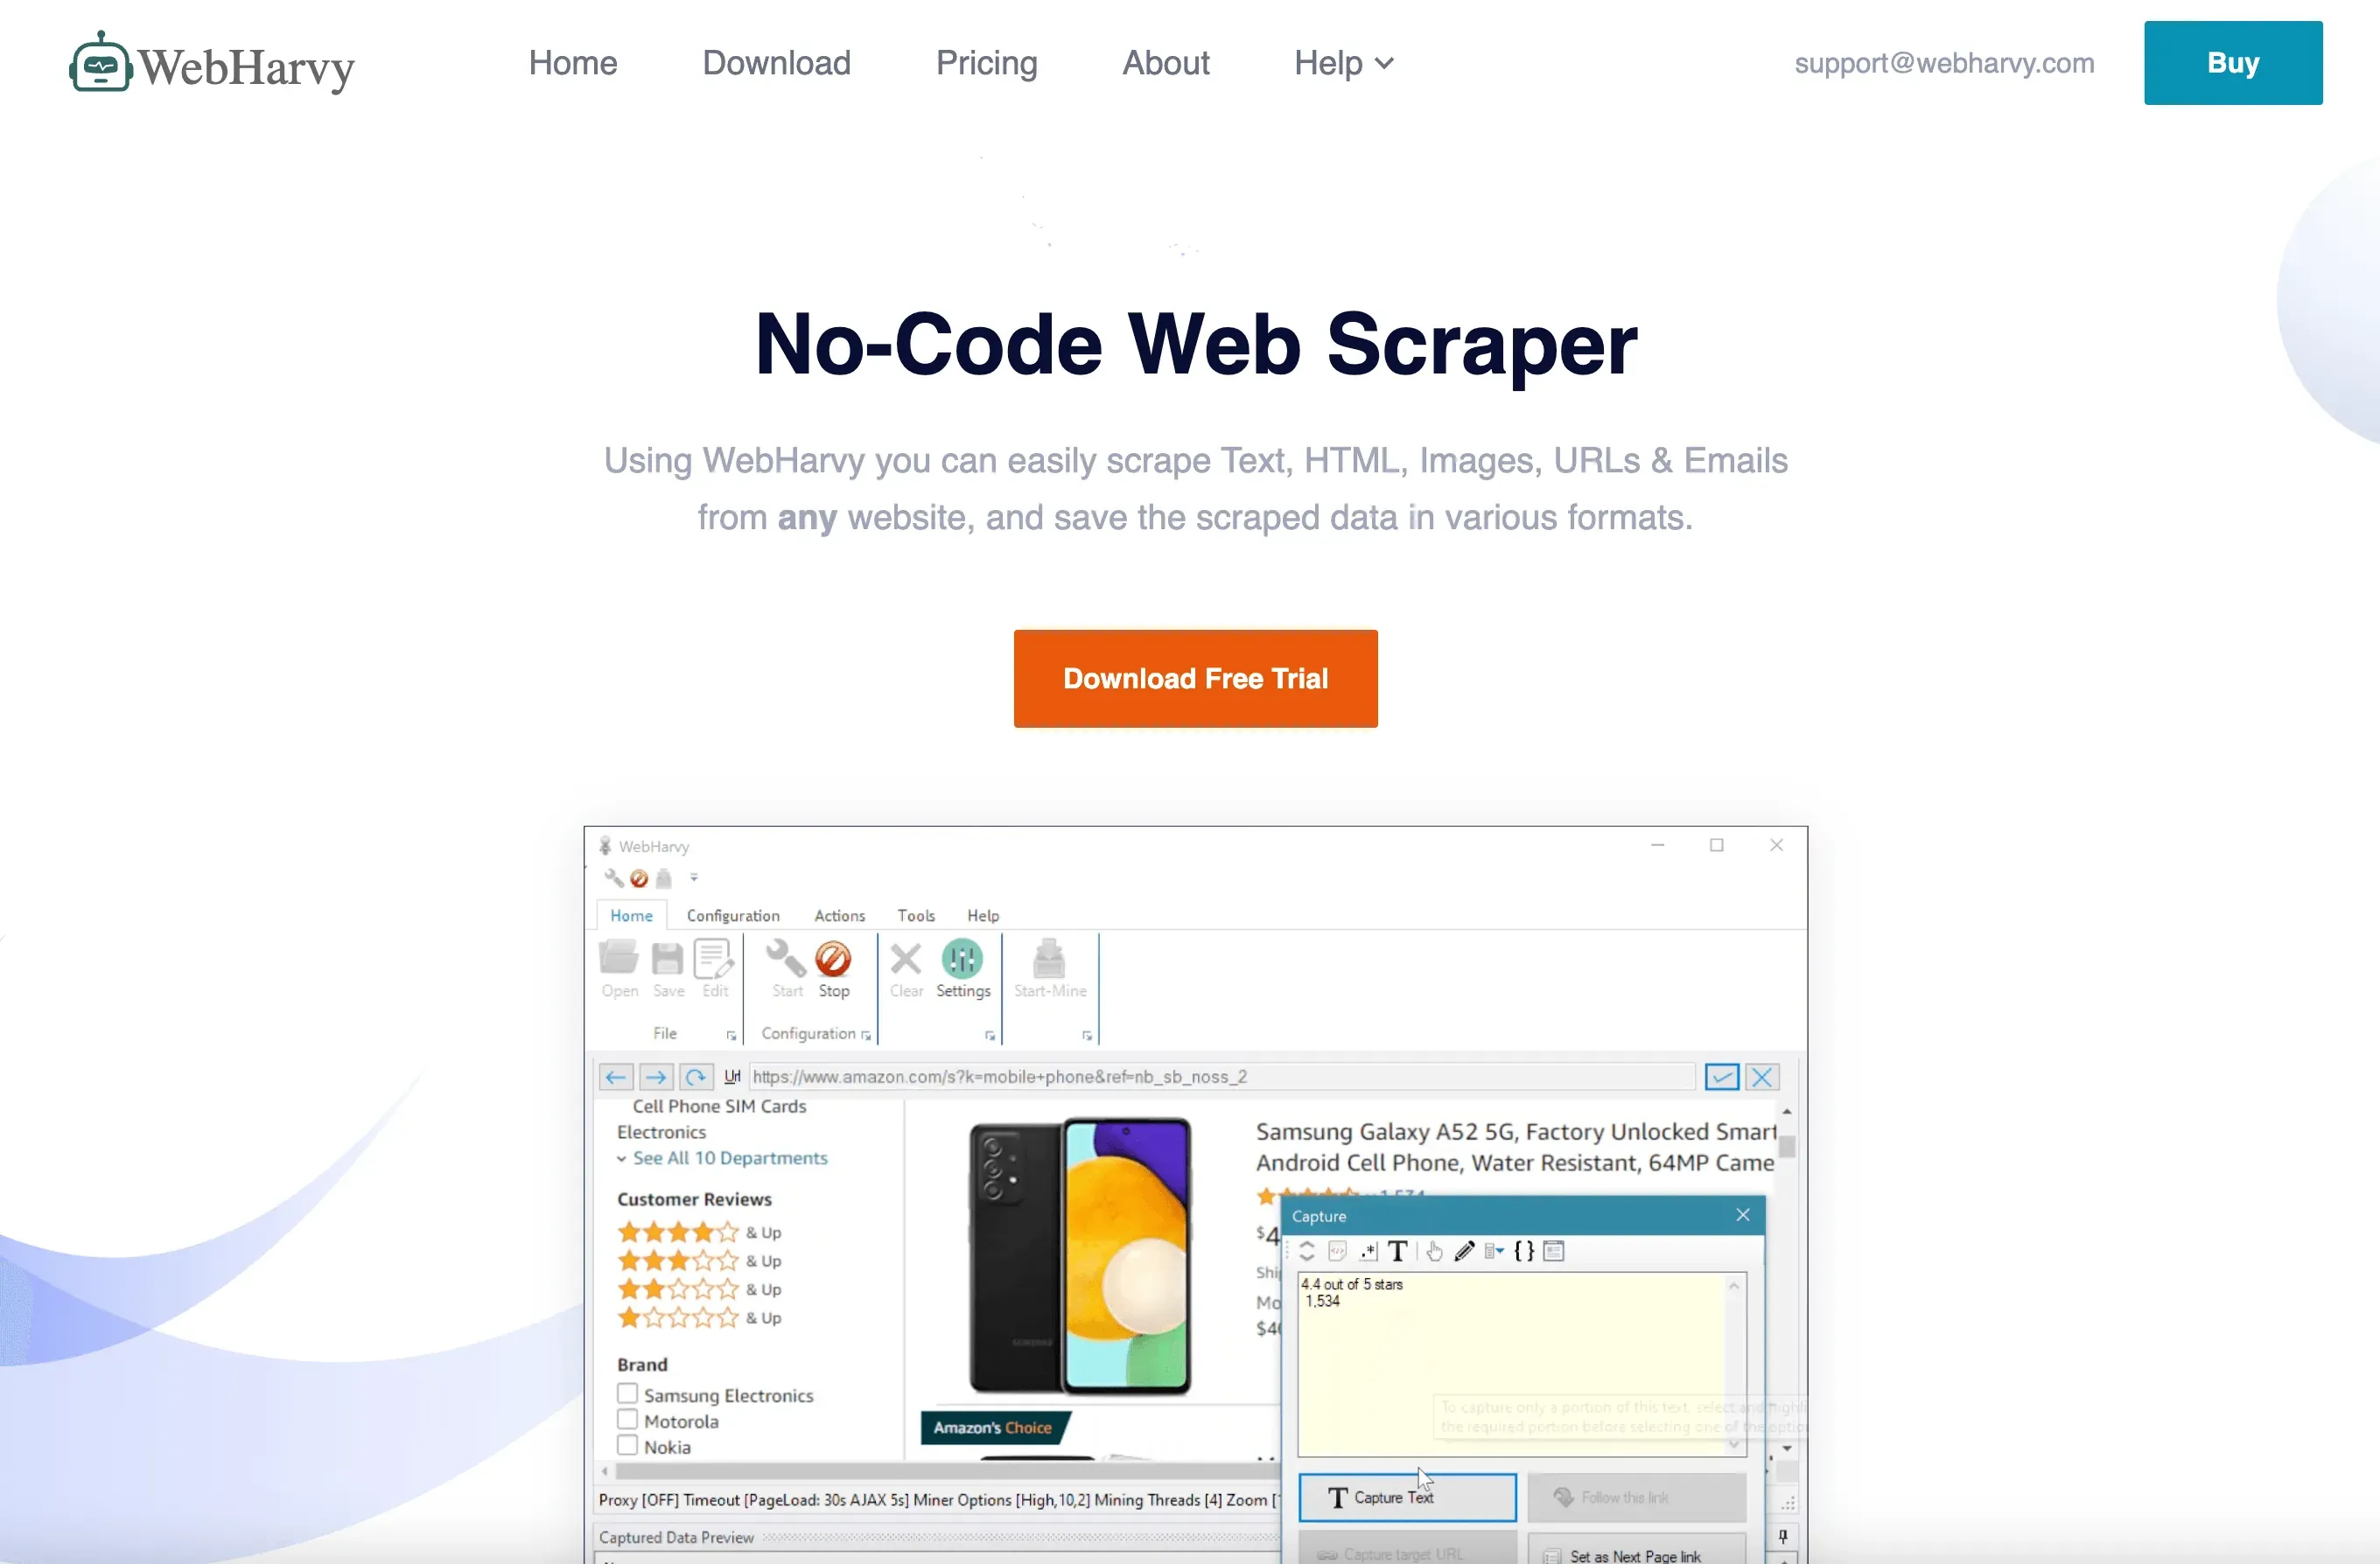 WebHarvy คือโปรแกรมดึงข้อมูลบน Windows แบบเดสก์ท็อปที่มีอินเทอร์เฟซภาพและใช้งานแบบ point-and-click เหมาะสำหรับคนที่อยากเลี่ยงการเขียนโค้ดและชอบแอปบนเครื่อง
เหมาะกับ: ผู้ใช้ Windows นักวิจัย และ SMB
ฟีเจอร์เด่น:
- เลือกข้อมูลด้วยภาพ: คลิกที่ข้อมูลเพื่อกำหนดฟิลด์ได้ ไม่ต้องเขียนโค้ด
- รองรับรูปภาพและการนำทางหลายหน้า: ดึงทั้งข้อความ รูปภาพ และตาม pagination ได้
- ส่งออกไป Excel, XML, ฐานข้อมูล: มีตัวเลือกการส่งออกที่ยืดหยุ่น
- จ่ายครั้งเดียว ใช้ได้ตลอด: ซื้อไลเซนส์ครั้งเดียวแล้วใช้ต่อได้ยาว ๆ (WebHarvy).
WebHarvy ได้รับความนิยมเป็นพิเศษสำหรับการดึงข้อมูลจากเว็บไซต์อีคอมเมิร์ซและเว็บประกาศซื้อขาย (Thunderbit Blog).
10. Mozenda
 Mozenda คือแพลตฟอร์มบนคลาวด์ที่สร้างมาเพื่อการดึงข้อมูลและระบบอัตโนมัติระดับองค์กร
เหมาะกับ: องค์กรขนาดใหญ่ และอุตสาหกรรมที่ต้องการความสอดคล้องตามข้อกำหนดสูง
ฟีเจอร์เด่น:
- ระบบอัตโนมัติบนคลาวด์: ตั้งเวลา เฝ้าดู และจัดการงานดึงข้อมูลจากศูนย์กลาง
- แปลงข้อมูล: ทำความสะอาด เพิ่มคุณค่า และส่งออกข้อมูลได้หลายรูปแบบ
- ทำงานร่วมกันเป็นทีม: รองรับผู้ใช้หลายคนและการจัดการเวิร์กโฟลว์
- ซัพพอร์ตระดับองค์กร: ความสอดคล้องตามข้อกำหนด ความเสถียร และการช่วยเหลือเฉพาะทาง (Appvizer).
ราคา: ประมาณ $99/เดือน และมีราคาแบบองค์กร
11. Sequentum (เดิมชื่อ Content Grabber)
 Sequentum คือเครื่องมือดึงข้อมูลระดับสูงทั้งแบบเดสก์ท็อปและเว็บ สำหรับมืออาชีพด้านข้อมูลและเอเจนซี ถ้าคุณเคยรู้จักมันในชื่อ Content Grabber ชื่อนั้นได้หายไปแล้ว—Sequentum เปลี่ยนชื่อผลิตภัณฑ์ และ contentgrabber.com ก็ไม่ตอบสนองอีกต่อไป (Sequentum FAQ).
เหมาะกับ: ผู้เชี่ยวชาญด้านข้อมูล เอเจนซี และคนที่ต้องการระบบอัตโนมัติขั้นลึก
ฟีเจอร์เด่น:
- สคริปต์ขั้นสูง: ทำงานดึงข้อมูลที่ซับซ้อนได้อัตโนมัติ
- รายงานและการติดตาม: ติดตามงาน รับการแจ้งเตือน และบริหารโปรเจกต์ใหญ่ได้
- การเชื่อมต่อ: ส่งออกไปฐานข้อมูล API หรือคลาวด์สตอเรจได้
- ไม่มีแพ็กเกจฟรี: มีแต่ไลเซนส์แบบเสียเงิน (DataOX).
Sequentum สร้างมาเพื่อการดึงข้อมูลปริมาณสูงที่ปรับแต่งได้
12. Helium Scraper
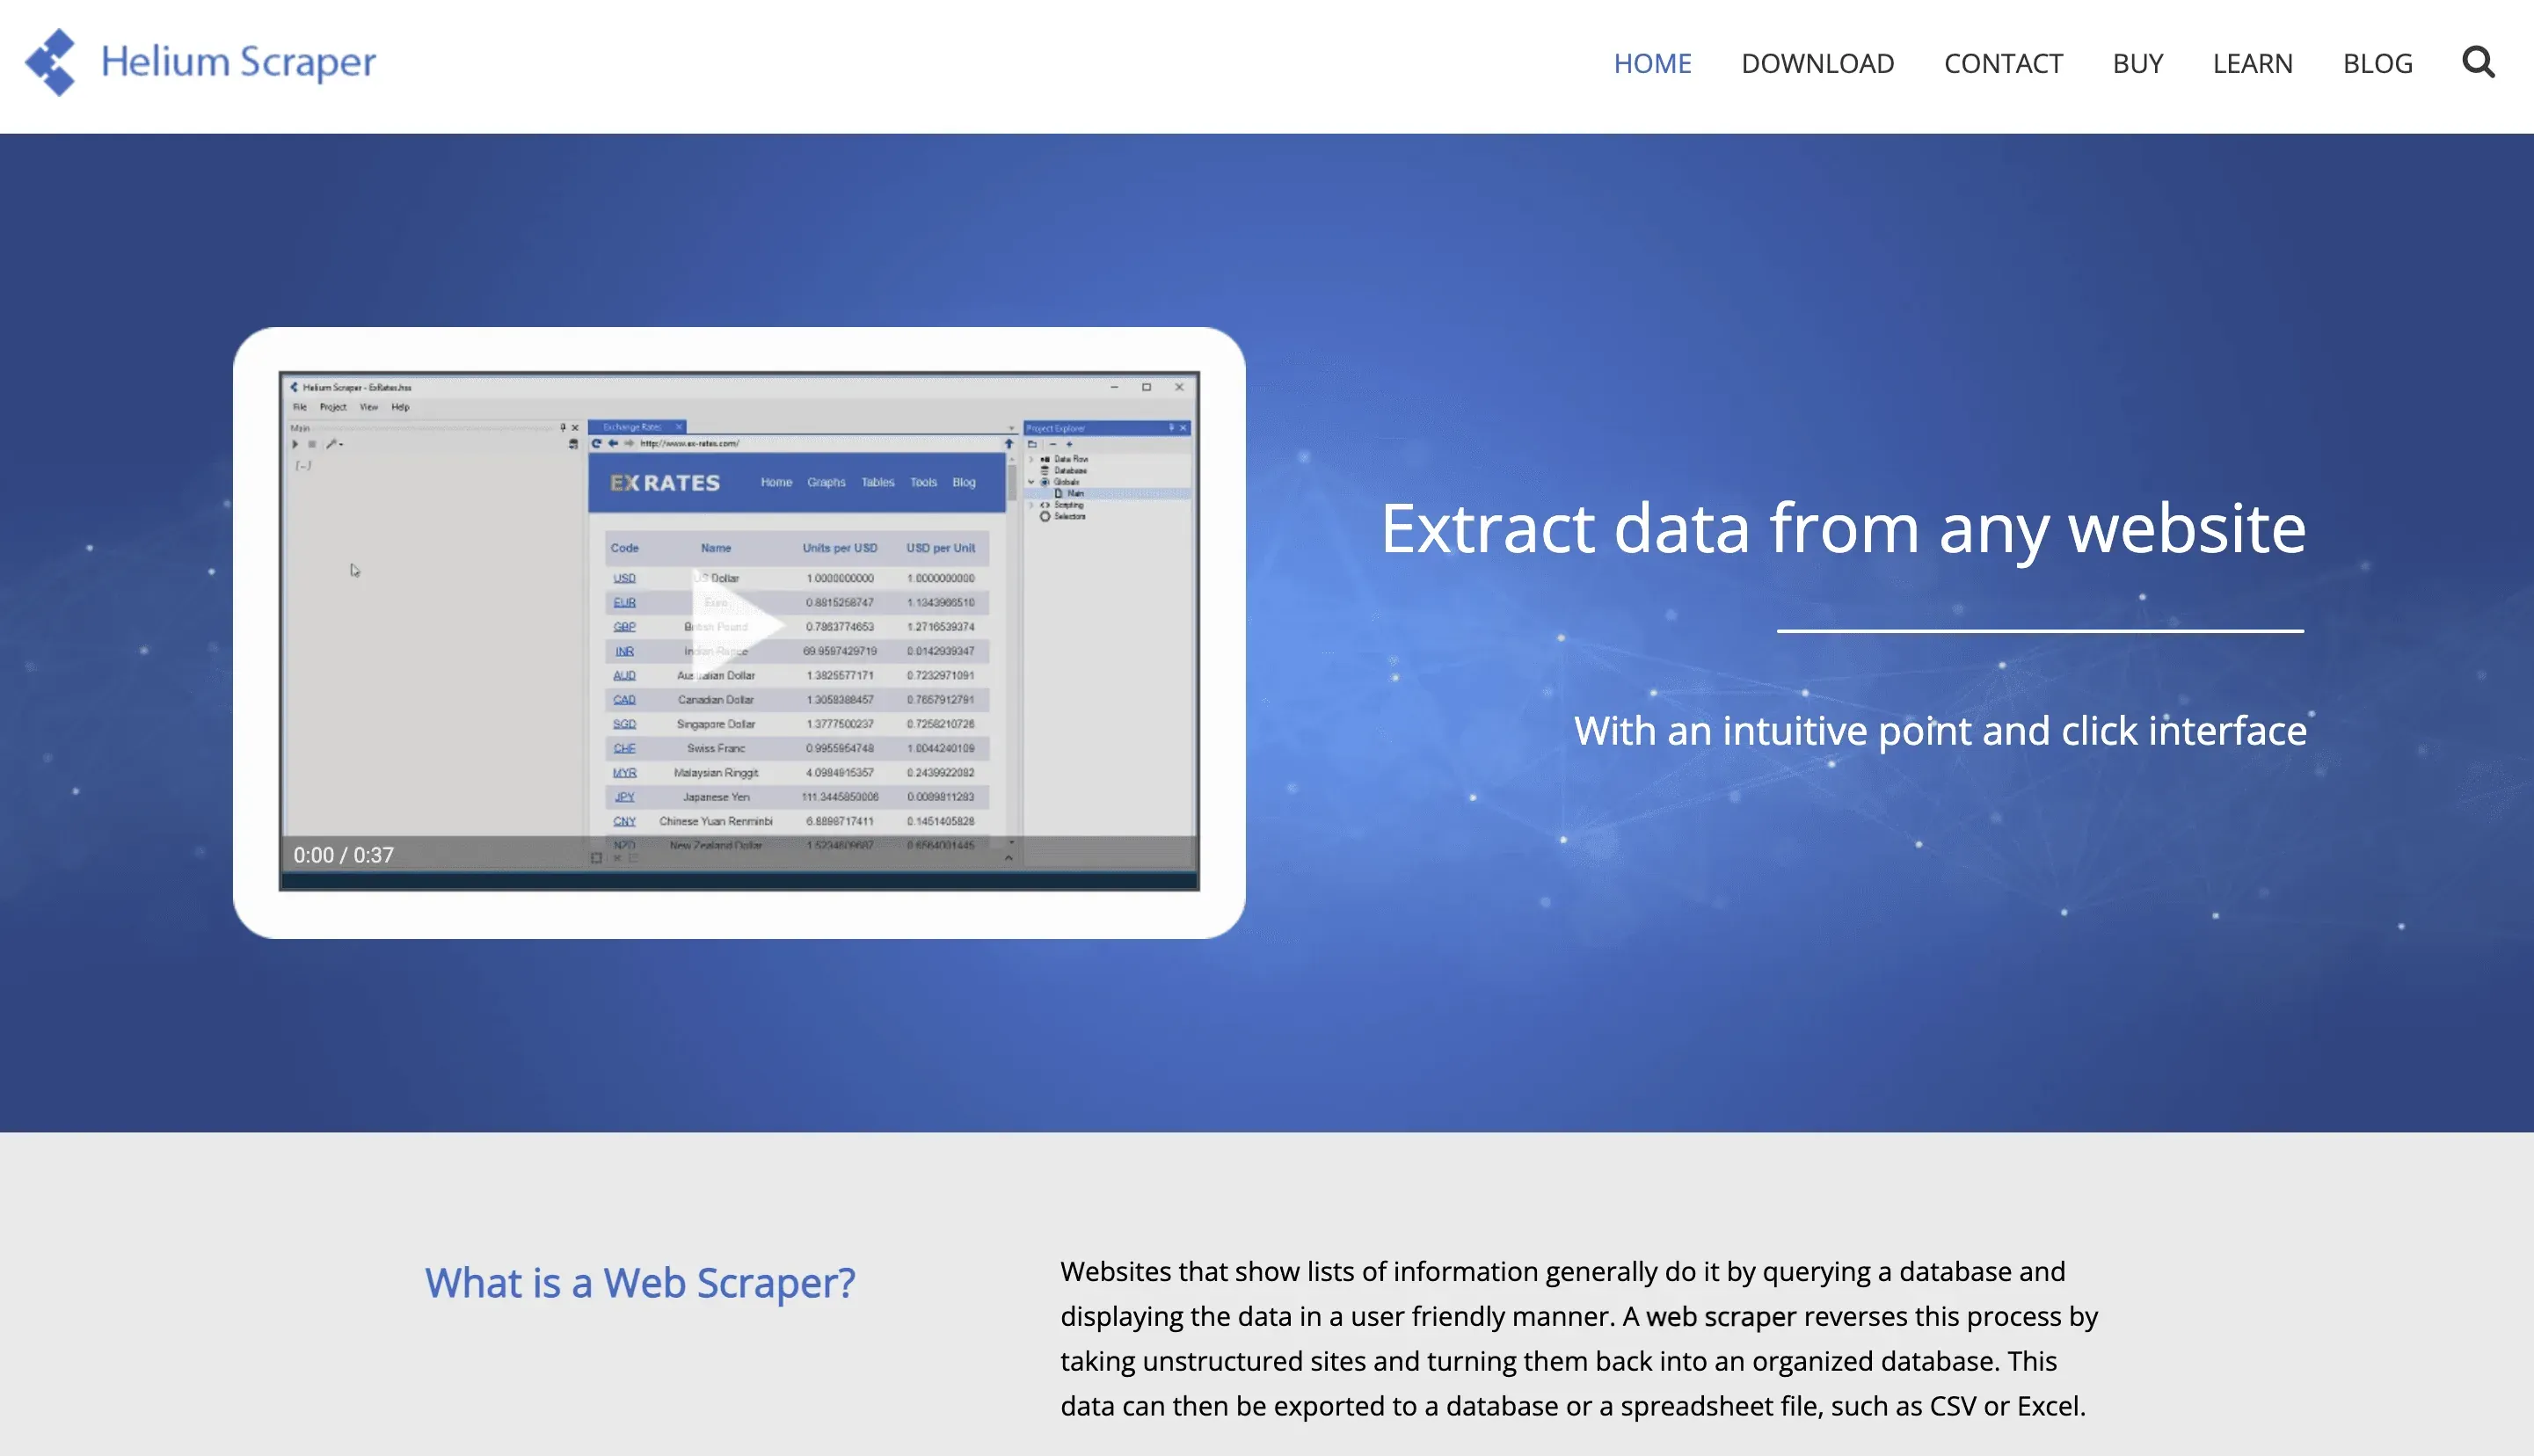 Helium Scraper คือเครื่องมือเดสก์ท็อปที่มีตัวสร้างเวิร์กโฟลว์แบบภาพ เหมาะสำหรับการดึงข้อมูลจากเว็บที่ซับซ้อนและเปลี่ยนแปลงตลอดเวลา
เหมาะกับ: ผู้ใช้ระดับสูง นักวิเคราะห์ และคนที่ต้องการความยืดหยุ่นโดยไม่ต้องเขียนโค้ด
ฟีเจอร์เด่น:
- เวิร์กโฟลว์แบบภาพ: อินเทอร์เฟซลากวางเพื่อสร้างตรรกะการดึงข้อมูล
- รองรับคอนเทนต์แบบ dynamic: ใช้งานได้ดีกับเว็บที่ใช้ JavaScript หนัก ๆ
- แปลงข้อมูล: ทำความสะอาดและจัดระเบียบข้อมูลก่อนส่งออก
- ตัวเลือกการส่งออก: Excel, CSV, ฐานข้อมูล และอื่น ๆ
- จ่ายครั้งเดียว: ไลเซนส์แบบถาวรเริ่มตั้งแต่ $99 (Basic, 1 ผู้ใช้) ถึง $699 (Enterprise, 10 ผู้ใช้)—ไม่มีค่าสมาชิก (Helium Scraper).
Helium Scraper เหมาะเป็นพิเศษกับเว็บที่ไม่มาตรฐานและเวิร์กโฟลว์แบบกำหนดเอง
เปรียบเทียบบริษัท Web Scraping ชั้นนำ: ฟีเจอร์แบบรวบยอด
นี่คือภาพรวมแบบเทียบกันชัด ๆ เพื่อช่วยให้คุณเลือกตัวที่เหมาะที่สุด:
| บริษัท | เหมาะกับ | ใช้งานง่าย | ระบบอัตโนมัติและ AI | รองรับสเกล | ตัวเลือกการส่งออก | แพ็กเกจฟรี / ราคา |
|---|---|---|---|---|---|---|
| Thunderbit | ผู้ไม่เขียนโค้ด, SMBs | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, Sheets, Notion | ฟรี (6 หน้า), $15/เดือนขึ้นไป |
| Scrapy | นักพัฒนา | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Python, CSV, DB | ฟรี, โอเพนซอร์ส |
| ParseHub | SMBs, นักวิจัย | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | CSV, Excel, JSON | ฟรี (5 โปรเจกต์), $189+ |
| Octoparse | ทีม ops, การตลาด | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, DB, API | ฟรี (10k แถว), $69+ |
| DataMiner | ผู้ใช้ Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, Sheets | ฟรี (500 หน้า), $19+ |
| Import.io | องค์กร | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, Cloud | ปรับตามความต้องการ, $199+/เดือน |
| Apify | นักพัฒนา, เอเจนซี | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, Sheets | เครดิตฟรี, $29+/เดือน |
| Diffbot | งานวิจัย, analytics | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, Knowledge Graph | $299+/เดือน |
| WebHarvy | ผู้ใช้ Windows | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, XML, DB | จ่ายครั้งเดียว, $129+ |
| Mozenda | องค์กร | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Excel, API, Cloud | $99+/เดือน, สำหรับองค์กร |
| Sequentum | ผู้เชี่ยวชาญข้อมูล, เอเจนซี | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | DB, API, Cloud | มีแต่ไลเซนส์แบบเสียเงิน |
| Helium Scraper | ผู้ใช้ระดับสูง, นักวิเคราะห์ | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | Excel, CSV, DB | จ่ายครั้งเดียว, เริ่มที่ $99 |
ตัวเลือกแนะนำแบบเร็ว ๆ:
- สำหรับคนไม่เขียนโค้ด: Thunderbit, DataMiner, ParseHub, WebHarvy
- สำหรับนักพัฒนา: Scrapy, Apify, Sequentum
- สำหรับองค์กร: Import.io, Diffbot, Mozenda
- สำหรับเวิร์กโฟลว์แบบภาพที่ยืดหยุ่น: Thunderbit, Octoparse, Helium Scraper
สรุป: จะเลือกพาร์ตเนอร์ Web Scraping แบบไหนดีสำหรับธุรกิจของคุณ
สำรวจคู่มือ web scraping เพิ่มเติม Get Started Free
web scraping ในปี 2026 ไม่ได้มีไว้สำหรับสายเทคนิคอีกต่อไป—แต่มันคือความสามารถหลักของธุรกิจสำหรับใครก็ตามที่ต้องใช้ข้อมูลเพื่อการตัดสินใจที่ฉลาดและเร็วกว่า บริษัท web scraping ที่เหมาะสมช่วยคุณประหยัดเวลา เพิ่ม ROI และปลดล็อก insight ที่คู่แข่งอาจมองข้าม
คำแนะนำของผมคือ:
- เลือกเครื่องมือให้ตรงกับทีม: ผู้ใช้ที่ไม่ถนัดเทคนิคจะชอบ Thunderbit หรือ DataMiner นักพัฒนาควรดู Scrapy หรือ Apify ส่วนองค์กรลองพิจารณา Import.io หรือ Diffbot
- คิดเรื่องสเกลและการเชื่อมต่อ: คุณต้องดึงข้อมูลจากหลายพันหน้าหรือไม่? อยากได้ข้อมูลเข้า Sheets, Notion หรือ CRM ของคุณเลยไหม?
- เริ่มจากทดลองใช้ฟรี: เครื่องมือส่วนใหญ่มักมีแพ็กเกจฟรี ลองใช้กับโปรเจกต์จริงก่อนตัดสินใจ
- อย่ากลัวที่จะผสมเครื่องมือ: บางครั้งเวิร์กโฟลว์ที่ดีที่สุดเกิดจากการใช้หลายเครื่องมือร่วมกัน
และถ้าคุณพร้อมจะดูว่า web scraping ทำได้ง่ายแค่ไหน ลองใช้ Thunderbit ดูได้เลย สเปรดชีตของคุณ—and สภาพจิตใจของคุณ—จะขอบคุณคุณแน่นอน
สำหรับบทความเชิงลึก เคล็ดลับ และบทเรียนเพิ่มเติม ลองเข้าไปดู Thunderbit Blog
คำถามที่พบบ่อย
1. web scraping คืออะไร และทำไมถึงสำคัญต่อธุรกิจในปี 2026?
web scraping คือกระบวนการดึงข้อมูลจากเว็บไซต์แบบอัตโนมัติ ซึ่งสำคัญต่อธุรกิจเพราะช่วยรวบรวมข้อมูลจำนวนมากได้รวดเร็ว ใช้สำหรับหาลีด ติดตามราคา วิจัยตลาด และอื่น ๆ ได้อีกมาก ช่วยประหยัดเวลาและทำให้ตัดสินใจได้ดีขึ้น
2. บริษัท web scraping เจ้าไหนเหมาะกับผู้ใช้ที่ไม่ถนัดเทคนิคที่สุด?
Thunderbit และ DataMiner เป็นตัวเลือกเด่นสำหรับคนไม่เขียนโค้ด ด้วยอินเทอร์เฟซแบบ AI และแบบภาพ ทั้งสองเครื่องมือช่วยดึงข้อมูลได้ในไม่กี่คลิก โดยไม่ต้องเขียนโค้ดเลย
3. ควรมองหาอะไรในบริษัท web scraping?
ให้ดูที่ความง่ายในการใช้งาน ระบบอัตโนมัติ (เช่น pagination, subpages, scheduling) ความสามารถในการรองรับสเกล ตัวเลือกการส่งออกข้อมูล (Excel, Sheets, APIs) และการซัพพอร์ตลูกค้าที่ดี เลือกเครื่องมือที่เข้ากับทักษะทางเทคนิคและความต้องการธุรกิจของคุณ
4. มีโซลูชัน web scraping ฟรีไหม?
มี! Thunderbit, DataMiner, ParseHub และ Octoparse ล้วนมีแพ็กเกจฟรี ส่วน Scrapy เป็นโอเพนซอร์สและใช้ฟรีสำหรับนักพัฒนา แผนฟรีเหมาะมากสำหรับโปรเจกต์เล็ก ๆ หรือทดลองใช้ก่อนขยายงาน
5. จะทำ web scraping ให้ถูกต้องและมีจริยธรรมได้อย่างไร?
ควรเคารพเงื่อนไขการใช้งานและนโยบายความเป็นส่วนตัวของเว็บไซต์เสมอ ดึงเฉพาะข้อมูลที่เปิดเผยต่อสาธารณะ หลีกเลี่ยงการใช้งานหนักเกินไปจนกระทบเว็บไซต์ และคำนึงถึงกฎหมายคุ้มครองข้อมูลส่วนบุคคล เช่น GDPR หลายบริษัท web scraping ชั้นนำมีฟีเจอร์ช่วยเรื่อง compliance และแนวปฏิบัติที่ดีให้ด้วย
พร้อมเริ่มดึงข้อมูลอย่างชาญฉลาดขึ้นแล้วหรือยัง? ลองใช้ Thunderbit ฟรี หรืออ่านคู่มือเพิ่มเติมบน Thunderbit Blog
ลองใช้ AI Web Scraper Get Started Free
เรียนรู้เพิ่มเติม



