
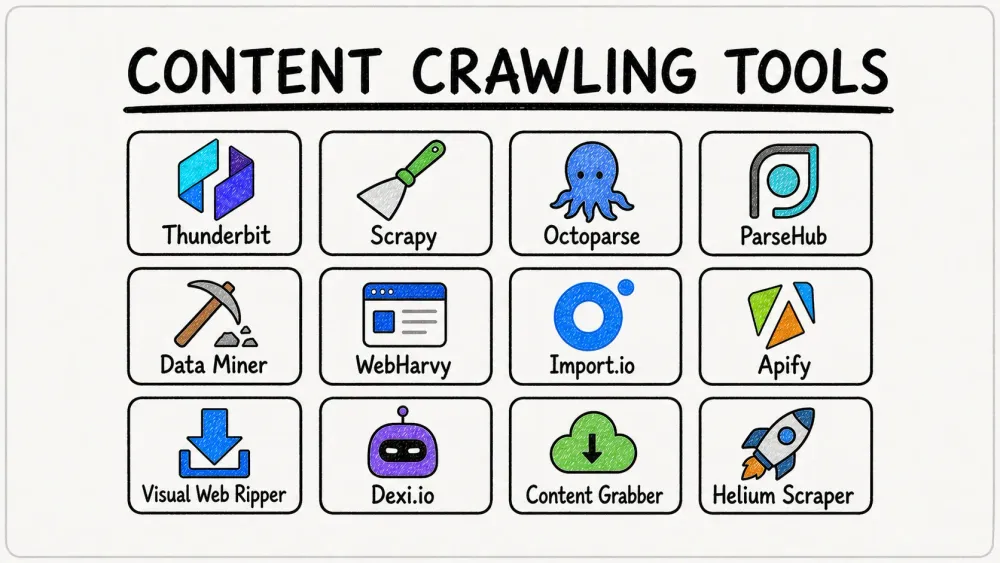
เว็บเต็มไปด้วยข้อมูลก็จริง แต่ปัญหาคือ: การเก็บข้อมูลเองมันน่าเบื่อพอ ๆ กับการนั่งจ้องสีแห้ง—and แถมยังไม่ค่อยได้ผลเท่าไหร่ด้วย ในปี 2026 ธุรกิจต่าง ๆ ต้องรับมือกับคอนเทนต์บนเว็บมากขึ้นกว่าที่เคย โดยปริมาณข้อมูลเว็บที่บริษัทเฉลี่ยได้รับต่อวันพุ่งจาก 1.2 TB ในปี 2020 เป็น 8 TB ในปี 2025 (Actowiz Solutions). ไม่ว่าคุณจะอยู่สายขาย การตลาด อีคอมเมิร์ซ หรือปฏิบัติการ ความต้องการข้อมูลเว็บที่เร็ว เป็นระบบ และแม่นยำ ไม่ได้เป็นแค่เรื่อง “มีก็ดี” อีกต่อไป แต่มันกลายเป็นของจำเป็นในการทำงานจริง ๆ และพูดกันตรง ๆ คือไม่มีใครมีเวลามานั่งก็อปปี้วางซ้ำแล้วซ้ำอีกแบบไม่จบไม่สิ้น
ดึงข้อมูลจากเว็บไซต์ใดก็ได้ด้วย AI คลิกครั้งเดียว แล้ว AI จะอ่านหน้าเว็บ วิเคราะห์โครงสร้าง และส่งคืนตารางที่สะอาดพร้อมใช้งาน ฟรีสูงสุด 6 หน้า/เดือน Get Started Free
นั่นแหละคือเหตุผลที่เครื่องมือ crawling คอนเทนต์กำลังมาแรงมาก เครื่องมือเหล่านี้ตั้งแต่ส่วนขยาย Chrome ที่ขับเคลื่อนด้วย AI ไปจนถึงแพลตฟอร์มระดับองค์กร ช่วยให้คุณทำงานทั้งกระบวนการได้แบบอัตโนมัติ เปลี่ยนหน้าเว็บที่รก ๆ ให้กลายเป็นสเปรดชีต ฐานข้อมูล หรือแดชบอร์ดแบบเรียลไทม์ที่ใช้งานได้จริง ผมทำงานด้าน SaaS และระบบอัตโนมัติมาหลายปี และบอกได้เลยว่า เครื่องมือที่ใช่ไม่ใช่แค่ช่วยประหยัดเวลา แต่มันเปลี่ยนวิธีทำงานของทั้งทีมได้เลย มาดูกันว่า 16 เครื่องมือ crawling คอนเทนต์ที่ดีที่สุด สำหรับการทำ web scraping อย่างมีประสิทธิภาพในปี 2026 มีอะไรบ้าง จุดเด่นของแต่ละตัวคืออะไร เหมาะกับธุรกิจแบบไหน และควรเลือกอย่างไรให้เข้ากับเวิร์กโฟลว์ของคุณ
ทำไมธุรกิจถึงต้องใช้เครื่องมือ Crawling คอนเทนต์ระดับท็อป
ถ้าคุณเคยต้องสร้างรายชื่อลีด ติดตามราคาคู่แข่ง หรือเช็กกระแสตลาดด้วยตัวเอง คุณคงรู้ดีว่าการเก็บข้อมูลแบบแมนนวลนั้นกลายเป็นฝันร้ายได้เร็วแค่ไหน มันช้า ผิดพลาดง่าย และกว่าจะทำเสร็จ ข้อมูลก็มักล้าสมัยไปแล้ว นั่นจึงเป็นเหตุผลที่ กว่า 70% ขององค์กรนำการดึงข้อมูลเว็บแบบอัตโนมัติมาใช้ภายในปี 2025 ช่วยลดงานที่ต้องทำมือได้ราว 60% (Actowiz Solutions).
เครื่องมือ crawling คอนเทนต์ช่วยดึงข้อมูลแบบมีโครงสร้างจากเว็บไซต์โดยอัตโนมัติ ทำให้คุณสามารถ:
- เติมลีดใหม่ ๆ เข้าสู่ CRM ได้ทันที (ไม่ต้องก็อปจากไดเรกทอรีอีกต่อไป)
- ติดตามราคาคู่แข่งและสต็อกสินค้าแบบเรียลไทม์
- รวบรวมรีวิว ข่าว และการพูดถึงบนโซเชียลมีเดีย เพื่อเอาไปต่อยอดเชิงการตลาด
- สร้างชุดข้อมูลเฉพาะทาง สำหรับงานวิจัยหรือการวิเคราะห์
- ตั้งเวลาสำหรับการดึงข้อมูลซ้ำเป็นประจำ เพื่อทำรายงานต่อเนื่อง
และผลตอบแทนจากการลงทุนก็เห็นได้ชัด ธุรกิจที่ใช้ web scraping รายงานว่าประหยัดต้นทุนรวมกันมากกว่า 500 ล้านดอลลาร์ ระหว่างปี 2020 ถึง 2025 พร้อมเพิ่มประสิทธิภาพการทำงานขึ้น 20–40% (Actowiz Solutions). พูดง่าย ๆ คือ เครื่องมือ crawling คอนเทนต์ช่วยให้ทีมของคุณไปโฟกัสกับกลยุทธ์ ไม่ใช่งานจุกจิกซ้ำ ๆ
เราคัดเลือกเครื่องมือ Crawling คอนเทนต์อันดับต้น ๆ อย่างไร
ไม่ใช่เว็บสแครปเปอร์ทุกตัวจะเหมือนกัน ตอนที่ผมรวบรวมลิสต์นี้ ผมมองเครื่องมือจากมุมของผู้ใช้ธุรกิจจริง ๆ — ทีมขาย การตลาด ปฏิบัติการ และวิจัย ที่ต้องการผลลัพธ์ ไม่ใช่ปวดหัว สิ่งที่เราพิจารณาหลัก ๆ มีดังนี้:
- ใช้งานง่ายแค่ไหน: คนที่ไม่ถนัดเทคนิคเริ่มใช้ได้เร็วหรือไม่ มีอินเทอร์เฟซแบบคลิกเลือกหรือมี AI ช่วยไหม
- ระบบอัตโนมัติและฟีเจอร์: รองรับ pagination, subpage, scheduling และเนื้อหาแบบ dynamic หรือไม่ ทำงานบนคลาวด์ได้ไหมเพื่อความเร็วและสเกล
- รูปแบบการส่งออกข้อมูลและการเชื่อมต่อ: ส่งออกไป Excel, CSV, Google Sheets, Airtable, Notion หรือเชื่อม API ได้หรือไม่
- รองรับการขยายตัวหรือไม่: เหมาะทั้งงานครั้งเดียวและโปรเจกต์ต่อเนื่องขนาดใหญ่ไหม
- ปรับแต่งได้แค่ไหน: เปลี่ยนตรรกะการดึงข้อมูล เพิ่มฟิลด์เอง หรือจัดการเว็บที่ซับซ้อนได้หรือไม่
- ความสอดคล้องตามกฎและความเป็นส่วนตัว: ช่วยให้คุณเดินตาม GDPR, CCPA และเงื่อนไขของเว็บไซต์ได้ไหม
- การสนับสนุนและคอมมูนิตี้: มีเอกสาร คู่มือ ซัพพอร์ต หรือชุมชนผู้ใช้ให้ช่วยแก้ปัญหาหรือไม่
- ราคา: มีแพ็กฟรีหรือทดลองใช้ฟรีไหม ราคาสอดคล้องกับขนาดการใช้งานและงบประมาณหรือเปล่า
และแน่นอน ผมให้ความสำคัญพิเศษกับ Thunderbit — เครื่องมือที่ผมกับทีมสร้างขึ้น — เพราะผมเชื่อจริง ๆ ว่านี่คือวิธีที่ง่ายที่สุดสำหรับผู้ใช้ธุรกิจในการเริ่มต้นกับ web scraping ที่ขับเคลื่อนด้วย AI
16 เครื่องมือ Crawling คอนเทนต์ที่ดีที่สุดสำหรับ Web Scraping อย่างมีประสิทธิภาพ
มาดูตัวที่ดีที่สุดกัน ตั้งแต่ความง่ายแบบ AI ไปจนถึงเครื่องมือสาย dev สุดทรงพลัง และอีกหลายแบบที่อยู่ตรงกลาง
1. Thunderbit
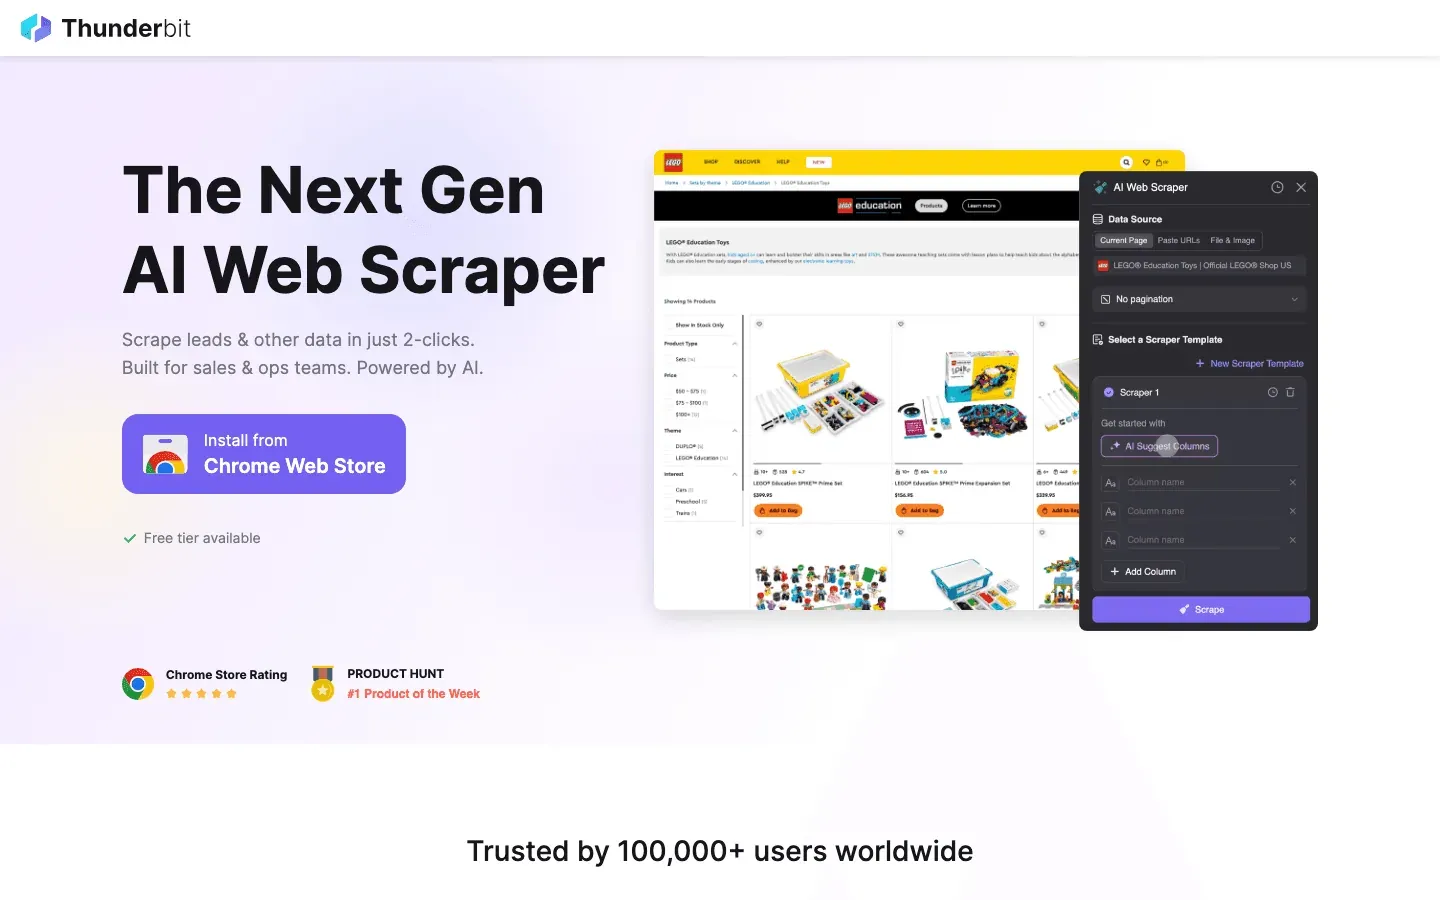 Thunderbit คือส่วนขยาย Chrome สำหรับ AI web scraper ที่ออกแบบมาสำหรับผู้ใช้ธุรกิจที่อยากได้ผลลัพธ์เร็ว จุดเด่นที่สุดคือ One Click Extract: แค่เปิดหน้าเว็บ คลิกครั้งเดียว แล้ว AI ของ Thunderbit จะอ่านหน้าเว็บ วิเคราะห์ฟิลด์ต่าง ๆ และตั้งค่า scraper ให้พร้อมใช้งานอัตโนมัติ ไม่ต้องเขียนโค้ด ไม่ต้องยุ่งกับ selector แค่คลิก ดึงข้อมูล แล้วส่งออกได้เลย
- ดึงข้อมูลจาก Subpage: Thunderbit สามารถเข้าไปยังแต่ละหน้าย่อยโดยอัตโนมัติ เช่น หน้ารายละเอียดสินค้า หรือโปรไฟล์ เพื่อเติมข้อมูลให้ชุดข้อมูลสมบูรณ์ เหมาะมากกับงาน lead generation หรือรีเสิร์ช e-commerce
- Pagination และ Template: รองรับลิสต์หลายหน้า และมีเทมเพลตสำเร็จรูปสำหรับเว็บไซต์อย่าง Amazon, Zillow และ Instagram
- ส่งออกข้อมูลฟรี: Export ไป Excel, Google Sheets, Airtable, Notion, CSV หรือ JSON ได้โดยไม่ต้องจ่ายเพิ่ม
- AI Autofill: ช่วยกรอกฟอร์มออนไลน์อัตโนมัติด้วย AI ขยายจากแค่ scraping ไปสู่ workflow automation
- Cloud & Browser Scraping: เลือกใช้โหมดคลาวด์ที่เร็วสำหรับเว็บสาธารณะ หรือโหมดเบราว์เซอร์สำหรับการใช้งานที่ต้องล็อกอิน
- ราคา: ฟรีสูงสุด 6 หน้า (หรือ 10 หน้าในช่วงทดลองใช้) และแพ็กแบบเสียเงินเริ่มที่เพียง $15/เดือน
Thunderbit เหมาะมากสำหรับทีมขาย การตลาด และปฏิบัติการที่อยากเก็บข้อมูลแบบอัตโนมัติโดยไม่ต้องเจอเรื่องเทคนิคปวดหัว ผมว่าเป็นเครื่องมือที่น่าจะมีมานานแล้ว — ตอนนี้ใคร ๆ ก็สร้างรายชื่อลีดหรือเฝ้าดูคู่แข่งได้ในไม่กี่นาที
ลองใช้ Thunderbit AI Web Scraper ฟรี ไม่ต้องตั้งค่า crawler ไม่ต้องดูแล selectors ส่งออกไป Excel, Google Sheets, Airtable หรือ Notion ได้โดยไม่มีค่าใช้จ่ายเพิ่ม Get Started Free
2. Scrapy
 Scrapy คือเฟรมเวิร์กโอเพนซอร์สสายจริงจังสำหรับนักพัฒนา เป็นเฟรมเวิร์กบน Python ที่ให้คุณเขียน spider แบบกำหนดเองเพื่อ crawl และดึงข้อมูลในสเกลใหญ่ Scrapy ถูกสร้างมาเพื่อความเร็วและความยืดหยุ่น รองรับ asynchronous crawling, custom pipelines, การหมุน proxy และการเชื่อมต่อกับฐานข้อมูลหรือ API
- เหมาะสำหรับ: นักพัฒนาและ data engineer ที่สร้างโปรเจกต์ scraping ขนาดใหญ่ ซับซ้อน หรือทำซ้ำเป็นประจำ
- จุดแข็ง: ควบคุมได้เต็มที่ ขยายต่อได้ ชุมชนใหญ่ และความเสถียรที่ผ่านการใช้งานจริงมาหนัก
- ข้อจำกัด: คนไม่เขียนโค้ดจะเรียนรู้ยาก ไม่มีอินเทอร์เฟซแบบภาพ
ถ้าคุณถนัด Python และอยากสร้าง crawler ที่แข็งแรงและขยายสเกลได้ Scrapy คือมาตรฐานระดับทอง
3. Octoparse
 Octoparse คือเว็บสแครปเปอร์แบบ no-code บนคลาวด์ ที่มาพร้อมอินเทอร์เฟซลากวางแบบภาพ คุณสามารถชี้แล้วคลิกเพื่อเลือกข้อมูล ตั้งค่า pagination และใช้การตรวจจับแพตเทิร์นด้วย AI เพื่อช่วยเร่งการตั้งค่าได้
- เทมเพลตสำเร็จรูป: ดึงข้อมูลจากเว็บยอดนิยมอย่าง Amazon, Twitter และ Google Maps ได้ในไม่กี่นาที
- Cloud Scraping & Scheduling: รันงานบนเซิร์ฟเวอร์ของ Octoparse ตั้งเวลางานที่ทำซ้ำ และรองรับโปรเจกต์ขนาดใหญ่
- รูปแบบส่งออก: CSV, Excel, JSON, API integration
- ราคา: มีแพ็กฟรีแบบจำกัด และแพ็กเสียเงินเริ่มราว $75/เดือน
Octoparse เหมาะกับ business analyst และคนที่ไม่เขียนโปรแกรม แต่ต้องการพลังการดึงข้อมูลระดับสูง
4. ParseHub
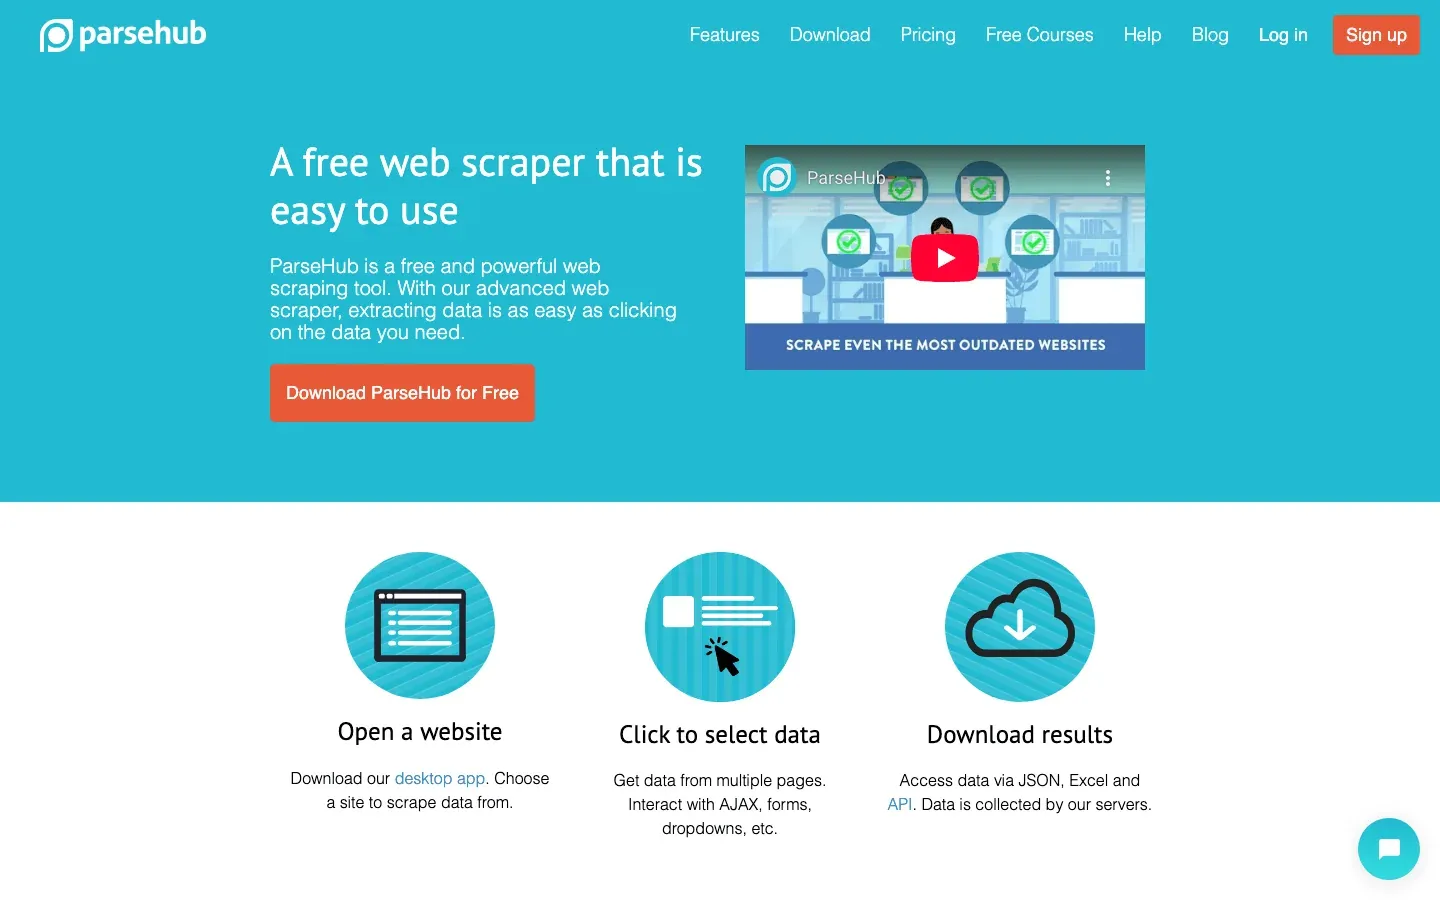 ParseHub คือเว็บสแครปเปอร์แบบ visual ที่เด่นมากในการรับมือกับคอนเทนต์แบบ dynamic และโครงสร้างเว็บไซต์ที่ซับซ้อน อินเทอร์เฟซแบบ point-and-click ช่วยให้คุณสร้างเวิร์กโฟลว์ได้ด้วยตรรกะมีเงื่อนไข ลูป และการนำทางหลายชั้น
- คอนเทนต์แบบ Dynamic: รองรับ dropdown, infinite scroll และองค์ประกอบที่โต้ตอบได้
- รันบนคลาวด์และในเครื่อง: รันโปรเจกต์บนคลาวด์ได้ (แบบเสียเงิน) หรือรันในเครื่องสำหรับงานขนาดเล็ก
- ส่งออก: CSV, Excel, JSON, API
- ราคา: มีแพ็กฟรีที่ค่อนข้างใจดี และแพ็กเสียเงินเริ่มที่ $49/เดือน
ParseHub เหมาะมากสำหรับคนไม่เขียนโค้ดที่ต้องการความยืดหยุ่นและพลังในการจัดการเว็บไซต์ยาก ๆ
5. Data Miner
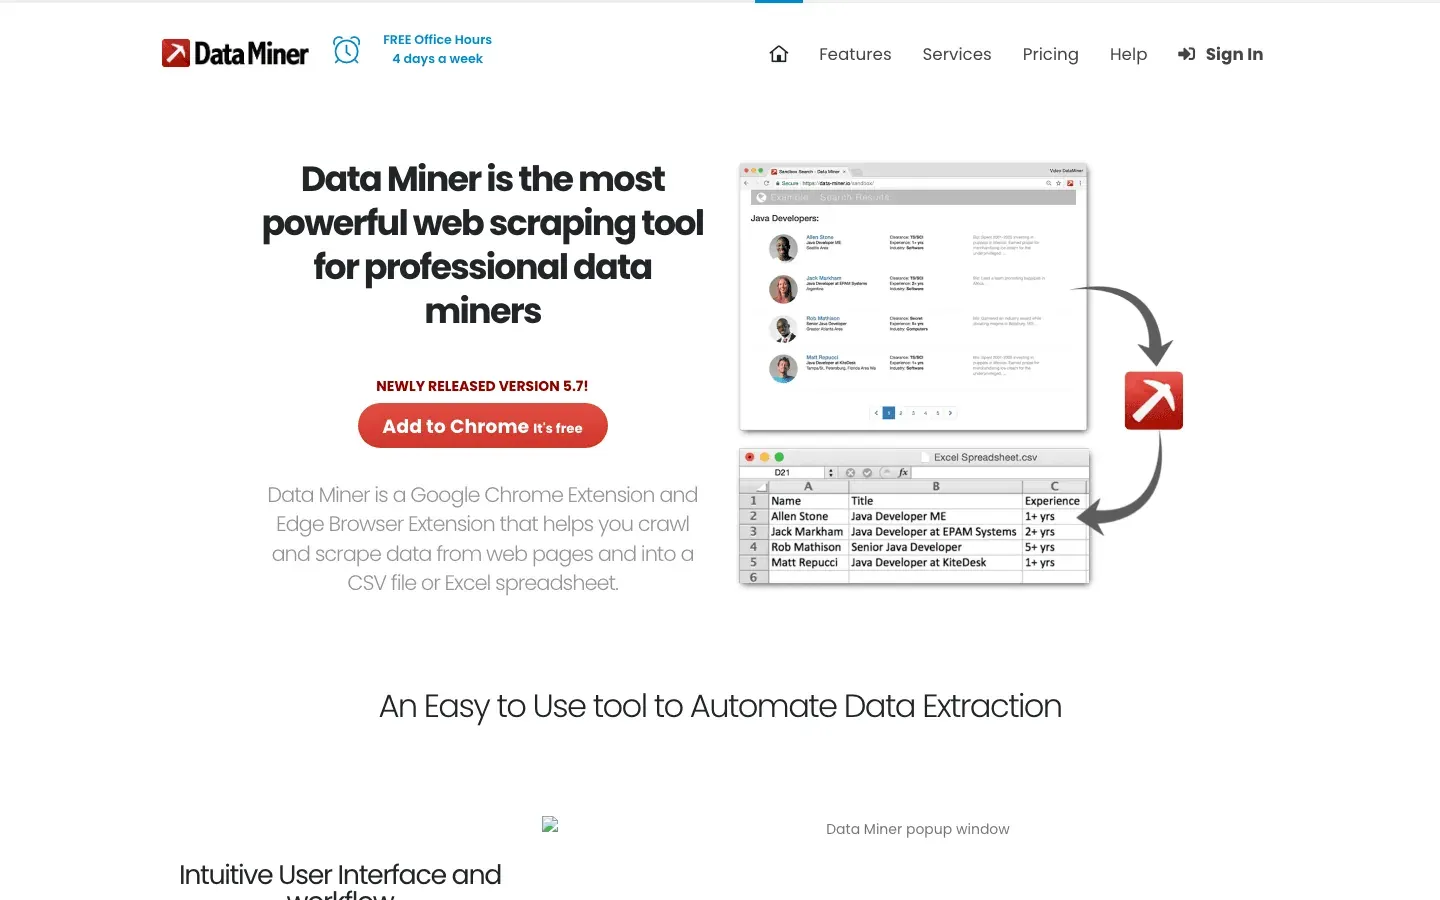 Data Miner คือส่วนขยาย Chrome/Edge สำหรับการดึงข้อมูลแบบรวดเร็วด้วยเทมเพลต มาพร้อม extraction recipes สาธารณะกว่า 50,000 แบบสำหรับเว็บไซต์มากกว่า 15,000 แห่ง ทำให้คุณมักจะดึงข้อมูลได้ในคลิกเดียว
- เชื่อมต่อ Google Sheets: อัปโหลดข้อมูลที่ดึงมาเข้าสู่ Sheets ได้โดยตรง
- Custom Recipes: สร้างตรรกะการดึงข้อมูลเองได้ด้วยการคลิกเลือกหรือ XPath
- Pagination และ Automation: รองรับการดึงข้อมูลหลายหน้าและงานตามตารางเวลา
- ราคา: มีแพ็กฟรี และแพ็กเสียเงินเริ่มที่ $19/เดือน
เหมาะกับนักวิเคราะห์และนักการตลาดที่ต้องการดึงข้อมูลปริมาณไม่มากถึงกลาง ๆ ได้เร็วจากในเบราว์เซอร์
6. WebHarvy
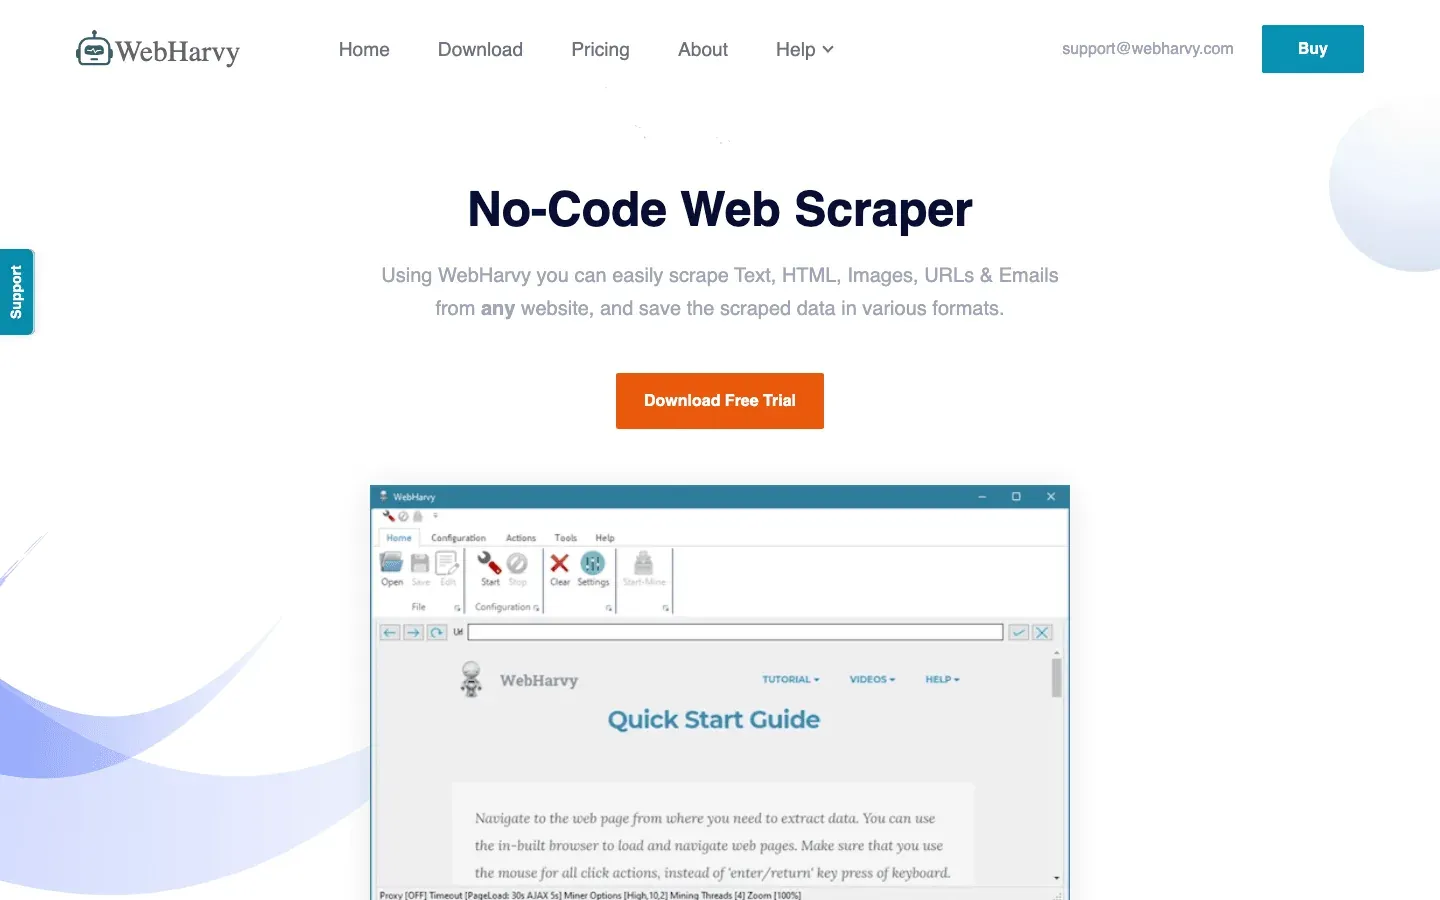 WebHarvy คือแอปเดสก์ท็อปสำหรับ Windows ที่รวมอินเทอร์เฟซแบบ point-and-click เข้ากับการตรวจจับแพตเทิร์นอัตโนมัติ เพียงคลิกที่องค์ประกอบที่ต้องการ แล้ว WebHarvy จะไฮไลต์รายการที่คล้ายกันทั้งหมดเพื่อดึงข้อมูล
- รองรับภาพ ข้อความ และ Pagination: ดึงรูปสินค้า อีเมล URL และอื่น ๆ ได้
- ตั้งเวลาบนเดสก์ท็อป: ตั้งตารางเวลาการสแครปบนเครื่อง PC ได้
- ไลเซนส์แบบจ่ายครั้งเดียว: ประมาณ $199 ต่อเครื่อง
เหมาะกับผู้ใช้ธุรกิจขนาดเล็กที่ต้องการเครื่องมือใช้ง่าย ไม่ต้องสมัครรายเดือน สำหรับงานดึงข้อมูลเป็นครั้งคราว
7. Import.io
 Import.io คือแพลตฟอร์มระดับองค์กรบนคลาวด์สำหรับการดึงข้อมูลปริมาณมาก มี AI ช่วยทำความสะอาดข้อมูล การมอนิเตอร์แบบเรียลไทม์ และฟีเจอร์ด้าน compliance ที่แข็งแรง
- API Integrations: ส่งข้อมูลตรงไปยังฐานข้อมูล, BI dashboard หรือแอปพลิเคชันได้
- Compliance: ออกแบบโดยคำนึงถึง GDPR และ CCPA
- ราคา: ใช้สัญญาระดับองค์กร ราคาสูง
เหมาะที่สุดสำหรับองค์กรขนาดใหญ่ที่ต้องการ pipeline ข้อมูลเว็บที่เชื่อถือได้ ปลอดภัย และขยายสเกลได้
8. Apify
 Apify คือแพลตฟอร์มอัตโนมัติบนคลาวด์และมาร์เก็ตเพลสสำหรับ web scraping ที่เรียกว่า “actors” (บอท) คุณสามารถใช้ actor สำเร็จรูปสำหรับเว็บยอดนิยม หรือสร้างเองด้วย JavaScript หรือ Python
- Marketplace: มีสแครปเปอร์สำเร็จรูปหลายร้อยตัวสำหรับเว็บไซต์อย่าง LinkedIn, Amazon และอื่น ๆ
- Scheduling & API: รัน ตั้งเวลา และเชื่อม actor ผ่าน API ได้
- ราคา: มีแพ็กฟรี และการใช้งานแบบเสียเงินเริ่มที่ $49/เดือน
เหมาะกับนักพัฒนาและทีมที่คล่องเทคโนโลยี ซึ่งต้องการระบบอัตโนมัติ ความยืดหยุ่น และโซลูชันจากคอมมูนิตี้
9. Dexi.io
 Dexi.io คือแพลตฟอร์มบนคลาวด์สำหรับโปรเจกต์ดึงข้อมูลเว็บแบบทำงานร่วมกัน มาพร้อมฟีเจอร์ automation, scheduling และการจัดการทีม
- Workflow Automation: สร้างและแชร์ data pipeline ข้ามทีมได้
- API & Export: เชื่อมต่อฐานข้อมูล, cloud storage หรือ BI tools ได้
- ราคา: ปรับตามความต้องการ เหมาะกับทีมและองค์กร
เหมาะกับองค์กรที่ต้องจัดการโปรเจกต์ข้อมูลต่อเนื่องและทำงานร่วมกันหลายคน
10. Helium Scraper
 Helium Scraper เป็นเครื่องมือเดสก์ท็อปที่ผสมการดึงข้อมูลแบบ visual เข้ากับความยืดหยุ่นด้านสคริปต์ ใช้ point-and-click ได้กับงานส่วนใหญ่ หรือจะเขียน JavaScript เองสำหรับตรรกะขั้นสูงก็ได้
- จัดการคอนเทนต์แบบ Dynamic: ดึงข้อมูลจากเว็บที่ใช้ AJAX หนัก ๆ ได้
- ทำความสะอาดและแปลงข้อมูล: มีสคริปต์ในตัวสำหรับเวิร์กโฟลว์เฉพาะ
- ไลเซนส์แบบจ่ายครั้งเดียว: ประมาณ $99
เหมาะกับ power user ที่ต้องการความยืดหยุ่นโดยไม่ต้องจ่ายค่าสมาชิกรายเดือน
11. Web Scraper
 Web Scraper คือส่วนขยาย Chrome ฟรีที่เป็นจุดเริ่มต้นของหลายคนในการเข้าสู่โลกของ web scraping คุณสามารถกำหนด sitemap คลิกเลือกองค์ประกอบ และส่งออกข้อมูลเป็น CSV หรือ JSON ได้
- Crawling หลายระดับ: ตามลิงก์ จัดการ pagination และดึงข้อมูลแบบ nested ได้
- ใช้ฟรีสำหรับการใช้งานในเครื่อง: มีเวอร์ชันคลาวด์แบบเสียเงินสำหรับการตั้งเวลางานและขยายสเกล
เหมาะกับมือใหม่ นักศึกษา หรือใครก็ตามที่ต้องการทางออกฟรีแบบรวดเร็วสำหรับงานขนาดเล็ก
12. Mozenda
 Mozenda คือแพลตฟอร์มคลาวด์ระดับองค์กรที่เน้น compliance การขยายสเกล และบริการแบบ managed service อินเทอร์เฟซแบบ point-and-click ช่วยให้คุณสร้าง “agents” สำหรับการดึงข้อมูลได้
- Managed Services: ทีมของ Mozenda สามารถสร้างและดูแล scraper ให้คุณได้
- Compliance & Support: ให้ความสำคัญสูงกับ GDPR, CCPA และความต้องการขององค์กร
- ราคา: เริ่มราว $500/เดือน
เหมาะที่สุดสำหรับองค์กรขนาดใหญ่ที่ต้องการโซลูชันเว็บดาต้าแบบ turnkey ขยายสเกลได้ และมีซัพพอร์ตแข็งแรง
13. SimpleIndex
 SimpleIndex คือเครื่องมืออัตโนมัติสำหรับทั้งการดึงข้อมูลจากเอกสารและเว็บ โดยเน้น OCR และการจัดทำดัชนีข้อมูล
- Screen Scraping OCR: ดึงข้อมูลจากเอกสารสแกน PDF หรือแม้แต่ฟอร์มเว็บที่แสดงบนหน้าจอ
- การเชื่อมต่อ: ส่งออกไปยังฐานข้อมูลและระบบจัดการเอกสารได้
- ไลเซนส์แบบจ่ายครั้งเดียว: หลายร้อยดอลลาร์ต่อเวิร์กสเตชัน
เหมาะกับองค์กรที่ต้องผสาน workflow ระหว่างเอกสารและข้อมูลเว็บเข้าด้วยกัน
14. Datastreamer (เดิมชื่อ Spinn3r)
 Datastreamer (เดิมชื่อ Spinn3r) คือแพลตฟอร์ม crawling คอนเทนต์แบบเรียลไทม์สำหรับบล็อก ข่าว และโซเชียลมีเดีย Firehose API ของมันส่งสตรีมคอนเทนต์ใหม่อย่างต่อเนื่องจากแหล่งข้อมูลนับล้าน
- กรองสแปมและประมวลผลภาษา: ได้ฟีดข้อมูลที่สะอาดและมีโครงสร้าง
- เข้าถึงผ่าน API: เชื่อมเข้าระบบของคุณได้โดยตรง
- ราคาแบบสมัครสมาชิก: คิดตามการใช้งาน
เหมาะที่สุดสำหรับทีมติดตามสื่อ รวมข่าว หรือทีมวิจัยที่ต้องการข้อมูลแบบเรียลไทม์
15. FMiner
 FMiner คือเครื่องมือสร้างเวิร์กโฟลว์แบบภาพสำหรับการ crawl เว็บที่ซับซ้อน อินเทอร์เฟซลากวางช่วยให้คุณออกแบบขั้นตอนการดึงข้อมูลหลายระดับและมีเงื่อนไขได้
- Python Scripting: แทรกโค้ดเองสำหรับตรรกะขั้นสูง
- ใช้งานได้หลายแพลตฟอร์ม: รองรับ Windows และ Mac
- ไลเซนส์แบบจ่ายครั้งเดียว: เริ่มราว $168
เหมาะกับนักวิเคราะห์หรือ data scientist ที่อยากวางโครงเวิร์กโฟลว์ซับซ้อนแบบเห็นภาพ
16. G2 Webscraper
 G2 Webscraper (หมายถึงเครื่องมือที่ได้คะแนนสูงบน G2) ได้รับคำชมเรื่องความง่ายและประสิทธิภาพ ผู้ใช้ชอบเครื่องมือที่ฟรี ใช้ง่าย และช่วยประหยัดเวลาได้มาก เช่น ส่วนขยาย Web Scraper Chrome หรือ Data Miner
- รีวิวผู้ใช้แข็งแรง: ได้คะแนนสูงเรื่องใช้งานง่ายและความน่าเชื่อถือ
- ตั้งค่าเร็ว: แทบไม่มีเส้นโค้งการเรียนรู้สำหรับงานพื้นฐานถึงระดับกลาง
ถ้าคุณอยากได้เครื่องมือที่ “ใช้งานได้เลย” สำหรับงาน scraping แบบตรงไปตรงมา ตัวเลือกยอดนิยมจาก G2 คือเดิมพันที่ปลอดภัย
ตารางเปรียบเทียบ: ภาพรวมเครื่องมือ Crawling คอนเทนต์ชั้นนำ
| เครื่องมือ | ใช้งานง่าย | ระบบอัตโนมัติและฟีเจอร์ | รูปแบบส่งออก | ความสอดคล้อง & ความเป็นส่วนตัว | ราคา | เหมาะที่สุดสำหรับ |
|---|---|---|---|---|---|---|
| Thunderbit | ⭐⭐⭐⭐⭐ | ฟิลด์ AI, subpage, cloud | Excel, CSV, Sheets, Notion, Airtable, JSON | ผู้ใช้กำหนดเองได้ | ฟรี, เริ่มที่ $15/เดือน | คนไม่เขียนโค้ด, ฝ่ายขาย, ops |
| Scrapy | ⭐ | โค้ดเต็มรูปแบบ, async, plugins | CSV, JSON, DB | ผู้ใช้ดูแลเอง | ฟรี, โอเพนซอร์ส | นักพัฒนา, โปรเจกต์ใหญ่ |
| Octoparse | ⭐⭐⭐⭐ | Visual, templates, cloud | CSV, Excel, JSON, API | ผู้ใช้กำหนดเองได้ | ฟรี, เริ่มที่ $75/เดือน | นักวิเคราะห์, e-commerce, คนไม่เขียนโค้ด |
| ParseHub | ⭐⭐⭐⭐ | Visual, dynamic, cloud | CSV, Excel, JSON, API | ผู้ใช้กำหนดเองได้ | ฟรี, เริ่มที่ $49/เดือน | คนไม่เขียนโค้ด, เว็บซับซ้อน |
| Data Miner | ⭐⭐⭐⭐⭐ | Templates, browser, Sheets | CSV, Excel, Sheets | ผู้ใช้กำหนดเองได้ | ฟรี, เริ่มที่ $19/เดือน | งานด่วนในเบราว์เซอร์ |
| WebHarvy | ⭐⭐⭐⭐⭐ | Visual, pattern detect | Excel, CSV, XML, JSON | ผู้ใช้กำหนดเองได้ | $199 จ่ายครั้งเดียว | ผู้ใช้ Windows, ธุรกิจขนาดเล็ก |
| Import.io | ⭐⭐⭐⭐ | AI, cloud, monitoring | CSV, API, DB | GDPR, CCPA | ระดับองค์กร | องค์กรใหญ่, compliance |
| Apify | ⭐⭐⭐ | Cloud, marketplace, API | JSON, API, Sheets | ผู้ใช้ดูแลเอง | ฟรี, เริ่มที่ $49/เดือน | dev, automation, integrations |
| Dexi.io | ⭐⭐⭐ | Cloud, team, workflow | CSV, API, DB, Storage | ผู้ใช้กำหนดเองได้ | กำหนดเอง | ทีม, โปรเจกต์ต่อเนื่อง |
| Helium Scraper | ⭐⭐⭐ | Visual + scripting | CSV, DB | ผู้ใช้กำหนดเองได้ | $99 จ่ายครั้งเดียว | power user, logic เฉพาะทาง |
| Web Scraper | ⭐⭐⭐⭐⭐ | Sitemap, browser | CSV, JSON | ผู้ใช้กำหนดเองได้ | ฟรี (โลคัล) | มือใหม่, งานเล็ก |
| Mozenda | ⭐⭐⭐ | Cloud, managed, compliance | CSV, API, DB | GDPR, CCPA | $500+/เดือน | องค์กร, managed service |
| SimpleIndex | ⭐⭐⭐ | OCR, web, docs | DB, DMS | ผู้ใช้กำหนดเองได้ | $500 จ่ายครั้งเดียว | เอกสาร + ข้อมูลเว็บ |
| Datastreamer | ⭐⭐ | เรียลไทม์, API | JSON, API | ผู้ใช้กำหนดเองได้ | สมัครสมาชิก | สื่อ, ข่าว, งานวิจัย |
| FMiner | ⭐⭐⭐ | Visual workflow, Python | CSV, DB | ผู้ใช้กำหนดเองได้ | $168 จ่ายครั้งเดียว | เวิร์กโฟลว์ซับซ้อนแบบภาพ |
| G2 Webscraper | ⭐⭐⭐⭐⭐ | ง่าย, เบราว์เซอร์ | CSV, JSON | ผู้ใช้กำหนดเองได้ | ฟรี/แตกต่างกันไป | ความเรียบง่าย, เห็นผลเร็ว |
มีสองเครื่องมือที่เคยอยู่ในลิสต์นี้แต่ตอนนี้ไม่ได้รวมแล้ว Visual Web Ripper ไม่ได้รับการดูแลโดย Sequentum ตั้งแต่ปี 2018 และเว็บไซต์ของ Content Grabber ตอนนี้ขึ้น 404 โดยไลน์ผลิตภัณฑ์ถูกแทนที่ด้วย Sequentum Cloud โปรดตรวจสอบความพร้อมใช้งานปัจจุบันก่อนวางแผนเวิร์กโฟลว์โดยอิงจากเครื่องมือทั้งสองนี้
วิธีเลือกเครื่องมือ Crawling คอนเทนต์ที่เหมาะกับธุรกิจของคุณ
การเลือกเครื่องมือที่เหมาะ คือการจับคู่ความต้องการของคุณกับจุดแข็งของเครื่องมือนั้น ๆ เช็กลิสต์สั้น ๆ ของผมมีดังนี้:
- กำหนด use case ให้ชัด: ใช้ครั้งเดียวหรือใช้งานต่อเนื่อง ปริมาณเล็กหรือใหญ่ ข้อมูลสาธารณะหรือต้องล็อกอิน
- จับคู่กับระดับทักษะ: คนไม่เขียนโค้ดควรเริ่มจาก Thunderbit, Octoparse, ParseHub หรือ WebHarvy ส่วนสาย dev ไปต่อกับ Scrapy หรือ Apify ได้เลย
- เช็กความต้องการเรื่อง export: ต้องการ Excel, Sheets หรือ API integration หรือไม่ ให้แน่ใจว่าเครื่องมือรองรับ
- พิจารณา compliance: ถ้าอยู่ในอุตสาหกรรมที่มีการกำกับดูแล หรือดึงข้อมูลส่วนบุคคล ให้เลือกเครื่องมือที่มีฟีเจอร์ด้าน compliance เช่น Import.io หรือ Mozenda
- เริ่มจากเล็ก ๆ: ใช้แพ็กฟรีหรือทดลองใช้ฟรีเพื่อลองกับข้อมูลจริงก่อนตัดสินใจซื้อ
- คิดเผื่ออนาคต: ความต้องการของคุณจะโตขึ้นไหม เลือกเครื่องมือที่ขยายตามได้
และอย่าลืมว่า บางครั้งเครื่องมือที่เรียบง่ายที่สุดก็คือเครื่องมือที่เหมาะที่สุด อย่าทำให้เรื่องง่ายกลายเป็นซับซ้อนเกินจำเป็นถ้าคุณแค่ต้องการสเปรดชีตเร็ว ๆ สักไฟล์
ความเป็นส่วนตัวของข้อมูลและ Compliance: ต้องระวังอะไรบ้าง
การทำ web scraping เปิดโอกาสมากมาย แต่มันก็มาพร้อมความรับผิดชอบเหมือนกัน วิธีอยู่ให้ถูกกฎหมายและถูกหลักปฏิบัติมีดังนี้:
- เคารพ robots.txt และนโยบายของเว็บ: ตรวจสอบเสมอว่าเว็บไซต์อนุญาตให้สแครปหรือไม่ และทำตามแนวทางของเขา
- หลีกเลี่ยงการดึงข้อมูลส่วนบุคคล เว้นแต่มีเหตุผลอันชอบธรรมและได้รับความยินยอม: GDPR และ CCPA เป็นเรื่องจริงจังมาก
- อย่ายิงคำขอใส่เซิร์ฟเวอร์ถี่เกินไป: ใช้ throttling, delay และ scheduling ที่มีในตัว เพื่อไม่ให้ถูกบล็อก และเพื่อเป็นพลเมืองอินเทอร์เน็ตที่ดี
- ใช้เครื่องมือที่มีฟีเจอร์ compliance หากอยู่ในอุตสาหกรรมอ่อนไหว: Import.io และ Mozenda ถูกสร้างมาโดยคำนึงถึง GDPR/CCPA
- บันทึกการทำงานของคุณ: เก็บประวัติว่าเก็บอะไรมา และเพราะอะไร โดยเฉพาะงานธุรกิจหรือกรณีที่มีข้อกำกับ
การสแครปอย่างมีจริยธรรมคือการสแครปที่ยั่งยืน และช่วยให้ธุรกิจของคุณไม่เจอปัญหาตามมา
บทสรุป: เพิ่มพลังให้ทีมของคุณด้วยเครื่องมือ Crawling คอนเทนต์ที่ใช่
เว็บคือฐานข้อมูลที่ใหญ่ที่สุดและรกที่สุดของธุรกิจคุณ และด้วยเครื่องมือ crawling คอนเทนต์ที่เหมาะสม คุณจะเริ่มใช้ประโยชน์จากมันได้จริงสักที ไม่ว่าคุณจะสร้างรายชื่อลีด ติดตามคู่แข่ง หรือป้อนข้อมูลเข้าแดชบอร์ดแบบเรียลไทม์ เครื่องมือทั้ง 18 ตัวนี้ครอบคลุมทุกสถานการณ์ ทุกระดับทักษะ และทุกงบประมาณ
ถ้าคุณอยากได้เส้นทางที่เร็วที่สุดสู่ผลลัพธ์ Thunderbit คือตัวเลือกอันดับหนึ่งของผมสำหรับผู้ใช้ธุรกิจ: ขับเคลื่อนด้วย AI ไม่ต้องเขียนโค้ด และพร้อมเปลี่ยนทุกเว็บไซต์ให้กลายเป็นชุดข้อมูลที่มีโครงสร้างได้ภายในไม่กี่นาที แต่ไม่ว่าคุณต้องการอะไร เริ่มจากทดลองใช้ฟรี ลองใช้งาน และดูว่าอะไรเหมาะกับเวิร์กโฟลว์ของคุณที่สุด
ดาวน์โหลด Thunderbit Chrome Extension ติดตั้ง เปิดหน้าที่ต้องการ แล้วคลิกครั้งเดียว Email Extractor, Phone Number Extractor และ Image Extractor ฟรีในทุกแพ็กเกจ Get Started Free
พร้อมเลิกงานก็อปปี้วางแบบเดิม ๆ แล้วหรือยัง? ดาวน์โหลด Thunderbit Chrome Extension แล้วดูว่าการดึงข้อมูลเว็บทำได้ง่ายแค่ไหน และถ้าคุณอยากเจาะลึกเรื่อง web scraping เพิ่มเติม ลองเข้าไปดู Thunderbit Blog สำหรับคู่มือ เคล็ดลับ และบทเรียนเพิ่มเติม
ลองใช้ Thunderbit AI Web Scraper Get Started Free
คำถามที่พบบ่อย
1. เครื่องมือ crawling คอนเทนต์คืออะไร และต่างจาก web scraper ทั่วไปอย่างไร?
เครื่องมือ crawling คอนเทนต์คือ web scraper ประเภทหนึ่งที่ออกแบบมาเพื่อดึงข้อมูลแบบมีโครงสร้างจากเว็บไซต์โดยอัตโนมัติ แม้ว่า web scraper ทุกตัวจะเก็บข้อมูลได้ แต่เครื่องมือ crawling คอนเทนต์มักมีฟีเจอร์อย่าง scheduling, การนำทางไปยัง subpage, การตรวจจับฟิลด์ด้วย AI และการเชื่อมต่อเข้ากับ workflow ของธุรกิจ ทำให้ทรงพลังกว่าและใช้งานง่ายกว่าสำหรับทีมงาน
2. เครื่องมือ crawling คอนเทนต์ตัวไหนเหมาะกับคนไม่ถนัดเทคนิคที่สุด?
Thunderbit, Octoparse, ParseHub, Data Miner และ WebHarvy ล้วนเหมาะกับคนไม่เขียนโค้ด Thunderbit โดดเด่นเรื่องความง่ายด้วย AI และส่งออกข้อมูลได้ทันทีไปยัง Excel, Sheets, Airtable หรือ Notion
3. จะมั่นใจได้อย่างไรว่าการทำ web scraping ถูกกฎหมายและสอดคล้องกับข้อกำหนด?
ให้เคารพเงื่อนไขของเว็บไซต์ robots.txt และกฎหมายความเป็นส่วนตัวอย่าง GDPR กับ CCPA เสมอ หลีกเลี่ยงการดึงข้อมูลส่วนบุคคลหากไม่มีเหตุผลอันชอบธรรมและความยินยอม สำหรับอุตสาหกรรมอ่อนไหว ให้เลือกเครื่องมือที่มีฟีเจอร์ compliance ในตัว เช่น Import.io หรือ Mozenda
4. เครื่องมือเหล่านี้รับมือกับเว็บไซต์ dynamic ที่ใช้ JavaScript หรือ infinite scroll ได้ไหม?
ได้ — เครื่องมืออย่าง Thunderbit, Octoparse, ParseHub, Apify และ FMiner รองรับคอนเทนต์แบบ dynamic, infinite scroll และการนำทางหลายระดับ บางตัวอาจต้องตั้งค่าเพิ่มหรือรันบนคลาวด์สำหรับเว็บที่ซับซ้อน
5. ควรพิจารณาอะไรบ้างเมื่อเลือกเครื่องมือ crawling คอนเทนต์ให้ธุรกิจ?
ให้ดูทักษะทางเทคนิคของทีม ขนาดของความต้องการข้อมูล รูปแบบการส่งออก/การเชื่อมต่อ ข้อกังวลด้าน compliance และงบประมาณ เริ่มจากแพ็กฟรีหรือทดลองใช้ฟรี แล้วทดสอบกับ use case จริงก่อนตัดสินใจ
ขอให้สนุกกับการสแครป—and ขอให้ข้อมูลของคุณสดใหม่ มีโครงสร้าง และพร้อมใช้งานเสมอ
อ่านเพิ่มเติม




