ทราฟฟิกจากบอทอัตโนมัติคิดเป็น มากกว่า 53% ของทราฟฟิกเว็บทั้งหมด—มากกว่าที่มนุษย์สร้างขึ้นเสียอีก ถ้าคุณกำลังดึงข้อมูล จัดการบัญชี หรือเช็กโฆษณาข้ามภูมิภาค คุณกำลังทำงานอยู่ในสภาพแวดล้อมที่ระบบป้องกันบอทถูกออกแบบมาเพื่อจับตาคุณโดยตรง
แต่ถึงอย่างนั้น คู่มือส่วนใหญ่เกี่ยวกับ "static vs rotating proxies" ก็มักย่อทุกอย่างให้เหลือแค่ตารางสองคอลัมน์แล้วจบไปเลย ทั้งที่พวกเขามองข้ามแนวคิดที่สามไปเลย (sticky sessions) ไม่อธิบายกลไกการตรวจจับจริง และไม่เคยคำนวณต้นทุนเมื่อสเกลใหญ่ขึ้น ผมใช้เวลาศึกษาผู้ให้บริการ proxy และ AI scraping API มามากสำหรับงานของเรา at Thunderbit และความจริงมันซับซ้อนกว่า—และน่าสนใจกว่า—ที่บทความรวมลิสต์ทั่วไปชอบเล่า คู่มือนี้จะพาไปดูความแตกต่างที่แท้จริงของทั้ง 3 แบบที่หลายบทความอธิบายผิด วิธีที่ระบบ anti-bot ตรวจจับทราฟฟิกจาก proxy จริง ๆ ค่าใช้จ่ายในการดึง 50K หน้า/วันผ่าน proxy หลายประเภท และ 9 เครื่องมือที่ผมพิจารณาใช้จริง บางตัวเป็นผู้ให้บริการ proxy ดิบ ๆ บางตัวเป็น scraping API และอีกหนึ่งตัว (ของเราเอง) ตัดขั้นตอนการจัดการ proxy ออกไปเลย
ลองใช้ Thunderbit สำหรับ AI Scraping
Static vs Rotating vs Sticky Proxy: ความต่างแบบ 3 ทางที่คู่มือส่วนใหญ่ไม่พูดถึง
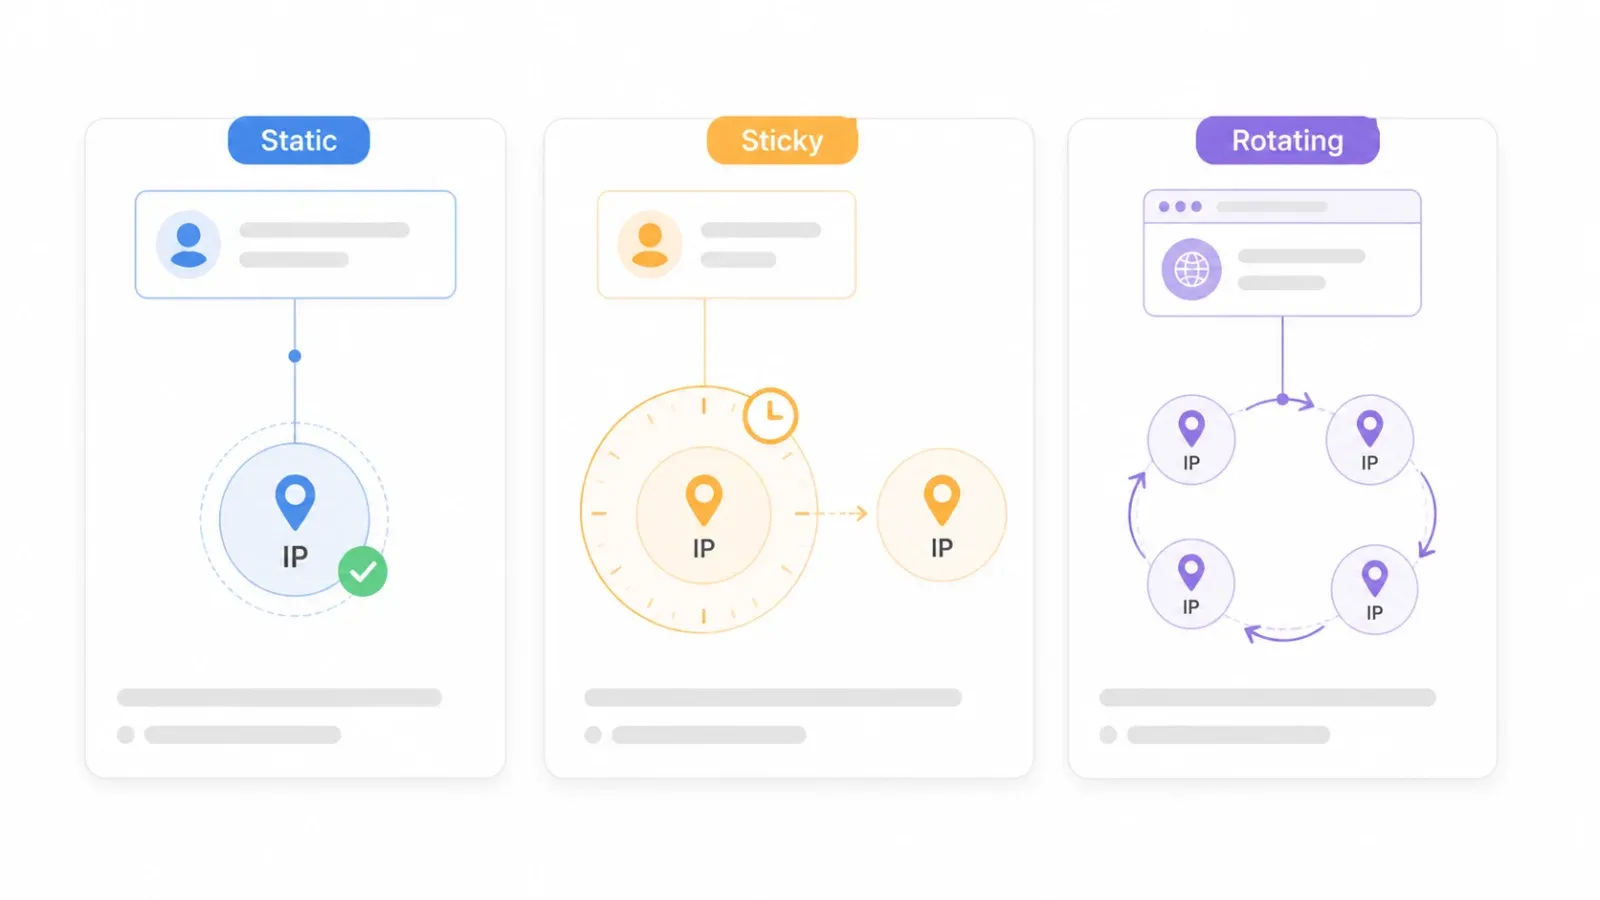
บทความเปรียบเทียบ proxy ส่วนใหญ่ชอบมองเป็นแค่สองฝั่ง: static กับ rotating ซึ่งมุมมองนี้ไม่ครบ และทำให้ตัดสินใจซื้อผิดได้จริง ๆ ความจริงแล้วพฤติกรรมของ proxy แบ่งได้ 3 แบบ และแต่ละแบบเหมาะกับงานคนละประเภท
Static proxy: ใช้ IP เดิมไปเรื่อย ๆ จนกว่าคุณจะเปลี่ยนเองหรือสัญญาใช้งานหมดอายุ ลองนึกภาพเหมือนอินเทอร์เน็ตบ้านของคุณ—เลขที่อยู่เดิมทุกวัน เหมาะเมื่อแพลตฟอร์มคาดหวังให้เห็นตัวตนเดิมต่อเนื่องในระยะยาว (เช่น การจัดการบัญชี เนื้อหาที่ล็อกตามภูมิภาค หรือการติดตามอันดับ)
Sticky session: ใช้ IP เดิมในช่วงเวลาที่ กำหนดได้ อาจ 10 นาที 30 นาที หรือสูงสุด 24 ชั่วโมงแล้วแต่ผู้ให้บริการ จากนั้นค่อยสลับ IP ใหม่ sticky session คือความต่อเนื่องแบบชั่วคราว ส่วน static proxy คือความต่อเนื่องแบบถาวร Decodo (เดิมคือ Smartproxy) อธิบาย sticky session ว่าคือการคง IP เดิมไว้ 1, 10, 30, 60 นาที หรือกำหนดเองได้สูงสุด 24 ชั่วโมง
Rotating proxy: เปลี่ยน IP ใหม่ทุกครั้งที่ขอข้อมูล หรือทุกไม่กี่วินาที เหมาะกับงานที่ต้องการความเป็นนิรนามสูงและปริมาณมาก แต่จะไม่มีความต่อเนื่องของ session เลย เว้นแต่ว่าคุณจะซ้อน sticky session เพิ่มเข้าไป
สรุปความต่างแบบตาราง:
| คุณสมบัติ | Static Proxy | Sticky Session | Rotating Proxy |
|---|---|---|---|
| IP เปลี่ยนไหม? | ไม่เปลี่ยนเลย (IP เดิมตลอด) | เปลี่ยนหลังครบช่วงเวลาที่กำหนด (เช่น 10–30 นาที) | เปลี่ยนทุก request หรือทุกไม่กี่วินาที |
| ความต่อเนื่องของ session | ถาวร | ชั่วคราว (กำหนด TTL ได้) | ไม่มี |
| งานที่เหมาะ | จัดการบัญชี, เนื้อหาล็อกภูมิภาค, ติดตามอันดับ | Scraping หลายขั้นตอน (ล็อกอิน → เข้าเว็บ → ดึงข้อมูล) | Scraping ปริมาณสูง, ตรวจสอบโฆษณา |
| ความเสี่ยงในการถูกตรวจจับ | สูงขึ้นเมื่อใช้ไปนาน ๆ (fingerprint เดิมสะสมประวัติ) | ปานกลาง | ต่ำสุดสำหรับการตรวจจับจาก IP (ถ้าเป็น residential) |
| รูปแบบค่าใช้จ่าย | มักคิดตาม IP/เดือน | รวมอยู่ในแพ็ก residential/mobile ที่คิดตาม GB | คิดตาม GB, per request หรือราคาเหมาจ่าย |
ทำไมเรื่องนี้ถึงสำคัญต่อการเลือกเครื่องมือ? ถ้าคุณต้องล็อกอินเข้าแพลตฟอร์ม เพิ่มสินค้าในตะกร้า หรือกรอกฟอร์มหลายขั้นตอน คุณต้องใช้ sticky session—not pure rotation (เพราะจะทำให้ session พัง) และก็ไม่จำเป็นต้องใช้ static IP ถาวรที่ทั้งเกินความต้องการและแพงเกินไป ผู้ใช้ในฟอรัมอย่าง r/proxies มักสับสนหมวดหมู่นี้ ถามว่า sticky session ทำงานเหมือน "regular rotating residential proxies" หรือเหมือน static IP กันแน่ คำตอบคือ: ไม่ใช่ทั้งสองแบบ มันคือสิ่งที่สาม
ระบบ Anti-Bot ตรวจจับ Static vs Rotating Proxy จริง ๆ อย่างไร
บทความเปรียบเทียบ proxy ส่วนใหญ่จะพูดถึง "ความเสี่ยงในการถูกตรวจจับ" แค่ในช่องตาราง แทบไม่มีใครอธิบายว่า มันตรวจจับได้ยังไง ซึ่งสำคัญมาก เพราะวิธีตรวจจับเป็นตัวกำหนดว่า rotating IP จะช่วยได้จริงหรือเปล่า
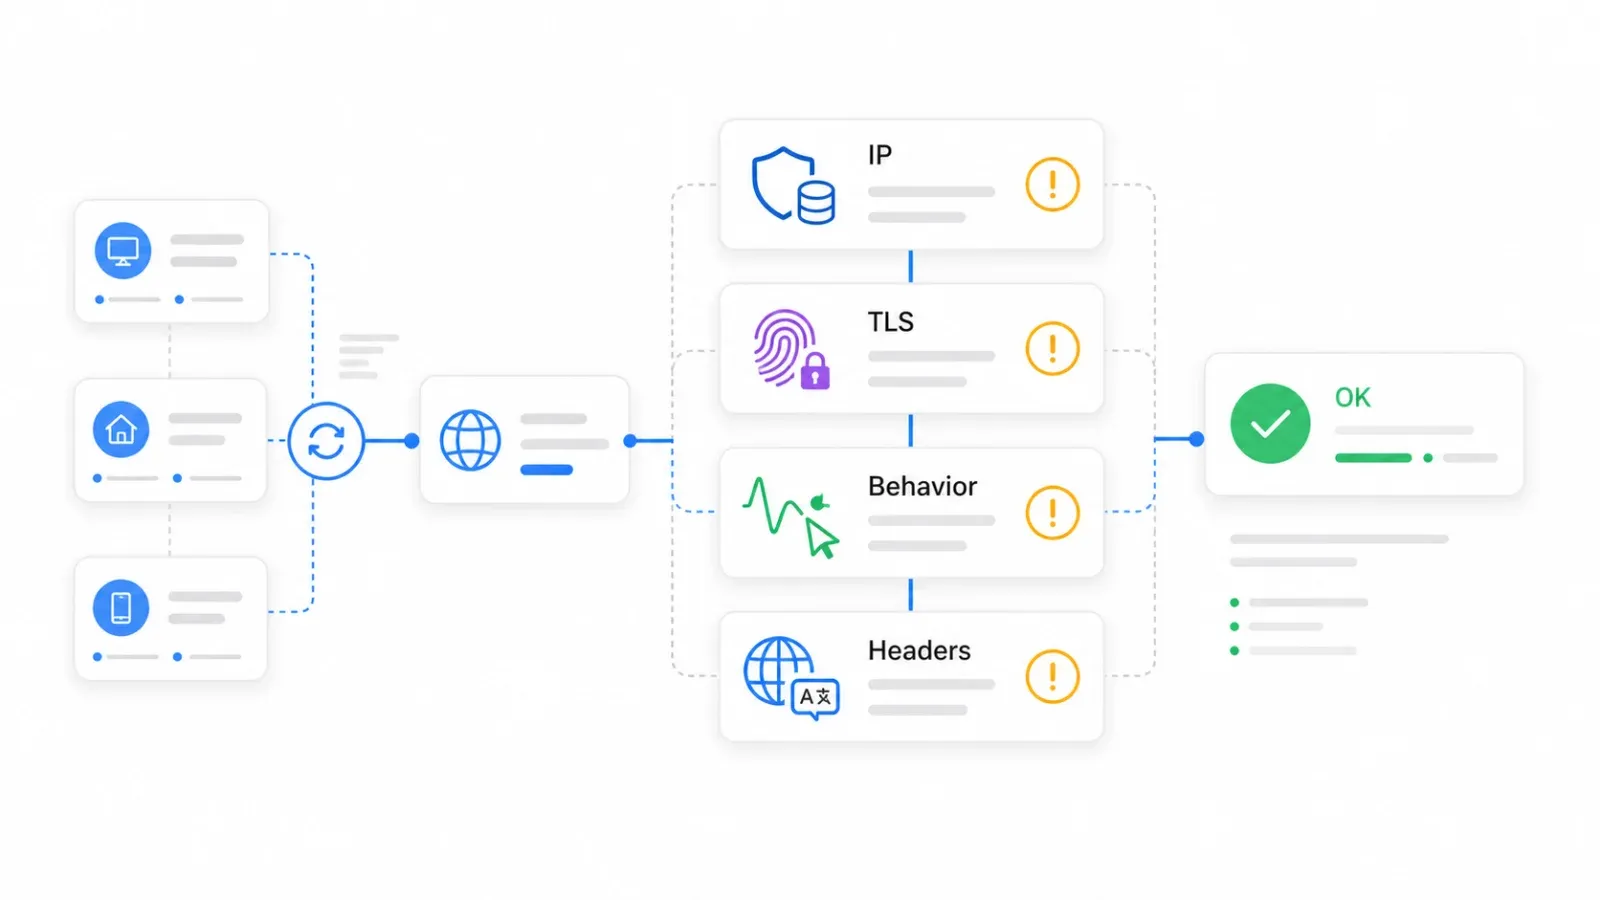
ระบบ anti-bot สมัยใหม่ใช้การตรวจจับอย่างน้อย 4 ชั้น และการหมุน IP ของคุณช่วยได้แค่ชั้นเดียว
ชั้นที่ 1: ฐานข้อมูลชื่อเสียงของ IP
ช่วง IP ของ datacenter มาจาก ASN ของคลาวด์และโฮสติ้ง เช่น Amazon, Google, DigitalOcean ฯลฯ ผู้ให้บริการ anti-bot จะมีฐานข้อมูลที่ทำเครื่องหมายช่วงพวกนี้ไว้ล่วงหน้า ส่วน IP แบบ residential และ mobile มักเริ่มต้นด้วยความน่าเชื่อถือสูงกว่า เพราะดูเหมือนทราฟฟิกจากผู้ใช้ทั่วไป เอกสาร bot ของ Cloudflare ใช้ bot score ตั้งแต่ 1 ถึง 99 โดยคะแนนต่ำหมายถึงมีแนวโน้มเป็นอัตโนมัติ ถ้า IP ของคุณมาจากช่วง datacenter ที่รู้กันอยู่แล้ว คุณจะเริ่มต้นด้วยคะแนนความน่าเชื่อต่ำตั้งแต่ยังไม่ส่ง request แรกเลย
ชั้นที่ 2: TLS/JA3/JA4 Fingerprinting
นี่คือจุดที่ผู้ซื้อ proxy ส่วนใหญ่ไม่ค่อยรู้ เมื่อไคลเอนต์ของคุณเริ่มเชื่อมต่อ HTTPS ระหว่าง TLS handshake จะมีลักษณะเฉพาะของซอฟต์แวร์ที่ส่ง request ถูกเปิดเผยออกมา เอกสาร JA3/JA4 ของ Cloudflare อธิบายว่า fingerprint เหล่านี้ใช้ระบุ TLS client จากลักษณะการเชื่อมต่อ และยังเป็นตัวระบุที่เสถียรแม้เปลี่ยนปลายทาง IP หลายครั้ง พูดง่าย ๆ คือ ถ้า request ของคุณอ้างว่าเป็น Chrome บน macOS แต่ TLS handshake กลับดูเหมือนมาจาก Python requests library การหมุน IP ก็ไม่ช่วยแก้ความไม่ตรงกันนั้น fingerprint ยังตามคุณอยู่
ชั้นที่ 3: สัญญาณพฤติกรรม
ความถี่ของ request ลำดับการเข้าเว็บ การเคลื่อนไหวของเมาส์ (หรือไม่มีเลย) รูปแบบการล็อกอิน และพฤติกรรม session ที่ไม่เหมือนการใช้งานของมนุษย์ เอกสารการตรวจจับของ DataDome อธิบายโมเดลพฤติกรรมที่จับแพตเทิร์นผิดปกติ เช่น ลองล็อกอินถี่เกินไป หรือการนำทางเร็วผิดมนุษย์ งานวิจัย arXiv ปี 2026 เกี่ยวกับ AI browsing agents พบว่า behavioral fingerprints แยก AI agents ออกจากมนุษย์ได้ดีกว่า browser fingerprints ด้วยซ้ำ
ชั้นที่ 4: ความสอดคล้องของ Header และสภาพแวดล้อม
งานวิจัยเชิงวัดจาก ปี 2026 ที่สำรวจ 10,000 เว็บไซต์ พบว่า 75% ของการบล็อกแบบ Chromium-headless-only เกิดจากสัญญาณระดับ header เพียงอย่างเดียว ถ้า Accept-Language ของคุณบอกว่าเป็น en-US แต่ IP ของคุณถูกระบุพิกัดว่าอยู่ที่ São Paulo นั่นคือสัญญาณผิดปกติ ถ้า user agent ของคุณไม่ตรงกับ TLS fingerprint ก็เป็นอีกสัญญาณหนึ่ง
สรุปคือ: การหมุน IP ช่วยลด rate limit และการสะสมประวัติด้านชื่อเสียงของ IP ได้จริง แต่มัน ไม่ แก้ TLS fingerprint ที่ไม่ตรงกัน ความผิดปกติด้านพฤติกรรม หรือความไม่สอดคล้องของ header นี่คือเหตุผลว่าทำไมเครื่องมือ scraping แบบ API-first—ที่จัดการ rendering, fingerprint consistency และ CAPTCHA solving ในระดับโครงสร้างพื้นฐาน—จึงกลายเป็นทางเลือกที่ใช้งานได้จริงแทนการต้องจัดการทั้ง 4 ชั้นด้วยตัวเอง
ตัดปัญหาการจัดการ proxy ด้วย AI scraping Get Started Free
ต้นทุนจริงของ Static vs Rotating Proxy เมื่อใช้งานในระดับสเกลใหญ่
เรื่องราคาเป็นส่วนที่คู่มือ proxy ส่วนใหญ่มักข้ามไป หรือพูดคลุมเครือว่า "ราคาย่อมเยา" แต่รูปแบบการคิดเงิน + น้ำหนักของหน้าเว็บ + อัตราการโดนบล็อก สามารถเปลี่ยนต้นทุนรวมได้มาก
Web Almanac ของ HTTP Archive ปี 2025 รายงานว่า median homepage มีขนาด 2.86 MB บนเดสก์ท็อป ถ้าคุณเรนเดอร์หน้าเต็มผ่าน residential proxy แบบคิดตามปริมาณข้อมูลที่ 50,000 หน้า/วัน คุณจะใช้แบนด์วิดท์ประมาณ 143 GB/วัน หรือราว 4.29 TB/เดือน ที่เรต $5–$15/GB สำหรับ rotating residential bandwidth นั่นหมายถึง $21,450–$64,350/เดือน ยังไม่รวมการลองใหม่และ request ที่โดนบล็อก
ตัวเลขนี้ทำให้หลายคนช็อกตั้งแต่เห็นครั้งแรก
และนี่คือเหตุผลที่คนมีประสบการณ์มักบล็อกรูปภาพ ฟอนต์ วิดีโอ และสคริปต์ที่ไม่จำเป็นใน headless browser—เป็นการ optimize แบบใช้งานจริงที่ช่วยลดแบนด์วิดท์ได้ 60–80% ถึงจะลดลงขนาดนั้น คุณก็ยังเหลือการใช้งาน 858 GB–1.72 TB/เดือน ซึ่งถ้าใช้เรต residential ก็ยังอยู่ที่ $4,290–$25,740/เดือน
การดึงแบบ direct HTTP หรือระดับ API เบากว่ามาก ประเมินจากภาคปฏิบัติว่า direct HTTP request ใช้เพียง 50–200 KB ต่อหน้า เทียบกับ 1.5–8 MB สำหรับการ render แบบ headless เต็มรูปแบบ ถ้าใช้ 200 KB/หน้า การดึง 50K หน้า/วันจะใช้แค่ประมาณ 300 GB/เดือน
| ประเภท Proxy | รูปแบบการคิดเงิน | ช่วงราคาทั่วไป | ต้นทุนประมาณสำหรับ 50K หน้า/วัน (เรนเดอร์เต็ม) | หมายเหตุ |
|---|---|---|---|---|
| Datacenter (static) | ต่อ IP/เดือน | ~$0.50–$2/IP | ต่ำ (เหมาจ่าย, ไม่มี meter ตาม GB) | เสี่ยงโดนบล็อกสูงบนเว็บที่ป้องกันเข้ม |
| ISP / Static Residential | ต่อ IP หรือ ต่อ GB | ~$3–$8/GB | ปานกลาง-สูง | เหมาะกับงานที่ต้องต่อเนื่องและเป้าหมายยาก |
| Rotating Residential | ต่อ GB | ~$5–$15/GB | สูงมาก เว้นแต่จะ optimize แบนด์วิดท์ | มาตรฐานทองคำด้านความเป็นนิรนาม แต่แพงมากเมื่อสเกลใหญ่ |
| Rotating Datacenter | ต่อ request หรือ ต่อ GB | ~$0.50–$3/GB | ต่ำ-ปานกลาง | เหมาะกับเว็บที่ไม่เข้มงวดมาก |
| AI Scraping API (เช่น Thunderbit) | ต่อ request / credits | ต่างกันตามแพ็ก | คาดการณ์ได้ (ไม่คิดตามแบนด์วิดท์) | คืนข้อมูลที่มีโครงสร้าง ไม่ใช่ raw HTML |
นี่คือเหตุผลที่ผู้ใช้ในฟอรัมมักถามถึงการหมุน ISP proxy แบบ static ด้วยมือ เพื่อเป็นทางเลือกที่ถูกกว่า residential bandwidth แบบคิดตามปริมาณข้อมูลจริง ๆ เรื่อง tradeoff ระหว่างความนิรนามกับต้นทุนมีอยู่จริง และคำตอบที่ถูกต้องขึ้นอยู่กับความซับซ้อนของ anti-bot ในปลายทางและปริมาณงานของคุณ
เลือกประเภท Proxy ให้ได้ภายใน 60 วินาที
ไม่มีบทความคู่แข่งอันดับต้น ๆ สักเจ้าที่ใส่ decision flowchart มาให้เลย นี่คือ logic แบบตัดสินใจทีละขั้นตอน:
-
คุณต้องใช้ IP เดิมตลอดในเซสชันยาว ๆ ไหม? → ใช่ → Static proxy (ถ้าเป้าหมายยาก ใช้ ISP/static residential; ถ้างานง่าย ใช้ datacenter)
-
ไม่ใช่ → คุณกำลังดึงข้อมูลมากกว่า 10K หน้าใช่ไหม? → ใช่ → Rotating proxy (residential สำหรับงานยาก, datacenter สำหรับงานที่ไม่เข้มงวด)
-
คุณต้องรักษา session ไว้สำหรับงานหลายขั้นตอนหรือไม่ (ล็อกอิน, ตะกร้า, ฟอร์ม)? → ใช่ → Sticky session (residential และกำหนด TTL ได้)
-
คุณอยากข้ามการจัดการ proxy ไปเลยไหม? → ใช่ → AI scraping API (เช่น Thunderbit API/MCP)
อีกมุมหนึ่งในรูปแบบตารางสถานการณ์:
| สถานการณ์ของคุณ | แนวทางที่เหมาะสุด |
|---|---|
| ต้องการ raw IP access (จัดการบัญชี, ทดสอบ geo) | จัดการ static หรือ rotating proxy เอง |
| ดึงข้อมูลแบบมีโครงสร้างจากเว็บที่ใช้ JS หนัก | AI scraping API (เช่น Thunderbit /extract) |
| Crawl ปริมาณสูงเพื่อ RAG/indexing | AI distill API (เช่น Thunderbit /distill) + batch |
| Scraping หลายขั้นตอนพร้อมล็อกอิน | Browser proxy ที่มี sticky sessions |
| งบจำกัด และเป้าหมายไม่ได้ป้องกันเข้ม | Datacenter proxy (ถูกสุด) |
ผู้อ่านส่วนใหญ่มักเข้ากลุ่มใดกลุ่มหนึ่งใน 5 แบบนี้ ลองเช็กก่อนเลื่อนลงไปดูรายการเครื่องมือ
เราคัด 9 เครื่องมือนี้จากอะไรบ้าง
ทุกเครื่องมือในลิสต์นี้ถูกประเมินด้วย 7 เกณฑ์:
- ประเภท proxy ที่มีให้: รองรับ static, rotating, ISP, residential, mobile หรือซ่อนชั้น proxy ไปเลย
- ขนาด IP pool: pool ใหญ่กว่ามักหมายถึงคุณภาพการหมุนที่ดีกว่าและโอกาสใช้ IP ซ้ำต่ำกว่า แต่ตัวเลขที่บอกกันเป็นการตลาด ไม่ได้ผ่านการตรวจสอบอิสระ
- รูปแบบราคา: คิดตาม IP, ต่อ GB, ต่อ request, เหมาจ่าย หรือใช้เครดิต รูปแบบ billing สำคัญพอ ๆ กับราคาต่อหน่วย
- การจัดการ anti-bot / detection: มี CAPTCHA solving, fingerprint management ในตัว หรือมีแค่ IP ที่หลากหลาย
- รองรับ sticky session: TTL ที่ตั้งได้ ระยะเวลาสูงสุด และความเสถียร
- ความเหมาะกับ use case: scraping, account management, SEO, ad verification—แต่ละเครื่องมือมีจุดเด่นต่างกัน
- ความง่ายในการเชื่อมต่อ: คุณภาพ API, มี SDK หรือไม่, ใช้งาน dashboard ง่ายแค่ไหน, มี no-code, MCP/CLI หรือเปล่า
รายการเริ่มด้วย Thunderbit (แนวทาง AI scraping API ของเรา) แล้วค่อยไล่ต่อด้วยผู้ให้บริการ proxy อีก 9 เจ้า โดยเรียงตามภาพรวมของสเกลและความลึกของฟีเจอร์
1. Thunderbit: ข้ามการจัดการ Proxy ไปเลยด้วย AI Scraping API
Thunderbit ไม่ใช่ผู้ให้บริการ proxy แต่มันคือทางเลือกเมื่อคุณเริ่มเข้าใจว่า proxy เป็นเพียงเครื่องมือไปสู่เป้าหมาย และสิ่งที่คุณต้องการจริง ๆ คือข้อมูลที่มีโครงสร้าง
เราออกแบบ Thunderbit ให้เป็น AI scraping API ที่จัดการ proxy, anti-bot, CAPTCHA และ JavaScript rendering ให้ในระดับโครงสร้างพื้นฐาน คุณแค่บอกว่าต้องการข้อมูลอะไร แล้วจะได้ผลลัพธ์ที่สะอาดและมีโครงสร้างกลับมา ไม่ต้องตั้งค่า proxy pool ไม่ต้องคิด logic การหมุน IP และไม่ต้อง spoof fingerprint
สำหรับนักพัฒนา (use case หลัก):
- Open API:
POST /distillแปลงหน้าเว็บเป็น Markdown ที่สะอาดPOST /extractรับ JSON schema แล้วคืน field ที่มีโครงสร้าง ทั้งสองแบบรองรับrenderModeและงาน batch (สูงสุด 100 URLs แบบ asynchronous พร้อม webhook) - MCP Server: Claude, Cursor และ AI agents อื่น ๆ สามารถเรียก
thunderbit_extractและthunderbit_distillระหว่างทำงานได้ ชั้น proxy ถูกซ่อนไว้ทั้งหมด—agent ได้แค่ข้อมูล - CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema <json>สำหรับ terminal, CI และ cron workflow รองรับ batch สูงสุด 100 distill / 50 extract URLs - Credit pricing: Distill = 1 เครดิต/URL, Extract = 20 เครดิต/URL ไม่มีการคิดแบนด์วิดท์ตาม GB Starter plan เริ่มที่ $15/เดือน พร้อม 500 credits
สำหรับผู้ใช้ที่ไม่ถนัดเทคนิค, Chrome Extension ให้ประสบการณ์ scraping แบบ 2 คลิกด้วย AI Suggest Fields แล้ว export ไป Excel, Google Sheets, Airtable หรือ Notion ได้เลย ไม่ต้องตั้งค่า proxy เอง—Thunderbit cloud scraping จัดการ IP rotation และ rendering ให้
เหมาะกับ: การดึงข้อมูลที่มีโครงสร้างจากเว็บที่ JS หนัก, RAG/indexing pipeline, เวิร์กโฟลว์ของ AI agents และทุกคนที่อยากใช้เวลาวิเคราะห์ข้อมูลมากกว่าดูแลโครงสร้างพื้นฐานของ proxy
ข้อจำกัด: ไม่ใช่ raw proxy provider ถ้าคุณต้องใช้ raw IP สำหรับจัดการบัญชี ทดสอบ geo หรือ sneaker bots proxy แบบดั้งเดิมยังเหมาะกว่า
ราคา: มี Free tier และ Starter เริ่มราว $15/เดือน ดูแพ็กปัจจุบันได้ที่ Thunderbit Pricing
ถ้าอยากรู้เชิงลึกว่า AI web scraping ทำงานข้างในอย่างไร ดูคู่มือ AI web scraping ของเรา
2. Bright Data: IP Pool ใหญ่ที่สุดสำหรับ Static และ Rotating Proxy

Bright Data เป็นหนึ่งในชุด proxy ที่เก่าแก่และครบเครื่องที่สุดในตลาด จุดขายหลักคือ 400M+ rotating residential IPs ครอบคลุม 195 ประเทศ พร้อมการกำหนดเป้าหมายระดับเมือง/รัฐ/รหัสไปรษณีย์/ASN และยังมี static ISP proxies มากกว่า 1.3M IP
- ประเภท Proxy: Residential (rotating), ISP/static residential, datacenter (static และ rotating), mobile
- IP Pool: 400M+ residential, 1.3M+ ISP—pool ที่อ้างว่ามีขนาดใหญ่ที่สุดในที่สาธารณะ
- การจัดการ Anti-bot: ผลิตภัณฑ์ Web Unlocker พร้อม CAPTCHA solving และ fingerprint management; Browser API สำหรับ headless rendering
- Sticky sessions: มี กำหนดค่าได้ (โดยทั่วไป 10–30 นาทีสำหรับ residential)
ราคา: Residential แบบ PAYG ปกติที่ $8/GB และมี promo rate ราว $4/GB สำหรับ commitment ที่สูงขึ้น Datacenter เริ่มประมาณ ~$0.90/IP และ ISP เริ่มประมาณ ~$1.30/IP โครงสร้างราคายืดหยุ่น แต่ถ้าใช้สเกลใหญ่ต้นทุนจะพุ่งเร็ว
เหมาะกับ: องค์กรที่ต้องการ IP หลากหลายมาก ๆ, geotargeting ละเอียด และชุดผลิตภัณฑ์ครบ ทีมที่มีงบและทีมเทคนิคพอจะรับมือ dashboard ที่ซับซ้อน
ข้อเสีย: dashboard มีช่วงเรียนรู้ค่อนข้างมาก ราคาอาจสูงสำหรับทีมเล็ก—ถ้าคุณดึง 50K หน้า/วันผ่าน residential proxy บิลแบนด์วิดท์จะโตเร็วมาก ผู้ใช้ในเว็บรีวิวมักพูดถึงความซับซ้อนของราคา
3. Oxylabs: Rotating และ Static Proxy ระดับพรีเมียมสำหรับงานสเกลใหญ่
Oxylabs เป็นผู้ให้บริการระดับ enterprise อีกเจ้า ที่เน้นโครงสร้างพื้นฐานสำหรับ web scraping อย่างจริงจัง พวกเขามี residential, static residential/ISP, datacenter, mobile, Web Unblocker และ Scraper API
- ประเภท Proxy: Residential (rotating), ISP/static residential, datacenter (static และ rotating), mobile
- IP Pool: pool ระดับ enterprise ขนาดใหญ่ (จำนวนปัจจุบันที่แน่นอนอาจเปลี่ยนตามผลิตภัณฑ์)
- การจัดการ Anti-bot: Web Unblocker และ Scraper APIs ที่รองรับ rendering และ CAPTCHA
- Sticky sessions: เวลา session มาตรฐานของ residential คือ 10 นาที และสามารถตั้งค่าอื่นได้ บางชุดรองรับได้นานถึง 24 ชั่วโมง
ราคา: Residential เริ่มที่ $6/GB และลดเหลือ $3.50/GB เมื่อใช้ถึง 1TB ส่วน ISP คิดตาม IP/เดือน จัดอยู่ในกลุ่มพรีเมียม
เหมาะกับ: องค์กรขนาดใหญ่ที่ต้องเก็บข้อมูลจำนวนมาก และทีมที่ต้องการ managed scraping solution ควบคู่กับ raw proxy access
ข้อเสีย: ราคาสูงกว่าตัวเลือกระดับกลาง อาจเกินความจำเป็นสำหรับโปรเจกต์ขนาดเล็กถึงกลาง
4. Smartproxy (Decodo): Rotating Proxy ราคาดี ตั้งค่าง่าย
Smartproxy ซึ่งตอนนี้รีแบรนด์เป็น Decodo เป็นผู้ให้บริการระดับกลางที่ได้รับความนิยม เพราะราคาที่แข่งขันได้และ dashboard ที่ใช้งานง่าย ผู้ใช้จำนวนมากยังคงค้นหาชื่อ "Smartproxy" อยู่ จึงจะเห็นทั้งสองชื่อปนกันในตลาด
- ประเภท Proxy: Residential (rotating), ISP/static residential, datacenter, mobile
- IP Pool: 115M+ residential IPs
- การจัดการ Anti-bot: มี Site Unblocker และ scraping API
- Sticky sessions: 1, 10, 30, 60 นาที หรือกำหนดเองได้สูงสุด 24 ชั่วโมง ครอบคลุม residential, datacenter, ISP และ mobile
ราคา: Residential เริ่มที่ $2/GB ในแพ็ก 3GB และถูกลงเมื่อใช้มากขึ้น Static residential/ISP เริ่มราว $3.33/IP ใน tier แรก ถือว่าคุ้มกับชุดฟีเจอร์ที่ได้
เหมาะกับ: ทีมขนาดเล็กถึงกลางที่ต้องการสมดุลระหว่างราคาและฟีเจอร์ และผู้ซื้อ proxy ครั้งแรกที่อยากให้เริ่มใช้งานได้ง่าย
ข้อเสีย: IP pool เล็กกว่า Bright Data หรือ Oxylabs ผู้ใช้บางส่วนรายงานความเร็วไม่สม่ำเสมอขึ้นอยู่กับ target และ pool
5. IPRoyal: Static และ Rotating Proxy ราคาประหยัด พร้อมเงื่อนไขยืดหยุ่น
IPRoyal สร้างจุดยืนเป็นตัวเลือกประหยัดงบที่มีจุดขายเฉพาะตัว: residential traffic แบบไม่หมดอายุ ซื้อ bandwidth มา แล้วใช้เมื่อไหร่ก็ได้
- ประเภท Proxy: Residential (rotating), ISP/static residential, datacenter, mobile, sneaker proxies
- IP Pool: กำลังเติบโต; ขนาดที่แน่ชัดในปัจจุบันแตกต่างตามแหล่งอ้างอิง
- การจัดการ Anti-bot: พื้นฐาน—อาศัยคุณภาพ IP มากกว่าฟีเจอร์ CAPTCHA solving หรือ fingerprint management ในตัว
- Sticky sessions: สูงสุด 7 วัน สำหรับ residential
ราคา: Residential เริ่มที่ $7/GB และลดเหลือ $1.75/GB เมื่อซื้อจำนวนมาก โมเดล traffic แบบไม่หมดอายุทำให้คุณไม่เสีย bandwidth ที่ไม่ได้ใช้เมื่อสิ้นเดือน
เหมาะกับ: ผู้ใช้ที่ต้องคุมงบ, รูปแบบการใช้งานที่ขึ้น ๆ ลง ๆ หรือเป็นฤดูกาล, sneaker และ ecommerce use case
ข้อเสีย: IP pool เล็กกว่าผู้ให้บริการระดับพรีเมียม มีฟีเจอร์ anti-detection ในตัวน้อยกว่า และไม่ค่อยเหมาะกับเป้าหมายที่ป้องกันเข้ม
6. SOAX: Rotating Proxy แบบเจาะพื้นที่ พร้อมตัวกรองละเอียด
SOAX เด่นที่สุดเมื่อคุณต้องการการกำหนดเป้าหมายแบบเฉพาะพื้นที่มาก ๆ ตัวกรองของเขาลงได้ถึงระดับประเทศ ภูมิภาค เมือง ISP และ ASN ซึ่งมีประโยชน์มากสำหรับ ad verification และ market research ที่ต้องการความแม่นยำด้านสถานที่
- ประเภท Proxy: Residential (rotating), ISP/static, datacenter, mobile
- IP Pool: 155M+ IPs across 195+ locations
- การจัดการ Anti-bot: มี clean IP pool ที่อัตราโดนแบนต่ำ; มี Web Data API
- Sticky sessions: มี พร้อมปรับ refresh rate ได้; รองรับโปรโตคอล HTTP(S), SOCKS5, UDP และ QUIC
ราคา: Business plan ที่ $4.00/GB รวม 800GB ($3,200/เดือน) แพ็ก enterprise เริ่มที่ $0.32/GB สำหรับดีลที่ปรับตามปริมาณใช้งาน
เหมาะกับ: ทีมวิจัยตลาดที่ต้องการข้อมูลระดับท้องถิ่นละเอียดมาก และงาน ad verification ข้ามภูมิศาสตร์หรือ ISP เฉพาะ
ข้อเสีย: อาจรู้สึกซับซ้อนเกินไปสำหรับงานง่าย ๆ ระยะเวลาสูงสุดของ sticky session แตกต่างตามผลิตภัณฑ์—ควรตรวจสอบก่อนตัดสินใจ
7. ScraperAPI: เอา Rotating Proxy มารวมใน API แบบเน้น Scraping ก่อน
ScraperAPI ไม่ใช่ผู้ให้บริการ proxy แบบดั้งเดิม เหมือน Thunderbit คือมันซ่อนชั้น proxy ไป แต่ยังส่งกลับมาเป็น raw HTML แทนข้อมูลที่มีโครงสร้าง ส่ง URL เข้าไป แล้วรับ HTML ที่เรนเดอร์แล้วกลับมา ScraperAPI จัดการการเลือก proxy การหมุน IP การ retry และ anti-bot ให้เบื้องหลัง
- การทำงาน: ใช้ API endpoint เดียว แล้วแนบ URL เป้าหมาย จากนั้น ScraperAPI จะดูแลทุกอย่าง
- การจัดการ Anti-bot: มี CAPTCHA solving, JS rendering และ geotargeting ในตัว
- Sticky sessions: ไม่ได้ใช้ในความหมายแบบดั้งเดิม—API จัดการ session ภายในระบบเอง
ราคา: มี 1,000 API credits ฟรี/เดือน หน้าเว็บมาตรฐาน = 1 credit Amazon = 5 credits Google/Bing = 25 credits LinkedIn = 30 credits เว็บไซต์ที่อยู่หลัง Cloudflare/DataDome/PerimeterX จะบวก 10 credits ต่อ request แพ็กแบบเสียเงินเริ่มประมาณ $49/เดือน สำหรับ 100K credits
เหมาะกับ: นักพัฒนาที่อยากข้ามโครงสร้างพื้นฐานของ proxy แล้วรับ HTML กลับมาเลย และงาน scraping ขนาดเล็กถึงกลาง
ข้อเสีย: ส่งกลับเป็น raw HTML คุณยังต้อง parse และจัดโครงสร้างเอง และอาจแพงมากเมื่อใช้ปริมาณสูงกับเว็บที่ป้องกันเข้มเพราะเครดิตถูกคูณเพิ่ม เปรียบเทียบกับ Thunderbit: ScraperAPI ให้ HTML; ส่วน /extract ของ Thunderbit ให้ JSON ที่สอดคล้องกับ schema โดยตรง
8. Webshare: Datacenter และ Rotating Proxy ราคาประหยัด ไม่มีฟีเจอร์เกินจำเป็น
Webshare คือทางเลือกแบบเน้นใช้งานตรงไปตรงมา มี datacenter proxy ราคาถูกมาก มี free tier ที่ให้ proxy 10 ตัว และเครื่องมือสำหรับนักพัฒนาที่ใช้ง่าย (Webshare ถูก Oxylabs เข้าซื้อในปี 2024 ซึ่งอาจมีผลต่อทิศทางผลิตภัณฑ์ในอนาคต)
- ประเภท Proxy: Datacenter (static และ rotating), residential (rotating), ISP
- IP Pool: อ้างว่า 80M+ residential และมี datacenter fleet ขนาดใหญ่
- การจัดการ Anti-bot: ขั้นต่ำ—ไม่มี CAPTCHA solving ในตัว อาศัยความหลากหลายของ IP เป็นหลัก
- Sticky sessions: มี สำหรับ residential proxies
ราคา: Rotating residential เริ่มที่ $1.40/GB Static residential เริ่มที่ $0.23/IP และมี free tier พร้อม proxy 10 ตัว ถือเป็นหนึ่งในตัวเลือกที่ถูกที่สุดในตลาด
เหมาะกับ: นักพัฒนาที่งบจำกัด เครื่องมือภายในองค์กร การ scrape เว็บที่ป้องกันไม่เข้ม และการทำ prototype
ข้อเสีย: IP ของ datacenter มักถูกบล็อกบนเว็บใหญ่ ๆ บ่อย ฟีเจอร์ anti-detection จำกัด และคุณภาพ residential pool อาจไม่สม่ำเสมอ
9. Storm Proxies: Rotating Proxy แบบง่าย พร้อมราคาเหมาจ่าย
Storm Proxies เป็นหนึ่งในไม่กี่เจ้า ที่มีแพ็ก rotating proxy แบบเหมาจ่ายและ bandwidth ไม่จำกัด โครงสร้างราคาสะดวกมาก: จ่ายตามจำนวน proxy port ต่อเดือน ใช้แบนด์วิดท์ได้เท่าไหร่ก็ได้
- ประเภท Proxy: Rotating residential, rotating datacenter, dedicated static datacenter
- IP Pool: หน้า official อ้างว่าเป็น 20M+ residential reverse backconnect proxies แต่รีวิวจากแหล่งอื่นระบุว่า pool ที่ใช้งานจริงเล็กกว่านั้น
- การจัดการ Anti-bot: ขั้นต่ำ—ไม่มี CAPTCHA หรือ fingerprint management ในตัว
- Sticky sessions: หมุนทุก request หรือทุก 3 / 15 นาที
ราคา: คิดแบบเหมาจ่ายรายเดือนตามจำนวน proxy port แหล่งข้อมูลภายนอกอธิบายแพ็กเช่น 5 residential ports ราว ~$50/เดือน พร้อม bandwidth ไม่จำกัด ควรเช็กหน้าชำระเงินก่อนซื้อจริง
เหมาะกับ: คนที่อยากได้ค่าใช้จ่ายรายเดือนคงที่ ไม่ต้องกังวลเรื่อง meter ของ bandwidth งาน scraping เบาถึงปานกลางที่ความแน่นอนของราคาสำคัญกว่าขนาด pool
ข้อเสีย: effective IP pool เล็กมาก (เสี่ยงใช้ IP ซ้ำสูง) geotargeting จำกัด dashboard ดูเก่า และไม่เหมาะกับเว็บที่ป้องกันเข้ม
Static vs Rotating Proxy: เปรียบเทียบเครื่องมือแบบเทียบกันตรง ๆ
| เครื่องมือ | ประเภท Proxy / API | ขนาด Pool โดยประมาณ | รูปแบบราคา | การจัดการ Anti-bot | รองรับ Sticky Session | Use Case ที่เหมาะสุด |
|---|---|---|---|---|---|---|
| Thunderbit | AI scraping API, MCP, CLI, Chrome Extension | batch สูงสุด 100 URLs | เครดิต (Distill 1/URL, Extract 20/URL) | ครบ: rendering, anti-bot, CAPTCHA | N/A (จัดการให้) | ดึงข้อมูลที่มีโครงสร้าง, RAG, AI agents |
| Bright Data | Residential, ISP, datacenter, mobile | 400M+ residential, 1.3M+ ISP | ต่อ GB + ต่อ IP + ต่อ request | Web Unlocker, Browser API | มี (10–30 นาที) | ใช้ระดับ enterprise, geotargeting |
| Oxylabs | Residential, ISP, datacenter, mobile | pool enterprise ขนาดใหญ่ | Residential $6→$3.50/GB | Web Unblocker, Scraper APIs | มี (มาตรฐาน 10 นาที, ปรับได้) | Enterprise scraping, managed solutions |
| Smartproxy/Decodo | Residential, ISP, datacenter, mobile | 115M+ residential | Residential ~$3.75/GB; ISP ~$3.33/IP | Site Unblocker | มี (1–60 นาที, สูงสุด 24 ชม.) | ตลาดกลาง, ผู้ซื้อครั้งแรก |
| IPRoyal | Residential, ISP, datacenter, mobile, sneaker | pool เติบโตต่อเนื่อง | Residential $7→$1.75/GB, ไม่หมดอายุ | พื้นฐาน (คุณภาพ IP) | มี (สูงสุด 7 วัน) | ผู้ใช้ประหยัดงบ, การใช้งานตามฤดูกาล |
| SOAX | Residential, ISP, datacenter, mobile | 155M+, 195+ locations | Business $4/GB; enterprise $0.32/GB | clean pools, Web Data API | มี (refresh ได้ตามต้องการ) | เจาะพื้นที่ละเอียด, market research |
| ScraperAPI | Scraping API พร้อมการหมุน proxy | ระดับบริการ (ไม่ใช่ raw pool) | ต่อเครดิต; standard 1, Amazon 5, Google 25 | CAPTCHA, rendering, geo ในตัว | จัดการภายในระบบ | นักพัฒนาที่อยากได้ HTML กลับมา |
| Webshare | Datacenter, residential, ISP | 80M+ residential | rotating res $1.40/GB; static $0.23/IP | ขั้นต่ำ | มี (residential) | dev งบจำกัด, prototype |
| Storm Proxies | Rotating residential/datacenter, static DC | อ้างว่า 20M+ | เหมาจ่ายรายเดือนต่อ port, bandwidth ไม่จำกัด | ขั้นต่ำ | ทุก request / 3 / 15 นาที | ค่าใช้จ่ายคงที่, scraping เบา |
NetNut ถูกถอดออกจากการเปรียบเทียบนี้: ณ เดือนสิงหาคม 2026, netnut.io แสดงประกาศยึดทรัพย์ของรัฐบาลกลางสหรัฐแทนหน้าเว็บสินค้า
เครื่องมือเหล่านี้แบ่งได้เป็น 3 กลุ่ม raw proxy infrastructure (Bright Data, Oxylabs, Smartproxy, IPRoyal, SOAX, Webshare, Storm Proxies) ให้คุณเข้าถึง IP แล้วคุณต้องจัดการอย่างอื่นเอง scraping APIs (ScraperAPI) ซ่อนชั้น proxy แต่ยังคืน raw HTML AI extraction APIs (Thunderbit) ซ่อนทั้งชั้น proxy และชั้น parsing แล้วคืนข้อมูลที่มีโครงสร้างโดยตรง
เมื่อ Proxy ไม่ใช่คำตอบ: AI Scraping API เทียบกับ Proxy ที่คุณดูแลเอง
นี่คือส่วนที่บทความคู่แข่งไม่มีใครพูดถึง: คนส่วนใหญ่ที่อ่านเรื่อง "static vs rotating proxies" ไม่ได้คลั่ง proxy พวกเขาแค่อยากดึงข้อมูล และ proxy เป็นแค่เครื่องมือไปสู่เป้าหมาย
สำหรับหลาย use case การต้องจัดการ proxy pool, logic การหมุน, fingerprint spoofing และ CAPTCHA solving คือภาระงานเกินจำเป็นที่เครื่องมือแบบ API-first ตัดทิ้งได้เลย แต่ก็ไม่เสมอไป นี่คือเวลาที่แต่ละแนวทางเหมาะสม:
Proxy ที่ดูแลเองเหมาะเมื่อคุณต้องการ raw IP access สำหรับจัดการบัญชี, ทดสอบ geo, หรือ sneaker bots; ควบคุม ASN, carrier หรือพฤติกรรม exit-IP ได้ละเอียด; หรือมี browser/proxy stack แบบกำหนดเองที่ทีมคุณดูแลอยู่แล้ว
API-first extraction เหมาะเมื่อคุณต้องการ ข้อมูลที่มีโครงสร้าง (รายการสินค้า ข้อมูลติดต่อ ราคา) มากกว่า raw HTML, Markdown ที่สะอาดสำหรับ RAG pipeline, เวิร์กโฟลว์ของ AI agent ที่ควรเข้าถึงเว็บระหว่างทำงานแบบไม่สะดุดสายตา หรือแค่อยากใช้เวลาน้อยลงกับ infrastructure ของ proxy และมีเวลามากขึ้นกับข้อมูล
API ของ Thunderbit จัดการ rendering, anti-bot และ CAPTCHA ฝั่งเซิร์ฟเวอร์ นักพัฒนาได้ Markdown ที่สะอาด (/distill) หรือ JSON ที่ตรงกับ schema (/extract) โดยไม่ต้องตั้งค่า proxy pool หรือกังวลเรื่อง fingerprint consistency ส่วน MCP server ทำให้ Claude หรือ Cursor เรียก scrape ระหว่างงานผ่าน thunderbit_extract ได้—ชั้น proxy แทบมองไม่เห็นเลย
ถ้าอยากดูมุมกว้างขึ้นเกี่ยวกับ web scraping without coding เรามีบทความแยกไว้แล้ว
แล้วเครื่องมือ Static vs Rotating Proxy ตัวไหนเหมาะกับคุณ?
ขอสรุปเป็นสถานการณ์เฉพาะ เพราะคำตอบแบบ "แล้วแต่กรณี" แม้จะถูก แต่ก็ช่วยไม่มาก:
- เหมาะสุดสำหรับองค์กรที่ต้องการ IP pool ขนาดใหญ่: Bright Data, Oxylabs
- เหมาะสุดสำหรับทีมประหยัดงบ: IPRoyal, Webshare, Storm Proxies
- เหมาะสุดสำหรับการเริ่มใช้งานระดับกลางที่ง่าย: Smartproxy/Decodo, SOAX
- เหมาะสุดถ้าอยากข้ามการจัดการ proxy ไปเลย: Thunderbit (ข้อมูลที่มีโครงสร้าง), ScraperAPI (raw HTML)
- เหมาะสุดสำหรับ workflow ของ AI agent และ MCP: Thunderbit
ระบบ anti-bot ฉลาดขึ้นเรื่อย ๆ—ทั้ง IP reputation, TLS fingerprinting, behavioral analysis และ header consistency—ในขณะเดียวกันต้นทุนการดูแล proxy เองก็สูงขึ้นตาม สำหรับทีมที่เป้าหมายสุดท้ายคือข้อมูลเว็บที่สะอาดและมีโครงสร้าง เครื่องมือแบบ API-first ที่ซ่อนชั้น proxy ทั้งหมดกำลังกลายเป็นตัวเลือกที่ใช้งานได้จริงมากขึ้นเรื่อย ๆ
การเปลี่ยนแปลงนี้ไม่ใช่แค่ทฤษฎี มันเกิดขึ้นแล้ว
ถ้าคุณอยากเห็นภาพการใช้งานจริง Thunderbit Chrome Extension เป็นจุดเริ่มต้นที่ดีสำหรับผู้ใช้ที่ไม่ถนัดเทคนิค และ เอกสาร API จะช่วยอธิบาย workflow สำหรับนักพัฒนา หากต้องการบริบทเพิ่มเติมเกี่ยวกับ landscape ของเครื่องมือ scraping โดยรวม ลองดูการเปรียบเทียบ best AI web scrapers ของเราได้เช่นกัน คุณยังดูวิดีโอสาธิตได้ที่ Thunderbit YouTube Channel
ลองใช้ Thunderbit AI Web Scraper Get Started Free
คำถามที่พบบ่อย
1. เมื่อไรควรใช้ static proxy แทน rotating proxy?
ใช้ static proxy เมื่อคุณต้องการ IP เดิมต่อเนื่องระหว่าง session—เช่น จัดการบัญชี เข้าถึงคอนเทนต์ที่ล็อกตามภูมิภาค ติดตามอันดับ หรือแพลตฟอร์มใด ๆ ที่มองว่าการเปลี่ยน IP เป็นเรื่องน่าสงสัย ถ้า target คาดหวังให้เห็นตัวตนเดิมต่อเนื่อง static คือคำตอบที่เหมาะกว่า สำหรับเป้าหมายที่ยาก ISP/static residential จะปลอดภัยกว่า datacenter
2. sticky session ต่างจาก static proxy อย่างไร?
sticky session จะคง IP เดิมไว้ในช่วงเวลาที่กำหนดได้ เช่น 10 นาที 30 นาที หรือสูงสุด 24 ชั่วโมงตามผู้ให้บริการ แล้วค่อยเปลี่ยนเป็น IP ใหม่ ส่วน static proxy จะใช้ IP เดิมไปเรื่อย ๆ จนกว่าคุณจะเปลี่ยนเอง ทั้งสองอย่างไม่เหมือนกัน ถึงแม้เอกสารของผู้ให้บริการบางเจ้าใช้คำเหล่านี้ปนกัน
3. ทำไม rotating proxy ยังโดนบล็อกในบางเว็บ?
เพราะระบบ anti-bot สมัยใหม่ตรวจจับหลายชั้น ไม่ได้ดูแค่ IP อย่างเดียว การ fingerprint แบบ TLS/JA3 การวิเคราะห์พฤติกรรม (แพตเทิร์น request, เส้นทางการนำทาง) และการตรวจความสอดคล้องของ header ล้วนสามารถจับทราฟฟิกอัตโนมัติได้ ไม่ว่า IP จะเปลี่ยนแค่ไหนก็ตาม rotating IP ช่วยลด rate limit ที่อิง IP แต่ไม่แก้การตรวจจับชั้นอื่น ๆ เหล่านี้
4. rotating residential proxy แพงแค่ไหนเมื่อใช้ในสเกลใหญ่?
ราคาสาธารณะที่ซื้อเองได้อยู่ประมาณ $1.40/GB (Webshare) ไปจนถึง $8/GB แบบ PAYG ปกติ (Bright Data) และมีส่วนลดสำหรับ enterprise ถ้าเรนเดอร์หน้าเต็มที่ระดับ 50K หน้า/วัน โดยหน้าเฉลี่ย ~2.86 MB แค่แบนด์วิดท์อย่างเดียวอาจพุ่งถึง 4+ TB/เดือน—ซึ่งอาจกลายเป็นเงินหลักหมื่นดอลลาร์ เครื่องมือแบบคิดตามเครดิตหรือ per-request API (เช่น Thunderbit หรือ ScraperAPI) จึงให้ราคาที่คาดการณ์ได้มากกว่า โดยไม่ต้องวัดแบนด์วิดท์
5. AI scraping API ใช้แทน proxy ได้ทั้งหมดไหม?
สำหรับการดึงข้อมูลที่มีโครงสร้างและงาน web scraping ส่วนใหญ่ คำตอบคือได้บ่อยครั้ง เครื่องมืออย่าง Thunderbit จัดการ rotation ของ proxy, มาตรการ anti-bot, CAPTCHA solving และ JS rendering ให้ในระดับโครงสร้างพื้นฐาน—คุณได้ข้อมูลสะอาดกลับมาโดยไม่ต้องดูแล proxy เอง แต่สำหรับงานที่ต้องใช้ raw IP access เช่น การจัดการบัญชี การทดสอบ geo หรือ sneaker bots proxy แบบดั้งเดิมยังจำเป็น
อ่านเพิ่มเติม



