
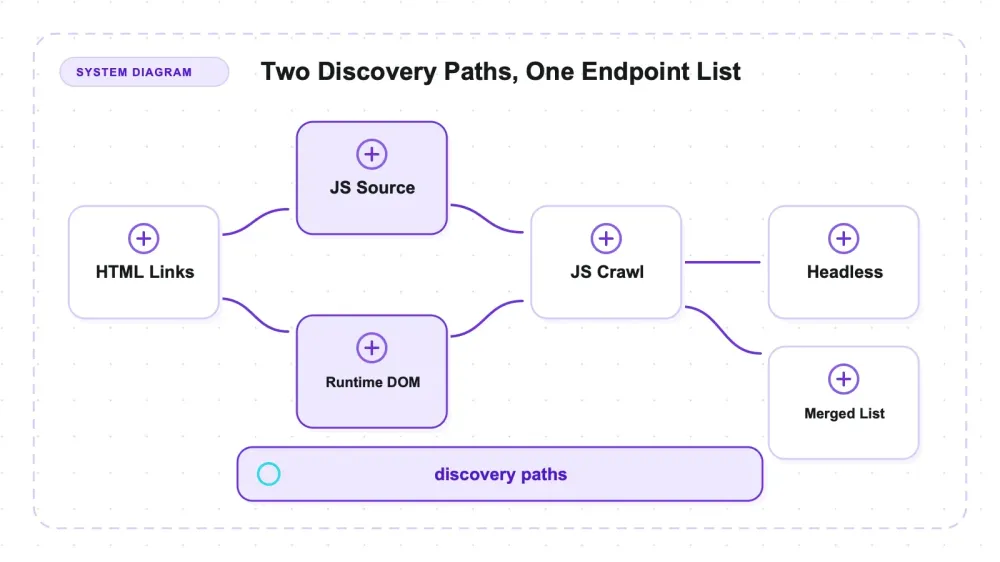
Katana คือโปรแกรม crawler สำหรับค้นหา endpoint ของ ProjectDiscovery — ไบนารีที่เขียนด้วย Go, ใช้สัญญาอนุญาต MIT และรับเป้าหมายเข้าไปแล้วส่งคืน URL กับ endpoint เพื่อนำไปใช้กับเครื่องมือถัดไปใน pipeline มันทำงานได้ทั้งโหมด HTTP แบบไม่เปิดเบราว์เซอร์ หรือจะใช้ -headless เพื่อควบคุม Chromium ก็ได้ คู่มือทางการมักบอกว่าโหมด headless ครอบคลุมได้มากกว่า แต่ชุดทดสอบนี้แสดงให้เห็นว่า “ชนิดของ endpoint” สำคัญพอ ๆ กับ “จำนวนที่พบ” เลยทีเดียว
ผมสร้างเว็บตัวอย่างขนาดเล็กที่มี endpoint อยู่ 3 ประเภทอย่างจงใจให้ต่างกัน และทดสอบว่าแต่ละโหมดหาเจออะไรบ้างบน v1.6.1 ที่ -d 4 เนื้อหา HTML ปกติถูกพบครบ 4/4 ลิงก์ และเส้นทางต่อเนื่อง 3 ชั้นครบทุกการตั้งค่าทั้งสี่แบบ แต่ความต่างจะโผล่ขึ้นมาใน endpoint ที่ถูกเปิดผ่าน source ของ JavaScript เทียบกับการเปลี่ยน DOM ระหว่างรันจริง
บน fixture นี้ headless พบ endpoint กลุ่ม runtime DOM ที่โหมดแบบไม่เปิดเบราว์เซอร์ที่ทดสอบไว้หาไม่เจอ ขณะที่โหมด standard พร้อม -jc พบ literal ในไฟล์ JavaScript ซึ่ง headless ทั้งสองรันหาไม่เจอ ไม่มีสักแถวในตารางสี่คำสั่งที่ครอบคลุมได้ทั้งสองกลุ่มนี้ ส่วนขอบเขตการค้นหา การ resume และ known files ก็เป็นข้อจำกัดเชิงปฏิบัติอีกชุดหนึ่ง
Katana คืออะไรจริง ๆ
Katana crawler — projectdiscovery/katana บน GitHub — เขียนด้วย Go และใช้ MIT License ผมทดสอบ v1.6.1 เมื่อวันที่ 27 กรกฎาคม 2026; เวอร์ชันสำคัญมาก เพราะผลเรื่อง coverage และ known files ด้านล่างเป็นข้อสังเกตเฉพาะกับ build นั้น ๆ
ป้ายกำกับของหมวดหมู่สำคัญกว่าปกติในกรณีนี้ endpoint-discovery crawler ไม่ใช่เครื่องมือดึงข้อมูลแบบ field extractor ถ้าคุณต้องการ go web crawler ที่คืนชื่อสินค้าและราคาออกมาเป็น JSON แบบมีโครงสร้าง Katana ไม่ใช่ตัวที่ใช่เลย — มันจะบอกคุณได้แค่ว่า /products/1138 มีอยู่จริง แต่ไม่พูดอะไรเกี่ยวกับหน้าดังกล่าวเลย นั่นคือพฤติกรรมตามดีไซน์ และถ้าเอามันวัดด้วยงาน extraction ก็เหมือนเอาเครื่องตรวจโลหะไปให้คะแนนเรื่องการประเมินราคาจิวเวลรี
งานหลักของมันคือ recon ด้าน offensive security และ pipeline แบบอัตโนมัติ: รับ STDIN แล้วปล่อย URL ออก STDOUT จากนั้นส่งต่อไปยังเครื่องมือถัดไป ข้อควรระวังที่ต้องย้ำไว้ก่อนเลยคือ ทุกการวัดในที่นี้ทดสอบกับ fixture บน 127.0.0.1 ที่ผมเขียนขึ้นเองทั้งหมด ให้ใช้ Katana กับโฮสต์ที่คุณเป็นเจ้าของหรือได้รับอนุญาตเป็นลายลักษณ์อักษรเท่านั้น ไม่มีอะไรในบทความนี้เกี่ยวกับการหลบเลี่ยงการป้องกันของใครทั้งนั้น สิ่งที่เราดูกันคือคำสั่งหนึ่ง ๆ มัน enumerate พื้นผิว endpoint ของเว็บได้มากแค่ไหน
สามโหมด และสิ่งที่แต่ละโหมดมองเห็นได้
โหมด standard คือ HTTP client ของ Go มันดึงหน้าเว็บ วิเคราะห์ HTML ตามลิงก์ href แล้วไม่เปิดเบราว์เซอร์เลย เร็ว ประหยัด และมองไม่เห็นอะไรที่เกิดขึ้นหลัง JavaScript ทำงาน
-jc (-js-crawl) เพิ่มตัว parser สำหรับ JavaScript เข้าไปบนเส้นทางแบบไม่เปิดเบราว์เซอร์นั้น มันดาวน์โหลดไฟล์ .js ที่ลิงก์ไว้ แล้วดึง string literal ที่มีรูปเป็น URL ออกจาก source โดยไม่ execute อะไรทั้งนั้น แค่ “อ่าน” เท่านั้น ยังมี -jsl (jsluice) ที่ README บอกว่าเป็น parser หนักกว่าและใช้หน่วยความจำมากกว่า — ผมไม่ได้ทดสอบตัวนั้น จึงพูดไม่ได้ว่ามันเปลี่ยนภาพ coverage หรือไม่
-headless จะสั่ง Chromium ให้รันสคริปต์บนหน้าเว็บ ใน fixture นี้ มันเป็นโหมด Katana เพียงแบบเดียวที่ดึงเส้นทางซึ่งถูกประกอบจาก fragments แล้วฉีดเข้า DOM ตอนรันจริงได้ ผลลัพธ์นี้ไม่ได้แปลว่าทุก parser หรือทุกโหมดในอนาคตจะดึงอะไรแบบเดียวกันได้
จากนั้นก็เป็นเรื่องของ scope model ซึ่งเป็นส่วนที่ผมอยากให้จำไว้ก่อนพิมพ์อะไรลง production
| Flag | ควบคุมอะไร | ค่า / ค่าเริ่มต้น |
|---|---|---|
-fs (field scope) | โฮสต์ใดบ้าง ที่อยู่ในขอบเขต | dn, rdn, fqdn หรือ regex แบบกำหนดเอง — ค่าเริ่มต้นคือ rdn |
-cs และ -cos | regex สำหรับกรอง URL ภายใน field scope นั้น | — |
-kf | known files: robots.txt และ sitemap.xml | README ระบุว่าต้องใช้ depth อย่างน้อย 3 |
-d | ระดับความลึก | ค่าเริ่มต้น 3 |
-resume | ดำเนิน crawl ต่อจากที่หยุดไว้ | — |
ลำดับนี้ไม่ใช่แค่เรื่องความสวยงามของเอกสาร: มันเป็นตัวตัดสินว่า regex ของ host จะขยายการ crawl หรือทำให้มันว่างเปล่าแบบเงียบ ๆ
การติดตั้ง: หนึ่งไบนารี กับอีกหนึ่งข้อยกเว้น
มี 3 ทางเข้า และมีเพียงทางเดียวที่ต้องมี toolchain:
| วิธีติดตั้ง | สิ่งที่ต้องมี |
|---|---|
ติดตั้งจากซอร์ส: go install github.com/projectdiscovery/katana/cmd/katana@latest | ต้องใช้ Go 1.25 ขึ้นไปตามที่ระบุ |
| ไบนารีที่คอมไพล์ไว้ล่วงหน้าบนหน้า release | ไม่ต้องมี toolchain |
| Docker image | ไม่ต้องมี toolchain |
ของผมลงไปที่ ~/go/bin/katana และรายงาน Current version: v1.6.1 ทุกครั้งที่รัน จนถึงตรงนี้ก็เป็นสไตล์ Go ที่คุ้นเคย: ไฟล์เดียว จบ ไม่ต้องมี runtime เพิ่ม
ข้อยกเว้นคือ headless เพราะตรงนั้นเบราว์เซอร์เป็น dependency แยกจากตัวไบนารี:
ที่ที่ -headless รัน | สิ่งที่ต้องใช้ |
|---|---|
| เครื่องของผม | Katana ตรวจพบ Chromium ที่ติดตั้งอยู่แล้วโดยอัตโนมัติ ผมไม่ได้บันทึก build ของเบราว์เซอร์ และไม่ได้ระบุ path ของเบราว์เซอร์ |
| เซิร์ฟเวอร์โล่ง ๆ ตามคำแนะนำ Ubuntu ของโปรเจกต์ | ต้อง apt install google-chrome-stable ก่อน headless จะทำงานได้ |
| เส้นทาง Docker | ใช้ headless ร่วมกับ -system-chrome |
ถ้าเป็นเซิร์ฟเวอร์โล่ง ๆ ความสะดวกสบายตรงนี้จะหายไป ให้เผื่อ budget สำหรับเบราว์เซอร์ ไม่ใช่แค่ตัวไบนารี ทันทีที่ -headless โผล่เข้ามาใน command line ของคุณ
อีกเรื่องเล็กแต่สำคัญถ้าคุณใช้ใน CI: Katana จะเช็กเวอร์ชันกับ GitHub ตอนเริ่มต้น -duc เอาไว้ปิดฟีเจอร์นั้น บนเครื่อง laptop อาจเป็นเรื่องจุกจิก แต่บน runner ที่ตัดขาดอินเทอร์เน็ตหรือมี rate limit มันคือ network round trip ทุกครั้งที่คุณไม่ได้ขอ ผมใส่ -duc ในรันที่ใช้จับเวลา เพื่อให้ตัวเลขสะท้อนเวลา crawl จริง ไม่ใช่เวลาคุยกับบ้าน
วิธีทดสอบของผม
ผมแบ่ง endpoint ออกเป็น 3 กลุ่ม เพราะมันช่วยแยกโหมดได้ชัดเจน ทุกอย่างอยู่ใน local fixture server และเขียน ground truth ไว้ ก่อน จะเริ่ม crawl ใด ๆ ดังนั้น recall จึงวัดกับชุดที่ตายตัว ไม่ใช่กับสิ่งที่ Katana พ่นออกมาบังเอิญ
- Class A — HTML ปกติ
/page/a,/page/b,/page/cและ chain 3 ชั้น/depth/1 → /depth/2 → /depth/3crawler ไหนก็ควรหาเจอ - Class B — literal ในไฟล์ JavaScript
/api/js-endpoint-7และ/api/js-endpoint-8มีอยู่แค่เป็น string literal ในไฟล์/static/app.jsที่ลิงก์ไว้ อ่านได้โดยไม่ต้องมีเบราว์เซอร์ ถ้ามีอะไรยอมอ่าน JS นั้นจริง ๆ - Class C — เฉพาะ runtime DOM เส้นทางหนึ่งถูกประกอบตอนรันจาก fragments (
'endpoint' + (6 * 7)) แล้ว script ฉีดมันเข้า DOM string/runtime-only/endpoint42ไม่เคยปรากฏติดกันใน byte ใด ๆ ที่เซิร์ฟเวอร์ส่งมา — ไม่อยู่ใน HTML และไม่อยู่ใน source ของ JS ต้อง execute เท่านั้นถึงจะเห็น
นอกจากนี้ยังมี robots.txt, sitemap.xml ที่มี <loc> สองรายการซึ่งไม่โผล่ที่ไหนอีก, route ที่คืน 500, ลิงก์เสียหนึ่งอัน และลิงก์นอก scope ที่ชี้ไปยังเซิร์ฟเวอร์ที่สองบน hostname คนละตัว
เครื่องมือที่ใช้วัดสำคัญพอ ๆ กับ fixture: เซิร์ฟเวอร์จะนับว่า มีการ fetch อะไรจริงบ้าง ดังนั้นข้ออ้างเรื่อง scope และ resume จึงยึดกับ hit จริง ไม่ใช่ stdout ของ Katana เอง ถ้าต้องการดูการรันดิบ ก็มีเก็บไว้ใน benchmark repo ให้ตรวจเลขได้
ช่องว่างของ coverage ที่ไม่มีใครวัด
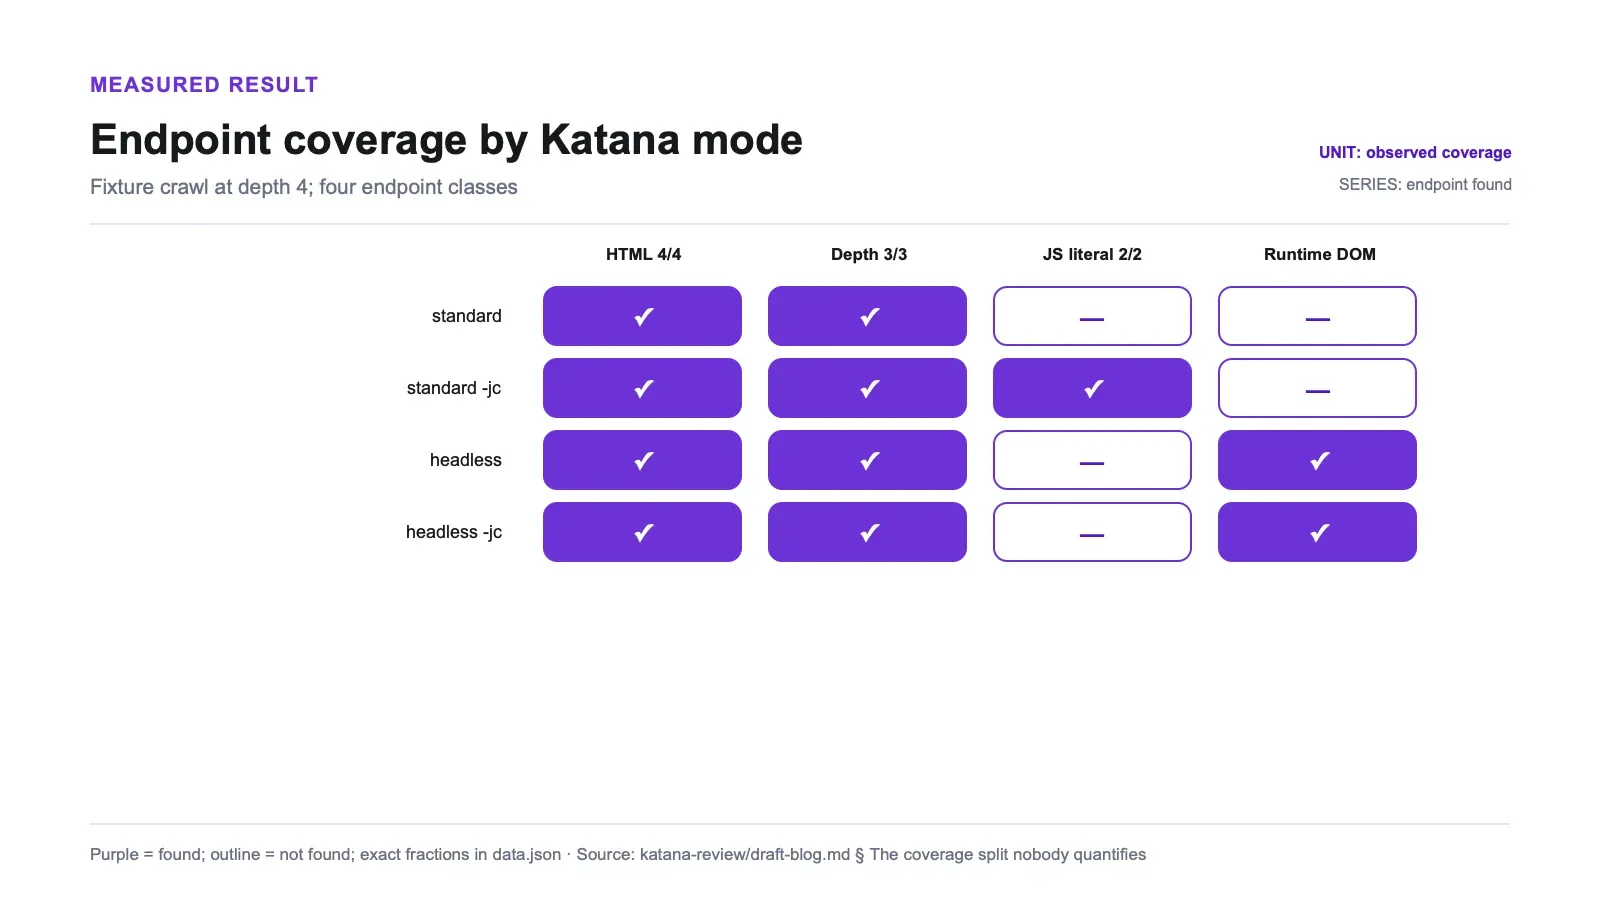
ตารางผลลัพธ์ตามโหมดและชนิด endpoint ที่ -d 4:
| โหมด | HTML links (A) | Depth chain (A) | JS-file literals (B) | Runtime-DOM (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | ไม่พบ |
standard -jc | 4/4 | 3/3 | 2/2 | ไม่พบ |
-headless | 4/4 | 3/3 | 0/2 | พบ |
-headless -jc | 4/4 | 3/3 | 0/2 | พบ |
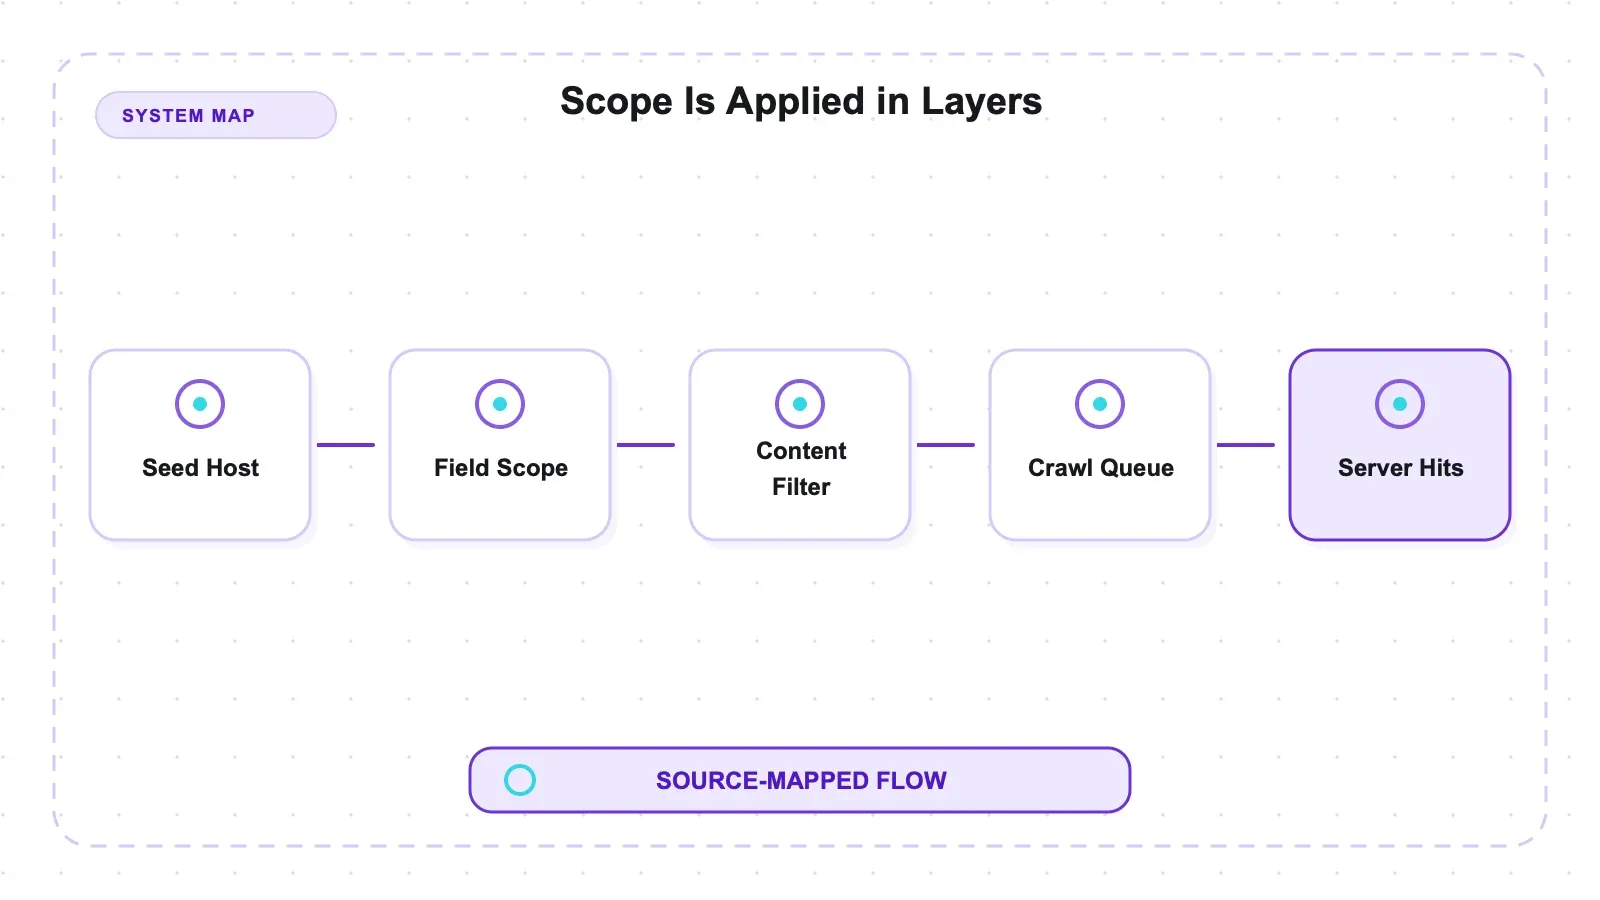
ถ้ามองสองคอลัมน์สุดท้ายเป็นคู่กัน ปัญหาจะชัดขึ้น Class B ถูกพบโดยเพียงหนึ่งการตั้งค่า: standard พร้อม -jc ส่วน Class C ถูกพบโดยสองการตั้งค่า: headless ทั้งคู่ ไม่มีแถวไหนที่ได้ผลทั้งสองคอลัมน์ ตารางเต็มอยู่ใน discovery-summary.json ซึ่ง field ที่คำนวณชื่อ headless_jc_covers_both เป็น false
ผลเชิงปฏิบัติคือคำพูดว่า “ใช้ headless ไปเลยเพื่อ coverage ที่ดีกว่า” ยังไม่ครบสำหรับการทดสอบนี้ headless ไม่ได้เพิ่ม Class B เข้าไปบนผลของ standard; มันกลับดึง Class C ได้ แต่ยังพลาด Class B การครอบคลุมทุก class ที่ใส่ไว้ใน fixture นี้ต้องใช้สองรันแล้วค่อย merge กัน:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
แถว -headless -jc คือแถวที่ผมอยากได้คำตอบจาก upstream มากที่สุด การเพิ่ม JavaScript parser เข้าไปในรัน headless ไม่ได้ช่วยอะไรเลย — ยังเป็น 0/2 บน Class B ทุกครั้ง รวมถึงรอบที่รันซ้ำใหม่ล่าสุดด้วย ผมกำลังรายงานพฤติกรรม ไม่ได้อ้างว่าหาสาเหตุเชิงกลไกได้ ผมไม่ได้ instrument ภายในของ Katana เพื่อหาว่าทำไมเส้นทางของเบราว์เซอร์ถึงหยุดช่วยเรื่อง JS-file literals ให้มองเป็นข้อสังเกตที่ทำซ้ำได้ และเป็น issue ที่ดีบน GitHub มากกว่าจะเป็น diagnosis (เรื่องที่ควรบันทึกไว้ด้วยกันคือ การผสม -hl -jc จบได้ปกติด้วย return code 0 บน v1.6.1 บน macOS ARM ซึ่งในอดีตไม่ได้เป็นแบบนี้เสมอไป)
เอกสารทางการ บอกว่า headless ให้ coverage ที่ดีกว่า และมันก็จริงสำหรับ class ที่ render ตอนรันในที่นี้ แต่คำแนะนำที่ตรวจทานแล้วไม่ได้อธิบายการแยกระหว่าง source-literal กับ runtime DOM เอาไว้ชัดเจน ดังนั้นให้มอง matrix นี้เป็นเหตุผลให้ทดสอบทั้งสองเส้นทางกับชนิด endpoint ของคุณเอง ไม่ใช่อนุกรมวิธานสากล
ต้นทุนด้านเวลาของ headless
รันต่อเนื่อง 3 ครั้งต่อโหมด บนเครื่องที่ว่างอยู่โดยไม่มีกิจกรรมอื่น:
| โหมด | p50 | min–max | mean |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
อัตราส่วนนี้คือ 5.1x และช่วงเวลาก็ไม่ทับซ้อนกันเลย — แม้รัน standard ที่ช้าที่สุดของผม (13.17s) ก็ยังเร็วกว่า headless ที่เร็วที่สุด (66.78s) มากกว่า 53 วินาที (cost-summary.json) นี่ไม่ใช่ noise ของการวัด
ข้อสังเกตหนึ่งเกี่ยวกับ 13 วินาทีนั้น: fixture ของผมตั้งใจใส่ route ที่คืน 500 และลิงก์เสียไว้ และ standard mode จะรอ tail ของการ retry ตามค่าเริ่มต้น -timeout 10 ในทั้งสองกรณี ผมไม่ได้ปรับ timeout เพื่อทำให้โหมดเร็วดูสวยขึ้น ซึ่งหมายความว่าหากจูน standard จริง ๆ ช่องว่างน่าจะ กว้างขึ้น ไม่ใช่แคบลง
อัตราส่วนนี้เป็นสัญญาณด้าน capacity ในเครื่อง local ไม่ใช่การคาดการณ์สำหรับ production ของจริง target จริงมี latency, failure, งานสคริปต์ และ scheduling แตกต่างกัน ขณะที่ fixture นี้มี timeout tail ตามค่าเริ่มต้น ใช้ค่าต่าง 5.1x ที่วัดได้เพื่อช่วยตัดสินว่า headless ควรมี budget และชุดเป้าหมายแยกหรือไม่ แล้วค่อย benchmark แผนนั้นบนโฮสต์ที่ได้รับอนุญาตและใกล้เคียงของจริง
Scope ถูกคุมไว้ แต่มีหนึ่ง flag ที่เหมือนไม่ได้ทำอะไร
การทดสอบ scope ใช้สองเซิร์ฟเวอร์: ตัวหลักบน 127.0.0.1 และตัวที่สองที่เข้าถึงได้ในชื่อ localhost บนพอร์ตอีกตัว ซึ่งเสิร์ฟ path ที่มีอยู่ เฉพาะที่นั่น เท่านั้น ดังนั้นถ้า hit path นั้นได้ ก็แปลว่า Katana fetch โฮสต์นอก scope จริง ไม่ใช่แค่พ่น URL ออกมาเฉย ๆ
| การตั้งค่า | fetch โฮสต์นอก scope หรือไม่ | จำนวน hit บนเซิร์ฟเวอร์ที่สอง |
|---|---|---|
ค่าเริ่มต้น (-fs rdn) | ไม่ | 0 |
-fs fqdn | ไม่ | 0 |
-cs localhost | ไม่ | 0 |
| `-fs '(127.0.0.1 | localhost)'` | ใช่ |
การยึด scope อย่างเคร่งครัดเป็นข่าวดี: โดยค่าเริ่มต้น Katana จะอยู่บ้าน และต้องทำอะไรแบบ explicit ถึงจะขยายออกไป นั่นคือ default ที่เหมาะสำหรับเครื่องมือที่ถูกใช้กับโครงสร้างพื้นฐานของคนอื่น
แถวที่น่าสนใจคือ -cs localhost มันไม่ได้ขยายการ crawl ไปยังโฮสต์ที่สอง — และยังปล่อยออกมา ไม่มี URL เลยสักตัว เพราะ -cs จะกรองภายใน field scope และ field scope ยังเป็นโฮสต์หลักอยู่ regex จึงไม่ match อะไรและผลลัพธ์ของ crawl ก็กลายเป็นเซ็ตว่างแทนที่จะเป็น error ถ้าคุณเคยเขียน regex scope แล้วใส่ชื่อโฮสต์ที่อยาก include แต่กลับได้ไฟล์เปล่า ๆ นี่คือกลไกนั้น (scope-summary.json) ถ้าจะเพิ่มโฮสต์ ให้ตั้ง -fs ถ้าจะจำกัดภายในโฮสต์ที่มีอยู่แล้ว ให้ใช้ -cs/-cos
Resume ละเอียดไม่เท่าที่ flag ทำให้คิด
README อธิบาย flag ว่า -resume string resume scan using resume.cfg ฟังดูเหมือนไฟล์ถูกวางไว้ใน working directory แต่จริง ๆ ไม่ใช่ บนเครื่องของผม checkpoint ถูกเขียนไปที่ ~/.config/katana/resume-<xid>.cfg — วัดจริง ไม่ได้อ่านเดาจากหน้าเอกสาร เพราะ docs ไม่ได้บอก path ไว้
สิ่งที่อยู่ข้างในยิ่งน่าสนใจ: ไฟล์นั้นมีแค่แผนที่ InFlightUrls ที่เก็บเพียงอย่างเดียวคือ seed URL ไม่ได้เก็บ visited set และไม่ได้เก็บ frontier ดังนั้นสิ่งที่เกิดขึ้นคือ เมื่อผมหยุด crawl ด้วย SIGINT หลัง 3 วินาทีแล้ว resume ต่อ:
| การรัน | จำนวน path ที่ไม่ซ้ำ |
|---|---|
| baseline crawl แบบเต็ม | 11 |
| fetch ไปแล้วก่อน interrupt | 10 |
| ถูก fetch ซ้ำโดยรัน resume | ครบทั้ง 11 รวมถึง 10 ที่เสร็จไปแล้ว |
Resume ยังไปถึงชุด endpoint สุดท้ายชุดเดิมได้ ดังนั้นไม่ได้พังอะไร แต่ความละเอียดของ checkpoint เป็นแบบ ต่อ seed ที่ป้อนเข้าไป ไม่ใช่ต่อ URL — ตัว dedupe filter ในหน่วยความจำไม่ได้ถูกเก็บถาวร ดังนั้นการ resume ของ crawl แบบ single-seed จึง crawl seed นั้นใหม่ทั้งหมด (resume-summary.json) ถ้าคุณป้อนรายการโฮสต์ 500 ตัวให้ Katana resume ควรช่วยประหยัดโฮสต์ที่จบครบแล้วได้ พฤติกรรมแบบ multi-seed นั้นอนุมานได้จากวิธีเก็บ state แม้ผมจะวัดเฉพาะกรณี single-seed ก็ตาม ถ้าคุณกำลังอยู่ลึกในไซต์ใหญ่ไซต์เดียว resume จะช่วยเรื่องความถูกต้อง ไม่ได้ช่วยเรื่องเวลา
Known files: ขอแล้ว แต่ถูกทิ้ง
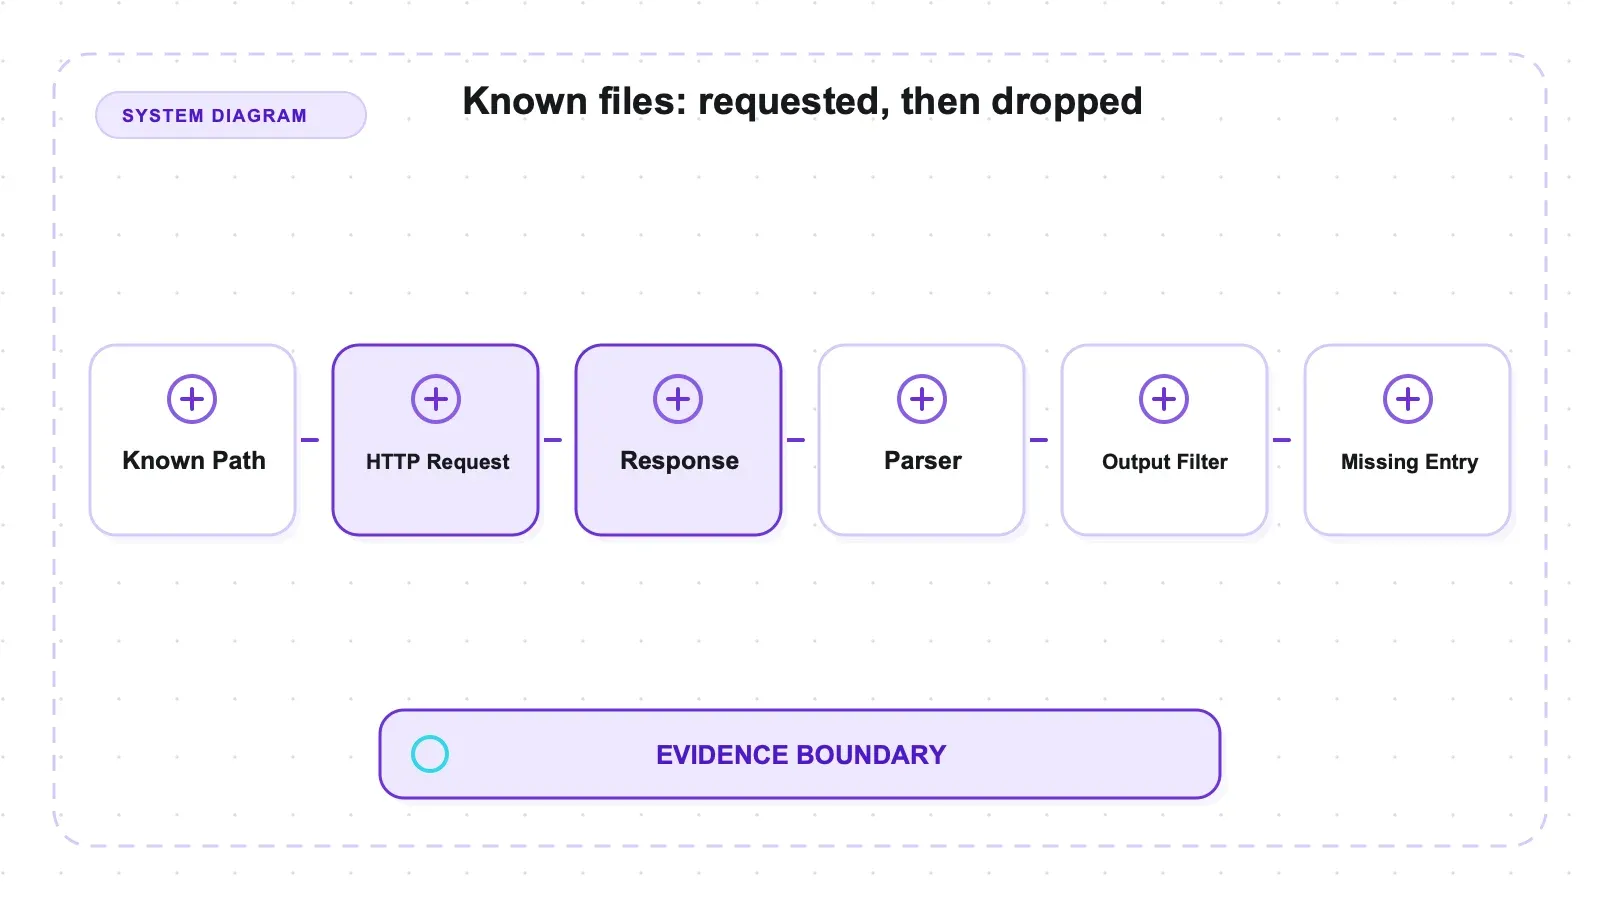
-kf all -d 3 ทำการ request ทั้งสองไฟล์จริง — robots.txt และ sitemap.xml โผล่ใน hit log ของเซิร์ฟเวอร์ — แต่จากนั้นกลับกู้คืน endpoint ที่อยู่ใน <loc> ของ sitemap ได้ 0 จาก 2 ค่า recall 0.0
ก่อนจะบอกว่านี่คือข้อจำกัด ผมลองทำให้เป็นความผิดของตัวเองก่อน การเปลี่ยนแปลงทุกแบบให้ผลเหมือนเดิม:
| สิ่งที่ลอง | endpoint ใน sitemap <loc> ที่กู้คืนได้ |
|---|---|
-kf all | 0/2, recall 0.0 |
-kf sitemapxml | 0/2, recall 0.0 |
-kf robotstxt | 0/2, recall 0.0 |
| depth 3 | 0/2, recall 0.0 |
| depth 4 | 0/2, recall 0.0 |
| depth 5 | 0/2, recall 0.0 |
เพิ่ม -jc เข้าไป | 0/2, recall 0.0 |
seed ตรงที่ /sitemap.xml | 0/2, recall 0.0 |
ข้อกำหนดที่เอกสารระบุไว้ — ใช้ -kf และไปลึกอย่างน้อย 3 — ผมทำครบทุกครั้งแล้ว ดังนั้นนี่ไม่ใช่เรื่อง flag หาย
สิ่งที่ควรตัดสินใจก่อนเลยคือ: บน fixture ที่ใช้ IP literal นี้ อย่าเพิ่งคิดว่าเมื่อสั่ง known files แล้ว URL ใน <loc> จะถูกเอาเข้าร่วม crawl โดยอัตโนมัติ ให้ตรวจ recall หรือไม่ก็ extract แล้ว seed URL เหล่านั้นเข้าไปเอง
โค้ดใน v1.6.1 สอดคล้องกับสิ่งที่สังเกตได้ แม้ผมจะไม่ได้ instrument ระหว่างรัน ใน sitemapxml.go ที่ v1.6.1 NewNavigationRequestURLFromResponse จะสร้าง navigation request จาก <loc> โดยไม่ได้ส่งต่อ RootHostname ที่ถูกเติมไว้ จากนั้น request จะไปถึง ValidateScope; ใน scope.go ที่ v1.6.1 เส้นทางสำหรับ IP-literal จะเปรียบเทียบ URL host กับ root ที่ว่างอยู่ และอาจปฏิเสธมันได้ คำสั่ง custom -fs '(127.0.0.1|localhost)' ไปคนละ branch ของ scope ในการทดสอบ scope แยกต่างหาก จึงเป็นการกู้คืนที่คาดเดาได้จากซอร์ส ไม่ใช่การแก้ -kf ที่วัดยืนยันแล้ว ความพยายามยืนยันเพิ่มเติมถูกขัดด้วยปัญหา dialing เป็นครั้งคราวใน known-files client บนโฮสต์นี้ ดังนั้นผลที่รายงานจึงยังคงเป็น 0/2
ถ้าจะใช้งานจริง ณ ตอนนี้ โดยยังไม่มีใครยืนยัน flag นี้ สิ่งที่ผมจะทำคือไป fetch sitemap เอง ดึง URL ใน <loc> ออกมา แล้วส่งให้ Katana เป็น seed list มีแค่สองบรรทัดใน shell และไม่ต้องเจอ validation เรื่อง scope เลย
มีสิ่งหนึ่งที่ทำงานตรงตามสเปกและควรพูดถึงสักประโยค: route ที่คืน 500 และลิงก์เสียถูก fetch ถูกบันทึก และข้ามต่อไป ทุก browserless run จบด้วย return code 0 crawler ที่ล้มเมื่อเจอ response แย่ ๆ ครั้งแรกนั้นใช้จริงไม่ได้ และ Katana ไม่ได้เป็นแบบนั้น
เช็ก coverage แบบเจาะ target ก่อน deploy
เมทริกซ์ของ fixture นี้มีประโยชน์ที่สุดในฐานะเทมเพลตสำหรับการทดสอบ target ที่คุณมีสิทธิ์ใช้งานเอง กำหนดชนิดของ endpoint ก่อนเริ่มใช้ Katana: ลิงก์ปกติ, literal ใน script ที่ลิงก์ไว้, route ที่เกิดขึ้นหลัง execute เท่านั้น, และรายการจาก known files เป็น 4 ถังเริ่มต้นที่สมเหตุสมผล เก็บตัวอย่าง ground truth ขนาดเล็กของแต่ละกลุ่มไว้ด้วย หากไม่มีรายการตั้งต้นนั้น ไฟล์ stdout ที่ใหญ่กว่าอาจดูเหมือน coverage ที่ดีกว่า ทั้งที่จริง ๆ แล้วบาง class หายไป
รันเส้นทางแบบ browserless และ headless แยกกันก่อนในฐานะการวัดคนละชุด บันทึกคำสั่งแบบตรงตัว เวอร์ชัน Katana build ของเบราว์เซอร์ return code และ output จากนั้น normalize และ diff ชุด endpoint แทนที่จะเทียบแค่จำนวนบรรทัด ถ้า standard -jc ไม่ได้เพิ่มอะไรที่ไม่ซ้ำบน sample ของคุณ นโยบาย headless-only อาจพอแล้ว แต่ถ้าชุดผลลัพธ์แยกจากกันเหมือนที่เจอนี่ ให้เก็บสองรอบให้ต่างกันและค่อย merge หลังเก็บข้อมูล การใส่สอง flag ลงในคำสั่งเดียวไม่ควรถูกสันนิษฐานว่าเท่ากับ union จนกว่าจะมี diff เฉพาะ target มายืนยัน
ตรวจสอบ scope ด้วยหลักฐานที่อยู่นอก output ของ Katana เอง วาง canary URL บนโฮสต์ที่ควรถูกกันไว้ แล้วดู request log ของเซิร์ฟเวอร์นั้นด้วย และทดสอบโฮสต์ที่สองตามที่ตั้งใจไว้หากการ crawl ควรจะขยายออกไป รัน -cs localhost ในที่นี้ให้ output ว่าง เพราะ content-scope filtering ไม่ได้ขยาย field scope ส่วนคำสั่ง -fs '(127.0.0.1|localhost)' กลับติดต่อเซิร์ฟเวอร์ตัวที่สองจริง ๆ การบันทึก regex แบบตรงตัวสำคัญ เพราะเปลี่ยนแค่ตัวอักษรเดียวก็อาจเปลี่ยนความหมายของ regex ไม่ใช่แค่รูปแบบการเขียน
ทดสอบการ interrupt และ known files แยกจากการวัด discovery recall สำหรับ resume ให้ interrupt seed ตัวอย่างหลังผ่านไปหลายหน้า เก็บ path ของ checkpoint ที่ถูกสร้าง และนับว่า URL ที่เสร็จแล้วถูก fetch ซ้ำกี่รายการ สำหรับ -kf ให้ยืนยันทั้งว่า robots/sitemap ถูก request และว่า URL ใน <loc> ถูก schedule จริงหรือไม่ นั่นคือคนละข้ออ้าง ใน fixture นี้ไฟล์ถูก fetch แต่ endpoint สองรายการจาก sitemap ไม่ได้ถูกนำเข้า ดังนั้นทั้ง request log และ endpoint output จึงจำเป็นต่อการเห็นขอบเขตที่แท้จริง
สุดท้าย ให้ตั้ง baseline ด้านต้นทุนในเครื่อง local ด้วยการรันต่อเนื่องบนเครื่องที่ว่าง แล้วค่อยทำซ้ำบน host ที่ใกล้เคียงกับของจริง เก็บค่า min, max และ median ไว้ ไม่ใช่แค่ตัวคูณอย่างเดียว ตัวเลข 5.1x ที่วัดได้ที่นี่รวมพฤติกรรม failure และ timeout ของ fixture นี้ด้วย มันบอกคุณได้ว่า headless ควรมี budget แยกต่างหาก ไม่ได้บอกว่าการทำ inventory ใน production จะใช้เวลานานเท่าไร
ข้อดีและข้อเสีย
ข้อดี:
- ครอบคลุม HTML ปกติได้สมบูรณ์ทุกโหมด — ลิงก์ 4/4 และ depth chain 3/3 ครบ โดยไม่ต้องตั้งค่าอะไรเพิ่ม
-jcใช้งาน browserless ได้จริง: ดึง endpoint 2/2 ที่อยู่เป็น string literal ในไฟล์ JS ที่ลิงก์ไว้ โดยไม่ต้องเสียค่าเบราว์เซอร์-headlessคือโหมดเดียวที่หา endpoint ที่ประกอบตอน runtime ได้ — ซึ่งเป็น class ที่ source parsing มองไม่เห็นโดยโครงสร้าง- ค่าเริ่มต้นของ scope ค่อนข้างปลอดภัย โฮสต์นอก scope ไม่ถูก fetch ทั้งใน default,
-fs fqdn, หรือ-cs - เป็นไบนารี Go ตัวเดียว ใช้ MIT License มี build สำเร็จรูปและ Docker image และ I/O เหมาะกับ pipeline
- ทนต่อ failure ได้ดี: 500 และ dead link ไม่ทำให้ crawl หยุด
ข้อเสีย:
- ไม่มีคำสั่งเดียวที่ครอบคลุมทั้ง endpoint จาก JS-file และ runtime DOM พร้อมกัน ต้องรันสองครั้งแล้ว merge
-jcไม่ช่วยอะไรเมื่อใช้ร่วมกับ-headless— 0/2 บน Class B ทุกครั้งที่รันแบบ headless- headless ใช้เวลาประมาณ 5.1 เท่าของ browserless (p50 66.82s เทียบ 13.08s ช่วงเวลาไม่ทับซ้อนกัน)
-resumecrawl หน้าเดิมซ้ำภายใน seed เดียว มันกู้ endpoint set กลับมา แต่ไม่กู้เวลาที่เสียไป- known files request robots.txt และ sitemap.xml แต่ดึง sitemap
<loc>จาก target แบบ IP ได้ 0/2 - headless ต้องมี Chromium อยู่บนเครื่องอย่างเงียบ ๆ เรื่อง “ไบนารีเดียว” หยุดลงตรงเบราว์เซอร์
- เป็น discovery เท่านั้น ไม่มี structured extraction, ไม่มีการแปลง content, ไม่มี schema ของฟิลด์
สิ่งที่ยังไม่ทดสอบ และจึงอยู่นอกขอบเขตของตัวเลขเหล่านี้: -jsluice, การทดสอบ depth cutoff แบบเฉพาะเจาะจงที่ -d 1/-d 2, multi-seed resume, การกรอกฟอร์มอัตโนมัติ และเว็บไซต์ production จริงที่ใช้ JavaScript หนัก ๆ หรือมีการป้องกัน ทุกตัวเลขมาจากเครื่องเดียว (macOS arm64) กับ fixture local เท่านั้น
เหมาะกับใคร และใครควรข้าม
ถ้างานของคุณคือทำ inventory ของ endpoint บนโครงสร้างพื้นฐานที่คุณมีสิทธิ์แตะ Katana มีโครงแบบ pipeline ที่ตรงงานพอดี: plumbing แบบ STDIN/STDOUT, ไบนารีที่กระจายได้ และทั้งโหมด browserless กับ browser-backed การ merge สองรอบเป็นสิ่งจำเป็นสำหรับ class ที่ใส่ไว้ใน fixture นี้ ส่วน target ของคุณจะต้องใช้ทั้งสองรอบหรือไม่ ต้องพิสูจน์จากหน้าเว็บตัวอย่าง
ข้ามไปถ้าคุณต้องการข้อมูล ไม่ใช่ที่อยู่ Katana จะไม่มีวันยื่นตารางสินค้าให้คุณ มันยื่นแค่ URL ที่สินค้าอาจอยู่ตรงนั้น และให้เครื่องมืออีกตัวไปทำ extraction ต่อ ข้ามไปด้วยถ้าคุณต้องการคำสั่งเดียวที่สมบูรณ์ เพราะการ merge สองรอบใช้ได้ดีใน pipeline แต่ค่อนข้างน่ารำคาญบน command prompt และถ้าการ enumerate ของคุณพึ่งพา sitemap <loc> แต่ target เป็น IP ให้ตรวจสิ่งที่คุณได้จริงก่อนเชื่อ output เพราะบน fixture ของผมเส้นทางนั้นให้ผลเป็นศูนย์
ตัวเลือกอื่น และขอบเขตของ extraction
Katana ฟรี, ใช้ MIT License, และ self-hosted มันเก็บ discovery, การเลือกโหมด, การวางเบราว์เซอร์ และการ merge ผลลัพธ์ไว้ฝั่งคุณทั้งหมด
ในโลก open source การเปรียบเทียบที่มีประโยชน์คือเทียบตามงาน ไม่ใช่ตามภาษา Colly เป็นอีกตัวเลือกฝั่ง Go แต่เป็นไลบรารีที่คุณต้องคอมไพล์พร้อม callback ของตัวเอง และมันไม่ render JavaScript เลย Crawl4AI ใช้เบราว์เซอร์จริงและสร้าง Markdown สำหรับ pipeline ของ LLM ซึ่งเป็น output คนละประเภทกัน ถ้าคุณกำลังชั่งหลายตัวพร้อมกัน open-source scraper roundup ของเราจะวางหมวดหมู่ไว้เทียบกันชัด ๆ
ข้อเปิดเผย: Thunderbit เป็นผลิตภัณฑ์ของผู้เผยแพร่ และไม่ได้ถูกทดสอบใน fixture ของ Katana นี้ มันอยู่ในหมวด managed extraction ที่ทำงานต่อจาก discovery แปลงหน้าเว็บเป็น text หรือ record ที่มีโครงสร้าง แทนที่จะ enumerate พื้นผิว endpoint ของ target ที่ได้รับอนุญาต เวิร์กโฟลว์หนึ่งอาจใช้ทั้งสองหมวดได้ แต่รีวิวนี้ให้หลักฐานเฉพาะพฤติกรรม discovery ของ Katana เท่านั้น
ลองใช้ Thunderbit สำหรับดึงข้อมูลเว็บ
บทสรุป
ใช้ Katana เมื่อสิ่งที่ต้องส่งมอบคือรายการ endpoint สำหรับ target ที่คุณมีสิทธิ์ crawl และคุณสามารถตรวจสอบ coverage ของแต่ละโหมดกับ target เหล่านั้นได้ ใน fixture นี้ standard -jc กู้คืน JavaScript-file literals ที่ใส่ไว้ ขณะที่ headless กู้ endpoint ที่ถูกใส่เข้า runtime DOM; โหมด browserless ที่ทดสอบไว้ไม่ได้กู้เส้นทาง runtime นั้นกลับมาเลย ค่า scope เริ่มต้นยังกันไม่ให้โฮสต์ที่สองถูก fetch และ browserless runs ก็เดินต่อหลังเจอ 500 กับ dead link
ข้อควรระวังอยู่ที่การใช้งานจริง: อาจต้อง merge สองรอบเมื่อมี endpoint หลายชนิด, headless ใช้เวลาประมาณห้าเท่า, single-seed resume จะ fetch เส้นทางเดิมซ้ำ, และ known-files recall เป็น 0/2 กับ target แบบ IP ผลเหล่านี้เป็นผลจาก fixture v1.6.1 ไม่ใช่คำรับประกันกับทุกเว็บไซต์ แต่ก็เพียงพอจะกำหนดสิ่งที่ควรตรวจซ้ำในการประเมินสำหรับ production
ลองใช้ Thunderbit สำหรับดึงข้อมูลเว็บ Get Started Free
คำถามที่พบบ่อย
Katana เก็บไฟล์ resume ไว้ที่ไหน และถ้ากลับมารันต่อจะข้ามหน้าที่ crawl ไปแล้วหรือไม่?
Checkpoint ถูกเก็บไว้ที่ ~/.config/katana/resume-<xid>.cfg ไม่ใช่ resume.cfg ใน working directory อย่างที่ help ของ flag ทำให้เข้าใจ และไม่ข้ามหน้าที่เสร็จแล้วด้วย: ไฟล์เก็บแค่ seed URL ที่กำลังอยู่ระหว่างทำ ดังนั้นการ resume ของ single-seed crawl จะ fetch path baseline ทั้ง 11 รายการซ้ำ รวมถึง 10 รายการที่เสร็จไปแล้ว คุณจะได้ endpoint set สุดท้ายเหมือนเดิม แต่ไม่ได้ประหยัดเวลา
ทำไม -kf all ถึง request sitemap.xml ของฉัน แต่ไม่ crawl URL ข้างใน?
สำหรับ target แบบ IP ผลลัพธ์นี้สอดคล้องกับขอบเขตการ validate scope มากกว่าจะเป็นความผิดของ flag เอง ในโค้ด v1.6.1 parser ของ sitemap ใน Katana สร้าง request ของแต่ละ <loc> โดยไม่ได้ส่ง root hostname ต่อไป และการตรวจ DNS-scope สำหรับ host แบบ IP-literal อาจปฏิเสธ URL นั้นได้ ผมไม่ได้ instrument การรันเพื่อยืนยันกลไกนี้ มันคงอยู่ที่ recall 0 ตลอดทุก flag ทุก depth และทุกการ seed ที่ผมลอง host regex แบบ custom -fs จะไปคนละ validation branch และเป็นวิธีแก้ที่ซอร์สคาดไว้ — แต่ผมยืนยันกับ -kf บนเครื่องของผมไม่ได้ จึงควรมองว่าเป็นสิ่งที่ยังไม่ทดสอบ วิธีที่ผมเชื่อใจที่สุดตอนนี้คือ extract URL ใน <loc> ด้วยตัวเองแล้วส่งให้ Katana เป็น seed
เวลาเขียนรายงานผลทดสอบ coverage ของ Katana ควรเก็บอะไรไว้บ้าง?
บันทึกเวอร์ชัน Katana และ command แบบตรงตัว รวมถึง expression ของ -fs ทุกตัวอักษร; กำหนดชนิด endpoint ก่อนรัน; เก็บ server-side hit log ควบคู่กับ stdout; และแยกสิ่งที่วัดได้จริงออกจากสมมติฐานที่อิงซอร์ส สำหรับรัน headless ควรบันทึก build ของเบราว์เซอร์ด้วย — การทดสอบนี้ไม่ได้บันทึกไว้ ซึ่งทำให้การ reproduce จำกัดลง
ควรใช้ -jc, -headless, หรือทั้งคู่?
เลือกตามชนิด endpoint ที่คุณต้องการ ใน fixture นี้ standard -jc พบ literal ที่เก็บในไฟล์ JavaScript ส่วน headless พบ endpoint ที่ถูกแทรกเข้า runtime DOM แต่ไม่มีโหมดใดครอบคลุมทั้งสองกลุ่มได้เพียงโหมดเดียว ดังนั้นสำหรับ target ที่มีหลายชนิด การรันสองรอบแล้ว dedupe จึงเป็นทางเลือกที่ป้องกันได้
URL ที่ล้มเพียงอันเดียวจะหยุด crawl ไหม? ไม่หยุดในการรันทดสอบควบคุมนี้ Katana เดินหน้าต่อหลังเจอทั้ง response 500 และ dead link และยังคืน path อื่นที่เข้าถึงได้กลับมาได้ การทำงานแบบนี้ไม่ใช่ข้ออ้างแทนการนับข้อผิดพลาดใน production: ควรเก็บ log ของ request ที่ล้ม และกำหนดอัตราความล้มเหลวที่ยอมรับได้ เพื่อไม่ให้ crawl ที่สำเร็จแค่บางส่วนถูกเข้าใจผิดว่า cover ครบแล้ว




