
ถ้าคุณกำลังเทียบ scraping solutions ในปี 2026 คำถามสำคัญจริง ๆ มักไม่ใช่ “ตัวไหนฟีเจอร์เยอะที่สุด?” แต่เป็น “ตัวเลือกไหนพาทีมของฉันจากเว็บที่รก ๆ ไปสู่ข้อมูลที่ใช้งานได้ โดยติดขัดน้อยที่สุด?”
พอเจอโจทย์จริง คำตอบก็แยกทางกันเร็วมาก ทีมขายและทีมปฏิบัติการมักต้องการการดึงข้อมูลผ่านเบราว์เซอร์และการส่งออกไฟล์ที่ใช้งานได้ทันที นักวิเคราะห์มักมองหาเวิร์กโฟลว์แบบ no-code ที่ทำซ้ำได้ ส่วนทีมเทคนิคจะให้ความสำคัญกับ API, การรับมือ anti-bot และคำถามว่าเราต้องดูแลสแตก crawler เองไหม
นี่คือฉบับปี 2026 ของลิสต์คัดเลือกประจำปีของเรา ซึ่งย่อมาจากรายการ 15 เครื่องมือที่เราเคยจัดไว้ในปี 2025 ผมตรวจสอบหน้าโปรดักต์ทางการ สัญญาณราคา และทิศทางของผลิตภัณฑ์เหล่านี้อีกครั้งในเดือนสิงหาคม 2026 แล้วคัดมาเฉพาะ 10 ตัวเลือกที่ยังเหมาะกับเวิร์กโฟลว์ของทั้งธุรกิจและนักพัฒนาในโลกจริง
ตัวเลือกแนะนำแบบเร็วตามลักษณะงาน
- อยากได้ทางลัดจากเว็บไปสเปรดชีตให้เร็วที่สุด? เริ่มที่ Thunderbit
- ต้องการมอนิเตอร์แบบ no-code ที่ทำซ้ำได้ หรือรันบนคลาวด์? ลองดู Browse AI, Octoparse และ ParseHub
- ต้องการความยืดหยุ่นของแพลตฟอร์มหรือโครงสร้างพื้นฐานสำหรับ scraping? ให้ดู Apify, Bright Data, Oxylabs และ ScrapingBee
- ต้องการเป็นเจ้าของโค้ดเต็มรูปแบบ? Scrapy และ Playwright ควรอยู่ในลิสต์อันดับต้น ๆ ของทีม developer
ลองใช้ Web Scraper บนหน้าเว็บจริง ไม่ต้องตั้งค่าและไม่ต้องเลือก selector — ให้ AI ชี้ไปที่หน้าเว็บ แล้วรับตารางที่มีโครงสร้างได้ในคลิกเดียว Get Started Free
ทำไมโซลูชัน Web Scraping ยังสำคัญสำหรับทีมธุรกิจ
ทีมส่วนใหญ่ไม่ได้ต้องการ “web scraping” ในฐานะงานสายเทคนิค แต่ต้องการข้อมูลที่เป็นโครงสร้างจากหน้าเว็บสาธารณะไปใช้กับ lead generation, การติดตามราคา, การทำวิจัย marketplace, การสรรหาบุคลากร, งานคอนเทนต์ หรือการติดตามคู่แข่ง ปัญหาคือข้อมูลบนเว็บไซต์ยังคงอยู่ในรูปแบบที่เอามาใช้ต่อด้วยมือได้ช้า
นั่นจึงเป็นเหตุผลที่เครื่องมือที่ดีที่สุดในตอนนี้แข่งกันที่ความเข้ากับเวิร์กโฟลว์ ไม่ใช่แค่พลังในการดึงข้อมูล คำถามที่ควรถามคือ เครื่องมือนั้นรองรับ pagination, subpages และหน้าแบบ dynamic ได้ไหม ส่งออกไปยัง Sheets หรือระบบภายในได้สะอาดแค่ไหน และทีมต้องรับภาระดูแลหลังตั้งค่าเสร็จมากน้อยเพียงใด
ถ้าคุณอยากเห็นตัวอย่างเร็ว ๆ ว่าเวิร์กโฟลว์การดึงข้อมูลแบบ browser-first บนหน้าผลการค้นหาจริงหน้าตาเป็นอย่างไร วิดีโอ Browse AI ด้านล่างนี้เป็นจุดเริ่มที่ดี:
วิธีที่เราเลือกโซลูชัน Web Scraping ที่ดีที่สุด
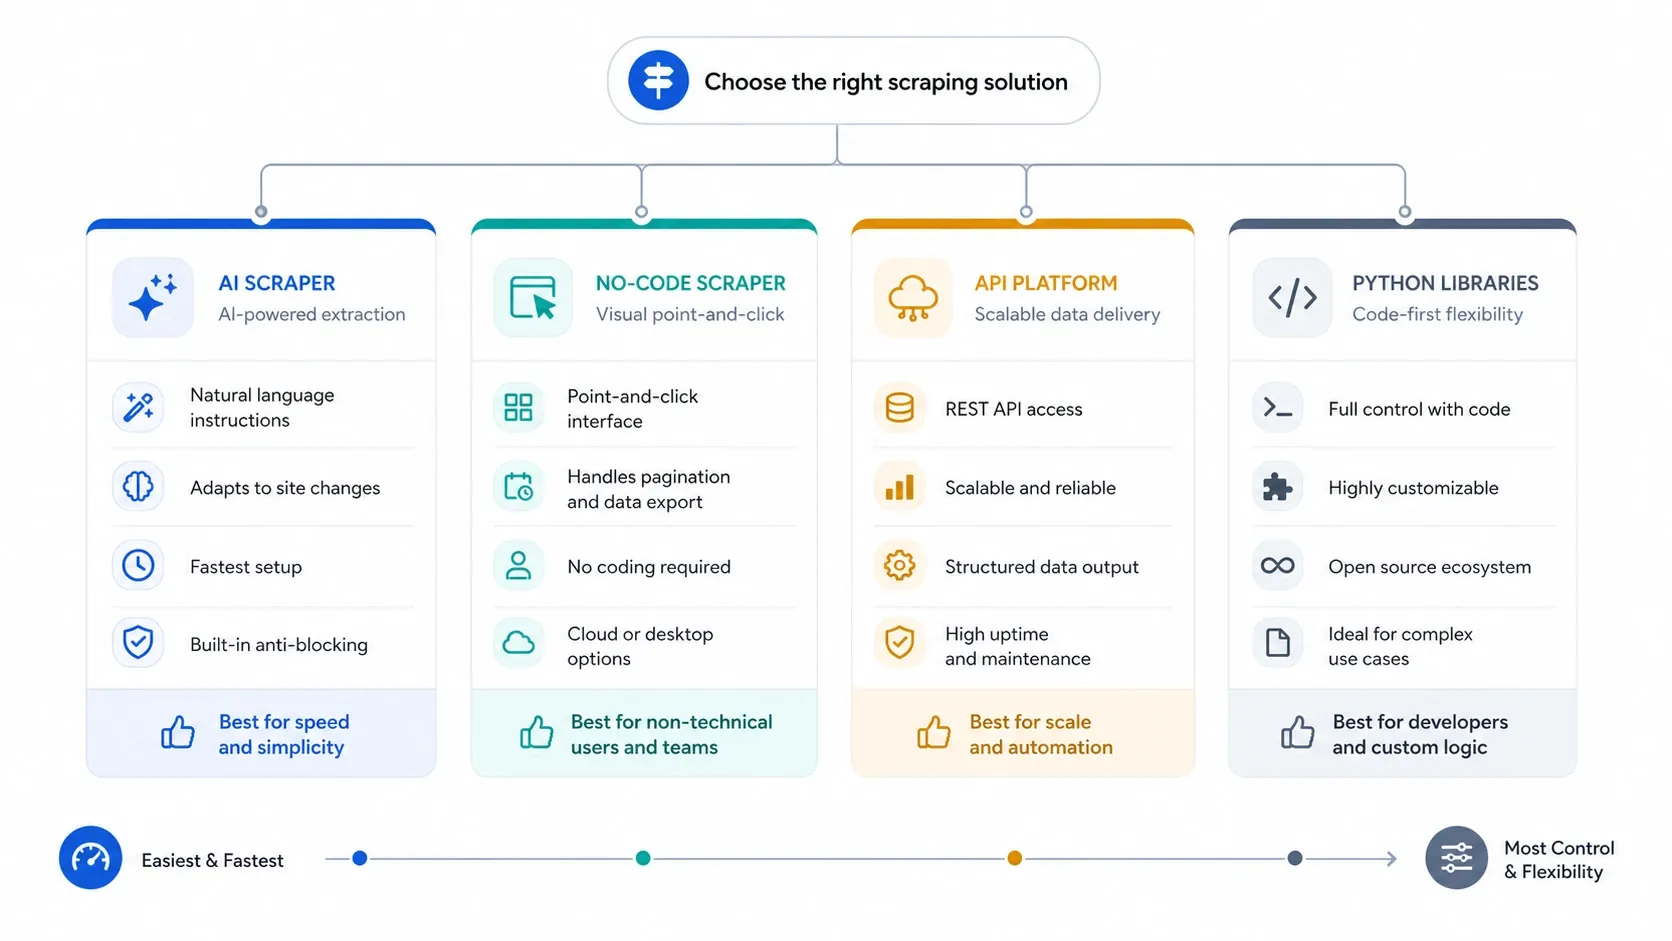
หน้านี้เป็นลิสต์คัดเลือกประจำปี ไม่ใช่คลังรวมทุกผลิตภัณฑ์ที่ยังมีหน้าเว็บอยู่ ผมให้ความสำคัญกับเครื่องมือที่ยังมีพัฒนาการของสินค้าอย่างน่าเชื่อถือในปี 2026 และเหมาะกับอย่างน้อยหนึ่งใน 4 โมเดลการทำงานจริงต่อไปนี้:
- Business scraping แบบ AI-first: ตั้งค่าเร็วที่สุด ติดขัดน้อยที่สุด และส่งออกเป็นสเปรดชีตได้ทันที
- No-code scraping ที่ทำซ้ำได้: เวิร์กโฟลว์แบบ visual, การตั้งเวลา และการควบคุมการดึงข้อมูลที่ชัดเจนกว่า
- แพลตฟอร์มและ API สำหรับสเกล: การรันบนคลาวด์, โครงสร้างเพื่อหลีกเลี่ยงการบล็อก และการเข้าถึงแบบโปรแกรมได้
- ไปป์ไลน์ที่ทีม developer เป็นเจ้าของ: เฟรมเวิร์กโอเพนซอร์สและไลบรารี browser automation สำหรับทีมที่ต้องการควบคุมทั้งหมด
เกณฑ์การให้คะแนนมีดังนี้:
- เวลาไปถึงการ scrape ที่ใช้งานได้ครั้งแรก: ผู้ใช้จริงต้องใช้เวลานานแค่ไหนกว่าจะได้ข้อมูลที่ export ได้
- ภาระการดูแล: เซ็ตอัปยังใช้งานได้จริงไหมเมื่อหน้าเว็บหรือเวิร์กโฟลว์เปลี่ยน
- เพดานการขยายสเกล: หลังจาก scrape สำเร็จครั้งแรกแล้ว ผลิตภัณฑ์นั้นยังเหมาะอยู่หรือไม่
- ความชัดเจนเรื่องราคา: มีแผนใช้ฟรี, แพ็กเกจ self-serve หรืออย่างน้อยมีแนวทางสำหรับองค์กรที่ชัดเจนหรือไม่
- ความเหมาะกับทีม: เครื่องมือตรงกับรูปแบบการทำงานของผู้ซื้อจริงหรือเปล่า
ตารางเปรียบเทียบเร็ว: โซลูชัน Web Scraping ที่ดีที่สุดในปี 2026
สัญญาณด้านราคาด้านล่างตรวจสอบจากหน้าโปรดักต์, ราคา หรือซัพพอร์ตทางการล่าสุดในเดือนสิงหาคม 2026
| เครื่องมือ | สัญญาณราคา | โมเดลหลัก | เหมาะที่สุดสำหรับ |
|---|---|---|---|
| Thunderbit | มีแผนใช้ฟรี; Starter เริ่ม $15/เดือน; Pro เริ่ม $38/เดือน; มีราคาสำหรับธุรกิจ | AI web scraper และเครื่องมือเวิร์กโฟลว์บนเบราว์เซอร์ | ทีมขาย, ops, ecommerce และทีมวิจัยที่ต้องการตั้งค่าให้เร็วที่สุด |
| Browse AI | มีแผนใช้ฟรี; Personal เริ่ม $19/เดือนเมื่อชำระรายปี; Professional เริ่ม $69/เดือนเมื่อชำระรายปี; Premium เริ่ม $500/เดือนเมื่อชำระรายปี | แพลตฟอร์ม robot แบบ no-code ที่ขับเคลื่อนด้วย AI | การมอนิเตอร์, ตรวจจับการเปลี่ยนแปลง และงาน scraping ที่ทำซ้ำเป็นประจำ |
| Octoparse | มีแผนใช้ฟรี; Standard เริ่ม $69/เดือน; Professional เริ่ม $249/เดือน | เครื่องมือ visual no-code scraper พร้อมรันบนคลาวด์ | นักวิเคราะห์และทีมปฏิบัติการที่รันงานซ้ำปริมาณมาก |
| ParseHub | มีแผนใช้ฟรี; แผนเสียเงินเริ่ม $189/เดือน | เครื่องมือ visual scraper บนเดสก์ท็อปสำหรับเว็บแบบ dynamic | ผู้ใช้ที่ต้องการคุมละเอียดขึ้นโดยไม่ต้องเขียนโค้ด |
| Apify | มีแผนใช้ฟรี; Starter เริ่ม $29/เดือน; Scale เริ่ม $199/เดือน; Business เริ่ม $999/เดือน | แพลตฟอร์ม cloud actor และโครงสร้างพื้นฐานสำหรับ scraping | ทีมแบบไฮบริดที่ต้องการทั้งเครื่องมือสำเร็จรูปและเวิร์กโฟลว์เฉพาะทาง |
| Bright Data | ราคาแบบคิดตามการใช้งานและตามผลิตภัณฑ์ ครอบคลุม scraper API, proxies และ data products | สแต็กการเก็บข้อมูลระดับองค์กร | โครงการเก็บข้อมูลจากเว็บสาธารณะขนาดใหญ่ที่ใส่ใจเรื่อง compliance |
| Oxylabs | Web Scraper API เริ่ม $49/เดือน; ราคา proxy และ unblocker อื่น ๆ แตกต่างกันไปตามผลิตภัณฑ์ | โครงสร้างพื้นฐานด้าน proxy และ scraper API | ทีมที่ซื้อความเสถียรและความสามารถในการหลีกเลี่ยงการบล็อกในฐานะ infrastructure |
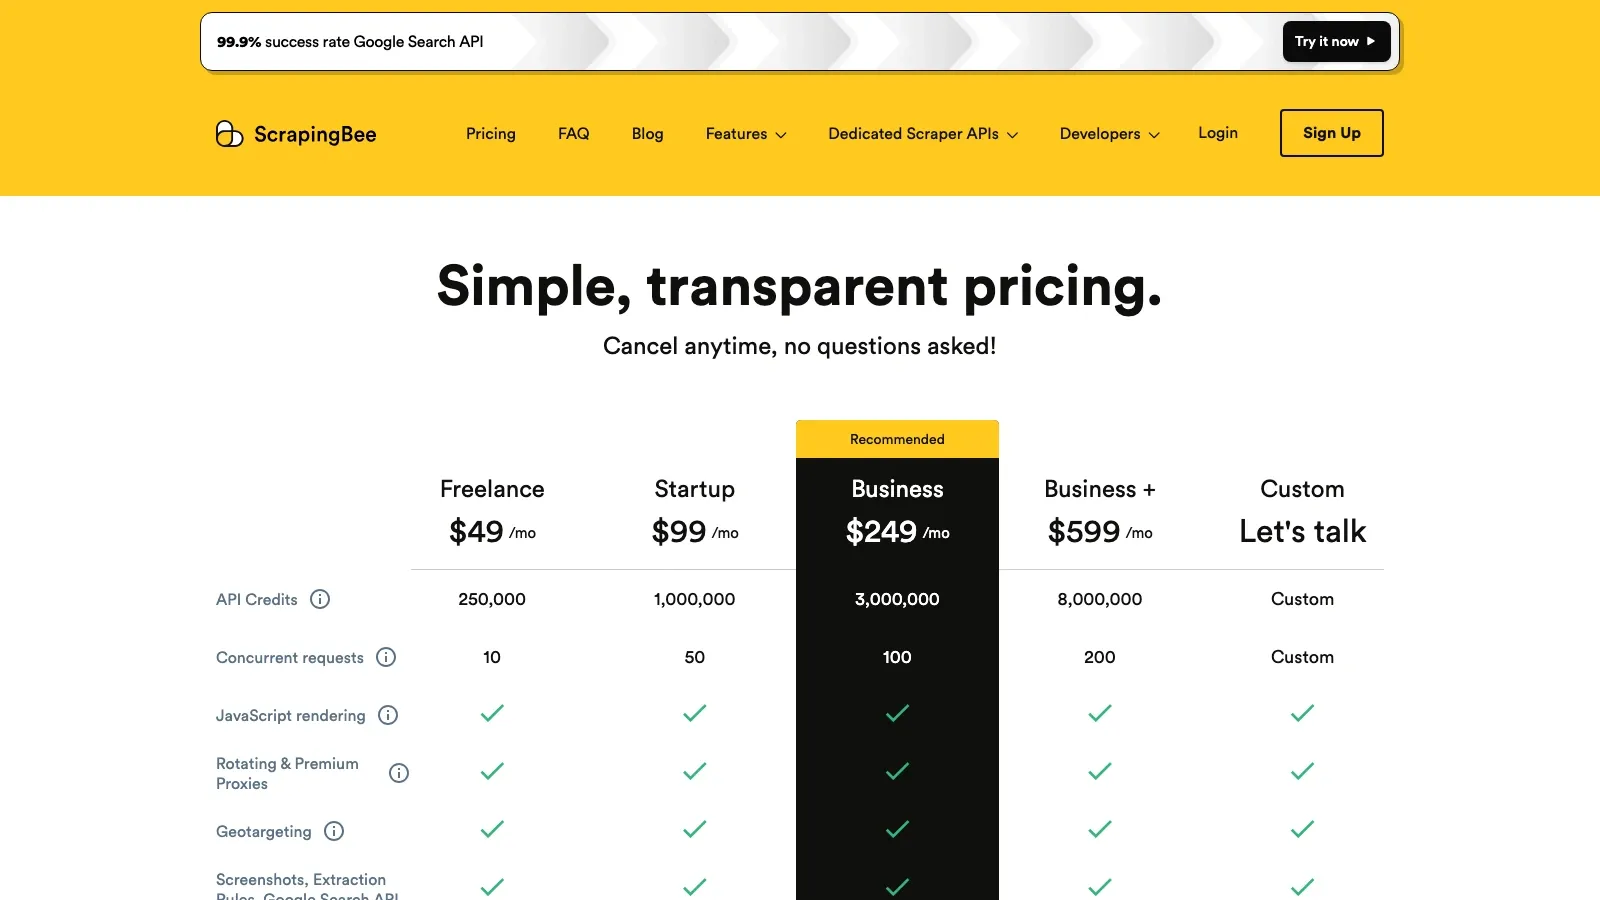
| ScrapingBee | Freelance เริ่ม $49/เดือน; Startup เริ่ม $99/เดือน; Business เริ่ม $249/เดือน | API สำหรับ scraping ที่เน้นการ render หน้าเว็บ | นักพัฒนาที่ scrape เว็บที่ใช้ JavaScript หนัก ๆ โดยไม่ต้องดูแล browser fleet เอง |
| Scrapy | ฟรีและโอเพนซอร์ส | Python crawling framework | ทีม developer ที่สร้างไปป์ไลน์ scraping ของตัวเอง |
| Playwright | ฟรีและโอเพนซอร์ส | ไลบรารี browser automation รุ่นใหม่ | ทีมที่ต้องการควบคุมเบราว์เซอร์แบบสคริปต์บน Chromium, Firefox และ WebKit |
10 โซลูชัน Web Scraping ที่ดีที่สุดในปี 2026
1. Thunderbit
Thunderbit เป็นจุดเริ่มต้นที่แข็งแรงที่สุดเมื่อโจทย์คือ “ขอข้อมูลนี้ลงชีตวันนี้เลย” ทิศทางของผลิตภัณฑ์ถูกออกแบบมารอบ ๆ AI field suggestion, การเสริมข้อมูลจาก subpage และการ export ที่เหมาะกับผู้ใช้ธุรกิจ ไม่ใช่กับนักพัฒนา scraper โดยเฉพาะ
- เหมาะที่สุดสำหรับ: ทีมขาย, operations, ecommerce, อสังหาริมทรัพย์ และเวิร์กโฟลว์วิจัยที่ใช้เบราว์เซอร์เป็นหลัก
- จุดเด่น: แนะนำฟิลด์ให้อัตโนมัติ รองรับ pagination และ subpages และส่งออกไปยัง Sheets, Excel, Airtable, Notion, CSV และ JSON ได้เร็ว
- เหตุผลที่ติดลิสต์: ยังเป็นเส้นทางที่สั้นที่สุดจากหน้าเว็บสาธารณะไปสู่ผลลัพธ์แบบมีโครงสร้างสำหรับคนที่ไม่เขียนโค้ด
- สัญญาณราคา: มีแผนใช้ฟรี, Starter เริ่ม $15/เดือน, Pro เริ่ม $38/เดือน และมีราคาสำหรับธุรกิจ
ลองใช้ Thunderbit AI Web Scraper ฟรี scrape เว็บไซต์ใดก็ได้ใน 1 คลิก แล้ว export ไปยัง Sheets, Excel, Airtable หรือ Notion Get Started Free
2. Browse AI
Browse AI ยังเป็นหนึ่งในตัวเลือก no-code ที่น่าเชื่อถือที่สุดสำหรับทีมที่ต้องการ robot แบบทำซ้ำได้, ระบบมอนิเตอร์ และผลลัพธ์ที่พร้อมใช้งานกับสเปรดชีต โดยไม่ต้องเขียนโค้ด จุดแข็งในปัจจุบันอยู่ที่งาน scraping และการตรวจจับการเปลี่ยนแปลงที่ต้องทำควบคู่กัน
- เหมาะที่สุดสำหรับ: การมอนิเตอร์คู่แข่ง, ติดตามราคา, scraping ไดเรกทอรี และการตรวจจับการเปลี่ยนแปลงแบบต่อเนื่อง
- จุดเด่น: บันทึก robot, มอนิเตอร์ซ้ำได้, ดึงข้อมูลคล้ายเบราว์เซอร์ และรองรับเว็บที่มีการป้องกันระดับสูง
- เหตุผลที่ติดลิสต์: ยังเป็นหนึ่งในตัวเลือก no-code ที่ชัดเจนที่สุดเมื่อโจทย์เป็นงานต่อเนื่อง ไม่ใช่งานครั้งเดียว
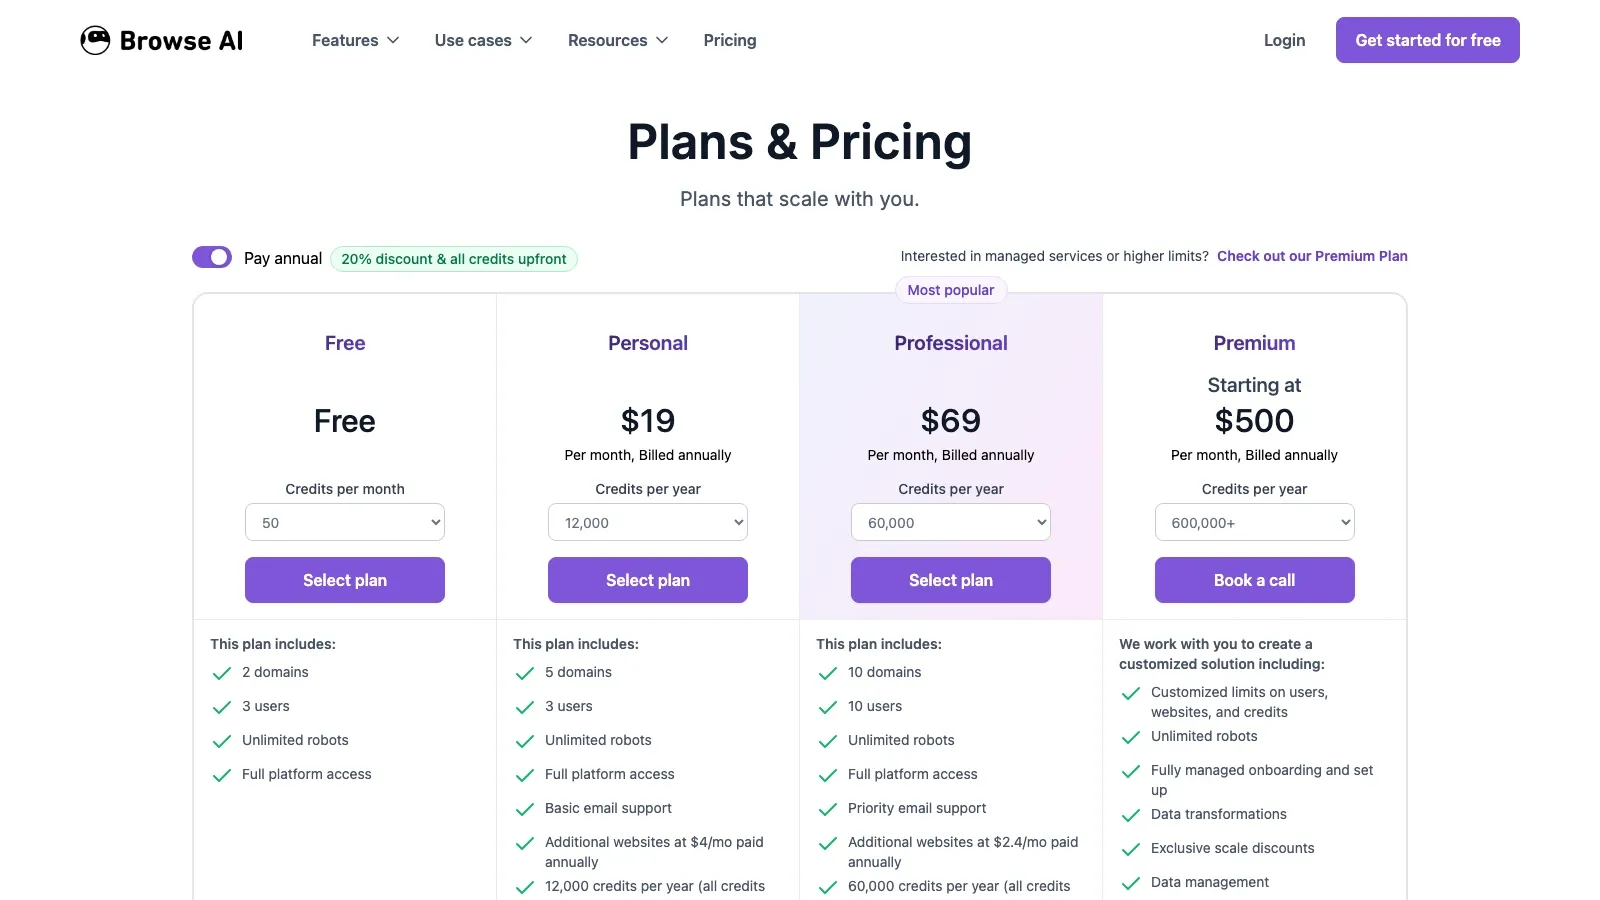
- สัญญาณราคา: มีแผนใช้ฟรี; Personal เริ่ม $19/เดือนเมื่อชำระรายปี; Professional เริ่ม $69/เดือนเมื่อชำระรายปี; Premium เริ่ม $500/เดือนเมื่อชำระรายปี
3. Octoparse
Octoparse ยังติดอันดับต้น ๆ เพราะเป็นหนึ่งในเส้นทางอัปเกรดที่ดีที่สุดเมื่อ one-click browser scraper ยังไม่พอ เครื่องมือนี้ให้ task builder ที่ชัดเจนกว่า, การดึงข้อมูลบนคลาวด์ และเพดานการควบคุมที่สูงกว่าเครื่องมือแบบ extension เบา ๆ
- เหมาะที่สุดสำหรับ: นักวิเคราะห์, ทีมตั้งราคา และทีมปฏิบัติการที่รันงานดึงข้อมูลซ้ำ ๆ ปริมาณมาก
- จุดเด่น: ตั้งค่างานแบบ visual, รันบนคลาวด์, เทมเพลต, ตัวเลือกกันบล็อก และการตั้งตารางรันซ้ำ
- เหตุผลที่ติดลิสต์: ยังเป็นสะพานเชื่อมที่สะอาดระหว่าง business scraping แบบง่ายกับ automation แบบ no-code ที่หนักขึ้น
- สัญญาณราคา: มีแผนใช้ฟรี; Standard เริ่ม $69/เดือน; Professional เริ่ม $249/เดือน
ถ้าคุณอยากเทียบเวิร์กโฟลว์แบบ task builder ที่เป็นโครงสร้างชัดเจนกับเครื่องมือ AI-first ที่เบากว่า วิดีโอสอน Octoparse ด้านล่างนี้คือตัวกลางที่เห็นภาพที่สุด:
4. ParseHub
ParseHub ยังควรอยู่ในลิสต์สำหรับผู้ใช้ที่ต้องการควบคุมการนำทางของเว็บแบบ dynamic มากขึ้น แต่ยังไม่พร้อมดูแลโค้ดเบสของตัวเอง เวิร์กโฟลว์ของมันหนักกว่า Thunderbit หรือ Browse AI แต่ยังมีประโยชน์เมื่อโครงสร้างหน้าเว็บต้องใช้ตรรกะบนเดสก์ท็อปที่ชัดเจนขึ้น
- เหมาะที่สุดสำหรับ: ผู้ใช้ที่ scrape เว็บแบบ interactive หรือ dynamic และรับการตั้งค่าที่มากขึ้นได้
- จุดเด่น: สร้าง flow บนเดสก์ท็อป, รองรับ AJAX, การนำทางแบบซ้อน และตรรกะการดึงข้อมูลแบบกำหนดเอง
- เหตุผลที่ติดลิสต์: ให้การควบคุมมากกว่าเครื่องมือเบราว์เซอร์แบบเบา ๆ โดยไม่ต้องเข้าเวิร์กโฟลว์วิศวกรรมเต็มรูปแบบ
- สัญญาณราคา: มีแผนใช้ฟรี; แผนเสียเงินเริ่ม $189/เดือนตามเอกสารซัพพอร์ตทางการล่าสุดของ ParseHub
เครื่องมือแพลตฟอร์มและ API ที่ดีที่สุดเมื่อเน้นสเกล
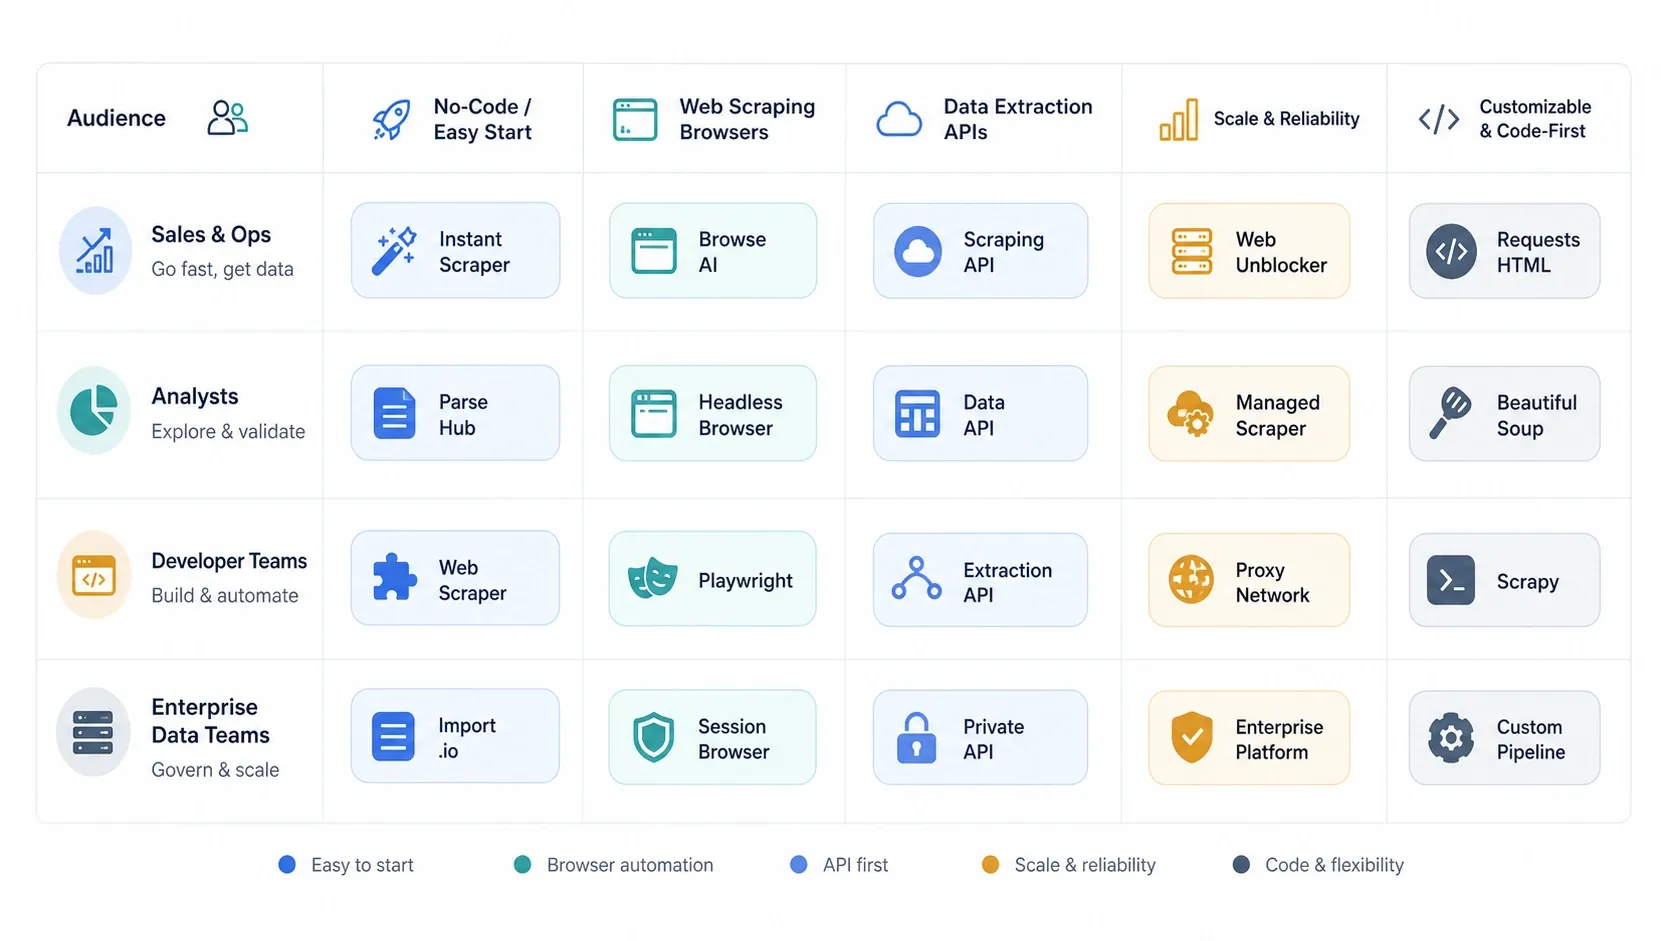
พอคำถามเปลี่ยนจาก “ฉัน scrape หน้านี้ได้ไหม?” ไปเป็น “ฉันจะรันมันให้เสถียรในระดับสเกลได้ไหม?” รายการตัวเลือกก็จะเปลี่ยนตาม เครื่องมือระดับแพลตฟอร์มมีความสำคัญมากขึ้นเมื่อการ render, อัตราการหลีกเลี่ยงการบล็อก, การจัดเส้นทาง proxy หรือเวิร์กโฟลว์แบบโปรแกรมได้ กลายเป็นคอขวดจริง
5. Apify
Apify เป็นแพลตฟอร์มที่ยืดหยุ่นที่สุดในลิสต์นี้ ถ้าคุณต้องการทั้ง scraper สำเร็จรูปและพื้นที่สำหรับสร้าง automation แบบกำหนดเองในอนาคต actor marketplace ผสานกับ runtime แบบ custom ทำให้มันไปได้ไกลกว่า browser extension ทั่วไปมาก
- เหมาะที่สุดสำหรับ: ทีมแบบไฮบริดที่อยากได้แพลตฟอร์มเดียวสำหรับ scraper สำเร็จรูป, API และเวิร์กโฟลว์เฉพาะทาง
- จุดเด่น: actor marketplace, รันบนคลาวด์, การเข้าถึงผ่าน API, integration และพื้นที่สำหรับโค้ดที่กำหนดเอง
- เหตุผลที่ติดลิสต์: เชื่อมระหว่างการ scrape แบบ self-serve กับโครงสร้างพื้นฐานจริงได้ดีกว่าคู่แข่งส่วนใหญ่
- สัญญาณราคา: มีแผนใช้ฟรี; Starter เริ่ม $29/เดือน; Scale เริ่ม $199/เดือน; Business เริ่ม $999/เดือน
6. Bright Data
Bright Data เหมาะกับทีมที่ไม่ได้แค่ซื้อ scraper แต่กำลังซื้อความสามารถในการหลบการบล็อก, คลัง proxy, ตัวเลือกการเก็บข้อมูลแบบ managed และสแต็กการเก็บข้อมูลที่กว้างพอจะรับมือกับเป้าหมายที่ยากขึ้นและปริมาณที่สูงขึ้น
- เหมาะที่สุดสำหรับ: โครงการเก็บข้อมูลระดับองค์กร, งานข้อมูลเว็บสาธารณะที่ต้องใส่ใจ compliance และทีมที่ต้องการมากกว่าแอป scraper ธรรมดา
- จุดเด่น: scraper API, เครือข่าย proxy, datasets แบบ managed, เครื่องมือ browser และโครงสร้างพื้นฐานที่ลึก
- เหตุผลที่ติดลิสต์: ยังเป็นหนึ่งในคำตอบที่แข็งแรงที่สุดเมื่อความเสถียรและสเกลสำคัญกว่าความง่าย
- สัญญาณราคา: Bright Data ใช้ราคาแบบตามผลิตภัณฑ์และตามการใช้งาน ครอบคลุม scraper APIs, proxies และบริการข้อมูลแบบ managed
7. Oxylabs
Oxylabs ยังเป็นหนึ่งในการซื้อโครงสร้างพื้นฐานที่ชัดเจนที่สุดสำหรับทีมที่ต้องการเก็บข้อมูลจากเว็บสาธารณะอย่างเชื่อถือได้ โดยไม่ต้องประกอบสแต็ก unblock และ proxy เองทั้งหมด ไลน์ผลิตภัณฑ์ของที่นี่แข็งแรงเป็นพิเศษสำหรับการติดตามราคา, วิจัยตลาด และโปรแกรมข้อมูลต่อเนื่อง
- เหมาะที่สุดสำหรับ: ทีมที่ซื้อ scraping ในฐานะ infrastructure ไม่ใช่เครื่องมือแบบ point-and-click
- จุดเด่น: Web Scraper API, Web Unblocker, ผลิตภัณฑ์ proxy และกระบวนการจัดซื้อที่เหมาะกับองค์กร
- เหตุผลที่ติดลิสต์: ยังเป็นหนึ่งในตัวเลือกที่น่าเชื่อถือที่สุดเมื่อผู้ซื้อให้ความสำคัญกับความเสถียรและการซัพพอร์ตมากกว่าการตั้งค่าที่ง่าย
- สัญญาณราคา: Web Scraper API เริ่ม $49/เดือน; ผลิตภัณฑ์ proxy และ unblocker อื่น ๆ แตกต่างกันไปตามสินค้าและการใช้งาน
8. ScrapingBee
ScrapingBee เหมาะมากเมื่อโจทย์จริงคือ “ช่วย render หน้าเว็บ หมุน proxy ให้ แล้วให้ทีมฉันไปโฟกัสที่การ parse ก็พอ” มันแคบกว่าแพลตฟอร์มขนาดใหญ่แบบ Apify แต่ความเฉพาะทางนี่แหละที่ทำให้ทีมวิศวกรรมจำนวนมากชอบ
- เหมาะที่สุดสำหรับ: นักพัฒนาที่ scrape เว็บ JavaScript หนัก ๆ โดยไม่อยากดูแล browser fleet เอง
- จุดเด่น: headless browser rendering, หมุน proxy, geotargeting และเวิร์กโฟลว์ API-first ที่เรียบง่าย
- เหตุผลที่ติดลิสต์: ช่วยย้ายภาระปัญหาที่น่าปวดหัวที่สุดของโครงสร้างพื้นฐานเบราว์เซอร์ออกไป โดยไม่บังคับให้ต้อง commit กับแพลตฟอร์มขนาดใหญ่
- สัญญาณราคา: Freelance เริ่ม $49/เดือน, Startup เริ่ม $99/เดือน, Business เริ่ม $249/เดือน
เฟรมเวิร์กที่ทีม developer เป็นเจ้าของดีที่สุด
9. Scrapy
Scrapy ยังเป็นเฟรมเวิร์ก crawler แบบโอเพนซอร์สที่สำคัญที่สุดเมื่อทีมต้องการเป็นเจ้าของไปป์ไลน์ของตัวเอง มันอาจไม่ใช่เส้นทางที่ง่ายที่สุดสู่การ scrape ครั้งแรก แต่ยังเป็นคำตอบที่ดีที่สุดอย่างหนึ่งสำหรับระบบ crawling ภายในที่ต้องใช้งานยาว ๆ
- เหมาะที่สุดสำหรับ: ทีม Python ที่สร้าง crawler ภายในหรือไปป์ไลน์ข้อมูลระดับ production
- จุดเด่น: crawling ประสิทธิภาพสูง, middleware, pipelines และการต่อขยายได้ดี
- เหตุผลที่ติดลิสต์: ยังให้ทีมเทคนิคสัดส่วนพลังต่อความสมบูรณ์ของเครื่องมือที่ดีมากในโลกของ scraping แบบโอเพนซอร์ส
- สัญญาณราคา: ฟรีและโอเพนซอร์ส
10. Playwright
Playwright คือคำแนะนำตั้งต้นของผมเมื่อทีมต้องการการควบคุมเบราว์เซอร์แบบสคริปต์สมัยใหม่ แทนเฟรมเวิร์ก crawler แบบคลาสสิก เว็บไซต์ทางการปัจจุบันก็สื่อชัดเจนว่าเป็น API เดียวสำหรับ Chromium, Firefox และ WebKit ครอบคลุมทั้งงานทดสอบ, การเขียนสคริปต์ และเวิร์กโฟลว์ของ agent
- เหมาะที่สุดสำหรับ: browser automation สมัยใหม่, เว็บที่ใช้ JavaScript หนัก ๆ และทีมที่ให้ความสำคัญกับ developer ergonomics
- จุดเด่น: พฤติกรรมการรอที่เชื่อถือได้, รองรับหลายเบราว์เซอร์ และควบคุม automation ได้ลึกสำหรับเวิร์กโฟลว์แบบสคริปต์
- เหตุผลที่ติดลิสต์: มักเป็นตัวเลือกที่สะอาดที่สุดเมื่อการทำงานต้องอาศัยการโต้ตอบกับเบราว์เซอร์จริง มากกว่าการ crawl ผ่าน HTTP ล้วน ๆ
- สัญญาณราคา: ฟรีและโอเพนซอร์ส
ลิสต์แนะนำแยกตามประเภททีม
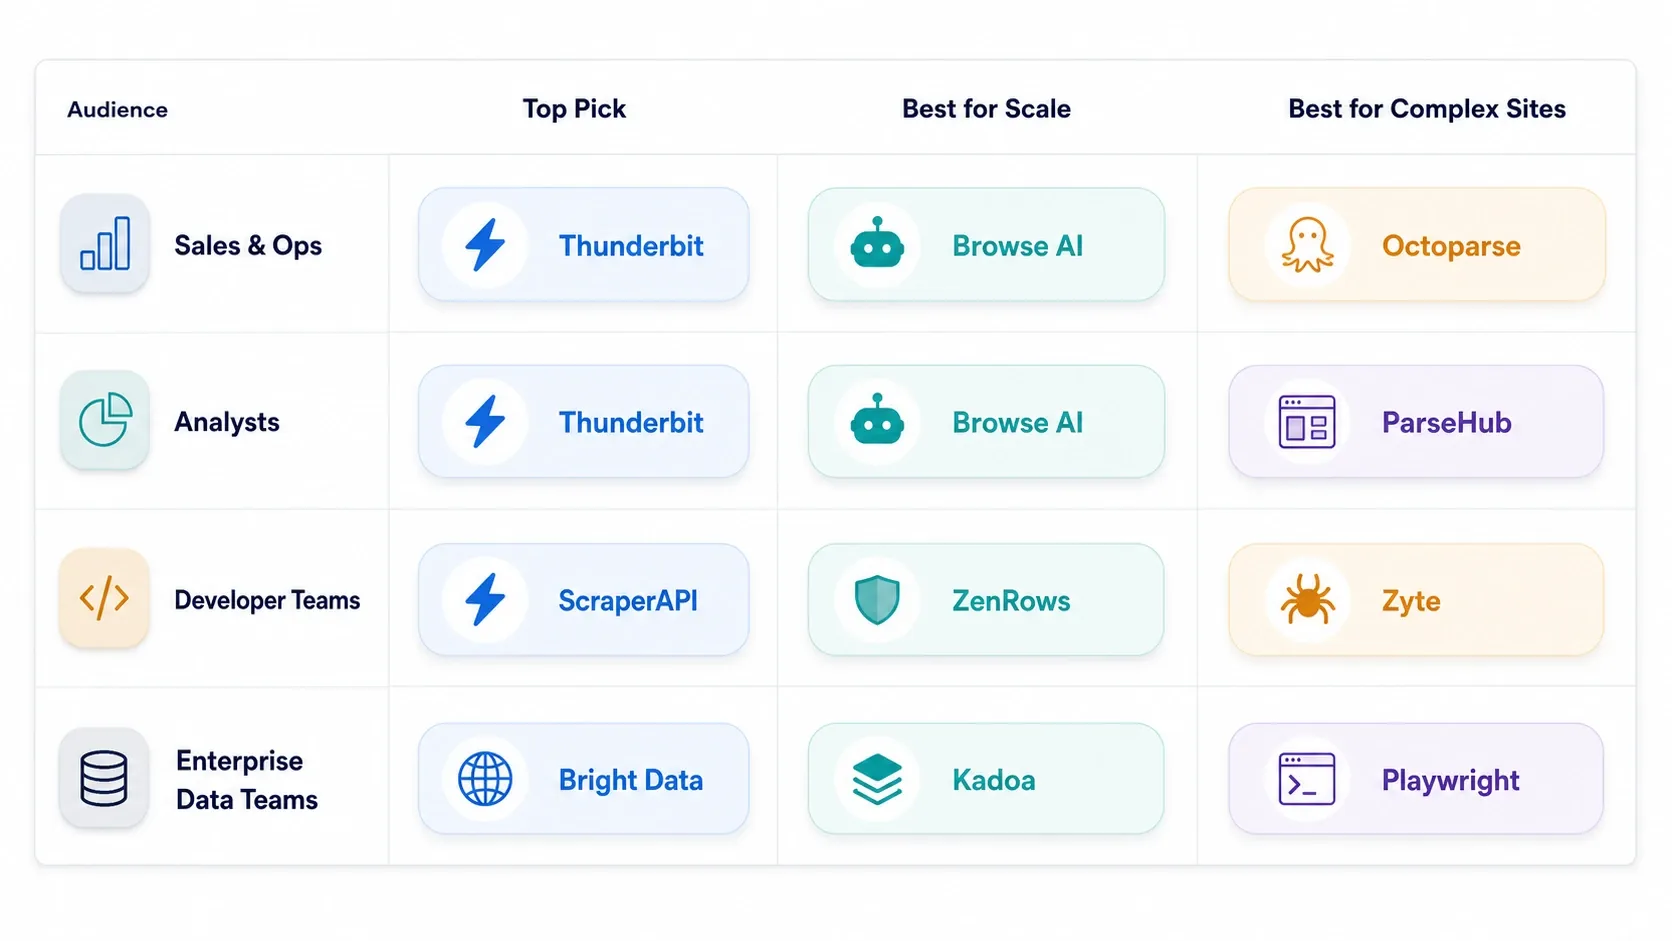
- ทีมขายและ ops: เริ่มที่ Thunderbit แล้วค่อยเทียบ Browse AI หากการมอนิเตอร์สำคัญกว่าการเสริมข้อมูลจาก subpage
- ทีมวิเคราะห์และทีมดึงข้อมูลซ้ำ ๆ: เริ่มที่ Octoparse แล้วค่อยดู ParseHub ถ้าต้องการตรรกะหน้าเว็บที่ชัดเจนกว่า
- ทีมเทคนิคแบบไฮบริด: เลือก Apify ถ้าคุณอยากได้แพลตฟอร์มเดียวที่มีทั้งเครื่องมือสำเร็จรูปและเวิร์กโฟลว์เฉพาะทาง
- โปรแกรมข้อมูลระดับองค์กร: เลือก Bright Data และ Oxylabs หากอัตราการหลบการบล็อก, procurement และความเสถียรคือเรื่องสำคัญที่สุด
- ไปป์ไลน์ที่ทีม developer เป็นเจ้าของ: ใช้ Scrapy สำหรับการเป็นเจ้าของ crawler และ Playwright สำหรับ automation แบบ browser-first ที่เขียนเป็นสคริปต์
ถ้าลิสต์ของคุณเริ่มขยับจาก browser extension ไปสู่การมอนิเตอร์แบบทำซ้ำได้และเวิร์กโฟลว์ระดับ marketplace วิดีโอ Apify ด้านล่างนี้จะเหมาะกว่า clip สรุปรวมทั่ว ๆ ไปอีกชิ้น:
เลือกอย่างไรโดยไม่ซื้อเกินความจำเป็น
ความผิดพลาดที่พบบ่อยที่สุดในหมวดนี้คือการซื้อผิดชั้นของเครื่องมือ
- เลือก AI scraper แบบ browser-first ถ้าปัญหาหลักคือเวลาในการตั้งค่าและความง่ายสำหรับผู้ใช้ธุรกิจ
- เลือกเครื่องมือเวิร์กโฟลว์แบบ no-code ถ้างานทำซ้ำ, การรันบนคลาวด์ หรือ pagination ที่ซับซ้อนสำคัญกว่าความง่ายแบบคลิกเดียว
- เลือกแพลตฟอร์มหรือสแต็ก API ถ้าการ render, การหมุน proxy และอัตราการหลบการบล็อก คือความต้องการจริง
- เลือกเฟรมเวิร์กโอเพนซอร์ส เฉพาะเมื่อทีมวิศวกรรมเป็นผู้รับภาระการดูแลอยู่แล้วและต้องการอำนาจควบคุมเต็มที่
กฎที่ใช้ได้จริงนั้นง่ายมาก: ซื้อเครื่องมือที่เบาที่สุดซึ่งยังทำงานที่คุณมีอยู่ตอนนี้ได้อย่างมั่นคง
บทสรุป
ไม่มีโซลูชัน web scraping ที่ดีที่สุดแบบสากล เพราะหมวดนี้ครอบคลุมเส้นทางการซื้อหลายแบบ Thunderbit เหมาะที่สุดเมื่อเริ่มงานในเบราว์เซอร์และต้องจบเป็นสเปรดชีตอย่างรวดเร็ว Browse AI, Octoparse และ ParseHub เหมาะกว่าเมื่อความทำซ้ำได้และการควบคุมแบบ no-code ที่ชัดเจนสำคัญขึ้น Apify, Bright Data, Oxylabs และ ScrapingBee จะมีความหมายมากขึ้นเมื่อโครงสร้างพื้นฐานกลายเป็นคอขวด Scrapy และ Playwright คือคำตอบที่ถูกต้องเมื่อทีมวิศวกรรมต้องการเป็นเจ้าของสแต็กทั้งหมด
เริ่มจากเครื่องมือที่เบาที่สุดซึ่งยังทำงานได้จริง Get Started Free
อ่านเพิ่มเติม
- เครื่องมือ AI Web Scraper ที่ดีที่สุดในปี 2026
- วิธี scrape เว็บไซต์ใดก็ได้ด้วย AI
- วิธีดึงข้อมูลเว็บไซต์ลง Excel
คำถามที่พบบ่อย
1. เครื่องมือ web scraping ที่ดีที่สุดสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิคในปี 2026 คืออะไร?
สำหรับผู้ใช้ที่ไม่ใช่สายเทคนิคส่วนใหญ่ Thunderbit คือจุดเริ่มต้นที่ดีที่สุด เพราะลดงานตั้งค่าและส่งออกไปยังเครื่องมือธุรกิจได้เร็ว Browse AI และ Octoparse เป็นตัวเลือกต่อไปที่แข็งแรง เมื่อการมอนิเตอร์ซ้ำ ๆ หรือการควบคุมแบบ no-code ที่ละเอียดขึ้นเริ่มสำคัญ
2. เครื่องมือ web scraping ตัวไหนเหมาะที่สุดสำหรับเวิร์กโฟลว์ no-code ที่ทำซ้ำได้?
Octoparse เป็นตัวเลือกตรงกลางที่แข็งแรงที่สุด ถ้าคุณต้องการรันบนคลาวด์, เทมเพลต และการตั้งเวลาการดึงข้อมูลที่ทำซ้ำได้ Browse AI จะเหมาะกว่าเมื่อการมอนิเตอร์และการตรวจจับการเปลี่ยนแปลงคือหัวใจของงาน
3. นักพัฒนาควรเลือกอะไรถ้าต้องการสเกลหรือการควบคุมที่มากขึ้น?
Apify คือแพลตฟอร์มที่แข็งแรงที่สุด ถ้าคุณต้องการโครงสร้างพื้นฐานบนคลาวด์พร้อมเครื่องมือที่นำกลับมาใช้ได้ Scrapy เป็นคำตอบที่ดีกว่าเมื่อทีมต้องการเป็นเจ้าของสแต็ก Python crawler เอง Playwright เหมาะกว่าเมื่อ browser automation เป็นแกนหลักของเวิร์กโฟลว์
4. เมื่อไร Bright Data หรือ Oxylabs ถึงเหมาะกว่าการใช้ browser scraper?
เหมาะกว่าเมื่อโจทย์ยากไม่ได้อยู่ที่การดึงข้อมูลจากหน้าเดียว แต่อยู่ที่การจัดการโครงสร้างพื้นฐาน: อัตราการหลีกเลี่ยงการบล็อก, การ routing proxy, procurement, compliance หรือการเก็บข้อมูลขนาดใหญ่ที่ต้องเสถียร
5. เครื่องมือฟรีและโอเพนซอร์สเพียงพอสำหรับงาน scraping จริงจังไหม?
เพียงพอได้ แต่ต้องเป็นกรณีที่ทีมพร้อมรับภาระการดูแล, ตรรกะการ parse, งาน anti-bot, การ retry และโครงสร้างพื้นฐานเอง ความแลกเปลี่ยนแบบนี้มักคุ้มค่าสำหรับทีมวิศวกรรม แต่โดยทั่วไปไม่ใช่จุดเริ่มต้นที่เหมาะกับผู้ใช้ธุรกิจ




