
พอเปิดแท็บเบราว์เซอร์ไปถึงแท็บที่สิบสี่ และนั่งไล่เครื่องคำนวณราคาไปถึงตัวที่สาม ผมก็เริ่มรู้แล้วว่า การเลือกบริการเว็บสแครปปิ้งในปี 2026 ยากกว่าการสแครปข้อมูลจริง ๆ เสียอีก ตลาดตอนนี้โตระเบิด — มีทั้งส่วนขยาย Chrome แบบไม่ต้องเขียนโค้ด, API ดิบ ๆ, สแตกสำหรับองค์กรที่พึ่งพร็อกซีหนัก ๆ, เครื่องมือดึงข้อมูลด้วย AI ไปจนถึงเอเจนซี่บริการครบวงจร แข่งกันแย่งงบก้อนเดียวกัน
ผมใช้เวลาหลายสัปดาห์ทดสอบบริการเว็บสแครปปิ้ง 12 เจ้า กับงานจริง ๆ: ดึงข้อมูลสินค้าจากเว็บอีคอมเมิร์ซ, เก็บลีดจากไดเรกทอรีธุรกิจ, และสแครปรายการงานที่มีทั้งเพจถัดไปและหน้ารายละเอียดเปียกซ้อน เป้าหมายไม่ใช่การจัดอันดับฟีเจอร์แบบแยกส่วน แต่คือการตอบคำถามเดียวที่ใช้งานได้จริง: บริการไหนเหมาะกับทีมแบบไหนกันแน่
จากรายงานข้อมูลเว็บสาธารณะของ Bright Data พบว่า 82% ขององค์กร มองว่าข้อมูลเว็บสาธารณะเป็นหัวใจสำคัญต่ออนาคตของพวกเขา รายงานตลาดปี 2025 ของ ScrapeOps พบว่า มากกว่า 65% ขององค์กร ใช้เว็บสแครปปิ้งเพื่อสร้างชุดข้อมูลสำหรับการวิเคราะห์และ AI แต่ถึงอย่างนั้น แบบสำรวจปี 2026 ของ Apify ก็ยังบอกว่า 46.7% ของมืออาชีพ ยังพึ่งโค้ดภายในองค์กรแบบเต็มตัว พร้อมภาระดูแลรักษาที่ตามมา
ก่อนจะไปดูเครื่องมือ มาทำความเข้าใจด้านกฎหมายของการสแครปข้อมูลกันแบบสั้น ๆ ก่อน
วิธีที่ผมประเมินบริการเว็บสแครปปิ้งที่ดีที่สุด
นี่คือเกณฑ์ที่ผมใช้เลือก โดยผมอิงจากสิ่งที่มักพังหลังพ้นช่วงเดโม ไม่ใช่แค่สิ่งที่โชว์ไว้บนหน้า features
- ความง่ายในการตั้งค่า / ทักษะเทคนิคที่ต้องใช้ — คนที่ไม่ใช่นักพัฒนาจะเริ่มเห็นประโยชน์ได้ภายใน 10 นาทีไหม?
- การรับมือ anti-bot และพร็อกซี — บริการจัดการพร็อกซีและการแก้ CAPTCHA ให้หรือเป็นภาระของเรา?
- การเรนเดอร์ JavaScript — รับมือหน้าเว็บไดนามิกหรือหน้าเว็บที่หนักไปทาง JS ได้เลยไหม?
- รูปแบบการส่งออกข้อมูลและการเชื่อมต่อ — ส่งข้อมูลเข้า Sheets, Airtable หรือ Notion ได้โดยไม่ต้องเขียนโค้ดเชื่อมกลางไหม?
- การตั้งเวลา / มอนิเตอร์อัตโนมัติ — ตั้งให้สแครปซ้ำได้เรื่อย ๆ โดยไม่ต้องใช้ cron jobs ไหม?
- ความสามารถในการสเกล — ทำงานได้ที่ 100 หน้า แล้วจะยังไหวที่ 1 ล้านหน้าหรือไม่?
- ความโปร่งใสของราคาและต้นทุนเมื่อสเกล — เดือนไปจะคาดการณ์บิลได้ไหม หรือมีเซอร์ไพรส์?
- การดึงข้อมูลด้วย AI เทียบกับ selector แบบ manual — ใช้ AI เดาคอลัมน์ให้ หรือเราต้องเขียน CSS/XPath เอง?
- ภาระการดูแลในระยะยาว — เกิดอะไรขึ้นเมื่อเว็บเป้าหมายรีดีไซน์หน้าใหม่?
ข้อสุดท้ายนี้สำคัญมาก รีวิวผู้ใช้ของเครื่องมืออย่าง Octoparse, Apify, Browse AI และ Bright Data มักจะบ่นเรื่องเดิมซ้ำ ๆ: ราคาเครดิตชวนสับสน, selector พังหลังเว็บเปลี่ยนหน้า, งานบนคลาวด์ล้มเมื่อเจอหน้าที่ป้องกันเข้มงวด, และเส้นโค้งการเรียนรู้ที่ชันเกินเดโมแรก ๆ “ภาระการดูแล” ไม่ใช่แค่ฟีเจอร์เสริม แต่มันคือตัวตัดสินว่าคุณจะยังใช้เครื่องมือนี้อยู่ในอีกหกเดือนข้างหน้าหรือไม่
บริการเว็บสแครปปิ้งแบบไหนที่เหมาะกับทีมของคุณ?
ก่อนจะเทียบทีละเครื่องมือ สิ่งที่มีประโยชน์ที่สุดคือช่วยให้คุณข้ามไปดู “ประเภท” ที่ใช่เลย ตลาดเว็บสแครปปิ้งไม่ใช่ตลาดเดียว แต่มันคือห้าตลาดที่ซ้อนทับกันอยู่ และการเลือกประเภทผิดเสียเวลามากกว่าการเลือกเครื่องมือผิดภายในประเภทที่ถูก
| สถานการณ์ของคุณ | ประเภทบริการที่แนะนำ | เหตุผล | ตัวที่เหมาะจากลิสต์นี้ |
|---|---|---|---|
| ทีมที่ไม่ถนัดเทคนิค (sales, marketing, ops) แต่ต้องการข้อมูลเร็ว | ส่วนขยาย Chrome แบบไม่ต้องเขียนโค้ด | ทางลัดที่เร็วที่สุดจากเว็บไปสเปรดชีต ตั้งค่าง่ายสุด | Thunderbit, Browse AI, Octoparse |
| นักพัฒนาที่ต้องฝังสแครปปิ้งเข้าแอปหรือ pipeline | Scraping API | ควบคุมได้มากกว่า, มี webhook, งานแบบ async, เข้ากับ CI/CD ได้ดี | ScrapingBee, ScraperAPI, ZenRows |
| ทีมที่ป้อนข้อมูลเข้า workflow ของ AI/LLM | AI-native extraction API | ส่งออกเป็น Markdown/JSON เป็นหลัก ลดงานเก็บกวาด HTML | Thunderbit API, Firecrawl, Diffbot |
| องค์กรที่ต้องการพร็อกซี + สเกลปริมาณสูง | แพลตฟอร์มเก็บข้อมูลแบบ full-stack | รวมพร็อกซี, anti-bot, SLA และ concurrency สูงไว้ในชุดเดียว | Bright Data, Oxylabs, Apify |
| บริษัทที่อยากได้ “ข้อมูล” มากกว่า “เครื่องมือ” | Managed service / agency | ผู้ให้บริการดูแลการสร้าง, มอนิเตอร์, QA และส่งมอบให้ | ScrapeHero |
นี่ไม่ใช่ทฤษฎีลอย ๆ แนวทาง build-vs-buy ของ Zyte ปี 2026 อธิบาย tradeoff นี้ไว้ชัดเจน: ทำเองได้คุมทุกอย่าง แต่ต้องดูแลต่อเนื่องตลอด; สแตกแบบผสมทำให้การปฏิบัติงานกระจัดกระจาย; ส่วนบริการจัดการให้จะลดภาระภายใน แต่ก็ลดความยืดหยุ่นในการใช้งานเอง
การดึงข้อมูลด้วย AI เทียบกับ selector แบบ CSS/XPath ดั้งเดิม
นี่คือจุดแยกทางเชิงเทคนิคที่ใหญ่ที่สุดในตลาดตอนนี้
การสแครปแบบดั้งเดิม ก็เหมือนเดินตามแผนที่ขุมทรัพย์ที่ระบุพิกัดชัดเจน คุณ inspect หน้าเว็บ หาค่า selector อย่าง .product-title เขียนกฎดึงข้อมูล ทดสอบ แล้วก็หวังว่าเว็บจะหน้าตาเดิมพรุ่งนี้ ถ้า frontend team เปลี่ยนชื่อ class หรือย้าย content เข้า div ใหม่ สแครปเปอร์ก็พัง
การสแครปด้วย AI คล้ายกับถามผู้ช่วยอัจฉริยะว่า “ช่วยหา ชื่อสินค้า ราคา และสถานะสต็อกในหน้านี้ให้หน่อย” แทนที่จะ hard-code เส้นทาง คุณแค่บอกปลายทางที่ต้องการ
ในทางปฏิบัติ workflow ทั้งสองแบบหน้าตาประมาณนี้:
โฟลว์แบบดั้งเดิม:
- เปิด DevTools ตรวจ element
- หา class
.product-titleหรือ XPath - เขียนกฎดึงข้อมูล
- ทดสอบบนหน้า sample
- แก้ทุกครั้งที่เว็บเปลี่ยน class names
โฟลว์แบบ AI (เช่น Thunderbit):
- เปิดหน้าแล้วคลิกครั้งเดียว
- AI เลือกคอลัมน์ให้เอง — ชื่อสินค้า, ราคา, คะแนน
- ถ้าอยากได้แบบอื่นก็สั่งเพิ่มได้ หรือพิมพ์บอกตรง ๆ
- ไม่งั้นก็ปล่อยรัน แล้วรับตารางข้อมูลกลับมาเลย
งานวิจัยที่เผยแพร่ออกมายังตามหลังคำโฆษณาอยู่บ้าง งาน Scientific Reports ปี 2025 รายงานว่า crawler แบบ AI มีความแม่นยำในการดึงข้อมูลสูงขึ้น 35% และประสิทธิภาพการประมวลผลดีขึ้น 40% เมื่อเทียบกับแบบดั้งเดิม แต่ชุดทดสอบเป็นคลังข่าว ไม่ใช่หน้าสินค้าหรือไดเรกทอรีธุรกิจ ดังนั้นผมจะไม่เอาตัวเลขนี้ไปเหมารวมกับเว็บในบทความนี้ งาน รีวิวของ Springer ปี 2025 มีประโยชน์กว่า: โมเดล AI ปรับตัวกับโครงสร้างที่เปลี่ยนได้ดีกว่า แต่ยังต้อง retrain หรือมี fallback logic เมื่อโดเมนหรือแพตเทิร์นเปลี่ยนมากพอ
| มิติเปรียบเทียบ | แบบดั้งเดิม (CSS/XPath) | การดึงข้อมูลด้วย AI |
|---|---|---|
| เวลาเริ่มต้น | 15–60 นาทีต่อเว็บ | ประมาณ 30 วินาที |
| ทักษะที่ต้องใช้ | ระดับนักพัฒนา | ไม่จำเป็น |
| รับมือการเปลี่ยน layout และเว็บใหม่ | พัง — ต้องเขียนกฎใหม่ทุกครั้งที่รีดีไซน์ และต้องมีกฎใหม่ทุกเว็บ | มักปรับตัวได้ — อ่านหน้าใหม่ทุกครั้งที่รัน |
| ความคาดเดาได้ | แน่นอน — กฎเดิมดึง field เดิมได้ทุกครั้ง | เชิงความน่าจะเป็น — อาจเลือก field ผิด จึงควรตรวจแบบสุ่ม |
| การติดป้าย / แปลงข้อมูล | ต้องทำขั้นตอน post-processing แยกต่างหาก | ใส่ label, แปลภาษา, จัดหมวดหมู่ระหว่างสแครปได้ |
| เหมาะกับ | pipeline ปริมาณสูงที่เสถียรและทีม dev ดูแลเอง | เว็บหลากหลาย, layout ไม่ตายตัว, ผู้ใช้ที่ไม่ใช่นักพัฒนา |
สิ่งที่ต่างกันชัดที่สุดในโลกจริงคือ “การดูแลรักษา” ไม่มีตัวเลขสาธารณะที่เชื่อถือได้ว่าตัวสแครปเปอร์พังบ่อยแค่ไหน ดังนั้นผมจะไม่ยกตัวเลขมายืนยันตรงนี้ สิ่งที่เห็นตรงกันคือรูปแบบคำบ่นในรีวิว G2 และ Capterra ของเครื่องมือแบบ selector-based ในลิสต์นี้: ไม่ค่อยใช่ว่าดึงข้อมูลไม่ได้ตั้งแต่แรก แต่ส่วนใหญ่คือดึงได้อยู่ดีจนกระทั่งเว็บเปลี่ยน แล้วมันหยุดดึงไปเลย
Thunderbit เป็นตัวอย่างที่ชัดที่สุดของแนว AI-first ในลิสต์นี้ AI ของมันเลือก field ที่ควรดึงให้หลังคลิกครั้งเดียว หรือคุณจะบอกข้อมูลที่ต้องการเป็นประโยคเดียวก็ได้ และ Field AI Prompts ยังช่วยติด label, แปล, สรุป หรือจัดหมวดหมู่ระหว่างการดึงข้อมูล ไม่ใช่แค่หลังบ้าน ภายใน Open API มีทั้ง endpoint Distill และ Extract ทำให้โมเดล AI extraction เดิมใช้งานแบบโปรแกรมได้ด้วย
ลองสแครปด้วย AI กับ Thunderbit
ภาพรวมบริการเว็บสแครปปิ้ง 12 เจ้า
| บริการ | ประเภท | เหมาะสุดสำหรับ | Anti-Bot/พร็อกซี | รองรับ JS | ดึงด้วย AI | ฟรี | ราคาเริ่มต้น (จ่ายรายเดือน) | ตัวเลือกการส่งออก |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | ส่วนขยาย Chrome แบบไม่ต้องเขียนโค้ด + API | ทีมที่ไม่ถนัดเทคนิค | ⚠️ จัดการบนคลาวด์ | ✅ | ✅ แมป field ด้วย AI | ✅ ฟรี 6 หน้า | ฟรี; แผนเสียเงินเริ่ม $15/เดือน | Excel, CSV, JSON, Sheets, Airtable, Notion |
| Bright Data | แพลตฟอร์มแบบ full-stack | pipeline ระดับองค์กร | ✅ เครือข่ายพร็อกซีระดับท็อป | ✅ | ⚠️ AI layer แบบบางส่วน/ใหม่กว่า | ✅ 5K records/เดือน | ไม่มีขั้นต่ำรายเดือน | JSON, CSV, API, webhook |
| Oxylabs | พร็อกซีระดับองค์กร + scraping | สแครป SERP, เว็บที่ป้องกันเข้ม | ✅ พร็อกซี residential/DC | ✅ | ⚠️ จำกัด | ⚠️ มี trial | ประมาณ $49/เดือน | JSON, CSV, API |
| Apify | แพลตฟอร์ม + marketplace | นักพัฒนา, คนทำ automation | ✅ ผ่านการตั้งค่าพร็อกซี | ✅ | ⚠️ บาง actor | ✅ ฟรี $5/เดือน | $29/เดือน + usage | JSON, CSV, Excel, API |
| ScrapingBee | บริการ API | pipeline ของนักพัฒนา | ✅ มีมาให้ในตัว | ✅ | ⚠️ มี AI extraction บางส่วน | ✅ 1,000 เครดิต | $49/เดือน | JSON, HTML, Markdown, API |
| ScraperAPI | บริการ API | ติดตามราคาขนาดใหญ่ | ✅ หมุนพร็อกซีในตัว | ✅ | ❌ | ⚠️ trial 7 วัน, 5K เครดิต | $49/เดือน | JSON, CSV, API |
| ZenRows | บริการ API | เว็บที่มี anti-bot หนัก | ✅ anti-bot ระดับพรีเมียม | ✅ | ⚠️ เบต้า | ✅ 5K เครดิต/เดือน | $19/เดือน | JSON, API |
| Octoparse | เดสก์ท็อปแบบไม่ต้องเขียนโค้ด + cloud | สแครปแบบภาพลากวาง | ✅ มีในตัว | ✅ | ⚠️ auto-detect จำกัด | ✅ ฟรี 10 tasks | $39/เดือน | Excel, CSV, JSON, HTML, XML, DB, Sheets |
| Diffbot | แพลตฟอร์ม AI/NLP | ข้อมูลโครงสร้างสำหรับองค์กร | ⚠️ พื้นฐานถึงปานกลาง | ✅ | ✅ ใช้ NLP | ✅ 10K เครดิต/เดือน | $299/เดือน | JSON, CSV, API |
| Firecrawl | API สำหรับนักพัฒนา (AI) | pipeline สำหรับ LLM/RAG | ✅ มีในตัว | ✅ | ✅ Markdown + structured | ✅ 1,000 เครดิต/เดือน | $19/เดือน | Markdown, JSON, HTML, API |
| Browse AI | มอนิเตอร์แบบไม่ต้องเขียนโค้ด | ตรวจจับการเปลี่ยนแปลง, ผู้ใช้ non-dev | ⚠️ พื้นฐาน | ✅ | ⚠️ แบบ template | ✅ 50 เครดิต/เดือน | $48/เดือน | CSV, JSON, Sheets, Airtable, API |
| ScrapeHero | บริการจัดการ/เอเจนซี่ | องค์กรที่ไม่อยากลงมือเอง | ✅ จัดการให้ทั้งหมด | ✅ | N/A | ❌ | เริ่ม $199/เดือน | ส่งมอบแบบกำหนดเอง |
แพตเทิร์นค่อนข้างชัด
Thunderbit, Browse AI และ Octoparse เน้นความเร็วในการตั้งค่า ScrapingBee, ScraperAPI และ ZenRows เน้นการควบคุมสำหรับนักพัฒนา Bright Data, Oxylabs และ Apify เน้นสเกลและโครงสร้างพื้นฐาน Firecrawl และ Diffbot เน้น output ที่เข้ากับงาน AI ส่วน ScrapeHero เน้นให้คุณไม่ต้องไปปฏิบัติการอะไรเอง
1. Thunderbit
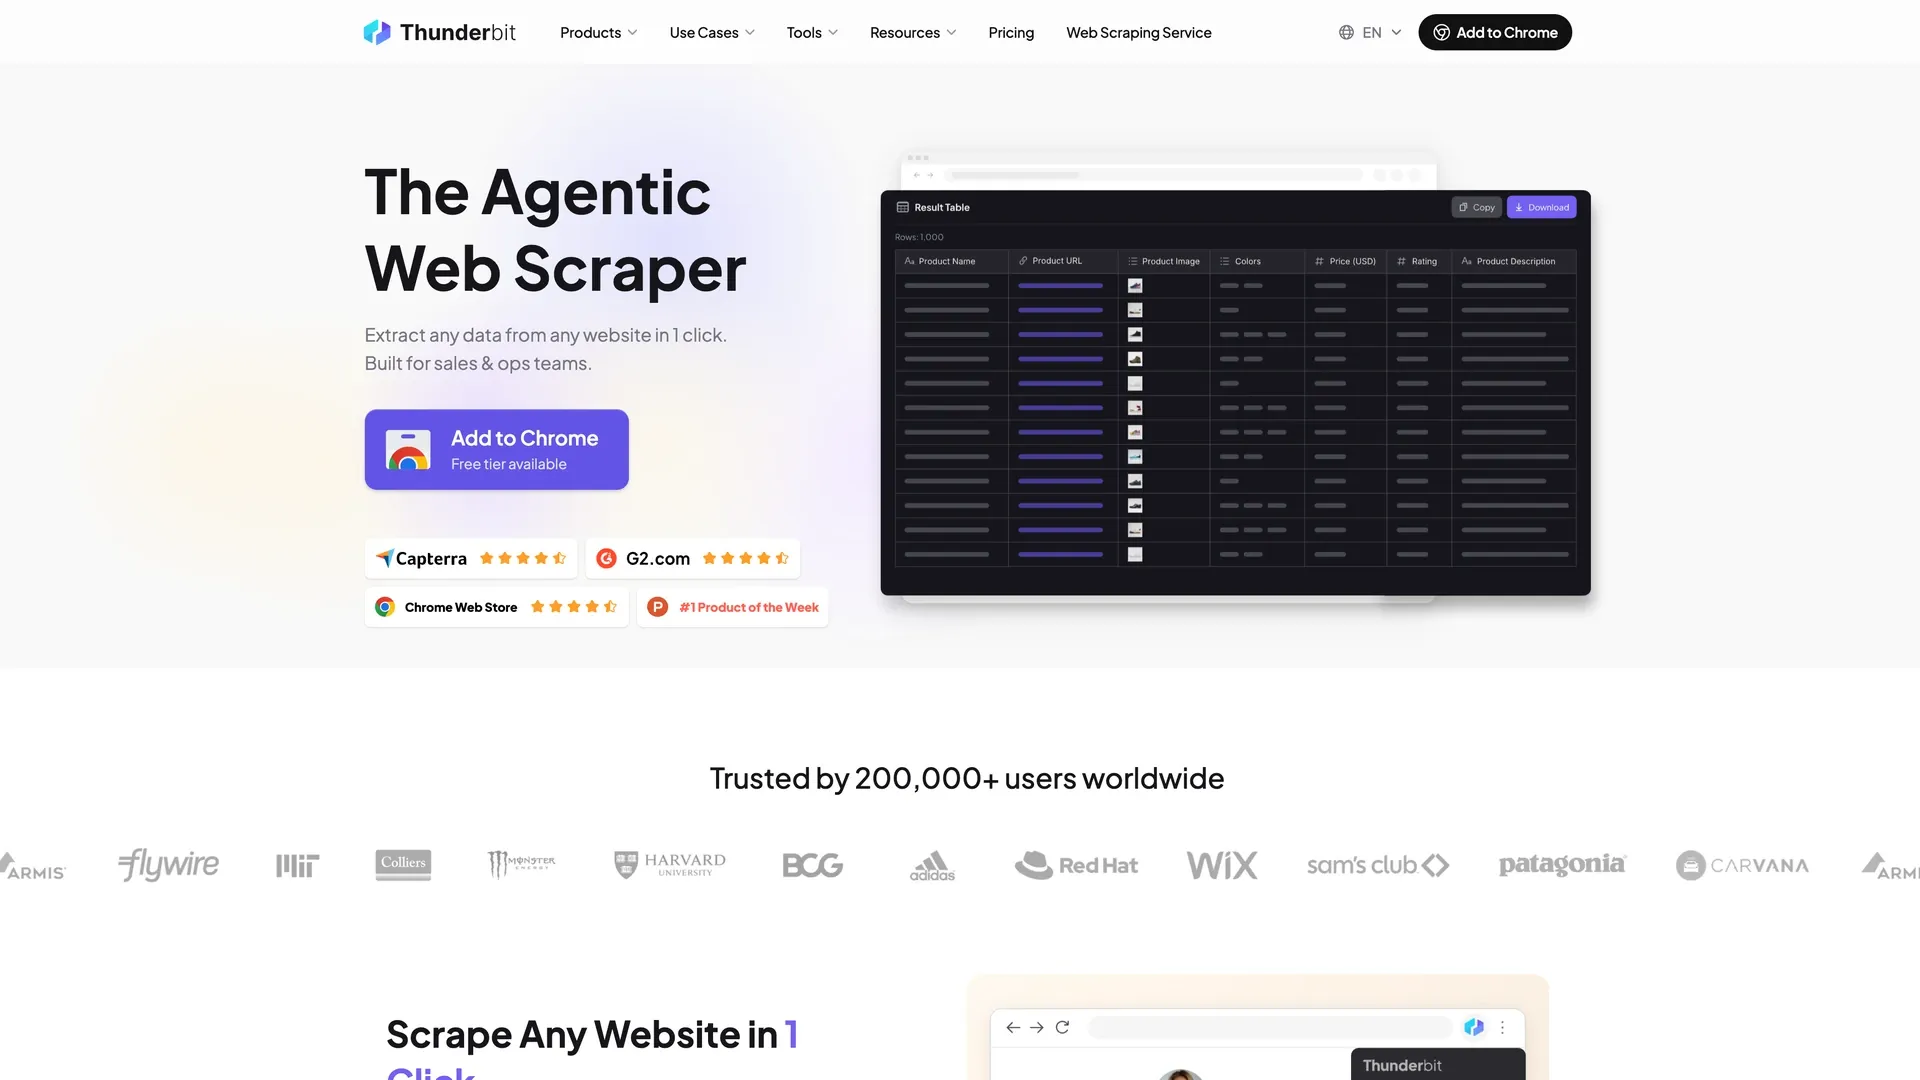 Thunderbit เป็นผลิตภัณฑ์ที่ใช้ได้ง่ายที่สุดในลิสต์นี้สำหรับคนที่ไม่ถนัดเทคนิค แต่ต้องการไปจากหน้าเว็บสู่สเปรดชีตโดยไม่ต้องแตะ selector เลยแม้แต่ตัวเดียว โฟลว์หลักตรงมาก: เปิดส่วนขยาย Chrome บนหน้าใดก็ได้แล้วคลิกครั้งเดียว — AI จะเดาว่าควรดึง field ไหนบ้างและรันงานให้เอง และถ้าคุณอยากได้แบบเฉพาะเจาะจง ก็แค่พิมพ์บอกเป็นภาษาอังกฤษธรรมดา แค่นั้นจริง ๆ สำหรับหน้าส่วนใหญ่ ไม่มี CSS selectors ไม่มี XPath ไม่ต้อง inspect element
สิ่งที่ทำให้ Thunderbit ต่างออกไปคือมันไม่ได้แค่ดึง field แต่ยังติด label, แปล, สรุป, จัดหมวดหมู่ และจัดรูปข้อมูลระหว่างสแครปได้ด้วย Field AI Prompts ซึ่งสำคัญมาก เพราะคอขวดจริงของผู้ใช้ธุรกิจมักไม่ใช่การดึงข้อมูล แต่คือการทำความสะอาดข้อมูลหลัง export ด้วย Thunderbit คุณสแครปหน้าสินค้าภาษาฝรั่งเศสแล้วรับผลลัพธ์เป็นภาษาอังกฤษพร้อม label ด้าน sentiment ได้ในรอบเดียว
ฟีเจอร์เด่น:
- ตั้งค่าแบบไม่ต้องใช้ selector — คลิกครั้งเดียว AI เลือกคอลัมน์ให้ หรือคุณบอกสิ่งที่ต้องการได้เลย
- Browser mode สำหรับหน้าที่ต้องล็อกอิน และ cloud mode (ครั้งละ 50 หน้า) สำหรับสแครปหน้า public แบบเร็ว ๆ
- สแครป subpage เพื่อเติมข้อมูลจากหน้ารายละเอียดเข้ากับหน้ารายการอัตโนมัติ
- รองรับ pagination และ infinite scroll ในตัว
- ตั้งเวลาภาษาแบบธรรมชาติ สำหรับมอนิเตอร์ซ้ำ ๆ เช่น “ทุกวันจันทร์ 9 โมงเช้า”
- template สแครปสำเร็จรูป สำหรับเว็บยอดนิยมอย่าง Amazon, Zillow, Google Maps และ Indeed
- Open API ที่มี
DistillและExtractสำหรับงานฝั่ง developer - รองรับ 34 ภาษา รวมถึงการแปลระหว่างดึงข้อมูล
เรื่องการส่งออกข้อมูลคือข้อได้เปรียบชัดที่สุดของ Thunderbit มันส่งออกไป Excel, CSV, JSON, Google Sheets, Airtable และ Notion ได้ฟรีและเป็น native รวมถึงจัดการรูปภาพใน Airtable และ Notion ได้ด้วย สำหรับทีมขายที่ใช้ Sheets หรือทีมมาร์เก็ตติ้งที่จัดงานวิจัยใน Notion มันตัดขั้นตอนแปลงข้อมูลทิ้งไปได้ทั้งก้อน ซึ่งเครื่องมือฝั่ง API มักจะปล่อยให้คุณทำเอง
ราคา: ใช้ระบบเครดิต มีฟรี 6 หน้า/เดือน และมี trial 7 วันสำหรับฟีเจอร์ Pro แผน browser แบบเสียเงินเริ่มที่ $15/เดือนถ้าจ่ายรายเดือน หรือ $9/เดือนถ้าจ่ายรายปี API มีราคาของตัวเอง: เริ่มด้วย 600 units ฟรี แล้วค่อยเป็น $29/เดือนสำหรับ 6,000 units ใน Starter, $72/เดือนสำหรับ 60,000 ใน Pro 1, $120/เดือนสำหรับ 120,000 ใน Pro 2 และมีสไลเดอร์ที่ไปได้สูงสุด 480,000 units ต่อเดือน ถ้าจ่ายรายปีจะเป็น $16/เดือนสำหรับ 60,000 units ต่อปีใน Starter และ $40/เดือนสำหรับ 600,000 units ใน Pro 1
ข้อดี:
- เริ่มต้นง่ายที่สุดในบรรดาทั้งหมด
- ส่งออกไปสเปรดชีตได้แบบ native ไม่ใช่ JSON แล้วให้คุณไปแปลงเอง
- แปลงข้อมูลด้วย AI ระหว่างสแครป ไม่ใช่หลังสแครปเท่านั้น
- เหมาะกับงาน sales, ecommerce, research และ real estate มาก
ข้อเสีย:
- มีระบบเครดิต 2 แบบคนละหน่วย: ส่วนขยายคิด 1 เครดิตต่อ output row (2 ถ้ามี subpage scraping) ส่วน API คิด 1 unit ต่อ Distill page และ 20 units ต่อ Extract page — ต้องวางงบแยกกัน
- ฟรีแค่ 6 หน้า/เดือน ซึ่งน้อยกว่า API vendors อื่น ๆ มาก (Firecrawl 1,000 เครดิต/เดือน, ZenRows 5,000, Diffbot 10,000)
- Self-serve ยังไม่ถึงระดับองค์กรแบบหนัก ๆ: แผน browser สูงสุดที่ประกาศไว้คือ Pro ที่ $38/เดือนแบบรายเดือน และเกินกว่านั้นต้องขอราคา Business แบบ custom
เหมาะสุดสำหรับ: สร้างลีดขาย, มอนิเตอร์คู่แข่งใน ecommerce, วิจัยการตลาด, สแครปงานและไดเรกทอรี, รายการอสังหาฯ
2. Bright Data
 Bright Data คือสิ่งที่ผู้ซื้อระดับองค์กรเลือกเมื่ออยากได้ผู้ให้บริการรายเดียวที่รวมพร็อกซี, scraping API, datasets, SERP APIs และยิ่งไปกว่านั้นคือ extraction ที่ช่วยด้วย AI มาด้วย มันไม่ใช่ผลิตภัณฑ์เดี่ยว ๆ แต่เป็นสแตกสำหรับเก็บข้อมูลทั้งชุด
ราคาของ Web Scraper API เปิดเผยสาธารณะ: ฟรี 5,000 records ต่อเดือน, แบบ pay-as-you-go ประมาณ $1.50 ต่อ 1,000 records และแผน scale ที่ $499/เดือน พร้อม 384,000 records รวมอยู่แล้ว และเกินจากนั้นคิด $1.30 ต่อ 1,000 records ที่นี่ record หมายถึง item ที่ดึงออกมา 1 ชิ้น — คือ 1 แถวในตาราง — ไม่ใช่ 1 หน้า Residential proxies เริ่มที่ $4/GB นอกจากนี้ยังมี structured datasets, Scraper Studio, AI scrapers และรองรับ MCP ด้วย
ฟีเจอร์เด่น:
- เครือข่ายพร็อกซีแข็งแกร่งมาก (residential, datacenter, mobile, ISP)
- รองรับ browser rendering และ CAPTCHA solving ในราคา Web Scraper API
- marketplace ของ datasets สำหรับข้อมูลที่เก็บไว้แล้ว
- ท่าทีด้าน compliance สำหรับองค์กร พร้อม Trust Center และการรับรองต่าง ๆ
ราคา: pay-as-you-go เริ่มราว $1.50/1K records; แผน scale เริ่ม $499/เดือน
ข้อดี: สเกลและโครงสร้างพื้นฐานพร็อกซีที่ยากจะเทียบได้ การกำกับดูแลระดับองค์กรครอบคลุม ข้อเสีย: ซับซ้อนกว่าที่ทีมขนาดกลางส่วนใหญ่ต้องการ ราคาจะไหลสูงขึ้นเมื่อรวม API, พร็อกซี และชั้นเสริมต่าง ๆ แพลตฟอร์มยังคงสมมติว่ามีเจ้าของทางเทคนิค แม้จะมี AI features ใหม่ ๆ แล้วก็ตาม
เหมาะสุดสำหรับ: pipeline ระดับ Fortune 500, ทีมข้อมูลที่สแครปหลายล้านหน้า, การสแครปข้ามภูมิภาคที่คุณภาพพร็อกซีสำคัญ, องค์กรที่ต้องการ compliance แบบเป็นทางการ
3. Oxylabs
 Oxylabs คือทางเลือก proxy-and-scraping ระดับองค์กรที่แข็งแรงที่สุดสำหรับทีมที่ให้ความสำคัญกับความเสถียรบนเป้าหมายที่ป้องกันเข้ม มันมีทั้ง residential และ datacenter proxies, Web Scraper API, SERP Scraper API, Web Unblocker และ Headless Browser layer รุ่นใหม่
ราคา เริ่มที่ $49/เดือนสำหรับ Web Scraper API และเรทต่อผลลัพธ์จะขึ้นอยู่ทั้งกับเว็บเป้าหมายและแพ็กเกจที่คุณใช้ บน Micro plan ที่ $49 เว็บไซต์ทั่วไป — คืออะไรก็ตามที่ไม่ใช่ Amazon หรือ Google — จะคิด $1.15 ต่อ 1,000 results ถ้าไม่เรนเดอร์ JS และ $1.35 ถ้าเรนเดอร์ด้วย; เมื่อขึ้นไปที่ Advanced plan $249 ตัวเลขสองตัวนั้นจะเป็น $0.95 และ $1.25 และจะลดลงเรื่อย ๆ ในชั้นที่สูงกว่า Residential proxies เริ่มที่ $6/GB และลดเหลือ $2.50/GB เมื่อใช้ถึง 1TB
ฟีเจอร์เด่น:
- โครงสร้างพื้นฐานพร็อกซีแข็งแรงมาก พร้อม rotation และ session management อัตโนมัติ
- SERP Scraper API ออกแบบมาเพื่อการมอนิเตอร์ search engine โดยเฉพาะ
- โมเดลคิดเงินเฉพาะสิ่งที่สำเร็จในผลิตภัณฑ์หลัก
- มี Trust Center และท่าทีด้าน compliance ชัดเจน
ราคา: เริ่มที่ $49/เดือน; ไม่มีฟรีต่อเนื่อง (มีแต่ trial)
ข้อดี: พร็อกซีเชื่อถือได้ เหมาะมากสำหรับการสแครป SERP และมีความน่าเชื่อถือระดับองค์กรสูง
ข้อเสีย: จำนวนผลลัพธ์บนหน้าโปรไฟล์ของแต่ละแพ็กเกจมักอิง Amazon แบบไม่ใช้ JS — บนเว็บทั่วไป Micro plan $49 จะได้ประมาณ 42,600 results ไม่ใช่ 98,000 เพราะเรทต่อ 1,000 เปลี่ยนทั้งตามเว็บเป้าหมายและระดับแพ็กเกจ ทำให้สองทีมที่สแครปปริมาณเท่ากันอาจได้บิลต่างกันมาก
เหมาะสุดสำหรับ: ทีม SEO, การมอนิเตอร์ SERP ระดับองค์กร, งานสเกลใหญ่ที่พึ่งพร็อกซีหนัก
4. Apify
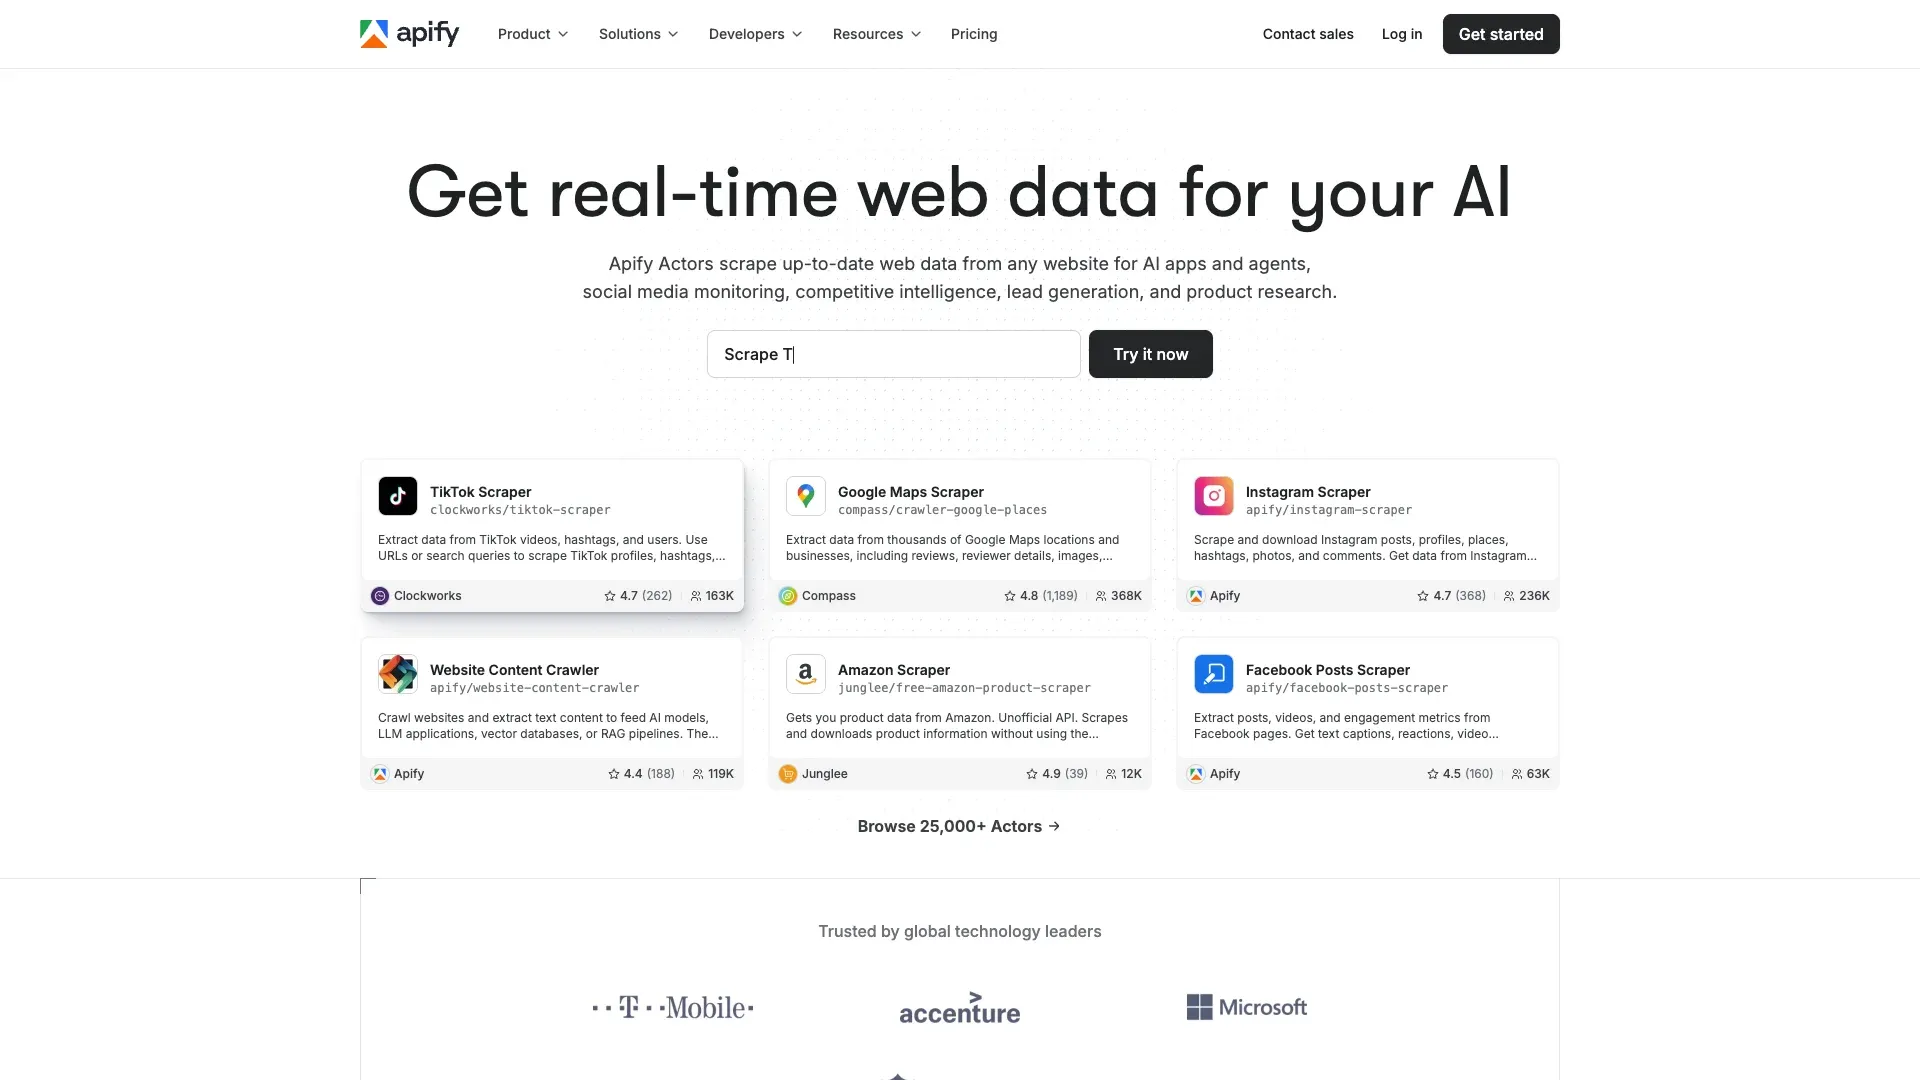 Apify คือแพลตฟอร์มแนว marketplace ที่ยืดหยุ่นที่สุดในลิสต์นี้ มันรวมการรันบนคลาวด์, storage, scheduling, logs, APIs และระบบนิเวศขนาดใหญ่ของ “Actors” ที่สร้างไว้แล้ว — ตอนนี้ Apify Store มีมากกว่า 59,000 Actors แล้ว แทนที่จะสร้าง scraper ทุกตัวเอง คุณมักเริ่มจาก actor ที่มีอยู่แล้วสำหรับ Google Maps, Amazon, Instagram, TikTok หรือเว็บ crawler ทั่วไปได้
ฟีเจอร์เด่น:
- marketplace ของ scraper สำเร็จรูปขนาดใหญ่มาก
- Apify SDK สำหรับพัฒนา actor เอง
- จัดการพร็อกซีและรันบนคลาวด์ในตัว
- API, storage, scheduling และ logs ดีมาก
ราคา คิดตามการใช้งาน: ฟรีพร้อม spend $5, จากนั้น Starter $29/เดือน, Scale $199, Business $999 — ทั้งหมดมีการคิดค่า compute-unit ซ้อนเข้าไปอีก ความยืดหยุ่นนี้มีพลังมาก แต่การคาดการณ์ค่าใช้จ่ายรายเดือนจะยากกว่า API products ที่เรียบง่ายกว่า
ข้อดี: คอมมูนิตี้ใหญ่ มี scraper สำเร็จรูปเยอะ เหมาะทั้งงานเล่นไปจน production และ automation จริงจัง
ข้อเสีย: การปรับแต่งหรือดีบัก actor มีเส้นโค้งการเรียนรู้ ค่า compute-unit + ค่า actor + พร็อกซี ทำให้คาดเดาบิลได้ยากกว่า เหมาะกับคนทำมากกว่าคนที่อยากได้สเปรดชีตตรง ๆ
เหมาะสุดสำหรับ: นักพัฒนาและคนทำ automation, ทีมที่อยาก reuse scrapers เดิม, workflow แบบผสม build-and-buy
5. ScrapingBee
 ScrapingBee เป็นหนึ่งใน scraping API ที่เข้าใจและ integrate ได้ง่ายที่สุด มันเน้น headless Chrome rendering, proxy rotation และความเรียบร้อยของ API มากกว่าจะพยายามเป็นแพลตฟอร์มแบบ visual
ราคา เริ่มที่ $49/เดือนสำหรับ 250,000 credits และ 50 concurrent requests โดย Startup อยู่ที่ $99/เดือนสำหรับ 1,000,000 credits และ 100 concurrent requests ผู้ใช้ใหม่ได้ 1,000 credits ฟรี จุดที่ต้องระวังคือ JS rendering, premium proxies, screenshots และ AI extraction ทั้งหมดกินเครดิตในอัตราตัวคูณที่สูงกว่า
ฟีเจอร์เด่น:
- REST API ที่สะอาดมาก
- มี endpoint เฉพาะสำหรับ Amazon, Google, YouTube, Walmart และ ChatGPT
- ส่งกลับได้ทั้ง HTML, JSON, Markdown หรือ plain text
- เหมาะกับ AI/LLM pipelines เพราะ Markdown ช่วยลดงานเก็บกวาด
ข้อดี: เป็นมิตรกับนักพัฒนา, render JS ได้ดี, ราคาเริ่มต้นโปร่งใส
ข้อเสีย: แผน $49 เป็น 250,000 credits จริง แต่เป็น 250,000 plain requests เท่านั้น — พอใช้ JS rendering, premium proxies, screenshots หรือ AI extraction แต่ละครั้งจะใช้มากกว่า 1 เครดิต ทำให้จำนวนหน้าจริงต่ำกว่าตัวเลขหัวข้อเยอะ concurrency ผูกกับแพ็กเกจ (50 parallel requests บน Freelance) ดังนั้น throughput อาจดันให้คุณต้องขยับชั้นก่อนที่จะถึง volume ที่ตั้งไว้ และยังต้องถือโค้ดเองอยู่ดี
เหมาะสุดสำหรับ: นักพัฒนาที่ฝัง scraping เข้า backend, ทีมที่อยากได้ API ใช้ง่าย, LLM pipelines ที่ต้องการ output แบบ text-first
6. ScraperAPI
 ScraperAPI ยังเป็นหนึ่งในตัวเลือก API แบบมีโครงสร้างที่แข็งแรงสำหรับการมอนิเตอร์อีคอมเมิร์ซและการสแครปปริมาณมากแบบต่อเนื่อง ผลิตภัณฑ์โฟกัสตรงไปตรงมา: endpoint เดียวที่รวมพร็อกซี, retries, JS rendering, geotargeting และ structured output ไว้ในที่เดียว
ราคา เริ่มที่ $49/เดือนสำหรับ 100,000 credits และ 20 threads โดย Startup อยู่ที่ $149/เดือนสำหรับ 1,000,000 credits และ 50 threads มี trial 7 วันพร้อม 5,000 credits โดยไม่ต้องใช้บัตร จุดที่ ScraperAPI น่าสนใจคือชั้น structured: async APIs, webhook delivery, DataPipeline สำหรับโปรเจกต์ low-code และ structured endpoints สำหรับ Amazon, eBay, Google, Redfin และ Walmart
ฟีเจอร์เด่น:
- structured endpoints แข็งแรงสำหรับอีคอมเมิร์ซและ search domain หลัก ๆ
- รองรับ async และ webhook ดี
- เหมาะกับงานมอนิเตอร์ปริมาณสูง
- มี geotargeting และ rendering ให้เลือกหลากหลาย
ข้อดี: trial credits ให้ค่อนข้างเยอะ, เอกสารดี, ใช้งานมอนิเตอร์อีคอมเมิร์ซได้เสถียร
ข้อเสีย: ตัวคูณเครดิต ทำให้การโมเดลต้นทุนยากขึ้น ไม่มี AI extraction จริงสำหรับหน้าเว็บทั่วไป เป็นเครื่องมือสำหรับนักพัฒนาเท่านั้น
เหมาะสุดสำหรับ: มอนิเตอร์ราคาอีคอมเมิร์ซ, competitive intelligence, pipeline สำหรับ search และ marketplace
7. ZenRows
 ZenRows คือผู้เชี่ยวชาญด้าน anti-bot จุดโฟกัสคือการผ่าน Cloudflare, DataDome, Akamai, Imperva และระบบป้องกันลักษณะเดียวกัน โดยยังคงประสบการณ์ใช้งานสำหรับนักพัฒนาแบบทันสมัย
ราคา เริ่มที่ $19/เดือนในแผน Build (45,000 credits, 20 concurrent requests) โดย Build เองก็เป็นสไลเดอร์ — $29 สำหรับ 80,000 credits, $39 สำหรับ 120,000 — และข้างบนมี Launch ที่ $69/เดือนสำหรับ 250,000 credits และ 50 concurrent requests กับ Growth ที่ $199/เดือนสำหรับ 1.2 ล้าน ทั้งหมดเป็นราคาจ่ายรายเดือน ส่วนจ่ายรายปีจะลด 17% โมเดลต้นทุนใช้ตัวคูณ: JS rendering 5x, premium proxies 10x และ ถ้าใช้ทั้งคู่คือ 25x
ฟีเจอร์เด่น:
- โฟกัสเว็บที่ป้องกันหนักได้ยอดเยี่ยม
- เอกสารและ coverage ด้าน anti-bot ครอบคลุม
- ecosystem การ integrate ทันสมัย รวมทั้ง LangChain, LlamaIndex และ MCP
- คิดเงินเฉพาะ request ที่สำเร็จ
ข้อดี: อัตราสำเร็จสูงมากกับ target ยาก ๆ ด้าน anti-bot
ข้อเสีย: ต้นทุนพุ่งเร็วมากเมื่อเจองานที่ป้องกันหนัก หน้าเว็บที่ต้องใช้ทั้ง JS rendering และ premium proxy จะกิน 25 เครดิตแทนที่จะเป็น 1 ทำให้แผน $19 ที่ดูเหมือน 45,000 หน้า กลายเป็นแค่ 1,800 หน้าเมื่อเจอ target ยาก ๆ
เหมาะสุดสำหรับ: นักพัฒนาที่สแครป target ยาก, งานมอนิเตอร์ที่เจอ anti-bot หนัก, ทีมที่สนใจผ่านด่านให้ได้มากกว่าประสบการณ์ใช้งานสเปรดชีต
8. Octoparse
 Octoparse คือเดสก์ท็อป scraper แบบ no-code คลาสสิก: ตัวสร้าง workflow แบบ visual, การรันบนเดสก์ท็อป, scheduling บนคลาวด์, browser navigation ในตัว และการส่งออกข้อมูลที่กว้างมาก ถ้า Thunderbit คือทางเลือก AI-first แบบ “คลิกเดียว” Octoparse ก็คือตัวเลือก visual flow-builder สำหรับคนที่อยากโมเดลตรรกะการดึงข้อมูลทีละขั้น
ราคา ซับซ้อนกว่าที่เห็นในตอนแรก ศูนย์ช่วยเหลือ ระบุราคาแบบจ่ายรายเดือนไว้ว่า Basic $39/เดือน, Standard เริ่ม $83/เดือน และ Professional $299/เดือน แต่หน้าราคา main page ใช้ค่าเริ่มต้นแบบจ่ายรายปี เลยแสดงตัวเลขหัวข้อเป็น Standard $69/เดือน และ Professional $249/เดือน ซึ่งจริง ๆ คือแพ็กเกจเดียวกันคนละเงื่อนไขการจ่าย ไม่ได้เป็นรายการราคาขัดกัน จุดที่ต่างกันจริงคือ Basic ซึ่งหน้า pricing page ไม่ได้แสดงไว้เลย ดังนั้นต้องเช็กให้ชัดว่าราคาที่เห็นอ้างอิงรอบบิลแบบไหนก่อนนำไปเทียบกับเจ้าอื่น หน้า pricing ยังเน้น add-on อย่าง residential proxies, CAPTCHA solving, crawler setup และบริการข้อมูลแบบจัดการเต็มรูปแบบด้วย
ฟีเจอร์เด่น:
- ตัวสร้าง workflow แบบ visual ที่สุกงอมแล้ว
- ส่งออกได้กว้าง: Excel, CSV, JSON, HTML, XML, Google Sheets, ฐานข้อมูล
- มี cloud scheduling และ automation ในตัว
- มี scraper templates สำหรับเว็บที่ใช้บ่อย
ข้อดี: ไม่ต้องเขียนโค้ด, เหมาะกับการสแครปซ้ำระดับกลาง, ตัวเลือกส่งออกหลากหลาย
ข้อเสีย: ต้องดูแลมากกว่าเครื่องมือ AI-native เมื่อ layout เปลี่ยน (เพราะอิง selector) เว็บที่ไดนามิกหรือป้องกันหนักยังทำให้ติดขัดได้ UX แบบ desktop-first อาจรู้สึกหนักกว่าเครื่องมือที่ใช้ผ่านเบราว์เซอร์
เหมาะสุดสำหรับ: ผู้ใช้ no-code ที่อยากได้การควบคุมมากกว่า prompt AI ธรรมดา, การสแครประดับกลางแบบเกิดซ้ำ, ทีมที่ถนัดการทำงานแบบ visual flow
9. Diffbot
 Diffbot คือแพลตฟอร์ม AI extraction ระดับองค์กรที่เข้มที่สุดในลิสต์นี้ แนวคิดของมันไม่ใช่ “สแครปหน้าเว็บนี้” แต่เป็น “เข้าใจประเภทของหน้านี้แล้วแปลงเป็นข้อมูลโครงสร้างในสเกลใหญ่” ผลิตภัณฑ์มี Extract, Crawl, Natural Language และ Knowledge Graph
ราคา เริ่มฟรีด้วย 10,000 credits จากนั้น $299/เดือนสำหรับ Startup (250,000 credits), $899 สำหรับ Plus (1,000,000 credits) และแผน enterprise แบบ custom หน้าเว็บที่ extract ปกติใช้ 1 เครดิต; ส่วน Knowledge Graph record export แพงกว่ามาก
ฟีเจอร์เด่น:
- เข้าใจประเภทหน้าเว็บได้ดีมากโดยอัตโนมัติ (บทความ, สินค้า, บทสนทนา)
- เหมาะมากกับการสร้าง knowledge graph และ entity pipeline
- การดึงข้อมูลใช้ NLP — ไม่ต้องใช้ selector
- ซัพพอร์ตระดับพรีเมียมและวางตัวระดับองค์กร
ข้อดี: เข้าใจโครงสร้างหน้าเว็บด้วย AI ได้ทรงพลัง เหมาะมากกับงาน knowledge graph
ข้อเสีย: แพงสำหรับโปรเจกต์เล็กหรือใช้งานเล่น ๆ DQL และ KG workflow มีเส้นโค้งการเรียนรู้ ใช้แรงเกินไปสำหรับการสแครปลงสเปรดชีตง่าย ๆ
เหมาะสุดสำหรับ: องค์กรที่สร้างชุดข้อมูลโครงสร้าง, โปรเจกต์ knowledge graph และ entity resolution, pipeline ingestion ที่พึ่ง NLP หนัก
10. Firecrawl
 Firecrawl คือเครื่องมือ ingest สำหรับ LLM ที่เป็นมิตรกับนักพัฒนามากที่สุดในกลุ่มนี้ มันแปลง URL ให้กลายเป็น Markdown, HTML, screenshot หรือ structured JSON ที่สะอาด โดยสร้างมาให้ใช้ผ่าน API ที่เรียบง่าย ไม่ใช่แอปแบบ visual
ราคา ชัดเจน: ฟรี 1,000 credits ต่อเดือน, Hobby 5,000 credits, Standard 100,000, Growth 500,000, Scale 1,000,000 และ Enterprise เกินกว่านั้น แผนเริ่มต้นที่ $19/เดือน หรือ $16/เดือนเมื่อจ่ายรายปี
ฟีเจอร์เด่น:
- Markdown output ที่สะอาดมากสำหรับ RAG และ LLM pipeline
- รองรับ structured JSON แบบ schema หรือ prompt
- เอกสารนักพัฒนาดี และมี open-source adoption ที่คึกคัก
- ระดับ browser concurrency ดีมากในแพ็กเกจสูงขึ้น
ข้อดี: ออกแบบมาเพื่อป้อนข้อมูลเข้า LLM โดยตรง ราคาเริ่มต้นเข้าถึงง่าย output สะอาด
ข้อเสีย: สร้างมาเพื่อ developer มี playground และ เครื่องมือฟรีสำหรับหน้าเดียว แต่ไม่ได้รันงานซ้ำที่ตั้งเวลาได้ — อะไรก็ตามที่ต้อง schedule, batch หรือผูกเข้ากับ pipeline ต้องใช้ API call หรือ SDK เครดิตจะหมดอายุเมื่อสิ้นเดือนในทุกแผนที่ต่ำกว่า Scale tier $749 และโครงสร้างแพ็กเกจมีช่องว่างตรงกลาง: slider เครดิตขยับ 5,000, 6,500, 8,000 pages ต่อเดือน แล้วกระโดดไป 100,000 เลย — แผน Standard $99
เหมาะสุดสำหรับ: RAG pipelines, AI agents, การ ingest และวิเคราะห์คอนเทนต์
11. Browse AI
 Browse AI ควรถูกมองว่าเป็นผลิตภัณฑ์มอนิเตอร์ที่แถมการสแครป ไม่ใช่ scraper ที่แถมมอนิเตอร์ การใช้งานที่เหมาะที่สุดคือการตรวจจับการเปลี่ยนแปลงซ้ำ ๆ: ราคา, สต็อก, ข้อความ, screenshot และการเปลี่ยนหน้าเว็บเมื่อเวลาผ่านไป
ราคา เริ่มที่แผนฟรี 50 credits ต่อเดือน จากนั้น Personal ที่ $48/เดือนสำหรับ 2,000 credits และ Professional แบบสไลเดอร์ — $87 สำหรับ 5,000 credits, $162 สำหรับ 10,000, ไปถึง $399 สำหรับ 30,000 — ส่วน Premium เริ่มจาก $500/เดือนเมื่อจ่ายรายปี ถ้าจ่ายรายปี Personal จะเป็น $19/เดือน และ Professional $69 เครดิตถูกใช้ไปตามจำนวนแถวและความซับซ้อนของงาน: หน้าเพจที่เปิดเพื่อข้อมูลของตัวมันเองคือ 1 task และมีขั้นต่ำ 1 เครดิต, 10 แถวก็ยังคิด 1 เครดิต, และเว็บพรีเมียมอาจแพงขึ้น 2–10 เท่า
ฟีเจอร์เด่น:
- เน้น monitoring และ alerting ดีมาก
- เหมาะกับการเช็กราคาหรือสต็อกซ้ำ ๆ
- เชื่อมกับ Sheets, Airtable, webhooks และ workflow ผ่าน API ได้
- ตั้งค่าแรกเริ่มเร็วสำหรับผู้ใช้ที่ไม่ใช่นักพัฒนา
ข้อดี: เหมาะมากกับ use case แบบ “อะไรเปลี่ยนไปบ้าง”, ตั้งค่าง่ายสำหรับ non-dev
ข้อเสีย: ยืดหยุ่นน้อยกว่า scraper ทั่วไปเมื่อเจอเว็บที่ไม่คุ้นหรือซับซ้อน การแปลงข้อมูลด้วย AI ในตัวน้อยกว่า Thunderbit
เหมาะสุดสำหรับ: ทีมอีคอมเมิร์ซที่มอนิเตอร์ราคาคู่แข่ง, ผู้ใช้ที่ไม่ใช่นักพัฒนาซึ่งต้องการแจ้งเตือนการเปลี่ยนแปลง
12. ScrapeHero
 ScrapeHero เป็นตัวที่แปลกจากเพื่อน เพราะมันไม่ใช่เครื่องมือซอฟต์แวร์หลัก ๆ แต่เป็นบริการสแครปแบบ managed service คุณบอกข้อมูลที่ต้องการ แล้วทีมของเขาจะสร้าง, ดูแล, QA และส่งมอบ dataset ให้
ราคา สะท้อนโมเดลบริการ: โปรเจกต์ on-demand เริ่มที่ $550 ต่อเว็บ, แผน Business รายเดือนเริ่มที่ $199 สำหรับสูงสุด 2 เว็บ โดยแต่ละเว็บได้ 1–5K pages, Enterprise Basic เริ่มที่ $1,500/เดือน สำหรับสูงสุด 4 เว็บ โดยรวมจำนวนหน้าเข้าด้วยกันและคิดเพิ่ม $650–$2,200 ต่อหนึ่งล้านหน้า, และ Enterprise Premium เริ่มที่ $8,000 ค่าตั้งค่าจะคิดแยกเป็น one-time fee สำหรับ Business และ Enterprise Basic ขั้นตอนการ ส่งมอบ มีทีมโปรเจกต์เฉพาะ, human QA และรูปแบบส่งมอบที่ปรับได้
ฟีเจอร์เด่น:
- แทบไม่ต้องดูแลเองเลยสำหรับลูกค้า
- มี human QA และรูปแบบส่งมอบแบบ custom
- เหมาะกับโปรเจกต์หลายเว็บที่ซับซ้อน
- ท่าทีด้าน compliance รองรับความต้องการระดับองค์กร
ข้อดี: ไม่ต้องดูแลเลย, รับมือโปรเจกต์ซับซ้อนได้ดี, บริการแบบ white-glove
ข้อเสีย: แพงเมื่อเทียบกับเครื่องมือ self-serve, ใช้เวลารอบแรกนานกว่าทำเอง, ไม่ใช่ self-serve เลย
เหมาะสุดสำหรับ: องค์กรที่เอาการสแครปออกไป outsource, ทีมที่สนใจผลลัพธ์มากกว่าการครอบครองเครื่องมือ, โปรเจกต์หลายเว็บที่มีการเปลี่ยนแปลงบ่อย
ต้นทุนจริงของบริการเว็บสแครปปิ้งที่ 10K, 100K และ 1M หน้า
การเทียบราคาของบริการเหล่านี้ค่อนข้างชวนงง เพราะแต่ละเจ้าคิดเงินคนละหน่วย — บ้างคิดเป็นหน้า, บ้างเป็น record, เครดิต, เวลาคอมพิวต์, แถว หรือขั้นต่ำต่อโปรเจกต์ ดังนั้นตารางด้านล่างจึงรายงานตัวเลขเดียวที่แปลงความหมายได้: บัตรของคุณจะถูกตัดเงินจริงเดือนนั้นเท่าไร ตัวเลขทั้งหมดเป็นราคาปกติรายเดือนของแพ็กเกจที่ถูกที่สุดที่รองรับปริมาณดังกล่าวในรูปแบบ plain pages — ไม่มี JavaScript rendering, ไม่มี premium proxies — โดยหัก allowance ฟรีรายเดือนของผู้ให้บริการออกแล้วเรียบร้อย ค่า proxy, add-on สำหรับ CAPTCHA และเวลาวิศวกรรมจะไม่ถูกรวมไว้ในตัวเลขนั้น และจะระบุไว้ในคอลัมน์สุดท้าย ถ้าไม่มีแพ็กเกจใดของผู้ให้บริการนั้นแตะปริมาณนั้นได้ ก็จะขึ้นว่า Custom quote แทนการฝืนยืดแพ็กเกจสูงสุดให้พอดี และถ้าผู้ให้บริการไม่ได้ขายเป็นรายหน้า ตารางจะบอกสิ่งที่เขาขายจริงแทนการเดาราคาต่อหน้า
| บริการ | ฟรี | บิลรายเดือนที่ 10K หน้า | บิลรายเดือนที่ 100K หน้า | บิลรายเดือนที่ 1M หน้า | วิธีคิดเงิน และสิ่งที่ตัวเลขนี้ยังไม่รวม |
|---|---|---|---|---|---|
| Thunderbit API | 600 units, ครั้งเดียว | $72 Pro 1 | $120 Pro 2 | Custom quote | Distill คิด 1 unit ต่อหน้า, Extract คิด 20. เครดิตฟรีเป็นของแถมครั้งเดียว ไม่ใช่ allowance รายเดือน ดังนั้นจึงไม่ต้องหักออก Self-serve หยุดที่ 480,000 units/เดือน |
| Bright Data | 5,000 records/เดือน | $7.50 สำหรับ 10K records | $142.50 สำหรับ 100K records | $1,293 สำหรับ 1M records | คิดต่อ record — คือ item ที่ดึงออกมา 1 ชิ้น หรือ 1 แถวในตาราง — ไม่ใช่ต่อหน้า ดังนั้นหน้า list หนึ่งหน้าอาจกินหลาย records ฟรี 5,000 records ถูกหักออกในทุกกรณี ที่ 1M แผน Scale คุ้มกว่า pay-as-you-go: $499 บวก records เพิ่มอีก 611,000 ที่ $1.30/1K |
| Oxylabs | Trial, 2K results | $49 Micro | $249 Advanced | $999 Business | คิดต่อผลลัพธ์ที่สำเร็จในอัตราที่กำหนดตามเว็บเป้าหมายและระดับแพ็กเกจ ตัวเลขหัวข้ออิง Amazon แบบไม่ใช้ JS — บนเว็บทั่วไปที่ $1.15 ต่อ 1,000 results แผน $49 Micro จะได้ประมาณ 42,600 results ไม่ใช่ 98,000 ผล trial ไม่ต่ออายุ จึงไม่มีอะไรต้องหัก |
| Apify | ใช้ได้ $5/เดือน | เริ่ม $29/เดือน + usage | เริ่ม $29/เดือน + usage | เริ่ม $29/เดือน + usage | ไม่ได้คิดตามหน้า แพ็กเกจคือเครดิตใช้งานแบบ prepaid — $29 Starter, $199 Scale, $999 Business — เอาไปใช้กับ compute units และ Store Actors ที่ตั้งราคาต่อผลลัพธ์เอง ดังนั้นนับหน้าล้วน ๆ ไม่ทำให้บิลคงที่ พร็อกซีเป็น add-on แยก |
| ScrapingBee | 1,000 credits, ครั้งเดียว | $49 Freelance | $49 Freelance | $99 Startup | 1 เครดิตต่อ plain request แต่ JS rendering, premium proxies, screenshots และ AI extraction ใช้มากกว่า 1 เครดิตต่อ call ในงานจริง เครดิตสมัครใหม่ไม่ต่ออายุ จึงไม่มีอะไรต้องหัก |
| ScraperAPI | trial 7 วัน, 5,000 credits | $49 Hobby | $49 Hobby | $149 Startup | 1 เครดิตต่อ plain request แต่ Amazon ใช้ 5 และ Google ใช้ 25 ที่ 100K pages แผน Hobby เต็มพอดี ไม่มีเหลือสำหรับ retry เครดิต trial ไม่ต่ออายุ จึงไม่มีอะไรต้องหัก |
| ZenRows | 5,000 credits/เดือน | $19 Build | $39 Build | $199 Growth | 1 เครดิตต่อหน้าแบบ plain แต่ถ้าต้องใช้ JS + premium proxy จะเป็น 25 เครดิต ฟรี 5,000 เครดิตถูกหักก่อน — เหลือ 5,000, 95,000 และ 995,000 chargeable pages — ซึ่งไม่เปลี่ยนว่าคุณจะตกที่ขั้นไหน |
| Octoparse | ฟรี 10 tasks | เริ่ม $39/เดือน | เริ่ม $39/เดือน | เริ่ม $39/เดือน | คิดจากจำนวน task และ cloud concurrency ไม่ได้คิดตามหน้า ดังนั้นจำนวนหน้าไม่แมปกับ tier โดยตรง: Basic $39, Standard $83, Professional $299 แบบรายเดือน residential proxies และ CAPTCHA solving ขายเป็น add-on: $3/GB และ $1–1.5 ต่อหนึ่งพัน solves |
| Diffbot | 10,000 credits/เดือน | $0, ฟรีครอบคลุม | $299 Startup | $899 Plus | 1 เครดิตต่อหน้าที่ extract ฟรี 10,000 เครดิต/เดือนถูกหักแบบเดียวกับทุกกรณี: ที่ 10K ครอบคลุมทั้งเดือน, ที่ 100K เหลือ 90,000 หน้าให้ซื้อ, ที่ 1M เหลือ 990,000 |
| Firecrawl | 1,000 credits/เดือน | $99 Standard | $99 Standard | $749 Scale | 1 เครดิตต่อหน้าที่สแครป ฟรีเครดิตถูกหักแล้วจะเหลือ 9,000 หน้าให้ซื้อที่ระดับ 10K ซึ่งยังเกิน Hobby ที่ 5,000 ทำให้ tier ไม่ขยับ เครดิตไม่ rollover ในแผนต่ำกว่า Scale |
| Browse AI | 50 credits/เดือน | $162 Professional | Custom quote | Custom quote | คิดเป็น credits: หน้า detail เป็น 1 task ขั้นต่ำ 1 เครดิต และ 10 แถวก็ยังคิด 1 เครดิต ดังนั้นหน้า list 50 แถวใช้ 5 เครดิต เว็บพรีเมียมแพงขึ้น 2–10 เท่า Self-serve หยุดที่ 30,000 credits/เดือน ดังนั้นเกินจากนั้นจะต้องขอใบเสนอราคา |
| ScrapeHero | ไม่มี | เริ่ม $199/เดือน | เริ่ม $1,500/เดือน | เริ่ม $1,500/เดือน | คิดเป็นราคาต่อเว็บ ตามความซับซ้อนและความถี่การรีเฟรช ไม่ใช่ต่อหน้า: Business ครอบคลุมสูงสุด 2 เว็บที่ 1–5K pages ต่อเว็บ, Enterprise Basic รวมหน้าข้ามได้สูงสุด 4 เว็บและบวก $650–$2,200 ต่อหนึ่งล้านหน้าเพิ่มเติม ค่าตั้งค่าคิดครั้งเดียวแยกต่างหาก |
มีข้อควรจำสำคัญบางอย่าง:
- ผลิตภัณฑ์แบบ browser ของ Thunderbit คิดตาม row และเป็นฝั่งผู้ใช้ ดังนั้นแถวด้านบนจึงอ้างอิง API — และเฉพาะ endpoint Distill ซึ่งคิด 1 unit ต่อหน้า Markdown เพราะมันเทียบกับ API เจ้าอื่นได้ตรงที่สุด ส่วน Structured Extract คิด 20 units ต่อหน้า ซึ่งจะทำให้ 10K หน้าเป็น $240 แทนที่จะเป็น $72
- ต้นทุนของ Apify ขึ้นกับ runtime ของ actor, memory และบริการเสริมอย่างพร็อกซีอย่างมาก
- ZenRows, ScrapingBee และ ScraperAPI ดูเหมือนถูกบนหน้า public แบบพื้นฐาน แต่จะพุ่งแพงขึ้นเร็วเมื่อเริ่มใช้ JS rendering, premium proxies หรือ target ที่ anti-bot หนัก
- หน่วยเศรษฐศาสตร์ของ ScrapeHero ต่างออกไป เพราะคุณจ่ายให้กับวิศวกรรม, QA และการจัดการโปรเจกต์ ไม่ได้จ่ายแค่ compute
ต้นทุนแฝงที่หน้า pricing ส่วนใหญ่มักพูดเบาคือการดูแลรักษา ค่า proxy อย่างเดียวดูเหมือนถูกบนกระดาษ แต่พอรวม retry, การดูแล parser, session ที่ถูกบล็อก และชั่วโมงของวิศวกร บริการสแครปแบบ bundled มักชนะในต้นทุนรวมการเป็นเจ้าของ
ถ้าคุณสแครปเป็นครั้งคราว ฝั่ง no-code จะเริ่มต้นถูกกว่า: แผนฟรีของ Thunderbit ให้ 6 หน้า/เดือน และแผน browser แบบเสียเงินเริ่มที่ $15/เดือน หรือประมาณ $9/เดือนเมื่อจ่ายรายปี ส่วน API services ที่นี่ก็ไม่ได้แพงกว่าเสมอไป — ZenRows และ Firecrawl ก็เริ่มที่ $19/เดือน — แต่แพ็กเกจขั้นต่ำที่เขาขายมักเป็นระดับหลายพันหน้าต่อเดือน คุณจึงจ่ายเพื่อ capacity ที่ยังไม่ใช้ สำหรับ pipeline ระดับองค์กรที่ 1M+ หน้า แพลตฟอร์ม full-stack หรือบริการจัดการเต็มรูปแบบมักคุ้มกว่าด้านเศรษฐศาสตร์ แม้ราคาหน้าป้ายจะสูงกว่า เพราะมันรวมต้นทุนพร็อกซีไว้แล้ว
ข้อมูลที่สแครปมาไปอยู่ที่ไหน? เทียบการส่งออกและการเชื่อมต่อ
JSON ไม่ใช่ Google Sheets และสำหรับคนที่ไม่ใช่นักพัฒนา ปลายทางของข้อมูลที่สแครปมาได้สำคัญพอ ๆ กับการดึงข้อมูลเอง
| บริการ | CSV | JSON | Excel | Google Sheets | Airtable | Notion | CRM/API/Webhook |
|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ Native | ✅ Native | ✅ Native | มี API |
| Bright Data | ✅ | ✅ | ❌ ไม่มี native | ทางอ้อม | ทางอ้อม | ทางอ้อม | API/webhook แข็งแรง |
| Oxylabs | ✅ | ✅ | ❌ ไม่มี native | ทางอ้อม | ทางอ้อม | ทางอ้อม | API แข็งแรง |
| Apify | ✅ | ✅ | ✅ | ผ่าน integration | ผ่าน integration | ผ่าน integration | API แข็งแรง |
| ScrapingBee | ผ่านเครื่องมืออื่น | ✅ | ❌ | ❌ | ❌ | ❌ | API แข็งแรง |
| ScraperAPI | ✅ บน structured endpoints | ✅ | ❌ | ❌ | ❌ | ❌ | API/webhook แข็งแรง |
| ZenRows | จำกัด | ✅ | ❌ | ❌ | ❌ | ❌ | API แข็งแรง |
| Octoparse | ✅ | ✅ | ✅ | ✅ Native | ⚠️ ผ่าน Zapier | ❌ | API, DB, Zapier |
| Diffbot | ✅ | ✅ | ❌ | รองรับผ่าน workflow | ทางอ้อม | ทางอ้อม | API |
| Firecrawl | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | API |
| Browse AI | ✅ | ✅ | ❌ | ✅ Native | ✅ Native | ❌ | API, webhook, Zapier/Make |
| ScrapeHero | ✅ | ✅ | ✅ | ส่งมอบแบบ custom | ส่งมอบแบบ custom | ส่งมอบแบบ custom | ส่งมอบผ่าน API/DB แบบ custom |
นี่คือข้อได้เปรียบที่ชัดมากของ Thunderbit ถ้าคุณเป็นทีมธุรกิจที่ใช้ Google Sheets หรือ Notion เป็นหลัก บริการฝั่ง API อย่างเดียวจะเพิ่มขั้นตอนพิเศษเข้าไป: ต้องเขียนโค้ดแปลง JSON อัปโหลดเอง แล้วทำซ้ำอีก Thunderbit ส่งออกไป Sheets, Airtable และ Notion ได้ฟรีแบบ native — รวมถึงอัปโหลดรูปภาพเข้า Notion และ Airtable — ทำให้ความฝืดนี้หายไปเกือบหมด พอจับคู่กับ scheduled scraping ข้อมูลก็ไหลไปยังปลายทางที่กำหนดได้เองตามรอบ โดยไม่ต้องเขียน glue code
จะเกิดอะไรขึ้นเมื่อเว็บเปลี่ยน? การดูแลและความเสถียร
สแครปเปอร์พังได้ นี่คือ pain point อันดับหนึ่งของตลาดนี้
ตลาดแบ่งออกเป็นสามโปรไฟล์ด้านการดูแล:
- เครื่องมือที่อิง selector (Octoparse, Apify actors จำนวนมาก, Browse AI templates): พังเมื่อเว็บเปลี่ยน layout และต้องอัปเดตกฎด้วยมือ
- บริการ API ที่มี parser abstraction (ScraperAPI structured endpoints, Bright Data structured datasets): รับมือเว็บหลัก ๆ ได้ดี แต่จะติดกับ long-tail หรือหน้าเฉพาะทางที่ parser ยังไม่ได้สร้างไว้
- เครื่องมือ AI-powered (Thunderbit, Firecrawl, Diffbot): อ่านหน้าใหม่ทุกครั้งที่รัน ดังนั้นการเปลี่ยน layout ส่วนใหญ่ไม่ต้องแก้ rule ใหม่ โมเดลความล้มเหลวเปลี่ยนจาก “selector พัง” เป็น “AI ตีความผิด” ซึ่งโดยมากแก้ด้วยการปรับ prompt ง่ายกว่าการเขียน selector ใหม่ทั้งชุด
ยังมีคอขวดอีกชั้นที่นอกเหนือจาก layout drift: การรับมือ anti-bot
- Bright Data, Oxylabs และ ZenRows แข็งแรงที่สุดในด้านนี้
- ScraperAPI และ ScrapingBee ทำได้ดีสำหรับ target ที่มีการป้องกันระดับ mainstream
- Browse AI และ Octoparse มักมีปัญหามากขึ้นกับเว็บไดนามิกที่ป้องกันหนัก
- Browser mode ของ Thunderbit ช่วยกับหน้าแบบล็อกอินและเพอร์โซนัลไลซ์ ซึ่งเครื่องมือ API-only มักทำให้ซับซ้อนขึ้น
สรุปคือ ถ้าคุณต้องการภาระดูแลต่ำที่สุด การดึงข้อมูลด้วย AI (Thunderbit, Firecrawl, Diffbot) รับมือ layout drift ได้ดีกว่าเครื่องมือแบบ selector-based ถ้าความเสถียรของคุณขึ้นอยู่กับการผ่าน anti-bot เป็นหลัก Bright Data, Oxylabs และ ZenRows คือทางเลือกที่แข็งแรงที่สุด ทีมส่วนใหญ่เจอทั้งสองปัญหา จึงเป็นเหตุผลว่าทำไมคำถาม “ประเภทไหนเหมาะกับทีมคุณ” ด้านบนถึงสำคัญกว่าการเทียบฟีเจอร์ทีละข้อ
ข้อควรพิจารณาด้านกฎหมายและจริยธรรมของเว็บสแครปปิ้ง
การสแครปข้อมูลที่เปิดเผยต่อสาธารณะมักทำได้ตามกฎหมาย แต่ไม่ได้หมายความว่าทุกกรณีใช้งานจะปลอดภัย ทีมยังควรเคารพ robots.txt เมื่อเหมาะสม ตรวจข้อกำหนดการใช้งาน และปฏิบัติตามกฎหมายความเป็นส่วนตัวอย่าง GDPR และ CCPA เมื่อเกี่ยวข้องกับข้อมูลส่วนบุคคล คดีในแนว hiQ v. LinkedIn สนับสนุนแนวคิดว่าการสแครปข้อมูลสาธารณะไม่ได้ผิด CFAA โดยอัตโนมัติในสหรัฐฯ แต่ประเด็นสัญญา ลิขสิทธิ์ และความเป็นส่วนตัวยังเป็นความเสี่ยงแยกต่างหาก ผู้ให้บริการระดับองค์กรอย่าง Bright Data, Oxylabs และ ScrapeHero ชอบสื่อสารเรื่อง compliance และ governance อย่างชัดเจน ส่วนคนอื่น ๆ ควรขอคำปรึกษากฎหมายเฉพาะกรณีก่อนจะสแครปในสเกลใหญ่ ดูพื้นหลังเพิ่มเติมได้ที่คู่มือของเราว่าด้วย ผลกระทบทางกฎหมายของเว็บสแครปปิ้ง
แล้วคุณควรเลือกบริการเว็บสแครปปิ้งตัวไหนจริง ๆ?
พอแล้วกับตารางเปรียบเทียบ สรุปสั้น ๆ หลังจากทดสอบครบทั้ง 12 เจ้าได้แบบนี้:
ทีมธุรกิจที่ไม่ถนัดเทคนิค (sales, ops, marketing): Thunderbit สแครปด้วย AI แบบคลิกเดียว ส่งออกไป Sheets/Airtable/Notion ฟรี และลดงานแก้ซ้ำเมื่อเว็บเปลี่ยน layout ได้มากที่สุด มันตัดแรงเสียดทานสองตัวหลัก — ความยุ่งยากในการตั้งค่าและความฝืดหลังสแครป — ไปพร้อมกัน
นักพัฒนาที่กำลังสร้าง scraping pipeline:
- ScrapingBee ถ้าอยากได้ API UX ที่สะอาดที่สุด
- ScraperAPI ถ้าอยากได้ structured endpoints และมอนิเตอร์อีคอมเมิร์ซแบบต่อเนื่อง
- ZenRows ถ้าปัญหาจริงของคุณคือ anti-bot
ทีมที่ป้อนข้อมูลเข้า AI/LLM workflows:
- Firecrawl ถ้าผลลัพธ์ต้องเป็น Markdown หรือ JSON แบบอิง schema
- Thunderbit API ถ้าทีมเดียวกันยังต้องการทางเลือก no-code เพราะส่วนขยายและ API ใช้โมเดล extraction เดียวกัน
- Diffbot ถ้าคุณกำลังสร้าง knowledge layer ระดับองค์กร
องค์กรที่ต้องการสเกลมหาศาล + พร็อกซีอินฟราสตรักเจอร์:
- Bright Data สำหรับสแตกองค์กรที่กว้างที่สุด
- Oxylabs ถ้าความเสถียรบน target ที่ป้องกันหนักคือสิ่งสำคัญสุด
ทีมที่อยากได้ marketplace ของ scraper สำเร็จรูป: Apify
บริษัทที่อยากได้ผลลัพธ์แบบไม่ต้องลงมือเอง: ScrapeHero
ทีมที่คุมงบและต้องการมอนิเตอร์แบบ no-code: Browse AI
ผู้ใช้ no-code ที่อยากได้ visual desktop builder พร้อมการควบคุมแบบ manual มากขึ้น: Octoparse
สำหรับผู้ใช้ธุรกิจวงกว้างที่สุด Thunderbit ยังเป็นตัวที่ชนะ เพราะมันตัดกำแพงสองด่านที่ทำให้คนเลิกใช้: การตั้งค่าที่ยุ่งยากและแรงเสียดทานตอน export ลองเริ่มจาก ฟรีเทียร์ หรือโหลด Chrome extension ไปลองเองได้เลย และถ้า Thunderbit ยังไม่ใช่คำตอบ ลองเจ้าต่าง ๆ ในลิสต์นี้ดู — ตอนนี้ไม่เคยมีช่วงเวลาไหนที่เหมาะจะเลิกคัดลอกวางเองด้วยมือไปมากกว่านี้แล้ว สำหรับวิดีโอสาธิตวิธีใช้งานจริง ดูได้ที่ Thunderbit YouTube channel
ลองใช้ Thunderbit Chrome extension
คำถามที่พบบ่อย
บริการเว็บสแครปปิ้งคืออะไร?
บริการเว็บสแครปปิ้งคือเครื่องมือหรือผู้ให้บริการแบบ managed ที่ช่วยเก็บข้อมูลจากเว็บไซต์แทนคุณ บางตัวเป็นแอป no-code ที่รันผ่านเบราว์เซอร์ บางตัวเป็น API สำหรับนักพัฒนา และบางตัวเป็นเอเจนซี่ที่จัดการครบวงจรและส่งมอบข้อมูลที่ทำความสะอาดแล้วโดยไม่ต้องให้คุณดูแลโครงสร้างพื้นฐานเอง
จำเป็นต้องเขียนโค้ดเพื่อใช้บริการเว็บสแครปปิ้งไหม?
ไม่จำเป็นเสมอไป Thunderbit, Browse AI และ Octoparse ออกแบบมาสำหรับผู้ใช้ที่ไม่ใช่นักพัฒนา ส่วน API services อย่าง ScrapingBee, ScraperAPI, Firecrawl และ ZenRows จะคาดหวังให้นักพัฒนาช่วยใช้งาน ส่วน ScrapeHero อยู่ฝั่งตรงข้าม — ทีมของเขาดูแลโปรเจกต์ทั้งหมดแทนคุณ
บริการเว็บสแครปปิ้งที่ดีที่สุดสำหรับธุรกิจขนาดเล็กคือเจ้าไหน?
สำหรับธุรกิจขนาดเล็กส่วนใหญ่ Thunderbit คือคำแนะนำที่ปลอดภัยที่สุด เพราะมีแผนฟรีที่ไม่หมดอายุ (6 หน้า/เดือน), ตั้งค่าง่าย และส่งออกตรงไปยังปลายทางที่เป็นมิตรกับธุรกิจอย่าง Google Sheets, Airtable และ Notion ได้เลย Browse AI ก็เหมาะเช่นกันถ้า use case หลักคือการมอนิเตอร์การเปลี่ยนแปลงตามเวลา
บริการเว็บสแครปปิ้งมีค่าใช้จ่ายเท่าไร?
ช่วงราคากว้างมาก บางบริการมีฟรีเทียร์หรือ trial API สำหรับนักพัฒนาในลิสต์นี้เริ่มประมาณ $19 ถึง $49 ต่อเดือน ส่วนแพลตฟอร์ม AI ระดับองค์กรสูงกว่านั้นมาก — Diffbot เริ่มที่ $299 เครื่องมือ no-code เริ่มราว $15 ถึง $48 ต่อเดือน ส่วนบริการระดับองค์กรและ managed service อาจพุ่งไปหลายร้อยหรือหลายพันดอลลาร์ต่อเดือน ต้นทุนที่ใหญ่กว่าค่ารายเดือนคือ multiplier สำหรับ JS rendering, premium proxies และเวลาภายในองค์กรที่ต้องใช้คอยให้สแครปเปอร์ทำงานต่อไปได้
ใช้บริการเว็บสแครปปิ้งถูกกฎหมายไหม?
โดยมากใช่สำหรับข้อมูลสาธารณะ แต่ความถูกต้องตามกฎหมายขึ้นอยู่กับเว็บ, ประเภทข้อมูล, เขตอำนาจศาล และสิ่งที่คุณทำกับผลลัพธ์ด้วย ประเด็นเรื่องความเป็นส่วนตัว ลิขสิทธิ์ และสัญญายังคงมีผล แม้จะสแครปจากหน้า public ก็ตาม ควรขอคำแนะนำทางกฎหมายสำหรับ use case ของคุณโดยเฉพาะ
ลอง Thunderbit สำหรับ AI web scraping Get Started Free
อ่านเพิ่มเติม



