
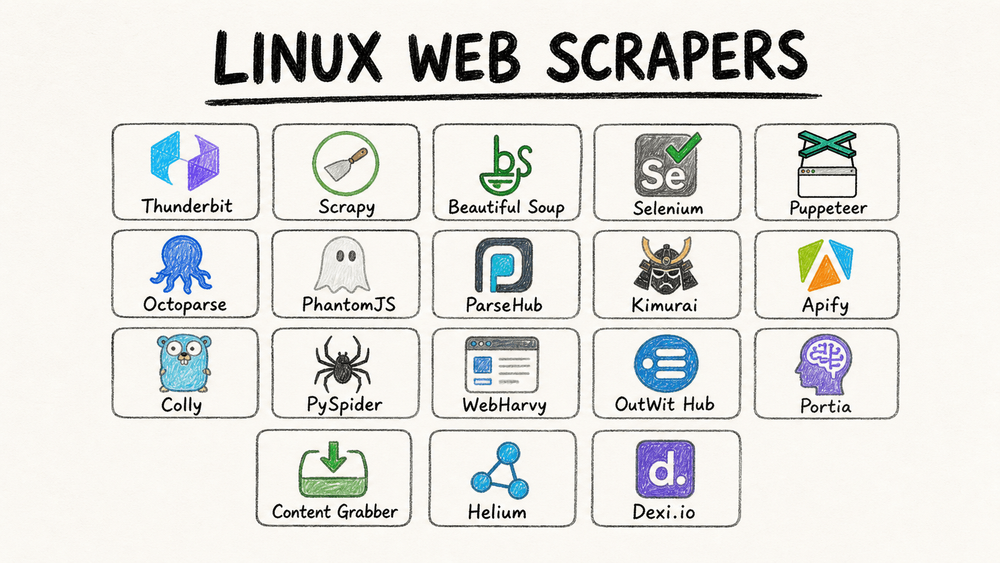
เว็บเต็มไปด้วยข้อมูล และพูดกันตรง ๆ เลย—คงไม่มีใครมีเวลามานั่ง copy-paste รายการสินค้านับพันรายการหรือหน้าราคาคู่แข่งทีละหน้าแน่ ๆ ถ้าคุณทำงานบน Linux อยู่แล้ว (เหมือนที่ผมใช้กับงานออโตเมชันและงาน dev ส่วนใหญ่) คุณคงรู้ดีว่าแพลตฟอร์มนี้ทรงพลังมากสำหรับทีมที่ขับเคลื่อนด้วยข้อมูล จริง ๆ แล้ว ระบบตระกูล Unix รองรับเว็บไซต์ที่ทราบระบบปฏิบัติการถึง 91.9% โดย Linux เป็นเวอร์ชันที่พบมากที่สุดแบบทิ้งห่าง แต่ปัญหาก็คือ การหา web scraper for linux ที่เข้ากับเวิร์กโฟลว์ของคุณจริง ๆ — ไม่ว่าคุณจะเป็นผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิค หรือเป็นสายโค้ดเต็มตัว — มันอาจให้ความรู้สึกเหมือนงมหาเข็มในกองฟาง
นั่นแหละคือเหตุผลที่ผมรวบรวมบทวิเคราะห์เชิงลึกของ 18 linux web scraping tools ที่ดีที่สุดสำหรับปี 2026 เอาไว้ให้ ตั้งแต่โซลูชัน AI แบบไม่ต้องเขียนโค้ดอย่าง Thunderbit (ใช่ครับ ตัวที่ทีมของผมกับผมสร้างขึ้นมาเอง) ไปจนถึงเฟรมเวิร์กฝั่งนักพัฒนาแบบคลาสสิกอย่าง Scrapy และ Beautiful Soup รายชื่อนี้คือทางลัดของคุณในการเลือก web scraper for linux ที่เหมาะกับงาน โดยไม่ต้องเสียเวลาลองผิดลองถูกให้ปวดหัว
ทำไมเครื่องมือ Linux Web Scraping ถึงสำคัญสำหรับผู้ใช้ธุรกิจ
หยุด copy-paste ก่อนเลือกเครื่องมือ Thunderbit ทำงานใน Chrome บนเดสก์ท็อป Linux ของคุณ — ไม่ต้องลงแพ็กเกจ ไม่ต้องตั้งไดรเวอร์ แค่กด 1 ครั้งก็ได้ตารางที่เป็นระเบียบพร้อมใช้ Get Started Free
พูดกันแบบไม่อ้อมค้อม: การเก็บข้อมูลด้วยมือคือสิ่งที่กินเวลาและฉุดประสิทธิภาพอย่างหนัก งานวิจัยหลายชิ้นชี้ว่าทีมที่ยังพึ่งพา copy-paste จะเสียเวลาหลายชั่วโมงต่อสัปดาห์ และมีอัตราความผิดพลาดราว 5% — ซึ่งสุดท้ายก็ลากไปสู่ความผิดพลาดที่มีต้นทุนสูงและโอกาสที่หลุดมือ (Thunderbit Blog). Linux ที่ขึ้นชื่อเรื่องความเสถียร ความปลอดภัย และความยืดหยุ่น เป็นแพลตฟอร์มยอดนิยมสำหรับรันสคราเปอร์ที่ต้องทำงาน 24/7 — ไม่ว่าคุณจะใช้งานบนเดสก์ท็อป เซิร์ฟเวอร์ หรือคลาวด์
กรณีใช้งานยอดนิยมของเครื่องมือ Linux web scraping ในธุรกิจ:
- Lead Generation: ทีมขายดึงข้อมูลรายชื่อจากไดเรกทอรี โซเชียลมีเดีย หรือเว็บรีวิวแบบอัตโนมัติ ลดงานจุกจิกที่ต้องทำซ้ำ (Thunderbit Blog).
- ติดตามราคา: ทีมอีคอมเมิร์ซดึงราคาคู่แข่งและข้อมูลสต็อกแบบอัตโนมัติ เพื่อให้ราคาของตัวเองทันสมัยและแข่งขันได้เสมอ
- วิจัยคู่แข่ง: ทีมการตลาดและทีมปฏิบัติการติดตามการเปิดตัวสินค้า รีวิว และคีย์เวิร์ด SEO ได้โดยไม่ต้อง “เดาสุ่ม” อีกต่อไป
- Market Intelligence: นักวิเคราะห์รวบรวมข่าว ฟอรั่ม และข้อมูลโซเชียลเพื่อจับเทรนด์แบบเรียลไทม์
- Workflow Automation: เครื่องมือบางตัว โดยเฉพาะแบบที่มี AI ยังสามารถทำงานเว็บแบบอัตโนมัติ เช่น กรอกฟอร์มหรือคลิกนำทางบนแดชบอร์ด จากเครื่อง Linux ของคุณได้เลย
ข้อดีที่สุดคือ เครื่องมือ Linux web scraping ที่เหมาะสมสามารถ ช่วยให้ผู้ใช้ที่ไม่ใช่สายเทคนิค เข้าถึงและใช้ประโยชน์จากข้อมูลบนเว็บได้ ไม่ใช่แค่โปรแกรมเมอร์เท่านั้น เพื่อการตัดสินใจทางธุรกิจที่ฉลาดและรวดเร็วขึ้น
เราเลือกเว็บสคราเปอร์ที่ดีที่สุดสำหรับ Linux อย่างไร
สคราเปอร์ไม่ได้เหมือนกันหมด โดยเฉพาะบน Linux นี่คือเกณฑ์ที่ผมใช้คัดเลือก:
- ความเข้ากันได้กับ Linux: ทุกเครื่องมือในลิสต์นี้รันได้บน Linux โดยตรง ผ่านเบราว์เซอร์ หรือมีวิธีใช้งานแบบง่าย ๆ เช่น Wine หรือผ่านคลาวด์
- ใช้งานง่าย: ตั้งแต่ prompt ของ AI ที่ใช้ภาษาธรรมชาติ ไปจนถึงอินเทอร์เฟซแบบ point-and-click ผมให้ความสำคัญกับเครื่องมือที่ช่วยให้คนไม่เขียนโค้ดได้ผลลัพธ์เร็ว แต่ก็ไม่ลืมผู้ใช้สายพลังที่ต้องการคุมทุกอย่างได้เต็มที่
- พลังในการดึงข้อมูล: รองรับคอนเทนต์แบบไดนามิก pagination subpage และชนิดข้อมูลหลากหลายแค่ไหน ทนทานต่อเทคนิคกันสคราเปอร์ได้ดีหรือไม่
- การขยายสเกลและระบบอัตโนมัติ: การตั้งเวลา cloud scraping และ distributed crawling เป็นสิ่งจำเป็นสำหรับโปรเจกต์ข้อมูลจริงจัง
- การเชื่อมต่อและการส่งออกข้อมูล: CSV, Excel, Google Sheets, API — ถ้าดึงข้อมูลออกไปใช้งานต่อไม่ได้ ก็แทบไม่มีประโยชน์
- ราคาและไลเซนส์: มีทั้งฟรี โอเพนซอร์ส และแบบเสียเงิน ครอบคลุมทุกงบ ตั้งแต่ผู้ก่อตั้งเดี่ยวไปจนถึงทีมองค์กร
- คอมมูนิตี้และการสนับสนุน: ฐานผู้ใช้ที่ active เอกสารที่ดี และทีมซัพพอร์ตที่ตอบไว ช่วยได้มากเวลาคุณติดปัญหา
ผมยังผสานเอา feedback จากผู้ใช้จริง รีวิวในอุตสาหกรรม และประสบการณ์ใช้งานจริงของผมเองกับเครื่องมือเหล่านี้เข้าไปด้วย ไปดูรายชื่อกันเลย
1. Thunderbit
 Thunderbit คืออันดับหนึ่งของผมสำหรับผู้ใช้ธุรกิจที่ต้องการ web scraper for linux ที่ใช้งานง่ายจริง ๆ ในฐานะ Chrome extension ที่ขับเคลื่อนด้วย AI มันทำงานได้อย่างสมบูรณ์บน Linux (แค่เปิด Chrome หรือ Chromium) และช่วยให้คุณดึงข้อมูลจากเว็บไซต์ใดก็ได้ในคลิกเดียว
จุดเด่นของ Thunderbit:
- Prompt ด้วยภาษาธรรมชาติ: แค่บอกสิ่งที่ต้องการ เช่น “ดึงชื่อสินค้าและราคาทั้งหมดจากหน้านี้” แล้ว AI ของ Thunderbit จะจัดการต่อให้
- AI Suggest Fields: คลิกครั้งเดียว Thunderbit จะสแกนหน้าเว็บและเสนอคอลัมน์กับชนิดข้อมูลให้เอง ไม่ต้องเลือกฟิลด์ทีละจุด
- ดึงข้อมูลจาก subpage และ pagination: ถ้าต้องการข้อมูลเพิ่ม Thunderbit สามารถเข้าไปยังแต่ละ subpage เช่นหน้ารายละเอียดสินค้า แล้วเติมข้อมูลลงตารางให้อัตโนมัติ
- Scraping แบบ cloud หรือ local: ดึงได้พร้อมกันสูงสุด 50 หน้าในคลาวด์ หรือใช้โหมดเบราว์เซอร์สำหรับเว็บที่ต้องล็อกอิน
- ส่งออกทันที: ส่งออกไป Excel, Google Sheets, Airtable, Notion, CSV หรือ JSON ได้ในคลิกเดียว และฟรีเสมอ
- เครื่องมือเสริม: ดึงอีเมล เบอร์โทร และรูปภาพได้ในคลิกเดียว และ AI autofill ยังช่วยกรอกฟอร์มอัตโนมัติได้ด้วย
ราคา: มีแพ็กเกจฟรี (6 หน้า/เดือน) แพ็กเกจเสียเงินเริ่มที่ $15/เดือน สำหรับ 500 แถว (Thunderbit Pricing) ผู้ใช้ชอบที่ “แทบไม่ต้องเรียนรู้อะไรเลย” และมัน “เปลี่ยนงานหลายชั่วโมงให้เหลือไม่กี่นาที” (Product Hunt Reviews) สำหรับงานใหญ่ ๆ คุณอาจต้องแบ่งรอบการรันย่อย แต่สำหรับ use case ทางธุรกิจส่วนใหญ่แล้ว มันช่วยประหยัดเวลาได้มาก
ความเข้ากันได้กับ Linux: 100% แค่รัน Chrome/Chromium บนเดสก์ท็อปหรือเซิร์ฟเวอร์ Linux
เหมาะสำหรับ: ผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิค เช่น ฝ่ายขาย การตลาด และฝ่ายปฏิบัติการ ที่อยากได้การตั้งค่าที่เร็วและง่ายที่สุด
ลอง Thunderbit ฟรีบน Linux ทำงานใน Chrome บน Linux ได้ทุกเครื่อง — ไม่ต้องคอมไพล์แพ็กเกจ ไม่ต้องติดตั้งไดรเวอร์ กดครั้งเดียวก็ดึงข้อมูลได้ Get Started Free
2. Scrapy
 Scrapy คือมาตรฐานทองคำสำหรับนักพัฒนา Python ที่ต้องการ web scraper for linux ที่ยืดหยุ่นและขยายสเกลได้ มันเป็นโอเพนซอร์ส เร็วมากด้วยการทำงานแบบ asynchronous crawling และรองรับตั้งแต่งานดึงข้อมูลเล็ก ๆ ไปจนถึง distributed crawl ขนาดใหญ่
ฟีเจอร์สำคัญ:
- Crawling แบบ asynchronous ความเร็วสูง — เหมาะสำหรับการดึงข้อมูลหลายพันหน้า
- ขยายต่อได้สูง: มีปลั๊กอินสำหรับ proxies, CAPTCHA และอื่น ๆ
- เชื่อมกับสแต็กข้อมูล Python ได้ดี: ส่งออกเป็น JSON, CSV, ฐานข้อมูล หรือ pandas
- รองรับ cookies, sessions และ auto-throttling
ราคา: ฟรี 100% และเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: ใช้ได้แบบ native (ติดตั้งผ่าน pip) ทำงานดีมากบนเซิร์ฟเวอร์และคอนเทนเนอร์
เหมาะสำหรับ: นักพัฒนาที่ต้องสร้างสคราเปอร์แบบกำหนดเองและรองรับงานขนาดใหญ่
หมายเหตุ: ไม่เหมาะกับคนไม่เขียนโค้ดนัก แต่ถ้าคุณใช้ Python เป็น Scrapy แทบเอาชนะยาก
3. Beautiful Soup
 Beautiful Soup เป็นไลบรารี Python น้ำหนักเบาสำหรับ การ parse HTML และ XML เหมาะเป็นตัวเลือกสำหรับงานสคราปแบบเร็ว ๆ หรือการทำความสะอาดหน้าเว็บที่เละเทะ
ฟีเจอร์สำคัญ:
- API เรียบง่าย ใช้แล้วเข้าใจง่าย — เหมาะกับมือใหม่
- ใช้คู่กับ requests ได้ดี สำหรับการดึงหน้าเว็บ
- จัดการ HTML ที่ไม่สมบูรณ์ได้อย่างยืดหยุ่น
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: 100% (เป็น pure Python)
เหมาะสำหรับ: นักพัฒนาและ data scientist ที่ทำงานดึงหรือ parse ข้อมูลขนาดเล็กถึงกลาง
ข้อจำกัด: ไม่รองรับ JavaScript หรือคอนเทนต์แบบไดนามิก — ถ้าจำเป็นต้องใช้ ให้จับคู่กับ Selenium หรือ Puppeteer
4. Selenium
 Selenium คือเฟรมเวิร์กคลาสสิกสำหรับ browser automation ช่วยให้คุณควบคุม Chrome, Firefox หรือเบราว์เซอร์อื่น ๆ เพื่อสคราเป้เว็บที่มี JavaScript หนัก ๆ และเป็นแบบไดนามิก
ฟีเจอร์สำคัญ:
- ควบคุมเบราว์เซอร์จริง — ล็อกอิน คลิก เลื่อน และโต้ตอบได้เหมือนมนุษย์
- รองรับ Python, Java, C# และภาษาอื่น ๆ
- มีโหมด headless สำหรับรันบนเซิร์ฟเวอร์ Linux
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: รองรับเต็มรูปแบบ (แค่ติดตั้ง browser driver ให้ถูกต้อง)
เหมาะสำหรับ: QA engineer, นักพัฒนางานสคราเปอร์ และใครก็ตามที่ต้องจำลองพฤติกรรมผู้ใช้
หมายเหตุ: ใช้ทรัพยากรเยอะและช้ากว่าสคราเปอร์แบบ HTTP ล้วน ๆ แต่บางครั้งมันก็เป็นวิธีเดียวที่จะดึงข้อมูลที่ต้องการได้
5. Puppeteer
 Puppeteer คือไลบรารี Node.js จาก Google สำหรับ ควบคุม Chrome/Chromium แบบ headless มันคล้าย Selenium แต่มี JavaScript API ที่ทันสมัยกว่า และเชื่อมกับฟีเจอร์ของ Chrome ได้แน่นกว่า
ฟีเจอร์สำคัญ:
- รัน JavaScript จัดการคอนเทนต์ไดนามิก และจับภาพหน้าจอได้
- เร็ว เสถียร และใช้งานง่ายสำหรับสาย Node.js
- ดัก request ของเครือข่ายและบล็อกทรัพยากรที่ไม่ต้องการได้
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: ติดตั้ง Chromium ให้อัตโนมัติ และทำงานแบบ headless เป็นค่าเริ่มต้น
เหมาะสำหรับ: นักพัฒนาที่สคราเป้เว็บแอปสมัยใหม่หรือเว็บแบบ single-page
6. Octoparse
 Octoparse เป็น web scraper แบบไม่ต้องเขียนโค้ด ที่มีอินเทอร์เฟซลากวางและเทมเพลตสำเร็จรูปจำนวนมาก แม้แอปเดสก์ท็อปจะรองรับแค่ Windows/Mac แต่ผู้ใช้ Linux ยังเข้าถึง แพลตฟอร์ม cloud ของ Octoparse ผ่านเบราว์เซอร์ หรือรันแอป Windows ผ่าน Wine ได้
ฟีเจอร์สำคัญ:
- เทมเพลตสำเร็จรูปกว่า 100 แบบ สำหรับเว็บอย่าง Amazon, eBay, Zillow และอื่น ๆ
- ตัวออกแบบเวิร์กโฟลว์แบบ visual — ชี้แล้วคลิกเพื่อสร้างสคราเปอร์
- Cloud scraping และการตั้งเวลา — ให้เซิร์ฟเวอร์ของ Octoparse ทำงานหนักแทน
- ส่งออกเป็น Excel, CSV, JSON และฐานข้อมูล
ราคา: แพ็กเกจฟรี (10 tasks, ประมาณ 50K แถว/เดือน) แพ็กเกจเสียเงินเริ่มที่ $69/เดือน สำหรับ Standard plan (เรียกเก็บรายปี); Professional อยู่ที่ $249/เดือน (Octoparse Pricing)
ความเข้ากันได้กับ Linux: ใช้ผ่าน cloud/web; แอปเดสก์ท็อปใช้ผ่าน Wine
เหมาะสำหรับ: คนไม่เขียนโค้ดที่ต้องการข้อมูลจากอีคอมเมิร์ซหรือมาร์เก็ตเพลซอย่างรวดเร็ว
7. PhantomJS
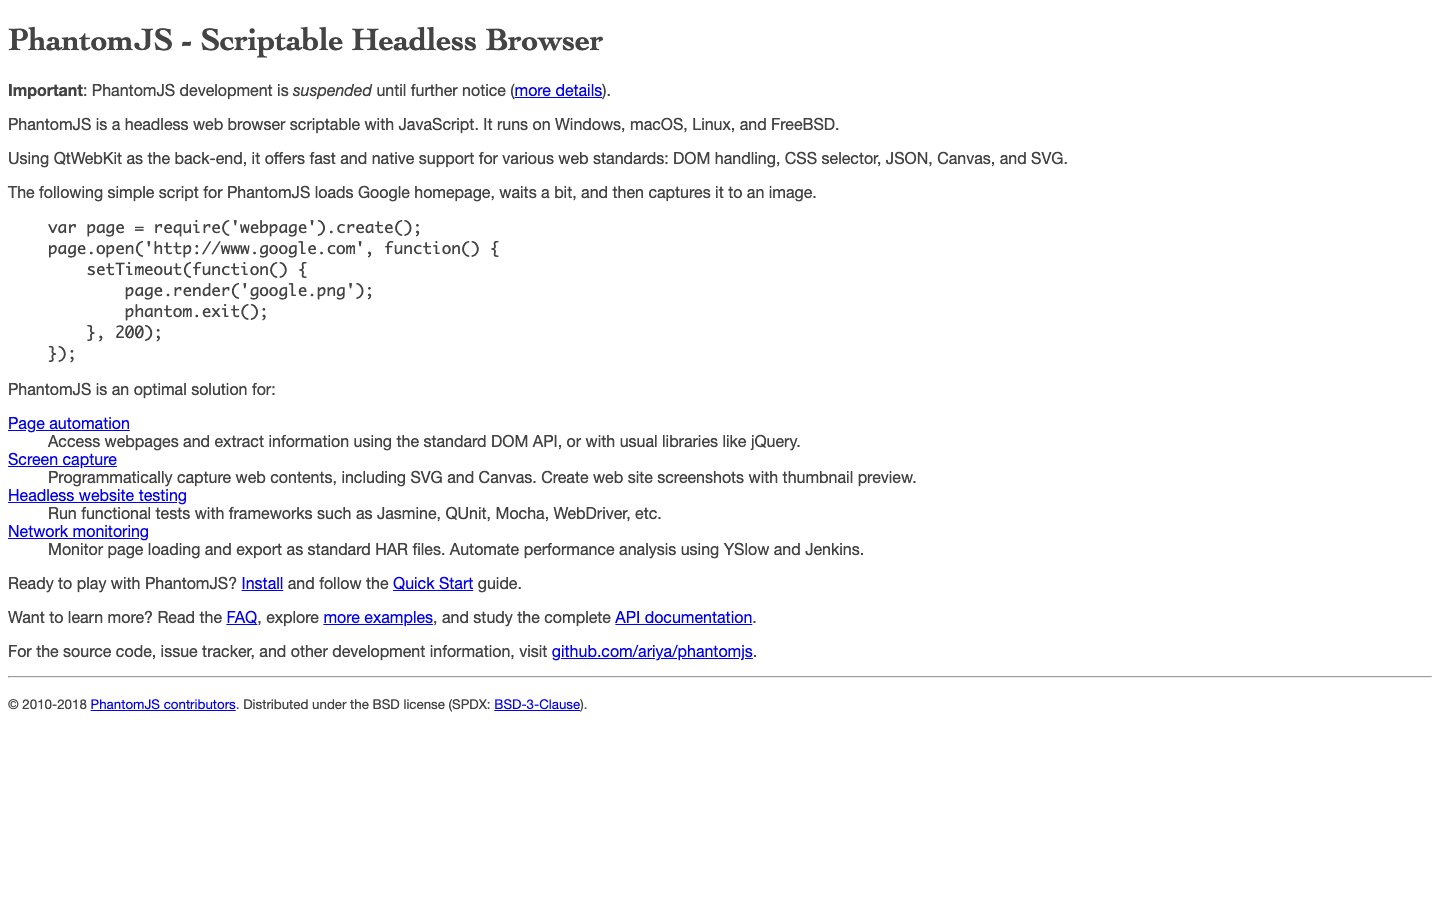 PhantomJS คือ เบราว์เซอร์ WebKit แบบ headless ที่ครั้งหนึ่งเคยเป็นตัวเลือกยอดนิยมสำหรับ browser automation แบบเบา ๆ ปัจจุบันถูกยกเลิกการพัฒนาแล้ว แต่ยังใช้งานบน Linux ได้สำหรับงานเก่าหรืองานง่าย ๆ
ฟีเจอร์สำคัญ:
- สคริปต์ด้วย JavaScript ได้
- รองรับ JavaScript ระดับปานกลาง และจับภาพหน้าจอ/PDF ได้
- ไม่ต้องมี GUI
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: binary แบบ native
เหมาะสำหรับ: โปรเจกต์ legacy หรือสภาพแวดล้อมที่ติดตั้ง Chrome ไม่ได้
ข้อควรระวัง: ถูกประกาศยุติอย่างเป็นทางการในปี 2017 และหยุดพัฒนาในเดือนมีนาคม 2018; เวอร์ชันสุดท้ายคือ v2.1.1 ไม่มีแพตช์ความปลอดภัย ไม่มี JavaScript engine รุ่นใหม่ และใช้งานไม่ได้กับเว็บสมัยใหม่ส่วนใหญ่ สำหรับโปรเจกต์ใหม่ ควรใช้ Puppeteer หรือ Playwright แทน ที่ยังใส่มาในลิสต์นี้เพราะมันยังโผล่ในสแต็ก Linux เก่า ๆ ที่คุณอาจต้องรับช่วงต่อ
8. ParseHub
 ParseHub เป็น web scraper แบบ visual ข้ามแพลตฟอร์ม ที่มีแอป native บน Linux เหมาะมากสำหรับคนไม่เขียนโค้ดที่อยากดึงข้อมูลจากเว็บซับซ้อนแบบไดนามิก
ฟีเจอร์สำคัญ:
- อินเทอร์เฟซ point-and-click — เลือกองค์ประกอบและสร้างเวิร์กโฟลว์ด้วยภาพ
- รองรับคอนเทนต์ไดนามิก แผนที่ infinite scroll และอื่น ๆ
- รันบนคลาวด์และตั้งเวลาได้
- ส่งออกเป็น CSV, JSON หรือผ่าน API
ราคา: มีแพ็กเกจฟรี (5 projects) แพ็กเกจเสียเงินเริ่มที่ $189/เดือน
ความเข้ากันได้กับ Linux: แอป native สำหรับ Linux, Windows และ Mac
เหมาะสำหรับ: นักวิเคราะห์และผู้ใช้กึ่งเทคนิคที่อยากควบคุมได้โดยไม่ต้องเขียนโค้ด
9. Kimurai
 Kimurai คือ เฟรมเวิร์ก web scraper แบบ Ruby ที่รองรับ Linux โดยตรง มันคล้าย Scrapy แต่สร้างมาสำหรับนักพัฒนา Ruby
ฟีเจอร์สำคัญ:
- รองรับหลายเบราว์เซอร์: Headless Chrome, Firefox, PhantomJS หรือ HTTP ธรรมดา
- ประมวลผลแบบ asynchronous เพื่อรองรับ concurrency สูง
- DSL ใน Ruby ที่อ่านง่ายสำหรับเขียน spider
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: 100% (Ruby)
เหมาะสำหรับ: นักพัฒนา Ruby หรือทีม Rails ที่ต้องการสคราเปอร์แบบกำหนดเองและรองรับ concurrency สูง
10. Apify
 Apify คือ แพลตฟอร์ม web scraping บนคลาวด์ ที่มี SDK โอเพนซอร์สและมาร์เก็ตเพลซของ “actors” สำเร็จรูป คุณสามารถรันสคราเปอร์บนเครื่อง Linux ของคุณหรือบนคลาวด์ก็ได้
ฟีเจอร์สำคัญ:
- SDK สำหรับ Node.js, Python และภาษาอื่น ๆ
- มาร์เก็ตเพลซของสคราเปอร์สำเร็จรูป
- รันบนคลาวด์ ตั้งเวลาได้ และเชื่อม API ได้
ราคา: มีแพ็กเกจฟรี และคิดตามการใช้งานสำหรับ cloud
ความเข้ากันได้กับ Linux: CLI/SDK รันบน Linux ได้; แพลตฟอร์ม cloud เข้าถึงผ่านเบราว์เซอร์
เหมาะสำหรับ: นักพัฒนาที่ต้องการผสมผสานการเขียนโค้ดเองกับโครงสร้างพื้นฐานคลาวด์ที่พร้อมใช้
11. Colly
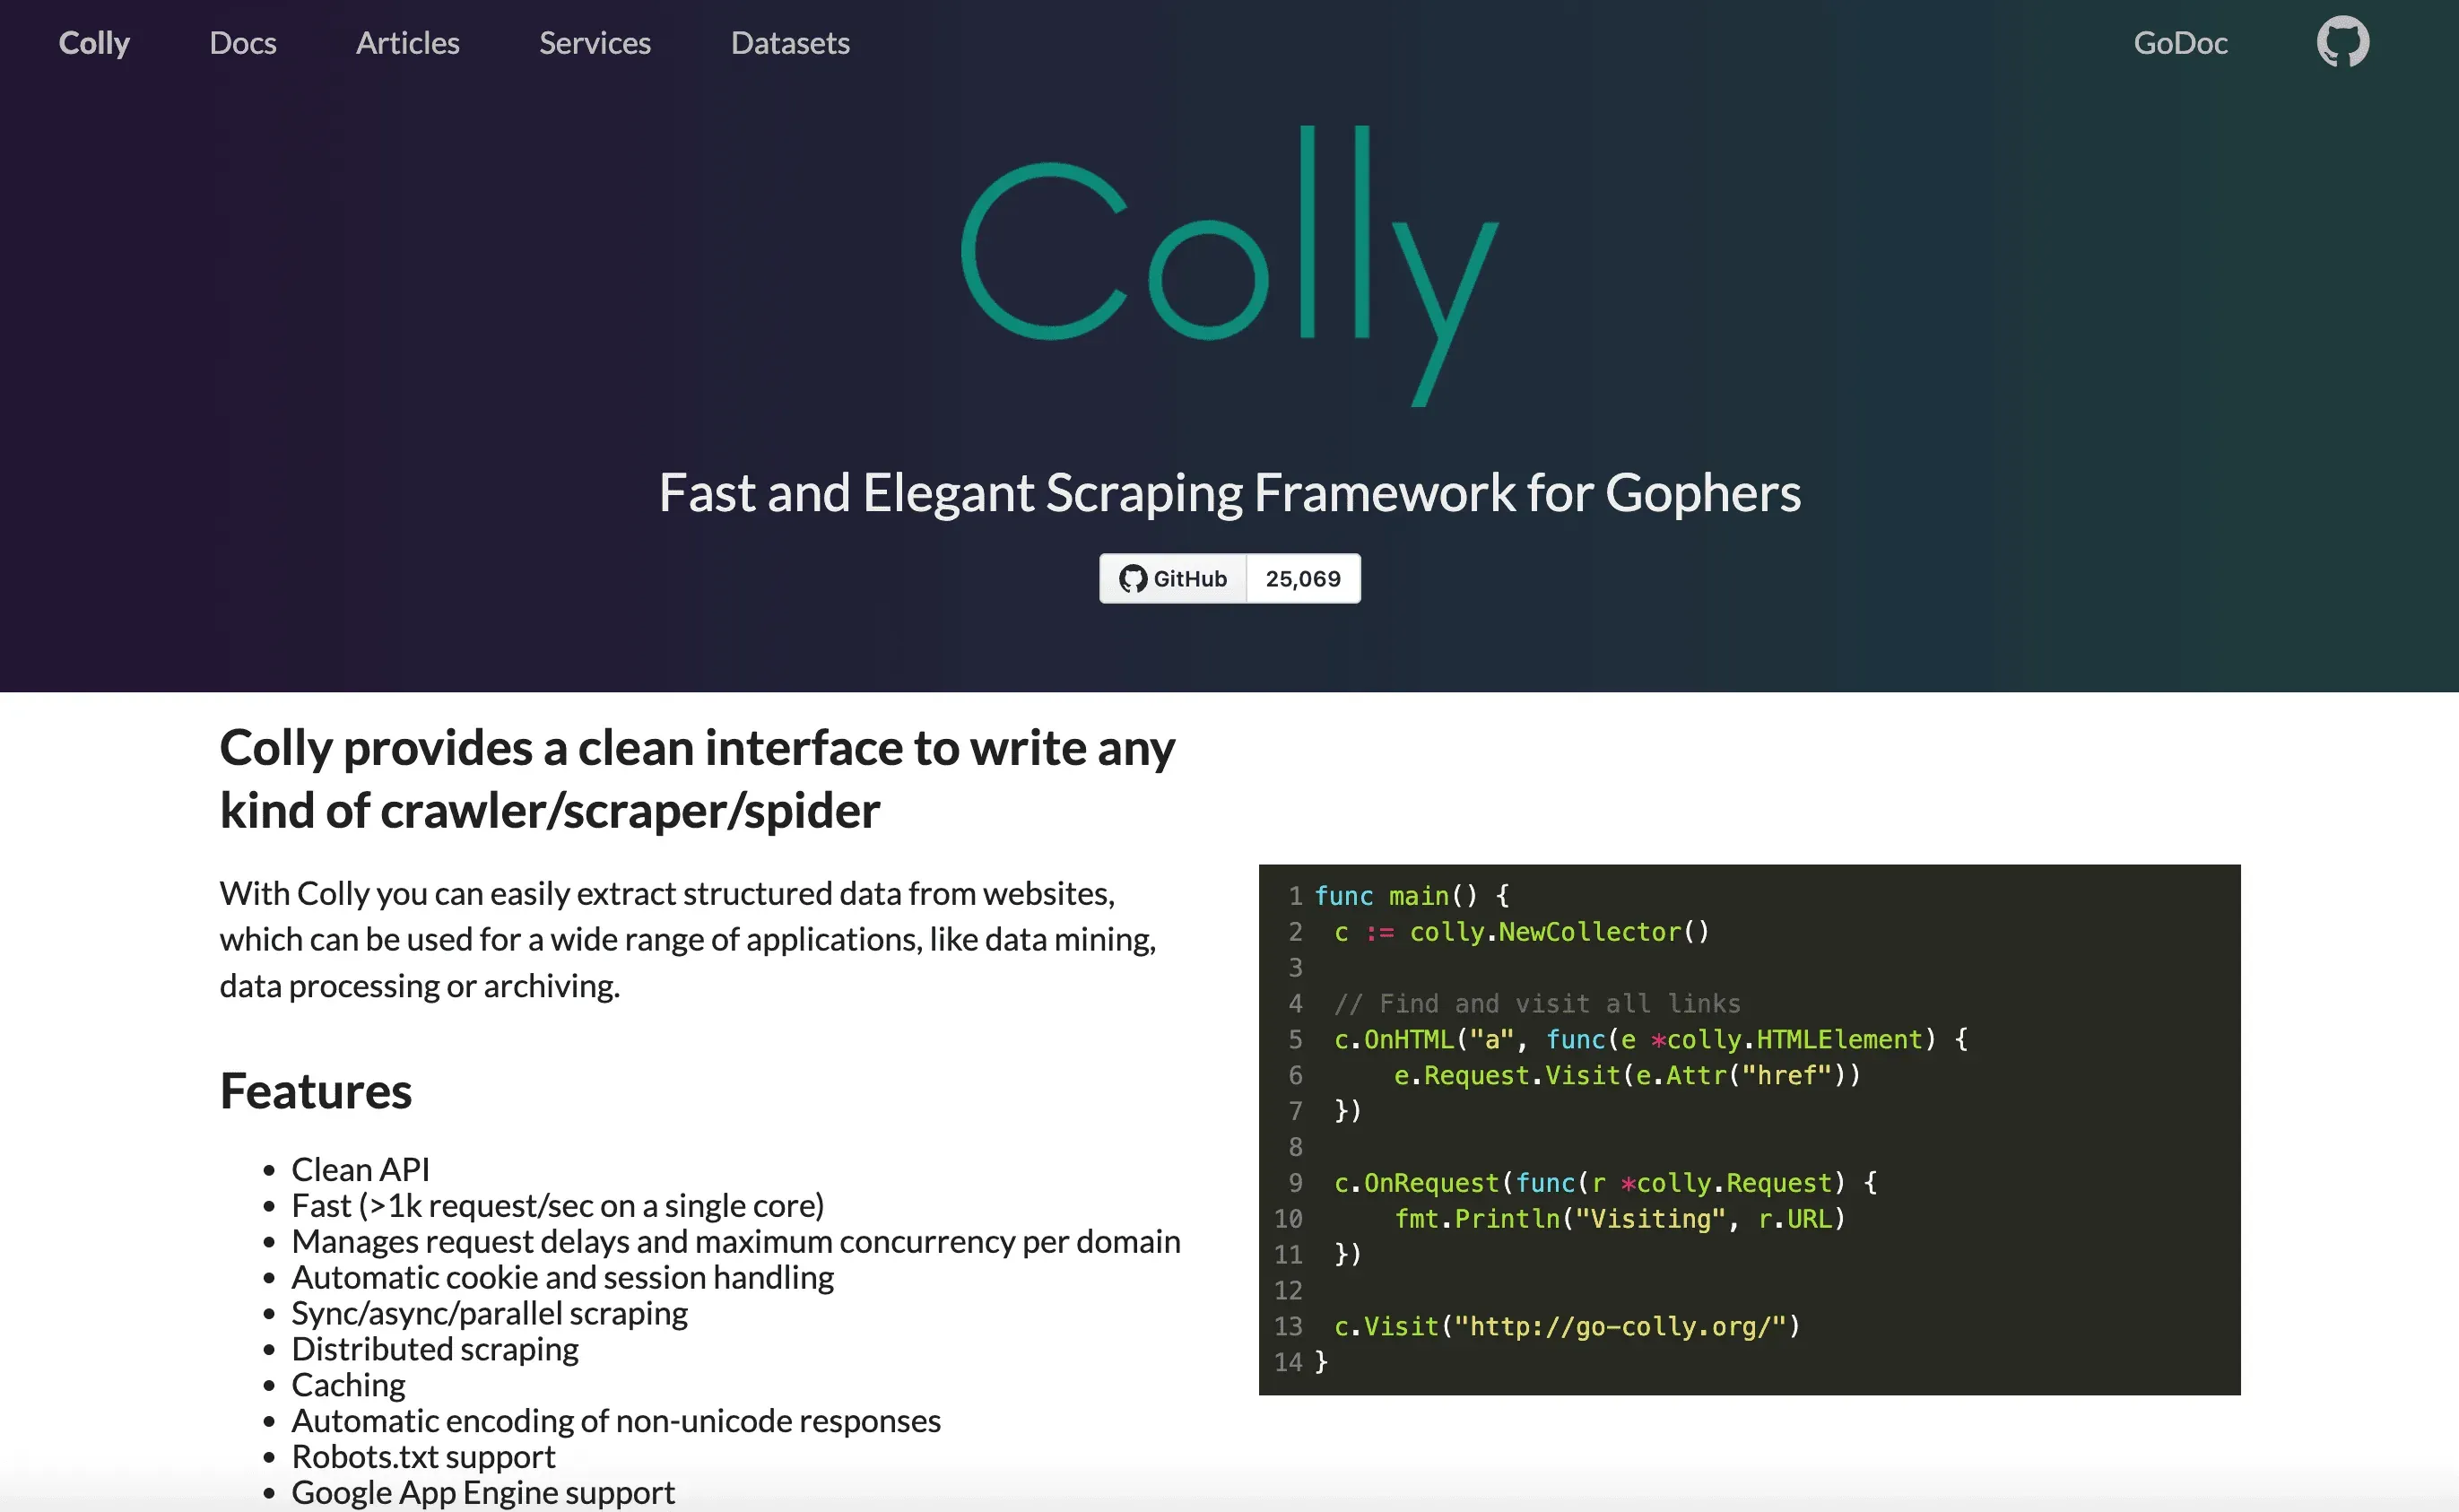 Colly คือ เฟรมเวิร์ก web scraping บน Go ที่ออกแบบมาเพื่อความเร็วและประสิทธิภาพ ถ้าคุณเป็นนักพัฒนา Go นี่คือเครื่องมือของคุณ
ฟีเจอร์สำคัญ:
- ดึงข้อมูลแบบ concurrent ได้เร็วมาก — มากกว่า 1,000 requests/วินาทีบน single core
- เก็บมารยาทในการ crawl (เคารพ robots.txt) และมีระบบจัดการ session/cookie
- กินหน่วยความจำน้อย
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: native binary ของ Go
เหมาะสำหรับ: นักพัฒนา Go ที่ต้องการสคราเปอร์ประสิทธิภาพสูง
12. PySpider
 PySpider คือ ระบบเว็บครอว์เลอร์บน Python ที่มี web UI — คุณสามารถจัดการ ตั้งเวลา และติดตามการ crawl ได้จากเบราว์เซอร์ ประเด็นสำคัญที่ควรรู้ตั้งแต่ต้น: repository นี้ถูกทำเครื่องหมายเป็น public archive บน GitHub และผู้พัฒนาหลักไม่ได้ปล่อยเวอร์ชันใหม่แล้ว ดังนั้นสิ่งที่เห็นก็คือสิ่งที่ได้ ถ้าคุณแค่ต้องการรูปแบบ UI/dashboard บน Linux มันยังใช้งานได้ แต่ถ้าคิดจะพึ่งพาระยะยาว ให้มองว่าเป็น legacy
ฟีเจอร์สำคัญ:
- อินเทอร์เฟซบนเว็บสำหรับเขียนสคริปต์และมอนิเตอร์
- รองรับ distributed crawling, scheduling และ retries
- เชื่อมกับฐานข้อมูลและ message queue ได้
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: ออกแบบมาสำหรับการ deploy บน Linux
เหมาะสำหรับ: ทีมที่โอเคกับการ fork และดูแล web UI สำหรับโปรเจกต์สคราปหลายงานด้วยตัวเอง (อย่าคาดหวังการแก้ไขจาก upstream)
13. WebHarvy
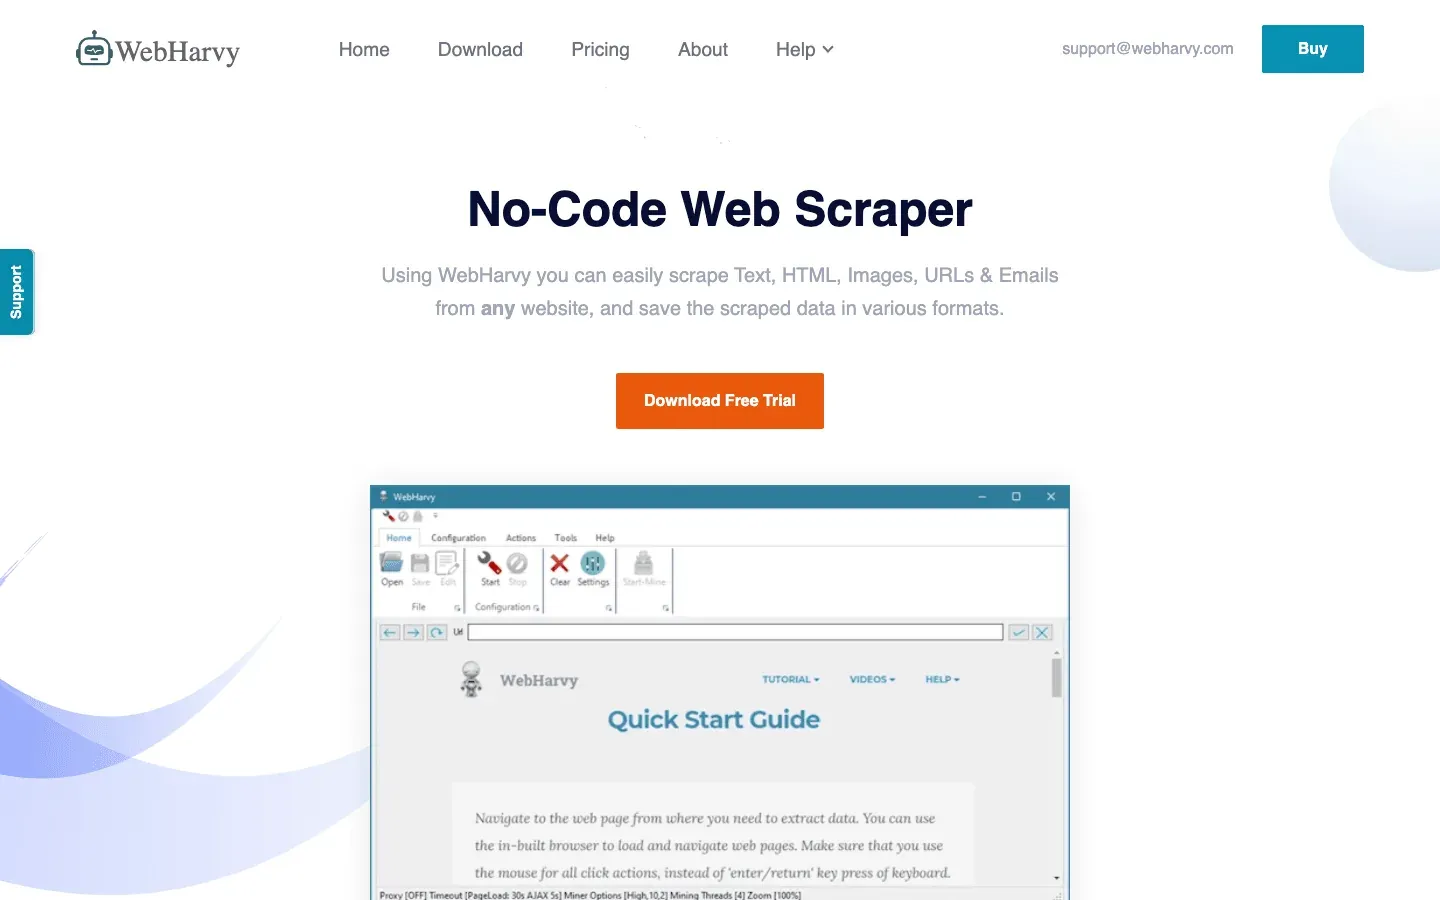 WebHarvy เป็น สคราเปอร์แบบ visual point-and-click สำหรับ Windows แต่ผู้ใช้ Linux สามารถรันผ่าน Wine ได้ จุดเด่นคือการตรวจจับ pattern และโมเดลจ่ายครั้งเดียว
ฟีเจอร์สำคัญ:
- เปิดหน้าเว็บแล้วคลิกเลือกข้อมูลได้ — ไม่ต้องเขียนโค้ด
- ตรวจจับรูปแบบของรายการอัตโนมัติ
- ส่งออกเป็น CSV, JSON, XML, SQL
ราคา: ประมาณ ~$129 แบบไลเซนส์จ่ายครั้งเดียว
ความเข้ากันได้กับ Linux: รันผ่าน Wine หรือ VM
เหมาะสำหรับ: มือใหม่หรือมืออาชีพทำงานคนเดียวที่ต้องการสคราเปอร์แบบภาพที่ใช้งานเร็ว
14. OutWit Hub
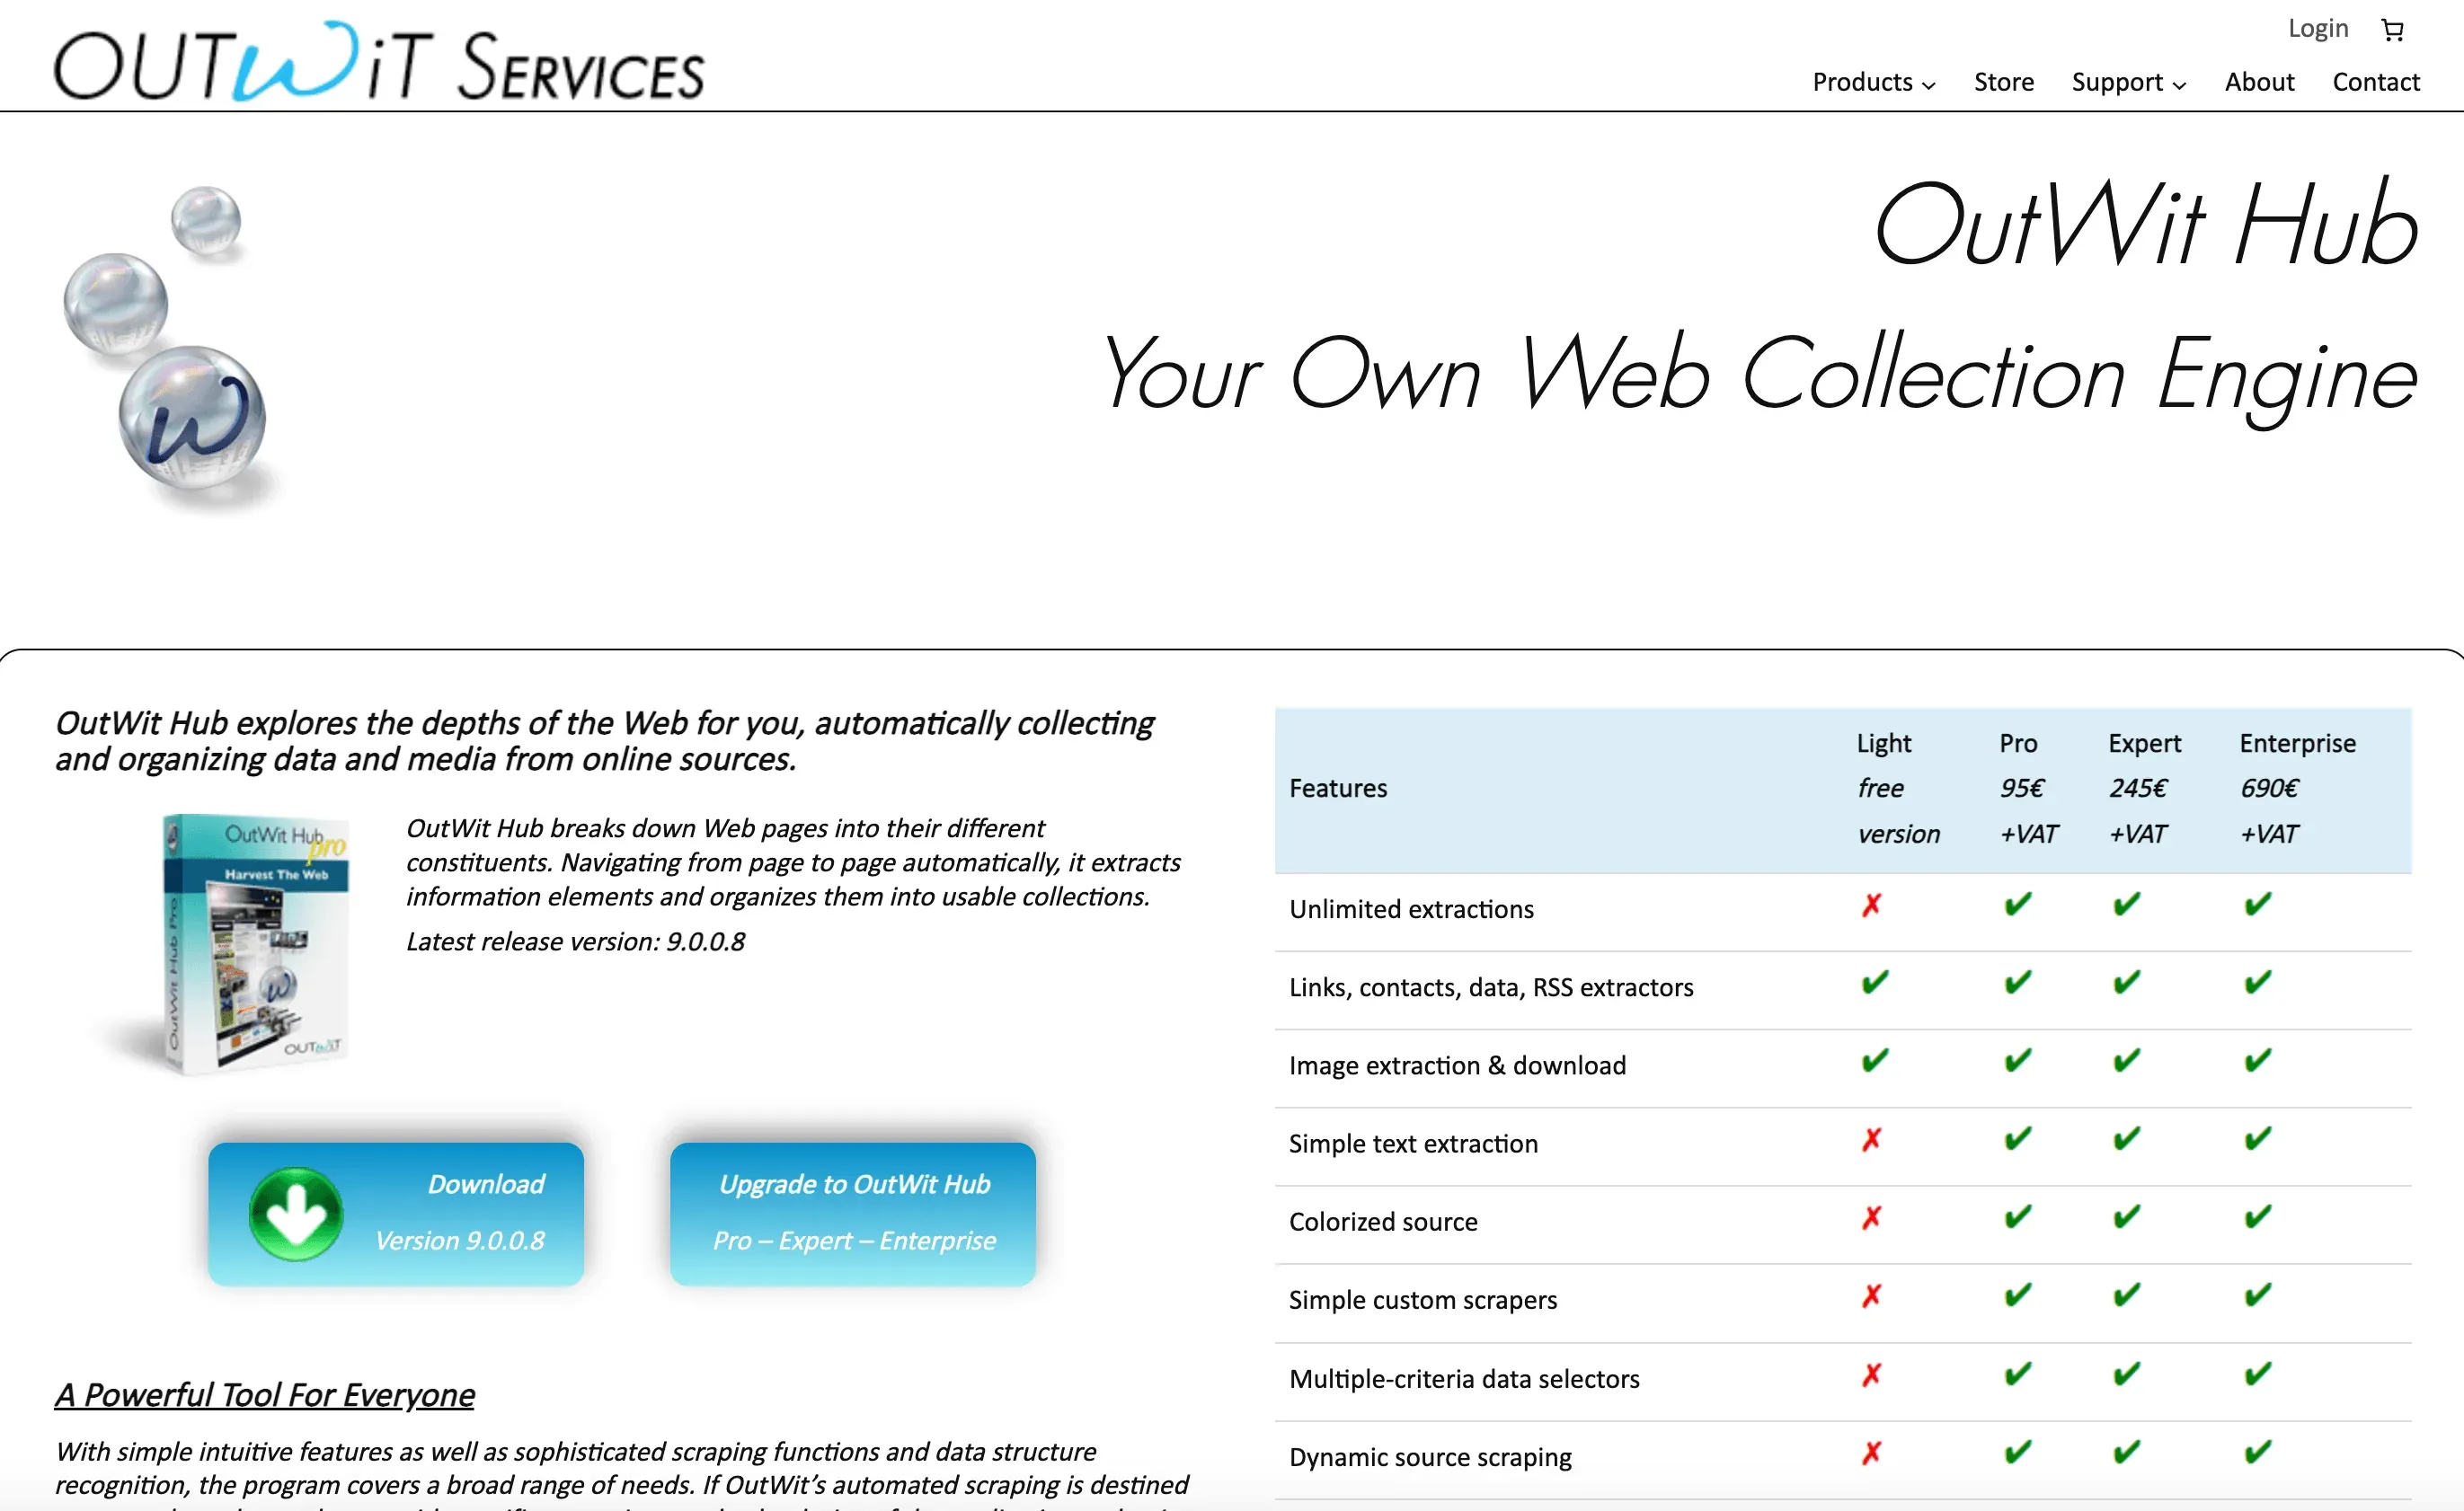 OutWit Hub เป็น แอป GUI แบบ native บน Linux สำหรับ web scraping มันจดจำ pattern ของข้อมูลอัตโนมัติและมีความสามารถด้าน extraction และ automation ที่ทรงพลัง
ฟีเจอร์สำคัญ:
- ตรวจจับลิงก์ รูปภาพ ตาราง อีเมล และอื่น ๆ ได้อัตโนมัติ
- มี script editor สำหรับการดึงข้อมูลแบบกำหนดเอง
- รองรับ macro automation และการตั้งเวลา
ราคา: เวอร์ชันฟรี (ความสามารถจำกัด); มี Pro แบบเสียเงิน — ตรวจสอบราคาล่าสุดจากร้านค้าของผู้ขาย
ความเข้ากันได้กับ Linux: แอป native สำหรับ Linux, Windows, Mac
เหมาะสำหรับ: คนไม่เขียนโค้ดแต่มีพื้นฐานทางเทคนิคเล็กน้อย และอยากได้สคราเปอร์แบบเดสก์ท็อป GUI
15. Portia
 Portia คือ web scraper แบบ visual โอเพนซอร์ส จาก Scrapinghub มันทำงานในเบราว์เซอร์และให้คุณ annotate หน้าเว็บเพื่อฝึกสคราเปอร์ — แต่ขอเตือนก่อนว่า repository นี้ไม่ได้มีการอัปเดตจริงจังมานานกว่าหนึ่งปีแล้ว จึงอยู่ในโซน “ใช้ด้วยความเสี่ยงของคุณเอง” ถ้าคุณอยากได้ไอเดียการ annotate แบบ visual ที่ยังมีการพัฒนา active อยู่ ParseHub หรือ Thunderbit จะเป็นตัวเลือกที่สะอาดกว่า
ฟีเจอร์สำคัญ:
- อินเทอร์เฟซบนเบราว์เซอร์สำหรับการดึงข้อมูลแบบ visual
- เชื่อมกับ Scrapy สำหรับโปรเจกต์แบบกำหนดเองได้
- เป็นโอเพนซอร์สและขยายต่อได้
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: ใช้งานผ่านเบราว์เซอร์ ใช้ได้กับทุกระบบปฏิบัติการ
เหมาะสำหรับ: ผู้ใช้ที่ต้องการ web scraping แบบ visual ที่เป็นโอเพนซอร์สและเชื่อมกับ Scrapy ได้
16. Sequentum Enterprise (เดิมชื่อ Content Grabber)
 Sequentum Enterprise เป็น สคราเปอร์ระดับองค์กรแบบ visual สำหรับ Windows แต่สามารถรันบน Linux ผ่าน Wine หรือ virtualization ได้
ฟีเจอร์สำคัญ:
- มี visual editor พร้อมสคริปต์ C# สำหรับ logic ขั้นสูง
- จัดการหลาย agent และตั้งเวลาได้
- เชื่อมกับฐานข้อมูล, API และอื่น ๆ ได้
ราคา: ไลเซนส์ระดับองค์กร คิดราคาตามการติดตั้ง
ความเข้ากันได้กับ Linux: ผ่าน Wine หรือ VM
เหมาะสำหรับ: เอเจนซีและทีมขนาดใหญ่ที่ต้องดูแลโปรเจกต์สคราปจำนวนมาก
17. Helium
 Helium คือ ไลบรารี Python ที่ทำให้การใช้งาน Selenium ง่ายขึ้น ออกแบบมาให้การเขียนสคริปต์ควบคุมเบราว์เซอร์เป็นมิตรมากขึ้น
ฟีเจอร์สำคัญ:
- คำสั่งเข้าใจง่าย เช่น
click("Login")หรือwrite("email") - ทำงานกับ Chrome และ Firefox
- เหมาะมากสำหรับงานสคริปต์เร็ว ๆ และงานออโตเมชันทั่วไป
ราคา: ฟรีและเป็นโอเพนซอร์ส
ความเข้ากันได้กับ Linux: ใช้ได้บน Linux (สร้างบน Selenium)
เหมาะสำหรับ: ผู้ใช้ Python ที่รู้สึกว่า Selenium เทอะทะเกินไป
18. Dexi.io
 Dexi.io คือ แพลตฟอร์มดึงข้อมูลและทำอัตโนมัติบนคลาวด์ เข้าถึงผ่านเบราว์เซอร์ได้ ดังนั้นผู้ใช้ Linux จึงใช้งานได้โดยไม่ต้องติดตั้งอะไรเลย
ฟีเจอร์สำคัญ:
- ตัวออกแบบเวิร์กโฟลว์แบบ visual สำหรับการสคราปและ automation
- รองรับการตั้งเวลา การแปลงข้อมูล และการเชื่อม API
- สเกลและซัพพอร์ตระดับองค์กร
ราคา: ปัจจุบันจำหน่ายภายใต้ Mozenda: ทดลองใช้ฟรี 14 วัน, Pilot ราคา $500/เดือน, ส่วนองค์กรติดต่อขอใบเสนอราคา
ความเข้ากันได้กับ Linux: เว็บแอป — ใช้ได้กับทุกระบบปฏิบัติการ
เหมาะสำหรับ: มืออาชีพและองค์กรที่ต้องการการดึงข้อมูลเว็บแบบขยายสเกลและเชื่อมระบบได้ดี
ตารางเปรียบเทียบแบบเร็ว: เครื่องมือ Linux Web Scraping ในภาพรวม
| เครื่องมือ | ประเภท / จุดเด่นหลัก | เหมาะกับใคร | ราคา | ความเข้ากันได้กับ Linux |
|---|---|---|---|---|
| Thunderbit | Chrome Extension ที่มี AI, คลิกเดียว, subpage, cloud/local | ผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิค | ฟรี, เริ่มที่ $15/เดือน | ✔ Chrome บน Linux |
| Scrapy | Python framework, async, CLI, ขยายต่อได้สูง | นักพัฒนา, สคราเปอร์ custom ขนาดใหญ่ | ฟรี | ✔ Native |
| Beautiful Soup | ไลบรารี Python, parse HTML/XML อย่างง่าย | Devs, data scientists, งานเล็ก | ฟรี | ✔ Native |
| Selenium | Browser automation, เว็บที่ใช้ JS หนัก | QA, devs, คอนเทนต์ไดนามิก | ฟรี | ✔ Native |
| Puppeteer | Node.js, headless Chrome, render JS | นักพัฒนา Node, เว็บแอปสมัยใหม่ | ฟรี | ✔ Native |
| Octoparse | No-code, ลากวาง, cloud templates | คนไม่เขียนโค้ด, e-commerce | ฟรี, เริ่มที่ $69/เดือน | ◐ Cloud/Wine |
| PhantomJS | Headless WebKit, เขียน JS ได้ | legacy, งานเบา, ไม่อยากใช้ Chrome | ฟรี | ✔ Native |
| ParseHub | Visual, ข้ามแพลตฟอร์ม, point-and-click | นักวิเคราะห์, ผู้ใช้กึ่งเทคนิค | ฟรี, เริ่มที่ $189/เดือน | ✔ Native |
| Kimurai | Ruby framework, multi-browser, async | นักพัฒนา Ruby, concurrency สูง | ฟรี | ✔ Native |
| Apify | Cloud platform, SDKs, marketplace | Devs, ผสม custom/cloud | มีแพ็กเกจฟรี, คิดตามการใช้งาน | ✔ Native/Cloud |
| Colly | Go framework, เร็ว, concurrent | นักพัฒนา Go, performance สูง | ฟรี | ✔ Native |
| PySpider | Python, web UI, scheduling, distributed | ทีมที่มีหลายโปรเจกต์ | ฟรี | ✔ Native |
| WebHarvy | Visual, ตรวจจับ pattern, จ่ายครั้งเดียว | มือใหม่, มืออาชีพทำงานคนเดียว | ~$129 จ่ายครั้งเดียว | ◐ Wine/VM |
| OutWit Hub | Native GUI, ตรวจจับข้อมูลอัตโนมัติ, scripting | คนไม่เขียนโค้ด, GUI บนเดสก์ท็อป | ฟรี; Pro แบบเสียเงิน (ดูผู้ขาย) | ✔ Native |
| Portia | โอเพนซอร์ส, visual, ใช้งานผ่านเบราว์เซอร์ | โอเพนซอร์ส, เชื่อม Scrapy | ฟรี | ✔ Browser |
| Sequentum Enterprise | Enterprise, visual, scripting, multi-agent | เอเจนซี, ทีมขนาดใหญ่ | $$$, คิดราคาเป็นใบเสนอราคา | ◐ Wine/VM |
| Helium | Python, Selenium แบบง่าย, API ใช้ง่าย | ผู้ใช้ Python, งานออโตเมชันเร็ว | ฟรี | ✔ Native |
| Dexi.io | Cloud, visual workflow, scheduling, API | องค์กร, automation ขยายสเกลได้ | เริ่มที่ $500/เดือน (ผ่าน Mozenda) | ✔ Browser |
วิธีเลือกเว็บสคราเปอร์สำหรับ Linux ให้เหมาะกับงาน: สิ่งที่ควรพิจารณา
ยังไม่แน่ใจว่าควรใช้แพ็กเกจไหน? เริ่มจากตัวที่ใช้ง่ายก่อน ถ้าคุณไม่อยากคอยดูแล selector เอง ให้ AI ช่วยคัดฟิลด์ให้ — กดครั้งเดียว แล้วส่งออกไป Sheets, Excel, Airtable หรือ Notion ได้เลย Get Started Free
การเลือกเครื่องมือที่ใช่คือการจับคู่ความต้องการกับทักษะของคุณ:
- ระดับทักษะทางเทคนิค: คนไม่เขียนโค้ดควรเริ่มที่ Thunderbit, ParseHub, Octoparse หรือ OutWit Hub ส่วนสายพัฒนาสามารถปลดล็อกพลังได้มากขึ้นด้วย Scrapy, Puppeteer, Colly หรือ Kimurai
- ความซับซ้อนของข้อมูล: สำหรับหน้าเว็บแบบ static Beautiful Soup หรือ Colly จะเร็วและตรงไปตรงมา ถ้าเป็นเว็บไดนามิกที่ใช้ JavaScript หนัก ๆ คุณน่าจะต้องใช้ Selenium, Puppeteer หรือเครื่องมือ visual ที่รองรับ JS
- สเกลและความถี่: ถ้าเป็นงานครั้งคราว เครื่องมือ no-code หรือ cloud scraper ก็เพียงพอ แต่ถ้าต้อง crawl ขนาดใหญ่และตั้งเวลารันสม่ำเสมอ ให้เลือก Scrapy, PySpider หรือ Apify
- ความต้องการด้านการเชื่อมต่อ: ถ้าต้องส่งออกไป Excel, Sheets หรือฐานข้อมูล อย่าลืมตรวจว่ามันรองรับเวิร์กโฟลว์ของคุณหรือไม่
- งบประมาณ: ตัวเลือกฟรีและโอเพนซอร์สมีให้เลือกมากสำหรับสายโค้ด ส่วนผู้ใช้ธุรกิจ Thunderbit และ ParseHub มีจุดเริ่มต้นที่คุ้มค่า ขณะที่ทีมองค์กรอาจลงทุนใน Dexi.io หรือ Sequentum Enterprise
- ซัพพอร์ตและคอมมูนิตี้: เครื่องมือโอเพนซอร์สมักมีคอมมูนิตี้ใหญ่ ส่วนเครื่องมือเชิงพาณิชย์จะมีซัพพอร์ตเฉพาะทาง
ทิป: อย่ากลัวที่จะใช้หลายเครื่องมือร่วมกัน คุณสามารถใช้ Thunderbit เพื่อทำต้นแบบและจับ pattern ของข้อมูลก่อน แล้วค่อยย้ายไป Scrapy ตอนทำงานระดับ production หรือจะใช้ Selenium สำหรับล็อกอินและดึง session cookie แล้วส่งต่อให้ Colly หรือ Scrapy ทำงานเร็ว ๆ ต่อก็ได้
สรุป: หาเครื่องมือ Web Scraping สำหรับ Linux ที่ดีที่สุดของคุณในปี 2026
ผู้ใช้ Linux ในปี 2026 มีตัวเลือกมากจนเลือกไม่ถูก ไม่ว่าคุณจะต้องการเครื่องมือ no-code ที่ขับเคลื่อนด้วย AI และให้ผลลัพธ์ในไม่กี่นาทีอย่าง Thunderbit เฟรมเวิร์กฝั่งนักพัฒนาที่แข็งแรงอย่าง Scrapy หรือ Colly หรือแพลตฟอร์มระดับองค์กรอย่าง Dexi.io ก็มี web scraper for linux ที่เหมาะกับความต้องการและเวิร์กโฟลว์ของคุณ
ประเด็นสำคัญ:
- Linux คือโครงสร้างหลักของระบบข้อมูลยุคใหม่ — สคราเปอร์ชั้นนำส่วนใหญ่รันได้แบบ native หรือผ่านเบราว์เซอร์
- เครื่องมือ AI และ no-code กำลังทำให้ web scraping เข้าถึงผู้ใช้ธุรกิจได้ง่ายขึ้น
- เฟรมเวิร์กสำหรับนักพัฒนายังคงเป็นตัวเลือกหลักเมื่อพูดถึงความยืดหยุ่น ความเร็ว และสเกล
- ลองก่อนซื้อ — เครื่องมือส่วนใหญ่มี free tier หรือทดลองใช้
พร้อมเริ่มหรือยัง? ดาวน์โหลด Thunderbit หรือเข้าไปดู Thunderbit Blog สำหรับคู่มือเพิ่มเติมเกี่ยวกับ web scraping, automation และการเติบโตที่ขับเคลื่อนด้วยข้อมูล
สำรวจ AI Web Scraper ของ Thunderbit ไม่ต้องเขียนสคริปต์หรือจัดการ cron job — ให้ AI อ่านหน้าเว็บแล้วส่งตารางให้คุณในคลิกเดียว Get Started Free
คำถามที่พบบ่อย
1. เว็บสคราเปอร์สำหรับ Linux ที่ง่ายที่สุดสำหรับคนไม่เขียนโค้ดคืออะไร?
Thunderbit คือคำตอบอันดับต้น ๆ สำหรับผู้ใช้ที่ไม่ถนัดเทคนิค มันทำงานเป็น Chrome extension บน Linux ใช้ AI ทำงานแทบทุกอย่าง และให้คุณดึงข้อมูลได้ในคลิกเดียว
2. Linux web scraper ตัวไหนเหมาะที่สุดสำหรับโปรเจกต์ขนาดใหญ่แบบกำหนดเอง?
Scrapy คือคำตอบสำหรับนักพัฒนา มันเร็ว ขยายสเกลได้ และปรับแต่งได้สูง — เหมาะกับงาน crawl ขนาดใหญ่ที่ทำซ้ำบ่อย
3. บน Linux สามารถสคราเป้เว็บที่ใช้ JavaScript หนัก ๆ หรือเว็บไดนามิกได้ไหม?
ได้แน่นอน! ใช้ Selenium หรือ Puppeteer เพื่อควบคุมเบราว์เซอร์จริงและดึงคอนเทนต์แบบไดนามิก เครื่องมือ visual อย่าง ParseHub และ Thunderbit ก็รองรับเว็บแบบไดนามิกเช่นกัน
4. มีเครื่องมือ Linux web scraping ฟรีสำหรับงานธุรกิจไหม?
มีแน่นอน Scrapy, Beautiful Soup, Selenium, Colly, PySpider และ Kimurai ล้วนฟรีและเป็นโอเพนซอร์ส ส่วน Thunderbit และ ParseHub ก็มีแพ็กเกจฟรีสำหรับงานขนาดเล็ก
5. จะเลือกอย่างไรระหว่าง Linux scraper แบบ no-code กับแบบเขียนโค้ด?
ถ้าต้องการความเร็วและความง่าย ให้เลือก no-code (Thunderbit, ParseHub, Octoparse) แต่ถ้าต้องการความยืดหยุ่น การทำอัตโนมัติ หรือการเชื่อมกับระบบอื่น เครื่องมือแบบโค้ด (Scrapy, Puppeteer, Colly) คือคำตอบที่ดีกว่า
ขอให้สนุกกับการสคราเป้ข้อมูล — และขอให้โปรเจกต์ข้อมูลบน Linux ของคุณไหลลื่นยิ่งกว่าการติดตั้ง Ubuntu ใหม่เอี่ยม ถ้าอยากดูทิปส์เรื่อง web scraping เพิ่มเติม เข้าไปที่ Thunderbit Blog หรือกดติดตาม ช่อง YouTube ของเรา สำหรับบทสอนแบบลงมือทำ
ลอง AI Web Scraper สำหรับ Linux Get Started Free
เรียนรู้เพิ่มเติม



