
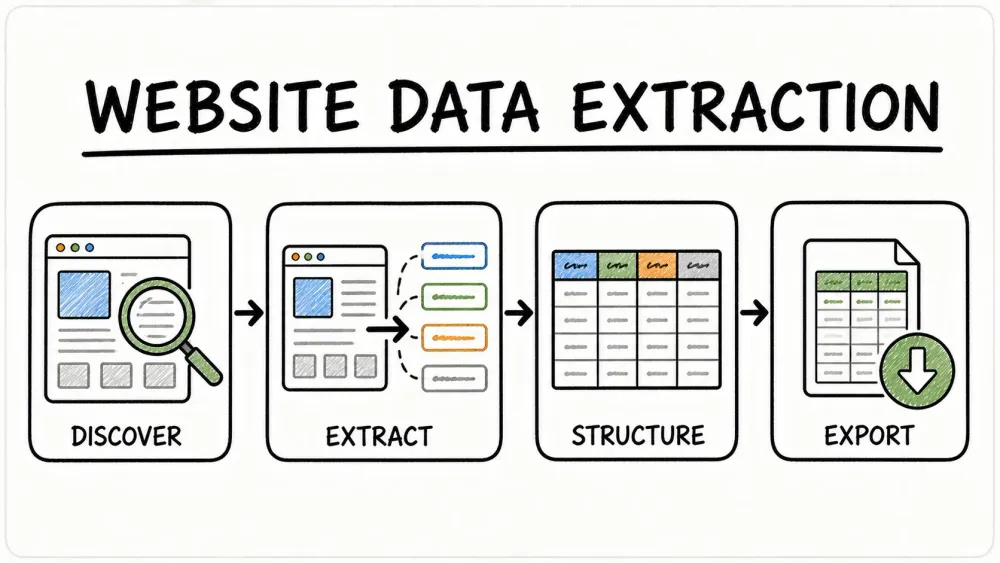
เว็บเต็มไปด้วยข้อมูลมหาศาล แต่การเปลี่ยนข้อมูลที่กระจัดกระจายเหล่านั้นให้กลายเป็นข้อมูลธุรกิจที่ใช้งานได้จริงคือความท้าทาย—และเป็นโอกาสสำคัญเช่นกัน ตลอดหลายปีที่ผ่านมาในการสร้าง SaaS และเครื่องมืออัตโนมัติ ผมเห็นโลกค่อย ๆ เปลี่ยนจากการตัดสินใจด้วยสัญชาตญาณไปสู่การขับเคลื่อนทุกอย่างด้วยข้อมูล ไม่ได้มีแค่บริษัทยักษ์ใหญ่เท่านั้น แม้แต่ทีมเล็ก ๆ ก็เร่ง ดึงข้อมูล จาก เว็บไซต์ มาใช้กับงานขาย การตลาด ราคา และการพัฒนาผลิตภัณฑ์ แต่พอเว็บซับซ้อนขึ้นและเปลี่ยนแปลงตลอดเวลา การ ดึงข้อมูล ที่สะอาด ถูกต้องตามข้อกำหนด และนำไปใช้ต่อได้จริง ก็กลายเป็นเกมใหม่ไปเลย
มาลงมือแบบใช้งานจริงกัน: ผมจะพาคุณไปดูว่าทำไมการ ดึงข้อมูล จาก เว็บไซต์ จึงสำคัญต่อธุรกิจยุคใหม่ อุปสรรคใหญ่ที่คุณจะเจอมีอะไรบ้าง และแนวปฏิบัติที่ดีที่สุด—รวมถึงบทเรียนที่ทีม Thunderbit สั่งสมมา—เพื่อทำให้ทุกอย่างถูกต้องทั้งในแง่กฎหมาย มีประสิทธิภาพ และรองรับการขยายงานได้จริง ไม่ว่าคุณจะกำลังจัดการคอนเทนต์ที่ไม่มีโครงสร้าง กังวลเรื่อง GDPR หรือแค่อยากเลิกคัดลอกวางลงสเปรดชีตด้วยมือ คู่มือนี้เหมาะกับคุณ
ทำไมการ ดึงข้อมูล จาก เว็บไซต์ จึงสำคัญต่อธุรกิจยุคใหม่
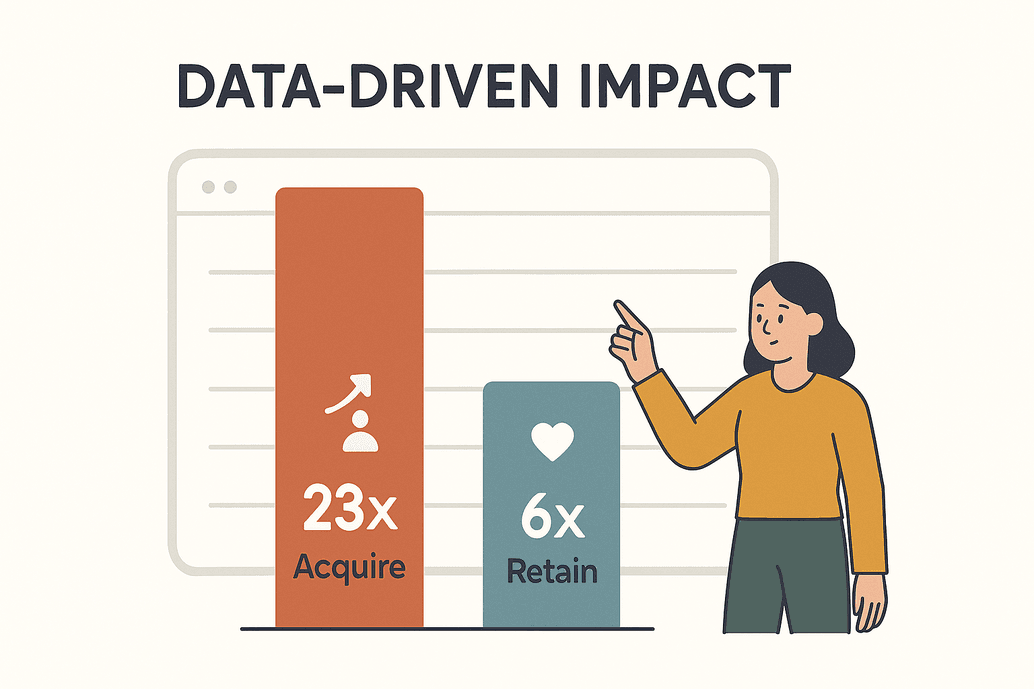 ข้อมูลไม่ใช่แค่คำฮิต—แต่เป็นเส้นเลือดหล่อเลี้ยงธุรกิจที่แข่งขันได้ในวันนี้ จากผลสำรวจของ McKinsey องค์กรที่ขับเคลื่อนด้วยข้อมูลมีโอกาส ดึงลูกค้าใหม่ได้มากกว่า 23 เท่า และรักษาลูกค้าไว้ได้มากกว่า 6 เท่า ซึ่งไม่ใช่แค่เรื่องน่าประทับใจ แต่เป็นเรื่องอยู่รอดเลยทีเดียว ภายในปี 2025 ธุรกิจต่าง ๆ จะ ดึงข้อมูล จากหน้าเว็บนับพันล้านหน้าในแต่ละวัน เพื่อนำไปใช้กับการวิเคราะห์ โมเดล AI และการตัดสินใจแบบเรียลไทม์ (kanhasoft.com).
แล้วในชีวิตจริงมันหน้าตาเป็นอย่างไร? นี่คือตัวอย่างสถานการณ์ที่ผมเห็นแทบทุกสัปดาห์:
| การใช้งานทางธุรกิจ | คำอธิบายและประโยชน์ | ตัวอย่าง/สถิติ |
|---|---|---|
| ติดตามราคา | ติดตามราคาคู่แข่ง สต็อก และโปรโมชันแบบเรียลไทม์ แล้วปรับกลยุทธ์ของคุณให้เหนือกว่าอยู่เสมอ | ผู้ค้าปลีกออนไลน์ชั้นนำกว่า 80% ดึงราคาคู่แข่งทุกวัน (kanhasoft.com). |
| สร้างลีด | ดึงข้อมูลจากไดเรกทอรี โซเชียลมีเดีย หรือเว็บรีวิว เพื่อหาโอกาสทางการขายและข้อมูลติดต่อใหม่ ๆ | การดึงข้อมูลอัตโนมัติช่วยเติม CRM ได้เร็วกว่ารีเสิร์ชด้วยมือมาก |
| วิเคราะห์เทรนด์ตลาด | รวบรวมรีวิว ฟอรั่ม และข่าว เพื่อมองเห็นเทรนด์หรือการเปลี่ยนแปลงของอารมณ์ตลาดตั้งแต่เนิ่น ๆ | 26% ของการสแครปมุ่งไปที่โซเชียลมีเดียเพื่อหาอินไซต์ด้านเทรนด์ (blog.apify.com). |
| รวบรวมคอนเทนต์ | เก็บข่าว รายการสินค้า หรืออีเวนต์จากหลายเว็บไซต์ไว้ในที่เดียวเพื่อเข้าถึงได้ง่าย | ทีมสื่อมักคัดสรรฟีดข่าวให้เหมาะกับกลุ่มผู้อ่านของตน |
| ข้อมูลสินค้าและงานวิจัย | เก็บรายละเอียดสินค้า รีวิว หรือข้อมูลวิจัยเพื่อใช้วิเคราะห์และพัฒนา | ที่ปรึกษาการลงทุน 67% ใช้ข้อมูลเว็บทางเลือก (scrap.io). |
| ข้อมูลสำหรับฝึก AI | ดึงข้อความ รูปภาพ หรือระเบียนจำนวนมากเพื่อใช้ฝึกโมเดล AI | โมเดล AI ขนาดใหญ่ราว 70% อาศัยข้อมูลเว็บที่สแครปมา (kanhasoft.com). |
ถ้าคุณยังไม่ได้ ดึงข้อมูล จาก เว็บไซต์ แปลว่าคุณไม่ได้แค่ล้าหลัง—แต่แทบจะมองไม่เห็นในตลาดของตัวเอง ผมเคยเห็นทีมอีคอมเมิร์ซเพิ่ม ROI ได้ถึงสามเท่าในหกเดือน เพียงแค่ทำระบบสแครปราคาคู่แข่งให้เป็นอัตโนมัติ (kanhasoft.com) สรุปสั้น ๆ คือ ข้อมูลเว็บคือสินทรัพย์เชิงกลยุทธ์ และการ ดึงข้อมูล มันออกมาอย่างถูกวิธีคือสิ่งจำเป็นในตอนนี้
ความท้าทายหลักเมื่อคุณ ดึงข้อมูล จาก เว็บไซต์ ใดก็ได้
แน่นอนว่าโลกนี้ไม่ได้สวยงามไปหมด เว็บเป็นพื้นที่ที่วุ่นวาย และการ ดึงข้อมูล จาก เว็บไซต์ ก็มีอุปสรรคจริงอยู่หลายอย่าง:
- ข้อมูลไม่มีโครงสร้าง: ประมาณ 80% ของข้อมูลออนไลน์ไม่มีโครงสร้าง—ซ่อนอยู่ใน HTML ที่ยุ่งเหยิง กระจายตามหลายหน้า หรือถูกซ่อนไว้หลังองค์ประกอบแบบอินเทอร์แอคทีฟ การแปลงสิ่งเหล่านี้ให้กลายเป็นตารางที่สะอาดไม่ใช่เรื่องง่าย (scrapingapi.ai).
- เว็บไซต์เปลี่ยนตลอด: เว็บไซต์อัปเดตเลย์เอาต์บ่อยมาก ผมเคยเห็นสคริปต์สแครปพังถึง 15 ครั้งในเดือนเดียว แค่เพราะเว็บเป้าหมายปรับดีไซน์เล็กน้อย (scrap.io).
- ปริมาณและสเกล: ธุรกิจต้อง ดึงข้อมูล จากหลายร้อยหรือหลายพันหน้า และมักต้องทำตามตารางเวลา การคัดลอกวางด้วยมือไม่ทันแน่นอน
- มาตรการป้องกันการสแครป: CAPTCHA, rate limit, หน้าล็อกอิน... เว็บไซต์ฉลาดขึ้นเรื่อย ๆ ในการบล็อกบอต ปัจจุบัน มากกว่าหนึ่งในสามของทราฟฟิกเว็บทั้งหมดคือบอต (scrap.io) และเทคโนโลยีป้องกันบอตก็พัฒนาเร็วมาก
- ความผิดพลาดจากการทำด้วยมือ: การคัดลอกวางด้วยคนช้าและพลาดง่าย เลือกตัวชี้วัดผิดเพียงตัวเดียว ก็อาจดึงข้อมูลผิดชุดหรือไม่ได้อะไรเลย
วิธีแบบดั้งเดิมไม่สามารถขยายได้จริง นี่จึงเป็นเหตุผลที่หลายทีมหันไปหาโซลูชันที่ฉลาดและอัตโนมัติมากขึ้น (และเป็นเหตุผลว่าทำไมผมถึงมั่นใจกับเครื่องมือที่ขับเคลื่อนด้วย AI มาก)
แนวปฏิบัติด้านกฎหมาย การปฏิบัติตามข้อกำหนด และความปลอดภัยสำหรับการ ดึงข้อมูล เว็บไซต์
ขอพูดตรงนี้ก่อน: แค่คุณ สามารถ ดึงข้อมูล จาก เว็บไซต์ ได้ ไม่ได้แปลว่าคุณ ควร ทำเสมอไป—อย่างน้อยก็ไม่ใช่โดยไม่คิดถึงด้านกฎหมายและจริยธรรม นี่คือสิ่งที่ทุกธุรกิจควรรู้:
- ข้อมูลสาธารณะ vs ข้อมูลส่วนตัว: การสแครปข้อมูลที่เปิดเผยต่อสาธารณะโดยทั่วไปมักถูกกฎหมายในหลายพื้นที่ แต่ข้อมูลที่อยู่หลังล็อกอิน? ห้ามแตะ การเลี่ยงระบบยืนยันตัวตนไม่ใช่เรื่องที่ควรทำ (xbyte.io).
- ข้อกำหนดการใช้งาน: ตรวจ Terms of Service ของเว็บไซต์เสมอ ถ้าระบุห้ามสแครป คุณอาจเสี่ยงต่อคดีความหรือถูกบล็อก หากไม่แน่ใจให้ขออนุญาต หรือใช้ API ทางการ
- กฎหมายความเป็นส่วนตัว (GDPR, CCPA): ถ้าคุณเก็บข้อมูลส่วนบุคคล ต้องมีฐานทางกฎหมายรองรับ (เช่น legitimate interest) เก็บเท่าที่จำเป็น และต้องลบข้อมูลได้เมื่อมีการร้องขอ การไม่ปฏิบัติตามอาจโดนปรับหนัก (xbyte.io).
- เคารพ robots.txt: แม้จะไม่ใช่ข้อบังคับทางกฎหมายโดยตรง แต่เป็นมารยาทที่ดี ควรปฏิบัติตาม crawl-delay และอย่าทำให้เซิร์ฟเวอร์รับภาระเกินไป
- ความปลอดภัยของข้อมูล: ให้ถือว่าข้อมูลที่สแครปมามีความอ่อนไหว จัดเก็บอย่างปลอดภัย จำกัดสิทธิ์การเข้าถึง และทำความสะอาดข้อมูลก่อนใช้งาน
เช็กลิสต์ด้านการปฏิบัติตามข้อกำหนด:
| สิ่งที่ต้องพิจารณา | แนวปฏิบัติที่ดีที่สุด |
|---|---|
| การเข้าถึงตามกฎหมาย | สแครปเฉพาะข้อมูลสาธารณะ; ห้ามข้ามการล็อกอิน (xbyte.io). |
| Terms of Service | ตรวจสอบและเคารพ ToS ของเว็บไซต์; ใช้ API หากห้ามสแครป |
| ข้อมูลส่วนบุคคล | หลีกเลี่ยงหากทำได้; หากจำเป็นให้เก็บเท่าที่น้อยที่สุดและปฏิบัติตาม GDPR/CCPA |
| robots.txt และ Crawl Delay | เคารพกฎของเว็บไซต์; จำกัดอัตราการส่งคำขอ |
| ความปลอดภัยของข้อมูล | เข้ารหัส จำกัดการเข้าถึง และลบเมื่อไม่จำเป็นต้องใช้แล้ว |
เพิ่มประสิทธิภาพ: AI ช่วยยกระดับการ ดึงข้อมูล เว็บไซต์ ได้อย่างไร
ตรงนี้แหละที่สนุกขึ้นมา AI เปลี่ยนเกมการ ดึงข้อมูล จาก เว็บไซต์ ไปโดยสิ้นเชิง จากเดิมที่ต้องมานั่งต่อสู้กับ selector หรือเขียนสคริปต์ที่พังง่าย ตอนนี้คุณสามารถใช้เครื่องมือที่ขับเคลื่อนด้วย AI ซึ่ง “อ่าน” หน้าเว็บและเดาได้ว่าควร ดึงข้อมูล อะไรออกมา—มักทำได้ด้วยการคลิกไม่กี่ครั้งเท่านั้น
แล้วในทางปฏิบัติหมายความว่าอะไร?
- ตั้งค่าน้อยมาก: สแครปเปอร์แบบ AI อย่าง Thunderbit ตรวจจับฟิลด์ได้อัตโนมัติ แค่กด “One Click Extract” เครื่องมือก็จะเสนอคอลัมน์ที่เหมาะสมให้เอง—ไม่ต้องเขียนโค้ด ไม่ต้องลองผิดลองถูก
- ปรับตัวได้ดี: สแครปเปอร์แบบ AI มองหาแพตเทิร์น ไม่ได้ยึดติดแค่เลย์เอาต์ตายตัว ถ้าเว็บไซต์เปลี่ยนไป AI มักปรับตัวได้เอง นั่นหมายถึงดูแลน้อยลง และไม่ต้องแก้ด่วนตอนดึกบ่อย ๆ
- แม่นยำ: AI ช่วยตัดสัญญาณรบกวน ลบข้อมูลซ้ำ และทำความสะอาดข้อมูลที่ยุ่งเหยิงได้ระหว่างสแครป บางทีมรายงานว่าเครื่องมือดึงข้อมูลแบบ AI ทำได้แม่นยำสูงถึง 99.5% (scrapingapi.ai).
- คอนเทนต์แบบไดนามิก: สแครปเปอร์แบบ AI รับมือเว็บไซต์ที่ใช้ JavaScript หนัก ๆ, infinite scroll และแม้แต่การดึงข้อความจากรูปภาพหรือ PDF ได้
- ประมวลผลไปพร้อมกัน: ต้องการแปล จัดหมวดหมู่ หรือสรุปข้อมูลระหว่างสแครปเลยไหม? AI ทำได้ในรอบเดียว
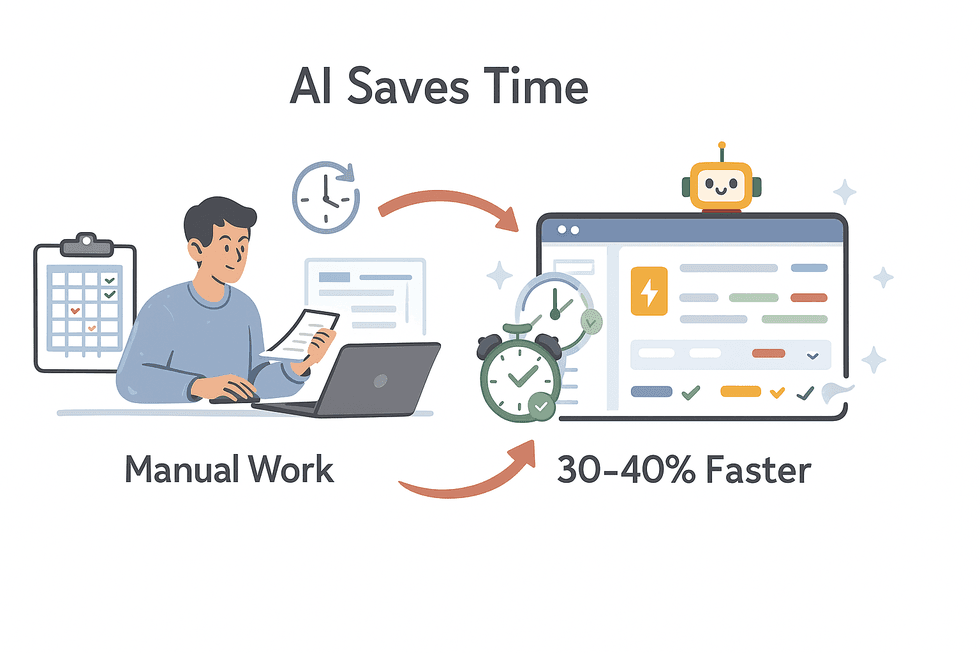 ผมเคยเห็นทีมประหยัดเวลาในการ ดึงข้อมูล ได้ 30–40% เพียงแค่เปลี่ยนมาใช้เครื่องมือที่ขับเคลื่อนด้วย AI (scrapingapi.ai). นั่นไม่ใช่แค่เพิ่มประสิทธิภาพ แต่มันคือความได้เปรียบในการแข่งขัน
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI Thunderbit's agentic web scraper อ่านเว็บไซต์ได้เองและเลือกฟิลด์ที่จะดึงให้อัตโนมัติทีละคลิก Get Started Free
Thunderbit ออกแบบมาเพื่อให้การ ดึงข้อมูล เป็นเรื่องง่าย แม่นยำ และเข้าถึงได้—even สำหรับคนที่ไม่เคยเขียนโค้ดเลยสักบรรทัด (และใช่ แม่ผมใช้ได้ด้วย ตอนนี้ยังเรียนรู้ Netflix อยู่ก็จริง)
Thunderbit Agentic Web Scraper: ฟีเจอร์สำคัญสำหรับผู้ใช้ธุรกิจ
ขออวดนิดหนึ่งว่าเราสร้างอะไรกันไว้ที่ Thunderbit (ก็ต้องขออนุญาตอวดหน่อยใช่ไหม?) Thunderbit ถูกออกแบบมาสำหรับผู้ใช้ธุรกิจ—ฝ่ายขาย ปฏิบัติการ การตลาด อสังหาริมทรัพย์—ที่ต้องการผลลัพธ์ ไม่ใช่ปัญหา นี่คือสิ่งที่ทำให้โดดเด่น:
- One Click Extract: คลิกครั้งเดียว แล้ว AI ของ Thunderbit จะสแกนหน้าเว็บ แนะนำคอลัมน์ และตั้งค่าสแครปเปอร์ให้คุณ ไม่ต้องมานั่งจิ้ม selector อีก
- 2-Click Scraping: เมื่อกำหนดฟิลด์เรียบร้อยแล้ว แค่กด “Scrape” ก็ได้ตารางที่สะอาดทันที—ไม่ต้องเขียนโค้ด ไม่ต้องตั้งค่าเพิ่ม
- Subpage Scraping: ถ้าต้องการรายละเอียดเพิ่ม Thunderbit สามารถเข้าไปยังหน้าย่อยแต่ละหน้าโดยอัตโนมัติ เช่น หน้าสินค้าหรือหน้าโปรไฟล์ แล้วเติมข้อมูลเสริมลงในตารางให้
- เทมเพลตสำเร็จรูป: สำหรับเว็บไซต์ยอดนิยมอย่าง Amazon, Zillow, Instagram, Shopify ฯลฯ แค่เลือกเทมเพลตแล้วเริ่มได้เลย—ไม่ต้องตั้งค่า
- ส่งออกได้ทุกที่: ส่งออกฟรีไปยัง Excel, Google Sheets, Airtable, Notion หรือ CSV ไม่มีค่าใช้จ่ายแอบแฝง
- Scheduled Scraping: ทำงานสแครปซ้ำอัตโนมัติ—แค่บอกความถี่ เช่น “ทุกวันจันทร์ 8 โมงเช้า” แล้ว Thunderbit จัดการต่อให้
- Scrape ผ่านคลาวด์หรือเบราว์เซอร์: ใช้เซิร์ฟเวอร์คลาวด์ของ Thunderbit เพื่อความเร็ว หรือใช้เบราว์เซอร์ของคุณเองสำหรับเว็บไซต์ที่ต้องล็อกอิน
- รองรับหลายภาษา: สแครปได้ 34 ภาษา รวมถึงอังกฤษ สเปน จีน และอีกมากมาย
ทดลองใช้ Thunderbit Agentic Web Scraper ฟรี แพลนฟรีครอบคลุม 6 หน้า/เดือน ไม่ต้องใช้บัตรเครดิต — เหมาะสำหรับทดสอบการ ดึงข้อมูล จากเว็บเป้าหมายของคุณ Get Started Free
ทำให้ทำงานอัตโนมัติและขยายสเกล: ใช้การตั้งเวลาและเครื่องมือเชื่อมต่อเพื่อ ดึงข้อมูล
การสแครปด้วยมือคือเรื่องของปี 2015 แล้ว คุณค่าจริงอยู่ตรงที่คุณทำให้การ ดึงข้อมูล เป็นอัตโนมัติและผสานเข้าไปในเวิร์กโฟลว์ของคุณ:
- Scheduled Scraping: ตั้ง Thunderbit ให้รันงานทุกวัน ทุกสัปดาห์ หรือช่วงเวลาใดก็ได้ตามต้องการ เหมาะมากสำหรับการติดตามราคา การหา leads หรือการรวมข่าว
- เชื่อมต่อโดยตรง: ส่งออกข้อมูลที่สแครปมาไปยัง Google Sheets, Excel, Airtable หรือ Notion ได้ทันที ไม่ต้องดาวน์โหลดแล้วอัปโหลดใหม่
- เชื่อมกับ CRM และ Analytics: ส่งข้อมูลเข้า CRM หรือเครื่องมือ BI เพื่อแดชบอร์ดเรียลไทม์ แจ้งเตือน หรือเริ่ม outreach อัตโนมัติ
ตัวอย่าง: เวิร์กโฟลว์ติดตามราคาแบบอัตโนมัติ
- ตั้ง Thunderbit บนหน้าสินค้าของคู่แข่ง
- ใช้ “One Click Extract” เพื่อดึงชื่อสินค้า ราคา และ URL
- ตั้งให้สแครปทุกเช้าเวลา 7 โมง
- ส่งผลลัพธ์ไปยัง Google Sheets ที่เชื่อมกับแดชบอร์ด
- ผู้จัดการด้านราคาเช็กการเปลี่ยนแปลงและปรับกลยุทธ์ก่อนที่คู่แข่งจะตื่น
เมื่อมีระบบอัตโนมัติ คุณไม่ได้แค่เร็วขึ้น—แต่คุณอัปเดตอยู่เสมอ
แนวปฏิบัติที่ดีที่สุดในการจัดการข้อมูลไม่มีโครงสร้างเมื่อ ดึงข้อมูล จาก เว็บไซต์
เอาตรง ๆ เลย: ข้อมูลเว็บส่วนใหญ่ไม่ได้สวยงามเป็นระเบียบ มันไม่มีโครงสร้าง ไม่สม่ำเสมอ และบางทีก็แปลกแบบสุด ๆ นี่คือวิธีจัดการให้เข้ารูปเข้ารอย:
- ให้ AI กำหนดโครงสร้าง: ใช้ One Click Extract หรือเทมเพลตเพื่อสร้างระเบียบ—AI จะคิดคอลัมน์และชนิดข้อมูลให้ แล้วค่อยปรับทีหลังถ้าจำเป็น
- Field AI Prompts: Thunderbit ให้คุณใส่คำสั่งเฉพาะของแต่ละฟิลด์ได้ อยากจัดหมวดหมู่สินค้า ฟอร์แมตเบอร์โทร หรือแปลคำอธิบาย? บอก AI ได้เลย
- ใช้ NLP ให้คุ้ม: สำหรับรีวิว ความเห็น หรือบทความ ให้ใช้ฟีเจอร์ NLP ในตัวเพื่อสรุป ให้คะแนนอารมณ์ หรือดึงคีย์เวิร์ด
- ทำข้อมูลให้เป็นมาตรฐานเดียวกัน: จัดรูปแบบวันที่ ราคา เบอร์โทร ให้เรียบร้อยตั้งแต่ตอนสแครป ไม่ใช่ค่อยไปแก้ทีหลัง ความสม่ำเสมอคือหัวใจ
- ลบข้อมูลซ้ำและตรวจสอบ: ลบรายการที่ซ้ำและสุ่มตรวจผลลัพธ์เพื่อความแม่นยำ ถ้ามีอะไรดูแปลก ให้ปรับ prompt หรือการตั้งค่า
Field AI Prompts: ปรับแต่งการ ดึงข้อมูล ให้ได้ผลลัพธ์ดีกว่า
นี่เป็นหนึ่งในฟีเจอร์ที่ผมชอบที่สุด ด้วย field-level AI prompts คุณสามารถ:
- ติดป้ายและจัดหมวดหมู่: “จัดสินค้านี้เป็น Electronics, Furniture หรือ Clothing จากคำอธิบายของมัน”
- บังคับรูปแบบ: “แสดงวันที่ในรูปแบบ YYYY-MM-DD” “ดึงเฉพาะราคาที่เป็นตัวเลข”
- แปลระหว่างสแครป: “แปลคำอธิบายสินค้าเป็นภาษาอังกฤษ”
- เก็บกวาดสัญญาณรบกวน: “ดึง bio ของผู้ใช้ โดยไม่รวมลิงก์ ‘Read more’ หรือโฆษณา”
- รวมหลายฟิลด์: “รวมที่อยู่หลายบรรทัดให้เป็นฟิลด์เดียว”
มันเหมือนมีนักวิเคราะห์รุ่นน้องติดอยู่ในสแครปเปอร์ของคุณ—แถมไม่เคยบ่นเรื่องพักกาแฟ
ทำให้ข้อมูลมีคุณภาพและสม่ำเสมอในการ ดึงข้อมูล จาก เว็บไซต์
การ ดึงข้อมูล ที่ดีไม่ได้จบแค่ตอนกด “Export” นี่คือวิธีทำให้ข้อมูลของคุณสะอาดและเชื่อถือได้:
- การตรวจสอบความถูกต้อง: ใช้การเช็กช่วงค่า ฟิลด์ที่จำเป็น และคีย์ที่ไม่ซ้ำกันเพื่อตรวจจับข้อผิดพลาด
- สุ่มตรวจตัวอย่าง: ตรวจข้อมูลที่สแครปมาเทียบกับเว็บไซต์ต้นทางด้วยตนเอง โดยเฉพาะหลังตั้งค่าใหม่หรือเมื่อเว็บไซต์เปลี่ยน
- จัดการข้อผิดพลาด: บันทึกงานสแครปที่ล้มเหลว และตั้งการแจ้งเตือนเมื่อมีความผิดปกติ เช่น จำนวนแถวลดลงแบบผิดปกติ
- ทำความสะอาดอย่างต่อเนื่อง: ใช้เครื่องมือสเปรดชีตหรือสคริปต์เพื่อตัดช่องว่าง แก้ encoding และทำให้ข้อความเป็นมาตรฐาน
- รักษา schema ให้คงที่: ชื่อฟิลด์และรูปแบบควรเสถียรตลอดเวลา และควรบันทึกการเปลี่ยนแปลงไว้เพื่อให้ทีมไม่ต้องเดา
ความเชื่อมั่นในข้อมูลคือทุกอย่าง ความละเอียดรอบคอบตั้งแต่ต้นช่วยลดปัญหาได้มากในภายหลัง
ดูว่า Thunderbit เปรียบเทียบอย่างไร ดูว่า การดึงข้อมูล แบบคลิกเดียวด้วย AI ของ Thunderbit อยู่ตรงไหนเมื่อเทียบกับเครื่องมือเว็บสแครปเปอร์อื่น ๆ ในตลาด Get Started Free
เปรียบเทียบเครื่องมือ ดึงข้อมูล: ควรมองหาอะไรเมื่อเลือกโซลูชัน
เครื่องมือเว็บสแครปปิงไม่ได้เหมือนกันทั้งหมด นี่คือสิ่งที่ควรพิจารณา:
| เครื่องมือ | จุดแข็ง | ข้อควรพิจารณา |
|---|---|---|
| Thunderbit | ใช้งานง่ายที่สุดสำหรับคนไม่สายเทคนิค; ตรวจจับฟิลด์ด้วย AI; สแครปหน้าย่อย; เทมเพลตสำเร็จรูป; ส่งออกฟรี; แพ็กเกจราคาเข้าถึงได้ (Thunderbit Blog). | ไม่ได้ออกแบบมาสำหรับโปรเจกต์ขนาดใหญ่มากที่เน้นนักพัฒนาหนัก ๆ; ใช้ระบบเครดิต |
| Browse AI | ไม่ต้องเขียนโค้ด, เหมาะกับการเฝ้าดูการเปลี่ยนแปลง; เชื่อม Google Sheets; ดึงข้อมูลจำนวนมากได้ | แพ็กเกจเริ่มต้นค่อนข้างแพง; การตั้งค่าอาจใช้เวลาพอสมควร |
| Octoparse | ทรงพลัง รองรับเว็บไซต์ไดนามิก; ฟีเจอร์ขั้นสูงสำหรับผู้ใช้สายเทคนิค | เรียนรู้ยาก; ราคาสูงกว่า |
| Web Scraper (webscraper.io) | ฟรีสำหรับโปรเจกต์เล็ก ๆ; ตั้งค่าแบบภาพ; ชุมชนแข็งแรง | การตั้งค่าด้วยมืออาจสับสน; ความช่วยเหลือจาก AI มีจำกัด |
| Diffbot | ขับเคลื่อนด้วย AI, แยกวิเคราะห์หน้าเว็บที่ไม่มีโครงสร้างผ่าน API; เหมาะกับนักพัฒนา | ราคาแพง, ใช้งานผ่าน API, ไม่เหมาะกับผู้ใช้ที่ไม่ถนัดเทคนิค |
คำแนะนำของผม: ถ้าคุณเป็นผู้ใช้ธุรกิจที่ต้องการผลลัพธ์เร็วและแม่นยำ Thunderbit เหมาะมาก สำหรับ power user หรือนักพัฒนา Octoparse หรือ Diffbot อาจคุ้มค่ากว่าถ้าคุณรับความซับซ้อนเพิ่มได้ และควรลองแพ็กเกจฟรีหรือช่วงทดลองใช้ก่อนตัดสินใจเสมอ
สรุป: นำแนวปฏิบัติที่ดีที่สุดในการ ดึงข้อมูล เว็บไซต์ ไปใช้จริง
การ ดึงข้อมูล จาก เว็บไซต์ ไม่ใช่เรื่อง “มีก็ดี” อีกต่อไป—แต่มันจำเป็นสำหรับทุกธุรกิจที่อยากแข่งขันได้ นี่คือสิ่งที่ผมหวังว่าคุณจะได้กลับไป:
- คุณค่า: ข้อมูลเว็บช่วยให้การตัดสินใจฉลาดและเร็วขึ้น อย่าปล่อยให้มันสูญเปล่า
- เอาชนะความท้าทาย: ใช้เครื่องมือ AI เพื่อรับมือกับข้อมูลไม่มีโครงสร้าง ปริมาณมาก และการเปลี่ยนแปลงของเว็บไซต์
- ทำให้ถูกกฎหมาย: เคารพกฎหมายความเป็นส่วนตัว กฎของเว็บไซต์ และความปลอดภัยของข้อมูล
- ทำอัตโนมัติ: ตั้งเวลาและผสานการ ดึงข้อมูล เข้ากับงานประจำวัน
- คุณภาพต้องมาก่อน: ตรวจสอบ ทำความสะอาด และเฝ้าดูข้อมูลของคุณอย่างต่อเนื่อง
พร้อมดูแล้วหรือยังว่ามันง่ายแค่ไหน? ดาวน์โหลด Thunderbit Chrome Extension แล้วลองกับโปรเจกต์ข้อมูลถัดไปของคุณ และถ้าอยากเจาะลึกกว่านี้ ลองเข้าไปที่ Thunderbit Blog เพื่อดูคู่มือ เคล็ดลับ และตัวอย่างจากโลกจริงเพิ่มเติม
ขอให้สแครปสนุก และขอให้ข้อมูลของคุณมีโครงสร้าง ถูกต้องตามข้อกำหนด และพร้อมใช้งานเสมอ
เริ่ม ดึงข้อมูล ด้วย Thunderbit ติดตั้งส่วนขยาย Chrome ฟรีของ Thunderbit แล้วเริ่ม ดึงข้อมูล แบบมีโครงสร้างจากทุกหน้าได้ในคลิกเดียว Get Started Free
คำถามที่พบบ่อย
1. การ ดึงข้อมูล จาก ทุกเว็บไซต์ ถูกกฎหมายไหม?
โดยทั่วไป การสแครปข้อมูลที่เปิดเผยสู่สาธารณะมักถูกกฎหมายในหลายเขตอำนาจศาล แต่คุณต้องหลีกเลี่ยงการข้ามล็อกอินหรือมาตรการรักษาความปลอดภัยเสมอ ตรวจ Terms of Service ของเว็บไซต์ และปฏิบัติตามกฎหมายความเป็นส่วนตัวอย่าง GDPR และ CCPA (xbyte.io).
2. AI ช่วยปรับปรุงกระบวนการ ดึงข้อมูล จาก เว็บไซต์ ได้อย่างไร?
เครื่องมือที่ขับเคลื่อนด้วย AI อย่าง Thunderbit สามารถตรวจจับฟิลด์อัตโนมัติ ปรับตามเลย์เอาต์ที่เปลี่ยนไป ทำความสะอาดและจัดรูปแบบข้อมูล รวมถึงจัดการคอนเทนต์แบบไดนามิกหรือการแปลภาษาได้—all ด้วยการตั้งค่าเพียงเล็กน้อยและความแม่นยำสูง (scrapingapi.ai).
3. แนวปฏิบัติที่ดีที่สุดสำหรับการจัดการข้อมูลไม่มีโครงสร้างคืออะไร?
กำหนดโครงสร้างข้อมูลไว้ล่วงหน้า ใช้ prompt ระดับฟิลด์เพื่อกำกับการ ดึงข้อมูล ทำให้รูปแบบเป็นมาตรฐานระหว่างสแครป และตรวจสอบผลลัพธ์ เครื่องมืออย่าง Thunderbit ช่วยให้จัดหมวดหมู่ จัดรูปแบบ และติดป้ายข้อมูลได้แบบเรียลไทม์
4. จะทำให้การ ดึงข้อมูล เว็บไซต์ เป็นอัตโนมัติและขยายสเกลได้อย่างไร?
ใช้ฟีเจอร์ตั้งเวลาเพื่อรันการสแครปเป็นช่วง ๆ และเชื่อมผลลัพธ์เข้ากับเครื่องมืออย่าง Google Sheets, Airtable หรือ CRM ของคุณโดยตรง ระบบอัตโนมัติช่วยให้ข้อมูลสดใหม่และลดงานมือ
5. จะทำอย่างไรให้มั่นใจในคุณภาพและความสม่ำเสมอของข้อมูลที่ดึงมา?
ใช้การตรวจสอบความถูกต้อง ตรวจสอบตัวอย่างเป็นประจำ รับมือข้อผิดพลาดอย่างเหมาะสม และรักษา schema ให้คงที่ตลอดเวลา การปรับปรุงและเฝ้าระวังอย่างต่อเนื่องคือกุญแจสำคัญของข้อมูลที่เชื่อถือได้
อยากเห็นแนวปฏิบัติเหล่านี้ใช้งานจริงไหม? ลองใช้ Thunderbit แพ็กเกจฟรี แล้วสัมผัสว่าการ ดึงข้อมูล เว็บที่ง่าย ถูกกฎหมาย และขยายสเกลได้เป็นอย่างไร
ลองใช้ Agentic Web Scraper Get Started Free
เรียนรู้เพิ่มเติม




