
แม้ Craigslist จะดูเหมือนแทบไม่เปลี่ยนจากยุคปี 2003 แต่ข้อมูลที่ซ่อนอยู่ในประกาศข้อความล้วน ๆ เหล่านี้กลับมีมูลค่าสูงอย่างน่าประหลาดใจ ด้วยยอดเข้าชมราว 127 ล้านครั้งต่อเดือน และ โพสต์ใหม่อีกหลายสิบล้านรายการในแต่ละเดือน ทำให้ Craigslist ยังคงเป็นหนึ่งในแพลตฟอร์มประกาศซื้อขายที่ใหญ่ที่สุดในสหรัฐฯ — และยังไม่มี API สาธารณะให้ใช้งานโดยตรง
ตลอดหลายปีที่ผ่านมา ฉันได้สร้างเครื่องมืออัตโนมัติที่ Thunderbit และสิ่งหนึ่งที่ได้ยินจากทีมขาย ทีมปฏิบัติการ และทีมอสังหาริมทรัพย์อยู่บ่อยมากก็คือ: "ผม/ฉันต้องการข้อมูล Craigslist ลงสเปรดชีต และไม่อยากนั่งก็อปปี้วางอยู่สามชั่วโมง" ปัญหาคือ คู่มือ "เว็บสแครปเปอร์ Craigslist ที่ดีที่สุด" ส่วนใหญ่ล้าสมัย ข้ามประเด็นสำคัญไป (เช่น การรับมือระบบป้องกันบอท) หรือแค่ลิสต์เครื่องมือเฉย ๆ โดยไม่ได้เปรียบเทียบจริงจัง
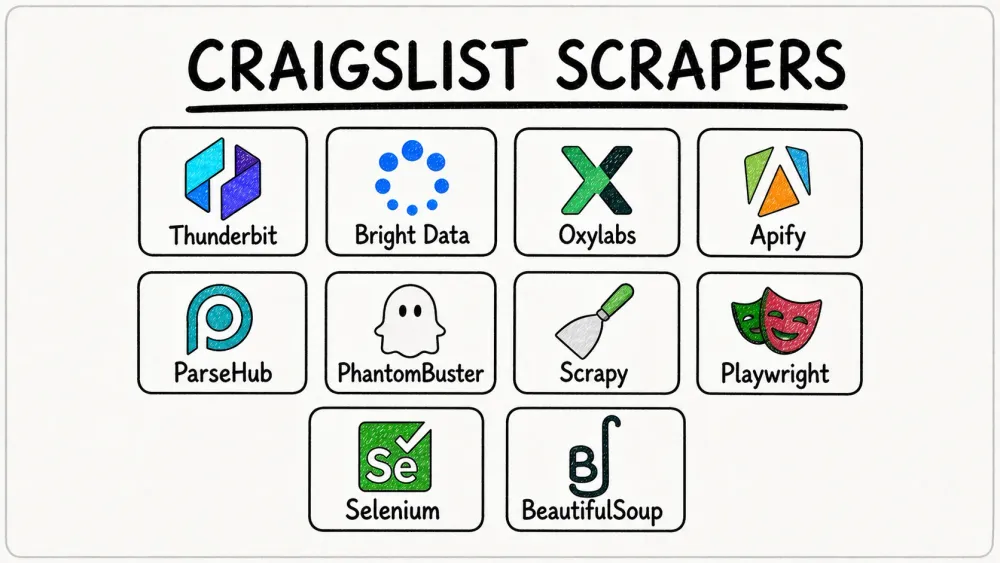
ดังนั้นฉันจึงรวบรวมคู่มือนี้ขึ้นมา โดยคัดมา 10 เครื่องมือที่ยังใช้งานได้จริงในปี 2026 — ตั้งแต่ Chrome extension แบบไม่ต้องเขียนโค้ด ไปจนถึงแพลตฟอร์มระดับองค์กร และไลบรารี Python แบบโอเพนซอร์ส ไม่ว่าคุณจะเป็นผู้ใช้งานธุรกิจที่ไม่เคยเขียนโค้ดสักบรรทัด หรือเป็นนักพัฒนาที่ถนัด Python ที่สุดในโลก ก็มีตัวเลือกที่เหมาะกับคุณ
ทำไมต้องสแครป Craigslist ในปี 2026? ตัวอย่างการใช้งานที่ทีมธุรกิจใช้จริง
Craigslist อาจดูคลาสสิกเก่า ๆ แต่ก็เป็นเสน่ห์และคุณค่าของมันเอง มันยังคงติดอันดับ #3 ของโลกในหมวดเว็บประกาศ และเปิดให้ใช้งานใน 416 พื้นที่ของสหรัฐฯ และเขตปกครอง ผ่านไดเรกทอรีอย่างเป็นทางการ นั่นหมายถึงสินค้าหรือโอกาสในระดับท้องถิ่นจำนวนมากที่หาไม่ได้จากที่เดียวแบบนี้ที่อื่น
นี่คือกรณีใช้งานที่ทีมต่าง ๆ กลับมาใช้ซ้ำแล้วซ้ำอีก:
- สร้างลีดขาย: ประกาศบริการและงานจ๊อบมักมีคำอธิบายธุรกิจ พื้นที่ และช่องทางติดต่อผ่านระบบ relay ของ Craigslist ซึ่งเพียงพอให้ทีมขายเอาไปสร้างรายชื่อลีดท้องถิ่นได้
- ติดตามตลาดอสังหาฯ: หน้าหมวดที่อยู่อาศัยแสดงค่าเช่า ย่าน จำนวนห้องนอน/ห้องน้ำ ตารางฟุต และเวลาประกาศ เหมาะมากสำหรับเทียบค่าเช่าและเช็กความพร้อมของห้อง
- เปรียบเทียบราคาคู่แข่ง: ประกาศขายสินค้าระบุชื่อเรื่อง ราคา สภาพ และทำเล ซึ่งมีค่าสูงมากสำหรับการทำรีเซลหรือศึกษาช่องทาง arbitrage
- สรรหาบุคลากรและติดตามตลาดแรงงาน: หมวด jobs และ gigs แสดงค่าตอบแทน ประเภทงาน และรายละเอียดบทบาท ช่วยสำรวจตลาดแรงงานในพื้นที่ได้
- วิเคราะห์ตลาดหลายภูมิภาค: เพราะ Craigslist แยกตามซับโดเมนและเมือง คุณจึงไล่ดูทีละภูมิภาคเพื่อวิเคราะห์ราคา ปริมาณ หรือสัดส่วนหมวดหมู่ได้
- ทำงานอัตโนมัติในเวิร์กโฟลว์: ผู้ใช้จำนวนมากแค่ต้องการให้ข้อมูล Craigslist ไหลเข้า CSV, Google Sheets, Airtable หรือ CRM โดยไม่ต้องเปิดเว็บไล่ดูทีละหน้า
มีผู้ใช้รายหนึ่งรายงานว่า งานสแครป Craigslist ที่เคยใช้เวลาวันละ 60–90 นาที ลดลงเหลือประมาณ 5 นาที เมื่อใช้ระบบอัตโนมัติ นี่แหละคือการประหยัดเวลาที่ทบต้นได้เร็วมาก
ดึงข้อมูล Craigslist ด้วย AI เว็บสแครปเปอร์แบบเอเจนต์ของ Thunderbit อ่านหน้าประกาศ Craigslist ด้วยตัวเอง และดึงราคา คำอธิบาย และข้อมูลติดต่อได้ในคลิกเดียว Get Started Free
เราคัดเลือกเว็บสแครปเปอร์ Craigslist ที่ดีที่สุดอย่างไร: เกณฑ์ที่ใช้ประเมิน
เว็บสแครปเปอร์ Craigslist ไม่ได้ดีเท่ากันทุกตัว และคำว่า "ดีที่สุด" ก็ขึ้นอยู่กับว่าคุณเป็นใครและต้องการอะไร ฉันประเมินแต่ละเครื่องมือตาม 6 มิติ:
- ความง่ายในการเริ่มใช้งาน — เป็นแบบมือใหม่ใช้ได้เลย (no-code) หรือจำเป็นต้องมีนักพัฒนา?
- การรับมือระบบป้องกันบอทของ Craigslist — มี proxy rotation, การจัดการ CAPTCHA หรือ browser fingerprinting มาให้ในตัวไหม?
- ระดับราคา — ฟรี, ฟรีบางส่วน, จ่าย, หรือระดับองค์กร?
- ตัวเลือกการส่งออกข้อมูล — CSV, Excel, Google Sheets, Airtable, Notion, JSON, ฐานข้อมูล?
- รองรับหลายภูมิภาคหรือไม่ — สแครปได้ครบทั้ง 416 ไซต์ของ Craigslist ในสหรัฐฯ หรือจำกัดแค่เมืองเดียว?
- ภาระในการดูแลรักษา — เครื่องมือพังเมื่อ Craigslist เปลี่ยนหน้าตาเว็บหรือปรับตัวอัตโนมัติได้?
ฉันยังไม่เจอบทความคู่แข่งชิ้นไหนที่เปรียบเทียบกันแบบเคียงข้างด้วยเกณฑ์เดียวกันอย่างนี้ — ถ้าคุณเบื่อกับลิสต์ "Top 10" ที่พูดกว้าง ๆ บทความนี้น่าจะตอบโจทย์
10 เว็บสแครปเปอร์ Craigslist ที่น่าสนใจที่สุดในภาพรวม
ก่อนลงลึกแต่ละเครื่องมือ นี่คือตารางเปรียบเทียบหลัก ฉันแบ่งออกเป็น 3 กลุ่ม: เครื่องมือ no-code สำหรับผู้ใช้ธุรกิจ แพลตฟอร์มระดับองค์กรสำหรับงานสเกลใหญ่ และไลบรารีโอเพนซอร์สสำหรับนักพัฒนา
| เครื่องมือ | ประเภท | มีฟรีไหม? | รองรับ Proxy / ระบบป้องกันบอท | จัดการ CAPTCHA | รูปแบบส่งออก | เหมาะกับใคร |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome extension แบบไม่ต้องเขียนโค้ด | ใช่ (6 หน้า/เดือน) | โหมดเบราว์เซอร์ (งานปริมาณปานกลางไม่ต้องใช้ proxy) | ไม่ระบุ (เซสชันเบราว์เซอร์) | Excel, Sheets, Airtable, Notion, CSV, JSON | ผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิค |
| Bright Data | เว็บสแครปเปอร์ + proxy + dataset ระดับองค์กร | ทดลองใช้ | จัดการการปลดบล็อก, proxy, ลองซ้ำ, เรนเดอร์หน้าเว็บ | ใช่ (แก้อัตโนมัติ) | JSON, NDJSON, CSV, Parquet, XLSX, API | เก็บข้อมูลปริมาณมากระดับองค์กร |
| Oxylabs | API + ชุด proxy | ทดลองใช้ | จัดการการปลดบล็อก, residential/ISP proxies | ใช่ | HTML, screenshot, เอาต์พุตผ่าน API | นักพัฒนาที่ต้องการโครงสร้างระดับองค์กร |
| Apify | แพลตฟอร์ม cloud actor marketplace | ใช่ (เครดิต $5/เดือน) | หมุน proxy ได้ (ขึ้นอยู่กับ actor) | บางส่วน / ขึ้นกับ actor | JSON, CSV, XML, Excel, JSONL | อัตโนมัติบนคลาวด์แบบยืดหยุ่น low-code |
| ParseHub | เว็บสแครปเปอร์แบบ visual no-code | ใช่ | หมุน proxy แบบจ่ายเพิ่ม, งานบนคลาวด์ | ไม่ใช่ฟีเจอร์หลัก | CSV, JSON, API/S3/Dropbox (แพ็กเกจจ่าย) | ผู้ใช้ no-code ที่งบจำกัด |
| Phantombuster | แพลตฟอร์มอัตโนมัติบนคลาวด์ | ใช่ (จำกัด) | มีรองรับ proxy | ใช้เครดิต / ทำงานตาม workflow | CSV, JSON (แพ็กเกจจ่าย) | อัตโนมัติการหาลีดบนหลายแพลตฟอร์ม |
| Scrapy | Python crawler แบบโอเพนซอร์ส | ฟรี (OSS) | ต้องใช้ proxy/middleware ของตัวเอง | ไม่รองรับ | JSON, JSONL, CSV, XML, DB | งาน crawler ระดับโปรดักชัน |
| Playwright | อัตโนมัติบราวเซอร์แบบโอเพนซอร์ส | ฟรี (OSS) | ต้องใช้ browser/proxy ของตัวเอง | ไม่รองรับ | ส่งออกแบบกำหนดเอง | ควบคุมระดับเบราว์เซอร์ |
| Selenium | อัตโนมัติบราวเซอร์แบบโอเพนซอร์ส | ฟรี (OSS) | ต้องใช้ browser/proxy ของตัวเอง | ไม่รองรับ | ส่งออกแบบกำหนดเอง | สแตกหลายภาษาแบบเดิม |
| BeautifulSoup | ตัว parser HTML แบบโอเพนซอร์ส | ฟรี (OSS) | ไม่มีในตัว | ไม่รองรับ | ส่งออกแบบกำหนดเอง | งาน parse แบบเบา ๆ |
จากตารางนี้เห็นภาพชัดว่ามี 3 กลุ่มหลัก:
- เครื่องมือ no-code (Thunderbit, ParseHub, Phantombuster) สำหรับผู้ใช้ธุรกิจที่อยากได้ข้อมูลโดยไม่ต้องแบกภาระด้านวิศวกรรม
- แพลตฟอร์มระดับองค์กร (Bright Data, Oxylabs, Apify) สำหรับทีมที่ต้องการสเกล ระบบป้องกันบอท และการส่งมอบที่มีการจัดการให้
- เครื่องมือโอเพนซอร์สสำหรับนักพัฒนา (Scrapy, Playwright, Selenium, BeautifulSoup) สำหรับคนที่อยากได้การควบคุมสูงสุด — แต่ต้องแลกกับการตั้งค่า การดูแลรักษา และการจัดการ proxy เอง
เอาล่ะ มาดูแบบเจาะลึกกัน
1. Thunderbit
 Thunderbit คือ Chrome extension ที่ขับเคลื่อนด้วย AI ออกแบบมาสำหรับคนที่อยากได้ข้อมูลที่มีโครงสร้างจากทุกเว็บไซต์ — รวมถึง Craigslist — โดยไม่ต้องเขียนโค้ดหรือเซ็ต proxy
ยอมรับตรง ๆ ว่าเราเป็นคนสร้างมันขึ้นมา แต่เหตุผลที่ฉันวาง Thunderbit ไว้อันดับแรก คือมันแก้ pain point เฉพาะทางของการสแครป Craigslist สำหรับผู้ใช้ที่ไม่ถนัดเทคนิคได้ตรงจุด: เลย์เอาต์แต่ละหมวดไม่เหมือนกัน การเสริมข้อมูลจากหน้ารายละเอียด และปัญหาที่พังบ่อยเมื่อ CSS selector เปลี่ยน
วิธีใช้กับ Craigslist:
- ติดตั้ง Thunderbit Chrome Extension แล้วเปิดหน้า listings ของ Craigslist ใดก็ได้ เช่น อพาร์ตเมนต์ในเมืองของคุณ
- คลิก "One Click Extract" — AI ของ Thunderbit จะอ่านหน้าเว็บ ทำความเข้าใจโครงสร้าง ตัดสินใจว่าคอลัมน์ไหนเหมาะ แล้วดึงข้อมูลลงตารางในครั้งเดียว สำหรับหมวดที่อยู่อาศัย คุณจะได้ Title, Price, Sqft, Bedrooms, Location, Date Posted, Link ส่วนหมวดงานจะได้ Title, Compensation, Job Type ฯลฯ โดยไม่ต้องกำหนด selector เอง
- จัดการ pagination — Thunderbit ใช้งานได้กับการเปลี่ยนหน้าด้วยการคลิกของ Craigslist
- ใช้ "Scrape Subpages" เพื่อเข้าไปดูแต่ละประกาศ แล้วดึงฟิลด์เฉพาะหน้ารายละเอียด เช่น คำอธิบายฉบับเต็ม รูปภาพทั้งหมด และข้อมูลติดต่อที่ฝังอยู่
- ส่งออกไป Google Sheets, Excel, Airtable, Notion หรือ CSV — ฟรี
ฟีเจอร์เด่น:
- ตรวจจับฟิลด์ด้วย AI: ปรับตัวเข้ากับแต่ละหมวดของ Craigslist อัตโนมัติ — housing ได้คอลัมน์ sqft/bedrooms, jobs ได้ compensation/job type, for-sale ได้ condition/price ไม่ต้องแตะ CSS เอง
- สแครปหน้าลูก (subpage scraping): หลังจากดึงผลลัพธ์จากหน้ารวมแล้ว เข้าไปเก็บข้อมูลจากแต่ละประกาศเพื่อเอาฟิลด์เฉพาะหน้ารายละเอียด
- โหมดสแครปบนเบราว์เซอร์: ทำงานใน Chrome session ของคุณเอง จึงไม่ต้องใช้ proxy สำหรับงานปริมาณไม่มาก ข้อดีคือประหยัดต้นทุนและลดความซับซ้อนได้เยอะ
- ดูแลรักษาแทบเป็นศูนย์: AI อ่านหน้าใหม่ทุกครั้ง เมื่อ Craigslist เปลี่ยนเลย์เอาต์ เครื่องมือก็ไม่พัง
- ส่งออกฟรี: Excel, Google Sheets, Airtable, Notion, CSV, JSON — ไม่มีการล็อกฟีเจอร์ส่งออก
ราคา: แผนฟรี (6 หน้า/เดือน), ทดลองฟรี (10 หน้า), และ แพ็กเกจแบบจ่ายเงิน สำหรับงานปริมาณสูงขึ้น
เหมาะกับ: ทีมขายที่สแครปลีดจาก Craigslist หมวด services/gigs, ทีมอสังหาฯ ที่ติดตามราคาเช่า, ทีมปฏิบัติการที่ต้องการข้อมูล Craigslist แบบมีโครงสร้างโดยไม่ต้องพึ่งนักพัฒนา และทุกคนที่อยากสแครป ติดป้าย และส่งออกข้อมูลในขั้นตอนเดียว
ลอง Thunderbit สำหรับสแครป Craigslist แผนฟรีครอบคลุม 6 หน้า/เดือน — เพียงพอสำหรับทดสอบการสแครป Craigslist ก่อนตัดสินใจอัปเกรด Get Started Free
2. Bright Data
 Bright Data คือยักษ์ใหญ่สายองค์กร และเป็นแพลตฟอร์มเดียวในลิสต์นี้ที่มีทั้งหน้าโปรดักต์ Craigslist Scraper โดยเฉพาะ และ Craigslist Dataset ใน marketplace
ถ้าคุณต้องดึงประกาศ Craigslist หลายพันรายการต่อวันจากทุกภูมิภาคในสหรัฐฯ Bright Data ถูกสร้างมารองรับสเกลแบบนั้นโดยตรง Web Unlocker ของมันจัดการ IP, การลองซ้ำ, การเรนเดอร์ และการบล็อก — รวมถึง แก้ CAPTCHA อัตโนมัติเป็นค่าเริ่มต้น Web Scraper IDE ช่วยให้สร้าง workflow เก็บข้อมูล Craigslist แบบกำหนดเอง และคุณสามารถวนลูปผ่าน URL ระดับภูมิภาคทั้ง 416 แห่งได้ด้วยโปรแกรม
ฟีเจอร์เด่น:
- เครือข่าย residential proxy ขนาดใหญ่มาก (IP หลายล้าน)
- มีระบบแก้ CAPTCHA และหลบระบบป้องกันบอทในตัว
- มีโปรดักต์ scraper และ dataset สำหรับ Craigslist โดยเฉพาะ
- ส่งออกได้: JSON, NDJSON, CSV, Parquet, XLSX, ส่งผ่าน API, webhooks
ราคา: Craigslist scraper คิดที่ 0.5 ดอลลาร์ต่อ 1K page loads แบบ pay-as-you-go และมีแพ็กเกจเช่น 380K page loads ในราคา $499 ส่วน residential proxies เริ่มที่ 4 ดอลลาร์/GB แบบจ่ายตามการใช้งาน มีทดลองใช้ฟรี 1,000 requests เป็นเวลา 1 สัปดาห์
เหมาะกับ: ทีมระดับองค์กรที่ต้องเก็บข้อมูล Craigslist ปริมาณสูง หลายภูมิภาค และต้องการ uptime ที่เชื่อถือได้พร้อมซัพพอร์ตโดยเฉพาะ ทีมเล็กที่คุมงบเข้ม ๆ ควรมองตัวเลือกอื่น
3. Oxylabs
 Oxylabs คือผู้ให้บริการโครงสร้างพื้นฐาน proxy และ scraping ระดับพรีเมียม พร้อม Craigslist Scraper API และหน้า Craigslist proxies โดยเฉพาะ
Oxylabs ออกแนวนักพัฒนามากกว่าแนว all-in-one ของ Bright Data Web Scraper API และ Web Unblocker รองรับ JS rendering, retry, session handling, การสร้าง fingerprint และการรับมือ anti-bot ที่กว้างกว่า ทดลองใช้ฟรีของ Craigslist Scraper API ไปได้ถึง 2,000 results
ฟีเจอร์เด่น:
- residential และ ISP proxy pools (residential เริ่ม 6 ดอลลาร์/GB, ISP เริ่ม 0.60 ดอลลาร์/IP)
- Web Unblocker พร้อม auto fingerprint และการจัดการ session
- API endpoint สำหรับ Craigslist โดยเฉพาะ
- มีทดลองใช้ 7 วัน
ราคา: Scraper API สำหรับเว็บอื่น ๆ เริ่มราว 0.15 ดอลลาร์/1K results แบบไม่ใช้ JS และ 0.35 ดอลลาร์/1K เมื่อใช้ JS ส่วน Web Unblocker แพ็กเกจเล็กเริ่มประมาณ 75 ดอลลาร์/เดือน residential proxies ในสเกลใหญ่คิดได้ราว 0.50 ดอลลาร์/GB ที่ระดับ 1TB
เหมาะกับ: ทีมพัฒนาที่อยากได้โครงสร้าง proxy แบบ managed และ workflow แบบ API สำหรับงานสแครป Craigslist ต่อเนื่อง ทีมที่ใช้งาน Oxylabs อยู่แล้วกับโปรเจกต์อื่นจะเพิ่ม Craigslist เข้าไปได้ง่ายมาก
4. Apify
 Apify คือแพลตฟอร์มสแครปและอัตโนมัติบนคลาวด์ที่มี marketplace ของ "Actors" สำเร็จรูป — เทมเพลตสแครปที่รันได้โดยไม่ต้องเขียนโค้ด
ภาพรวมของ Craigslist บน Apify ค่อนข้างน่าสนใจ: มี actor ของชุมชนหลายตัวที่ดูแลโดยคนละระดับคุณภาพกันมาก actor ivanvs/craigslist-scraper มีผู้ใช้รวม 829 คนและคะแนน 5.0 ขณะที่ automation-lab/craigslist-scraper มีผู้ใช้ 44 คนและคะแนน 1.0 คุณภาพไม่สม่ำเสมอ ดังนั้นควรลองก่อนตัดสินใจใช้งานจริง
ฟีเจอร์เด่น:
- มี actor สำหรับ Craigslist หลายตัว (บางตัวดึงได้ ประมาณ 120 listings ต่อหน้า พร้อมดีเลย์ในตัว)
- รันบนคลาวด์ ตั้งเวลาได้ เชื่อม API และ webhook ได้
- มี proxy rotation
- ส่งออกได้: JSON, CSV, XML, Excel, JSONL
ราคา: แผนฟรีพร้อมเครดิต $5/เดือน และแพ็กเกจเริ่มราว ~$49/เดือน การคิดราคาตาม compute อาจพุ่งได้ถ้าใช้งานหนัก — ควรดูการใช้ CU ให้ดี
เหมาะกับ: ทีมที่อยากได้โซลูชันบนคลาวด์โดยไม่ต้องดูแล infra เอง ผู้ใช้ที่ถนัด low-code และทีมที่ต้องสแครป Craigslist แบบตั้งเวลาเป็นรอบ ๆ
5. ParseHub
 ParseHub คือเครื่องมือสแครปเว็บแบบ visual บนเดสก์ท็อป ที่ให้คุณคลิกเลือกองค์ประกอบบนหน้าเว็บเพื่อกำหนดว่าต้องการดึงอะไร
การตั้งค่าสแครป Craigslist ใน ParseHub ทำได้โดยคลิกที่ชื่อประกาศ ราคา และลิงก์ เพื่อสอนเครื่องมือว่าต้องเก็บอะไร มันรองรับ pagination ผ่าน AJAX click loops และรองรับการรันบนคลาวด์ในแพ็กเกจจ่ายเงิน แผนฟรีให้ได้ถึง 5 โปรเจกต์ ซึ่งถือว่าโอเคสำหรับงาน Craigslist ขนาดเล็ก
ฟีเจอร์เด่น:
- ตัวสร้าง workflow แบบ visual point-and-click
- รองรับ pagination และเนื้อหาแบบ dynamic
- รันบนคลาวด์และตั้งเวลาได้ในแพ็กเกจจ่ายเงิน
- ส่งออกได้: CSV, Excel, JSON
ราคา: แผนฟรี (5 โปรเจกต์) และแพ็กเกจจ่ายเงินเริ่มราว ~$189/เดือน สำหรับจำนวนหน้าและการตั้งเวลาที่มากขึ้น
ข้อจำกัด: อาจช้าเมื่อต้องสแครปจำนวนมาก รองรับ scheduled runs จำกัดในแผนฟรี และที่สำคัญคือมันอาศัย CSS selector จึงต้องดูแลปรับเองเมื่อ Craigslist เปลี่ยนเลย์เอาต์
เหมาะกับ: ผู้ใช้รายบุคคลหรือทีมเล็กที่ต้องการเครื่องมือ no-code แบบเห็นภาพ และมีความต้องการสแครประดับปานกลาง โดยไม่จำเป็นต้องใช้ AI ตรวจจับฟิลด์
6. Phantombuster
 Phantombuster คือแพลตฟอร์มอัตโนมัติบนคลาวด์ที่เดิมดังมากในสาย LinkedIn และ social media scraping มันไม่ใช่เครื่องมือที่เกิดมาเพื่อ Craigslist โดยตรง แต่ Web Element Extractor ของมันสามารถดึงข้อมูลจากหน้า public ด้วย CSS selectors ได้
การตั้งค่าสแครป Craigslist ใน Phantombuster ต้องทำมากกว่าเครื่องมือเฉพาะทาง — คุณต้องระบุ selectors สร้าง workflow และตั้ง schedule เอง แต่ถ้าคุณใช้งาน Phantombuster สำหรับ LinkedIn หรือ social media lead gen อยู่แล้ว การเพิ่ม Craigslist เข้าไปใน pipeline ก็ไม่ยาก
ฟีเจอร์เด่น:
- เทมเพลตอัตโนมัติสำเร็จรูปและรันบนคลาวด์
- ตั้งเวลาและเชื่อม CRM ได้
- มี proxy support และเครดิตสำหรับแก้ CAPTCHA
- ส่งออกได้: CSV, JSON เฉพาะแพ็กเกจจ่าย (แผนฟรีจำกัดที่ 10 แถว)
ราคา: แผนฟรีมี 5 slots, 2 ชั่วโมง/เดือน และจำกัดส่งออก 10 แถว แพ็กเกจรายปีแบบจ่ายเงินเริ่มราว ~$56/เดือน เมื่อชำระเป็นรายปี
เหมาะกับ: ทีมขายที่ใช้งาน Phantombuster อยู่แล้วสำหรับการหา lead หลายแพลตฟอร์ม และอยากเพิ่ม Craigslist เข้าไปในเวิร์กโฟลว์เดิม
7. Scrapy
 Scrapy คือเฟรมเวิร์กเว็บสแครป Python แบบโอเพนซอร์สที่ได้รับความนิยมที่สุด และเป็นตัวเลือกชัดเจนสำหรับทีมพัฒนาที่ต้องการควบคุมการครอว์ล Craigslist ได้เต็มที่
เวอร์ชันเสถียรล่าสุดคือ 2.15.0 (9 เมษายน 2026) Scrapy รองรับการครอว์ลหลายภูมิภาค (วนผ่าน URL ของทุกพื้นที่), มีระบบจัดคิวและควบคุมอัตราการร้องขอในตัว, มี downloader middleware สำหรับหมุน proxy, และมี feed exports ไปยัง CSV, JSON, JSONL, XML และ pipeline ฐานข้อมูล ปลั๊กอิน scrapy-playwright ช่วยเพิ่มการเรนเดอร์แบบเบราว์เซอร์เมื่อจำเป็น
ฟีเจอร์เด่น:
- ปรับแต่งได้สูง ระดับ production
- middleware สำหรับ proxies, retries, cookies และการหมุน user-agent
- ส่งออก feed: JSON, JSONL, CSV, XML และ pipeline ฐานข้อมูล
- ฟรีและโอเพนซอร์ส
ต้นทุนแฝง: ตัว Scrapy เองใช้ฟรี แต่ถ้าจะรันในสเกลใหญ่บน Craigslist จะมีค่า proxy ($50–500+/เดือน), ค่า hosting/server และค่าดูแลต่อเนื่องเมื่อ Craigslist เปลี่ยนโครงสร้าง HTML
เหมาะกับ: ทีมพัฒนาที่มีประสบการณ์ Python ต้องการความยืดหยุ่นสูง มีโครงสร้าง proxy อยู่แล้ว และต้องครอว์ล Craigslist หลายภูมิภาคในปริมาณมาก
8. Playwright
 Playwright คือไลบรารีอัตโนมัติบราวเซอร์สมัยใหม่จาก Microsoft ที่ควบคุม Chromium, Firefox และ WebKit ได้ด้วยโปรแกรม เวอร์ชันล่าสุดยังปล่อยต่อเนื่อง — v1.59.1 ออกเมื่อ 1 เมษายน 2026
ในชุมชนนักพัฒนา ปี 2026 เริ่มมองว่า Playwright เป็นตัวเลือกที่แนะนำมากกว่า Selenium สำหรับการสแครป Craigslist เพราะเร็วกว่า เสถียรกว่า และมีความ stealth ต่อระบบตรวจจับบอทดีกว่า โดยเฉพาะเมื่อใช้ปลั๊กอินอย่าง playwright-extra มันรองรับทั้งโหมด headless และแบบเปิดหน้าต่าง, auto-wait สำหรับ elements, network interception และการจับ screenshot/PDF
ฟีเจอร์เด่น:
- รองรับ Python, JavaScript/TypeScript, Java และ .NET
- โหมดเบราว์เซอร์ทั้ง headless และ headed
- auto-wait สำหรับ elements, network interception
- ฟรีและโอเพนซอร์ส
ข้อได้เปรียบกับ Craigslist: Playwright เลียนแบบพฤติกรรมผู้ใช้จริงได้แนบเนียนกว่า HTTP request ตรง ๆ ซึ่งช่วยลดความเสี่ยงในการถูกบล็อก ความเห็นใน Reddit ของชุมชนมักเทไปทาง Playwright มากกว่า Selenium สำหรับโปรเจกต์ใหม่ ๆ
ต้นทุนแฝง: เหมือน Scrapy — ต้องมี proxy, hosting และค่าดูแลเมื่อ selector พัง
เหมาะกับ: นักพัฒนาที่ต้องการควบคุมระดับเบราว์เซอร์อย่างละเอียด ทีมที่ทำสแครปเนื้อหาแบบ JavaScript-rendered และคนที่อยากใช้ทางเลือกใหม่แทน Selenium
9. Selenium
 Selenium คือเฟรมเวิร์กอัตโนมัติบราวเซอร์ที่อยู่คู่สายงานมานานและถูกใช้อย่างแพร่หลาย เวอร์ชันล่าสุดคือ 4.43.0 (10 เมษายน 2026) และยังคงขยายความสามารถด้าน BiDi และ network control
Selenium รองรับหลายภาษา (Python, Java, C#, JavaScript) และเบราว์เซอร์หลักทั้งหมด มันจำลอง session บราวเซอร์เต็มรูปแบบได้ จัดการล็อกอินถ้าจำเป็น และเลื่อนหน้าเว็บได้ แต่เมื่อเทียบกับ Playwright แล้ว มันช้ากว่า พูดเยอะกว่า และโดนตรวจจับว่าเป็นบอทง่ายกว่า หากไม่มีไลบรารี stealth เพิ่มเติมอย่าง undetected-chromedriver
ฟีเจอร์เด่น:
- รองรับหลายภาษา (Python, Java, C#, JavaScript)
- จำลอง session บราวเซอร์เต็มรูปแบบ
- ecosystem เก่าแก่และเอกสารเยอะ
- ฟรีและโอเพนซอร์ส
ข้อจำกัด: ชุมชนในปี 2026 มักเอนเอียงไปทาง Playwright สำหรับโปรเจกต์เริ่มใหม่ มีโพสต์หนึ่งใน Reddit ระบุว่า Cloudflare ยังตรวจจับ Selenium ได้ "แม้ใช้ residential proxies" — เรื่อง stealth แบบพร้อมใช้จึงยากกว่า
เหมาะกับ: ทีมพัฒนาที่ลงทุนกับ Selenium อยู่แล้วและไม่อยากย้าย โปรเจกต์ที่ต้องใช้หลายภาษา (Java, C#) และระบบสแครปแบบเก่า
10. BeautifulSoup
 BeautifulSoup คือไลบรารี Python น้ำหนักเบาสำหรับ parse HTML และ XML เวอร์ชันล่าสุดบน PyPI คือ 4.14.3 (30 พฤศจิกายน 2025)
ต้องย้ำให้ชัด: BeautifulSoup คือ ตัว parser ไม่ใช่เว็บสแครปเปอร์แบบครบวงจร มันไม่ดึงหน้าเว็บเองและไม่จัดการ browser automation คุณต้องใช้ร่วมกับ requests สำหรับดึงหน้าเว็บ แล้วให้ BeautifulSoup parse HTML ที่ได้รับมา นั่นทำให้มันเป็นจุดเริ่มต้นที่ง่ายที่สุดสำหรับนักพัฒนา แต่ก็มีข้อจำกัดมากที่สุดเช่นกัน
ฟีเจอร์เด่น:
- เรียนรู้ง่ายมาก ใช้โค้ดน้อย
- เหมาะกับงานสแครป Craigslist ขนาดเล็กหรือครั้งเดียว
- ฟรีและโอเพนซอร์ส
ข้อจำกัด: ไม่มีการจัดการ pagination ในตัว ไม่มี JavaScript rendering ไม่มี proxy rotation — ต้องต่อเพิ่มเองทั้งหมด ถ้า Craigslist เปลี่ยนโครงสร้าง HTML selector ของคุณก็พัง และต้องแก้มือเอง
เหมาะกับ: ผู้เริ่มต้น Python ที่อยากลองสแครป Craigslist แบบตั้งค่าน้อยที่สุด งานดึงข้อมูลครั้งเดียวจากหมวดหรือภูมิภาคเดียว และนักพัฒนาที่ต้องการตัว parse เบา ๆ
แผนรับมือการโดนแบนบน Craigslist: proxy, rate limit และพฤติกรรมที่ทำให้ถูกบล็อก
นี่คือส่วนที่คู่มือสแครป Craigslist ส่วนใหญ่มักข้าม และเป็นส่วนที่สำคัญที่สุด การทดสอบของ Scraperly ในเดือนเมษายน 2026 จัด Craigslist ไว้ในระดับความยาก 3/5 โดยระบุว่ามี CAPTCHA แบบกำหนดเอง, rate limiting และการบล็อก IP บทเรียนจาก Bright Data ก็ผลักให้ผู้ใช้ไปใช้ Web Unlocker หรือ Scraping Browser ที่ใช้ Playwright แทนการยิง HTTP ตรง ๆ ส่วนหน้า proxy ของ Oxylabs ระบุชัดว่า Craigslist ตรวจจับ proxy ได้ และ residential proxy คือทางเลือกที่ดีที่สุด
สิ่งที่ใช้งานได้จริงคือ:
| กลยุทธ์ | ประสิทธิภาพกับ Craigslist | ต้นทุน | ความซับซ้อน |
|---|---|---|---|
| Residential proxies | ✅ สูง | $$ (4–6 ดอลลาร์/GB) | ปานกลาง |
| ISP proxies | ✅ สูง | $ (0.60–0.80 ดอลลาร์/IP) | ปานกลาง |
| Datacenter proxies | ⚠️ ต่ำ (มักถูกบล็อก) | $ (0.20–0.40 ดอลลาร์/IP) | ต่ำ |
| สแครปผ่านเบราว์เซอร์ (session ของตัวเอง) | ✅ ปานกลาง-สูง | ฟรี | ต่ำ |
| จำกัดอัตรา + หน่วงเวลาแบบสุ่ม | ✅ จำเป็นพื้นฐาน | ฟรี | ต่ำ |
คำแนะนำที่นำไปใช้ได้ทันที:
- หน่วงเวลาระหว่าง request: อย่างน้อย 2–5 วินาทีต่อ request Scraperly แนะนำให้อยู่แถว ๆ 5–10 requests/นาทีต่อ IP และเปลี่ยน IP หลังครบ 20–30 requests
- หมุน session: สลับ user-agent และ browser fingerprint พฤติกรรมครอว์ลที่คาดเดาได้จะถูกจับเร็วมาก
- หลีกเลี่ยง datacenter proxies: ราคาถูก แต่โดนบล็อกบน Craigslist เร็ว
- สแครปผ่านเบราว์เซอร์ช่วยตัดปัญหา proxy ได้แทบทั้งหมดสำหรับงานปริมาณไม่มาก Thunderbit โหมดเบราว์เซอร์ทำงานใน Chrome session ของคุณเอง — ไม่ต้องตั้ง proxy ไม่ต้องหมุน IP และไม่มีค่าใช้จ่าย สำหรับผู้ใช้ธุรกิจส่วนใหญ่ที่สแครปไม่กี่ร้อยประกาศ นี่เกินพอ
และนี่คือเรื่องการดูแลรักษาที่คนมักมองข้าม: เมื่อ Craigslist เปลี่ยน CSS (ซึ่งเกิดเป็นระยะ) เว็บสแครปเปอร์ที่พึ่ง CSS-selector ทุกตัวจะพังหมด คุณต้องเปิดดูหน้าเว็บ หา selector ใหม่ อัปเดตโค้ด และทดสอบใหม่ เครื่องมือที่ใช้ AI อย่าง Thunderbit เลี่ยงปัญหานี้ได้โดยตรง — เพราะ AI อ่านโครงสร้างหน้าใหม่ทุกครั้ง การเปลี่ยนเลย์เอาต์จึงไม่ทำให้เวิร์กโฟลว์พัง
โค้ด vs. no-code: ตัวอย่างการสแครป Craigslist แบบครบทั้งสองทาง
ฉันรู้ว่าคนอ่านบทความนี้แบ่งกันประมาณครึ่งต่อครึ่ง: ฝั่งผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิคแต่ต้องการข้อมูล กับฝั่งนักพัฒนามือใหม่ถึงกลางที่อยากได้โค้ดใช้งานได้จริง ดังนั้นนี่คือทั้งสองเส้นทางวางคู่กัน
แบบไม่ต้องเขียนโค้ด: สแครป Craigslist ด้วย Thunderbit ทีละขั้น
- ติดตั้ง Thunderbit Chrome Extension จาก Chrome Web Store
- เข้าไปที่หน้ารายการของ Craigslist — เช่น อพาร์ตเมนต์ในเมืองของคุณ (
https://yourcity.craigslist.org/search/apa) - คลิก "One Click Extract" — AI ของ Thunderbit จะอ่านหน้าเว็บ ทำความเข้าใจโครงสร้าง ตัดสินใจว่าคอลัมน์ไหนเหมาะกับหมวดนั้น และเติมตารางที่มีโครงสร้างให้ในครั้งเดียว สำหรับ housing คุณจะเห็น Title, Price, Sqft, Bedrooms, Location, Date Posted, Link ถ้าต้องการ ก็ปรับคอลัมน์ภายหลังได้
- จัดการ pagination — คลิกไล่หน้าหรือปล่อยให้ Thunderbit จัดการให้
- ใช้ "Scrape Subpages" เพื่อเข้าไปเก็บข้อมูลแต่ละประกาศและเพิ่มฟิลด์จากหน้ารายละเอียด เช่น คำอธิบายเต็ม รูปภาพทั้งหมด และข้อมูลติดต่อที่ฝังอยู่
- ส่งออก ไป Google Sheets, Excel, Airtable, Notion หรือ CSV — ฟรี
ทั้งกระบวนการใช้เวลาประมาณ 2 นาทีต่อหนึ่งหน้าผลลัพธ์ ไม่มี CSS selector ไม่มี proxy ไม่มีโค้ด
เส้นทางแบบโค้ด: สแครป Craigslist ด้วย Python + Playwright
Playwright คือไลบรารีที่ชุมชนนักพัฒนาแนะนำมากที่สุดสำหรับ Craigslist scraping ในปี 2026 นี่คือตัวอย่าง Python ที่ใช้งานได้จริงสำหรับสแครปหน้าผลลัพธ์ที่อยู่อาศัยของ Craigslist ดึง title/price/link จัดการ pagination และส่งออกผลลัพธ์
แนวทางคือ: ลองอ่าน structured data แบบ JSON-LD ก่อน (Craigslist ฝัง schema ItemList ในบางหน้า) ถ้าไม่เจอค่อย fallback ไปใช้ DOM selector การเปลี่ยนหน้าทำผ่าน s=120
import asyncio, json
from urllib.parse import urlparse, parse_qs, urlencode, urlunparse
from playwright.async_api import async_playwright

def next_page_url(url, step=120):
    p = urlparse(url)
    qs = parse_qs(p.query)
    offset = int(qs.get("s", ["0"])[0]) + step
    qs["s"] = [str(offset)]
    return urlunparse((p.scheme, p.netloc, p.path, "", urlencode(qs, doseq=True), ""))

async def scrape_page(page, url):
    await page.goto(url, wait_until="domcontentloaded")
    await page.wait_for_timeout(1500)
    data = []
    # Try JSON-LD first
    for raw in await page.locator('script[type="application/ld+json"]').all_text_contents():
        try:
            obj = json.loads(raw)
        except Exception:
            continue
        if isinstance(obj, dict) and obj.get("@type") == "ItemList":
            for item in obj.get("itemListElement", []):
                thing = item.get("item", {})
                data.append({
                    "title": thing.get("name"),
                    "price": thing.get("offers", {}).get("price"),
                    "link": thing.get("url"),
                })
            if data:
                return data
    # Fallback: DOM selectors
    cards = page.locator("div.cl-search-result, li.cl-static-search-result")
    count = await cards.count()
    for i in range(count):
        card = cards.nth(i)
        title = await card.locator("a.posting-title, a.titlestring").first.text_content()
        link = await card.locator("a.posting-title, a.titlestring").first.get_attribute("href")
        price = (await card.locator(".price, .result-price").first.text_content()
                 if await card.locator(".price, .result-price").count() else None)
        data.append({"title": (title or "").strip(), "price": (price or "").strip(), "link": link})
    return data

async def main():
    start_url = "https://newyork.craigslist.org/search/apa?query=studio"
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        url = start_url
        all_rows = []
        for _ in range(3):  # scrape 3 pages
            rows = await scrape_page(page, url)
            if not rows:
                break
            all_rows.extend(rows)
            url = next_page_url(url)
        await browser.close()
        for row in all_rows[:10]:
            print(row)

asyncio.run(main())
สิ่งที่ต้องมีนอกเหนือจากสคริปต์นี้: ติดตั้ง Playwright (pip install playwright && playwright install), ตั้งค่า proxy หากรันปริมาณมาก และจัดการ CAPTCHA เองถ้าเจอ rate limit นี่แหละคือ tradeoff: ได้คุมทุกอย่าง แต่ก็ต้องรับผิดชอบทุกอย่าง
ฟรี vs จ่าย: สรุปต้นทุนแบบตรงไปตรงมาสำหรับเว็บสแครปเปอร์แต่ละตัว
นี่คือตารางที่ฉันอยากให้มีตอนเริ่มหาข้อมูลเรื่องนี้ คำว่า "ฟรี" ในงานเว็บสแครปปิ้งมันมีเงื่อนไขซ่อนอยู่เยอะมาก
| เครื่องมือ | ฟรีจริงไหม? | ข้อจำกัดของแผนฟรี | ราคาเริ่มต้นแบบจ่าย | ต้นทุนแฝง |
|---|---|---|---|---|
| Thunderbit | แผนฟรี | 6 หน้า/เดือน; ทดลองฟรี = 10 หน้า | มีแพ็กเกจจ่ายสำหรับปริมาณสูง | ไม่มี — ส่งออกฟรี |
| Scrapy | ✅ โอเพนซอร์ส | ไม่จำกัด | $0 | ค่า proxy, hosting, และค่าดูแล |
| BeautifulSoup | ✅ โอเพนซอร์ส | ไม่จำกัด | $0 | ค่า proxy, hosting, และค่าดูแล |
| Playwright | ✅ โอเพนซอร์ส | ไม่จำกัด | $0 | ค่า proxy, hosting, และค่าดูแล |
| Selenium | ✅ โอเพนซอร์ส | ไม่จำกัด | $0 | ค่า proxy, hosting, และค่าดูแล |
| ParseHub | แผนฟรี | 5 โปรเจกต์ | ประมาณ ~$189/เดือน | scheduled run จำกัดในฟรี |
| Apify | แผนฟรี | เครดิตฟรี $5/เดือน | ประมาณ ~$49/เดือน | ราคาแบบ compute อาจพุ่ง |
| Phantombuster | แผนฟรี | 5 slots, 2 ชม./เดือน, ส่งออกได้ 10 แถว | ประมาณ ~$56/เดือน (รายปี) | คิดราคาต่อ slot |
| Bright Data | ทดลองใช้เท่านั้น | 1K requests/1 สัปดาห์ | ประมาณ ~$500+/เดือน | ค่า proxy แยกต่างหาก |
| Oxylabs | ทดลองใช้เท่านั้น | 2K results / 1GB | ประมาณ ~$75+/เดือน (Unblocker) | ราคาแบบองค์กร |
สิ่งที่ต้องใส่เครื่องหมายดอกจันใหญ่ ๆ สำหรับคำว่า "ฟรี" ในเครื่องมือโอเพนซอร์ส: Scrapy, Playwright, Selenium และ BeautifulSoup ติดตั้งได้ฟรี 0 ดอลลาร์ แต่ถ้าจะรันในสเกลใหญ่บน Craigslist ก็แปลว่าต้องใช้เวลานักพัฒนาหลายชั่วโมงกับการตั้งค่า ค่า residential proxy เดือนละ 50–500+ ดอลลาร์ และการดูแลต่อเนื่องทุกครั้งที่ Craigslist เปลี่ยน HTML ส่วน Thunderbit ใช้ AI อ่านหน้าใหม่ทุกครั้ง (ดูแลรักษาเป็นศูนย์) ส่งออกฟรี และสแครปผ่านเบราว์เซอร์ช่วยตัดค่า proxy ออกไปสำหรับงานปริมาณปานกลาง นี่คือข้อได้เปรียบที่แท้จริงสำหรับคนที่ไม่ใช่นักพัฒนา
คุณดึงข้อมูลอะไรได้จริงบ้าง: ฟิลด์ข้อมูล Craigslist แยกตามหมวด
แต่ละหมวดของ Craigslist มีโครงสร้างข้อมูลไม่เหมือนกันเลย ประกาศที่อยู่อาศัยไม่ได้หน้าตาเหมือนประกาศงาน นี่คือฟิลด์ที่คุณสามารถดึงได้จริงจากหมวดหลัก ๆ:
| หมวด Craigslist | ฟิลด์ที่ดึงได้ | มีข้อมูลติดต่อไหม? | |---|---|---|---| | Housing / Apartments | Title, Price, Sqft, Bedrooms, Bathrooms, Location, Date, Images, Description, Map Link, Availability, Pet Policy, Laundry/Parking | ⚠️ บางครั้ง (relay email แบบไม่เปิดเผยตัวตน) | | For Sale | Title, Price, Condition, Location, Date, Images, Description, Make/Model/Year (แล้วแต่ประกาศ) | ⚠️ บางครั้ง | | Jobs | Title, Company, Compensation, Location, Job Type, Experience Level, Date, Description | พบได้น้อย (มักมีแค่ลิงก์สมัคร) | | Services | Title, Location, Description, Images | ⚠️ บางครั้ง | | Gigs | Title, Compensation, Location, Date, Description | ⚠️ บางครั้ง |
ข้อควรจำที่สำคัญ:
- ข้อมูลติดต่อ: Craigslist ใช้ระบบ email relay แบบไม่เปิดเผยตัวตนโดยตั้งใจ เพื่อป้องกันการสแครปอีเมลตรง ๆ เครื่องมือที่อ้างว่า "ดึงอีเมล" ได้ มักดึงแค่ที่อยู่ relay (
reply+randomstring@craigslist.org) ไม่ใช่อีเมลจริงของผู้ลงประกาศ - ฟิลด์จากหน้ารายละเอียด เช่น คำอธิบายฉบับเต็ม รูปภาพทั้งหมด และข้อมูลติดต่อที่ฝังอยู่ จะมีเฉพาะตอนเข้าไปในประกาศรายรายการ ไม่ได้อยู่บนหน้าผลลัพธ์การค้นหา
- ฟีเจอร์ "One Click Extract" ของ Thunderbit จะตรวจจับฟิลด์ที่มีอยู่บนหน้าปัจจุบันและเสนอคอลัมน์ที่เหมาะสมให้อัตโนมัติ คนที่สแครป housing จะได้คอลัมน์ sqft/bedrooms ส่วนคนที่สแครป jobs จะได้ compensation/job-type โดยไม่ต้องตั้งค่าเอง จากนั้น subpage scraping จะเข้าไปดึงฟิลด์เฉพาะหน้ารายละเอียดให้
เช็กความจริงด้านกฎหมาย: ข้อกำหนดของ Craigslist, คดี 3Taps และสิ่งที่ควรรู้
ฉันไม่ใช่ทนาย และนี่ไม่ใช่คำแนะนำทางกฎหมาย แต่ฉันรู้ว่าผู้ใช้กังวลเรื่องนี้ และควรตอบตรง ๆ
บรรทัดฐานสำคัญ: ในคดี Craigslist v. 3Taps (2013) Craigslist ได้รับคำสั่งห้ามต่อ 3Taps จากการสแครปและเผยแพร่ประกาศซ้ำ หลังจากส่งจดหมาย cease-and-desist แล้ว 3Taps ถูกกล่าวหาว่าเลี่ยงการบล็อก IP ด้วย proxy server และศาลมองว่าการเข้าถึงหลังถูกบล็อกอาจถือเป็นการเข้าใช้งาน "โดยไม่ได้รับอนุญาต" EFF ระบุ ว่าคดีนี้มีการยอมความในปี 2015
ข้อกำหนดการใช้งานของ Craigslist ระบุชัดว่า ห้าม ใช้ "robots, spiders, scripts, scrapers, crawlers, หรือเทียบเท่าอัตโนมัติหรือทำมือใด ๆ" เพื่อโต้ตอบกับไซต์ และยังระบุค่าปรับแบบ liquidated damages ไว้ที่ 0.25 ดอลลาร์ต่อหน้า หลังจากเข้าชมเกิน 1,000 หน้าแรกในช่วง 24 ชั่วโมง หากฝ่าฝืน
แนวทางปฏิบัติจริง:
- ✅ สแครปข้อมูลประกาศสาธารณะเพื่อการวิจัยตลาดหรือใช้งานส่วนตัว
- ✅ เคารพ robots.txt และ rate limit
- ⚠️ อย่านำประกาศที่สแครปมาลงซ้ำแบบมวลรวม
- ⚠️ อย่าใช้ข้อมูลติดต่อที่สแครปได้เพื่อส่งการตลาดแบบไม่ได้รับเชิญ
- ❌ อย่าเลี่ยงข้อจำกัดทางเทคนิคหลังจากถูกบล็อกแล้ว
จุดแยกแยะสำคัญคือ การสแครปข้อมูลสาธารณะเพื่อวิเคราะห์ของคุณเอง ไม่เหมือนกับการเผยแพร่ซ้ำจำนวนมากหรือเก็บอีเมลไปสแปม แต่ต้องจำไว้ว่า Craigslist เคยยกระดับจากการบังคับใช้เงื่อนไข ไปสู่การบล็อก IP และถึงขั้นดำเนินคดีมาแล้ว
เว็บสแครปเปอร์ Craigslist ตัวไหนเหมาะกับคุณที่สุด?
หลังจากทดสอบและประเมินทั้ง 10 ตัว นี่คือคำแนะนำตามสถานการณ์ใช้งาน:
- ผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิคและต้องการข้อมูล Craigslist เร็ว ๆ → Thunderbit ไม่ต้องเขียนโค้ด ตรวจจับฟิลด์ด้วย AI ดูแลรักษาแทบเป็นศูนย์ ส่งออกฟรี คือเส้นทางที่เร็วที่สุดจาก "ฉันต้องการข้อมูลนี้" ไปสู่ "ข้อมูลอยู่ในสเปรดชีตแล้ว"
- ทีมองค์กรที่สแครปหลายพันรายการต่อวันจากทุกภูมิภาค → Bright Data มี scraper เฉพาะ Craigslist, โครงสร้าง proxy ขนาดใหญ่, แก้ CAPTCHA อัตโนมัติ และซัพพอร์ตโดยตรง
- ทีมพัฒนาที่ต้องการ API/proxy แบบ managed → Oxylabs สำหรับ workflow ที่เน้น proxy, Apify สำหรับความยืดหยุ่นจาก actor marketplace
- นักพัฒนาที่อยากคุมทุกอย่างและปรับแต่งได้เต็มที่ → Scrapy + Playwright โอเพนซอร์ส ยืดหยุ่นสูงสุด แต่ต้องเตรียม proxy และดูแลรักษาเอง
- ผู้ใช้ที่งบจำกัดแต่ความต้องการปานกลาง → แผนฟรีของ Apify ($5/เดือนเครดิต) หรือแผนฟรีของ ParseHub (5 โปรเจกต์)
- ทีมขายที่ใช้งานเครื่องมือ lead gen หลายแพลตฟอร์มอยู่แล้ว → Phantombuster เพิ่ม Craigslist เข้า pipeline เดิมได้เลย
- มือใหม่ Python ที่ต้องการสแครปแบบครั้งเดียว → BeautifulSoup + requests โค้ดน้อย ตั้งค่าน้อย ความสามารถก็พอเหมาะ
สำหรับผู้ใช้ธุรกิจที่ไม่ถนัดเทคนิคส่วนใหญ่ Thunderbit ให้สมดุลที่ดีที่สุดระหว่างความง่าย ความแม่นยำ และต้นทุน ส่วนฝั่งนักพัฒนา Scrapy + Playwright คือชุดที่ทรงพลังที่สุด และสำหรับสเกลระดับองค์กร Bright Data ก็ยากจะสู้ได้
ถ้าคุณอยากดูว่าการสแครป Craigslist ด้วย AI หน้าตาเป็นอย่างไร ลอง ใช้ Thunderbit ดู — แผนฟรีพอให้ทดสอบกับเคสของคุณเองได้ และถ้าต้องการลงลึกเรื่องเทคนิค web scraping เพิ่มเติม ลองอ่านคู่มือของเราเรื่อง how to scrape into Google Sheets, best automated web scraping tools, และ web scraping without getting blocked หรือเข้าไปดู ช่อง YouTube ของเรา สำหรับวิดีโอสอนทีละขั้นตอน
ขอให้สแครปอย่างราบรื่น — และขอให้ข้อมูลของคุณสะอาด เป็นโครงสร้าง พร้อมใช้งานเสมอ
คำถามที่พบบ่อย
การสแครปประกาศ Craigslist ผิดกฎหมายไหม?
ข้อกำหนดการใช้งานของ Craigslist ห้ามการสแครปแบบอัตโนมัติโดยตรง และคดี Craigslist v. 3Taps ถือเป็นบรรทัดฐานทางกฎหมายสำคัญ การสแครปข้อมูลประกาศสาธารณะเพื่อการใช้งานส่วนตัวหรือวิเคราะห์มักถูกมองต่างจากการเผยแพร่ซ้ำจำนวนมากหรือสแปม แต่คุณควรเคารพ rate limit และกฎของไซต์เสมอ — และนี่ไม่ใช่คำแนะนำทางกฎหมาย
ฉันสแครป Craigslist ได้ไหมโดยไม่ต้องเขียนโค้ด?
ได้ เครื่องมืออย่าง Thunderbit, ParseHub และ Apify มีตัวเลือกแบบ no-code หรือ low-code สำหรับดึงข้อมูล Craigslist โดยเฉพาะ Thunderbit ยิ่งง่ายเพราะใช้ AI ตรวจจับฟิลด์ — แค่คลิก "One Click Extract" แล้ว "Scrape" ก็พอ
เว็บสแครปเปอร์ Craigslist ฟรีที่ดีที่สุดคืออะไร?
สำหรับนักพัฒนา Scrapy หรือ BeautifulSoup ฟรีและโอเพนซอร์สจริง ๆ (แต่ค่า proxy และค่าดูแลยังมีอยู่) ส่วนผู้ที่ไม่เขียนโค้ด แผนฟรีของ Thunderbit (6 หน้า/เดือน) คือจุดเริ่มต้นที่ดีที่สุด และแผนฟรีของ ParseHub (5 โปรเจกต์) ก็เป็นอีกตัวเลือกหนึ่ง
จะหลีกเลี่ยงการถูกบล็อกตอนสแครป Craigslist ได้อย่างไร?
ใช้ rate limiting (หน่วงอย่างน้อย 2–5 วินาที), หมุน user-agent, หลีกเลี่ยง datacenter proxies (บน Craigslist residential หรือ ISP proxies จะเวิร์กกว่าเยอะ) และอย่าไล่ครอว์ลเป็นแพตเทิร์นที่คาดเดาได้ สำหรับงานปริมาณไม่มาก เครื่องมือสแครปผ่านเบราว์เซอร์อย่าง Thunderbit ช่วยเลี่ยงปัญหา proxy ได้เลย เพราะมันทำงานใน Chrome session ของคุณเอง
ฉันสแครป Craigslist ทุกภูมิภาคพร้อมกันได้ไหม?
ด้วยเครื่องมือฝั่งนักพัฒนาอย่าง Scrapy หรือ Playwright คุณสามารถวนลูปผ่าน 416 URL ของภูมิภาคในสหรัฐฯ/เขตปกครอง ได้ตามโปรแกรม เครื่องมือระดับองค์กรอย่าง Bright Data และ Oxylabs ก็มี multi-region scraping มาให้ในตัว ส่วน Thunderbit คุณสามารถเปิดแต่ละไซต์ภูมิภาคแล้วใช้เวิร์กโฟลว์เดิมได้ AI จะปรับเข้ากับแต่ละหน้าให้อัตโนมัติ
ลอง Thunderbit สำหรับสแครป Craigslist Get Started Free
เรียนรู้เพิ่มเติม



