Baidu-scraper för sökresultat och artiklar













Gör Baidu-resultat till ren och användbar data
Samla sökresultat och tillgängliga artikeluppgifter i en enda tydlig tabell.
Rensa Baidu-data medan du samlar in den
Thunderbit placerar synliga titlar, URL:er, utdrag, datum och källor i tydliga kolumner. Om ett resultat inte visar ett fält lämnas cellen tom.

Exportera Baidu-research med ett klick
Skicka varje körning till ett granskningsblad för sökresultat. Rankning, källor, datum och detaljer från länkade sidor stannar bredvid det matchande Baidu-resultatet.
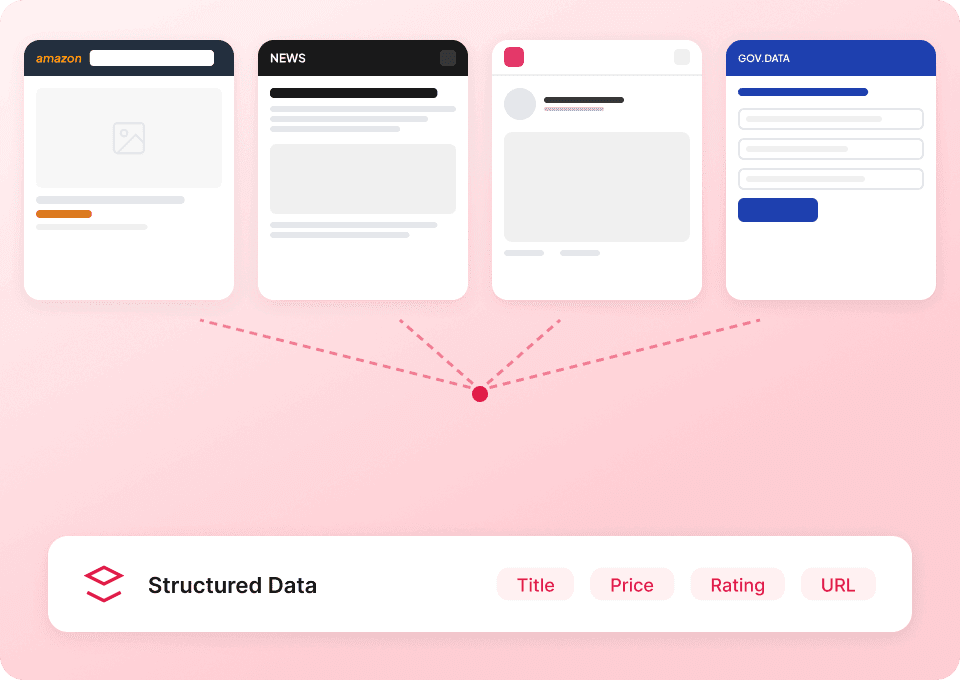
Använd samma arbetsflöde på alla webbplatser
Thunderbit läser fält utifrån betydelse, inte utifrån en specifik Baidu-layout. Använd samma arbetssätt på valfri tillgänglig offentlig webbplats när din research går vidare till en ny källa.
Behåll sammanhanget kring varje Baidu-resultat
En länklista tappar sammanhang. Thunderbit håller synliga detaljer bredvid varje resultat.
Kopierade länkar och lösa anteckningar
Resultatdetaljerna skiljs åtStrukturerad Baidu-research
Synligt sammanhang följer med varje resultatVilken data kan du extrahera från Baidu?
Välj bland dessa offentliga, synliga fält. Resultatmoduler och länkade sidor visar inte alla fält för varje sökning.
- Sökfråga
- Resultatrankning
- Resultattitel
- Resultat-URL
- Visad URL
- Resultatutdrag
- Resultatdatum
- Resultatets webbplatsikon
- Relaterad sökfras
- Stavningsförslag
- Pinyin-förslag
- Sökresultatsidans nummer
- Källwebbplats
- Källdomän
- Artikelförfattare
- Artikelns publiceringsdatum
- Artikelns sammanfattning
- Dokumentnamn
- Dokumentbeskrivning
- Dokumentets brödsmulor
- Dokumentgenre
- Dokumentets filformat
- Dokumentets sidantal
- Dokumentets uppladdningstid
- Dokument-URL
- Resultatinnehållstyp
- Miniatyrbild
- Videominiatyr
- Platsadress
- Baidu-funktionsmodul
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.

Frågor om insamling av Baidu-sökdata
Tillgängliga fält varierar beroende på sökning, resultattype och vilken information som visas på länkade sidor.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Teams Scraper
Thunderbit Teams Scraper hjälper dig att hämta ut chattmeddelanden och information om communitymedlemmar från Microsoft Teams. Med AI-drivna fältförslag kan du snabbt samla in meddelandetext, avsändaruppgifter, tidsstämplar och medlemsprofiler för analys eller rapportering. Perfekt för projektledare, HR och forskare som vill ha Teams-data i ett strukturerat format.
Läs mer ->
Framer Scraper
Thunderbits Framer Scraper hjälper dig att extrahera mallistor och showcase-exempel från Framer med hjälp av AI. Skrapa kategorier som Portfolio-mallar och besök sedan varje mall- eller showcase-undersida för att hämta detaljer som titel, taggar, förhandsgranskningslänkar och metadata. Exportera resultatet till Excel, Google Sheets, Airtable eller Notion med bara ett par klick.
Läs mer ->
WordPress.org-scraper
Thunderbits WordPress.org-scraper hjälper dig att med AI hämta strukturerad data från WordPress plugin-katalog och blockmönsterbiblioteket. Skrapa listningssidor och berika resultaten med detaljer från undersidor, som pluginstatistik, versioner, betyg och mönstermetadata – och exportera sedan till Excel, Google Sheets, Airtable eller Notion.
Läs mer ->
Capterra-scraper
Extrahera mjukvarunamn, betyg och prismodeller från Capterra med bara 2 klick – och exportera direkt till Excel, Google Sheets eller Notion. Ingen kod behövs.
Läs mer ->
GoDaddy Scraper
Peka på vilket GoDaddy-domännamn, vilken tillgänglighetsstatus eller vilket pris som helst — Thunderbits AI hämtar datan på 2 klick och exporterar den direkt till Excel, Google Sheets eller Notion.
Läs mer ->
Goodreads-scraper
Extrahera boktitlar, författarnamn, betyg och antal recensioner från Goodreads på 2 klick — och exportera sedan dina data till Excel, Google Sheets eller Notion, redo för analys.
Läs mer ->Redo att växla upp din dataextraktion?
Gå med över 200 000 yrkespersoner som redan använder Thunderbit för att automatisera sina arbetsflöden för web scraping.
Gratis provperiod ger obegränsade credits för 8 webbsidor.



